
Lernpfad
Dateningenieur in Python
40 Std.
Apache Spark und Apache Flink sind zwei Open-Source-Frameworks zur Datenverarbeitung, die breit in Big Data und Analytics eingesetzt werden. Beide sind leistungsstarke Werkzeuge mit robusten Fähigkeiten zur Datenverarbeitung, unterscheiden sich aber in Architektur und Kernfunktionen.
Wir beleuchten die wichtigsten Eigenschaften von Spark und Flink — mit Fokus auf Verarbeitungsmodelle, Datenabstraktionen, Zustandsverwaltung und Performance. Außerdem schauen wir uns an, wie jedes Framework Batch- und Echtzeitverarbeitung handhabt. Wenn du ihre Unterschiede und Gemeinsamkeiten verstehst, kannst du das passende Framework für deinen Bedarf auswählen.
Das Datenvolumen wächst rasant. Unternehmen, die Big Data nutzen wollen, stoßen schnell an Grenzen bei Skalierung und Effizienz.
Datenverarbeitungs-Frameworks schaffen Abhilfe: Sie unterstützen eine Vielzahl von Operationen wie Ingestion, Transformation und Speicherung — auch bei Terabytes an Daten. Sie bieten ein breites Set an Tools und APIs und geben dir damit die Flexibilität, von Basisaufgaben bis hin zu Machine-Learning-Workflows alles abzudecken. Zusätzlich abstrahieren sie Komplexität und vereinfachen so Entwicklung und Debugging von Datenanwendungen.
Im Kern verteilen Datenverarbeitungs-Frameworks die Arbeit auf mehrere Knoten in einem Cluster. Manche sind speziell auf Echtzeitdaten ausgelegt, sodass du Daten beim Eintreffen analysieren kannst. Andere sind für Batch-Verarbeitung optimiert — ideal für rückblickende Analysen.
Apache Spark ist ein Open-Source-Framework für verteiltes Rechnen, das große Datenmengen effizient und schnell verarbeitet. Es setzt auf ein In-Memory-Programmiermodell, kann Daten also im Hauptspeicher der Clusterknoten halten — das beschleunigt die Verarbeitung im Vergleich zu Tools, die stärker auf Festplattenzugriffe setzen, erheblich. Über einfach zu nutzende Schnittstellen kannst du komplexe Datenoperationen per API in mehreren Sprachen ausführen, etwa in Python und R — zwei der wichtigsten Sprachen in der Data Science.
Apache Spark führt Operationen fehlertolerant aus und kann Ausfälle von Clusterknoten automatisch abfangen. Möglich macht das die Komponente Resilient Distributed Dataset (RDD), eine verteilte Sammlung von Dateneinträgen als Basiseinheiten.
Das Ausführungsmodell von Spark, der Directed Acyclic Graph (DAG), optimiert außerdem die parallele Abarbeitung deiner Aufgaben. Dadurch kann Spark Tasks über verschiedene Knoten eines Clusters verteilen und alle Ressourcen maximal nutzen.
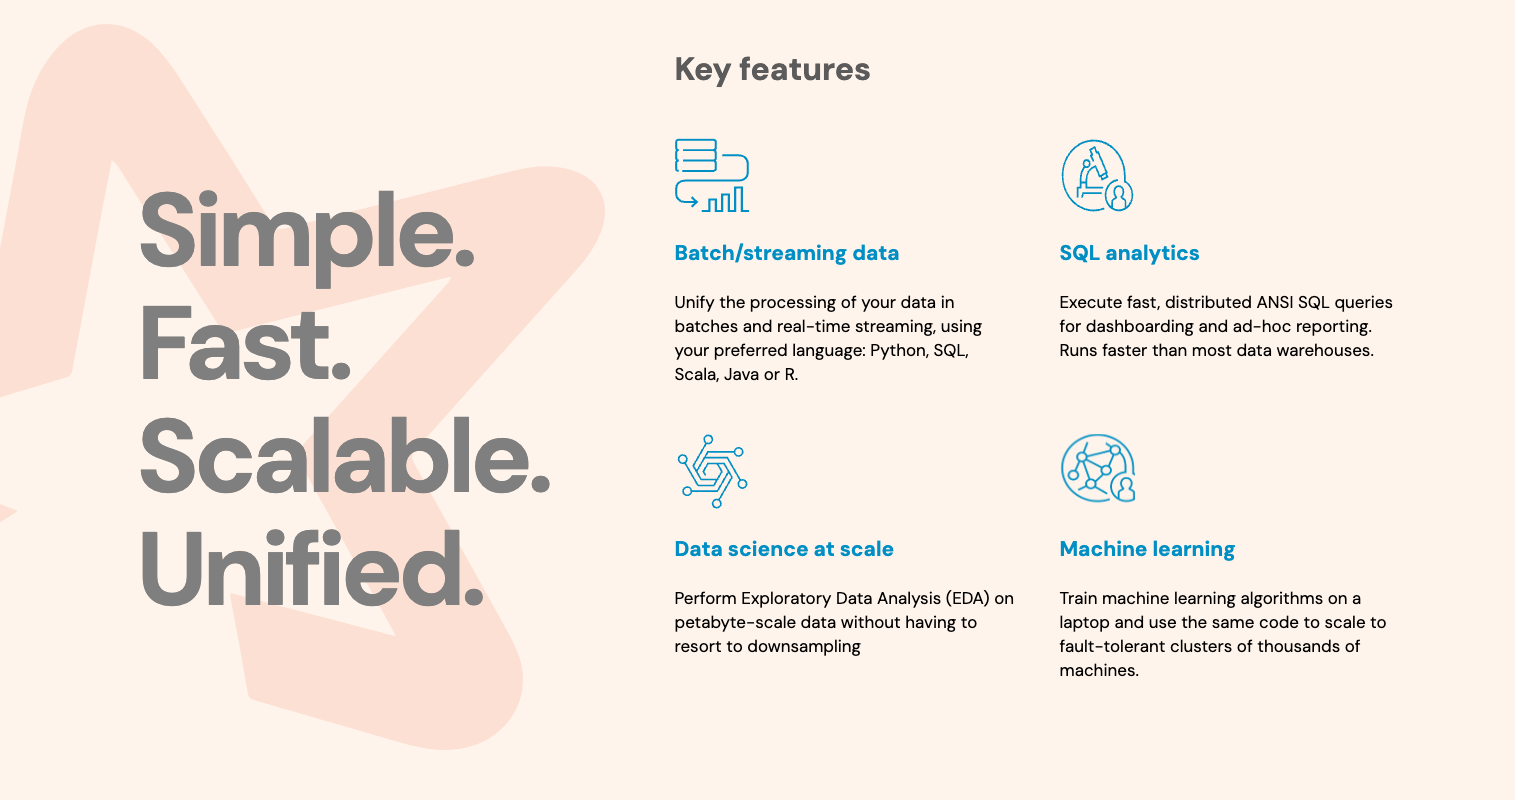 Hauptfunktionen von Apache Spark. Quelle
Apache Flink ist ein Open-Source-System zur Datenverarbeitung, das vor allem bei Echtzeitanalysen und der Verarbeitung großer Datenmengen mit niedriger Latenz und hoher Performance punktet. Mit derselben Infrastruktur kann Flink auch Batch-Daten verarbeiten — ein großer Vorteil, wenn du komplexe Datenpipelines auf verteilten Systemen bauen und betreiben willst, die Echtzeitdaten verarbeiten. Flink bietet APIs in mehreren Sprachen, darunter Python und R, sowie spezialisierte Bibliotheken für Event-Processing-Pipelines und Machine Learning.
Apache Flink behandelt Daten als kontinuierliche Ereignisströme — ideal für Anwendungen, in denen Daten fortlaufend eintreffen und verarbeitet werden. Dieses strombasierte Programmiermodell ist ein Schlüssel für niedrige Latenzen bei der Ereignisreaktion. Mit Flink-Operationen kannst du zudem komplexe, hochgradig maßgeschneiderte Datenpipelines bauen.
Flink verwaltet Zustand in Echtzeitanwendungen effizient. Das heißt, du kannst den Anwendungszustand bei eintreffenden Daten fehlertolerant halten und aktualisieren.
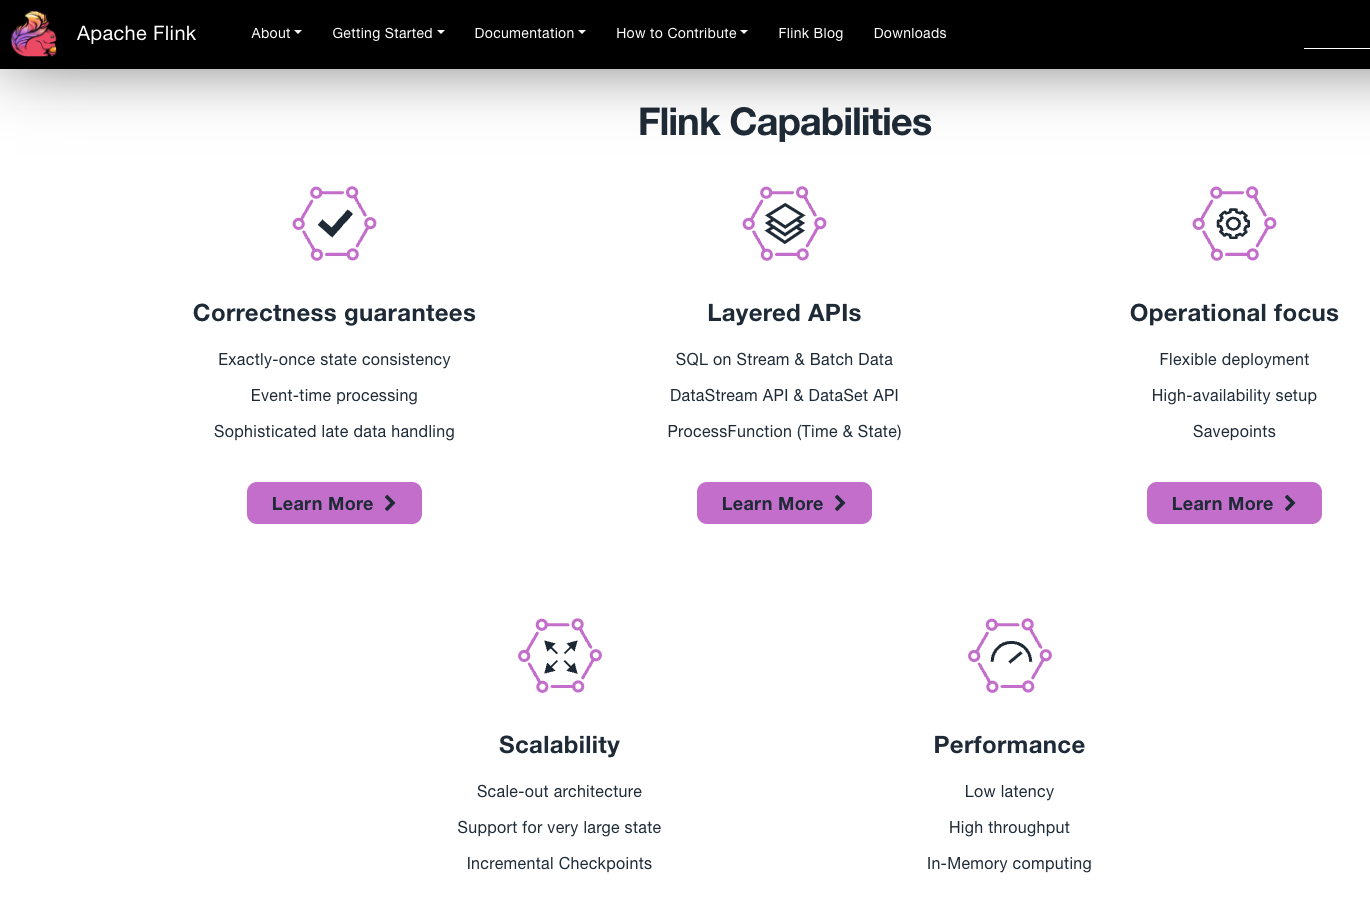 Hauptfunktionen von Flink. Quelle
Wenn du die Stärken eines passenden Datenverarbeitungs-Frameworks nutzt, steigerst du Leistung und Effizienz deiner Datenpipeline. Unter all den Features von Spark und Flink gibt es einige zentrale Punkte, die du bei der Auswahl bewerten solltest:
Trotz markanter Unterschiede teilen Spark und Flink mehrere wichtige Eigenschaften. Beide sind für großskalige Datenverarbeitung mit niedriger Latenz gebaut. Beide bieten APIs in mehreren Sprachen, darunter Python, Scala, Java und R, und sind in ein breites Big-Data-Ökosystem eingebunden. Außerdem implementieren Spark und Flink diverse Performance-Optimierungen.
Schauen wir uns diese Gemeinsamkeiten genauer an:
Apache Flink und Apache Spark verarbeiten große Datenmengen in einem Cluster aus Rechnern. So kannst du Anwendungen horizontal skalieren und riesige Datensätze mit geringer Latenz bewältigen, indem Ressourcen dynamisch über mehrere Knoten zugewiesen werden. Beide Frameworks unterstützen Batch- und Streaming-Verarbeitung.
Sowohl Spark als auch Flink stellen High-Level-APIs und Abstraktionen in mehreren Sprachen wie Scala, Python und Java bereit, sodass du Pipelines in deiner bevorzugten Sprache schreiben und ausführen kannst. Diese APIs erleichtern die Entwicklung von Datenanwendungen. Darüber hinaus bringt Flink Bibliotheken für Machine Learning (FlinkML), Complex Event Processing (FlinkCEP) und Graphverarbeitung (Gelly) mit. Spark bietet ebenfalls Bibliotheken für Machine Learning (MLlib), Graphverarbeitung (GraphX) und Echtzeitdatenverarbeitung (Structured Streaming).
Apache Spark wie auch Apache Flink integrieren sich in ein umfangreiches Ökosystem aus Big-Data-Tools, darunter Hadoop Distributed File System, Apache Kafka und Cloud-Speicher wie Amazon S3.
Beide Frameworks setzen auf Performance-Optimierungen, die die Effizienz der Datenverarbeitung maximieren. So kannst du komplexe Aufgaben durch parallele Ausführung, geschickte Task-Planung und Query-Optimierung stemmen. Spark nutzt den Catalyst Optimizer, während Flink für Batch-Verarbeitung einen kostenbasierten Optimierer einsetzt.
In ihren Grundfähigkeiten und Verarbeitungsansätzen sind sich Apache Spark und Apache Flink ähnlich. Gleichzeitig gibt es deutliche Unterschiede bei den Stärken und Schwerpunkten ihrer Verarbeitungsmodelle, der Reife ihrer Ökosysteme und Sprachunterstützung sowie beim Ansatz zu Optimierung und Zustandsmanagement.
Apache Flink ist primär auf Echtzeitverarbeitung ausgelegt. Das Framework basiert auf einer Streaming-Laufzeit und kann zusätzlich Batch-Verarbeitung übernehmen. Apache Spark wurde hingegen ursprünglich für Batch-Verarbeitung entwickelt und eignet sich besonders für rückblickende Analysen großer Datensätze. Über Micro-Batching kann Spark auch Streams verarbeiten — allerdings meist mit höheren Latenzen als Flink.
Beide Frameworks bieten APIs in mehreren Programmiersprachen. Flinks Python-Support ist jedoch weniger ausgereift, was ein Nachteil sein kann, wenn dein Team stark datenscience-orientiert ist.
Obwohl beide Frameworks gut mit Big-Data-Tools integrieren, verfügt Apache Spark über ein größeres und reiferes Ökosystem mit vielen Konnektoren, Bibliotheken und Tools. Apache Flink baut das verfügbare Set an Tools und Erweiterungen aus, gilt aber insgesamt noch als weniger gereift.
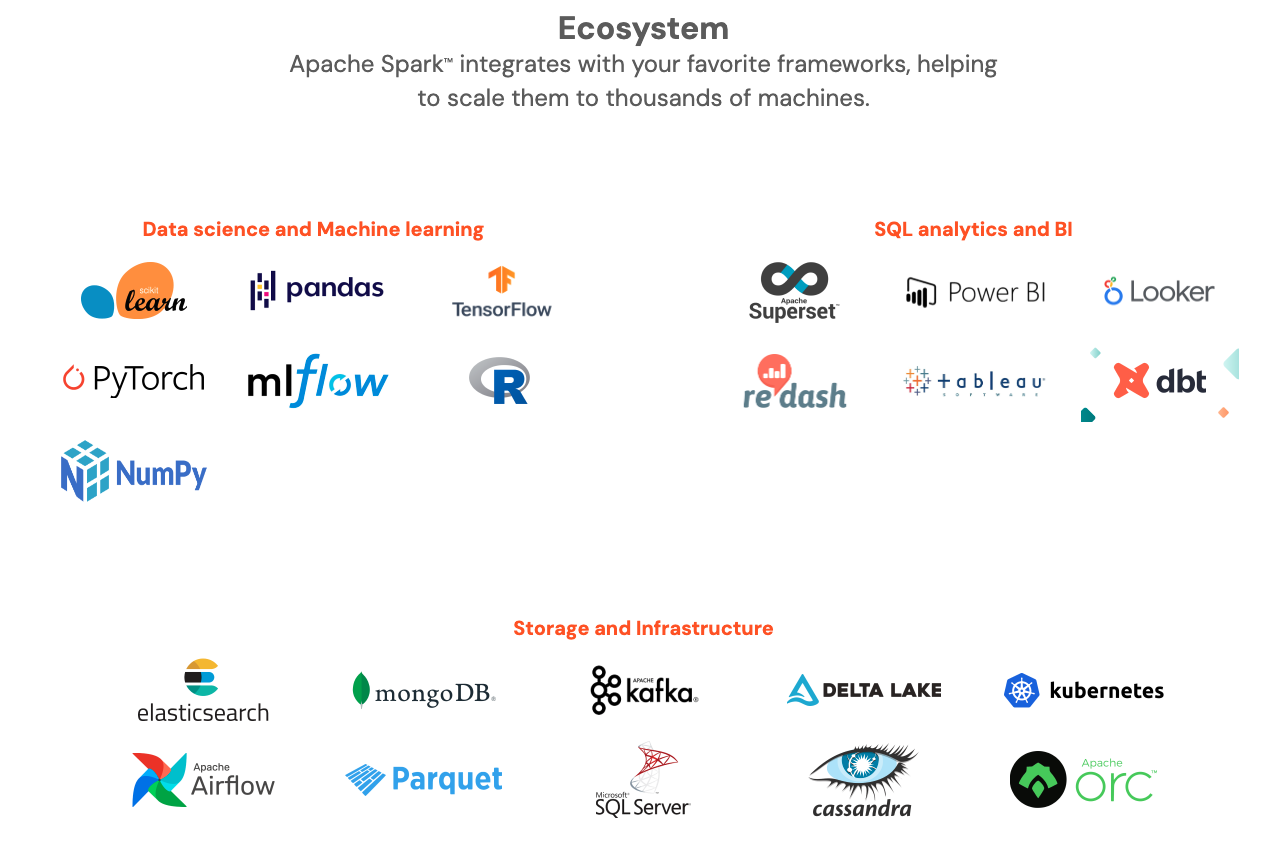
Apache Spark Ökosystem. Quelle
Apache Flink bietet eine fortgeschrittene und flexible Zustandsverwaltung — ein Pluspunkt, wenn du Pipelines betreibst, die Zustand in Echtzeit halten und aktualisieren müssen, z. B. Event-Time- und Processing-Time-Fenster oder Fenster zur Erkennung komplexer Ereignismuster. Spark deckt grundlegende Windowing-Funktionen ab, die gut funktionieren, wenn Batch- und Micro-Batching-Verarbeitung gefragt ist.
Apache Flink und Apache Spark haben viele Gemeinsamkeiten, unterscheiden sich aber deutlich in Verarbeitungsansatz, Latenz, Performance und Zustandsmanagement. Außerdem differieren Reife des Ökosystems und Sprachsupport leicht. Welches Framework du wählst, hängt vor allem von den Anforderungen deines Projekts ab. In einigen Disziplinen hat jedoch jeweils eines der beiden die Nase vorn:
Spark wurde ursprünglich für Batch-Verarbeitung entwickelt, unterstützt heute aber auch Streaming über Spark Streaming. Flink wurde speziell für Streaming entwickelt und unterstützt inzwischen ebenfalls Batch-Verarbeitung.
Spark nutzt Resilient Distributed Datasets und Datenpartitionierung, um Parallelisierung zu steigern und Ressourcen optimal zu nutzen. Flink setzt auf Operator Chaining und Pipeline-Ausführung, was Parallelverarbeitung und Ressourcenmanagement weiter verbessert. Generell gilt Flink als schneller und performanter bei Echtzeitanwendungen.
Spark bietet grundlegende Windowing-Funktionen, vor allem zeitbasiert, passend für feste oder gleitende Zeitfenster in Batch und Streaming. Flink überzeugt mit erweiterten Windowing-Fähigkeiten, darunter Event-Time- und Processing-Time-Fenster, Session-Fenster und benutzerdefinierte Fensterfunktionen. Flinks Windowing ist deutlich vielseitiger und effizienter — die bevorzugte Wahl bei komplexen Anforderungen.
Spark setzt auf den Catalyst Optimizer, der Transformationen und Abfragen optimiert, und integriert die Tungsten-Engine zur weiteren Performance-Steigerung. Flink verfügt über einen kostenbasierten Optimierer speziell für Batch-Aufgaben, der Ressourcen und Datencharakteristika bewertet, um den effizientesten Plan zu wählen. Zusätzlich beschleunigen pipelinebasierte Ausführung und Low-Latency-Scheduling die Verarbeitung. Die Wahl hängt vom Use Case ab, da beide unterschiedliche Stärken haben.
Spark erreicht Fehlertoleranz über Resilient Distributed Datasets (RDDs), unveränderliche, partitionierte Datenstrukturen, die bei Ausfällen schnell rekonstruiert werden können. Flink nutzt hingegen verteilte, snapshot-basierte Checkpoints, die den Anwendungszustand zu definierten Zeitpunkten sichern und so eine rasche Wiederherstellung mit minimalen Performanceeinbußen ermöglichen. Beide sind fehlertolerant, doch Flinks Ansatz führt meist zu schnellerer Recovery und geringerer Störung laufender Prozesse — ideal, wenn Ausfallzeiten kritisch sind.
Spark unterstützt Scala, Java, Python und R — attraktiv für Entwicklerinnen und Entwickler sowie Data Scientists dank breiter Kollaborationsmöglichkeiten und umfassender APIs. Flink unterstützt Java, Scala und Python mit intuitiven APIs, hat aber eingeschränktere Python-Fähigkeiten, was die Verbreitung in Data-Science-Teams bremsen kann. Sparks überlegener Python-Support macht es für datengetriebene Teams, die vorwiegend Python nutzen, besonders attraktiv.
Spark bringt ein vollständiges, gereiftes Ökosystem mit und integriert sich nahtlos in zahlreiche Big-Data-Tools wie Hadoop, Hive und Pig. Das macht Spark zur robusten Wahl für komplexe Datenlandschaften mit vielfältigen Toolchains. Flink bietet weniger Integrationen, glänzt jedoch bei der Anbindung an Apache Kafka. Aufgrund der umfassenderen und gereifteren Integrationen hat Spark insgesamt das stärkere Ökosystem.
Die folgende Tabelle fasst die wichtigsten Unterschiede zwischen Spark und Flink zusammen:
| Kategorien | Spark | Flink | Fazit |
|---|---|---|---|
| Datenverarbeitung | Batch-orientiertes Modell | Echtzeit-orientiertes Modell | Kommt darauf an |
| Performance | RDDs und Datenpartitionierung | Operator Chaining und Pipeline-Ausführung | Flink |
| Windowing | Zeitbasierte Funktionen | Event-Time, Sessions und benutzerdefinierte Funktionen | Flink |
| Optimierung | Catalyst Optimizer | Kostenbasierter Optimierer | Kommt darauf an |
| Fehlertoleranz | Über RDDs erreicht | Verteilte Snapshots | Flink |
| Sprach- und API-Support | Umfassende Unterstützung | Mehrere Sprachen, Python weniger ausgereift | Spark |
| Ökosystem | Vollständige Integration mit Big-Data-Tools | Integration mit einigen Tools, stark mit Kafka | Spark |
Das passende Datenverarbeitungs-Framework kann die Performance deiner Pipeline spürbar verbessern. Unter den verfügbaren Optionen stechen Apache Spark und Apache Flink als zwei leistungsstarke, vielseitige Werkzeuge mit jeweils eigenen Stärken hervor.
Spark eignet sich hervorragend für Batch-Verarbeitung und bietet eine Vielzahl an Tools, APIs und eine enge Integration mit anderen Big-Data-Technologien. Wenn du lernen willst, Spark mit Python zu nutzen, schau dir unseren Kurs Introduction to PySpark und das Tutorial Getting Started with Pyspark an. Flink überzeugt bei Echtzeit- und Streaming-Verarbeitung mit effizientem Zustandsmanagement, starken Windowing-Funktionen und niedriger Latenz.
Am Ende hängt die Wahl zwischen beiden Frameworks von den spezifischen Anforderungen deines Projekts ab. Um beide Tools wirklich zu verstehen, lies weiter und übe mit den folgenden Ressourcen.
Lerne mit DataCamp
Lernpfad
Kurs
Kurs