Apache Spark और Apache Flink दो ओपन-सोर्स डेटा प्रोसेसिंग फ़्रेमवर्क हैं जो बिग डेटा और एनालिटिक्स के लिए व्यापक रूप से उपयोग किए जाते हैं। दोनों ही शक्तिशाली टूल हैं जिनमें मजबूत डेटा प्रोसेसिंग क्षमताएँ हैं, लेकिन उनकी आर्किटेक्चर और प्रमुख कार्यप्रणालियाँ अलग हैं।
हम Spark और Flink की प्रमुख विशेषताओं का अन्वेषण करेंगे, खासकर प्रोसेसिंग मॉडल, डेटा एब्स्ट्रैक्शन, स्टेट मैनेजमेंट और परफ़ॉर्मेंस पर ध्यान केंद्रित करते हुए। हम यह भी देखेंगे कि प्रत्येक फ़्रेमवर्क बैच और रियल-टाइम डेटा प्रोसेसिंग को कैसे संभालता है। उनकी भिन्नताओं और समानताओं को समझना आपको अपनी आवश्यकताओं के लिए सही फ़्रेमवर्क चुनने में मदद करेगा।
डेटा प्रोसेसिंग फ़्रेमवर्क का महत्व
हम सभी जानते हैं कि उपलब्ध डेटा की मात्रा तेजी से बढ़ रही है। वे संगठन जो बिग डेटा का उपयोग करना चाहते हैं, उन्हें स्केलेबिलिटी और दक्षता से जुड़ी चुनौतियों का सामना करना पड़ सकता है।
डेटा प्रोसेसिंग फ़्रेमवर्क एक आवश्यक समाधान हैं क्योंकि वे टेराबाइट्स डेटा के साथ काम करते समय भी इन्जेस्टन, ट्रांसफ़ॉर्मेशन और स्टोरेज सहित विभिन्न डेटा ऑपरेशनों का समर्थन कर सकते हैं। वे टूल्स और API का व्यापक स्पेक्ट्रम प्रदान करते हैं, जो आपको बेसिक ऑपरेशनों से लेकर मशीन लर्निंग मॉडलिंग तक के कार्यों में लचीलापन देता है। अतिरिक्त रूप से, डेटा प्रोसेसिंग फ़्रेमवर्क जटिलता का एब्स्ट्रैक्शन देते हैं जो डेटा प्रोसेसिंग एप्लीकेशनों के विकास और डिबगिंग को सरल बनाता है।
सामान्य रूप से, डेटा प्रोसेसिंग फ़्रेमवर्क क्लस्टर में कई नोड्स पर वर्कलोड को वितरित करके काम करते हैं। कुछ फ़्रेमवर्क विशेष रूप से रियल-टाइम डेटा प्रोसेस करने के लिए बनाए गए हैं, जो आपको डेटा के आते ही उसका विश्लेषण करने में सक्षम बनाते हैं। अन्य फ़्रेमवर्क बैच डेटा प्रोसेसिंग के लिए अनुकूलित होते हैं, जो आपकी रेट्रोस्पेक्टिव विश्लेषण आवश्यकताओं के लिए उपयोगी है।
Apache Spark क्या है?
Apache Spark एक ओपन-सोर्स, वितरित कंप्यूटिंग फ़्रेमवर्क है जिसे बड़े पैमाने के डेटा को कुशलता और गति से संभालने के लिए डिज़ाइन किया गया है। यह इन-मेemory प्रोग्रामिंग मॉडल का उपयोग करता है, यानी यह क्लस्टर नोड्स की मुख्य मेमोरी में डेटा स्टोर कर सकता है, जिससे उन टूल्स की तुलना में प्रोसेसिंग काफी तेज हो जाती है जो अधिकतर डिस्क एक्सेस पर निर्भर करते हैं। इसका आसान इंटरफ़ेस आपको कई भाषाओं—जैसे Python और R, जो डेटा साइंस की प्रमुख भाषाएँ हैं—में उपलब्ध API सेट के माध्यम से जटिल डेटा ऑपरेशनों को निष्पादित करने देता है।
Apache Spark ऑपरेशनों को रेज़िलिएंट तरीके से निष्पादित कर सकता है, यानी यह क्लस्टर नोड्स में विफलताओं को सहन कर सकता है और स्वचालित रूप से रिकवर हो सकता है। यह शक्तिशाली सुविधा इसके घटक Resilient Distributed Dataset (RDD) की वजह से है, जो डेटा रिकॉर्ड्स को रखने वाली मूल इकाइयों का वितरित कलेक्शन है।
दूसरी ओर, Spark का एग्ज़ीक्यूशन मॉडल Directed Acyclic Graph (DAG) आपको अपने कार्यों के पैरेलल निष्पादन को ऑप्टिमाइज़ करने देता है। यह घटक Spark को उसी क्लस्टर के विभिन्न नोड्स में कार्यों को वितरित करने में सक्षम बनाता है, जिससे सभी उपलब्ध संसाधनों का पूरा लाभ उठाया जा सके।
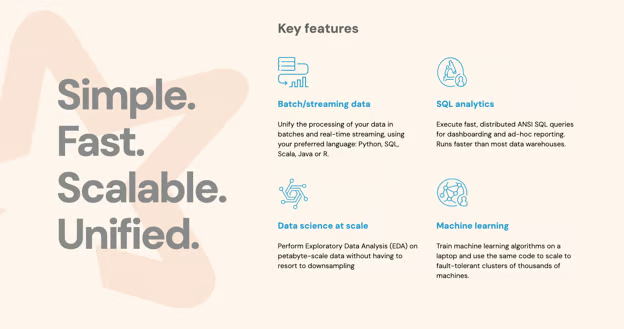 Apache Spark की मुख्य विशेषताएँ। Source
Apache Flink क्या है?
Apache Flink एक ओपन-सोर्स डेटा प्रोसेसिंग सिस्टम है, जो रियल-टाइम डेटा का विश्लेषण करने और बड़े डेटा को कम विलंबता और उच्च प्रदर्शन के साथ प्रोसेस करने में अलग नज़र आता है। उसी इंफ्रास्ट्रक्चर का उपयोग करके Apache Flink बैच डेटा भी प्रोसेस कर सकता है, जो वितरित प्रणालियों पर रियल-टाइम डेटा प्रोसेस करने वाली जटिल डेटा पाइपलाइनों के निर्माण और संचालन में बड़ा लाभ देता है। यह Python और R सहित कई भाषाओं में API सेट और विशेषित लाइब्रेरीज़ प्रदान करता है, जो आपको मशीन लर्निंग और इवेंट प्रोसेसिंग पाइपलाइन बनाने में मदद करते हैं।
Apache Flink आपके डेटा को इवेंट्स के सतत प्रवाह के रूप में मानता है, जो उन अनुप्रयोगों में उपयोगी है जहाँ डेटा लगातार प्राप्त और प्रोसेस किया जा रहा होता है। यह फ्लो-आधारित प्रोग्रामिंग मॉडल इवेंट्स पर कम विलंबता से प्रतिक्रिया देने की एक प्रमुख विशेषता है। साथ ही, आप Apache Flink के ऑपरेशनों का उपयोग करके जटिल और अत्यधिक अनुकूलित डेटा प्रोसेसिंग पाइपलाइन बना सकते हैं।
Flink रियल-टाइम डेटा प्रोसेसिंग अनुप्रयोगों में स्टेट का कुशलतापूर्वक प्रबंधन करता है। इसका अर्थ है कि आप डेटा आते ही अपनी एप्लीकेशनों की स्थिति को फॉल्ट टॉलरेंस के साथ बनाए रख और अपडेट कर सकते हैं।
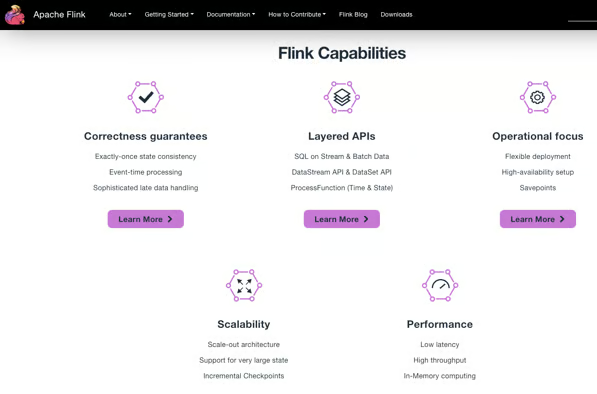 Flink की मुख्य विशेषताएँ। Source
Spark और Flink के बीच चयन करते समय प्रमुख विचार
उपयुक्त डेटा प्रोसेसिंग फ़्रेमवर्क की विशेषताओं का लाभ उठाने से आपकी डेटा पाइपलाइन के प्रदर्शन और दक्षता में सुधार हो सकता है। Spark और Flink की सभी विशेषताओं में से, कुछ प्रमुख बिंदु हैं जिनका आपको इन टूल्स में से चुनते समय मूल्यांकन करना चाहिए:
- डेटा प्रोसेसिंग मॉडल: क्या आप बैच या रियल-टाइम डेटा प्रोसेस और विश्लेषण कर रहे हैं?
- उपयोग में सरलता: क्या आपकी एप्लीकेशन को लचीले API चाहिए? आप कौन सी प्रोग्रामिंग भाषा का उपयोग कर रहे हैं?
- ईकोसिस्टम और संगतता: आप अपनी डेटा पाइपलाइन में किन अन्य टूल्स और तकनीकों को शामिल कर रहे हैं? अपनी इंफ्रास्ट्रक्चर में आप पहले से किन विशेष टूल्स और सेवाओं का उपयोग कर रहे हैं?
- परफ़ॉर्मेंस और स्टेट मैनेजमेंट: क्या आप संसाधन उपयोग को प्राथमिकता देते हैं? आपकी पाइपलाइन को किस प्रकार का वर्कलोड और क्लस्टर कॉन्फ़िगरेशन चाहिए? क्या आपकी एप्लीकेशन को जटिल स्टेट मैनिपुलेशन की आवश्यकता है?
Spark और Flink के बीच प्रमुख समानताएँ
हालाँकि Spark और Flink में कुछ भिन्न विशेषताएँ हैं, वे कई महत्वपूर्ण गुण साझा करते हैं। दोनों ही बड़े पैमाने के डेटा-प्रोसेसिंग कार्यों को कम विलंबता के साथ संभालने के लिए डिज़ाइन किए गए हैं। दोनों ही Python, Scala, Java और R सहित कई भाषाओं में API सेट प्रदान करते हैं और बड़े बिग डेटा टूल ईकोसिस्टम के साथ इंटीग्रेटेड हैं। इसके अलावा, Spark और Flink परफ़ॉर्मेंस ऑप्टिमाइज़ेशन लागू करते हैं।
आइए इन समानताओं में से प्रत्येक पर नज़र डालते हैं:
वितरित डेटा प्रोसेसिंग मॉडल
Apache Flink और Apache Spark कंप्यूटरों के क्लस्टर में बड़े पैमाने के डेटा को प्रोसेस करने के लिए डिज़ाइन किए गए हैं। यह सुविधा आपकी एप्लीकेशन को क्षैतिज रूप से स्केल करने देती है ताकि आप कई नोड्स में वर्कलोड के लिए संसाधनों को कम-विलंबता के साथ डायनेमिक रूप से अलॉट और डी-अलॉट करके विशाल डेटासेट्स को संभाल सकें। दोनों फ़्रेमवर्क बैच और स्ट्रीमिंग डेटा प्रोसेसिंग, दोनों को संभाल सकते हैं।
हाई-लेवल API
Spark और Flink दोनों कई भाषाओं—जैसे Scala, Python और Java—में लागू हाई-लेवल API और एब्स्ट्रैक्शंस प्रदान करते हैं, जो आपको अपनी पसंदीदा भाषा में पाइपलाइन लिखने और चलाने देते हैं। ये API डेटा प्रोसेसिंग एप्लीकेशनों के विकास को आसान बनाते हैं। इसके अलावा, Flink में मशीन लर्निंग (FlinkML), कॉम्प्लेक्स इवेंट प्रोसेसिंग (FlinkCEP) और ग्राफ़ प्रोसेसिंग (Gelly) के लिए लाइब्रेरीज़ शामिल हैं। Spark भी मशीन लर्निंग (MLlib), ग्राफ़ प्रोसेसिंग (GraphX) और रियल-टाइम डेटा प्रोसेसिंग (GraphX) के लिए लाइब्रेरीज़ प्रदान करता है।
बिग डेटा ईकोसिस्टम के साथ अच्छा इंटीग्रेशन
Apache Spark और Apache Flink दोनों ही Hadoop Distributed File System, Apache Kafka और Amazon S3 जैसे क्लाउड स्टोरेज सिस्टम सहित एक व्यापक बिग डेटा टूल ईकोसिस्टम के साथ इंटीग्रेटेड हैं।
परफ़ॉर्मेंस ऑप्टिमाइज़ेशन
दोनों फ़्रेमवर्क में परफ़ॉर्मेंस ऑप्टिमाइज़ेशन का कार्यान्वयन है जो डेटा प्रोसेसिंग में दक्षता को अधिकतम करता है। यह सुविधा आपको Spark और Flink के पैरेलल एग्ज़ीक्यूशन, टास्क प्लैनिंग और क्वेरी ऑप्टिमाइज़ेशन का लाभ उठाकर जटिल कार्यों को निष्पादित करने देती है। Spark Catalyst ऑप्टिमाइज़र का उपयोग करता है जबकि Flink में बैच प्रोसेसिंग के लिए कॉस्ट-बेस्ड ऑप्टिमाइज़र है।
प्रमुख अंतर: Spark बनाम Flink
Apache Spark और Apache Flink अपनी मूल क्षमताओं और डेटा प्रोसेसिंग दृष्टिकोणों के संदर्भ में कई समानताएँ साझा करते हैं। हालाँकि, उनके प्रोसेसिंग मॉडल की ताकतों और फोकस क्षेत्रों, उनके ईकोसिस्टम और भाषा समर्थन की परिपक्वता, और ऑप्टिमाइज़ेशन तथा स्टेटस मैनेजमेंट के दृष्टिकोण में उल्लेखनीय अंतर भी हैं।
डेटा प्रोसेसिंग मॉडल
Apache Flink मुख्य रूप से रियल-टाइम डेटा प्रोसेसिंग पर केंद्रित है। चूँकि यह फ़्रेमवर्क अपनी स्ट्रीमिंग रनटाइम पर बना है, यह बैच प्रोसेसिंग को भी संभाल सकता है। दूसरी ओर, Apache Spark मूल रूप से बैच प्रोसेसिंग के लिए डिज़ाइन किया गया था, जो इसे बड़े डेटासेट्स के रेट्रोस्पेक्टिव विश्लेषण के लिए अधिक उपयुक्त बनाता है। माइक्रो-बैच दृष्टिकोण लागू करके, Spark स्ट्रीमिंग डेटा भी प्रोसेस कर सकता है, लेकिन इसकी विलंबता Flink की तुलना में अधिक रहती है।
API और भाषा समर्थन
जैसा कि बताया गया है, दोनों फ़्रेमवर्क कई प्रोग्रामिंग भाषाओं में API प्रदान करते हैं। हालाँकि, Flink का Python समर्थन कम परिपक्व है, जो डेटा-साइंटिस्ट-केंद्रित टीम के साथ काम करने पर एक सीमा बन सकता है।
बिग डेटा ईकोसिस्टम की परिपक्वता
यद्यपि दोनों फ़्रेमवर्क का बिग डेटा टूल्स के साथ अच्छा इंटीग्रेशन है, Apache Spark का ईकोसिस्टम बड़ा और अधिक परिपक्व है, जिसमें कनेक्टर्स, लाइब्रेरीज़ और टूल्स की विविधता उपलब्ध है। Apache Flink उपलब्ध टूल्स और एक्सटेंशनों के सेट को बढ़ा रहा है, लेकिन इसे अब भी अपेक्षाकृत कम परिपक्व ईकोसिस्टम माना जा सकता है।
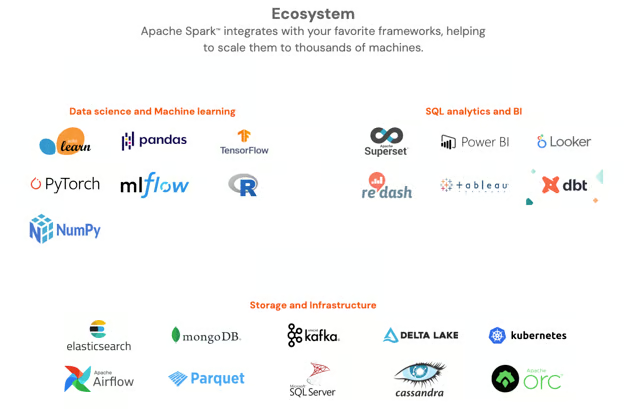
Apache Spark ईकोसिस्टम। Source
परफ़ॉर्मेंस और स्टेटस मैनेजमेंट
Apache Flink आपको अधिक उन्नत और लचीले स्टेटस मैनेजमेंट के साथ काम करने देता है, जो उन पाइपलाइनों में लाभ देता है जिन्हें रियल-टाइम में स्टेट बनाए रखने और अपडेट करने की आवश्यकता होती है, जैसे इवेंट-टाइम और प्रोसेसिंग-टाइम विंडोज़ प्रोसेसिंग या जटिल इवेंट पैटर्न को संभालने के लिए विंडोज़। Spark बेसिक विंडोइंग फ़ंक्शनैलिटी प्रदान करता है, जो बैच और माइक्रो-बैचिंग प्रोसेसिंग की आवश्यकता होने पर अच्छी तरह काम करती है।
Spark बनाम Flink: एक विस्तृत तुलना
Apache Flink और Apache Spark कई समानताएँ दिखाते हैं, लेकिन उनके प्रोसेसिंग दृष्टिकोण और उससे जुड़ी विलंबता, परफ़ॉर्मेंस और स्टेट मैनेजमेंट में पर्याप्त अंतर भी हैं। साथ ही, उनके ईकोसिस्टम की परिपक्वता और भाषा समर्थन में भी कुछ भिन्नताएँ हैं। आप कौन सा फ़्रेमवर्क चुनते हैं यह मुख्य रूप से आपके प्रोजेक्ट की विशिष्ट आवश्यकताओं पर निर्भर करेगा। फिर भी, कुछ विशेषताओं में Spark या Flink एक-दूसरे की तुलना में बेहतर साबित होते हैं:
डेटा प्रोसेसिंग
Spark मूल रूप से बैच प्रोसेसिंग के लिए डिज़ाइन किया गया था, लेकिन अब यह अपने Spark Streaming मॉड्यूल के माध्यम से स्ट्रीमिंग डेटा को भी सपोर्ट करता है। दूसरी ओर, Flink विशेष रूप से स्ट्रीमिंग डेटा के लिए विकसित किया गया था, लेकिन अब यह बैच प्रोसेसिंग का भी समर्थन करता है।
- विजेता: उपयोग-केस पर निर्भर। Spark स्ट्रीमिंग के लिए बेहतर है, और Flink बैच प्रोसेसिंग के लिए बेहतर है।
परफ़ॉर्मेंस
Spark पैरेलल प्रोसेसिंग को बढ़ावा देने और संसाधन उपयोग को ऑप्टिमाइज़ करने के लिए Resilient Distributed Datasets और डेटा पार्टिशनिंग तकनीकों का उपयोग करता है। Flink ऑपरेटर चेनिंग और पाइपलाइन एग्ज़ीक्यूशन का लाभ उठाता है, जिससे इसके पैरेलल प्रोसेसिंग और संसाधन प्रबंधन की दक्षता बढ़ती है। सामान्यतः, Flink को तेज़ माना जाता है और रियल-टाइम प्रोसेसिंग एप्लीकेशनों में बेहतर परफ़ॉर्मेंस प्रदान करता है।
- विजेता: कुल मिलाकर बेहतर परफ़ॉर्मेंस के कारण Flink।
विंडोइंग
Spark मुख्यतः समय-आधारित इम्प्लीमेंटेशनों के लिए उपयुक्त बेसिक विंडोइंग सुविधाएँ प्रदान करता है, जो बैच और स्ट्रीमिंग दोनों डेटा प्रोसेसिंग के लिए फिक्स्ड या स्लाइडिंग टाइम विंडोज़ में उपयुक्त बैठती हैं। Flink अधिक उन्नत विंडोइंग क्षमताएँ प्रदान करता है, जिनमें इवेंट-टाइम और प्रोसेसिंग-टाइम-आधारित विंडोज़, सेशन विंडोज़ और कस्टम विंडो फ़ंक्शंस शामिल हैं। Flink की विंडोइंग क्षमताएँ उल्लेखनीय रूप से अधिक बहुमुखी और दक्ष हैं, जो इसे जटिल आवश्यकताओं के लिए पसंदीदा बनाती हैं।
- विजेता: जटिल विंडोइंग आवश्यकताओं को संभालने में उच्च लचीलापन होने के कारण Flink।
ऑप्टिमाइज़ेशन
Spark Catalyst ऑप्टिमाइज़र का उपयोग करता है, जो डेटा ट्रांसफ़ॉर्मेशन और प्रोसेसिंग क्वेरीज़ को ऑप्टिमाइज़ करने में उत्कृष्ट है, और फ़्रेमवर्क के प्रदर्शन को बेहतर करने के लिए Tungsten एग्ज़ीक्यूशन इंजन को इंटीग्रेट करता है। Flink में विशेष रूप से बैच-प्रोसेसिंग कार्यों के लिए डिज़ाइन किया गया कॉस्ट-बेस्ड ऑप्टिमाइज़र है, जो उपलब्ध संसाधनों और डेटा की विशेषताओं का मूल्यांकन करके सबसे कुशल दृष्टिकोण चुनता है। इसके अलावा, Flink का पाइपलाइन-आधारित एग्ज़ीक्यूशन और लो-लेटेंसी शेड्यूलिंग डेटा प्रोसेसिंग गति को उल्लेखनीय रूप से सुधारते हैं। ऑप्टिमाइज़ेशन के लिए Spark और Flink के बीच चयन विशिष्ट उपयोग-केस पर निर्भर करता है, क्योंकि दोनों अलग-अलग लाभ प्रदान करते हैं।
- विजेता: केस पर निर्भर। जटिल डेटा कार्यों के लिए Spark उत्कृष्ट है। तेज़, बैच प्रोसेसिंग के लिए Flink बेहतर है।
फॉल्ट टॉलरेंस
Spark Resilient Distributed Datasets (RDDs) के उपयोग के माध्यम से फॉल्ट टॉलरेंस प्राप्त करता है, जो अपरिवर्तनीय, पार्टिशन किए गए डेटा स्ट्रक्चर हैं और विफलताओं की स्थिति में त्वरित पुनर्निर्माण की अनुमति देते हैं। दूसरी ओर, Flink वितरित स्नैपशॉट-आधारित दृष्टिकोण का उपयोग करता है, जो विशिष्ट चेकपॉइंट्स पर एप्लीकेशन की स्टेट कैप्चर करता है, जिससे न्यूनतम प्रदर्शन प्रभाव के साथ विफलताओं से तेज़ रिकवरी संभव होती है। जबकि दोनों फ़्रेमवर्क प्रभावी फॉल्ट टॉलरेंस प्रदान करते हैं, Flink की पद्धति आम तौर पर तेज़ रिकवरी समय और चल रही प्रक्रियाओं में कम बाधा उत्पन्न करती है, जो उन परिस्थितियों में इसे बेहतर विकल्प बनाती है जहाँ डाउनटाइम को न्यूनतम रखना महत्वपूर्ण है।
- विजेता: Flink, क्योंकि इसकी अधिक कुशल फॉल्ट-टॉलरेंस प्रणाली कम व्यवधान के साथ तेज़ रिकवरी सक्षम करती है।
भाषा समर्थन और API
Spark Scala, Java, Python और R सहित कई प्रोग्रामिंग भाषाओं का समर्थन करता है, जिससे यह डेवलपर्स और डेटा साइंटिस्ट्स दोनों के लिए अत्यंत आकर्षक बनता है, और इन भाषाओं के लिए व्यापक API सेट प्रदान करता है। Flink, यद्यपि Java, Scala और Python को सहज और उपयोगकर्ता-मित्र API के साथ सपोर्ट करता है, फिर भी Python क्षमताएँ अपेक्षाकृत सीमित हैं, जो डेटा साइंस टीमों में इसके अपनाव में बाधा बन सकती हैं। Spark का श्रेष्ठ Python समर्थन इसे उन डेटा-केंद्रित टीमों के लिए अधिक आकर्षक बनाता है जहाँ Python प्रमुख रूप से उपयोग होती है।
- विजेता: Spark, क्योंकि यह डेटा साइंस में व्यापक रूप से प्रयुक्त भाषा Python के लिए श्रेष्ठ समर्थन प्रदान करता है।
ईकोसिस्टम
Spark एक पूर्ण और परिपक्व ईकोसिस्टम का दावा करता है, जो Hadoop, Hive और Pig जैसे अनेक बिग डेटा टूल्स के साथ सहजता से इंटीग्रेट होता है। यह व्यापक संगतता Spark को उन जटिल डेटा परिवेशों के लिए मज़बूत विकल्प बनाती है जहाँ विविध टूलसेट्स की आवश्यकता होती है। Flink के अन्य बिग डेटा टूल्स के साथ इंटीग्रेशन अपेक्षाकृत सीमित हैं, यद्यपि यह Apache Kafka के साथ अपने इंटीग्रेशन में उत्कृष्ट है। अधिक व्यापक और परिपक्व इंटीग्रेशनों के कारण, Spark सामान्यतः अधिक सशक्त ईकोसिस्टम प्रस्तुत करता है।
- विजेता: Spark, क्योंकि इसका व्यापक और परिपक्व ईकोसिस्टम Hadoop, Hive और Pig जैसे अनेक बिग डेटा टूल्स के साथ सहज इंटीग्रेशन प्रदान करता है।
Flink बनाम Spark: एक सारांश
नीचे आप एक तालिका देख सकते हैं जो Spark और Flink के बीच प्रमुख अंतरों का सार प्रस्तुत करती है:
| Categories | Spark | Flink | Winner |
|---|
| Data Processing | Batch-oriented model | Real-time oriented model | Depends |
| Performance | RDDs and data partitioning | Operator chaining and pipeline execution | Flink |
| Windowing | Time-based functionalities | Event-time, session, and custom functions | Flink |
| Optimization | Catalyst optimizer | Cost-based optimizer | Depends |
| Fault Tolerance | Achieved by RDDs | Distributed snapshots | Flink |
| Language and API Support | Comprehensive support | Several languages, Python not advanced | Spark |
| Ecosystem | Full integration with big data tools | Integration with some tools, excels with Kafka | Spark |
अंतिम विचार
सबसे उपयुक्त डेटा प्रोसेसिंग फ़्रेमवर्क चुनना आपकी डेटा पाइपलाइन के प्रदर्शन को बेहतर बना सकता है। सभी फ़्रेमवर्क में, Apache Spark और Apache Flink अपनी विशिष्ट ताकतों और क्षमताओं के साथ दो शक्तिशाली और बहुमुखी टूल के रूप में सामने आते हैं।
Spark बैच प्रोसेसिंग के लिए बेहतरीन रूप से उपयुक्त है, और यह कई टूल्स, API, तथा अन्य बिग डेटा तकनीकों के साथ पूर्ण इंटीग्रेशन प्रदान करता है। यदि आप Python से Spark का उपयोग करना सीखना चाहते हैं, तो हमारा Introduction to PySpark कोर्स और हमारा Getting Started with Pyspark ट्यूटोरियल देखें। Flink रियल-टाइम और स्ट्रीमिंग डेटा प्रोसेसिंग में अलग दिखता है क्योंकि यह कुशल स्टेट मैनेजमेंट, विंडोइंग फ़ंक्शनैलिटी और कम-विलंबता प्रदर्शन प्रदान करता है।
आखिरकार, इन दोनों फ़्रेमवर्क के बीच चयन आपके प्रोजेक्ट-विशिष्ट आवश्यकताओं और जरूरतों पर निर्भर करेगा। इन टूल्स को अच्छी तरह समझने के लिए, पढ़ना जारी रखें और नीचे दिए गए संसाधनों का उपयोग करके अभ्यास करें।


Apache Spark और Apache Flink दो ओपन-सोर्स डेटा प्रोसेसिंग फ़्रेमवर्क हैं जो बिग डेटा और एनालिटिक्स के लिए व्यापक रूप से उपयोग किए जाते हैं। दोनों ही शक्तिशाली टूल हैं जिनमें मजबूत डेटा प्रोसेसिंग क्षमताएँ हैं, लेकिन उनकी आर्किटेक्चर और प्रमुख कार्यप्रणालियाँ अलग हैं।
हम Spark और Flink की प्रमुख विशेषताओं का अन्वेषण करेंगे, खासकर प्रोसेसिंग मॉडल, डेटा एब्स्ट्रैक्शन, स्टेट मैनेजमेंट और परफ़ॉर्मेंस पर ध्यान केंद्रित करते हुए। हम यह भी देखेंगे कि प्रत्येक फ़्रेमवर्क बैच और रियल-टाइम डेटा प्रोसेसिंग को कैसे संभालता है। उनकी भिन्नताओं और समानताओं को समझना आपको अपनी आवश्यकताओं के लिए सही फ़्रेमवर्क चुनने में मदद करेगा।
डेटा प्रोसेसिंग फ़्रेमवर्क का महत्व
हम सभी जानते हैं कि उपलब्ध डेटा की मात्रा तेजी से बढ़ रही है। वे संगठन जो बिग डेटा का उपयोग करना चाहते हैं, उन्हें स्केलेबिलिटी और दक्षता से जुड़ी चुनौतियों का सामना करना पड़ सकता है।
डेटा प्रोसेसिंग फ़्रेमवर्क एक आवश्यक समाधान हैं क्योंकि वे टेराबाइट्स डेटा के साथ काम करते समय भी इन्जेस्टन, ट्रांसफ़ॉर्मेशन और स्टोरेज सहित विभिन्न डेटा ऑपरेशनों का समर्थन कर सकते हैं। वे टूल्स और API का व्यापक स्पेक्ट्रम प्रदान करते हैं, जो आपको बेसिक ऑपरेशनों से लेकर मशीन लर्निंग मॉडलिंग तक के कार्यों में लचीलापन देता है। अतिरिक्त रूप से, डेटा प्रोसेसिंग फ़्रेमवर्क जटिलता का एब्स्ट्रैक्शन देते हैं जो डेटा प्रोसेसिंग एप्लीकेशनों के विकास और डिबगिंग को सरल बनाता है।
सामान्य रूप से, डेटा प्रोसेसिंग फ़्रेमवर्क क्लस्टर में कई नोड्स पर वर्कलोड को वितरित करके काम करते हैं। कुछ फ़्रेमवर्क विशेष रूप से रियल-टाइम डेटा प्रोसेस करने के लिए बनाए गए हैं, जो आपको डेटा के आते ही उसका विश्लेषण करने में सक्षम बनाते हैं। अन्य फ़्रेमवर्क बैच डेटा प्रोसेसिंग के लिए अनुकूलित होते हैं, जो आपकी रेट्रोस्पेक्टिव विश्लेषण आवश्यकताओं के लिए उपयोगी है।
Apache Spark क्या है?
Apache Spark एक ओपन-सोर्स, वितरित कंप्यूटिंग फ़्रेमवर्क है जिसे बड़े पैमाने के डेटा को कुशलता और गति से संभालने के लिए डिज़ाइन किया गया है। यह इन-मेemory प्रोग्रामिंग मॉडल का उपयोग करता है, यानी यह क्लस्टर नोड्स की मुख्य मेमोरी में डेटा स्टोर कर सकता है, जिससे उन टूल्स की तुलना में प्रोसेसिंग काफी तेज हो जाती है जो अधिकतर डिस्क एक्सेस पर निर्भर करते हैं। इसका आसान इंटरफ़ेस आपको कई भाषाओं—जैसे Python और R, जो डेटा साइंस की प्रमुख भाषाएँ हैं—में उपलब्ध API सेट के माध्यम से जटिल डेटा ऑपरेशनों को निष्पादित करने देता है।
Apache Spark ऑपरेशनों को रेज़िलिएंट तरीके से निष्पादित कर सकता है, यानी यह क्लस्टर नोड्स में विफलताओं को सहन कर सकता है और स्वचालित रूप से रिकवर हो सकता है। यह शक्तिशाली सुविधा इसके घटक Resilient Distributed Dataset (RDD) की वजह से है, जो डेटा रिकॉर्ड्स को रखने वाली मूल इकाइयों का वितरित कलेक्शन है।
दूसरी ओर, Spark का एग्ज़ीक्यूशन मॉडल Directed Acyclic Graph (DAG) आपको अपने कार्यों के पैरेलल निष्पादन को ऑप्टिमाइज़ करने देता है। यह घटक Spark को उसी क्लस्टर के विभिन्न नोड्स में कार्यों को वितरित करने में सक्षम बनाता है, जिससे सभी उपलब्ध संसाधनों का पूरा लाभ उठाया जा सके।
Apache Flink क्या है?
Apache Flink एक ओपन-सोर्स डेटा प्रोसेसिंग सिस्टम है, जो रियल-टाइम डेटा का विश्लेषण करने और बड़े डेटा को कम विलंबता और उच्च प्रदर्शन के साथ प्रोसेस करने में अलग नज़र आता है। उसी इंफ्रास्ट्रक्चर का उपयोग करके Apache Flink बैच डेटा भी प्रोसेस कर सकता है, जो वितरित प्रणालियों पर रियल-टाइम डेटा प्रोसेस करने वाली जटिल डेटा पाइपलाइनों के निर्माण और संचालन में बड़ा लाभ देता है। यह Python और R सहित कई भाषाओं में API सेट और विशेषित लाइब्रेरीज़ प्रदान करता है, जो आपको मशीन लर्निंग और इवेंट प्रोसेसिंग पाइपलाइन बनाने में मदद करते हैं।
Apache Flink आपके डेटा को इवेंट्स के सतत प्रवाह के रूप में मानता है, जो उन अनुप्रयोगों में उपयोगी है जहाँ डेटा लगातार प्राप्त और प्रोसेस किया जा रहा होता है। यह फ्लो-आधारित प्रोग्रामिंग मॉडल इवेंट्स पर कम विलंबता से प्रतिक्रिया देने की एक प्रमुख विशेषता है। साथ ही, आप Apache Flink के ऑपरेशनों का उपयोग करके जटिल और अत्यधिक अनुकूलित डेटा प्रोसेसिंग पाइपलाइन बना सकते हैं।
Flink रियल-टाइम डेटा प्रोसेसिंग अनुप्रयोगों में स्टेट का कुशलतापूर्वक प्रबंधन करता है। इसका अर्थ है कि आप डेटा आते ही अपनी एप्लीकेशनों की स्थिति को फॉल्ट टॉलरेंस के साथ बनाए रख और अपडेट कर सकते हैं।
Spark और Flink के बीच चयन करते समय प्रमुख विचार
उपयुक्त डेटा प्रोसेसिंग फ़्रेमवर्क की विशेषताओं का लाभ उठाने से आपकी डेटा पाइपलाइन के प्रदर्शन और दक्षता में सुधार हो सकता है। Spark और Flink की सभी विशेषताओं में से, कुछ प्रमुख बिंदु हैं जिनका आपको इन टूल्स में से चुनते समय मूल्यांकन करना चाहिए:
Spark और Flink के बीच प्रमुख समानताएँ
हालाँकि Spark और Flink में कुछ भिन्न विशेषताएँ हैं, वे कई महत्वपूर्ण गुण साझा करते हैं। दोनों ही बड़े पैमाने के डेटा-प्रोसेसिंग कार्यों को कम विलंबता के साथ संभालने के लिए डिज़ाइन किए गए हैं। दोनों ही Python, Scala, Java और R सहित कई भाषाओं में API सेट प्रदान करते हैं और बड़े बिग डेटा टूल ईकोसिस्टम के साथ इंटीग्रेटेड हैं। इसके अलावा, Spark और Flink परफ़ॉर्मेंस ऑप्टिमाइज़ेशन लागू करते हैं।
आइए इन समानताओं में से प्रत्येक पर नज़र डालते हैं:
वितरित डेटा प्रोसेसिंग मॉडल
Apache Flink और Apache Spark कंप्यूटरों के क्लस्टर में बड़े पैमाने के डेटा को प्रोसेस करने के लिए डिज़ाइन किए गए हैं। यह सुविधा आपकी एप्लीकेशन को क्षैतिज रूप से स्केल करने देती है ताकि आप कई नोड्स में वर्कलोड के लिए संसाधनों को कम-विलंबता के साथ डायनेमिक रूप से अलॉट और डी-अलॉट करके विशाल डेटासेट्स को संभाल सकें। दोनों फ़्रेमवर्क बैच और स्ट्रीमिंग डेटा प्रोसेसिंग, दोनों को संभाल सकते हैं।
हाई-लेवल API
Spark और Flink दोनों कई भाषाओं—जैसे Scala, Python और Java—में लागू हाई-लेवल API और एब्स्ट्रैक्शंस प्रदान करते हैं, जो आपको अपनी पसंदीदा भाषा में पाइपलाइन लिखने और चलाने देते हैं। ये API डेटा प्रोसेसिंग एप्लीकेशनों के विकास को आसान बनाते हैं। इसके अलावा, Flink में मशीन लर्निंग (FlinkML), कॉम्प्लेक्स इवेंट प्रोसेसिंग (FlinkCEP) और ग्राफ़ प्रोसेसिंग (Gelly) के लिए लाइब्रेरीज़ शामिल हैं। Spark भी मशीन लर्निंग (MLlib), ग्राफ़ प्रोसेसिंग (GraphX) और रियल-टाइम डेटा प्रोसेसिंग (GraphX) के लिए लाइब्रेरीज़ प्रदान करता है।
बिग डेटा ईकोसिस्टम के साथ अच्छा इंटीग्रेशन
Apache Spark और Apache Flink दोनों ही Hadoop Distributed File System, Apache Kafka और Amazon S3 जैसे क्लाउड स्टोरेज सिस्टम सहित एक व्यापक बिग डेटा टूल ईकोसिस्टम के साथ इंटीग्रेटेड हैं।
परफ़ॉर्मेंस ऑप्टिमाइज़ेशन
दोनों फ़्रेमवर्क में परफ़ॉर्मेंस ऑप्टिमाइज़ेशन का कार्यान्वयन है जो डेटा प्रोसेसिंग में दक्षता को अधिकतम करता है। यह सुविधा आपको Spark और Flink के पैरेलल एग्ज़ीक्यूशन, टास्क प्लैनिंग और क्वेरी ऑप्टिमाइज़ेशन का लाभ उठाकर जटिल कार्यों को निष्पादित करने देती है। Spark Catalyst ऑप्टिमाइज़र का उपयोग करता है जबकि Flink में बैच प्रोसेसिंग के लिए कॉस्ट-बेस्ड ऑप्टिमाइज़र है।
प्रमुख अंतर: Spark बनाम Flink
Apache Spark और Apache Flink अपनी मूल क्षमताओं और डेटा प्रोसेसिंग दृष्टिकोणों के संदर्भ में कई समानताएँ साझा करते हैं। हालाँकि, उनके प्रोसेसिंग मॉडल की ताकतों और फोकस क्षेत्रों, उनके ईकोसिस्टम और भाषा समर्थन की परिपक्वता, और ऑप्टिमाइज़ेशन तथा स्टेटस मैनेजमेंट के दृष्टिकोण में उल्लेखनीय अंतर भी हैं।
डेटा प्रोसेसिंग मॉडल
Apache Flink मुख्य रूप से रियल-टाइम डेटा प्रोसेसिंग पर केंद्रित है। चूँकि यह फ़्रेमवर्क अपनी स्ट्रीमिंग रनटाइम पर बना है, यह बैच प्रोसेसिंग को भी संभाल सकता है। दूसरी ओर, Apache Spark मूल रूप से बैच प्रोसेसिंग के लिए डिज़ाइन किया गया था, जो इसे बड़े डेटासेट्स के रेट्रोस्पेक्टिव विश्लेषण के लिए अधिक उपयुक्त बनाता है। माइक्रो-बैच दृष्टिकोण लागू करके, Spark स्ट्रीमिंग डेटा भी प्रोसेस कर सकता है, लेकिन इसकी विलंबता Flink की तुलना में अधिक रहती है।
API और भाषा समर्थन
जैसा कि बताया गया है, दोनों फ़्रेमवर्क कई प्रोग्रामिंग भाषाओं में API प्रदान करते हैं। हालाँकि, Flink का Python समर्थन कम परिपक्व है, जो डेटा-साइंटिस्ट-केंद्रित टीम के साथ काम करने पर एक सीमा बन सकता है।
बिग डेटा ईकोसिस्टम की परिपक्वता
यद्यपि दोनों फ़्रेमवर्क का बिग डेटा टूल्स के साथ अच्छा इंटीग्रेशन है, Apache Spark का ईकोसिस्टम बड़ा और अधिक परिपक्व है, जिसमें कनेक्टर्स, लाइब्रेरीज़ और टूल्स की विविधता उपलब्ध है। Apache Flink उपलब्ध टूल्स और एक्सटेंशनों के सेट को बढ़ा रहा है, लेकिन इसे अब भी अपेक्षाकृत कम परिपक्व ईकोसिस्टम माना जा सकता है।
Apache Spark ईकोसिस्टम। Source
परफ़ॉर्मेंस और स्टेटस मैनेजमेंट
Apache Flink आपको अधिक उन्नत और लचीले स्टेटस मैनेजमेंट के साथ काम करने देता है, जो उन पाइपलाइनों में लाभ देता है जिन्हें रियल-टाइम में स्टेट बनाए रखने और अपडेट करने की आवश्यकता होती है, जैसे इवेंट-टाइम और प्रोसेसिंग-टाइम विंडोज़ प्रोसेसिंग या जटिल इवेंट पैटर्न को संभालने के लिए विंडोज़। Spark बेसिक विंडोइंग फ़ंक्शनैलिटी प्रदान करता है, जो बैच और माइक्रो-बैचिंग प्रोसेसिंग की आवश्यकता होने पर अच्छी तरह काम करती है।
Spark बनाम Flink: एक विस्तृत तुलना
Apache Flink और Apache Spark कई समानताएँ दिखाते हैं, लेकिन उनके प्रोसेसिंग दृष्टिकोण और उससे जुड़ी विलंबता, परफ़ॉर्मेंस और स्टेट मैनेजमेंट में पर्याप्त अंतर भी हैं। साथ ही, उनके ईकोसिस्टम की परिपक्वता और भाषा समर्थन में भी कुछ भिन्नताएँ हैं। आप कौन सा फ़्रेमवर्क चुनते हैं यह मुख्य रूप से आपके प्रोजेक्ट की विशिष्ट आवश्यकताओं पर निर्भर करेगा। फिर भी, कुछ विशेषताओं में Spark या Flink एक-दूसरे की तुलना में बेहतर साबित होते हैं:
डेटा प्रोसेसिंग
Spark मूल रूप से बैच प्रोसेसिंग के लिए डिज़ाइन किया गया था, लेकिन अब यह अपने Spark Streaming मॉड्यूल के माध्यम से स्ट्रीमिंग डेटा को भी सपोर्ट करता है। दूसरी ओर, Flink विशेष रूप से स्ट्रीमिंग डेटा के लिए विकसित किया गया था, लेकिन अब यह बैच प्रोसेसिंग का भी समर्थन करता है।
परफ़ॉर्मेंस
Spark पैरेलल प्रोसेसिंग को बढ़ावा देने और संसाधन उपयोग को ऑप्टिमाइज़ करने के लिए Resilient Distributed Datasets और डेटा पार्टिशनिंग तकनीकों का उपयोग करता है। Flink ऑपरेटर चेनिंग और पाइपलाइन एग्ज़ीक्यूशन का लाभ उठाता है, जिससे इसके पैरेलल प्रोसेसिंग और संसाधन प्रबंधन की दक्षता बढ़ती है। सामान्यतः, Flink को तेज़ माना जाता है और रियल-टाइम प्रोसेसिंग एप्लीकेशनों में बेहतर परफ़ॉर्मेंस प्रदान करता है।
विंडोइंग
Spark मुख्यतः समय-आधारित इम्प्लीमेंटेशनों के लिए उपयुक्त बेसिक विंडोइंग सुविधाएँ प्रदान करता है, जो बैच और स्ट्रीमिंग दोनों डेटा प्रोसेसिंग के लिए फिक्स्ड या स्लाइडिंग टाइम विंडोज़ में उपयुक्त बैठती हैं। Flink अधिक उन्नत विंडोइंग क्षमताएँ प्रदान करता है, जिनमें इवेंट-टाइम और प्रोसेसिंग-टाइम-आधारित विंडोज़, सेशन विंडोज़ और कस्टम विंडो फ़ंक्शंस शामिल हैं। Flink की विंडोइंग क्षमताएँ उल्लेखनीय रूप से अधिक बहुमुखी और दक्ष हैं, जो इसे जटिल आवश्यकताओं के लिए पसंदीदा बनाती हैं।
ऑप्टिमाइज़ेशन
Spark Catalyst ऑप्टिमाइज़र का उपयोग करता है, जो डेटा ट्रांसफ़ॉर्मेशन और प्रोसेसिंग क्वेरीज़ को ऑप्टिमाइज़ करने में उत्कृष्ट है, और फ़्रेमवर्क के प्रदर्शन को बेहतर करने के लिए Tungsten एग्ज़ीक्यूशन इंजन को इंटीग्रेट करता है। Flink में विशेष रूप से बैच-प्रोसेसिंग कार्यों के लिए डिज़ाइन किया गया कॉस्ट-बेस्ड ऑप्टिमाइज़र है, जो उपलब्ध संसाधनों और डेटा की विशेषताओं का मूल्यांकन करके सबसे कुशल दृष्टिकोण चुनता है। इसके अलावा, Flink का पाइपलाइन-आधारित एग्ज़ीक्यूशन और लो-लेटेंसी शेड्यूलिंग डेटा प्रोसेसिंग गति को उल्लेखनीय रूप से सुधारते हैं। ऑप्टिमाइज़ेशन के लिए Spark और Flink के बीच चयन विशिष्ट उपयोग-केस पर निर्भर करता है, क्योंकि दोनों अलग-अलग लाभ प्रदान करते हैं।
फॉल्ट टॉलरेंस
Spark Resilient Distributed Datasets (RDDs) के उपयोग के माध्यम से फॉल्ट टॉलरेंस प्राप्त करता है, जो अपरिवर्तनीय, पार्टिशन किए गए डेटा स्ट्रक्चर हैं और विफलताओं की स्थिति में त्वरित पुनर्निर्माण की अनुमति देते हैं। दूसरी ओर, Flink वितरित स्नैपशॉट-आधारित दृष्टिकोण का उपयोग करता है, जो विशिष्ट चेकपॉइंट्स पर एप्लीकेशन की स्टेट कैप्चर करता है, जिससे न्यूनतम प्रदर्शन प्रभाव के साथ विफलताओं से तेज़ रिकवरी संभव होती है। जबकि दोनों फ़्रेमवर्क प्रभावी फॉल्ट टॉलरेंस प्रदान करते हैं, Flink की पद्धति आम तौर पर तेज़ रिकवरी समय और चल रही प्रक्रियाओं में कम बाधा उत्पन्न करती है, जो उन परिस्थितियों में इसे बेहतर विकल्प बनाती है जहाँ डाउनटाइम को न्यूनतम रखना महत्वपूर्ण है।
भाषा समर्थन और API
Spark Scala, Java, Python और R सहित कई प्रोग्रामिंग भाषाओं का समर्थन करता है, जिससे यह डेवलपर्स और डेटा साइंटिस्ट्स दोनों के लिए अत्यंत आकर्षक बनता है, और इन भाषाओं के लिए व्यापक API सेट प्रदान करता है। Flink, यद्यपि Java, Scala और Python को सहज और उपयोगकर्ता-मित्र API के साथ सपोर्ट करता है, फिर भी Python क्षमताएँ अपेक्षाकृत सीमित हैं, जो डेटा साइंस टीमों में इसके अपनाव में बाधा बन सकती हैं। Spark का श्रेष्ठ Python समर्थन इसे उन डेटा-केंद्रित टीमों के लिए अधिक आकर्षक बनाता है जहाँ Python प्रमुख रूप से उपयोग होती है।
ईकोसिस्टम
Spark एक पूर्ण और परिपक्व ईकोसिस्टम का दावा करता है, जो Hadoop, Hive और Pig जैसे अनेक बिग डेटा टूल्स के साथ सहजता से इंटीग्रेट होता है। यह व्यापक संगतता Spark को उन जटिल डेटा परिवेशों के लिए मज़बूत विकल्प बनाती है जहाँ विविध टूलसेट्स की आवश्यकता होती है। Flink के अन्य बिग डेटा टूल्स के साथ इंटीग्रेशन अपेक्षाकृत सीमित हैं, यद्यपि यह Apache Kafka के साथ अपने इंटीग्रेशन में उत्कृष्ट है। अधिक व्यापक और परिपक्व इंटीग्रेशनों के कारण, Spark सामान्यतः अधिक सशक्त ईकोसिस्टम प्रस्तुत करता है।
Flink बनाम Spark: एक सारांश
नीचे आप एक तालिका देख सकते हैं जो Spark और Flink के बीच प्रमुख अंतरों का सार प्रस्तुत करती है:
अंतिम विचार
सबसे उपयुक्त डेटा प्रोसेसिंग फ़्रेमवर्क चुनना आपकी डेटा पाइपलाइन के प्रदर्शन को बेहतर बना सकता है। सभी फ़्रेमवर्क में, Apache Spark और Apache Flink अपनी विशिष्ट ताकतों और क्षमताओं के साथ दो शक्तिशाली और बहुमुखी टूल के रूप में सामने आते हैं।
Spark बैच प्रोसेसिंग के लिए बेहतरीन रूप से उपयुक्त है, और यह कई टूल्स, API, तथा अन्य बिग डेटा तकनीकों के साथ पूर्ण इंटीग्रेशन प्रदान करता है। यदि आप Python से Spark का उपयोग करना सीखना चाहते हैं, तो हमारा Introduction to PySpark कोर्स और हमारा Getting Started with Pyspark ट्यूटोरियल देखें। Flink रियल-टाइम और स्ट्रीमिंग डेटा प्रोसेसिंग में अलग दिखता है क्योंकि यह कुशल स्टेट मैनेजमेंट, विंडोइंग फ़ंक्शनैलिटी और कम-विलंबता प्रदर्शन प्रदान करता है।
आखिरकार, इन दोनों फ़्रेमवर्क के बीच चयन आपके प्रोजेक्ट-विशिष्ट आवश्यकताओं और जरूरतों पर निर्भर करेगा। इन टूल्स को अच्छी तरह समझने के लिए, पढ़ना जारी रखें और नीचे दिए गए संसाधनों का उपयोग करके अभ्यास करें।