
Cursus
Artificial Intelligence begrijpen
2 uur
426.1K
Update: Sinds we dit artikel publiceerden, heeft OpenAI verschillende nieuwe modellen uitgebracht. Blijf op de hoogte en bekijk ook onze gidsen over GPT-5.4, GPT-5.3-Codex en GPT-5.3-Instant.
Het is nog maar een maand geleden dat GPT-5.1 werd gelanceerd. Maar een maand is lang in de AI-wereld. In de tussentijd bracht Google Gemini 3 uit, dat bovenaan eindigde op veel van de meest gevolgde benchmarktests, en lanceerde Antropic Claude Opus 4.5, dat opnieuw de koppositie innam op het gebied van software-engineering.
OpenAI wil zich graag profileren als het bedrijf dat het best in staat is zakelijke waarde te leveren. Maar na terugval op belangrijke ranglijsten vreesde het mogelijk gebruikers of zelfs enterprise-klanten te verliezen. Volgens berichten leidde die druk tot een “code rood” en zette het team aan om de release van GPT-5.2 te versnellen.
In dit artikel help ik je alles te begrijpen wat is aangekondigd bij de release van GPT-5.2, inclusief wat bedrijven te winnen hebben met de drie nieuwe modellen, die momenteel worden uitgerold in ChatGPT voor alle betalende gebruikers (en nu beschikbaar zijn in de API). Bekijk ook onze gids voor de ChatGPT Images-tool en voor de twee nieuwere modellen, GPT-5.3 Codex en GPT-5.2 Instant.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week uitlegt. Abonneer je en blijf scherp in slechts een paar minuten per week:
GPT-5.2 brengt gerichte verbeteringen in redeneren, geheugen en het gebruik van tools. In de bewoording van OpenAI vertalen deze verbeteringen zich in betere enterprise-workflows en minder faalmomenten tijdens je werk. Elk van de drie modellen in de serie kiest een andere aanpak om die waarde te leveren.
GPT-5.2 Instant geeft prioriteit aan lage latentie en snelle reactietijden. Het wordt gepositioneerd als het alledaagse werkpaard voor informatie opvragen, schrijven en vertalen. Het is het model waar de meeste mensen standaard mee werken, en het voordeel is doorvoersnelheid in plaats van diepgang. In de praktijk vult het het gat wanneer je snelle antwoorden of lichte automatisering nodig hebt zonder te betalen voor zwaardere redenering.
GPT-5.2 Thinking bevat uitgebreide redeneercapaciteiten waarmee het model complexe problemen stap voor stap kan doorwerken voordat het antwoordt.
Op OpenAI’s eigen benchmarks is dit het model dat nieuwe hoogtes haalt op kenniswerk, coderen en long-context-taken, vooral wanneer het tools kan gebruiken zoals spreadsheets en presentaties.
Het is OpenAI’s poging tot een general-purpose engine voor kenniswerk, en het is het model dat je kiest wanneer nauwkeurigheid verbetert door bewust nadenken. Voor veel organisaties wordt dit de keuze voor analyse, meerstaps-workflows en agentische taken.
Dit is het vlaggenschip, gebouwd met enterprise-klanten in gedachten.
Het is ook de duurste optie in het assortiment, omdat het gericht is op situaties met hoge inzet waarin incrementele verbeteringen in redeneerkwaliteit, feitelijke nauwkeurigheid en abstracte probleemoplossing de hogere kosten per token rechtvaardigen.
Pro is bedoeld voor omgevingen waar fouten kostbaar zijn, en waar teams een model nodig hebben dat samenhang kan bewaren over zeer lange contexten. Het is het model voor beslissingsondersteuning, complexe planning en elke workload waar betrouwbaarheid net zo belangrijk is als pure capaciteit.
GPT-5.2 wordt al uitgerold. OpenAI lanceerde het model officieel op 11 december 2025, waarbij betalende ChatGPT-abonnementen als eerste toegang kregen, en de beschikbaarheid geleidelijk uitbreidt over regio’s en platforms. Gebruikers kunnen alle drie de GPT-5.2-modellen rechtstreeks in ChatGPT gebruiken, en ontwikkelaars kunnen ze gebruiken via de OpenAI API via de Responses- en Chat Completions-endpoints.
De release van GPT 5.1 was opvallend licht op benchmarkresultaten omdat de focus lag op de gebruikerservaring. Het is dan ook geen verrassing dat GPT 5.2 probeert het roer om te gooien door meer op resultaten te focussen.
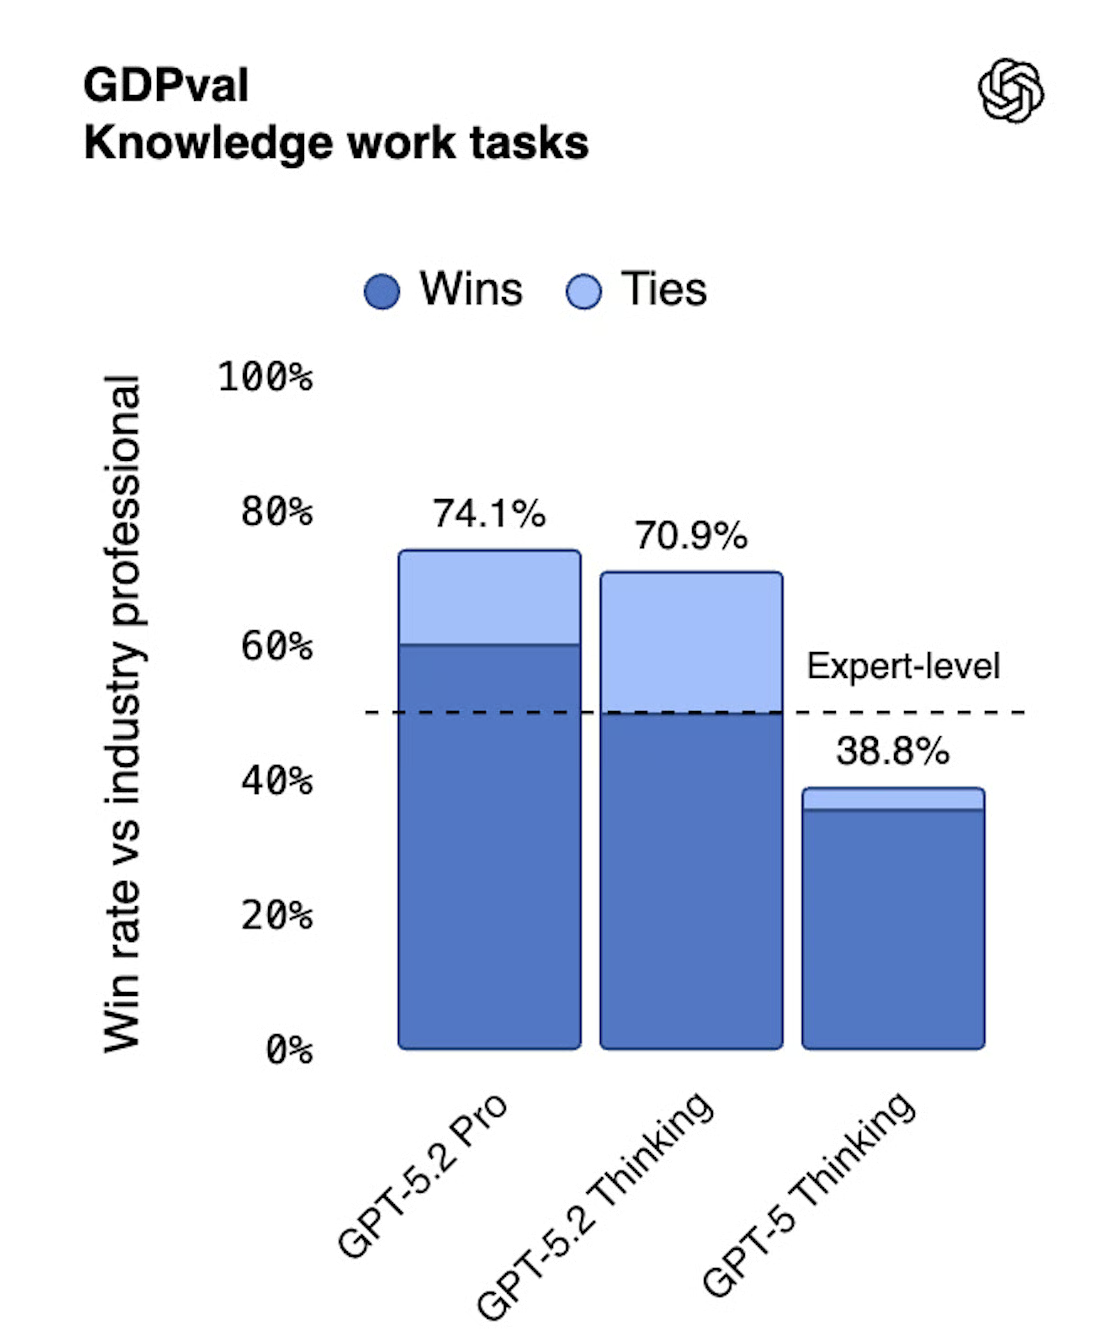
GDPval is de meest uitgelichte benchmark in de nieuwe release. Maar deze werd pas op arXiv geïntroduceerd in begin oktober 2025, dus het benadrukken van deze benchmark zegt veel over de aard van de release.
GDPval is een test van de taken die professionals dagelijks op hun werk uitvoeren, zoals het maken van rapporten en presentaties. De vragen zijn gekozen uit 44 beroepen in de negen belangrijkste sectoren die bijdragen aan het Amerikaanse bbp. Dat varieert van een verpleegkundige tot een data scientist en een universitair docent. De taken vereisen echte werkproducten, zoals spreadsheets, boekhoudkundige grootboeken, video’s en presentaties.
De op één na meest uitgelichte benchmark in deze release is SWE-Bench Pro, een lastige software-engineering-eval waarop GPT-5.2 55,6% scoorde. SWE-Bench Pro vereist het oplossen van langlopende issues uit echte repositories, problemen die dingen omvatten zoals meerdere bestandswijzigingen aanbrengen.
Je hebt misschien gehoord van SWE-bench Verified, een eenvoudigere versie van de test. Hierop scoorde GPT 5.2 80%. Ter context: we meldden onlangs dat Claude Opus 4.5 80,9% scoorde op deze test, dus de twee modellen zijn grofweg vergelijkbaar.
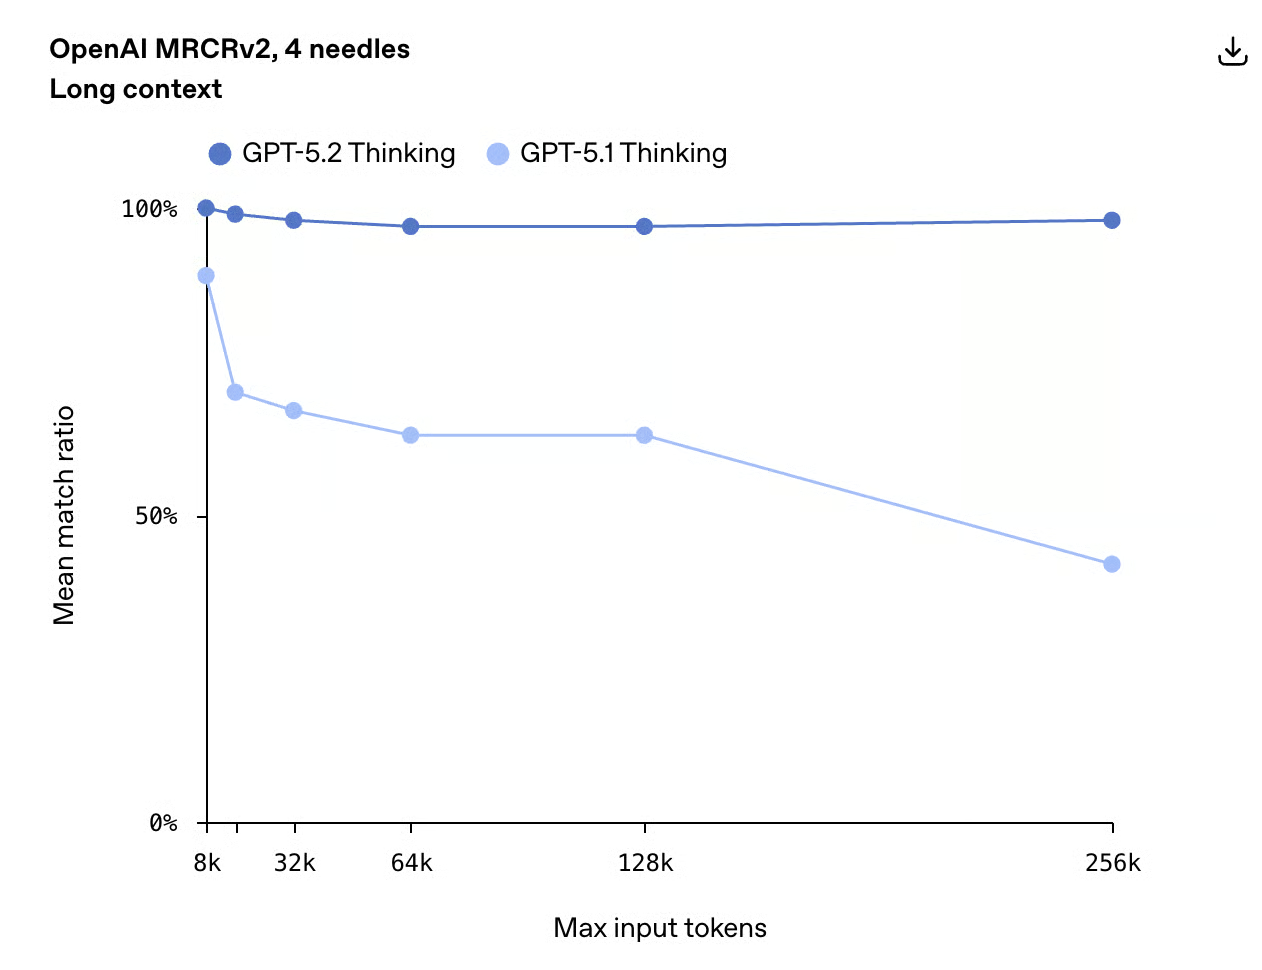
GPT 5.2 laat ook sterke prestaties zien op een andere benchmark, MRCR v2, wat staat voor Multi-Round Coreference Resolution (versie 2). Het scoort bijna perfect, wat OpenAI wil laten begrijpen als: we kunnen GPT 5.2 gebruiken voor lange documenten.
Het behaalt bijna perfecte nauwkeurigheid tot 256k tokens. Dat zijn zo’n tweehonderdduizend woorden, ruwweg de lengte van een roman.
OpenAI stelde vol vertrouwen dat GPT 5.2 grote verbeteringen brengt in intelligentie, long-context begrip, agentische tool-calling en visie, dus het is logisch om die elk op hun beurt te evalueren.
Om het long-context begrip van GPT-5.2 te testen, uploadde ik een online versie van J.M. Coetzee’s roman Disgrace. Vervolgens vroeg ik het model om een klein, makkelijk te vergeten detail diep in een lange passage.
Ik vroeg GPT-5.2 om antwoord op deze vraag:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 vond het juiste antwoord, ook al voelde het voor mij als een speld-in-een-hooibergdetail. Dit diner werd één keer genoemd in het boek en had geen echte narratieve relevantie.
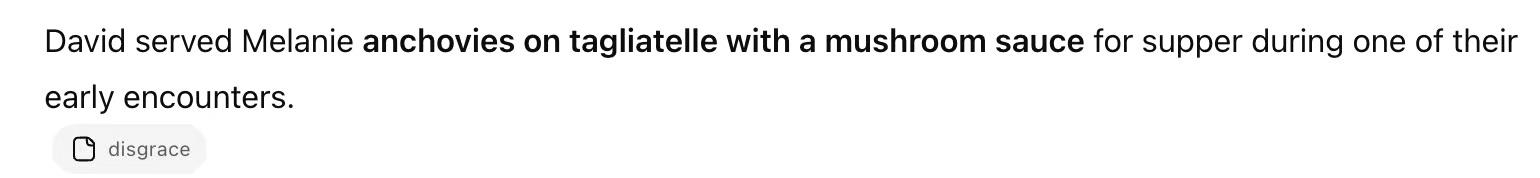
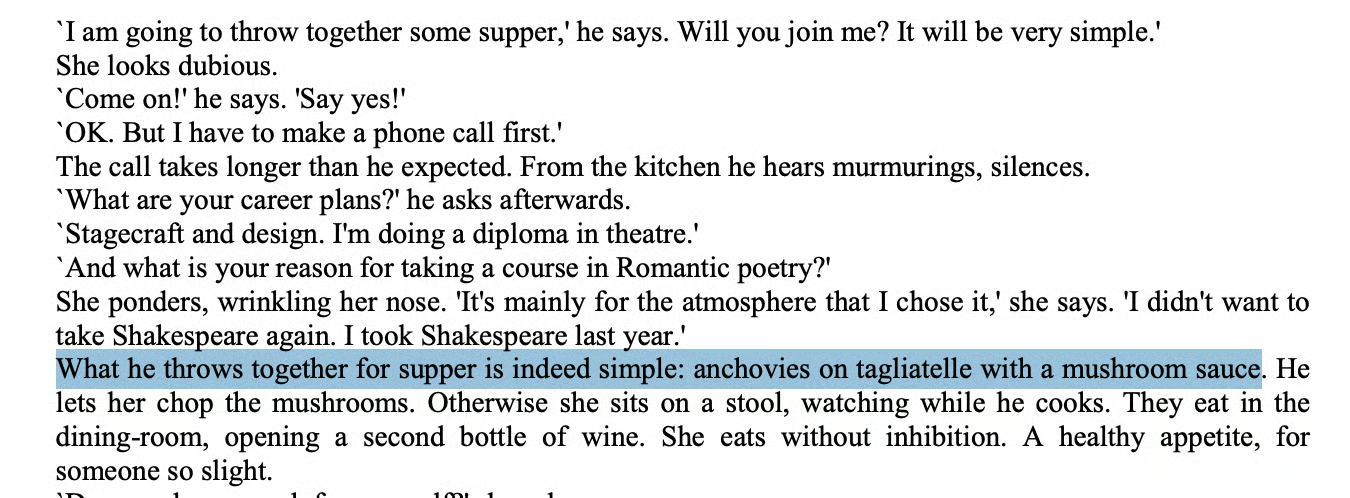
Deze test liet mij zien dat de retrieval van GPT-5.2 niet is gebaseerd op patroonraden, maar op echte retentie over een lange sequentie.
Dit soort retentie is belangrijk omdat echte long-context prestaties draaien om het behouden van gedetailleerde state over grote lappen tekst. Als een model een vluchtig dinerrecept onthoudt dat diep in een verhaal van 90 pagina’s begraven zit, kan het ook variabelen in een codebase, clausules in een contract of financiële details in een rapport van 200 pagina’s bijhouden.
Om de agentische capaciteiten van GPT-5.2 te testen, gaf ik het een taak die navigeren en klikken vereist. Ik vroeg het zich te gedragen als een autonome makelaar voor huurappartementen. Deze mogelijkheid is handig voor mensen die willen verhuizen maar te druk zijn om zelf huursites af te struinen.
Het model moest een browser gebruiken, filters toepassen, doorklikken naar listings, details extraheren en een vergelijkingsrapport samenstellen.
Dit was in essentie de prompt:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
Deze opzet was bedoeld om long-horizon redeneren, tool-calling en UI-interactie in één keer te testen.
GPT-5.2 navigeerde naar een woningsite, stelde de filters in en werkte de resultaten zelfstandig door. Het klikte door naar afzonderlijke woningen, haalde gestructureerde velden op, koos zowel een wijk als een prijsklasse (ik had die filters zelf kunnen vragen, maar ik ben niet echt van plan te verhuizen) en stelde vervolgens een kleine, gerangschikte shortlist samen.
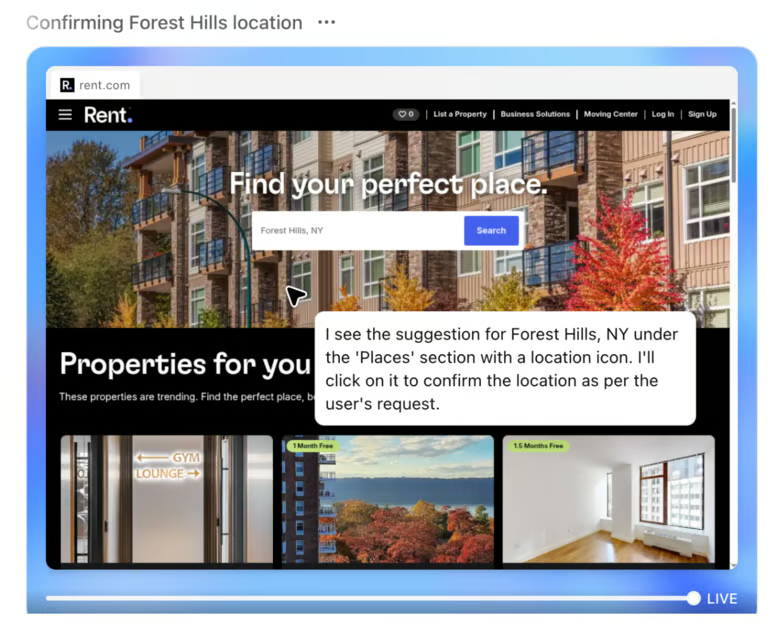
Ik weet zeker dat het onderzoek niet perfect was. In de trace van het model zag ik dat sommige sites scraping blokkeerden, maar de agent herstelde door van site te wisselen en leverde uiteindelijk toch een bruikbare set aanbevelingen.
Eén ding dat me opviel in de eindtabel was dat het model me geen echte URL’s gaf; in plaats daarvan waren het verwijzingen in screenshot-stijl. Dat komt omdat de meeste huursites geautomatiseerde toegang blokkeren en de browsingtool de daadwerkelijke links niet mag extraheren of delen. In dat geval voegt het gewoon een verwijzing in naar de screenshot die het in de sandbox heeft vastgelegd. Dat was dus een beetje irritant.
Ik wilde zien hoe ver deze agentische mogelijkheden reiken in een domein met veel minder schone databronnen, dus probeerde ik een tweede experiment in genealogie.
Ik vroeg GPT-5.2 te onderzoeken of leden van de familie Waples voorkomen in Engelse parochieregisters en of er een historische of genealogische link met Herefordshire zou kunnen zijn.
GPT-5.2 ondernam specifieke acties, zoals een gratis genealogiesite openen en door pagina’s klikken om records te vinden en downloaden.
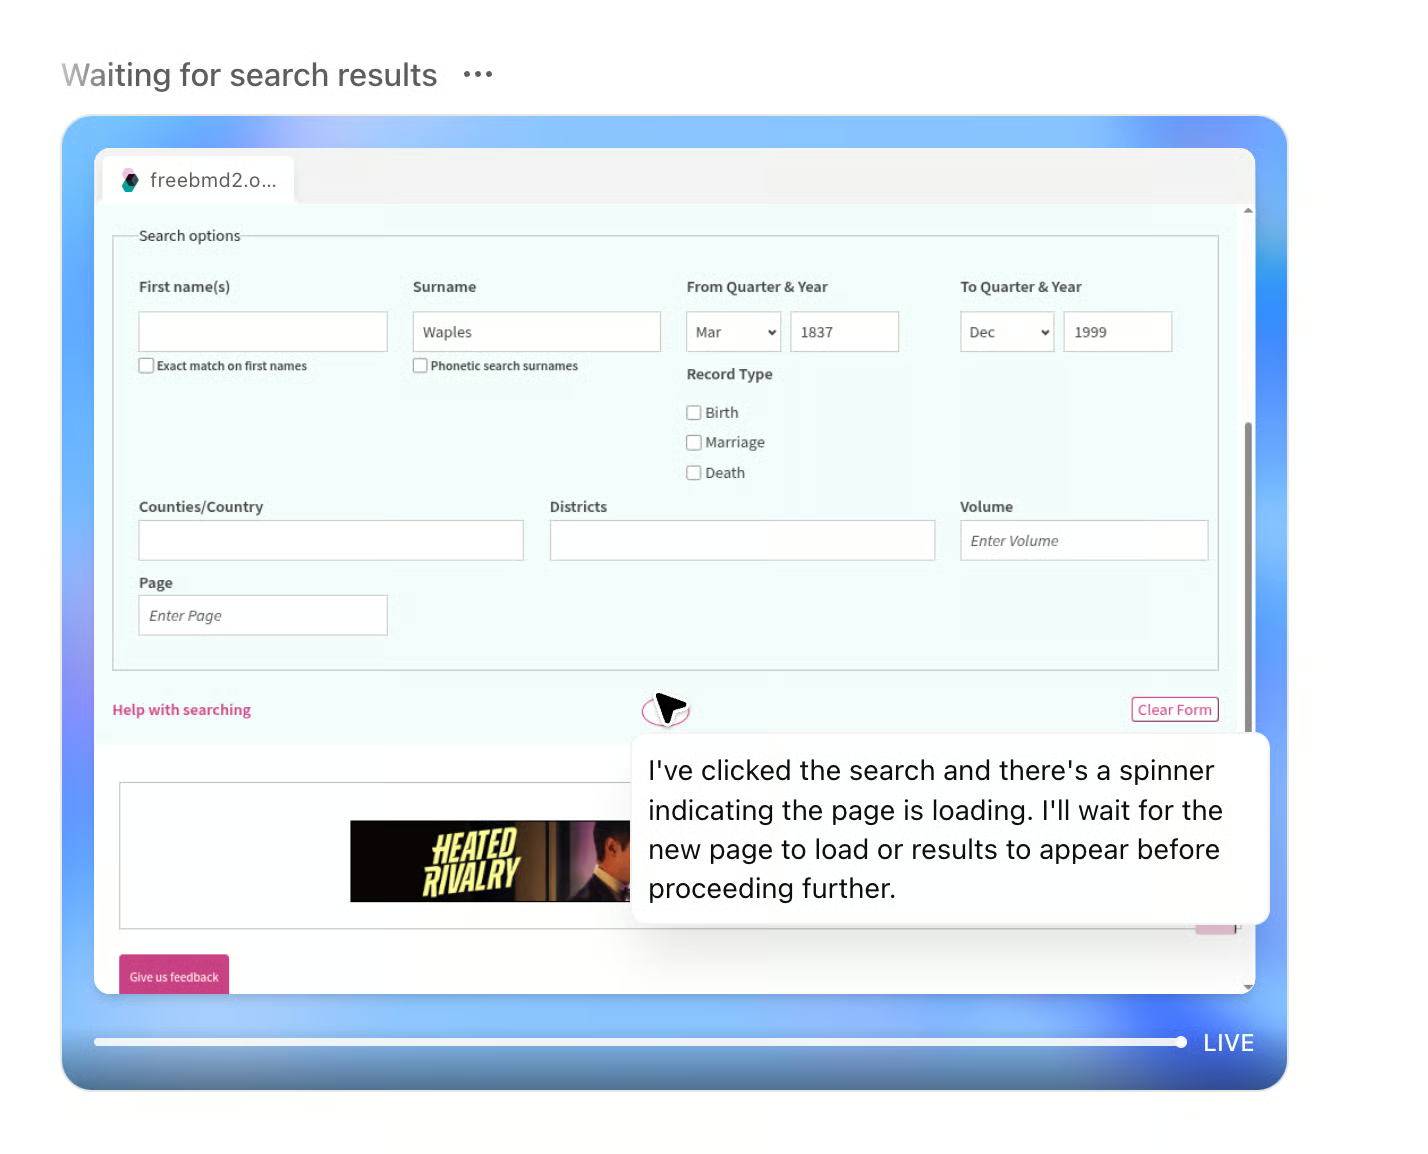
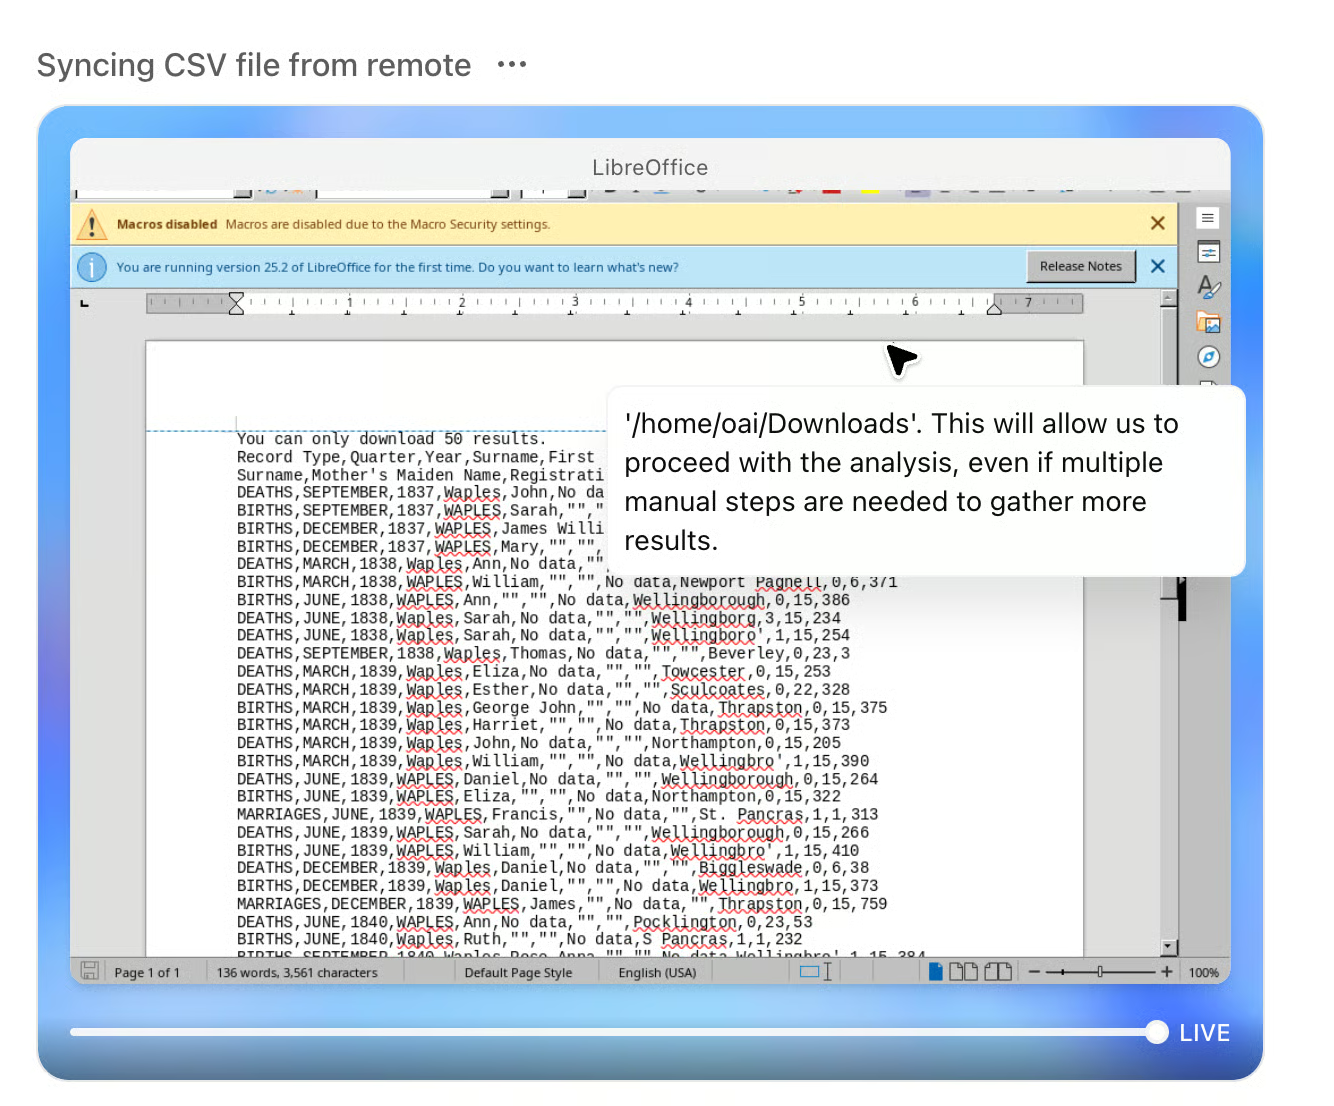
Het model brak het probleem op in subtaken, voerde zoekopdrachten uit in bronnen zoals FreeBMD en Forebears, en stelde zelfs een gerichte aanvraagmail op om niet-gedigitaliseerde records na te jagen.
Tegelijkertijd leerde ik dat genealogie als onderzoeksdomein harde grenzen kent. Veel van de belangrijkste bronnen, zoals parochieregisters of presentment rolls, bestaan alleen in archieven of achter beperkte catalogi. FreeBMD hanteert een downloadlimiet van 50 records, de catalogus van HARC is niet toegankelijk zonder sessiecookies, en historisch relevante documenten worden in de praktijk via betaalde onderzoeksdiensten verkregen.
Het model kan deze barrières herkennen en vervolgstappen voorstellen, maar ze niet doorbreken. Deze test leverde niets heel nuttigs op, maar dat lag niet aan het model.
Dit alles laat zien waarom OpenAI zich richt op zakelijke use-cases, want daar ligt de kans. Maar het herinnert er ook aan dat veel data nog offline, gefragmenteerd, achter een paywall of achter echte deuren zit.
Voor mijn laatste test uploadde ik een sudoku als test van zowel visie als algemene intelligentie.
Sudoku is op zich geen zware wiskunde omdat het begrensd is. Maar als de puzzel als afbeelding en niet als gestructureerde tekst wordt getoond, moet het model meerdere vaardigheden tegelijk gebruiken: het raster lezen, de “givens” behouden en vervolgens logica toepassen om het op te lossen.
can you fill out this sudoku for meDe afbeelding was niet perfect getekend, maar dat was onderdeel van de test:
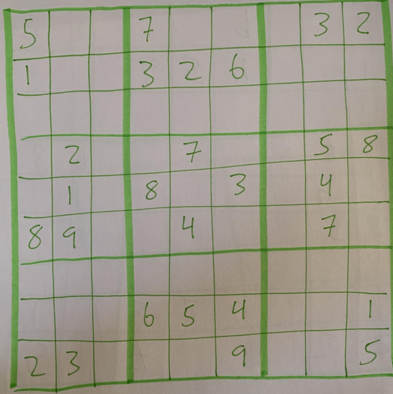
GPT-5.2 gaf mij een juiste puzzel, maar verving minstens één van de hardgecodeerde cijfers die niet mochten worden aangepast. Je zou kunnen zeggen dat het onbedoeld heeft “gesjoemeld”.
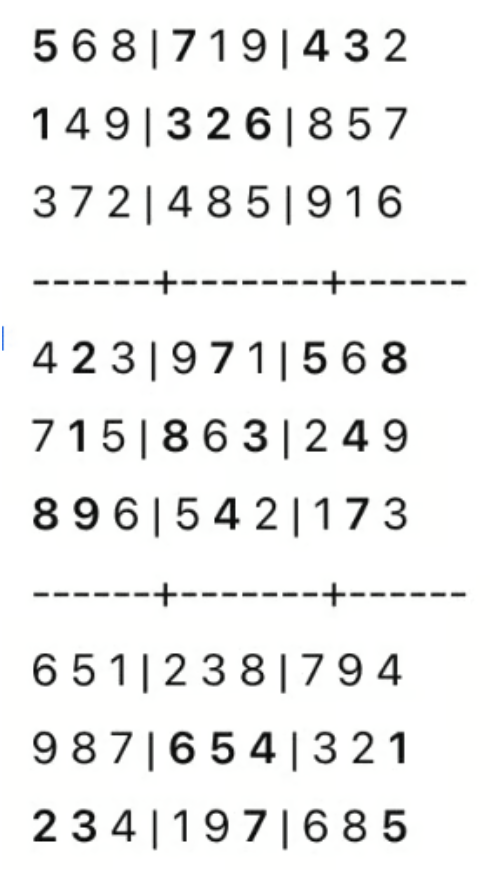
Dit soort fout is geen mislukking in redeneren. Het is eerder een hapering in visie en getrouwheid. Het model las ofwel een gegeven cel verkeerd, begreep niet welke posities vaststonden, of raakte de constraints kwijt bij het omzetten van de afbeelding naar een intern raster.
De tests hierboven laten zien wat je in ChatGPT kunt doen, maar de echte flexibiliteit komt via de API, waar je zelf de redeneerinspanning, tokenbudgetten en toolintegraties beheert.
Alle drie de modellen zijn nu beschikbaar via OpenAI's Responses API en Chat Completions API:
|
Model |
API-modelstring |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
Hier zijn de prijzen:
Twee aanvullingen voor power users: een 1xhigh1-instelling voor redeneerinspanning en een /compact endpoint dat het effectieve contextvenster voor langlopende workflows vergroot.
Laten we kijken hoe GPT-5.2 zich verhoudt tot andere recente releases:
Gemini 3, uitgebracht medio november, verpulverde de scores op veel van de meest gevolgde benchmarktests. Het staat bovenaan op Humanity’s Last Exam, en het verslaat ook GPT-5.2 Pro op GPQA Diamond, maar nipt (93,8% vs. 93,2%).
De grote prestatieverbetering van Gemini weerspiegelt waarschijnlijk verbeteringen in zowel de mixture-of-experts-implementatie als de trainingsinfrastructuur. Gemini 3 gebruikt sparse routing op tokenniveau en is getraind op Google’s aangepaste TPU-infrastructuur. Waar GPT-5.2 nu goed scoort, is op professionele werkbenchmarks zoals GDPval en enterprise tool-calling-evals. Daar heeft OpenAI duidelijk de nadruk op gelegd.
Claude Opus 4.5, uitgebracht eind november, koos een andere weg. Anthropic focuste op wat zij “hybride redeneren” noemen—uitgebreid denken combineren met een sterkere basisintelligentie—en het resultaat is een model dat uitblinkt in software-engineering en open taken. Op SWE-bench Verified scoort Opus 4.5 80,9%, net iets boven de 80% van GPT-5.2.
Waar de modellen uiteenlopen is in stijl: Opus 4.5 neigt naar langere, meer beschouwende antwoorden, terwijl GPT-5.2 Thinking inzet op toolgebruik en gestructureerde outputs zoals spreadsheets en presentaties. Voor codeeragents en complexe refactors liggen ze praktisch nek-aan-nek; voor enterprise-workflows met slides en rapporten gokt OpenAI dat GPT-5.2 het voordeel heeft.
Er is veel aandacht voor GPT-benchmarkresultaten, en er zal bij OpenAI veel druk zijn om te leveren. Een maand geleden werd de release van GPT 5.1 overschaduwd door Gemini 3. Nu, bij de release van GPT 5.2, eindigt OpenAI nipt als tweede achter Gemini 3 op GPQA en nipt als tweede achter Claude Opus 4.5 op SWE-Bench Verified—dat moet frustrerend zijn voor het team.
OpenAI benadrukt in plaats daarvan de hoge prestaties op GDPval en SWE-Bench Pro, maar vooral de eerste test is obscuur vergeleken met de industriestandaarden die de krantenkoppen halen. Je zou kunnen denken dat OpenAI een winnend verhaal wil vertellen zonder aandacht te vestigen op de ranglijsten waarop het momenteel verliest.
Maar de race is extreem spannend, en deze bedrijven hebben nog veel ruimte om zich te bewijzen. Eén ding waar we in het bijzonder op zullen letten, is hoe nieuwe modellen presteren op de aankomende ARC-AGI-3-benchmark, die in ontwikkeling is.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

