
कोर्स
Understanding Artificial Intelligence
2 घंटा
427.3K
अपडेट: इस लेख के प्रकाशित होने के बाद से, OpenAI ने कई नए मॉडल जारी किए हैं। अपडेट रहने के लिए, हमारे GPT-5.4, GPT-5.3-Codex, और GPT-5.3-Instant के गाइड भी देखें।
हमें GPT-5.1 के लॉन्च को देखे हुए अभी सिर्फ एक महीना हुआ है। लेकिन AI की दुनिया में एक महीना लंबा समय होता है। इसी बीच, Google ने Gemini 3 जारी किया, जिसने कई चर्चित बेंचमार्क परीक्षणों में शीर्ष स्थान हासिल किया, और Antropic ने Claude Opus 4.5 जारी किया, जिसने एक बार फिर सॉफ्टवेयर इंजीनियरिंग में लीडरबोर्ड में शीर्ष स्थान पाया।
OpenAI खुद को ऐसा कंपनी दिखाना चाहता है जो व्यावसायिक मूल्य देने में सबसे सक्षम है। लेकिन प्रमुख लीडरबोर्ड पर फिसलने के बाद, उसे उपयोगकर्ता या यहां तक कि एंटरप्राइज़ क्लाइंट खोने का डर रहा होगा। रिपोर्टों के अनुसार, उसी दबाव ने एक “कोड रेड” ट्रिगर किया और टीम को GPT-5.2 का रिलीज़ तेज़ करने के लिए प्रेरित किया।
इस लेख में, मैं आपको GPT-5.2 की रिलीज़ के साथ घोषित हर चीज़ को समझने में मदद करूंगा—कंपनियों को तीन नए मॉडलों से क्या मिल सकता है, जो वर्तमान में सभी पेड उपयोगकर्ताओं के लिए ChatGPT में रोलआउट हो रहे हैं (और अब API में उपलब्ध हैं)। आप हमारा ChatGPT Images टूल गाइड और दो नए मॉडलों, GPT-5.3 Codex और GPT-5.2 Instant, भी देख सकते हैं।
हम अपने पाठकों को The Median—हमारा निःशुल्क शुक्रवार न्यूज़लेटर—भेजकर AI की ताज़ा ख़बरों से अपडेट रखते हैं, जो हफ्ते की प्रमुख कहानियों का संक्षिप्त विश्लेषण करता है। सब्सक्राइब करें और हफ्ते में बस कुछ मिनटों में अपडेट रहें:
GPT-5.2 तर्क, मेमोरी, और टूल उपयोग में विशिष्ट और लक्षित सुधार लाता है। OpenAI के अनुसार, ये सुधार एंटरप्राइज़ वर्कफ़्लो को बेहतर बनाते हैं और आपके काम के दौरान फेल्योर पॉइंट्स को कम करते हैं। सीरीज़ के तीनों मॉडल इस मूल्य को देने के लिए अलग-अलग दृष्टिकोण अपनाते हैं।
GPT-5.2 Instant कम विलंबता और तेज़ प्रतिक्रिया समय को प्राथमिकता देता है। इसे रोज़मर्रा के जानकारी प्राप्ति, ड्राफ्टिंग, और अनुवाद के काम के लिए भरोसेमंद मॉडल के रूप में पेश किया गया है। अधिकतर लोग डिफ़ॉल्ट रूप से इसी मॉडल से इंटरैक्ट करेंगे, और इसका लाभ गहराई से अधिक थ्रूपुट है। व्यावहारिक तौर पर, जब आपको तेज़ उत्तर या हल्की ऑटोमेशन की ज़रूरत हो और भारी तर्क के लिए भुगतान न करना हो, तब यह गैप भरता है।
GPT-5.2 Thinking विस्तारित तर्क क्षमताओं को शामिल करता है, जो मॉडल को उत्तर देने से पहले जटिल समस्याओं पर चरण-दर-चरण काम करने देता है।
OpenAI के अपने बेंचमार्क पर, यह वह मॉडल है जो नॉलेज-वर्क, कोडिंग, और लंबे संदर्भ वाले कार्यों में नए उच्च स्तर तय करता है, खासकर जब यह स्प्रेडशीट और प्रेज़ेंटेशन जैसे टूल का उपयोग कर सकता है।
यह OpenAI का सामान्य-उद्देश्यीय नॉलेज-वर्क इंजन है, और वह मॉडल जिसे आप तब चुनते हैं जब सोची-समझी प्रक्रिया से सटीकता बढ़ती है। कई संगठनों के लिए, विश्लेषण, मल्टी-स्टेप वर्कफ़्लोज़, और एजेण्ट-आधारित कार्यों के लिए यही पसंद होगा।
यह फ़्लैगशिप है, और इसे एंटरप्राइज़ ग्राहकों को ध्यान में रखकर बनाया गया है।
यह लाइनअप का सबसे महंगा विकल्प भी है क्योंकि इसे हाई-स्टेक्स परिदृश्यों के लिए लक्षित किया गया है, जहां तर्क की गुणवत्ता, तथ्यात्मक सटीकता, और अमूर्त समस्या-समाधान में क्रमिक बढ़तें ऊंचे प्रति-टोकन लागत को जायज़ ठहराती हैं।
Pro उन वातावरणों के लिए है जहां गलतियाँ महंगी पड़ती हैं, और जहां टीमों को बहुत लंबे संदर्भों में सुसंगतता बनाए रखने वाला मॉडल चाहिए। यह निर्णय-सहायता प्रणालियों, जटिल योजना, और ऐसे किसी भी वर्कलोड में काम आ सकता है जहां विश्वसनीयता, कच्ची क्षमता जितनी ही महत्वपूर्ण हो।
GPT-5.2 पहले से ही रोलआउट हो रहा है। OpenAI ने 11 दिसंबर, 2025 को मॉडल को आधिकारिक रूप से लॉन्च किया, जिसमें पेड ChatGPT प्लान्स को पहले एक्सेस मिला, और उपलब्धता क्षेत्रों और प्लेटफ़ॉर्म्स पर लगातार विस्तार कर रही है। उपयोगकर्ता तीनों GPT-5.2 मॉडल सीधे ChatGPT में एक्सेस कर सकते हैं, और डेवलपर्स OpenAI API के Responses और Chat Completions एंडपॉइंट्स के माध्यम से इनका उपयोग कर सकते हैं।
GPT 5.1 का रिलीज़ बेंचमार्क परिणामों पर अपेक्षाकृत हल्का था क्योंकि उसका फोकस उपयोगकर्ता अनुभव पर था। इसलिए यह आश्चर्य की बात नहीं कि GPT 5.2 अब परिणामों पर अधिक फोकस करके चीज़ों को संतुलित करने की कोशिश कर रहा है।
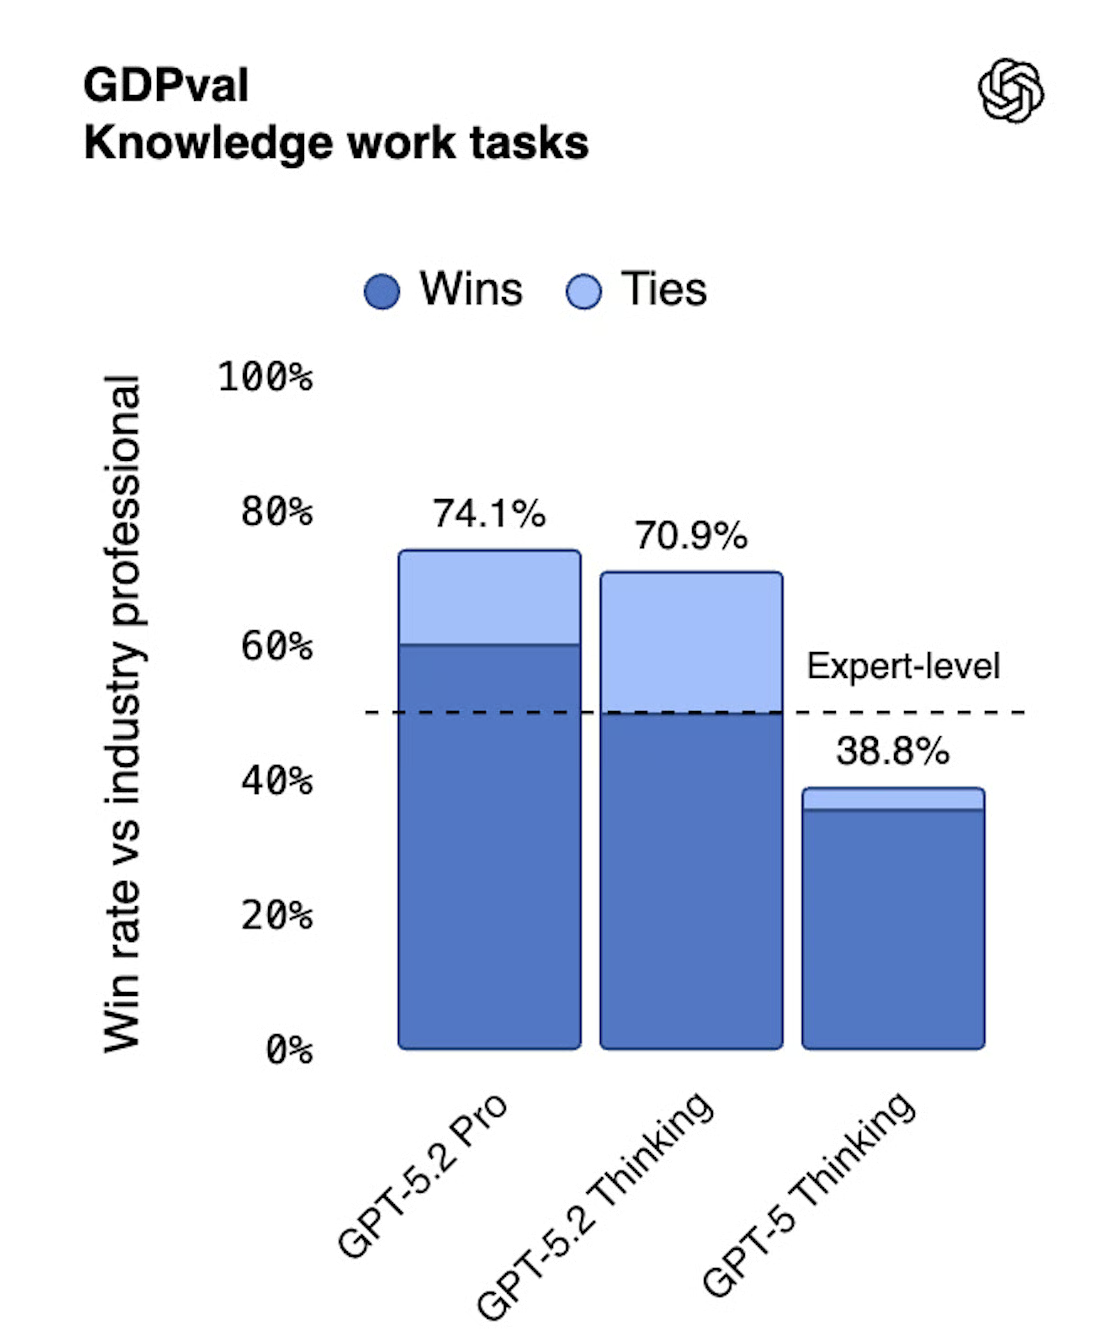
GDPval इस नए रिलीज़ में सबसे ज्यादा हाइलाइट किया गया बेंचमार्क है। लेकिन इसे अक्टूबर 2025 की शुरुआत में arxiv पर ही पेश किया गया था, इसलिए इस बेंचमार्क को हाईलाइट करना रिलीज़ की प्रकृति के बारे में बहुत कुछ बताता है।
GDPval उन कार्यों का परीक्षण है जो पेशेवर लोग रोज़मर्रा की नौकरी में करते हैं, जैसे रिपोर्ट बनाना और प्रेज़ेंटेशन तैयार करना। टेस्ट प्रश्न अमेरिकी GDP में योगदान देने वाले शीर्ष नौ उद्योगों की 44 नौकरियों से चुने जाते हैं। इसमें नर्स से लेकर डेटा साइंटिस्ट और कॉलेज प्रोफेसर तक सब शामिल हैं। टास्क में स्प्रेडशीट, अकाउंटिंग लेजर, वीडियो, और प्रेज़ेंटेशन जैसे वास्तविक वर्क प्रोडक्ट्स चाहिए होते हैं।
इस रिलीज़ में दूसरा सबसे अधिक हाइलाइट किया गया बेंचमार्क SWE-Bench Pro है, जो एक कठिन सॉफ्टवेयर इंजीनियरिंग इवैल है जिस पर GPT-5.2 ने 55.6% स्कोर किया। SWE-Bench Pro वास्तविक रिपॉज़िटरीज़ से लंबे-क्षितिज वाले इश्यू हल करने की मांग करता है, जिनमें कई फ़ाइल बदलाव जैसे कार्य शामिल होते हैं।
आपने शायद SWE-bench Verified के बारे में सुना होगा, जो टेस्ट का एक आसान संस्करण है। इस पर, GPT 5.2 ने 80% स्कोर किया। संदर्भ के लिए, हमने हाल ही में रिपोर्ट किया था कि Claude Opus 4.5 ने इस टेस्ट पर 80.9% स्कोर किया, इसलिए दोनों मॉडल लगभग तुलनीय हैं।
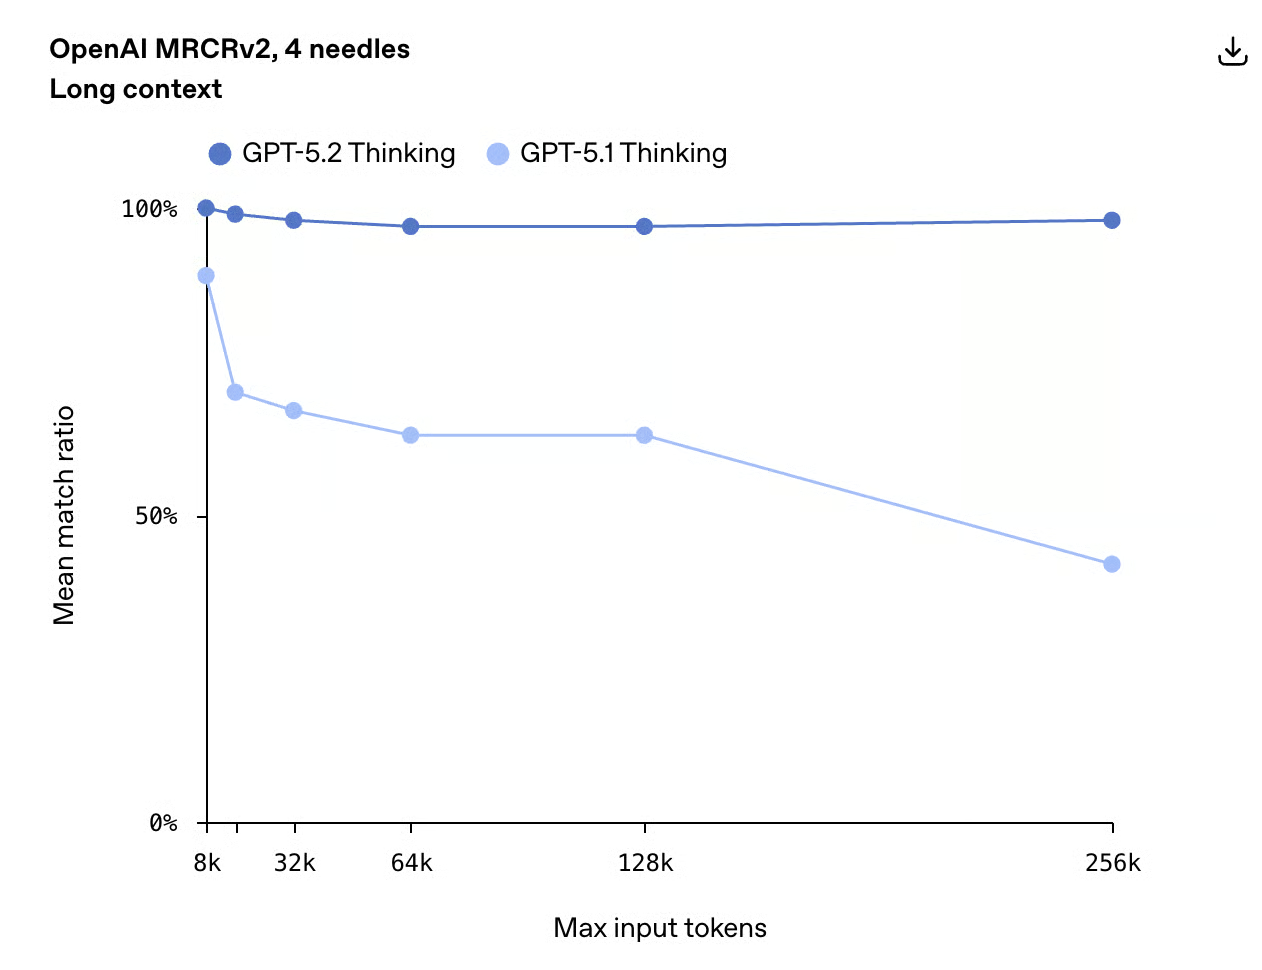
GPT 5.2 एक और बेंचमार्क MRCR v2 (Multi-Round Coreference Resolution, संस्करण 2) में शानदार प्रदर्शन दिखाता है। यह लगभग परफेक्ट स्कोर करता है, जिसका मतलब OpenAI हमें यह समझाना चाहता है कि हम GPT 5.2 का उपयोग लंबे दस्तावेज़ों के साथ काम करने के लिए कर सकते हैं।
श्रेय के तौर पर, यह 256k टोकन तक लगभग परफेक्ट सटीकता हासिल करता है। यह करीब दो लाख शब्द होते हैं, जो लगभग एक उपन्यास के आकार के बराबर है।
OpenAI ने आत्मविश्वास के साथ कहा कि GPT 5.2 बुद्धिमत्ता, लंबे संदर्भ की समझ, एजेण्ट-आधारित टूल-कॉलिंग, और विज़न में बड़े सुधार लाता है, इसलिए इन्हें बारी-बारी से परखना समझदारी है।
GPT-5.2 की लंबे संदर्भ की समझ की जांच करने के लिए, मैंने J.M. Coetzee के उपन्यास Disgrace का एक ऑनलाइन संस्करण अपलोड किया। फिर मैंने मॉडल से एक लंबे पैरे में कहीं भीतर छिपी छोटी, आसानी से भुला दी जाने वाली बात बताने को कहा।
मैंने GPT-5.2 से यह सवाल पूछा:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 ने सही उत्तर ढूंढ लिया, जबकि मुझे लगा था कि यह तिनके के ढेर में सुई जैसा विवरण है। इस डिनर का किताब में एक बार ज़िक्र था और घटना का कथानक में असल में कोई महत्व नहीं था।
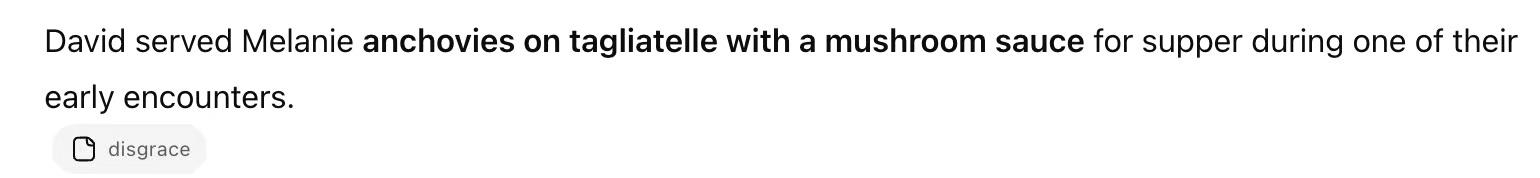
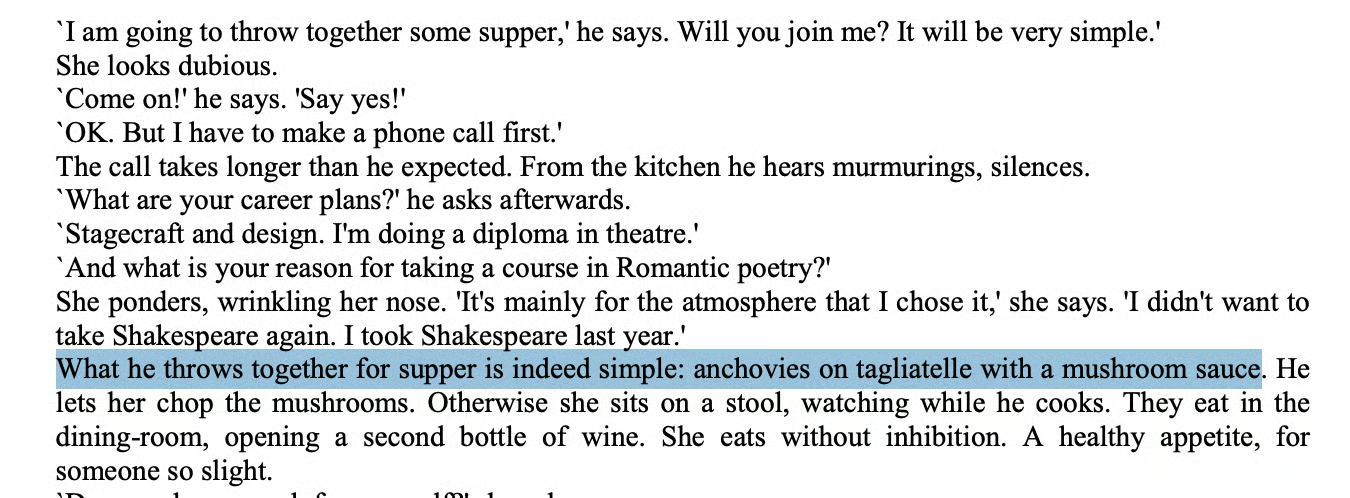
इस परीक्षण ने दिखाया कि GPT-5.2 की रिट्रीवल पैटर्न-गेसिंग पर नहीं, बल्कि लंबे अनुक्रम में वास्तविक रिटेंशन पर आधारित है।
इस तरह की रिटेंशन मायने रखती है क्योंकि असली लंबे संदर्भ का प्रदर्शन व्यापक पाठ में सूक्ष्म स्टेट बनाए रखने के बारे में है। अगर कोई मॉडल 90-पेज की कथा में दबी एक क्षणिक डिनर रेसिपी याद रख सकता है, तो वह कोडबेस में वेरिएबल्स, किसी कॉन्ट्रैक्ट के कानूनी क्लॉज़, या 200-पेज की रिपोर्ट में वित्तीय विवरण भी ट्रैक कर सकता है।
GPT-5.2 की एजेण्टिक क्षमताओं की जांच के लिए, मैंने इसे ऐसा कार्य दिया जो नेविगेशन और क्लिकिंग की मांग करता है। मैंने इसे एक स्वायत्त अपार्टमेंट-हंटिंग एजेण्ट की तरह व्यवहार करने को कहा। यह क्षमता उन लोगों के लिए सहायक होगी जो शिफ्ट होना चाहते हैं लेकिन किराये की साइटों को खुद खंगालने के लिए बहुत व्यस्त हैं।
मॉडल को ब्राउज़र का उपयोग करना था, फ़िल्टर लगाने थे, लिस्टिंग्स में क्लिक करना था, विवरण निकालना था, और एक तुलना रिपोर्ट तैयार करनी थी।
प्रॉम्प्ट का सार यह था:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
यह सेटअप एक साथ लंबे-क्षितिज तर्क, टूल-कॉलिंग, और UI इंटरैक्शन का परीक्षण करने के लिए डिज़ाइन किया गया था।
GPT-5.2 एक लिस्टिंग साइट पर गया, फ़िल्टर सेट किए, और अपने आप परिणामों से गुज़रा। इसने व्यक्तिगत यूनिट्स में क्लिक किया, संरचित फ़ील्ड्स निकाले, एक मोहल्ला और एक प्राइस बैंड चुना (मैं खुद भी ये फ़िल्टर मांग सकता था, लेकिन मैं वास्तव में शिफ्ट होने की सोच नहीं रहा था), और फिर एक छोटा, रैंक किया हुआ शॉर्ट-लिस्ट कंपाइल किया।
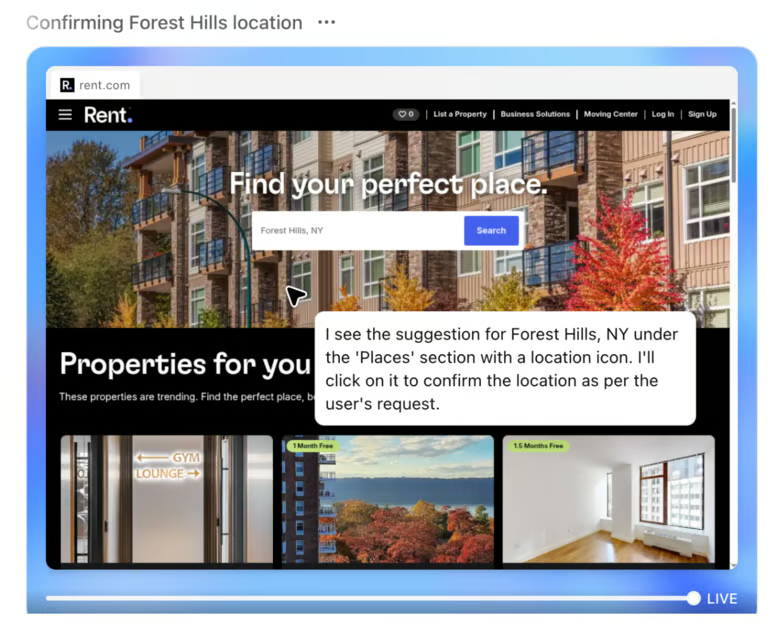
मुझे यकीन है कि रिसर्च परफेक्ट नहीं थी। मैं मॉडल के ट्रेस में देख सकता था कि कुछ साइट्स ने स्क्रैपिंग को ब्लॉक किया, लेकिन एजेण्ट ने साइट बदलकर रिकवर किया, और अंत में इसने काम चलाऊ सिफारिशों का सेट तैयार कर ही दिया।
अंतिम तालिका में मैंने नोटिस किया कि मॉडल ने मुझे असली URLs नहीं दिए; इसके बजाय, उसने स्क्रीनशॉट-शैली के संदर्भ दिए। ऐसा इसलिए है क्योंकि अधिकतर रेंटल साइट्स ऑटोमेटेड एक्सेस को ब्लॉक करती हैं, और ब्राउज़िंग टूल को असली लिस्टिंग लिंक निकालने या साझा करने की अनुमति नहीं है। जब ऐसा होता है, तो यह सैंडबॉक्स के भीतर कैप्चर किए गए स्क्रीनशॉट की ओर इशारा भर डाल देता है। तो वह हिस्सा थोड़ा खीझ देने वाला था।
मैं देखना चाहता था कि ये एजेण्टिक क्षमताएँ ऐसे डोमेन में कितनी दूर तक जा सकती हैं जहां स्वच्छ डेटा स्रोत कम हैं, इसलिए मैंने वंशावली (genealogy) में दूसरा प्रयोग किया।
मैंने GPT-5.2 से जाँच करने को कहा कि क्या Waples परिवार के सदस्य अंग्रेज़ी पैरिश रजिस्टरों में मिलते हैं और क्या Herefordshire से कोई ऐतिहासिक या वंशावली संबंध हो सकता है।
GPT-5.2 ने ठोस कार्रवाइयाँ कीं, जैसे एक मुफ़्त वंशावली साइट पर जाना और रिकॉर्ड खोजने व डाउनलोड करने के लिए पेजों पर क्लिक करना।
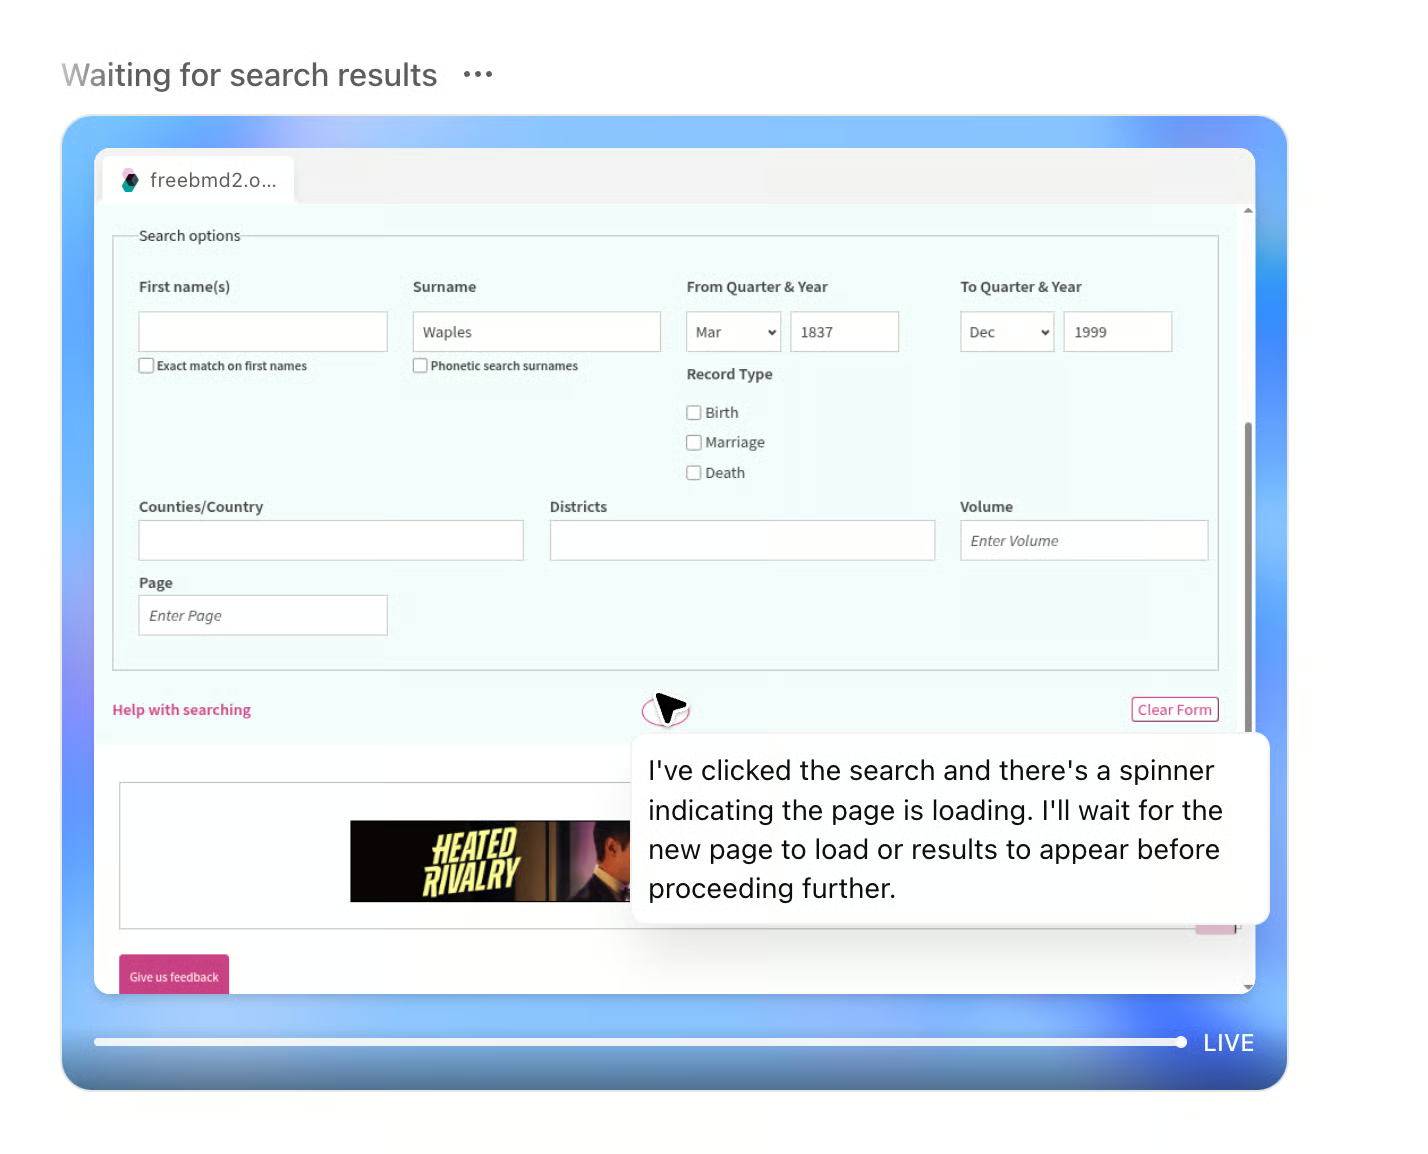
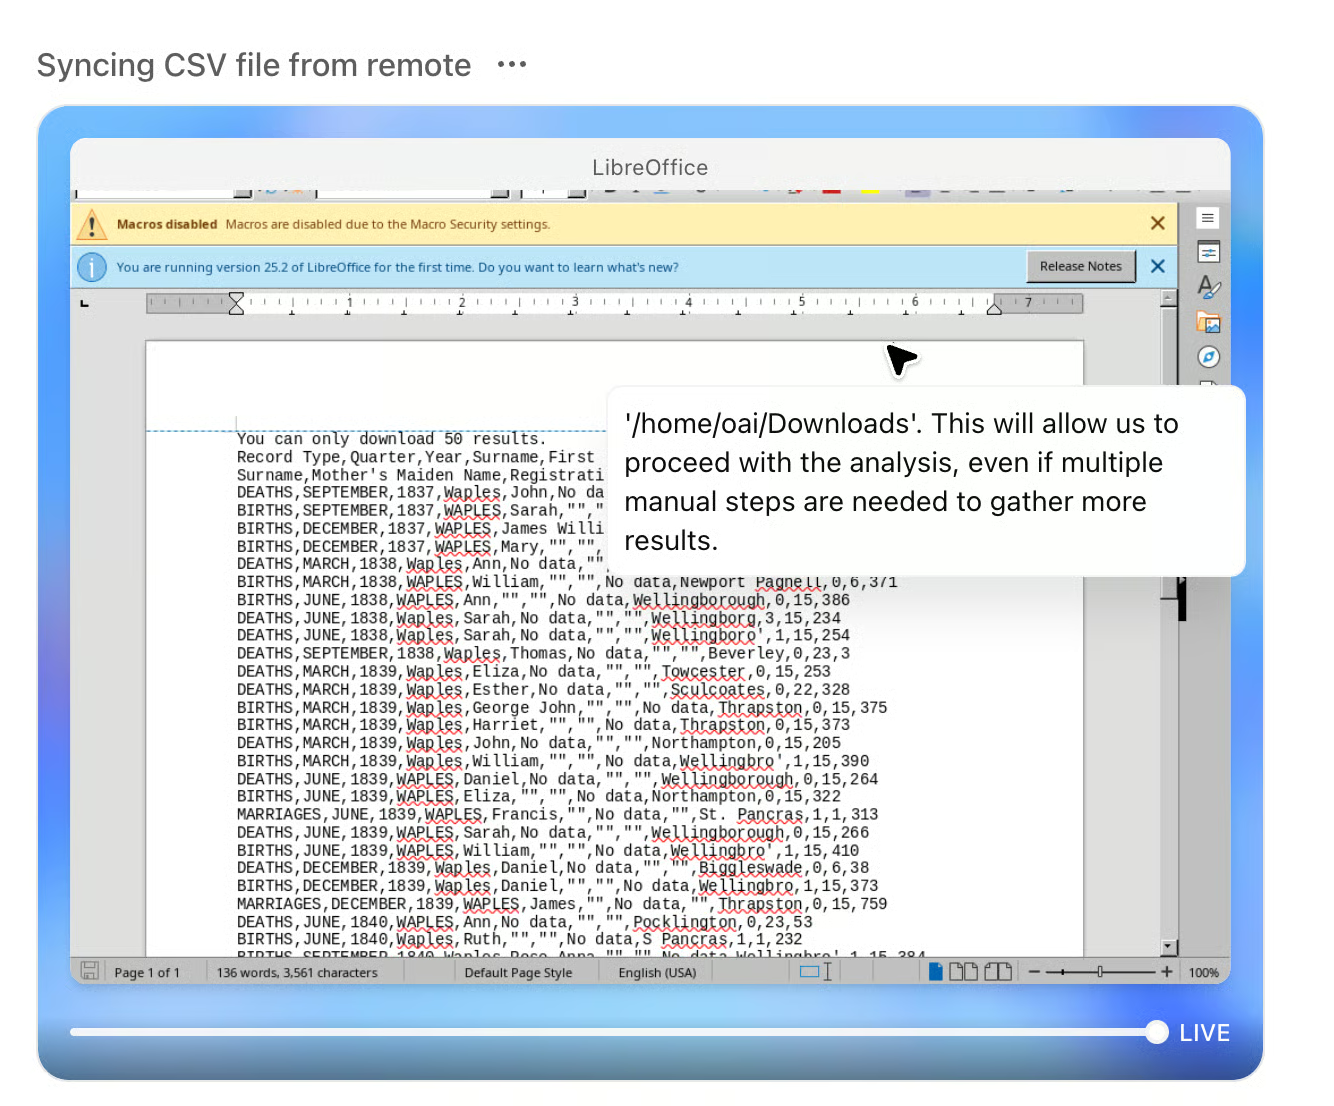
मॉडल ने समस्या को उप-कार्यों में बांटा, FreeBMD और Forebears जैसे संसाधनों में लुकअप्स चलाए, और जो रिकॉर्ड डिजिटाइज़ नहीं हैं उनके लिए एक लक्षित पूछताछ ईमेल का मसौदा भी तैयार किया।
साथ ही, मुझे पता चला कि शोध-डोमेन के रूप में वंशावली कुछ कड़े प्रतिबंध लगाती है। कई प्रमुख स्रोत, जैसे पैरिश रजिस्टर या प्रेज़ेन्टमेंट रोल, सिर्फ़ आर्काइव में मौजूद हैं या सीमित कैटलॉग के पीछे छिपे हैं। FreeBMD 50-रिकॉर्ड डाउनलोड की सीमा लगाता है, HARC का कैटलॉग सेशन कुकीज़ के बिना एक्सेस नहीं किया जा सकता, और ऐतिहासिक रूप से प्रासंगिक दस्तावेज़ वास्तव में पेड रिसर्च सेवाओं के ज़रिये हासिल होते हैं।
मॉडल इन बाधाओं को पहचान सकता है और अगले कदम सुझा सकता है, लेकिन उन्हें पार नहीं कर सकता। यह परीक्षण कोई बहुत उपयोगी चीज़ नहीं दे पाया, लेकिन यह मॉडल की कमी नहीं थी।
यह सब दिखाता है कि OpenAI व्यापारिक उपयोग मामलों पर क्यों केंद्रित है—क्योंकि अवसर वहीं है। लेकिन यह याद दिलाता है कि बहुत सा डेटा अब भी ऑफ़लाइन, बिखरा हुआ, पेवॉल के पीछे, या वास्तविक दरवाज़ों के पीछे बंद है।
अंतिम परीक्षण के लिए, मैंने विज़न और सामान्य बुद्धिमत्ता दोनों की जांच के रूप में एक सुडोकू अपलोड किया।
सुडोकू स्वयं भारी गणित नहीं है क्योंकि यह सीमित है। लेकिन जब पहेली तस्वीर के रूप में हो और संरचित पाठ के रूप में नहीं, तो मॉडल को एक साथ कई कौशलों का उपयोग करना पड़ता है: ग्रिड पढ़ना, “givens” को सुरक्षित रखना, और फिर उसे हल करने के लिए तर्क लागू करना।
can you fill out this sudoku for meछवि पूरी तरह से स्पष्ट नहीं थी, लेकिन यही परीक्षण का हिस्सा था:
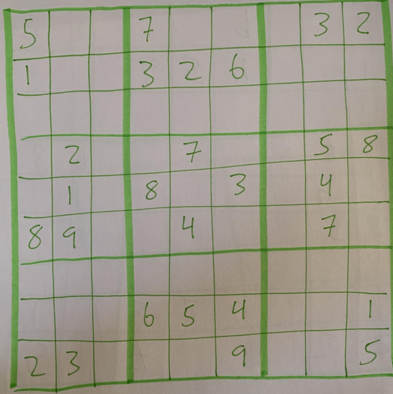
GPT-5.2 ने एक सटीक पहेली दी, लेकिन उसने कम-से-कम एक हार्डकोडेड संख्या को बदल दिया जो उसे नहीं बदलनी चाहिए थी। आप कह सकते हैं कि उसने अनजाने में चीट कर लिया।
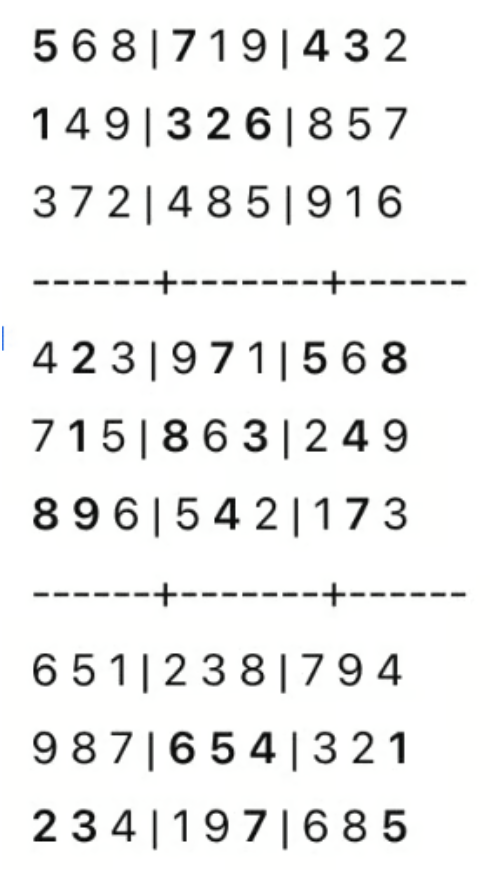
इस तरह की गलती तर्क की असफलता नहीं है। यह विज़न और निष्ठा में टूटन है। मॉडल ने या तो किसी दिए गए सेल को गलत पढ़ लिया, यह समझने में असफल रहा कि कौन-सी स्थितियाँ स्थिर थीं, या इमेज को आंतरिक ग्रिड में बदलते समय संयमों का ट्रैक खो दिया।
ऊपर किए गए परीक्षण दिखाते हैं कि आप ChatGPT के अंदर क्या कर सकते हैं, लेकिन असली लचीलापन API पर जाने पर आता है, जहां आप खुद तर्क-प्रयास, टोकन बजट, और टूल इंटीग्रेशन नियंत्रित करते हैं।
तीनों मॉडल अब OpenAI के Responses API और Chat Completions API के माध्यम से उपलब्ध हैं:
|
मॉडल |
API मॉडल स्ट्रिंग |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
यहाँ मूल्य निर्धारण है:
पावर उपयोगकर्ताओं के लिए दो जोड़: एक 1xhigh1 तर्क-प्रयास सेटिंग और एक /compact एंडपॉइंट, जो लंबे समय तक चलने वाले वर्कफ़्लोज़ के लिए प्रभावी संदर्भ विंडो बढ़ाता है।
आइए देखें कि GPT-5.2 हालिया रिलीज़ों की तुलना में कैसा है:
Gemini 3, जो नवंबर के मध्य में जारी हुआ, ने कई चर्चित बेंचमार्क परीक्षणों में स्कोर को पछाड़ दिया। यह Humanity's Last Exam पर शीर्ष स्थान रखता है, और GPQA Diamond पर भी GPT-5.2 Pro को मामूली अंतर से मात देता है (93.8% बनाम 93.2%)।
Gemini के प्रदर्शन में बड़ी बढ़त संभवतः mixture-of-experts के इम्प्लीमेंटेशन और ट्रेनिंग इन्फ्रास्ट्रक्चर दोनों में सुधारों को दर्शाती है। Gemini 3 टोकन-स्तरीय स्पार्स रूटिंग का उपयोग करता है, और यह Google के कस्टम TPU इन्फ्रास्ट्रक्चर पर ट्रेन किया गया था। जहां GPT-5.2 अभी अच्छा कर रहा है, वह पेशेवर कार्य बेंचमार्क (जैसे GDPval) और एंटरप्राइज़ टूल-कॉलिंग इवैल्स हैं। OpenAI ने स्पष्ट रूप से अपना प्रयास यहीं केंद्रित किया है।
Claude Opus 4.5, जिसे नवंबर के अंत में जारी किया गया, ने अलग राह अपनाई। Anthropic ने जिसे उन्होंने “हाइब्रिड रीजनिंग” कहा—विस्तारित सोच को मजबूत बेसलाइन इंटेलिजेंस के साथ जोड़ना—पर ध्यान केंद्रित किया, और नतीजा एक ऐसा मॉडल था जो सॉफ्टवेयर इंजीनियरिंग और ओपन-एंडेड टास्क में उत्कृष्ट है। SWE-bench Verified पर, Opus 4.5 80.9% स्कोर करता है, जो GPT-5.2 के 80% से ज़रा सा अधिक है।
जहां मॉडल शैली में अलग होते हैं: Opus 4.5 लंबे, अधिक विचारशील उत्तरों की ओर झुकता है, जबकि GPT-5.2 Thinking टूल उपयोग और स्प्रेडशीट्स व प्रेज़ेंटेशन जैसे संरचित आउटपुट पर ज़ोर देता है। कोडिंग एजेण्ट्स और जटिल रिफैक्टर्स के लिए, ये प्रभावी रूप से बराबरी पर हैं; स्लाइड्स और रिपोर्ट्स से जुड़े एंटरप्राइज़ वर्कफ़्लोज़ के लिए, OpenAI का दांव है कि GPT-5.2 को बढ़त है।
GPT बेंचमार्क परिणामों पर भी खूब ध्यान रहा है, और OpenAI पर डिलीवर करने का काफ़ी दबाव रहा होगा। एक महीना पहले, GPT 5.1 की रिलीज़ को Gemini 3 ने ढक लिया था। अब, GPT 5.2 की रिलीज़ में, OpenAI GPQA पर Gemini 3 से मामूली अंतर से और SWE-Bench Verified पर Claude Opus 4.5 से मामूली अंतर से पीछे है, जो टीम के लिए निराशाजनक हो सकता है।
OpenAI ने इसके बजाय GDPval और SWE-Bench Pro पर उच्च प्रदर्शन को हाइलाइट किया है, लेकिन खासकर पहला टेस्ट इंडस्ट्री-स्टैंडर्ड्स की तुलना में कम जाना-पहचाना है जो सुर्खियाँ बटोरते हैं। कोई सोच सकता है कि OpenAI ऐसा विजयी नैरेटिव बताने की कोशिश कर रहा है जिसमें उन लीडरबोर्ड्स पर ध्यान न जाए जिनमें वह फिलहाल पीछे है।
लेकिन दौड़ बेहद क़रीबी है, और इन कंपनियों के पास खुद को साबित करने के लिए अभी बहुत गुंजाइश है। एक चीज़ जिस पर हम खास नज़र रखेंगे, वह है कि नए मॉडल आगामी ARC-AGI-3 बेंचमार्क पर कैसा प्रदर्शन करते हैं, जो विकासाधीन है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स