
Last chance! 50% off DataCamp Premium
Sale ends in
Güncelleme: Bu makaleyi yayınladığımızdan beri OpenAI birkaç yeni model çıkardı. Güncel kalmak için GPT-5.4, GPT-5.3-Codex ve GPT-5.3-Instant rehberlerimize de göz atmayı unutmayın.
Son GPT-5.1 lansmanını görmemizin üzerinden sadece bir ay geçti. Ancak yapay zekâ dünyasında bir ay uzun bir süre. Bu arada Google, en çok takip edilen kıyaslamaların çoğunda zirveye yerleşen Gemini 3’ü, Anthropic ise yazılım mühendisliğinde bir kez daha lider olan Claude Opus 4.5’i çıkardı.
OpenAI, iş dünyasına değer sunma konusunda en donanımlı şirket olarak konumlanmak istiyor. Ancak önemli listelerde geriye düşmesinin ardından kullanıcılarını veya hatta kurumsal müşterilerini kaybetmekten endişe etmiş olabilir. Bildirildiğine göre bu baskı bir “kırmızı alarmı” tetikledi ve ekibi GPT-5.2’nin çıkışını hızlandırmaya itti.
Bu yazıda, GPT-5.2’nin çıkışıyla duyurulan her şeyi, ChatGPT’de tüm ücretli kullanıcılara kademeli olarak sunulan (ve artık API’de de bulunan) üç yeni modelden işletmelerin ne kazanacağını anlamanıza yardımcı olacağım. Ayrıca ChatGPT Images aracı ve iki yeni model olan GPT-5.3 Codex ve GPT-5.2 Instant rehberlerimize de göz atabilirsiniz.
Okurlarımızı yapay zekâdaki en son gelişmelerden haberdar etmek için The Median adlı ücretsiz Cuma bültenimizi gönderiyoruz; haftanın önemli haberlerini sade bir şekilde özetliyoruz. Abone olun, haftada sadece birkaç dakikada gündemi yakalayın:
GPT-5.2, akıl yürütme, bellek ve araç kullanımı alanlarında belirli ve hedefli iyileştirmeler getiriyor. OpenAI’nin çerçevesinde bu geliştirmeler, daha iyi kurumsal iş akışlarına ve işiniz sırasında daha az hata noktasına dönüşüyor. Serideki üç modelin her biri bu değeri sunmak için farklı bir yaklaşım benimsiyor.
GPT-5.2 Instant, düşük gecikme ve hızlı yanıt sürelerine öncelik verir. Bilgi alma, taslak oluşturma ve çeviri gibi günlük işler için çok yönlü bir araç olarak sunuluyor. Çoğu kişinin varsayılan olarak etkileşime geçeceği model budur; avantajı derinlikten çok işlem hacmidir. Pratikte, daha ağır akıl yürütme için ücret ödemeden hızlı yanıtlar veya hafif otomasyon gerektiğinde boşluğu doldurur.
GPT-5.2 Thinking, yanıtını vermeden önce karmaşık problemleri adım adım çalışmasına imkân tanıyan genişletilmiş akıl yürütme yeteneklerini içerir.
OpenAI’nin kendi kıyaslamalarında, özellikle hesap tabloları ve sunumlar gibi araçları kullanabildiğinde bilgi işi, kodlama ve uzun bağlam görevlerinde yeni zirveler belirleyen model budur.
Bu, OpenAI’nin genel amaçlı bir bilgi işi motoru girişimidir ve doğruluğun kasıtlı düşünmeyle arttığı durumlarda seçtiğiniz modeldir. Birçok kuruluş için analiz, çok adımlı iş akışları ve özerk görevlerde tercih bu olacaktır.
Amiral gemisi model budur ve kurumsal müşteriler düşünülerek geliştirilmiştir.
Ayrıca serideki en pahalı seçenektir; çünkü akıl yürütme kalitesindeki, olgusal doğruluktaki ve soyut problem çözmedeki artımsal kazanımların, belirteç başına daha yüksek maliyeti haklı çıkardığı yüksek riskli senaryolara yöneliktir.
Pro, hataların maliyetli olduğu ve ekiplerin çok uzun bağlamlar boyunca tutarlılığı koruyabilen bir modele ihtiyaç duyduğu ortamlara yöneliktir. Karar destek sistemlerinde, karmaşık planlamada ve güvenilirliğin ham kapasite kadar önemli olduğu tüm iş yüklerinde kullanılabilecek model budur.
GPT-5.2 hâlihazırda yayına alınıyor. OpenAI modeli 11 Aralık 2025’te resmen duyurdu; önce ücretli ChatGPT planları erişim sağladı ve kullanılabilirlik bölgeler ve platformlar genelinde genişlemeye devam ediyor. Kullanıcılar üç GPT-5.2 modelinin tümüne doğrudan ChatGPT içinde erişebilir; geliştiriciler ise OpenAI API üzerinden Responses ve Chat Completions uç noktalarıyla kullanabilir.
GPT 5.1 sürümünün yayımlanması kullanıcı deneyimine odaklandığı için kıyaslama sonuçları açısından dikkat çekici biçimde sınırlıydı. Dolayısıyla GPT 5.2’nin odağı yeniden sonuçlara çevirerek rotayı düzeltmeye çalışması şaşırtıcı değil.
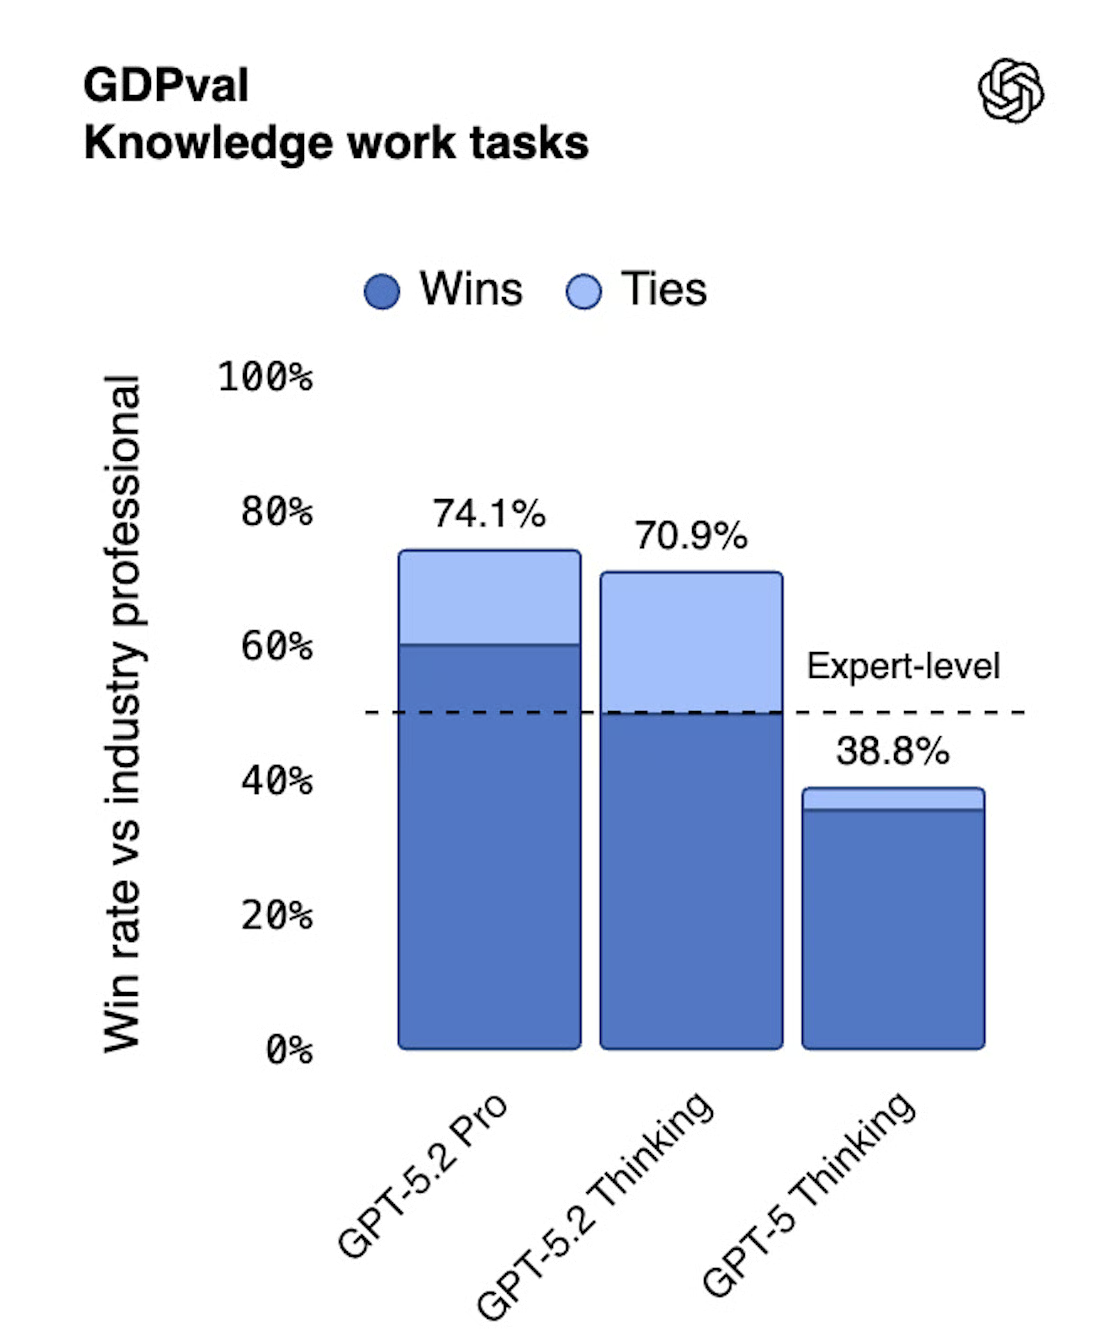
GDPval yeni sürümde en çok öne çıkarılan kıyas sonuçlarından biridir. Ancak bu kıyas arXiv’de yalnızca 2025 Ekim ayı başında tanıtıldı; dolayısıyla bu sonuca yapılan vurgu, sürümün doğası hakkında çok şey söylüyor.
GDPval, çalışan profesyonellerin günlük işlerinde gerçekleştirdiği rapor oluşturma ve sunum hazırlama gibi görevleri test eder. Test soruları, ABD GSYİH’sına en çok katkı yapan dokuz sektör genelindeki 44 meslekten seçiliyor. Bu, hem hemşirelerden veri bilimcilerine hem de üniversite hocalarına kadar geniş bir yelpazeyi kapsıyor. Görevler, hesap tabloları, muhasebe defterleri, videolar ve sunumlar gibi gerçek iş çıktıları gerektiriyor.
Bu sürümde ikinci en çok vurgulanan kıyas SWE-Bench Pro; zorlu bir yazılım mühendisliği değerlendirmesi ve GPT-5.2 burada %55,6 puan aldı. SWE-Bench Pro, birden çok dosya değişikliği yapmak gibi konuları içeren, gerçek depolardan uzun vadeli sorunların çözülmesini gerektirir.
SWE-bench Verified adını duymuş olabilirsiniz; bu testin daha kolay bir versiyonudur. Bu testte GPT 5.2 %80 aldı. Bağlam için, yakın zamanda Claude Opus 4.5’in bu testte %80,9 aldığını bildirmiştik; dolayısıyla iki model kabaca kıyaslanabilir düzeyde.
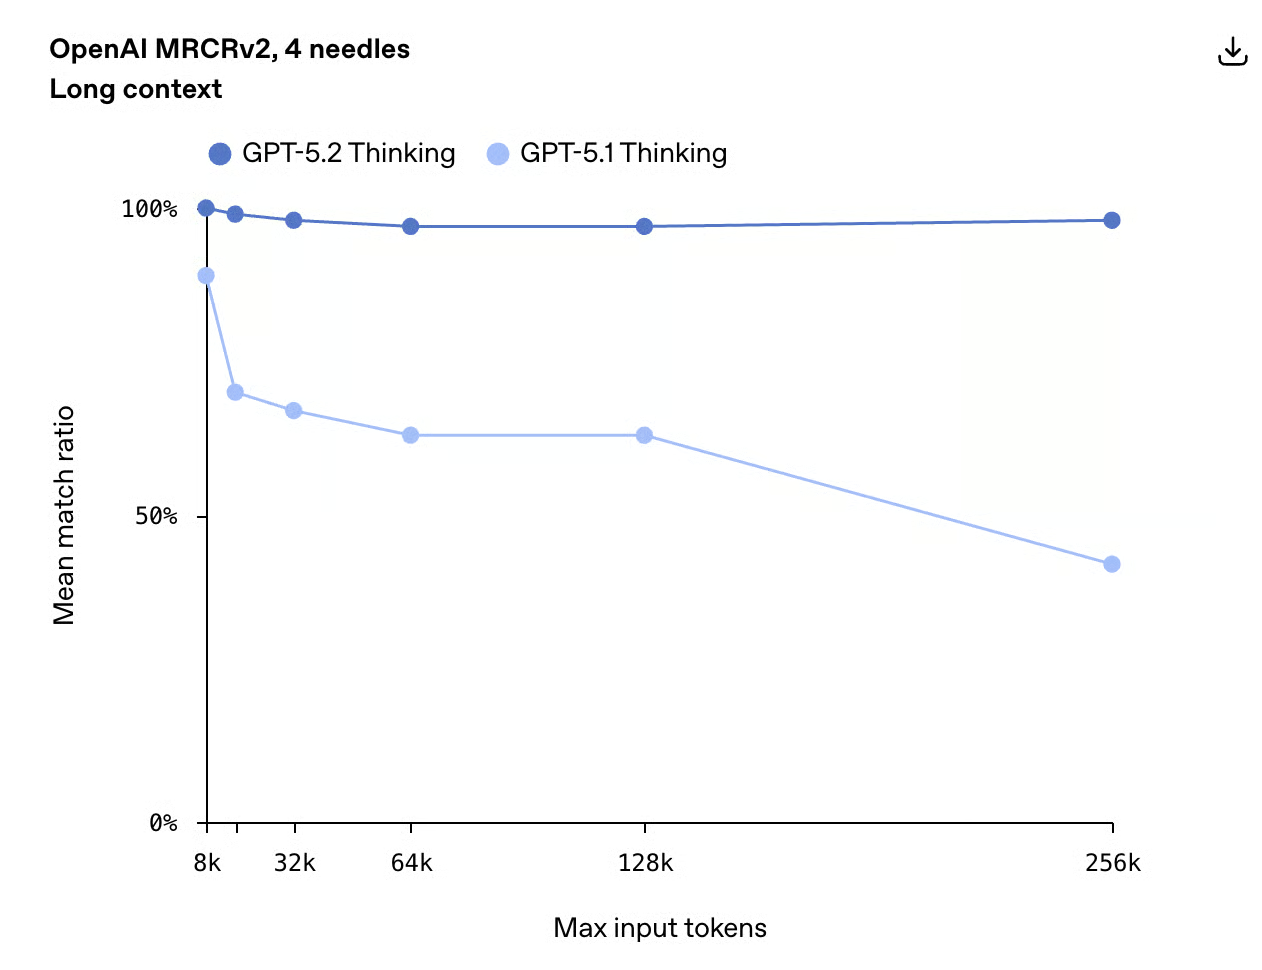
GPT 5.2, MRCR v2 adlı başka bir kıyaslamada da (Multi-Round Coreference Resolution, sürüm 2) çok iyi performans gösteriyor. Neredeyse mükemmel bir puan alıyor; OpenAI, bunun GPT 5.2’yi uzun belgelerle çalışmak için kullanabileceğimiz anlamına geldiğini vurgulamak istiyor.
Hakkını teslim etmek gerekirse, 256k belirtece kadar neredeyse mükemmel doğruluk sağlıyor. Bu da yaklaşık iki yüz bin kelime, yani kabaca bir roman uzunluğu demek.
OpenAI, GPT 5.2’nin zekâ, uzun bağlam anlama, özerk araç çağırma ve görme konusunda büyük iyileştirmeler getirdiğini iddia etti; bu yüzden her birini sırayla değerlendirmek mantıklı.
GPT-5.2’nin uzun bağlam anlama yeteneğini test etmek için J.M. Coetzee’nin Utanç adlı romanının çevrimiçi bir sürümünü yükledim. Ardından modelden, uzun bir pasajın derinliklerinde kalan küçük, kolayca unutulabilir bir ayrıntıyı söylemesini istedim.
GPT-5.2’den şu soruya cevap istedim:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2, bana samanlıkta iğne aramak gibi gelen bu ayrıntıyı doğru buldu. Bu akşam yemeği kitapta bir kez anılmıştı ve olayın anlatıda gerçek bir önemi yoktu.
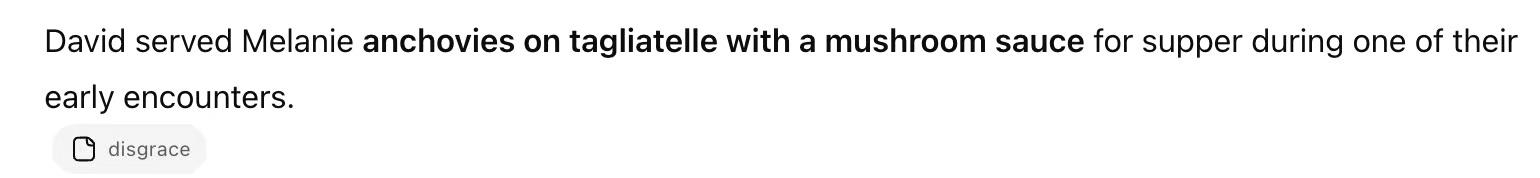
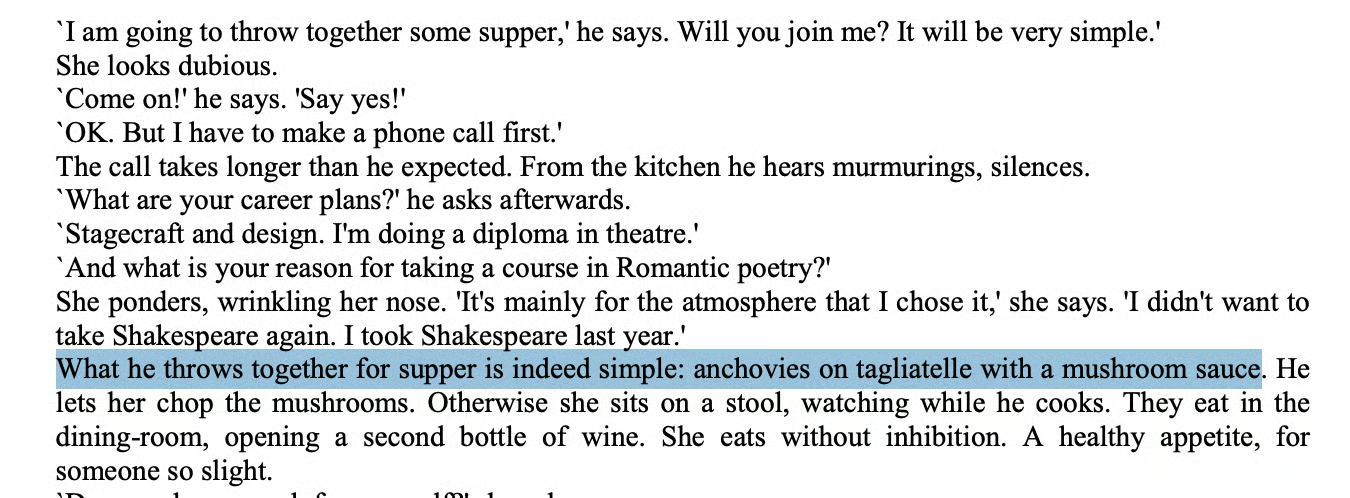
Bu test, GPT-5.2’nin geri çağırmasının kalıp tahminine değil, uzun bir dizilim boyunca gerçek bir tutmaya dayandığını bana gösterdi.
Bu tür bir tutma önemlidir; çünkü gerçek uzun bağlam performansı, geniş metin bölümleri boyunca ayrıntılı durumu korumakla ilgilidir. Bir model, 90 sayfalık bir anlatının derinliklerine gömülü uçucu bir akşam yemeği tarifini hatırlayabiliyorsa, bir kod tabanındaki değişkenleri, bir sözleşmedeki hukuki hükümleri veya 200 sayfalık bir rapordaki finansal ayrıntıları da takip edebilir.
GPT-5.2’nin özerk yeteneklerini test etmek için gezinme ve tıklama gerektiren bir görev verdim. Ondan otonom bir daire arama aracısı gibi davranmasını istedim. Taşınmak isteyen ama ilan sitelerini taramaya vakti olmayan kişiler için bu yetenek faydalı olabilir.
Modelin bir tarayıcı kullanması, filtreler uygulaması, ilanlara tıklaması, ayrıntıları çıkarması ve bir karşılaştırma raporu derlemesi gerekiyordu.
Özünde istem şuydu:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
Bu istem kurgusu, uzun vadeli akıl yürütme, araç çağırma ve arayüz etkileşimini tek seferde test etmek üzere tasarlandı.
GPT-5.2 bir ilan sitesine gitti, filtreleri ayarladı ve sonuçları kendi başına işledi. Tek tek dairelere tıkladı, yapısal alanları çıkardı, hem bir semt hem de bir fiyat aralığı seçti (bunları ben de isteyebilirdim ama gerçekten taşınmayı düşünmüyorum) ve ardından küçük, sıralı bir kısa liste derledi.
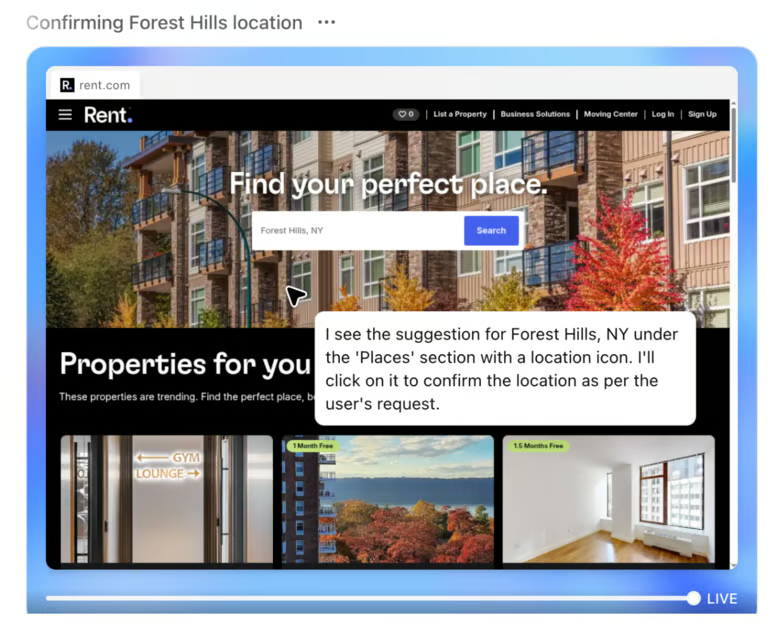
Araştırmanın kusursuz olmadığına eminim. Modelin izinde bazı sitelerin kazımayı engellediğini gördüm, ancak ajan site değiştirerek toparlandı ve sonunda kullanılabilir bir öneri seti sundu.
Son tabloda fark ettiğim bir şey, modelin gerçek URL’leri vermemesi; onun yerine ekran görüntüsü tarzı referanslar sunmasıydı. Bunun nedeni, çoğu ilan sitesinin otomatik erişimi engellemesi ve tarama aracının gerçek ilan bağlantılarını çıkarmaya veya paylaşmaya izinli olmaması. Bu durumda, yalnızca kum havuzu içinde yakaladığı ekran görüntüsüne bir işaretçi ekliyor. Bu kısım biraz can sıkıcıydı.
Bu özerk yeteneklerin, daha az temiz veri kaynağı olan bir alanda ne kadar ilerleyebileceğini görmek için soy kütüğü üzerinde ikinci bir deney yaptım.
GPT-5.2’den, Waples ailesinin İngiliz kilise kayıtlarında görünüp görünmediğini ve Herefordshire ile tarihsel ya da soykütüksel bir bağ olup olmadığını araştırmasını istedim.
GPT-5.2, ücretsiz bir soy kütüğü kaynağına erişmek ve sayfalar arasında gezinip kayıtları bulup indirmek gibi belirli eylemler gerçekleştirdi.
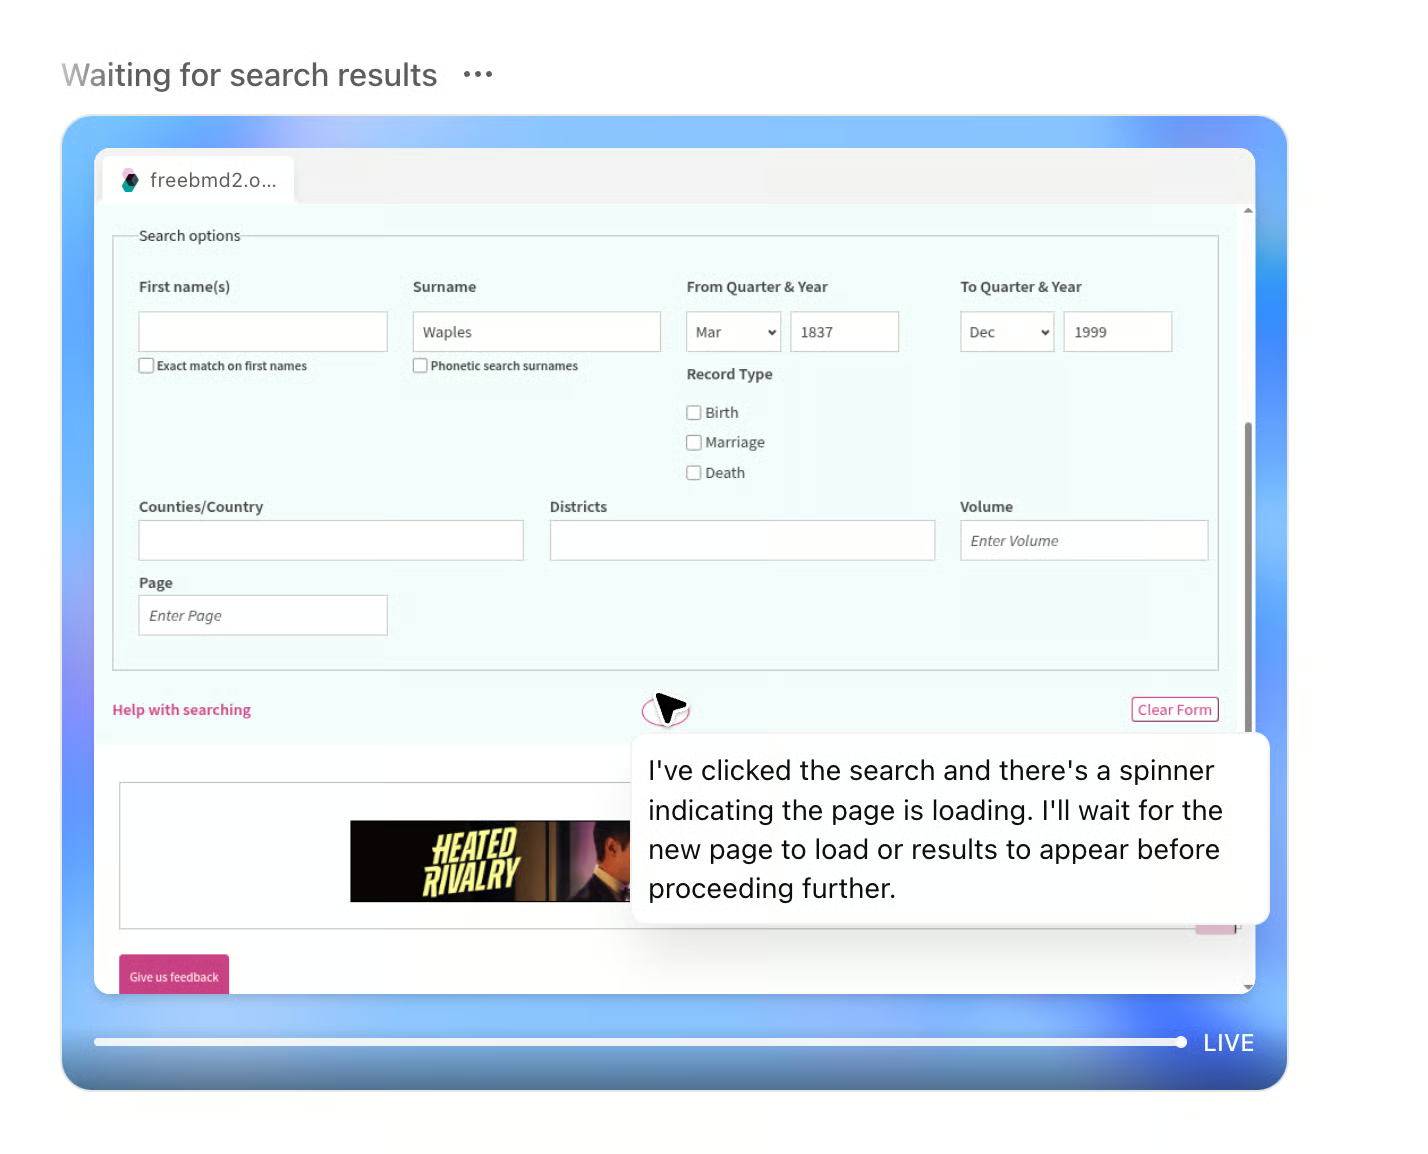
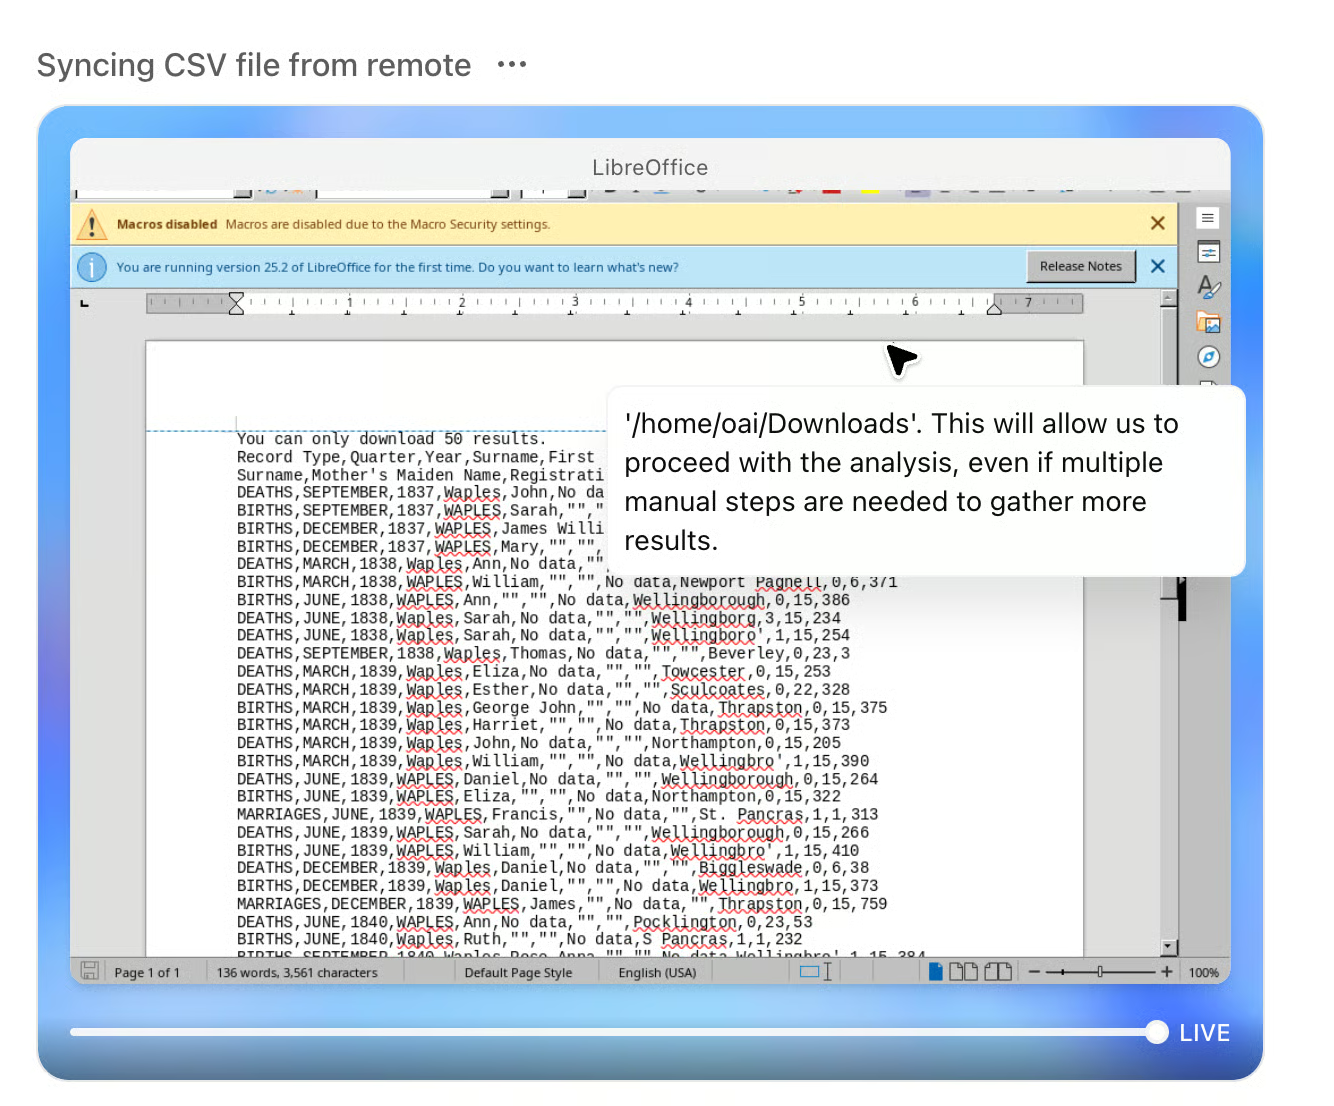
Model, sorunu alt görevlere böldü; FreeBMD ve Forebears gibi kaynaklarda sorgular yaptı ve hatta dijitalleştirilmemiş kayıtların peşine düşmek için hedefli bir bilgi talep e-postası taslağı hazırladı.
Aynı zamanda, araştırma alanı olarak soy kütüğünün bazı sert sınırlamalar getirdiğini öğrendim. Kilise kayıtları veya presentment roll gibi birçok temel kaynak, yalnızca arşivlerde ya da kısıtlı katalogların arkasında mevcut. FreeBMD, 50 kayıt indirme sınırı koyuyor; HARC’ın kataloğuna oturum çerezi olmadan erişilemiyor ve tarihsel açıdan ilgili belgeler genellikle ücretli araştırma hizmetleriyle elde ediliyor.
Model bu engelleri tanıyıp bir sonraki adımları önerebiliyor; ancak onları aşamıyor. Bu test çok faydalı bir sonuç üretmedi ama bu modelin suçu değildi.
Tüm bunlar, OpenAI’nin neden iş dünyası kullanım alanlarına odaklandığını gösteriyor; çünkü fırsat orada. Ancak verilerin büyük bir kısmının hâlâ çevrimdışı, parçalı, ödeme duvarı arkasında veya gerçek kapıların ardında kilitli olduğunu hatırlatıyor.
Son testim için, hem görme hem de genel zekâyı sınamak üzere bir Sudoku yükledim.
Sudoku, kısıtlı bir yapıda olduğu için ağır matematik gerektirmez. Ancak bilmece bir resim olarak ve yapılandırılmış metin olarak değil de göründüğünde, modelin aynı anda birkaç beceri kullanması gerekir: ızgarayı okumak, “verili”leri korumak ve ardından çözmek için mantık uygulamak.
can you fill out this sudoku for meGörüntü mükemmel çizilmemişti; bu da testin bir parçasıydı:
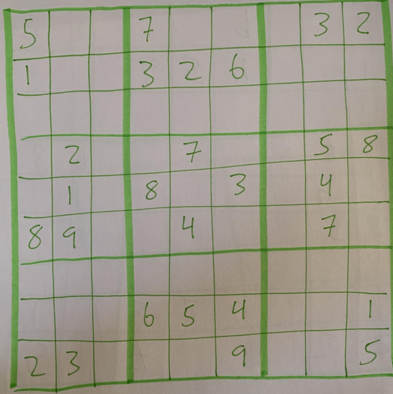
GPT-5.2 bana doğru bir bilmece verdi; ancak sabitlenmiş sayılardan en az birini değiştirdi. İstemsizce kopya çektiğini söyleyebilirsiniz.
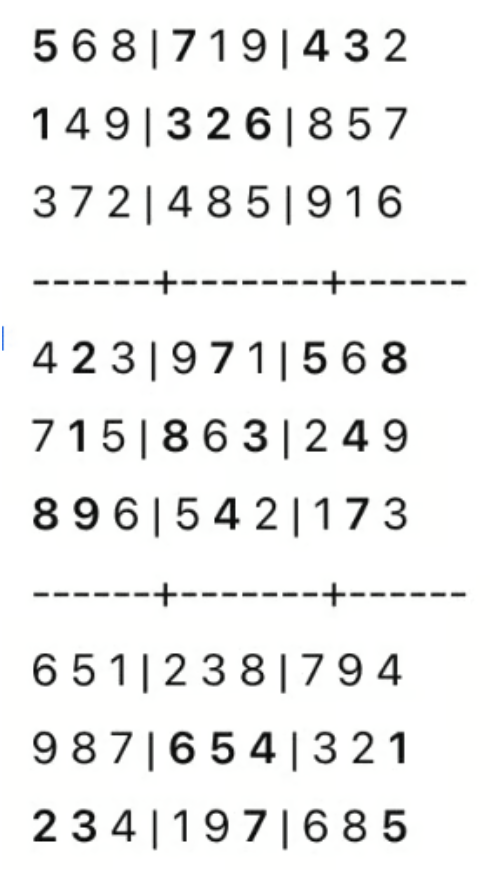
Bu tür bir hata, akıl yürütmenin bir başarısızlığı değildir. Daha çok görmede ve sadakatte bir kopuştur. Model ya verili bir hücreyi yanlış okudu, ya hangilerinin sabit konumlar olduğunu kavrayamadı ya da resmi dahili bir ızgaraya dönüştürürken kısıtları gözden kaçırdı.
Yukarıda yaptığım testler ChatGPT içinde neler yapabileceğinizi gösteriyor; ancak gerçek esneklik, akıl yürütme çabasını, belirteç bütçelerini ve araç entegrasyonlarını kendinizin kontrol ettiği API’ye geçtiğinizde ortaya çıkıyor.
Üç modelin tümü şu anda OpenAI'nin Responses API’si ve Chat Completions API’si üzerinden kullanılabilir:
|
Model |
API model dizesi |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
İşte ücretler:
Güçlü kullanıcılar için iki ekleme: bir 1xhigh1 akıl yürütme çabası ayarı ve uzun süreli iş akışları için etkin bağlam penceresini genişleten bir /compact uç noktası.
GPT-5.2’yi diğer yakın tarihli sürümlerle nasıl karşılaştırabileceğimize bakalım:
Gemini 3, Kasım ortasında yayınlandı ve en çok izlenen kıyas testlerinin birçoğunda puanları ezdi geçti. Humanity's Last Exam’de birinci sırayı elinde tutuyor ve GPQA Diamond’da da GPT-5.2 Pro’yu az bir farkla geçiyor (%93,8’e karşı %93,2).
Gemini’nin performansta büyük sıçraması muhtemelen hem mixture-of-experts uygulamasındaki hem de eğitim altyapısındaki iyileştirmeleri yansıtıyor. Gemini 3 belirteç düzeyinde seyrek yönlendirme kullanıyor ve Google’ın özel TPU altyapısında eğitildi. GPT-5.2’nin şu anda iyi olduğu alan ise GDPval gibi profesyonel iş kıyasları ve kurumsal araç çağırma değerlendirmeleri. OpenAI’nin gayretini açıkça buraya yoğunlaştırdığı görülüyor.
Claude Opus 4.5 Kasım sonlarında farklı bir yoldan ilerledi. Anthropic, “hibrit akıl yürütme” dedikleri—genişletilmiş düşünmeyi daha güçlü temel zekâyla birleştirme—üzerine odaklandı ve ortaya yazılım mühendisliğinde ve açık uçlu görevlerde üstün bir model çıktı. SWE-bench Verified’da Opus 4.5, GPT-5.2’nin %80’ine karşı %80,9 puan alıyor.
Modeller tarz olarak ayrışıyor: Opus 4.5 daha uzun ve müzakereci yanıtlara meyilliyken, GPT-5.2 Thinking hesap tabloları ve sunumlar gibi yapılandırılmış çıktılar ve araç kullanımı üzerinde duruyor. Kodlama ajanları ve karmaşık yeniden düzenlemelerde neredeyse başa başlar; slaytlar ve raporlar içeren kurumsal iş akışlarında ise OpenAI, GPT-5.2’nin avantajlı olduğuna oynuyor.
GPT kıyas sonuçlarına yönelik ilgi de yoğun ve OpenAI üzerinde teslimat baskısı büyük olmalı. Bir ay önce GPT 5.1’in çıkışı Gemini 3 tarafından gölgelendi. Şimdi GPT 5.2’nin çıkışında, OpenAI GPQA’da Gemini 3’ün, SWE-Bench Verified’da ise Claude Opus 4.5’in az farkla gerisinde kalarak ikinci sırada; bu da ekip için can sıkıcı olmalı.
OpenAI bunun yerine GDPval ve SWE-Bench Pro’daki yüksek performansı öne çıkardı; ancak özellikle ilki, manşetleri süsleyen sektör standartlarına kıyasla bilinmez bir test. OpenAI’nin, şu anda geride olduğu listelere dikkat çekmeden kazanımlı bir hikâye anlatmaya çalıştığı düşünülebilir.
Ama yarış çok yakın ve bu şirketlerin kendilerini kanıtlamak için hâlâ fazlasıyla alanı var. Özellikle, geliştirilmekte olan ARC-AGI-3 kıyaslamasında yeni modellerin nasıl performans göstereceğini izleyeceğiz.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




