
Last chance! 50% off DataCamp Premium
Sale ends in
Menyusul perilisan Gemini 3 yang mengesankan dari Google, Anthropic baru-baru ini mengumumkan Claude Opus 4.5, yang disebut sebagai ‘model terbaik di dunia untuk pengodean, agen, dan penggunaan komputer.’
Meski tolok ukur Gemini 3 sangat mengesankan, model tersebut masih berada di belakang Claude Sonnet 4.5 pada SWE-bench, yaitu uji keterampilan rekayasa perangkat lunak. Dengan Claude Opus 4.5, Anthropic melampaui skornya sendiri pada SWE-bench dan pengujian lainnya.
Claude Opus 4.5 menandai peluncuran model besar ketiga Anthropic hanya dalam dua bulan, setelah Sonnet 4.5 dan Haiku 4.5. Dan sekarang, dengan valuasi Anthropic yang melampaui $350 miliar, kita tahu mereka punya sumber daya untuk terus melaju secepat ini.
Dalam artikel ini, saya akan mengulas semua hal baru di Claude Opus 4.5, melihat tolok ukurnya, fitur-fitur baru, dan langsung menguji kemampuannya.
Claude Opus 4.5 adalah model bahasa besar terbaru dari Anthropic. Meneruskan Opus 4, ini adalah model paling canggih Anthropic, dengan fokus pada pengodean, penalaran, dan tugas jangka panjang. Model ini mencetak 80,9% pada SWE-bench dan 59,3% pada Terminal-bench.
Claude Opus 4.5 kini tersedia di aplikasi Anthropic, API, dan platform cloud utama.
Dari pengumumannya, hal-hal berikut menonjol bagi saya:
Bersamaan dengan peluncuran model, Anthropic mengumumkan beberapa pembaruan produk, yang akan saya bahas lebih lanjut di bawah. Di antaranya Claude for Chrome, ekstensi browser yang memungkinkan Claude mengambil tindakan lintas tab, dan Claude for Excel.
Ulasan tidak akan lengkap tanpa menguji model baru ini satu atau dua kali. Mari lihat bagaimana peningkatan terbaru menangani berbagai tugas:
Pertama, saya ingin melihat bagaimana Opus 4.5 menangani masalah optimasi ekonomi klasik. Saya membayangkan model permintaan log-linear yang memprediksi kuantitas terjual dari harga. Ini adalah hal yang Anda lihat di mata kuliah ekonometrika, dan juga benar-benar berguna. Jika Anda mengetahui kurva permintaan dan biaya Anda, Anda bisa mencari harga yang memaksimalkan pendapatan.
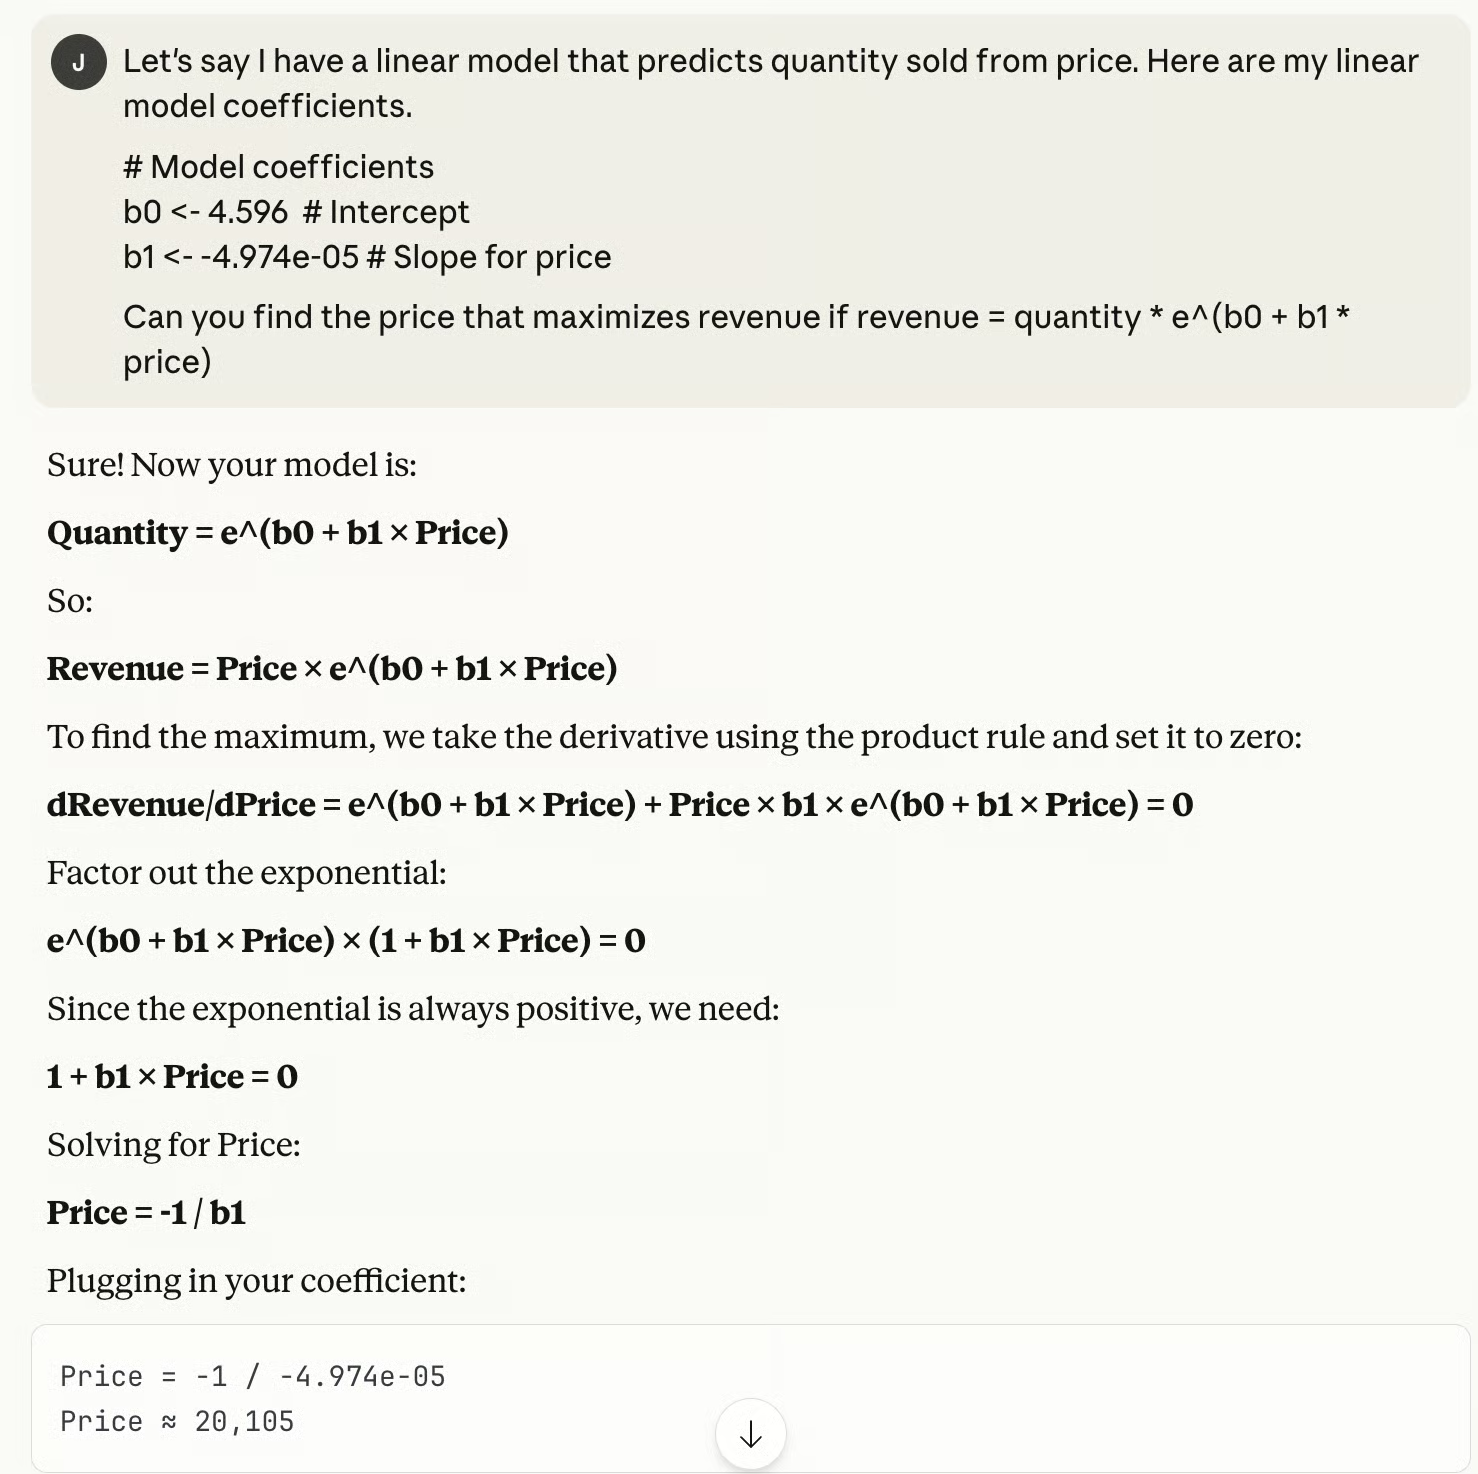
Opus 4.5 memberi saya jawaban yang benar, tanpa berpikir lama, dan semuanya dalam sekali jalan.
Saya terkesan karena hampir semua perusahaan yang menjual sesuatu akan punya gambaran tentang kuantitas terjual dan harga, tetapi tidak semua perusahaan punya sumber daya untuk menyusun jawaban untuk masalah optimasi dasar.
Namun di sini, dengan prompt yang dirancang baik, Anda dapat menemukan jawabannya dengan mudah. Tentu saja, tetap menjadi tugas analis untuk memutuskan apakah cukup banyak kendala sudah dimodelkan dengan tepat.
Hal lain yang saya suka: Opus 4.5 menunjukkan langkah-langkahnya. Ia tidak hanya memberi angka. Ia menjabarkan turunan, pemfaktoran, dan aljabarnya. Jika ada kesalahan, saya bisa melihat di mana letaknya.
Selanjutnya, saya ingin menguji Opus 4.5 pada pertanyaan statistik. Saya membuat dataset di mana yield merupakan fungsi dari temperature dengan noise yang ditambahkan.
library(tidyverse)

set.seed(1024)

# Generate data
n <- 100
df <- data.frame(
  temperature = seq(0, 100, length.out = n)
) %>%
  mutate(yield = 0.5 * temperature + 10 + rnorm(n, 0, 5))
Lalu saya memberikan prompt ini kepada Claude.
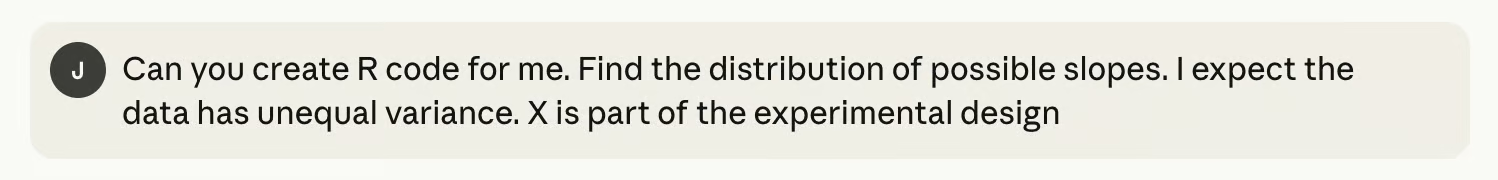
Claude mengembalikan hal berikut, yang saya gunakan untuk membuat histogram di bawah.
# Fit model
fit <- lm(yield ~ temperature, data = df)
fitted_vals <- fitted(fit)
resids <- residuals(fit)
original_slope <- coef(fit)[2]

# Residual bootstrap
set.seed(123)
n_boot <- 1000
boot_slopes <- numeric(n_boot)

for (i in 1:n_boot) {
  new_y <- fitted_vals + sample(resids, replace = TRUE)
  boot_fit <- lm(new_y ~ df$temperature)
  boot_slopes[i] <- coef(boot_fit)[2]
}

# Confidence intervals
ci_lower <- quantile(boot_slopes, 0.025)
ci_upper <- quantile(boot_slopes, 0.975)

# Plot
ggplot(data.frame(slope = boot_slopes), aes(x = slope)) +
  geom_histogram(bins = 40, fill = "gray70", color = "white") +
  geom_vline(xintercept = original_slope, color = "red", linewidth = 1) +
  geom_vline(xintercept = ci_lower, color = "steelblue", linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = ci_upper, color = "steelblue", linetype = "dashed", linewidth = 1) +
  labs(
    title = "Bootstrap Estimate: Effect of Temperature on Yield",
    subtitle = paste0("Estimate: ", round(original_slope, 3),
                      " | 95% CI: [", round(ci_lower, 3), ", ", round(ci_upper, 3), "]"),
    x = "Slope (yield per °C)",
    y = "Count"
  ) +
  theme_minimal()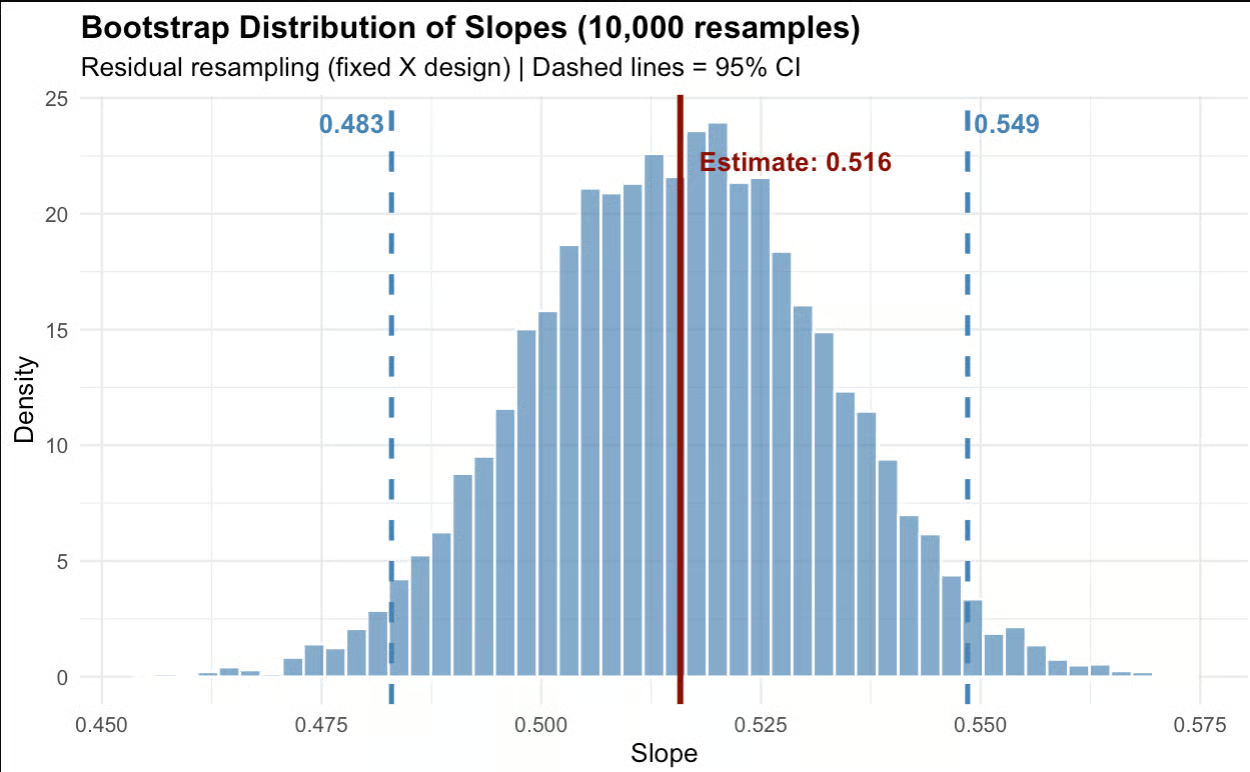
Saya harus mengatakan bahwa saya menyukai hasil ini. Opus 4.5 menemukan interval kepercayaan untuk kemiringan, yang sebenarnya saya minta.
Model ini menggunakan metode bootstrap, yang merupakan teknik bagus untuk mencari interval kepercayaan ketika heteroskedastisitas hadir. Lebih spesifik lagi, model ini menggunakan bootstrap pada residual, bukan metode bootstrap lain yang melakukan resampling pasangan (X,Y), yang akan mengasumsikan ada kesalahan pada variabel X.
Semua ini adalah poin yang lebih halus namun kemungkinan penting bagi orang yang mengerjakan jenis pekerjaan ini: Residual bootstrap lebih baik saat X ditetapkan berdasarkan desain, seperti yang saya tentukan dalam prompt, dan ketika Anda menginginkan inferensi yang bersyarat pada nilai X yang persis sama, seperti pada studi ilmiah. Intinya, Opus 4.5 memperhatikan nuansa dalam prompt.
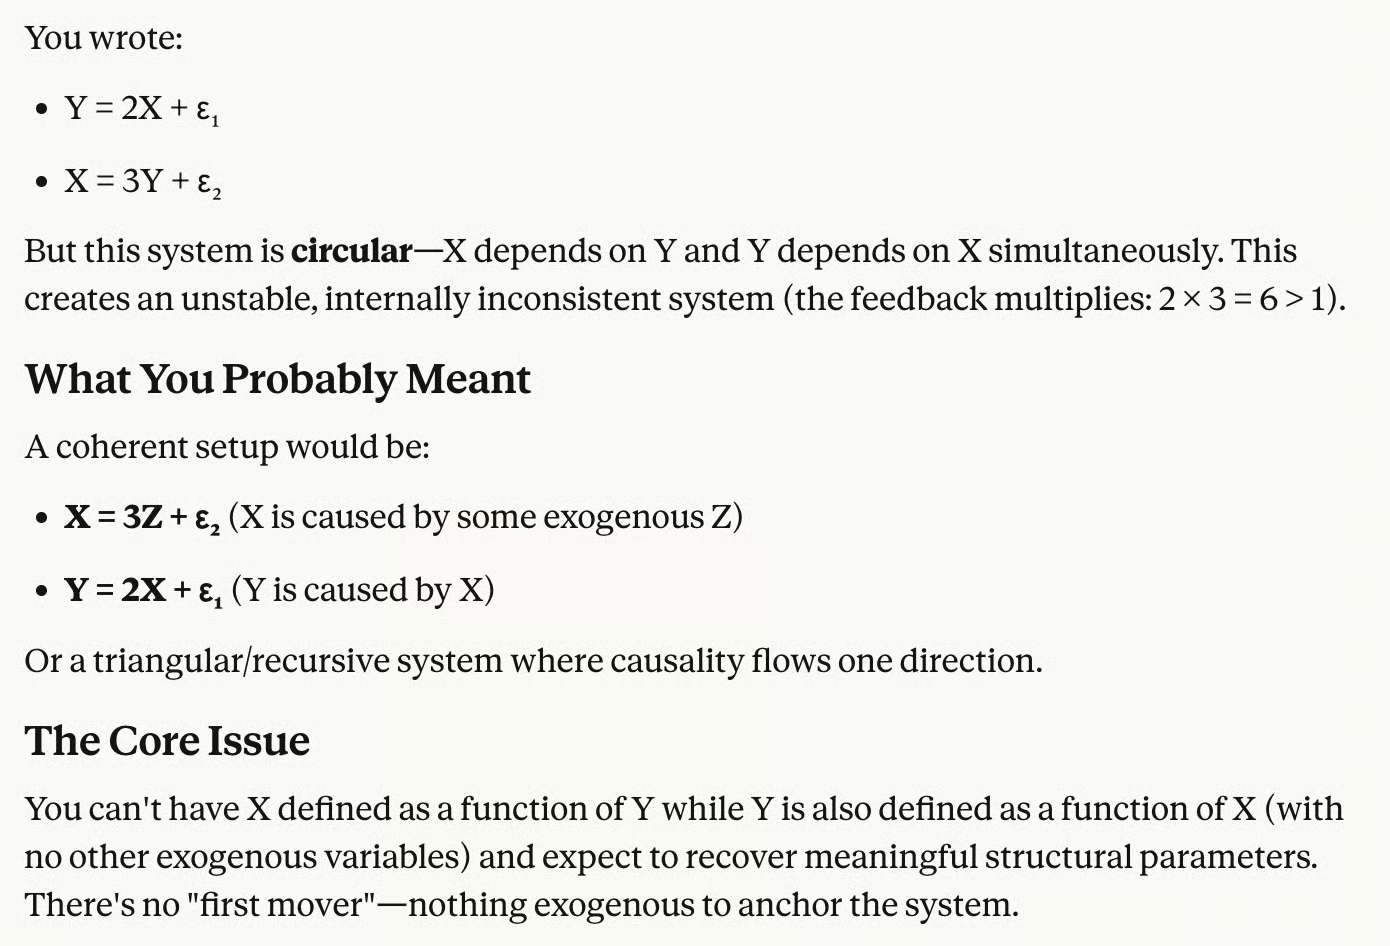
Berikutnya, saya ingin melihat apakah saya bisa menjebak Opus 4.5 dengan cara tertentu.
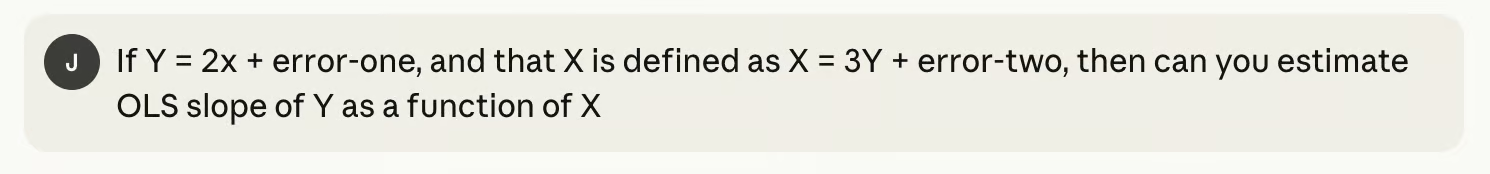
Dalam kasus ini, modelnya jauh lebih cepat dari saya. Opus 4.5 memahami bahwa pertanyaan saya bersifat sirkular - saya mendefinisikan X berdasarkan Y dan sebaliknya, sehingga kita tidak bisa mendapatkan estimasi yang bermakna untuk kemiringan garis regresi, dengan data yang ada.
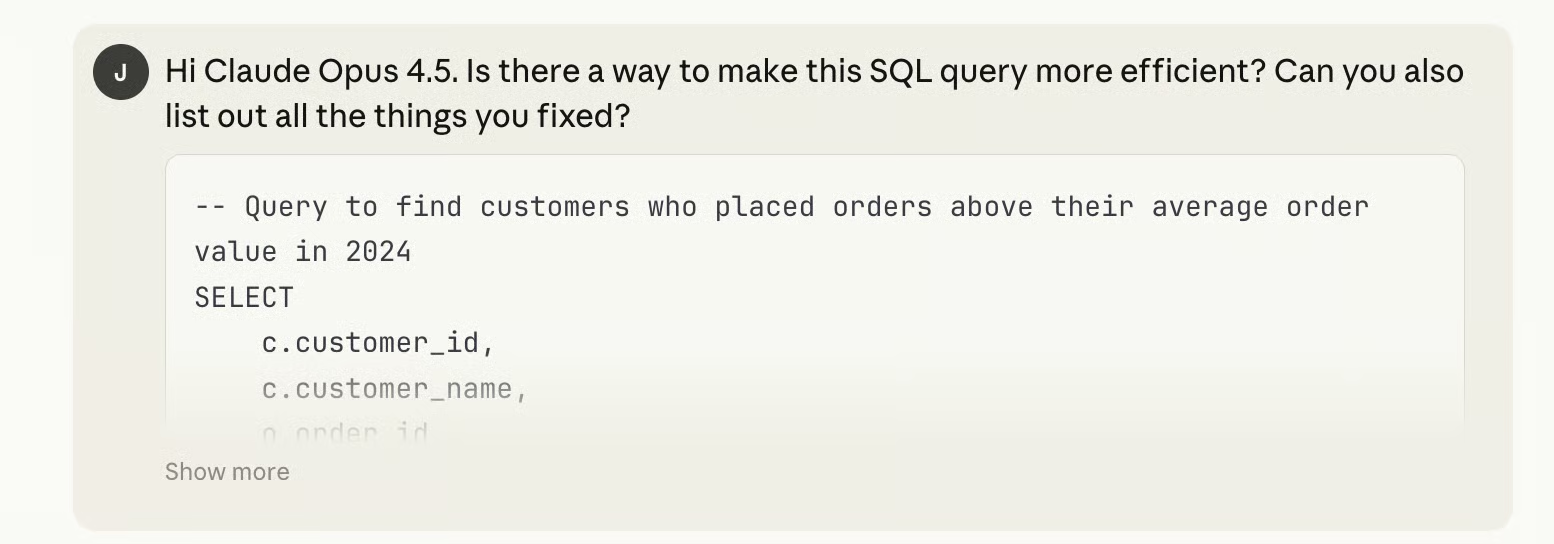
Terakhir, saya pikir akan menyenangkan menguji Opus 4.5 pada pertanyaan SQL. Saya mengirimkan kueri SQL yang dapat berjalan, tetapi sangat tidak efisien.
-- Find customers who placed orders above their average order value in 2024
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > (
        SELECT AVG(o2.order_total)
        FROM orders o2
        WHERE o2.customer_id = c.customer_id
    )
    AND c.customer_id IN (
        SELECT DISTINCT o3.customer_id
        FROM orders o3
        WHERE o3.order_date >= '2024-01-01'
    )
    AND EXISTS (
        SELECT 1
        FROM customer_preferences cp
        WHERE cp.customer_id = c.customer_id
            AND cp.email_opt_in = 1
    )
ORDER BY (
    SELECT COUNT(*)
    FROM orders o4
    WHERE o4.customer_id = c.customer_id
) DESC;
Saya meminta Opus 4.5 untuk memperbaiki kueri tersebut. Ia memberi jawaban dalam sekitar satu detik.
-- Find customers who placed orders above their average order value in 2024
WITH customer_avg AS (
    SELECT
        customer_id,
        AVG(order_total) AS avg_order_total,
        COUNT(*) AS order_count
    FROM orders
    GROUP BY customer_id
)
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
JOIN customer_avg ca ON c.customer_id = ca.customer_id
JOIN customer_preferences cp ON c.customer_id = cp.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > ca.avg_order_total
    AND cp.email_opt_in = 1
ORDER BY ca.order_count DESC;
Antara lain, Opus 4.5 mengganti subkueri berkorelasi untuk AVG dengan CTE. (Kueri asli menghitung ulang AVG(order_total) untuk setiap baris yang dievaluasi, tetapi CTE kini menghitung rata-rata setiap pelanggan sekali di awal.) Opus 4.5 juga menghapus klausa IN (SELECT DISTINCT ...) yang berlebihan, yang hanya menambah kerja tanpa manfaat. Dan ia mengonversi subkueri EXISTS menjadi JOIN, yang lebih baik.
Ada sorotan lain dari rilis terbaru Anthropic ini. Mari kita bahas lebih rinci:
Anthropic menambahkan beberapa blok bangunan baru untuk pengembang. Yang paling menonjol adalah parameter effort, yang memungkinkan Anda mengontrol seberapa banyak pemikiran yang dilakukan model sebelum merespons. Atur rendah untuk tugas cepat dan ringan; atur lebih tinggi ketika Anda perlu model menelaah sesuatu.
Menurut Anthropic, pada effort sedang, Opus 4.5 menyamai skor terbaik Sonnet 4.5 pada SWE-bench sambil menggunakan 76% token keluaran lebih sedikit. Pada effort tinggi, ia mengalahkan Sonnet lebih dari 4% — masih menggunakan hampir separuh token.
Ada juga pengelolaan konteks dan memori yang ditingkatkan. Untuk agen yang berjalan lama, Claude kini dapat secara otomatis merangkum konteks sebelumnya agar tidak macet di tengah tugas. Ini dipasangkan dengan pemadatan konteks, yang membuat agen berjalan lebih lama dengan intervensi lebih sedikit.
Terakhir, Opus 4.5 tampaknya cukup baik dalam orkestrasi multi-agen, yang berarti ia dapat mengelola tim subagen.
Kinerja Opus 4.5 pada evaluasi riset mendalam meningkat sekitar 15%.
Saya menguji sendiri kemampuan riset mendalamnya. Saya memintanya membuat laporan tentang kata-kata Inggris Kuno yang masih bertahan hingga kini tetapi tidak umum digunakan, dan bagaimana jenis kata-kata ini berubah dari waktu ke waktu. Laporannya selesai dalam tujuh menit:
Saya cukup terkesan dengan kualitas laporan dari sisi seberapa menarik, kualitas penulisan, organisasi, dan kedalaman risetnya.
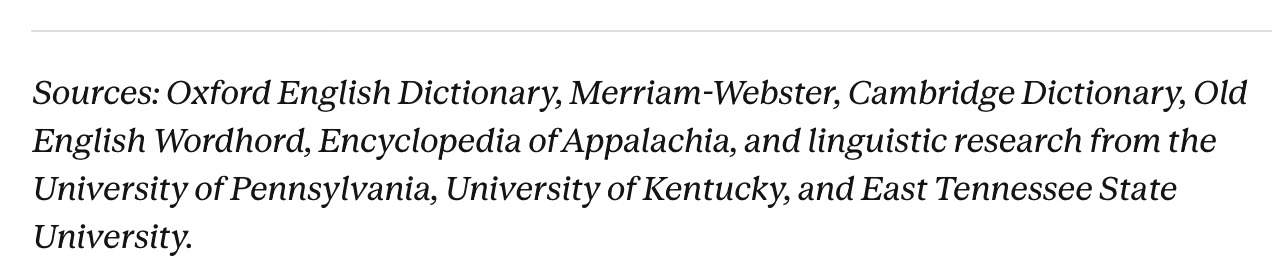
Itu bukan dokumen yang benar-benar kering dan terlalu padat dengan kata-kata arkais atau usang. Saya akui beberapa bagian bisa dibedakan lebih baik. Bagian tengah laporan agak lebih membosankan daripada yang lain. Tetapi—dan ini poin utamanya—laporan tersebut sangat matang secara riset. Lihat saja sitasi-sitasi ini:
Selain itu, saya mempelajari satu kata baru yang sangat bagus: apricity, yang berarti kehangatan matahari di musim dingin.
Anthropic merilis dua peningkatan untuk Claude Code.
Yang disebut Plan Mode kini membangun rencana yang lebih presisi sebelum mengeksekusi. Dalam praktiknya, ini berarti Claude mengajukan pertanyaan klarifikasi di awal, lalu menghasilkan berkas plan.md yang dapat diedit untuk Anda tinjau dan ubah sebelum mulai bekerja. Idenya adalah menyelamatkan Anda dari awal yang keliru.
Integrasi aplikasi desktop adalah peningkatan besar lainnya. Claude Code kini tersedia di aplikasi desktop, yang berarti Anda dapat menjalankan beberapa sesi lokal dan jarak jauh secara paralel. Menggunakan contoh Anthropic sendiri: satu agen memperbaiki bug, yang lain meneliti isu GitHub, dan yang ketiga memperbarui dokumentasi.
Beberapa fitur agentik telah hadir di aplikasi konsumen Claude:
Claude for Chrome memungkinkan Claude menangani tugas di seluruh tab browser Anda. Kini tersedia untuk semua pengguna Max. Anggap saja sebagai agen penjelajahan yang dapat menavigasi, mengeklik, mengisi formulir, dan menarik informasi dari berbagai situs.
Claude for Excel menghadirkan otomatisasi spreadsheet ke Claude. Yang satu ini telah diumumkan sebelumnya, tetapi Anthropic kini memperluas akses beta ke semua pengguna Max, Team, dan Enterprise, sehingga menjadi lebih nyata.
Penanganan percakapan panjang memperbaiki batasan yang cukup mengganggu. Sebelumnya, obrolan panjang akan mencapai batas konteks dan berhenti, sehingga Anda harus memulai percakapan baru. Kini Claude secara otomatis merangkum bagian awal percakapan di latar belakang, yang membebaskan ruang agar Anda tidak mentok.
Opus 4.5, seperti model Claude sebelumnya, diuji pada tolok ukur umum dalam pengodean agentik, penggunaan alat, penggunaan komputer, dan pemecahan masalah. Berikut hasil utama untuk Opus 4.5.
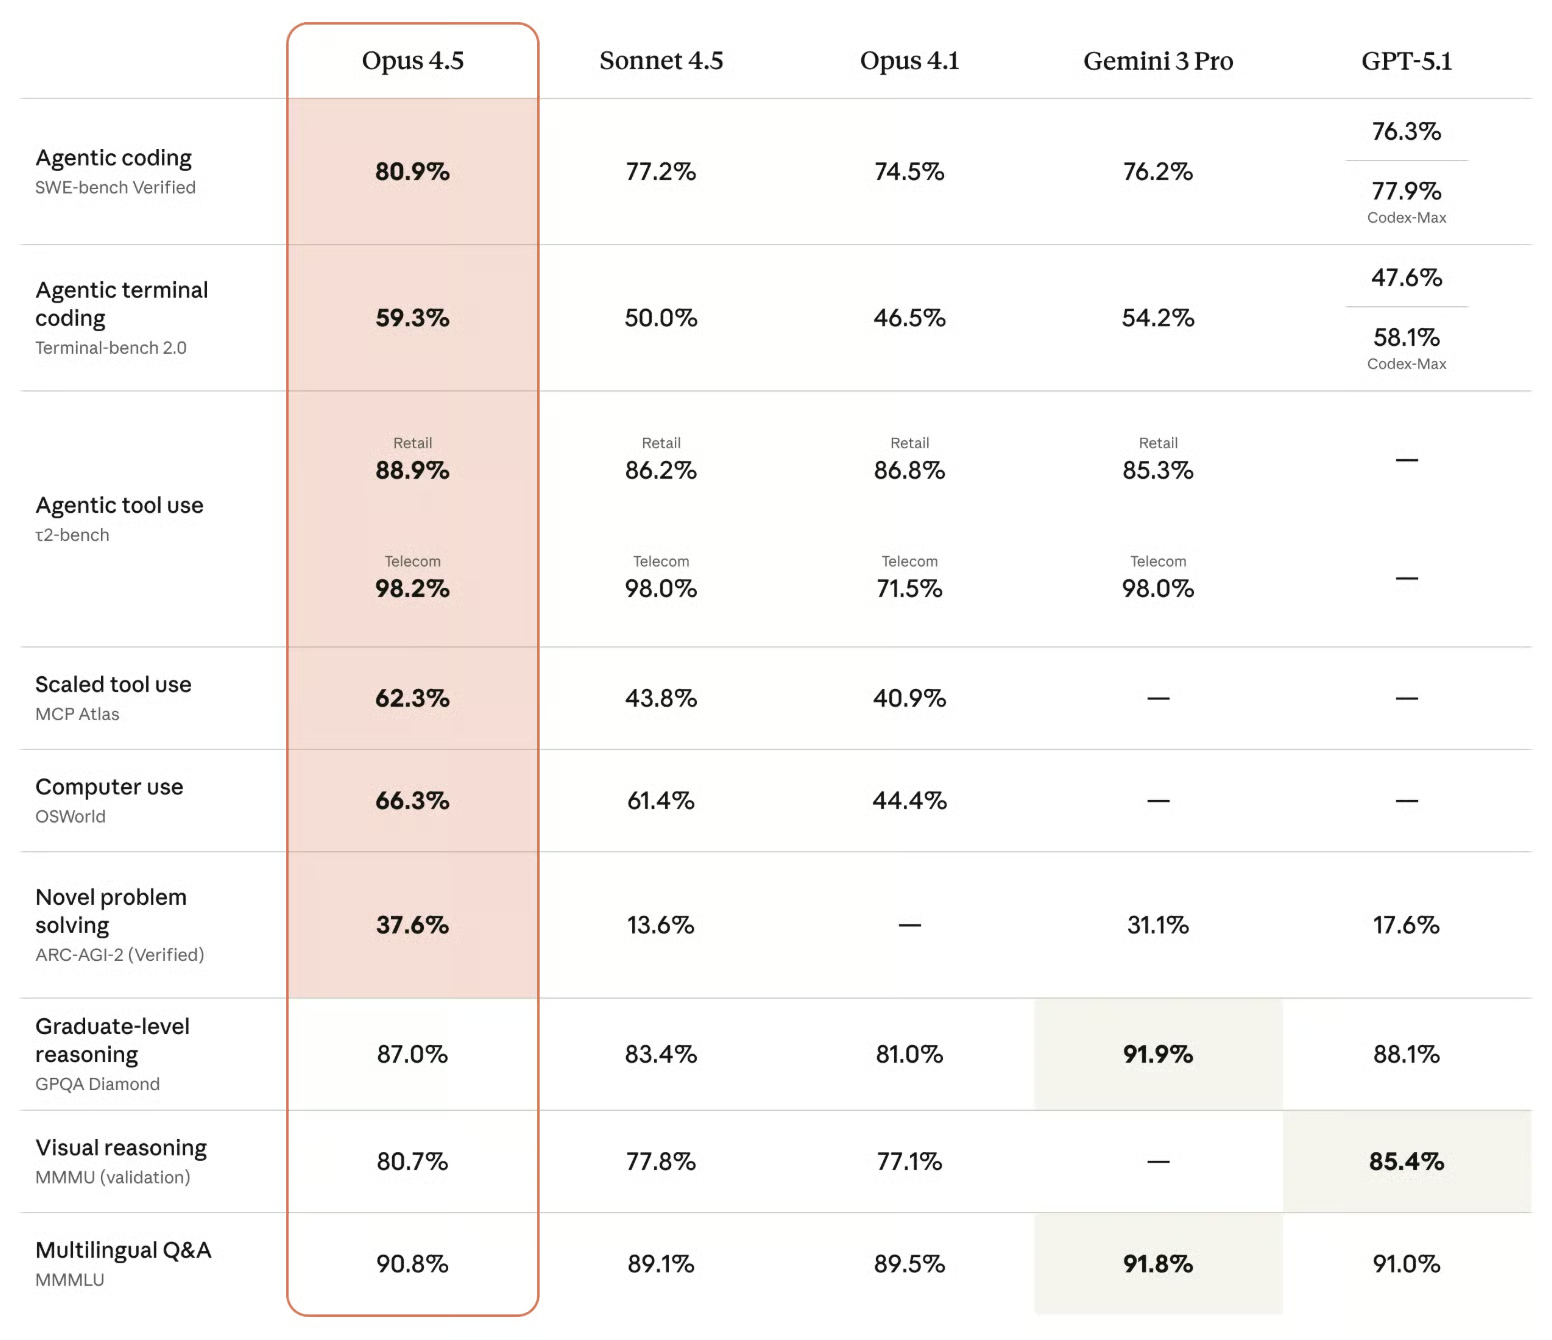
Opus 4.5 meraih peringkat teratas di banyak pengujian paling penting. Apa pun yang melibatkan tindakan nyata, seperti menulis kode yang lolos uji (SWE-bench), menggunakan alat dalam alur kerja multi-langkah (τ2-bench, MCP Atlas), dan mengoperasikan komputer (OSWorld). Opus 4.5 memimpin, sering kali dengan selisih besar.
Kesenjangan penggunaan alat skala juga sangat besar: 62,3% vs. 43,8% untuk pesaing terbaik berikutnya, yang juga Claude! Namun, ini menunjukkan betapa besar investasi Anthropic untuk meningkatkan performanya, khususnya pada tugas-tugas agentik. Meskipun model lama mereka mungkin saat ini memimpin di beberapa kategori, mereka tidak memperlambat kemajuan.
Tampaknya Gemini 3 Pro unggul pada beberapa tolok ukur yang intensif pengetahuan, seperti penalaran tingkat pascasarjana (GPQA Diamond) dan tanya jawab multibahasa (MMMLU). Tolok ukur ini mungkin memberi imbalan pada keluasan data pelatihan dan penalaran cermat atas fakta-fakta yang dihafal, dan Google, tentu saja, memiliki banyak sumber daya.
Peningkatan dari Anthropic tidak hanya seputar pengodean, riset, dan penggunaan komputer. Ada penekanan besar pada keamanan, dengan klaim bahwa model ini adalah yang paling aman dan ‘paling selaras secara andal’ yang pernah mereka rilis.
Klaim ini didukung oleh penurunan apa yang mereka sebut ‘skor perilaku yang mengkhawatirkan’, yang lebih rendah daripada model 4.5 lainnya, serta GPT-5.1 dan Gemini 3 Pro. Anthropic juga membuat Opus 4.5 lebih tangguh terhadap serangan injeksi prompt, yang dapat menipu model melakukan perilaku berbahaya.
Claude Opus 4.5 tersedia hari ini di seluruh lini produk Anthropic, termasuk aplikasi Claude, API, dan ketiga platform cloud utama. Pengembang dapat mengaksesnya langsung melalui ID model claude-opus-4-5-20251101.
Harga juga turun cukup signifikan. Dengan tarif $5 per satu juta token masukan dan $25 per satu juta token keluaran, Opus 4.5 membuat kapabilitas kelas atas Anthropic jauh lebih terjangkau.
Bagi pengguna enterprise, perubahan harga ini bisa sangat berarti. Kombinasi biaya yang lebih rendah, akses API yang diperluas, dan ketersediaan yang lebih luas di berbagai penyedia cloud menempatkan Opus 4.5 sebagai opsi yang kompetitif.
Claude Opus 4.5 adalah pernyataan paling jelas Anthropic tentang posisi mereka dalam perlombaan AI. Sementara Google mendorong pemahaman multimodal dan model di perangkat, Anthropic bertaruh besar pada tindakan: pengodean agentik, penggunaan alat, dan interaksi komputer.
Hasil benchmark benar-benar menceritakan segalanya: Opus 4.5 meraih skor tertinggi yang pernah tercatat pada tolok ukur rekayasa perangkat lunak dan menangani debugging multi-sistem tanpa banyak arahan.
Pengujian saya menegaskan apa yang disiratkan tolok ukur: Opus 4.5 sangat andal untuk pekerjaan multi-langkah. Baik saat menjalankan simulasi bootstrap maupun mensintesis riset lintas makalah, model ini mendekati masalah seperti seorang pemikir: adaptif dan dengan penalaran yang jelas. Jika Anda ingin meningkatkan alur kerja, inilah yang penting.
Jika Anda ingin mempelajari lebih lanjut tentang model Claude, saya sarankan mengikuti kursus Introduction to Claude Models.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt





