
Last chance! 50% off DataCamp Premium
Sale ends in
Aggiornamento: Da quando abbiamo pubblicato questo articolo, OpenAI ha rilasciato diversi nuovi modelli. Per restare aggiornato, dai un'occhiata anche alle nostre guide su GPT-5.4, GPT-5.3-Codex e GPT-5.3-Instant.
È passato solo un mese dal lancio di GPT-5.1. Ma un mese è tantissimo nel mondo dell'IA. Nel frattempo, Google ha rilasciato Gemini 3, che ha conquistato il primo posto nella maggior parte dei benchmark più seguiti, e Antropic ha rilasciato Claude Opus 4.5, che ancora una volta ha dominato la classifica nell’ingegneria del software.
OpenAI vuole presentarsi come l’azienda più attrezzata per offrire valore al business. Ma dopo essere scivolata in classifiche chiave, potrebbe aver temuto di perdere utenti o persino clienti enterprise. Secondo quanto riportato, quella pressione ha innescato un “codice rosso” e spinto il team ad accelerare il rilascio di GPT-5.2.
In questo articolo, ti aiuterò a capire tutto ciò che è stato annunciato con l’uscita di GPT-5.2, incluso cosa possono ottenere le aziende dai tre nuovi modelli, attualmente in rollout su ChatGPT per tutti gli utenti a pagamento (e ora disponibili nell’API). Puoi anche consultare la nostra guida allo strumento Immagini di ChatGPT e ai due modelli più recenti, GPT-5.3 Codex e GPT-5.2 Instant.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’IA inviando The Median, la nostra newsletter gratuita del venerdì che spiega le storie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
GPT-5.2 porta miglioramenti specifici e mirati in ragionamento, memoria e uso degli strumenti. Nella narrazione di OpenAI, questi upgrade si traducono in workflow aziendali migliori e meno punti di rottura nel tuo lavoro. Ciascuno dei tre modelli della serie adotta un approccio diverso per offrire quel valore.
GPT-5.2 Instant dà priorità alla bassa latenza e ai tempi di risposta rapidi. È presentato come il mulo da lavoro quotidiano per recuperare informazioni, fare drafting e tradurre. È il modello con cui la maggior parte delle persone interagirà di default, e il suo vantaggio è il throughput più che la profondità. In pratica, colma il vuoto quando ti servono risposte rapide o automazioni leggere senza pagare per un ragionamento più pesante.
GPT-5.2 Thinking incorpora capacità di ragionamento esteso che consentono al modello di affrontare problemi complessi passo dopo passo prima di fornire la risposta.
Nei benchmark interni di OpenAI, è il modello che stabilisce nuovi massimi per lavoro di conoscenza, coding e task a lungo contesto, soprattutto quando può usare strumenti come fogli di calcolo e presentazioni.
È il tentativo di OpenAI di creare un motore general-purpose per la knowledge work, ed è il modello che scegli quando l’accuratezza migliora con un pensiero deliberato. Per molte organizzazioni, sarà la scelta per analisi, workflow multi-step e task agentici.
Questo è il top di gamma, pensato per i clienti enterprise.
È anche l’opzione più costosa della linea perché pensata per scenari ad alto rischio, dove i guadagni incrementali in qualità del ragionamento, accuratezza fattuale e problem solving astratto giustificano il costo per token più elevato.
Pro è destinato a contesti in cui gli errori costano, e dove i team hanno bisogno di un modello che mantenga coerenza su contesti molto lunghi. È il modello per sistemi di supporto alle decisioni, pianificazione complessa e qualsiasi carico in cui l’affidabilità conta quanto la potenza grezza.
GPT-5.2 è già in rollout. OpenAI ha lanciato ufficialmente il modello l’11 dicembre 2025, con accesso prioritario ai piani ChatGPT a pagamento e disponibilità in espansione tra regioni e piattaforme. Gli utenti possono accedere a tutti e tre i modelli GPT-5.2 direttamente dentro ChatGPT, e gli sviluppatori possono usarli tramite l’API di OpenAI attraverso gli endpoint Responses e Chat Completions.
Il rilascio di GPT 5.1 era stato notoriamente avaro di risultati sui benchmark perché si concentrava sull’esperienza utente. Non sorprende quindi che GPT 5.2 stia cercando di raddrizzare la rotta puntando maggiormente sui risultati.
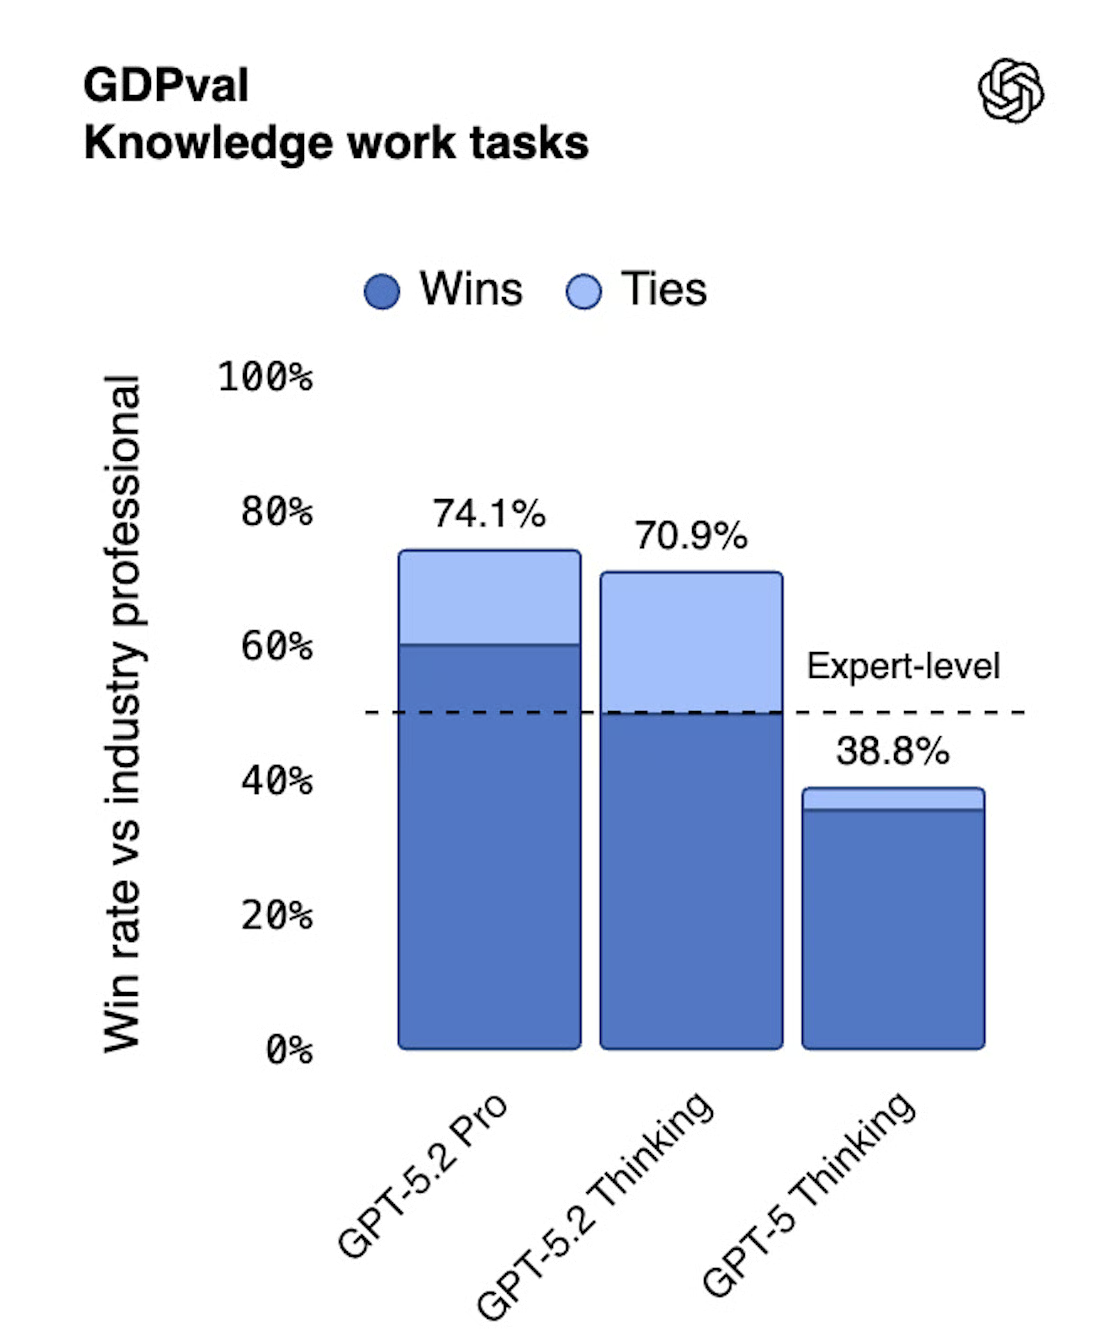
GDPval è il risultato di benchmark più messo in evidenza nel nuovo rilascio. Ma è stato introdotto su arXiv solo a inizio ottobre 2025, quindi mettere in luce questo benchmark rivela molto sulla natura del rilascio.
GDPval è un test dei compiti che i professionisti svolgono ogni giorno sul lavoro, come creare report e presentazioni. Le domande del test sono prese da 44 professioni nei nove settori che più contribuiscono al PIL degli Stati Uniti. Include tutto, da un’infermiera a un data scientist fino a un professore universitario. I task richiedono prodotti di lavoro reali, come fogli di calcolo, libri contabili, video e presentazioni.
Il secondo benchmark più evidenziato in questo rilascio è SWE-Bench Pro, una valutazione difficile di ingegneria del software su cui GPT-5.2 ha ottenuto il 55,6%. SWE-Bench Pro richiede di risolvere issue di lungo raggio da repository reali, problemi che comportano, ad esempio, modifiche a più file.
Potresti aver sentito parlare di SWE-bench Verified, che è una versione più semplice del test. Su questo, GPT 5.2 ha segnato l’80%. Per contesto, di recente abbiamo riportato che Claude Opus 4.5 ha ottenuto l’80,9% in questo test, quindi i due modelli sono grossomodo comparabili.
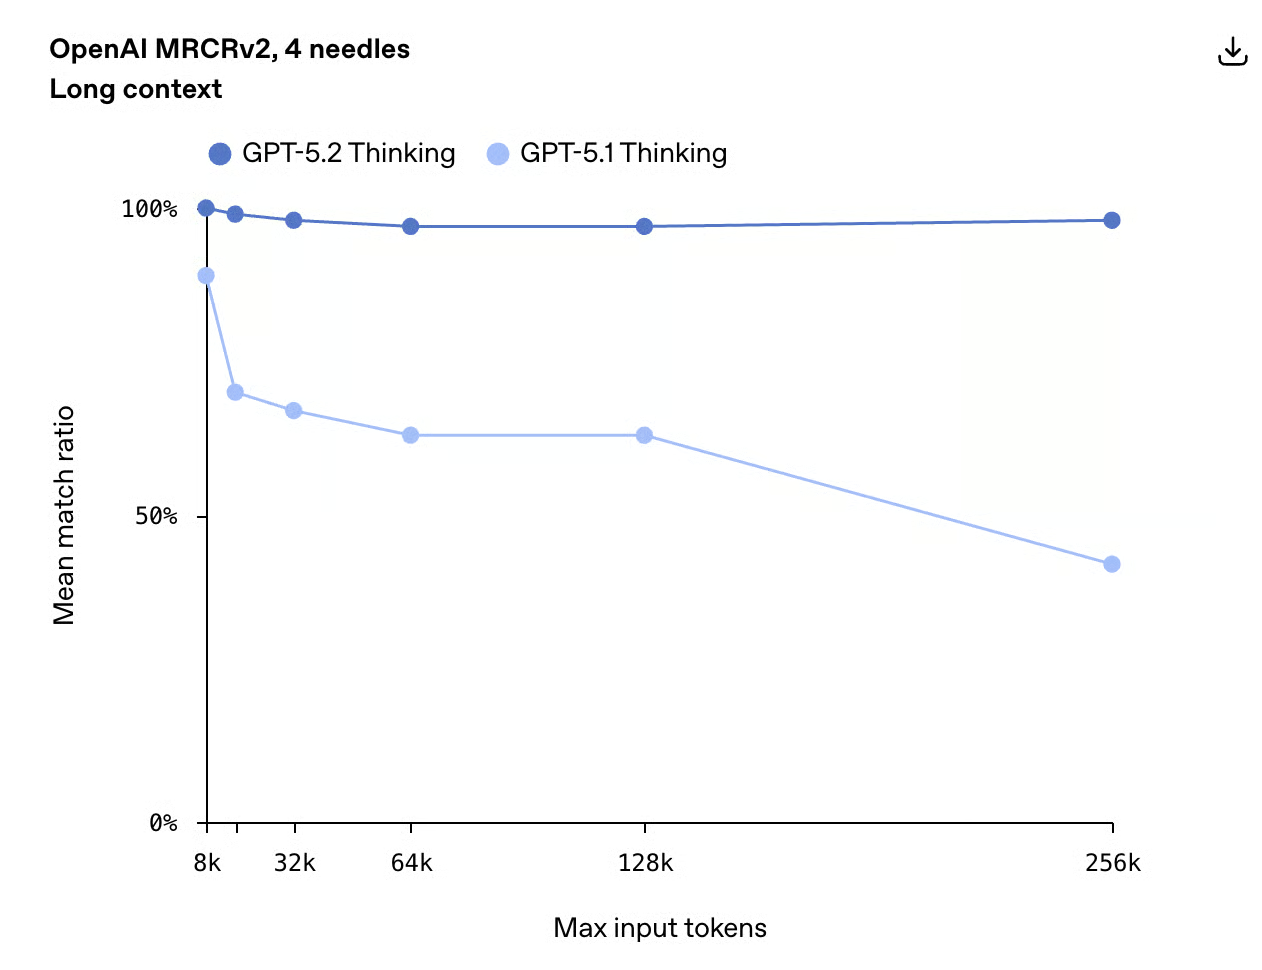
GPT 5.2 mostra ottime prestazioni in un altro benchmark chiamato MRCR v2, che sta per Multi-Round Coreference Resolution (versione 2). Ottiene un punteggio quasi perfetto, che OpenAI vuole farci intendere significhi che possiamo usare GPT 5.2 per lavorare con documenti lunghi.
A suo merito, raggiunge un’accuratezza quasi perfetta fino a 256k token. Sono circa duecentomila parole, più o meno la dimensione di un romanzo.
OpenAI ha affermato con sicurezza che GPT 5.2 porta grandi miglioramenti in intelligenza, comprensione di lunghi contesti, tool-calling agentico e visione, quindi ha senso valutare ognuno di questi aspetti a turno.
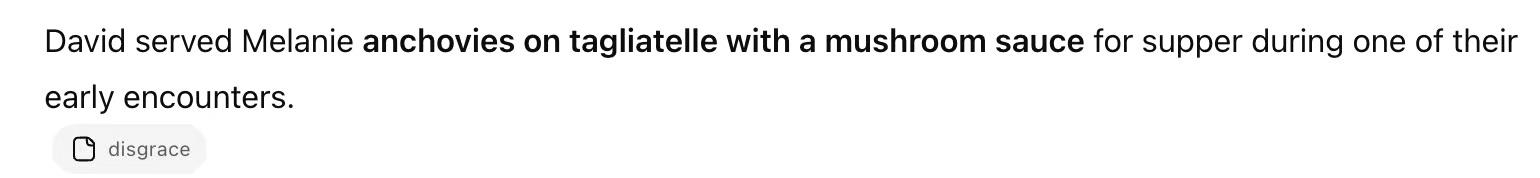
Per testare la comprensione del lungo contesto di GPT-5.2, ho caricato una versione online del romanzo di J.M. Coetzee, Disgrace. Poi ho chiesto al modello di dirmi un piccolo dettaglio, facile da dimenticare, nascosto in un lungo passaggio.
Ho chiesto a GPT-5.2 una risposta a questa domanda:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 ha trovato la risposta giusta, anche se a me sembrava un dettaglio da ago nel pagliaio. Questa cena è menzionata una sola volta nel libro, e l’evento non ha una vera importanza narrativa.
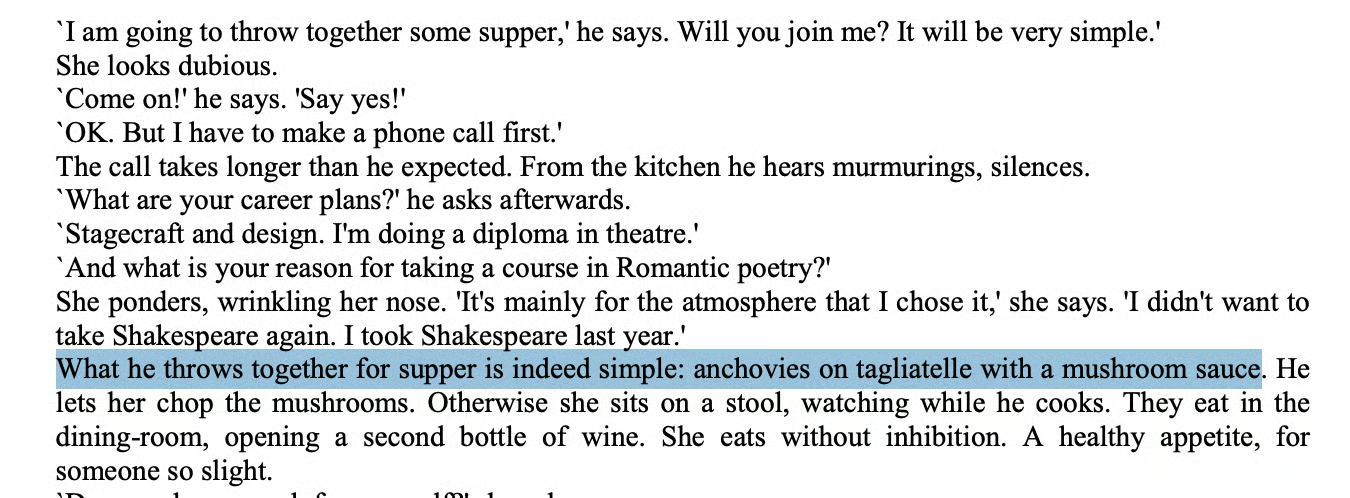
Questo test mi ha dimostrato che il recupero di GPT-5.2 non si basa su pattern guessing ma su una reale ritenzione lungo una sequenza estesa.
Questo tipo di ritenzione conta perché la vera performance su lunghi contesti riguarda il mantenimento di uno stato granulare su vaste porzioni di testo. Se un modello può ricordare una ricetta di una cena fugace sepolta in una narrazione di 90 pagine, può tracciare variabili in un codebase, clausole legali in un contratto o dettagli finanziari in un report di 200 pagine.
Per testare le capacità agentiche di GPT-5.2, gli ho dato un compito che richiede navigazione e click. Gli ho chiesto di comportarsi come un agente autonomo per la ricerca di appartamenti. Questa capacità sarebbe utile a chi vuole trasferirsi ma è troppo impegnato per setacciare i siti di affitti in prima persona.
Il modello doveva usare un browser, applicare filtri, entrare negli annunci, estrarre dettagli e assemblare un report comparativo.
Ecco in sostanza il prompt:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
Questa impostazione del prompt è stata pensata per testare in un colpo solo ragionamento di lungo raggio, tool-calling e interazione con la UI.
GPT-5.2 ha navigato su un sito di annunci, impostato i filtri e lavorato sui risultati in autonomia. È entrato nei singoli immobili, ha estratto campi strutturati, ha scelto sia un quartiere che una fascia di prezzo (avrei potuto chiedere io questi filtri, ma in realtà non sto cercando casa), e poi ha compilato una piccola short list con ranking.
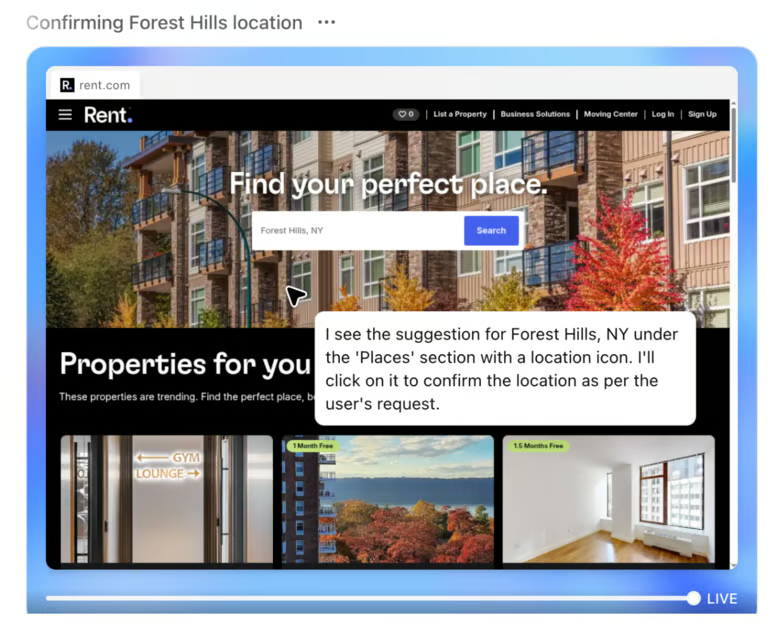
Sono certo che la ricerca non fosse perfetta. Ho visto nel trace del modello che alcuni siti bloccavano lo scraping, ma l’agente si è ripreso cambiando sito e, alla fine, ha comunque prodotto un set di raccomandazioni utilizzabile.
Una cosa che ho notato nella tabella finale è che il modello non mi ha fornito URL reali; al loro posto, ha dato quei riferimenti in stile screenshot. Questo perché la maggior parte dei siti di affitti blocca l’accesso automatico, e lo strumento di browsing non è autorizzato a estrarre o condividere i link effettivi degli annunci. Quando succede, inserisce solo un puntatore allo screenshot catturato nel sandbox. Questa parte è stata un po’ fastidiosa.
Volevo vedere quanto si spingessero queste capacità agentiche in un dominio con molte meno fonti di dati pulite, quindi ho provato un secondo esperimento in ambito genealogico.
Ho chiesto a GPT-5.2 di indagare se membri della famiglia Waples compaiono nei registri parrocchiali inglesi e se potesse esserci un legame storico o genealogico con l’Herefordshire.
GPT-5.2 ha intrapreso azioni specifiche, come accedere a un sito di genealogia gratuito e cliccare tra le pagine per trovare e scaricare registri.
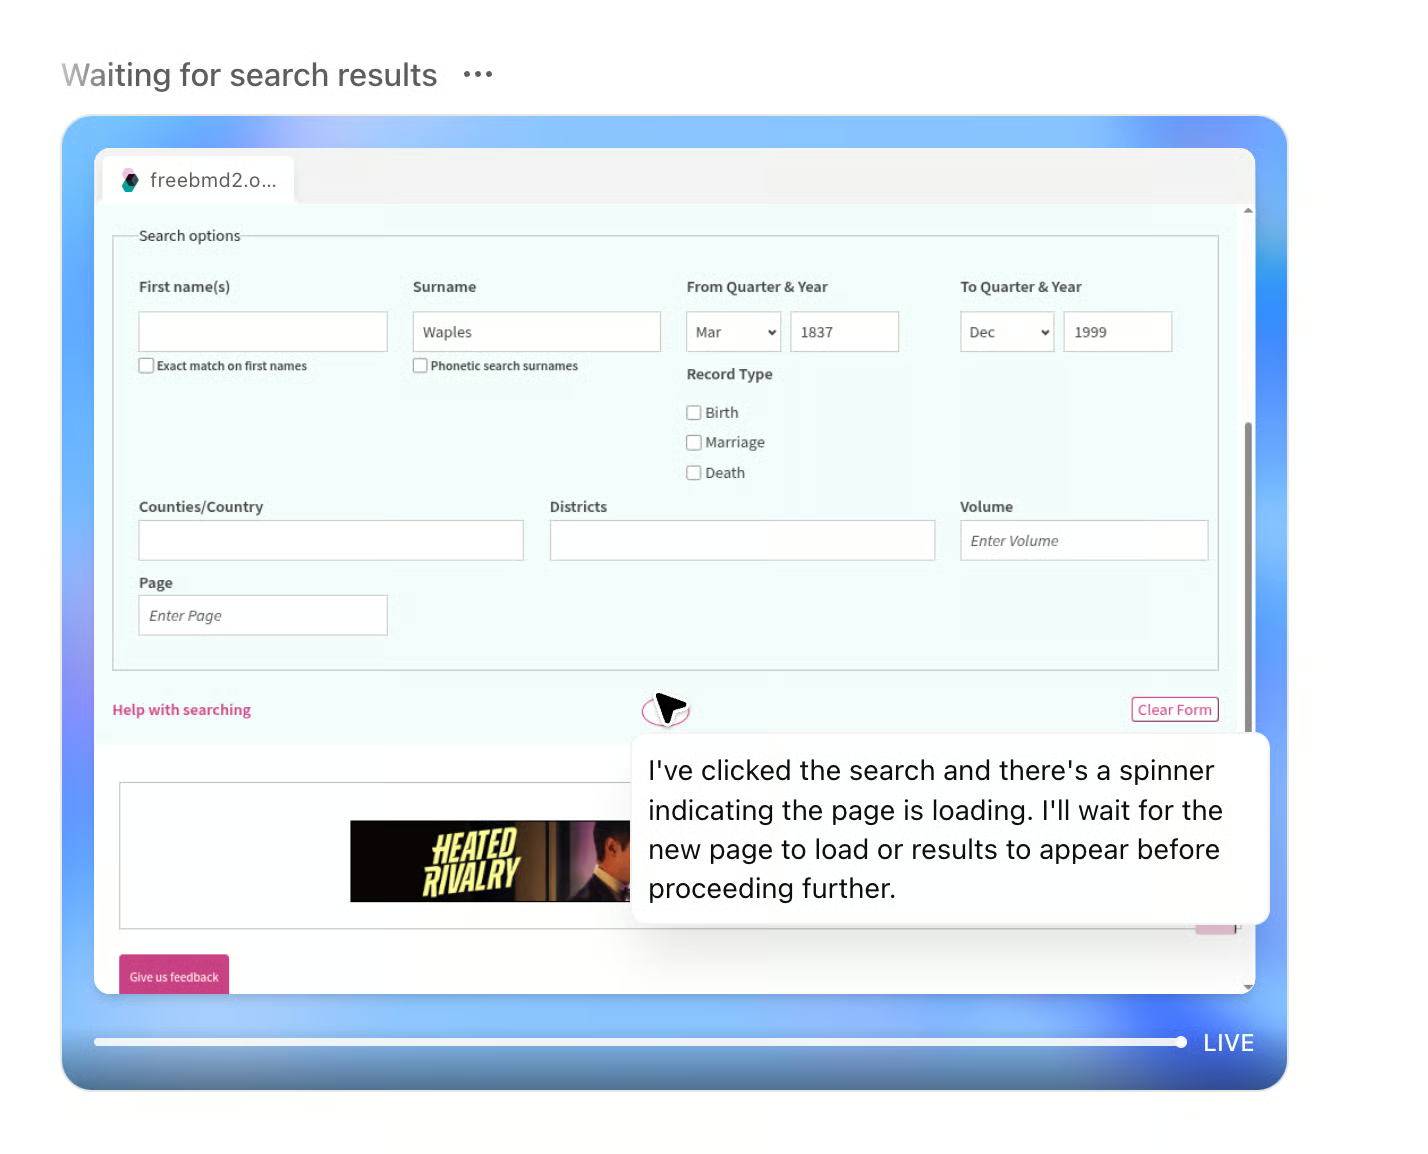
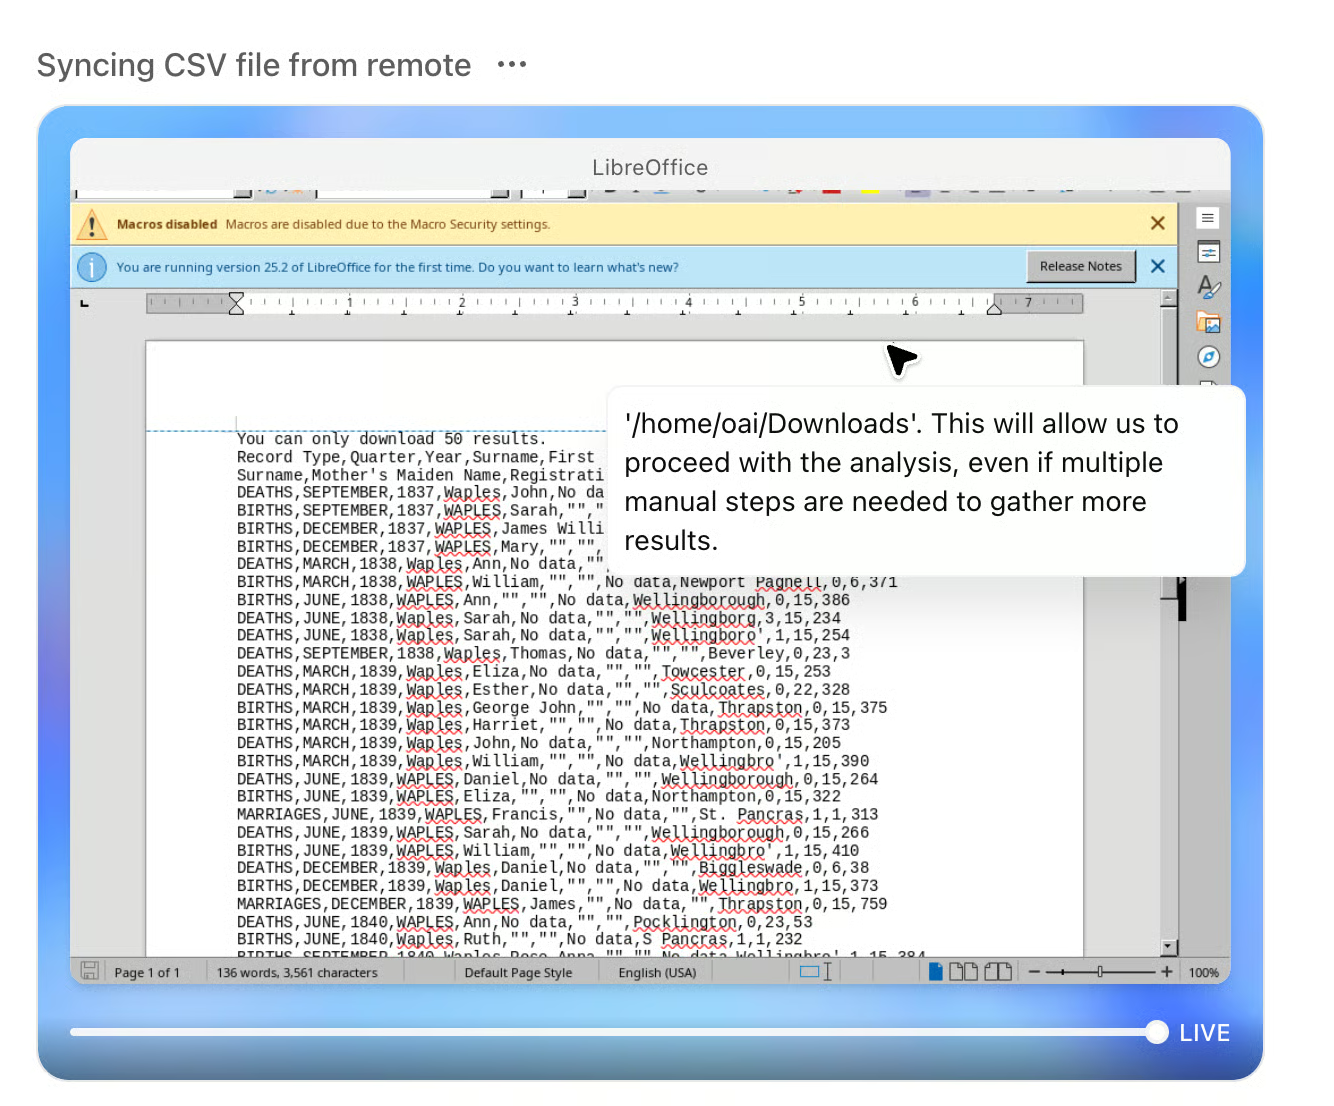
Il modello ha scomposto il problema in sotto-task, ha eseguito ricerche in risorse come FreeBMD e Forebears, e ha persino abbozzato un’email di richiesta mirata per reperire documenti non digitalizzati.
Allo stesso tempo, ho capito che la genealogia come dominio di ricerca impone limiti rigidi. Molte fonti chiave, come registri parrocchiali o presentment rolls, esistono solo negli archivi o dietro cataloghi con accesso ristretto. FreeBMD impone un limite di 50 record scaricabili, il catalogo di HARC non è accessibile senza cookie di sessione, e i documenti storicamente rilevanti si ottengono davvero tramite servizi di ricerca a pagamento.
Il modello può riconoscere queste barriere e suggerire i passi successivi, ma non può oltrepassarle. Questo test non ha prodotto nulla di molto utile, ma non è stata colpa del modello.
Tutto ciò dimostra perché OpenAI è concentrata sui casi d’uso aziendali, perché è lì che c’è l’opportunità. Ma è un buon promemoria che molti dati sono ancora offline, frammentati, dietro paywall o chiusi dietro porte reali.
Per il mio test finale, ho caricato un Sudoku come prova sia di visione che di intelligenza generale.
Il Sudoku in sé non è matematica pesante perché è vincolato. Ma quando il puzzle è mostrato come immagine e non come testo strutturato, il modello deve usare più abilità insieme: leggere la griglia, preservare i “dati iniziali” e poi applicare la logica per risolverlo.
can you fill out this sudoku for meL’immagine non era disegnata alla perfezione, ma questo faceva parte del test:
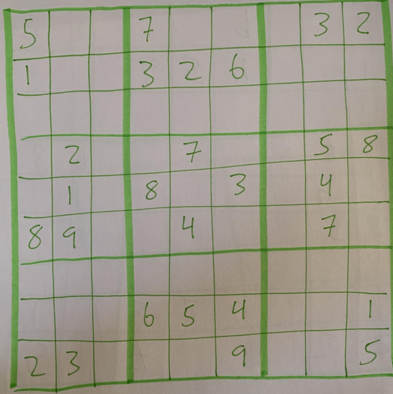
GPT-5.2 mi ha restituito un puzzle corretto, ma ha sostituito almeno uno dei numeri preimpostati che non avrebbe dovuto toccare. Si potrebbe dire che abbia “imbrogliato” senza volerlo.
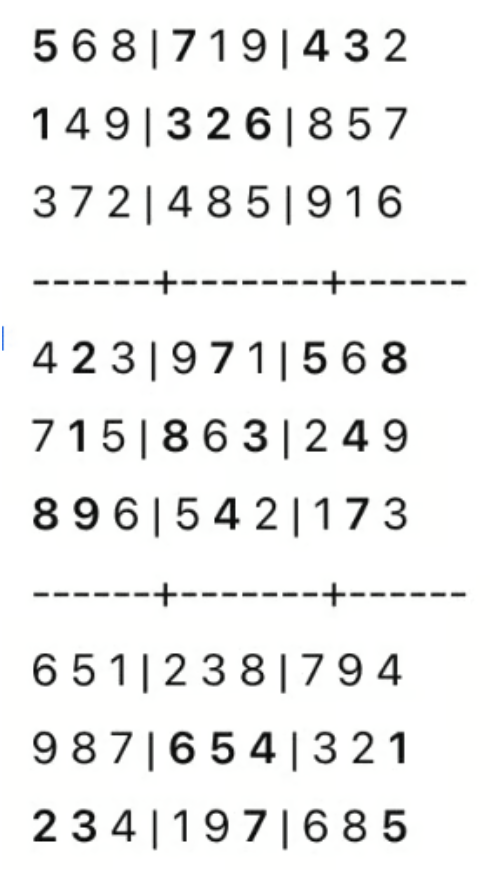
Questo tipo di errore non è un fallimento del ragionamento. È più un problema di visione e fedeltà. Il modello o ha letto male una cella data, o non ha capito quali fossero posizioni fisse, oppure ha perso i vincoli mentre convertiva l’immagine in una griglia interna.
I test che ho eseguito sopra mostrano cosa puoi fare dentro ChatGPT, ma la vera flessibilità arriva quando passi all’API, dove controlli tu stesso lo sforzo di ragionamento, i budget di token e le integrazioni degli strumenti.
Tutti e tre i modelli sono ora disponibili attraverso le Responses API e Chat Completions API di OpenAI:
|
Modello |
Stringa modello API |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
Ecco i costi:
Due aggiunte per power user: un’impostazione di sforzo di ragionamento 1xhigh1 e un endpoint /compact che estende la finestra di contesto effettiva per workflow di lunga durata.
Diamo un’occhiata a come GPT-5.2 si confronta con gli altri recenti rilasci:
Gemini 3, rilasciato a metà novembre, ha stracciato i punteggi in molti dei benchmark più osservati. Detiene il primo posto su Humanity's Last Exam e batte anche GPT-5.2 Pro su GPQA Diamond, ma di poco (93,8% vs 93,2%).
Il grande incremento di performance di Gemini riflette probabilmente miglioramenti sia nell’implementazione della mixture-of-experts sia nell’infrastruttura di training. Gemini 3 usa un instradamento sparso a livello di token, ed è stato addestrato sull’infrastruttura TPU personalizzata di Google. Dove GPT-5.2 sta andando bene ora è sui benchmark di lavoro professionale come GDPval e sulle valutazioni di tool-calling per l’impresa. È qui che OpenAI ha chiaramente concentrato i suoi sforzi.
Claude Opus 4.5, rilasciato a fine novembre, ha seguito una strada diversa. Anthropic si è concentrata su quella che ha definito “hybrid reasoning” — combinare pensiero esteso con un’intelligenza di base più forte — e il risultato è un modello che eccelle nell’ingegneria del software e nei task open-ended. Su SWE-bench Verified, Opus 4.5 ottiene l’80,9%, poco sopra l’80% di GPT-5.2.
Dove i modelli divergono è nello stile: Opus 4.5 tende a risposte più lunghe e deliberative, mentre GPT-5.2 Thinking enfatizza l’uso di strumenti e output strutturati come fogli di calcolo e presentazioni. Per agenti di coding e refactor complessi sono di fatto alla pari; per workflow enterprise che coinvolgono slide e report, OpenAI scommette che GPT-5.2 abbia il vantaggio.
C’è stata anche molta attenzione ai risultati dei benchmark sui GPT, e in OpenAI dev’esserci molta pressione per consegnare. Un mese fa, il rilascio di GPT 5.1 è stato oscurato da Gemini 3. Ora, con GPT 5.2, OpenAI arriva seconda, di poco, a Gemini 3 su GPQA e seconda, di poco, a Claude Opus 4.5 su SWE-Bench Verified, il che deve essere frustrante per il team.
OpenAI ha invece messo in evidenza le alte prestazioni su GDPval e SWE-Bench Pro, ma soprattutto il primo test è oscuro rispetto agli standard di settore che fanno notizia. Si potrebbe pensare che OpenAI stia cercando di raccontare una storia vincente senza richiamare troppo l’attenzione alle classifiche in cui attualmente è dietro.
Ma la corsa è apertissima e queste aziende hanno ancora molto margine per dimostrare il proprio valore. Una cosa che osserveremo in particolare è come i nuovi modelli si comporteranno nel prossimo benchmark ARC-AGI-3, attualmente in sviluppo.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




