
{count, plural, one {Khóa học} other {Khóa học}}
Hiểu về Trí tuệ Nhân tạo
{hours} giờ
428K
Cập nhật: Kể từ khi chúng tôi xuất bản bài viết này, OpenAI đã phát hành một số mô hình mới. Để cập nhật, hãy xem thêm các hướng dẫn của chúng tôi về GPT-5.4, GPT-5.3-Codex và GPT-5.3-Instant.
Mới chỉ một tháng kể từ khi chúng ta chứng kiến GPT-5.1 ra mắt. Nhưng một tháng là khoảng thời gian rất dài trong thế giới AI. Trong thời gian đó, Google phát hành Gemini 3, vươn lên dẫn đầu trên hầu hết các bài kiểm tra điểm chuẩn được dõi theo nhiều nhất, và Antropic phát hành Claude Opus 4.5, một lần nữa đứng đầu bảng xếp hạng trong lĩnh vực kỹ nghệ phần mềm.
OpenAI muốn thể hiện mình là công ty có khả năng mang lại giá trị kinh doanh tốt nhất. Nhưng sau khi tụt hạng trên các bảng xếp hạng then chốt, hãng có thể lo sợ mất người dùng hoặc thậm chí khách hàng doanh nghiệp. Theo các báo cáo, áp lực đó đã kích hoạt một “báo động đỏ” và thúc đẩy nhóm đẩy nhanh việc phát hành GPT-5.2.
Trong bài viết này, tôi sẽ giúp bạn hiểu mọi thứ được công bố cùng việc ra mắt GPT-5.2, bao gồm những gì doanh nghiệp có thể nhận được từ ba mô hình mới, hiện đang được triển khai trong ChatGPT cho tất cả người dùng trả phí (và đã có trên API). Bạn cũng có thể xem hướng dẫn về công cụ Hình ảnh ChatGPT và về hai mô hình mới hơn, GPT-5.3 Codex và GPT-5.2 Instant.
Chúng tôi luôn cập nhật cho độc giả những điều mới nhất trong AI thông qua The Median, bản tin miễn phí ngày thứ Sáu phân tích các câu chuyện quan trọng nhất trong tuần. Đăng ký để luôn sắc bén chỉ với vài phút mỗi tuần:
GPT-5.2 mang đến những cải tiến cụ thể và có mục tiêu về suy luận, bộ nhớ và khả năng dùng công cụ. Theo cách diễn giải của OpenAI, các nâng cấp này chuyển hóa thành quy trình công việc doanh nghiệp tốt hơn và ít điểm lỗi hơn trong quá trình làm việc. Mỗi trong ba mô hình của dòng này có một cách tiếp cận khác nhau để mang lại giá trị đó.
GPT-5.2 Instant ưu tiên độ trễ thấp và tốc độ phản hồi nhanh. Nó được định vị là “máy kéo” hằng ngày để lấy thông tin, soạn thảo và dịch thuật. Đây là mô hình đa số người dùng sẽ tương tác theo mặc định, và lợi thế của nó là thông lượng thay vì chiều sâu. Trên thực tế, nó lấp khoảng trống khi bạn cần câu trả lời nhanh hoặc tự động hóa gọn nhẹ mà không phải trả phí cho suy luận nặng.
GPT-5.2 Thinking tích hợp khả năng suy luận mở rộng, cho phép mô hình xử lý các vấn đề phức tạp theo từng bước trước khi đưa ra câu trả lời.
Trên các điểm chuẩn của chính OpenAI, đây là mô hình lập đỉnh mới trên các tác vụ công việc tri thức, lập trình và ngữ cảnh dài, đặc biệt khi có thể dùng các công cụ như bảng tính và trình chiếu.
Đây là nỗ lực của OpenAI nhằm tạo ra một động cơ công việc tri thức đa năng, và là mô hình bạn chọn khi độ chính xác được cải thiện nhờ suy nghĩ có chủ đích. Với nhiều tổ chức, đây sẽ là lựa chọn cho phân tích, quy trình nhiều bước và các tác vụ dạng “tác nhân”.
Đây là mẫu đầu bảng, được xây dựng hướng tới khách hàng doanh nghiệp.
Đồng thời, đây cũng là lựa chọn đắt nhất trong dòng sản phẩm vì nhắm đến các kịch bản rủi ro cao, nơi những lợi ích gia tăng về chất lượng suy luận, độ chính xác thực tế và giải quyết vấn đề trừu tượng xứng đáng với chi phí theo token cao hơn.
Pro hướng đến môi trường nơi sai sót gây tốn kém, và nơi các nhóm cần một mô hình có thể duy trì tính mạch lạc trên những ngữ cảnh rất dài. Đây là mô hình có thể dùng trong hệ thống hỗ trợ quyết định, lập kế hoạch phức tạp và mọi khối lượng công việc nơi độ tin cậy quan trọng không kém năng lực thô.
GPT-5.2 đã bắt đầu được triển khai. OpenAI chính thức ra mắt mô hình vào ngày 11 tháng 12 năm 2025, với các gói ChatGPT trả phí được truy cập trước, và phạm vi khả dụng tiếp tục mở rộng trên các khu vực và nền tảng. Người dùng có thể truy cập cả ba mô hình GPT-5.2 trực tiếp trong ChatGPT, và nhà phát triển có thể dùng chúng qua OpenAI API qua các đầu cuối Responses và Chat Completions.
Bản phát hành GPT 5.1 trước đó khá ít kết quả điểm chuẩn vì tập trung vào trải nghiệm người dùng. Vì vậy không ngạc nhiên khi GPT 5.2 đang cố “chỉnh hướng” bằng cách tập trung nhiều hơn vào kết quả.
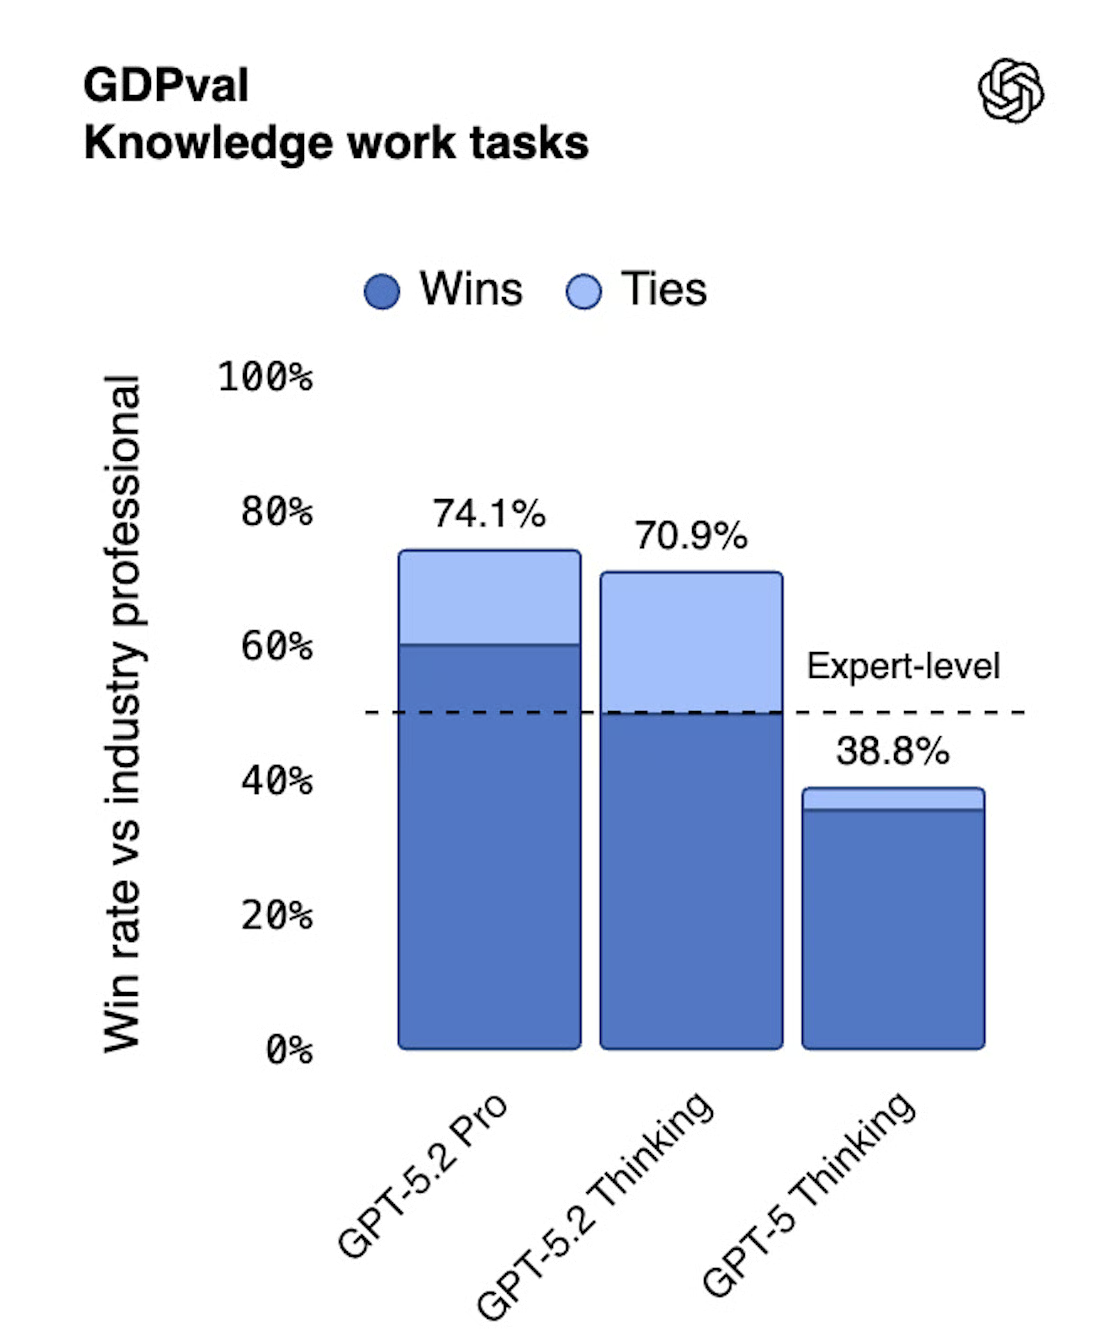
GDPval là kết quả điểm chuẩn được nhấn mạnh nhất trong bản phát hành mới. Nhưng nó chỉ được giới thiệu trên arxiv vào đầu tháng 10 năm 2025, nên việc nhấn mạnh điểm chuẩn này nói lên nhiều điều về bản phát hành.
GDPval kiểm tra các tác vụ mà người làm nghề thực hiện hằng ngày, như xây dựng báo cáo và làm bài thuyết trình. Câu hỏi được chọn từ 44 nghề nghiệp trong 9 ngành đóng góp lớn nhất vào GDP Hoa Kỳ. Bao gồm từ y tá đến nhà khoa học dữ liệu tới giảng viên đại học. Các tác vụ đòi hỏi sản phẩm công việc thực, như bảng tính, sổ cái kế toán, video và bài thuyết trình.
Điểm chuẩn được nhấn mạnh thứ hai là SWE-Bench Pro, một bài đánh giá kỹ nghệ phần mềm khó, trong đó GPT-5.2 đạt 55,6%. SWE-Bench Pro yêu cầu giải quyết các vấn đề dài hạn từ kho mã thực, những vấn đề đòi hỏi các thay đổi nhiều tệp, v.v.
Bạn có thể đã nghe về SWE-bench Verified, phiên bản dễ hơn của bài kiểm tra. Ở bài này, GPT 5.2 đạt 80%. Để tham chiếu, gần đây chúng tôi báo cáo rằng Claude Opus 4.5 đạt 80,9% ở bài này, nên hai mô hình khá tương đồng.
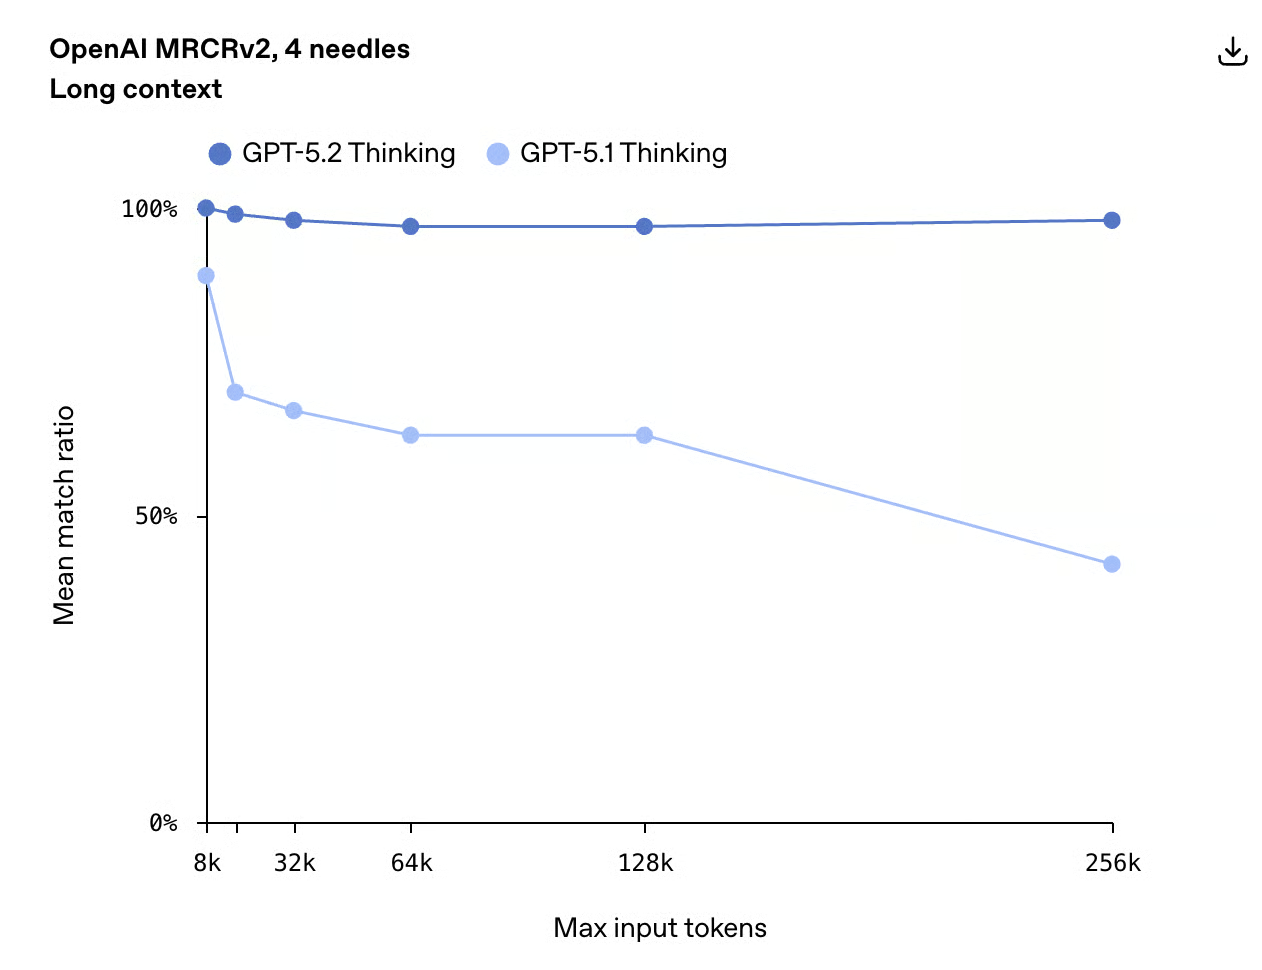
GPT 5.2 thể hiện rất tốt ở một điểm chuẩn khác gọi là MRCR v2, viết tắt của Multi-Round Coreference Resolution (phiên bản 2). Nó đạt điểm gần như hoàn hảo, điều mà OpenAI muốn chúng ta hiểu là có thể dùng GPT 5.2 để làm việc với tài liệu dài.
Công bằng mà nói, nó đạt độ chính xác gần như hoàn hảo lên tới 256k token. Đó là khoảng hai trăm nghìn từ, xấp xỉ độ dài một cuốn tiểu thuyết.
OpenAI tự tin khẳng định GPT 5.2 mang lại cải thiện lớn về trí tuệ, hiểu ngữ cảnh dài, gọi công cụ dạng tác nhân và thị giác, nên hợp lý khi lần lượt đánh giá từng khía cạnh.
Để kiểm tra khả năng hiểu ngữ cảnh dài của GPT-5.2, tôi đã tải lên một phiên bản trực tuyến của tiểu thuyết Disgrace của J.M. Coetzee. Sau đó tôi yêu cầu mô hình nêu một chi tiết nhỏ, dễ bị quên, nằm sâu trong một đoạn văn dài.
Tôi hỏi GPT-5.2 câu này:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 đã tìm ra câu trả lời đúng, dù với tôi đây giống như chi tiết kim đáy bể. Bữa tối này chỉ được nhắc đến một lần trong sách và không có ý nghĩa tường thuật thực sự.
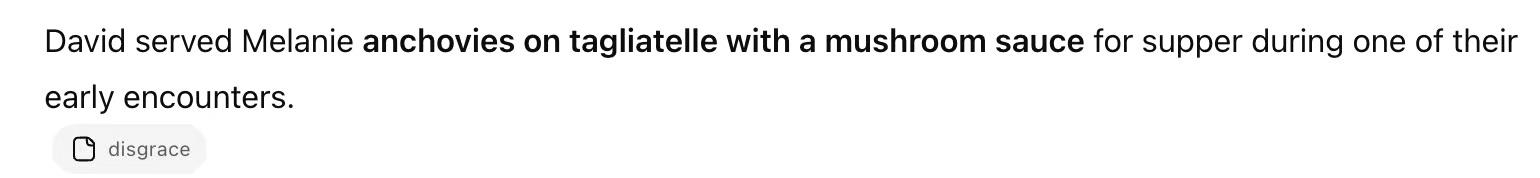
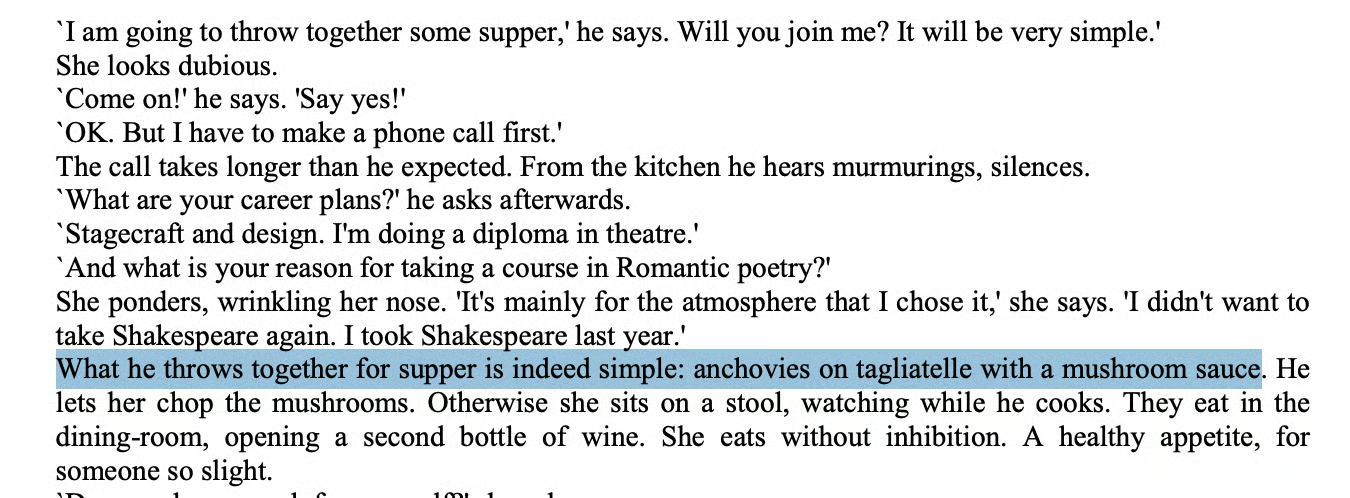
Bài kiểm tra này cho tôi thấy việc truy xuất của GPT-5.2 không dựa trên đoán mẫu mà là sự ghi nhớ thực sự trên một chuỗi dài.
Dạng ghi nhớ này quan trọng vì hiệu năng ngữ cảnh dài thực sự là duy trì trạng thái chi tiết trên phạm vi văn bản rất rộng. Nếu một mô hình có thể nhớ một công thức bữa tối thoáng qua, chôn sâu trong một câu chuyện 90 trang, thì nó có thể theo dõi biến số trong codebase, điều khoản pháp lý trong hợp đồng, hoặc chi tiết tài chính trong một báo cáo 200 trang.
Để kiểm tra khả năng tác nhân của GPT-5.2, tôi giao một nhiệm vụ đòi hỏi điều hướng và nhấp chuột. Tôi yêu cầu nó hành xử như một tác nhân tự động tìm căn hộ. Khả năng này sẽ hữu ích cho những người muốn chuyển nhà nhưng quá bận để lục lọi các trang thuê nhà.
Mô hình phải dùng trình duyệt, áp dụng bộ lọc, nhấp vào từng tin đăng, trích xuất chi tiết và tổng hợp một báo cáo so sánh.
Đây là nội dung cốt lõi của prompt:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
Thiết lập prompt này được thiết kế để kiểm tra suy luận dài hạn, gọi công cụ và tương tác UI trong cùng một lượt.
GPT-5.2 đã điều hướng tới một trang danh sách, đặt các bộ lọc và tự xử lý kết quả. Nó nhấp vào từng căn hộ, rút ra các trường có cấu trúc, tự chọn cả khu vực lẫn khung giá (tôi có thể yêu cầu các bộ lọc này, nhưng tôi không thực sự tìm nhà), sau đó tổng hợp một danh sách ngắn có xếp hạng.
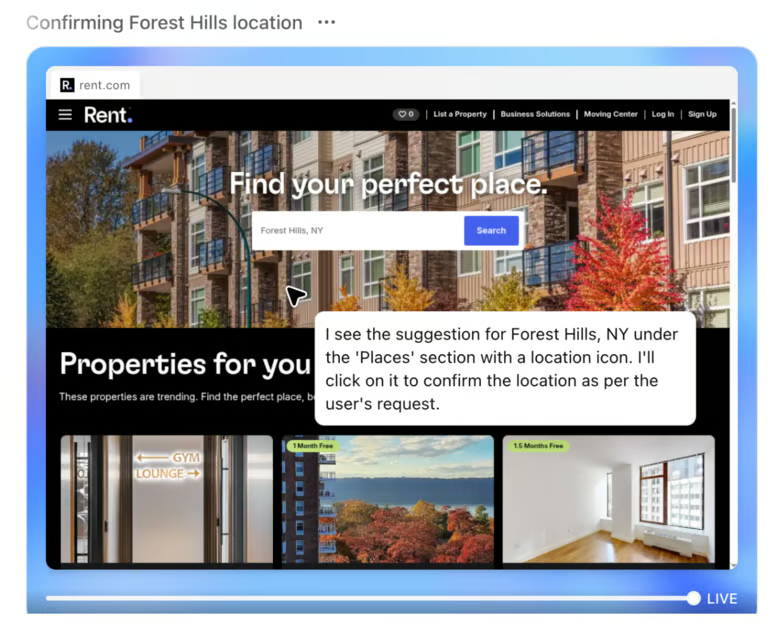
Chắc chắn phần nghiên cứu không hoàn hảo. Tôi thấy trong trace của mô hình rằng một số trang chặn trích xuất, nhưng tác nhân đã hồi phục bằng cách đổi trang, và cuối cùng vẫn tạo ra một bộ gợi ý có thể dùng được.
Một điều tôi nhận thấy trong bảng cuối là mô hình không cung cấp URL thật; thay vào đó, nó đưa các tham chiếu kiểu ảnh chụp màn hình. Đó là vì hầu hết trang thuê nhà chặn truy cập tự động, và công cụ duyệt không được phép trích xuất hoặc chia sẻ liên kết tin đăng thực tế. Khi đó, nó chỉ chèn một con trỏ tới ảnh chụp màn hình đã ghi trong sandbox. Điểm này hơi bất tiện.
Tôi muốn xem khả năng tác nhân này “giãn” được bao xa trong một lĩnh vực có ít nguồn dữ liệu sạch hơn nhiều, nên tôi thử thí nghiệm thứ hai về gia phả.
Tôi yêu cầu GPT-5.2 điều tra xem gia đình Waples có xuất hiện trong sổ đăng ký giáo xứ ở Anh hay không và liệu có mối liên hệ lịch sử hoặc gia phả nào với Herefordshire.
GPT-5.2 đã thực hiện các hành động cụ thể, như truy cập một trang gia phả miễn phí và nhấp qua các trang để tìm và tải về hồ sơ.
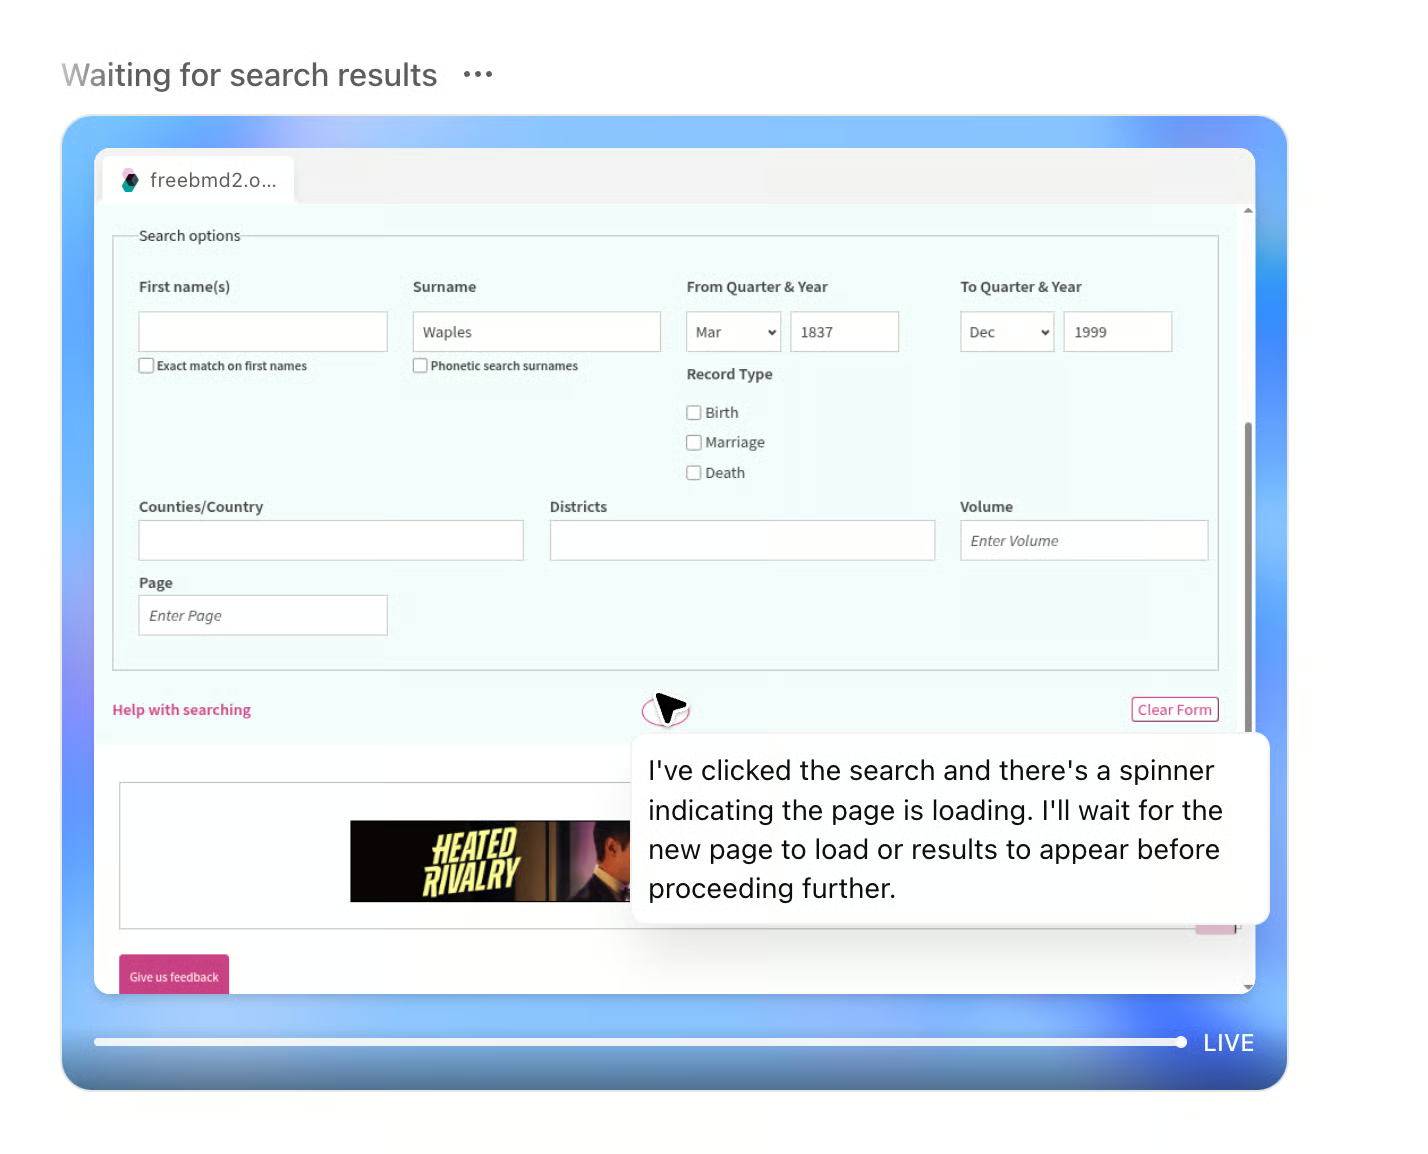
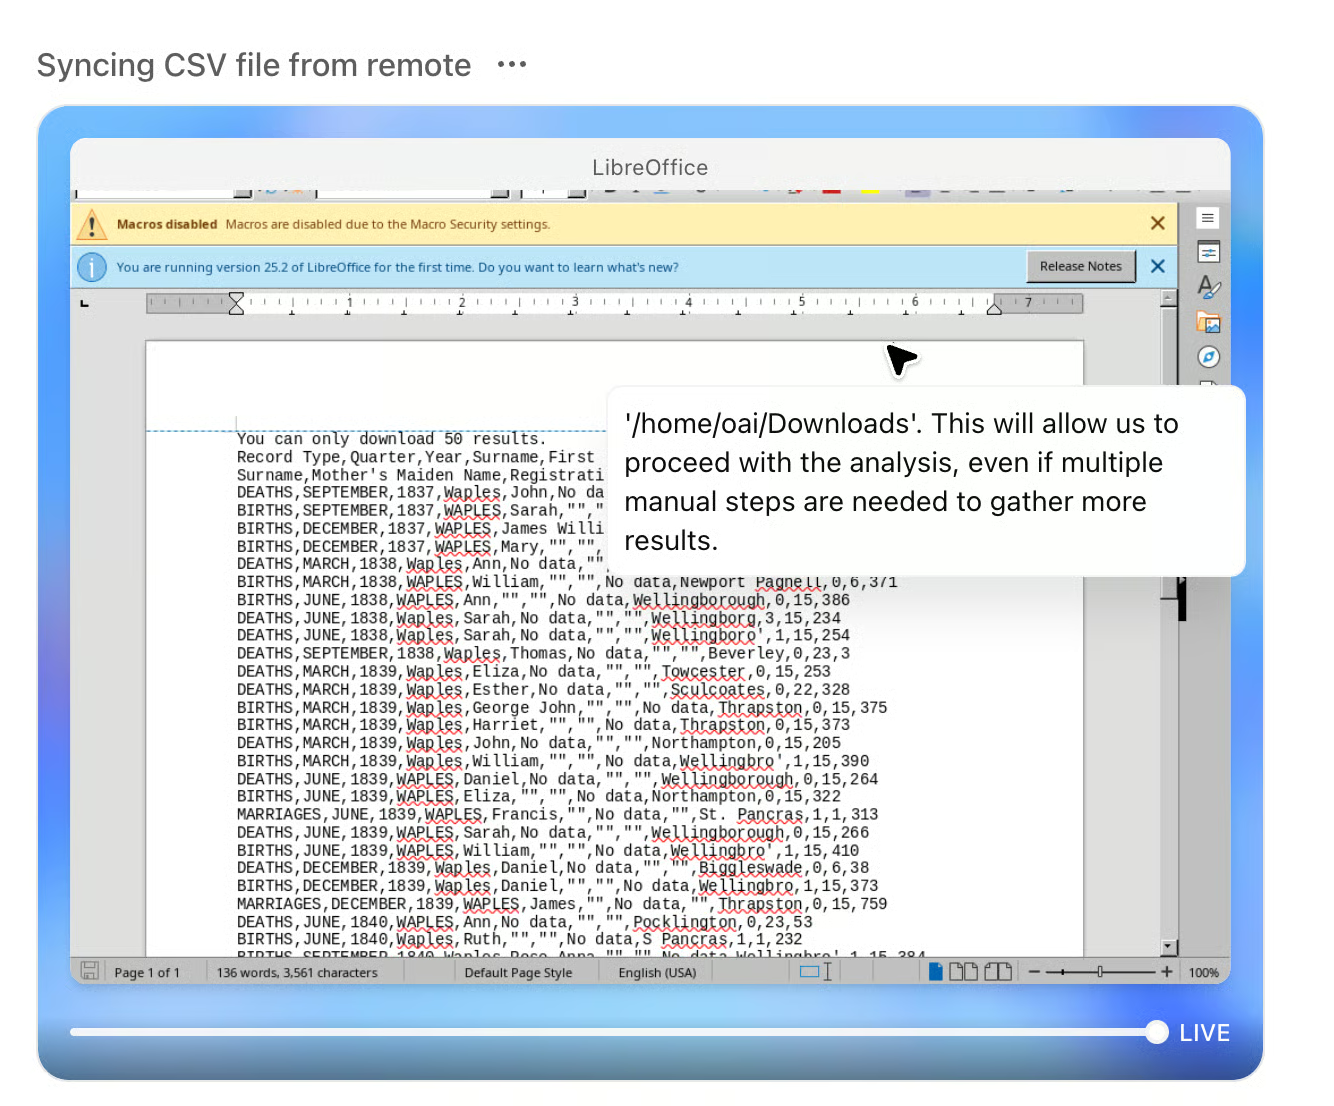
Mô hình chia nhỏ vấn đề thành các tiểu nhiệm vụ, tra cứu trong các nguồn như FreeBMD và Forebears, và thậm chí soạn một email hỏi thăm có mục tiêu để theo đuổi những hồ sơ chưa số hóa.
Đồng thời, tôi nhận ra nghiên cứu gia phả đặt ra các giới hạn cứng. Nhiều nguồn chủ chốt, như sổ đăng ký giáo xứ hay sổ kê khai, chỉ tồn tại trong lưu trữ hoặc sau các danh mục hạn chế. FreeBMD giới hạn tải xuống 50 bản ghi, danh mục của HARC không thể truy cập nếu không có cookie phiên, và các tài liệu liên quan lịch sử thường chỉ có được qua dịch vụ nghiên cứu trả phí.
Mô hình có thể nhận biết các rào cản này và đề xuất bước tiếp theo, nhưng không thể vượt qua chúng. Bài kiểm tra này không tạo ra gì hữu ích lắm, nhưng đó không phải lỗi của mô hình.
Tất cả cho thấy vì sao OpenAI tập trung vào bài toán doanh nghiệp, vì đó là nơi có cơ hội. Nhưng cũng là lời nhắc rằng rất nhiều dữ liệu vẫn đang ngoại tuyến, phân mảnh, thu phí, hoặc bị khóa sau những cánh cửa thực sự.
Trong bài kiểm tra cuối, tôi tải lên một Sudoku để kiểm tra cả thị giác lẫn trí tuệ tổng quát.
Bản thân Sudoku không phải toán nặng vì có ràng buộc. Nhưng khi câu đố ở dạng ảnh chứ không phải văn bản có cấu trúc, mô hình phải dùng đồng thời nhiều kỹ năng: đọc lưới, giữ nguyên các “givens” và áp dụng logic để giải.
can you fill out this sudoku for meBức ảnh không được vẽ hoàn hảo, nhưng đó là một phần của bài kiểm tra:
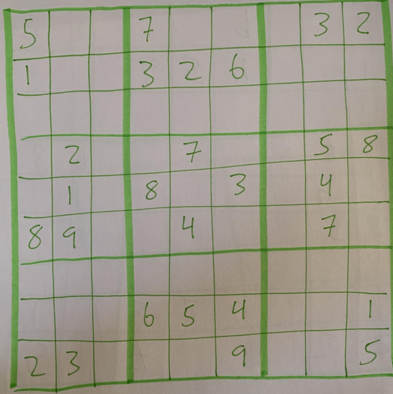
GPT-5.2 đưa ra một lời giải chính xác, nhưng đã thay thế ít nhất một con số cố định vốn không được phép đổi. Có thể nói nó “gian lận” mà không cố ý.
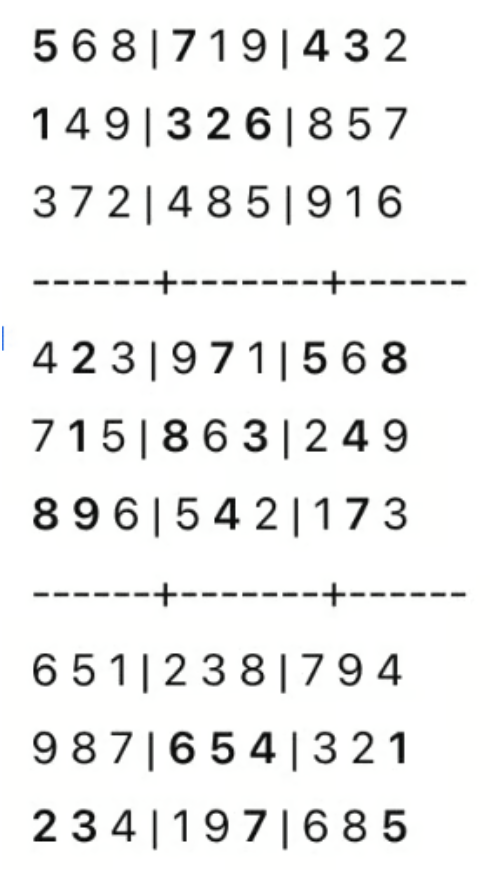
Dạng sai sót này không phải thất bại về suy luận. Nó giống sự đứt gãy về thị giác và tính trung thực. Mô hình hoặc đọc sai một ô cho trước, hoặc không hiểu đâu là vị trí cố định, hoặc đánh mất các ràng buộc khi chuyển ảnh thành lưới nội bộ.
Các bài test ở trên cho thấy bạn có thể làm gì trong ChatGPT, nhưng sự linh hoạt thực sự đến khi chuyển sang API, nơi bạn tự kiểm soát nỗ lực suy luận, ngân sách token và tích hợp công cụ.
Cả ba mô hình hiện khả dụng qua Responses API và Chat Completions API của OpenAI:
|
Mô hình |
Chuỗi định danh trong API |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
Đây là mức giá:
Hai bổ sung cho người dùng nâng cao: thiết lập nỗ lực suy luận 1xhigh1 và đầu cuối /compact giúp mở rộng cửa sổ ngữ cảnh hiệu dụng cho các quy trình chạy dài.
Hãy xem GPT-5.2 so với các bản phát hành gần đây khác như thế nào:
Gemini 3, phát hành giữa tháng 11, đã “nghiền nát” điểm số trên nhiều bài kiểm tra điểm chuẩn được dõi theo nhất. Nó giữ vị trí số 1 trên Humanity's Last Exam, và cũng vượt GPT-5.2 Pro trên GPQA Diamond, nhưng chỉ nhỉnh hơn đôi chút (93,8% so với 93,2%).
Mức tăng hiệu năng lớn của Gemini nhiều khả năng phản ánh cải tiến cả ở mixture-of-experts lẫn hạ tầng huấn luyện. Gemini 3 dùng định tuyến thưa ở cấp token, và được huấn luyện trên hạ tầng TPU tùy biến của Google. Nơi GPT-5.2 đang làm tốt hiện nay là các điểm chuẩn công việc chuyên nghiệp như GDPval và các bài đánh giá gọi công cụ cho doanh nghiệp. Đây là nơi OpenAI rõ ràng đã dồn lực.
Claude Opus 4.5, phát hành cuối tháng 11, đi con đường khác. Anthropic tập trung vào cái gọi là "suy luận lai"—kết hợp tư duy mở rộng với trí tuệ nền tảng mạnh hơn—và kết quả là một mô hình xuất sắc ở kỹ nghệ phần mềm và các tác vụ mở. Trên SWE-bench Verified, Opus 4.5 đạt 80,9%, nhỉnh hơn chút so với 80% của GPT-5.2.
Điểm khác biệt là phong cách: Opus 4.5 thiên về phản hồi dài và cân nhắc kỹ, trong khi GPT-5.2 Thinking nhấn mạnh vào sử dụng công cụ và đầu ra có cấu trúc như bảng tính và bài thuyết trình. Với tác nhân lập trình và tái cấu trúc phức tạp, chúng gần như ngang ngửa; còn với quy trình doanh nghiệp liên quan slide và báo cáo, OpenAI đặt cược GPT-5.2 có lợi thế.
Có rất nhiều sự chú ý đổ dồn vào các kết quả điểm chuẩn GPT, và hẳn OpenAI chịu nhiều áp lực để bứt phá. Một tháng trước, bản phát hành GPT 5.1 bị lu mờ bởi Gemini 3. Giờ đây, ở GPT 5.2, OpenAI đứng thứ hai sít sao sau Gemini 3 trên GPQA và thứ hai sát nút sau Claude Opus 4.5 trên SWE-Bench Verified—ắt hẳn là điều gây ức chế cho đội ngũ.
Thay vào đó, OpenAI nhấn mạnh hiệu năng cao trên GDPval và SWE-Bench Pro, nhưng đặc biệt bài test đầu tiên khá xa lạ so với các chuẩn công nghiệp thường lên trang nhất. Có thể nghĩ rằng OpenAI đang cố kể một câu chuyện chiến thắng mà không làm nổi bật các bảng xếp hạng họ đang thua.
Tuy nhiên, cuộc đua đang rất sít sao, và các công ty này vẫn còn nhiều đất để chứng tỏ. Một điều chúng tôi sẽ đặc biệt theo dõi là hiệu năng của các mô hình mới trên điểm chuẩn ARC-AGI-3 sắp ra mắt, hiện đang được phát triển.
Học cùng DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
