
{count, plural, other {课程}}
理解 Artificial Intelligence
{hours} 小时
428K
更新:自本文发布以来,OpenAI 已推出多款新模型。为保持最新进展,也请查看我们的 GPT-5.4、GPT-5.3-Codex 和 GPT-5.3-Instant 指南。
距离我们看到 GPT-5.1 发布仅过去一个月。但在 AI 的世界里,一个月已相当漫长。在此期间,Google 发布了 Gemini 3,在多数备受关注的基准测试上名列前茅;Anthropic 也发布了 Claude Opus 4.5,再次在软件工程榜单上夺冠。
OpenAI 渴望将自己定位为最能为企业创造价值的公司。但在关键榜单上失利后,它可能担心流失用户甚至企业客户。据报道,这种压力引发了“红色代码”,推动团队加速发布 GPT-5.2。
本文将帮助您理解 GPT-5.2 发布时宣布的全部内容,包括企业可从三款新模型中获得的收益。这些模型正向所有付费 ChatGPT 用户逐步推送(并已在 API 中提供)。您也可以查看我们的 ChatGPT Images 工具指南,以及两款较新的模型 GPT-5.3 Codex 和 GPT-5.2 Instant。
我们通过每周五免费通讯 The Median 为读者带来最新 AI 动态,精炼解读本周要闻。订阅即可每周用几分钟保持敏锐:
GPT-5.2 在推理、记忆与工具使用方面带来明确而有针对性的改进。按照 OpenAI 的说法,这些提升将转化为更佳的企业工作流,并在工作中减少故障点。该系列中的三款模型各自采用不同路径来兑现这一价值。
GPT-5.2 Instant 优先追求低时延与快速响应。其定位是获取信息、撰写与翻译等日常“主力机型”。这是大多数人默认会与之交互的模型,优势在于吞吐量而非深度。实际而言,当您需要快速答案或轻量自动化且不想为更重的推理付费时,它能补上空缺。
GPT-5.2 Thinking 融入了扩展推理能力,使模型能在给出回答前逐步推演复杂问题。
在 OpenAI 自有基准中,它在知识型工作、编码与长上下文任务上创下新高,尤其是在可调用电子表格与演示等工具时。
这是 OpenAI 打造的通用型知识工作引擎,当需要用更审慎的思考来提升准确性时,就该选它。对许多组织而言,它将是分析、多步骤工作流与代理型任务的首选。
这是旗舰款,面向企业客户打造。
它也是该系列中最昂贵的选择,因为目标场景风险较高;在这类场景中,推理质量、事实准确性与抽象问题求解上的细微提升,足以证明更高的每 token 成本是值得的。
Pro 面向错误代价高且需要在超长上下文中保持连贯性的环境。它可用于决策支持系统、复杂规划,以及任何同等重视可靠性与原始能力的工作负载。
GPT-5.2 已开始逐步推送。OpenAI 于 2025 年 12 月 11 日正式发布该模型,付费 ChatGPT 套餐优先获得访问权限,随后在各地区与平台持续扩展。用户可在 ChatGPT 内直接访问三款 GPT-5.2 模型,开发者可通过 OpenAI API 的 Responses 与 Chat Completions 端点调用。
在发布 GPT 5.1 时,因侧重用户体验,几乎未公布基准测试结果。因此,GPT 5.2 更强调结果导向,试图扭转这一局面,并不意外。
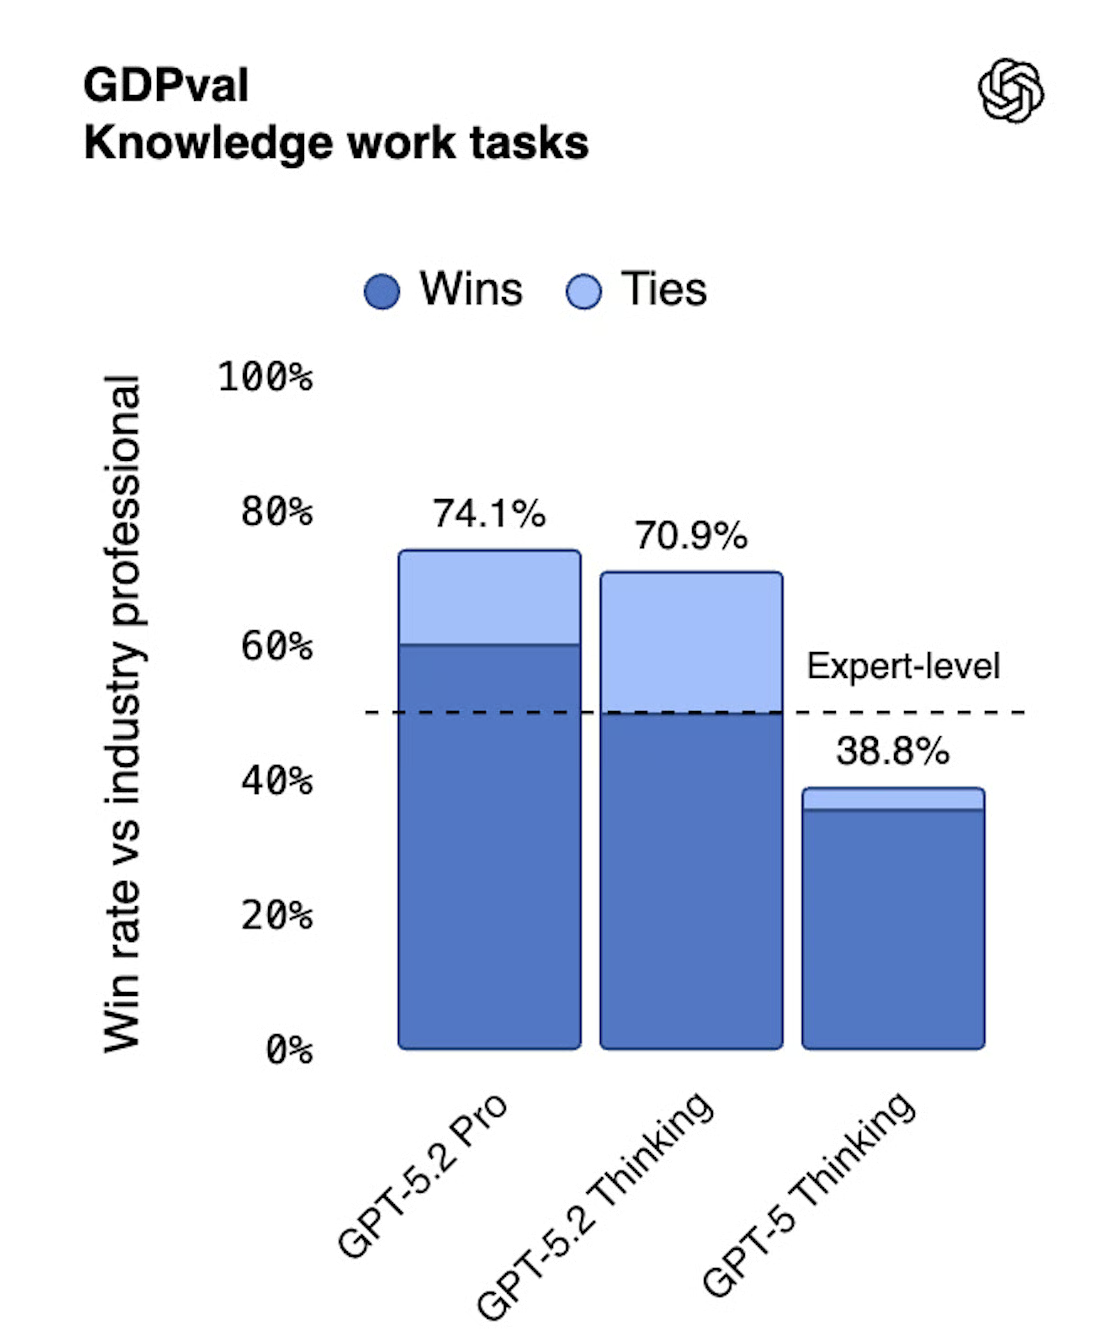
GDPval 是此次发布中被重点强调的基准之一。但它仅在 2025 年 10 月初在 arxiv 上提出,重点强调它也反映了这次发布的取向。
GDPval 测试职场专业人士日常执行的任务,如制作报告和演示。题目来自对美国 GDP 贡献最高的九大行业中的 44 个职业,涵盖护士、数据科学家、大学教授等。任务需要真实的工作产出,如电子表格、会计分录、视频与演示文稿。
此次发布中第二个被重点强调的基准是 SWE-Bench Pro,这是一个难度较高的软件工程评测,GPT-5.2 取得了 55.6% 的分数。SWE-Bench Pro 要求解决来自真实仓库的长程问题,例如需要在多个文件间进行修改。
您可能听说过更容易的 SWE-bench Verified。在该测试中,GPT 5.2 得分为 80%。作为对比,我们最近报道过 Claude Opus 4.5 在该测试上得分 80.9%,两者大致相当。
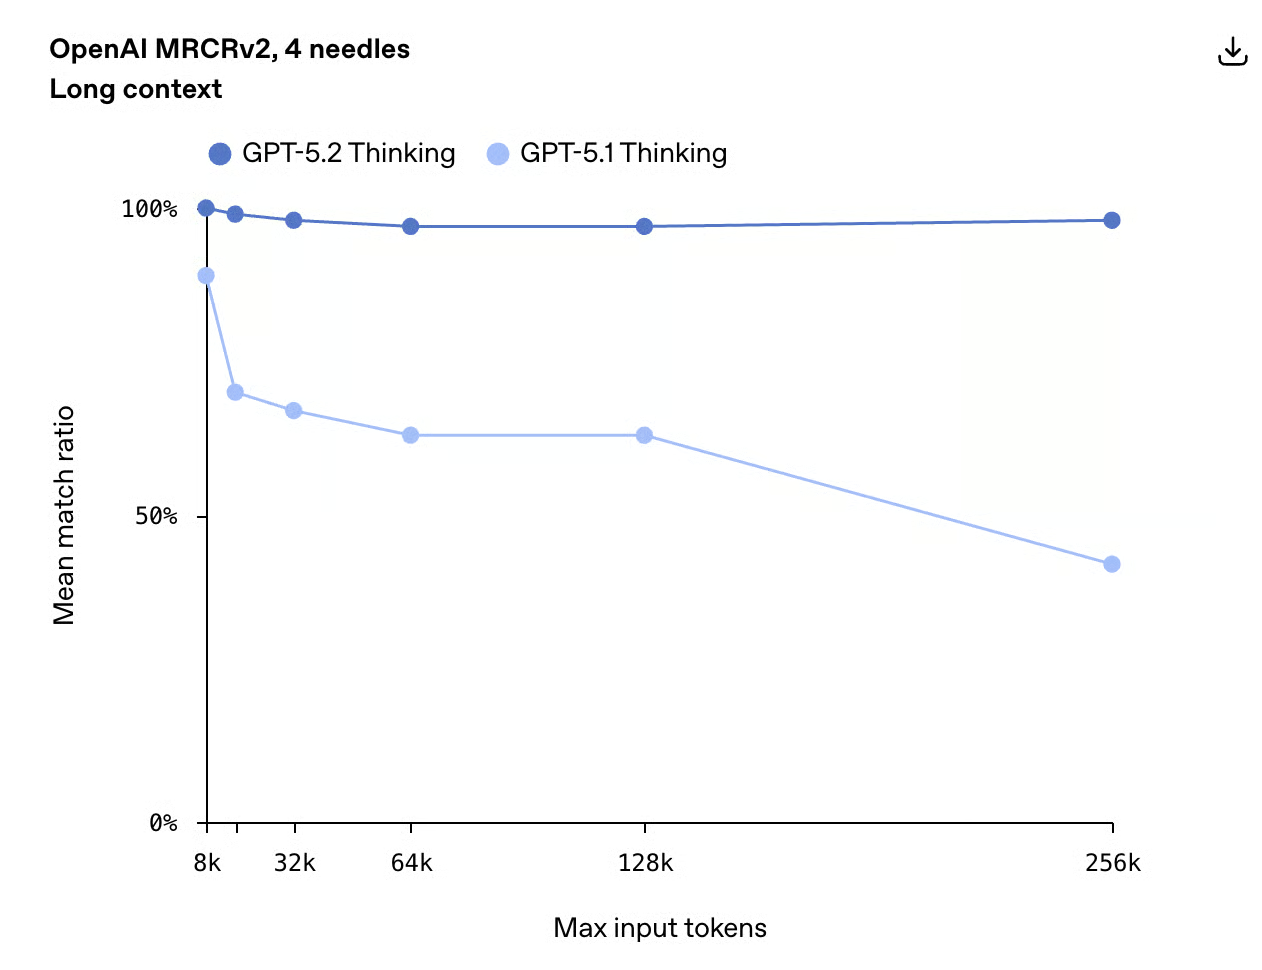
GPT 5.2 在另一项名为 MRCR v2(多轮指代消解,第 2 版)的基准上表现出色,几乎拿到满分。OpenAI 希望我们据此理解为:我们可以用 GPT 5.2 处理长文档。
值得肯定的是,它在多达 256k tokens 的范围内几乎保持完美准确度。这大约相当于二十万字,接近一部长篇小说的长度。
OpenAI 坦陈 GPT 5.2 在智能、长上下文理解、代理型工具调用与视觉方面有大幅改进,因此逐一评估这些方面是合理的。
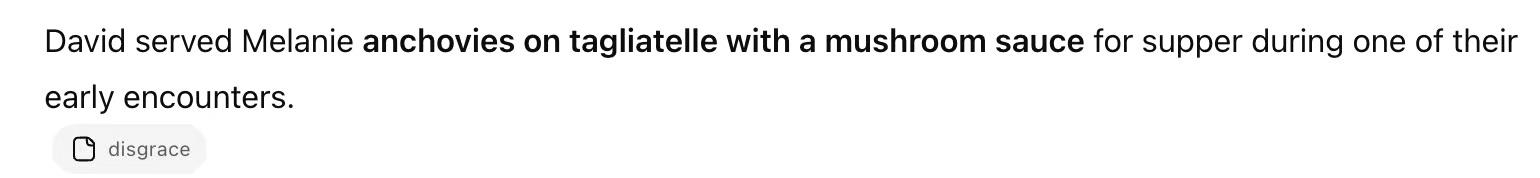
为测试 GPT-5.2 的长上下文理解,我上传了 J.M. Coetzee 的小说《耻》的在线版本。随后我要求模型在一段很长的文字中,指出一个微小且容易被忽略的细节。
我向 GPT-5.2 提出了这样一个问题:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 找到了正确答案,尽管在我看来这像是大海捞针。那顿晚餐在书中只被提及过一次,对叙事并无实质影响。
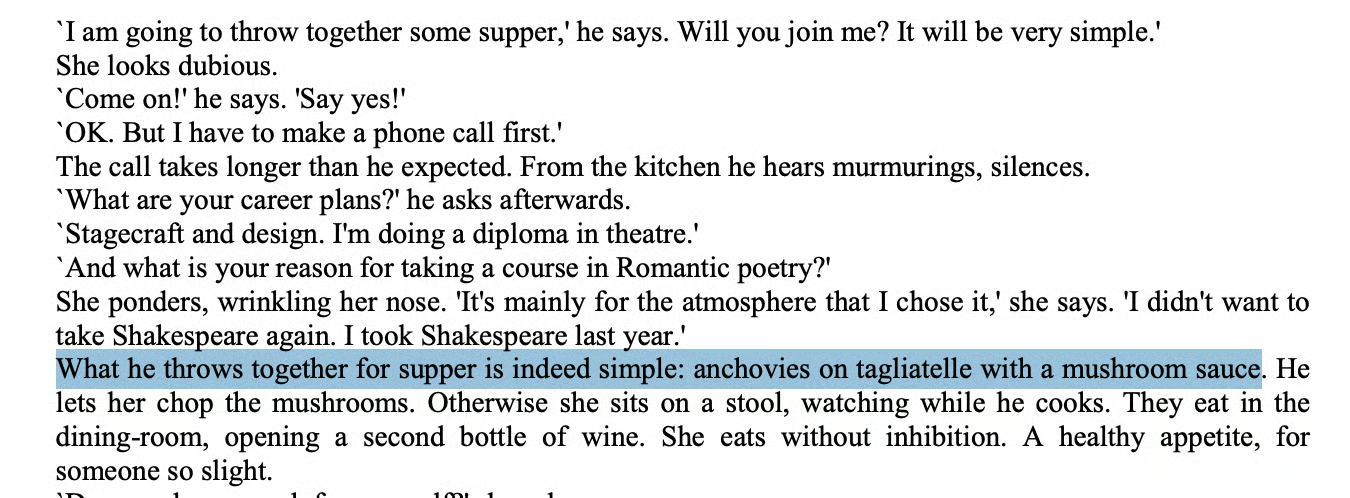
这项测试让我看到,GPT-5.2 的检索并非基于模式猜测,而是能在长序列中进行真正的保留与定位。
这种保留能力很重要,因为真正的长上下文表现在于能在广阔文本中维持细粒度状态。如果一个模型能记住埋在 90 页叙事深处的一道转瞬即逝的晚餐菜谱,它就能跟踪代码库中的变量、合同里的法律条款,或 200 页报告中的财务细节。
为测试 GPT-5.2 的代理能力,我给它一个需要导航与点击的任务:像一个自主的找房代理那样工作。对于想搬家却没空自己浏览租房网站的人来说,这很有帮助。
模型必须使用浏览器、应用筛选、点击进入房源、提取详情,并汇总成对比报告。
提示语的核心如下:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
该提示的设置旨在一次性测试长程推理、工具调用与 UI 交互。
GPT-5.2 自主导航至房源网站、设置筛选并处理结果。它点击进入单套房源,抽取结构化字段,自主选择了社区与价格带(我本可以自己指定,但我并不真的要搬家),随后汇总出一份小型的排名短清单。
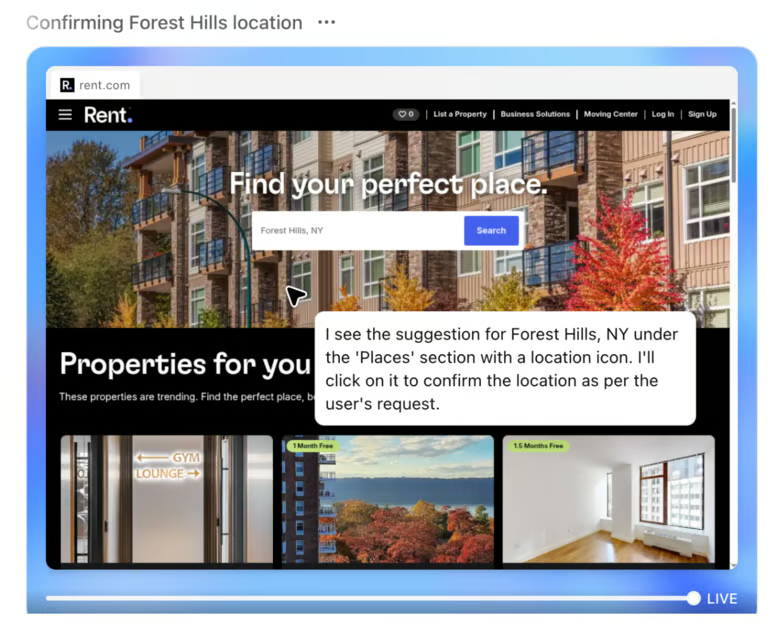
我确信研究并不完美。从模型的轨迹中可见,有些网站阻止了抓取,但代理通过切换网站进行恢复,最终仍产出了可用的推荐集合。
我在最终表格中注意到一件事:模型没有给出真实 URL,而是提供了类似截图的引用。这是因为大多数租房网站会阻止自动化访问,而浏览工具也不允许提取或分享实际房源链接。遇到这种情况时,它只会在沙盒中插入指向所截屏幕的指针。这一点略显不便。
我想看看在数据源远不那么整洁的领域,这些代理能力能延展到何种程度,因此在家谱研究上做了第二个实验。
我请 GPT-5.2 调查 Waples 家族成员是否出现在英格兰教区登记册中,以及是否与赫里福德郡存在任何历史或家谱联系。
GPT-5.2 采取了具体行动,例如访问免费家谱网站并逐页点击查找与下载记录。
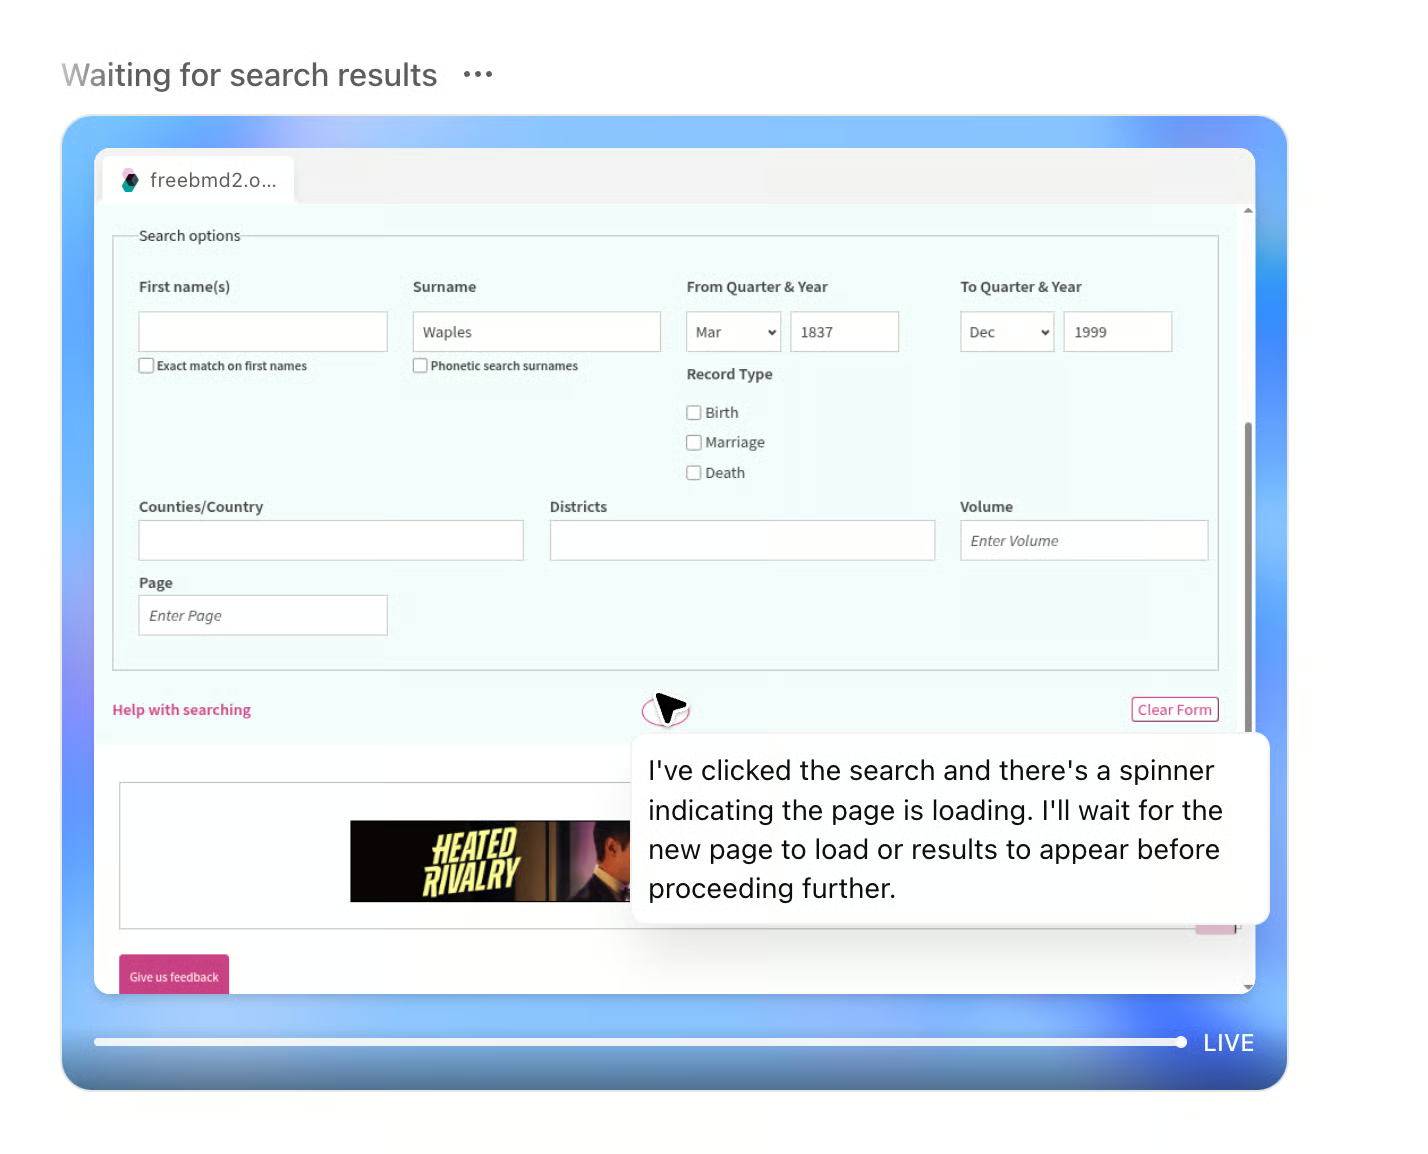
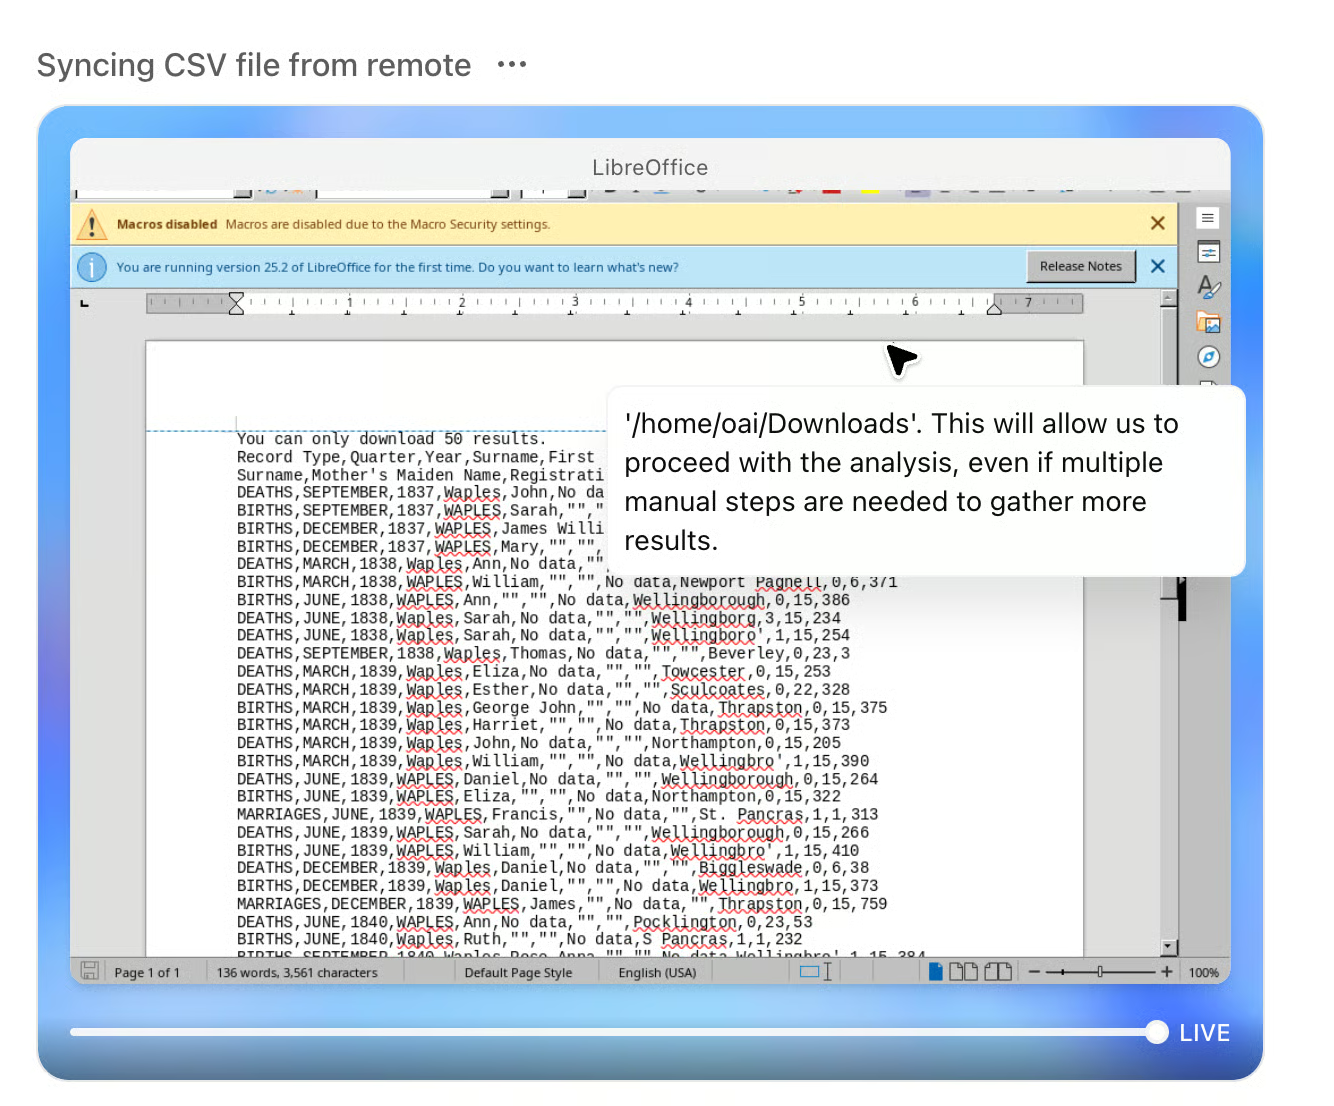
模型将问题拆分为子任务,在 FreeBMD 与 Forebears 等资源上进行检索,甚至撰写了定向询问邮件,以追索尚未数字化的记录。
与此同时,我也了解到家谱研究这一领域存在硬性限制。许多关键来源,如教区登记册或呈文名册,只存在于档案馆或被限制的目录之后。FreeBMD 对下载设有 50 条记录上限,HARC 的目录没有会话 cookie 无法访问,而具有历史价值的文档往往需通过付费研究服务获取。
模型能识别这些壁垒并给出后续建议,但无法跨越它们。该测试未能产出很有用的结果,但并非模型之过。
所有这些都说明了为什么 OpenAI 专注于商业用例——因为机会在那儿。但这也提醒我们,仍有大量数据处于离线、碎片化、付费墙之后,或锁在真实的门后。
最后的测试中,我上传了一道数独,作为对视觉与通用智能的考验。
数独本身并非重数学问题,因为其约束明确。但当题目以图片而非结构化文本呈现时,模型必须同时运用多项能力:读取棋盘、保留“给定数”,并运用逻辑求解。
can you fill out this sudoku for me这张图片画得并不规整,但这正是测试的一部分:
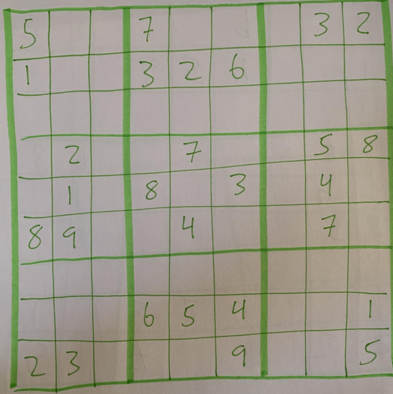
GPT-5.2 给出了正确的棋盘解,但至少替换了一个不应被改动的给定数。可以说它“无意中作弊”了。
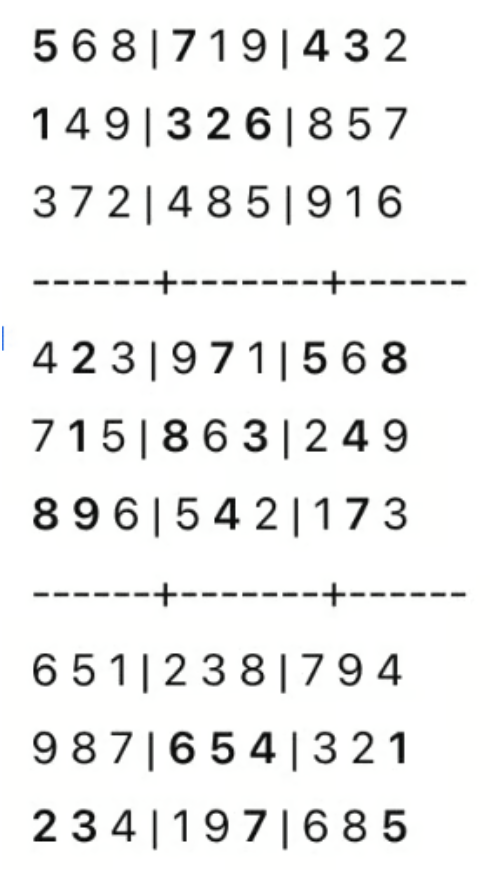
这种错误并非推理失败,更像是视觉与保真度的断链。模型要么误读了某个给定格,要么没有理解哪些是固定位置,或在将图像转换为内部网格时丢失了约束。
上述测试展示了您在 ChatGPT 内可以完成的事情,但真正的灵活性在于迁移至 API:在那里您可以自行控制推理强度、token 预算与工具集成。
三款模型均已通过 OpenAI 的 Responses API 与 Chat Completions API 提供:
|
模型 |
API 模型字符串 |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
以下是价格:
两项面向高阶用户的新增功能:1xhigh1 推理强度设置,以及可延展长时工作流有效上下文窗口的 /compact 端点。
来看一下 GPT-5.2 与近期其他发布的对比:
Gemini 3 于 11 月中发布,在许多最受关注的基准测试上表现强势。它在 Humanity's Last Exam 上居首,也在 GPQA Diamond 上略胜 GPT-5.2 Pro 一筹(93.8% vs. 93.2%)。
Gemini 表现的大幅提升,很可能源于 Mixture-of-Experts 实现与训练基础设施的改进。Gemini 3 采用 token 级稀疏路由,并在 Google 的定制 TPU 基础设施上训练。当前 GPT-5.2 的优势体现在 GDPval 等职业工作基准与企业工具调用评测上——这正是 OpenAI 明显倾注精力的方向。
Claude Opus 4.5 于 11 月下旬发布,走的是不同路径。Anthropic 聚焦所谓的“混合推理”——将扩展思考与更强基线智能结合——其成果是在软件工程与开放式任务上表现出色。在 SWE-bench Verified 上,Opus 4.5 得分 80.9%,略高于 GPT-5.2 的 80%。
两者风格也有差异:Opus 4.5 倾向更长、更审慎的回答;而 GPT-5.2 Thinking 更强调工具使用与结构化输出,如电子表格与演示。对于编码代理与复杂重构,它们几乎不相上下;在涉及幻灯片与报告的企业工作流中,OpenAI 押注 GPT-5.2 更具优势。
外界对 GPT 基准成绩高度关注,OpenAI 承受的交付压力可想而知。一个月前,GPT 5.1 的发布被 Gemini 3 盖过风头。如今 GPT 5.2 发布,在 GPQA 上略逊 Gemini 3、在 SWE-Bench Verified 上又略逊 Claude Opus 4.5,这对团队而言想必颇为沮丧。
OpenAI 转而强调在 GDPval 与 SWE-Bench Pro 上的高表现,但尤其是前者,相较于更能登上头条的行业标准而言,仍相当小众。或许 OpenAI 正在试图讲述一个胜利的故事,同时避开它目前落后的榜单。
不过竞赛非常胶着,这些公司仍有很大施展空间。我们将重点关注的一点是新模型在即将到来的 ARC-AGI-3 基准(开发中)上的表现。
与 DataCamp 一起学习
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}