
Kursus
Pengantar R
4 jam
3.1M
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Google
Membuat resume yang mengesankan saja tidak cukup untuk menembus pasar kerja data science. Jika Anda ingin memulai karier di data science, langkah krusial adalah membangun portofolio data berisi proyek-proyek relevan yang menampilkan keterampilan data Anda dalam wawancara.
Kabar baiknya, tidak pernah terlalu dini atau terlambat untuk mulai membuat portofolio seperti itu. Baik Anda benar-benar pemula maupun sudah setengah jalan mempelajari data science, Anda bisa mulai mengerjakan proyek R Anda sekarang.
Tidak masalah jika proyek pertama Anda terlihat amatir. Anda selalu bisa kembali, mengembangkannya, memolesnya, atau bahkan menghapusnya ketika Anda membuat proyek yang lebih maju. Hal terpenting adalah memulai prosesnya.
Dalam artikel ini, kami akan menguraikan beberapa ide bermanfaat untuk proyek data science menggunakan R dan melihat beberapa contoh untuk memulai. Kami juga akan membahas bahasa pemrograman R dan bagaimana R digunakan untuk analisis data dan data science.
R adalah bahasa pemrograman untuk analisis data, data science, dan machine learning, yang juga menyertakan lingkungan komputasi statistik dan grafik. R dirancang khusus untuk komputasi statistik tingkat lanjut dan cepat, pemodelan data, serta membangun visualisasi yang berdampak. Di sinilah bahasa ini menunjukkan kekuatan sebenarnya.
Selain itu, R:
Anda akan menemukan informasi lebih lanjut tentang bahasa pemrograman R dan cara mempelajarinya melalui artikel kami What is R? - The Statistical Computing Powerhouse dan How to Get Started with R. Anda juga dapat mengikuti kursus DataCamp Introduction to R.
Untuk mulai belajar R dari nol atau menguasai keterampilan teknis tertentu, lihat berbagai sumber belajar kami, termasuk kursus, jalur keterampilan, dan jalur karier. Secara khusus, untuk jalur belajar R yang seimbang dan komprehensif, pertimbangkan jalur karier Data Scientist with R dan Machine Learning Scientist with R.
Melakukan analisis data adalah langkah pertama dari setiap proyek data science. Ini logis: sebelum terjun memprediksi skenario masa depan dengan teknik machine learning dan deep learning, kita harus mengungkap kondisi saat ini (dan masa lalu).
Di sisi lain, analisis data dapat menjadi tugas mandiri. Dalam kedua kasus, R menyediakan spektrum luas pustaka yang berguna dan khusus diadaptasi untuk tujuan analitis.
Dengan R, kita dapat mengambil data dari situs web, membersihkan dan merapikannya, memvisualisasikannya, mengeksplorasi statistiknya, membuat dan menguji hipotesis, serta mengekstrak wawasan dan pola bermakna dari data awal. Di antara tugas-tugas ini, analisis statistik dan visualisasi yang menakjubkan adalah kartu truf R, dan di sinilah bahasa pemrograman ini biasanya mengungguli pesaing utamanya, Python.
Selain paket serbaguna yang umum digunakan di R, ada banyak modul yang dirancang untuk berbagai masalah analitis terapan. Misalnya:
fAssets: Paket ini dirancang untuk menganalisis dan memodelkan aset keuangan.
mdapack: Ini adalah paket analisis data medis.
GEOmap: Paket ini digunakan untuk pemetaan topografis dan geologis.
AeRobiology: Perangkat komputasi untuk data aerobiologi.
galigor: Kumpulan paket untuk pemasaran Internet.
lingtypology: Paket ini digunakan untuk tipologi linguistik dan pemetaan.
Selain itu, R bahkan mencakup pustaka yang sangat terfokus seperti:
Seperti disebutkan sebelumnya, R adalah bahasa pemrograman berorientasi data science yang menawarkan lebih dari 19.000 paket data science. Selain tugas analitis murni yang tercantum di bagian sebelumnya, kita dapat menggunakan R untuk masalah yang lebih maju dengan cakupan memprediksi dan memodelkan data yang belum diketahui. Menggunakan R memungkinkan kita untuk:
Sekali lagi, selain paket data science yang umum digunakan (caret untuk pelatihan klasifikasi dan regresi, naivebayes untuk menerapkan algoritma Naive Bayes, randomForest untuk membangun model random forest, deepNN untuk deep learning, dll.), ada banyak pustaka yang sangat terspesialisasi, bahkan yang sangat spesifik. Beberapa di antaranya:
OenoKPM: Paket ini digunakan untuk memodelkan kinetika produksi CO2 dalam fermentasi alkohol.
fHMM: Paket ini dirancang untuk menyesuaikan model Markov tersembunyi pada data keuangan.
paleopop: Kerangka pemodelan berorientasi pola untuk model paleo-klimatik ceruk-populasi terkopel.
ibdsim2: Paket ini digunakan untuk mensimulasikan wilayah kromosom yang dibagi anggota keluarga.
rSHAPE: Paket ini dirancang untuk mensimulasikan evolusi populasi haploid aseksual.
Sekarang, kita akan melihat beberapa contoh proyek R dan menemukan ide menarik untuk pengembangan lanjutan, baik untuk pemula maupun pengguna berpengalaman.
Salah satu cara paling bermanfaat untuk mencari proyek R adalah dengan membuat contoh-contoh tersebut sendiri!
Jangan khawatir, tidak seseram kelihatannya. Bahkan jika Anda pemula dalam data science di R, Anda bisa memilih proyek "sandbox" yang sudah dilengkapi data siap dianalisis atau dimodelkan, memperkenalkan Anda pada konteks masalah, dan memberi panduan bermanfaat tentang langkah-langkah yang harus dilakukan dan alasannya.
Jika Anda pembelajar yang lebih mahir, Anda selalu dipersilakan untuk mengeksplorasi data lebih dalam, dari berbagai sudut, dan melampaui instruksi yang disarankan demi memuaskan rasa ingin tahu Anda terhadap data. Dalam hal apa pun, belajar aktif sambil praktik lebih baik daripada sekadar membaca proyek orang lain.
DataCamp menawarkan banyak pilihan proyek data science di R yang memungkinkan Anda melatih banyak keterampilan teknis. Contohnya mencakup impor dan pembersihan data, manipulasi data, visualisasi data, probabilitas & statistik, machine learning, dan lainnya.
Selain topik populer (seperti Mengeksplorasi Pasar Airbnb NYC, Memvisualisasikan COVID-19, Klastering Data Pasien Penyakit Jantung, atau Memprediksi Tarif Taksi dengan Random Forest) yang secara tradisional dianalisis di berbagai sekolah data science, di sini Anda juga akan menemukan banyak topik baru dan menarik. Jangan ragu untuk mengeksplorasinya lebih dalam:
Setelah menelusuri proyek R yang ada atau membuat beberapa proyek terpandu sendiri, Anda bisa memutuskan untuk mulai membuat proyek sendiri dari nol. Ini selalu ide yang baik, di tahap mana pun Anda belajar R.
Jika Anda membuat salah satu proyek pertama yang tidak terpandu, hal pertama yang perlu dipikirkan adalah di mana menemukan data untuk dikerjakan. Untungnya, ada banyak repositori online populer yang menawarkan koleksi besar dataset gratis dan terdokumentasi dengan baik, baik dunia nyata maupun sintetis. Beberapa contoh sumber daya yang patut diperhatikan adalah DataLab, Kaggle, UCI Machine Learning Repository, Google Dataset Search, Google Cloud Platform, FiveThirtyEight, dan Quandl
Sekarang Anda memiliki banyak pilihan data, apa yang tepatnya bisa Anda lakukan sebagai pemula di R? Karena ini akan menjadi proyek data science pertama Anda di R, pertimbangkan untuk melakukan pembersihan dan manipulasi data dasar, eksplorasi data sederhana, dan visualisasi data.
Spotify adalah salah satu layanan digital musik, video, dan media terbesar tempat Anda dapat menemukan jutaan lagu, video, dan podcast dari seluruh dunia.
Anda dapat menggunakan dataset yang sudah siap pakai Spotify Music Data, yang berisi sekitar 600 lagu teratas selama kurun waktu tertentu, dan mengeksplorasi statistiknya dari banyak sisi. Misalnya pertimbangkan menganalisis faktor dan pertanyaan berikut, lengkapi temuan Anda dengan grafik yang bermakna bila perlu:
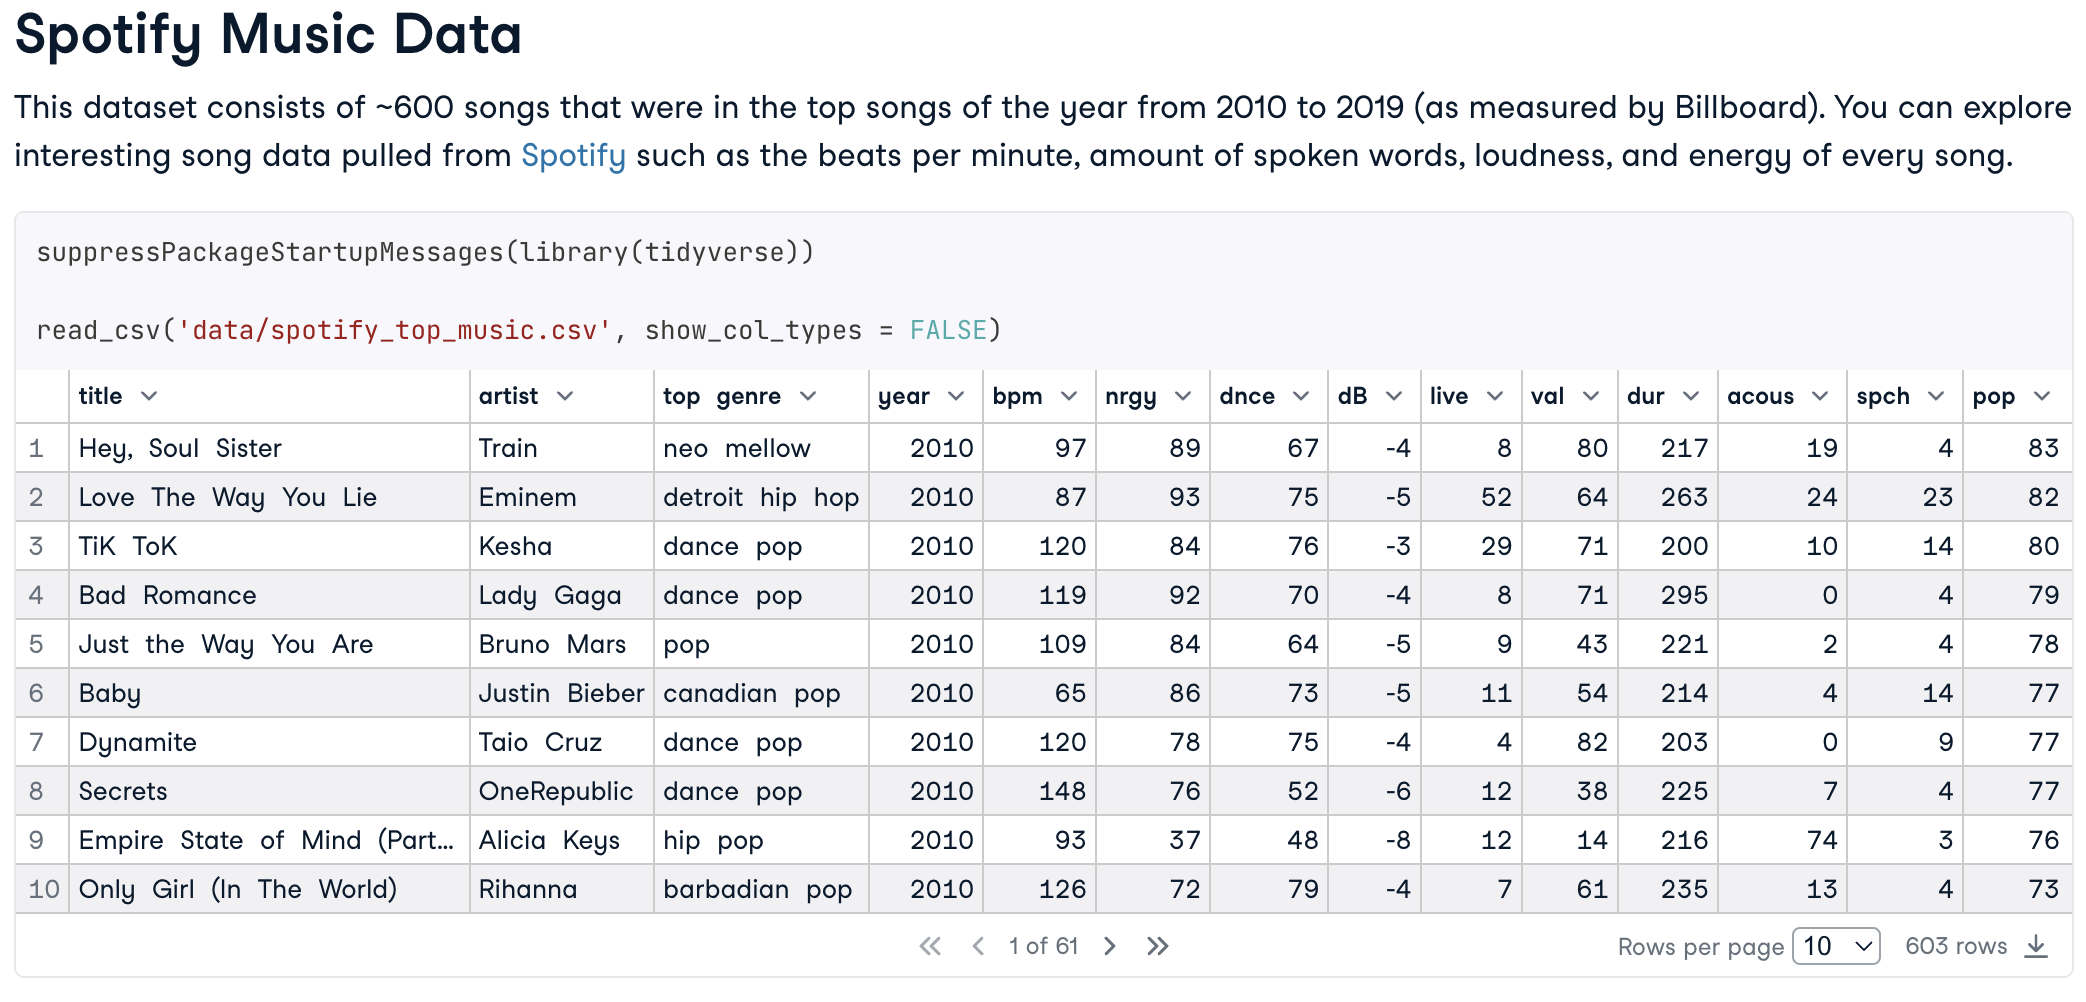
Contoh dari Proyek R Spotify Music Data
National Basketball Association (NBA) adalah liga bola basket profesional pria di Amerika Utara yang beranggotakan 30 tim, salah satu yang terbesar di dunia.
Dataset NBA Shooting Data memuat data yang dikumpulkan untuk empat pemain berbeda pada playoff NBA 2021. Anda dapat menganalisis dan memvisualisasikan data ini serta mencoba menjawab pertanyaan berikut:
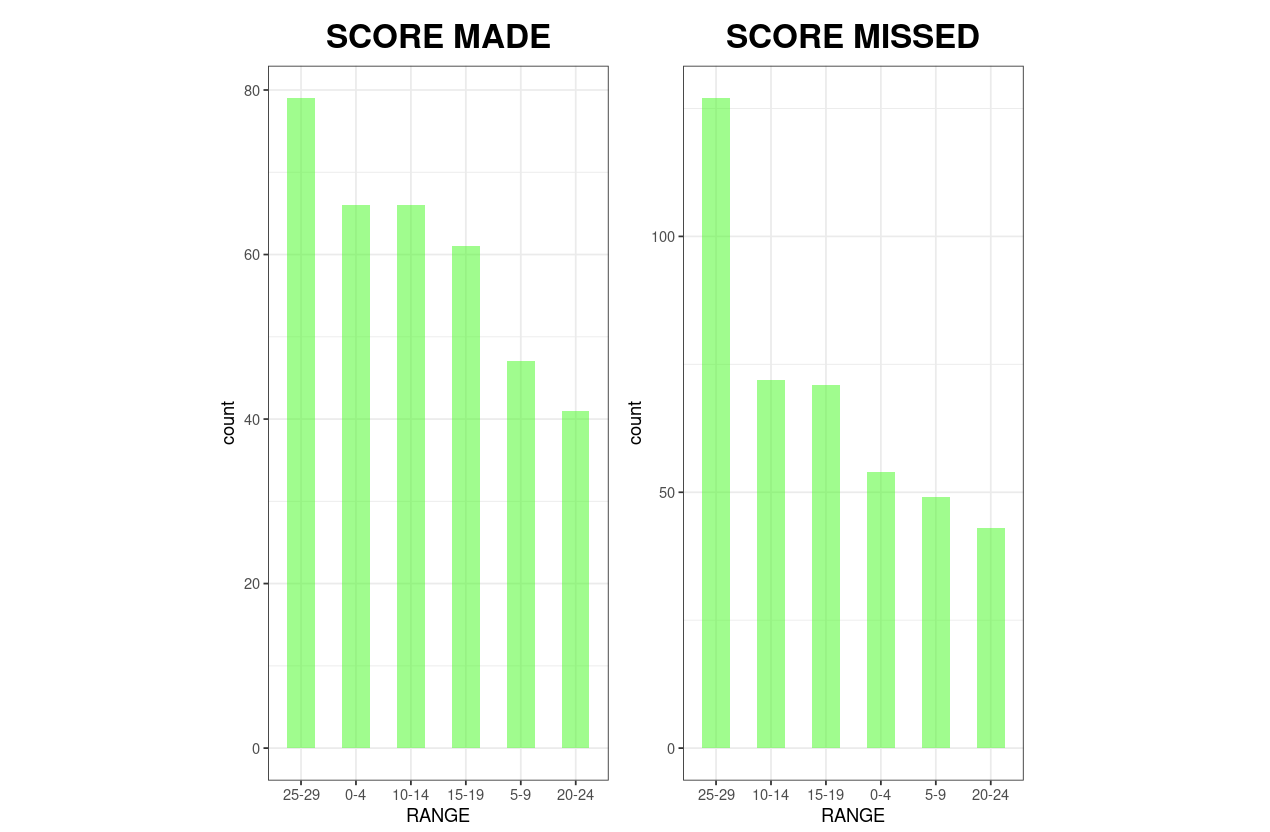
Contoh dari proyek R tentang statistik tembakan NBA
Ide menarik lainnya untuk proyek R bagi pemula adalah menyelidiki tren populasi dunia.
Dataset World Population Data menyediakan statistik total populasi untuk setiap negara dari 1960 hingga 2020, serta beberapa informasi tambahan per negara, seperti wilayah, kelompok pendapatan, dan catatan khusus (jika ada). Ada banyak pertanyaan yang bisa Anda eksplorasi di sini:
Jangan lupa tambahkan grafik yang menarik bila membantu: ini akan membantu pembaca Anda lebih memahami wawasan utama dari analisis Anda.
Jika Anda sedang berada di tengah perjalanan mempelajari data science di R, Anda mungkin tertarik membangun proyek R yang lebih canggih di mana Anda menerapkan keterampilan analisis data sekaligus beberapa algoritma machine learning.
Topik apa yang bisa Anda pilih? Mari lihat beberapa ide potensial untuk proyek data science R tingkat lanjut Anda.
Churn pelanggan adalah kecenderungan pelanggan membatalkan langganan suatu layanan dan, akibatnya, berhenti menjadi klien layanan tersebut. Ini dihitung sebagai persentase pelanggan yang churn dalam periode tertentu.
Indikator ini bergantung pada banyak faktor dan menunjukkan kesehatan bisnis secara keseluruhan. Ketika terlalu tinggi, tingkat churn pelanggan menjadi masalah serius bagi perusahaan mana pun karena menyebabkan hilangnya pendapatan dan merusak reputasi perusahaan. Karena itu, sangat penting mampu memprediksi tingkat churn untuk mencegahnya.
Anda dapat menggunakan dataset Telecom Customer Churn untuk membangun proyek data science memprediksi tingkat churn pelanggan di perusahaan telekomunikasi.
Khususnya di sini, Anda perlu memprediksi apakah seorang pelanggan akan churn atau tidak berdasarkan data yang tersedia dan faktor apa yang meningkatkan probabilitas pelanggan melakukan churn. Secara teknis, ini adalah masalah klasifikasi khas dalam machine learning ketika klien diberi label 1 (churn) atau 0 (non-churn).
Kecurangan kartu kredit adalah tantangan serius dalam perbankan karena bidang ini secara tradisional menangani banyak transaksi online. Deteksi kecurangan kartu kredit sebagian besar merupakan masalah klasifikasi terawasi di mana kita dapat menerapkan metode seperti k-Nearest Neighbors (KNN), regresi logistik, support vector machines (SVM), atau decision tree.
Namun, ini juga dapat diselesaikan menggunakan pendekatan klastering, deteksi anomali, atau jaringan saraf tiruan.
Masalah ini sulit bagi bisnis perbankan secara umum karena pola kecurangan dan taktik pelaku terus berkembang, sehingga sistem deteksi kecurangan harus cepat beradaptasi dengan perubahan ini.
Bagi data scientist atau machine learning scientist, tantangannya juga terletak pada sifat dataset seperti ini: selalu terjadi ketidakseimbangan kelas, karena kasus kecurangan selalu minoritas (untungnya) dan tersembunyi dengan baik di antara transaksi nyata (sayangnya).
Dataset Credit Card Fraud berisi informasi tentang transaksi kartu kredit di bagian barat Amerika Serikat. Pertimbangkan untuk menggunakannya mendeteksi kecurangan kartu kredit dengan menerapkan pendekatan klasifikasi.
Sebagai saran tambahan, model sebaiknya cenderung lebih konservatif, artinya demi keamanan, tidak masalah menandai transaksi sebagai curang meskipun sebenarnya tidak. Anda juga mungkin ingin menyelidiki sebaran geospasial tingkat kecurangan di berbagai negara bagian.
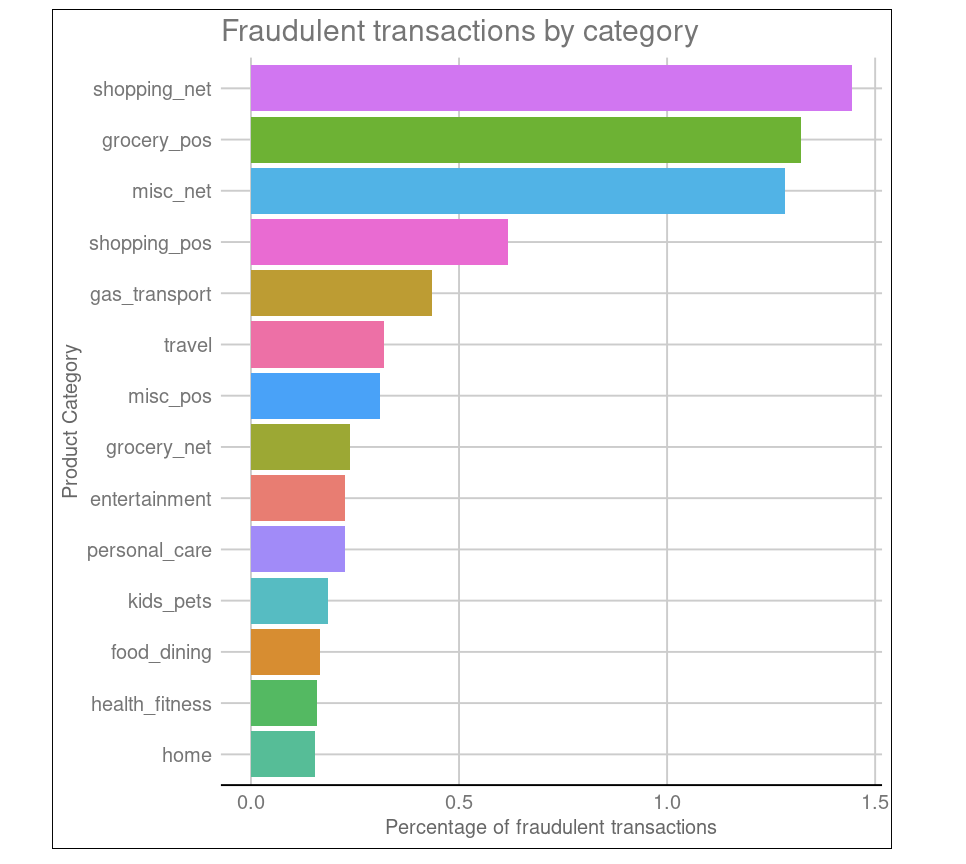
Contoh proyek R lainnya dari DataCamp
Sementara dua proyek sebelumnya terkait pengklasifikasian entri data ke kategori yang telah ditentukan, di sini Anda diminta memprediksi keluaran kontinu berdasarkan fitur masukan. Dengan kata lain, Anda perlu menyelesaikan masalah regresi dengan menerapkan metode seperti regresi linear, regresi ridge, regresi lasso, decision tree, atau support vector machines (SVM).
Dataset Bike Sharing Demand mencakup informasi tentang jumlah sepeda umum yang disewa per jam di sistem bike-sharing Seoul, cuaca, tanggal, waktu, apakah itu hari libur nasional atau tidak, dan lainnya. Tugas Anda adalah memprediksi jumlah sepeda yang akan disewa berdasarkan informasi tersebut.
Anda juga dapat menggunakan proyek ini untuk membandingkan rata-rata jumlah sepeda yang disewa menurut waktu dalam sehari (pagi, siang, dan malam) di empat musim yang berbeda, mengeksplorasi hubungan antara suhu dan jumlah sepeda yang disewa, dll. Tambahkan visualisasi yang bermakna untuk mendukung temuan Anda bila sesuai.
Sebaiknya Anda memiliki setidaknya satu proyek dalam portofolio yang menunjukkan kemampuan menerapkan pendekatan pembelajaran tanpa pengawasan.
Untuk tujuan ini, pertimbangkan dataset E-Commerce Data yang terdiri dari pembelian yang dilakukan di pengecer online berbasis Inggris oleh klien dari berbagai negara selama periode tertentu.
Skenario spekulatif di sini adalah pengecer ingin menginventarisasi barang yang tersedia. Sebagai data scientist yang diasumsikan bekerja di perusahaan ini, Anda perlu mengelompokkan produk ke dalam sejumlah kecil kategori menurut kemiripannya berdasarkan beberapa karakteristik umum (harga, kuantitas terjual, dll.). Ini adalah masalah klastering dalam pembelajaran tanpa pengawasan, dengan k-means sebagai algoritma yang paling populer.
Anda juga dapat menganalisis pertanyaan tambahan, seperti lima negara mana yang menyumbang laba terbesar, atau apakah ukuran pesanan dari negara di luar Inggris secara signifikan lebih besar daripada dari dalam Inggris.
Terakhir, pertimbangkan untuk mengasah keterampilan pemrosesan bahasa alami (NLP) di R dalam salah satu proyek Anda.
Dataset SMS Spam Collection berisi kumpulan lebih dari 5.500 pesan berbahasa Inggris yang diberi label sebagai spam atau non-spam ("ham").
Berdasarkan data ini, buatlah filter yang mampu membedakan antara spam dan pesan biasa secara akurat. Untuk melakukannya, Anda perlu menggunakan paket NLP di R (misalnya, koRpus) untuk mencari pola linguistik dan kontekstual dalam teks pesan dan memahami apa yang membuat sebuah pesan menjadi spam atau ham, kemudian menggeneralisasi temuan ini pada data baru.
Opsional, Anda dapat menyelidiki kata-kata yang paling sering memicu spam dengan membuat visualisasi word cloud.
Sebagai penutup, kami membahas mengapa penting membangun portofolio proyek untuk memulai karier di data science, mengapa dan bagaimana menggunakan R untuk analisis data dan data science, di mana menemukan data dan contoh proyek R, serta topik apa yang dapat Anda kembangkan dalam proyek tersebut baik sebagai pemula maupun pembelajar data science tingkat lanjut.
Tentu saja, ide-ide yang disarankan untuk proyek Anda hanyalah puncak gunung es. Dengan R, Anda dapat melakukan jauh lebih banyak: membuat sistem rekomendasi, melakukan segmentasi pelanggan, meramalkan kurs bursa, melakukan analisis sentimen pelanggan, mengidentifikasi penempatan taksi yang optimal, dan banyak hal lainnya.
Baik Anda menargetkan menjadi Data Scientist with R, Data Analyst with R, Machine Learning Scientist with R, atau Statistician with R, menunjukkan keterampilan Anda melalui proyek praktis sangat berharga. Pustaka R yang luas dan dukungan komunitas menjadikannya pilihan ideal untuk analisis data, machine learning, dan komputasi statistik tingkat lanjut.
Dengan memulai dari proyek sederhana dan secara progresif menangani tantangan yang lebih kompleks, Anda dapat membangun portofolio yang tidak hanya menunjukkan kemahiran teknis tetapi juga kemampuan mengekstrak wawasan bermakna dari data. Pengalaman langsung ini tidak hanya akan mengesankan calon pemberi kerja, tetapi juga mempersiapkan Anda menghadapi beragam tantangan dinamis dalam karier data science Anda.
Untuk inspirasi lebih lanjut, kunjungi DataLab, IDE online dengan dataset pratamuat dan templat pradefinisi untuk menulis kode dan menganalisis data yang membantu Anda beralih dari belajar ke praktik data science.
Kursus untuk R
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




