
打造一份出色的简历本身并不足以打入数据科学就业市场。若您想开启数据科学职业生涯,建立一个数据作品集,将相关项目纳入其中,以便在面试中展示您的数据技能,是至关重要的一步。
好消息是,开始创建这样的作品集,无论何时都不算早也不算晚。无论您是零基础,还是已经学到一半,现在就可以着手进行 R 项目。
您的首批项目显得稚嫩也完全没问题。等您完成更高级的项目后,随时可以回头完善、打磨,甚至删除它们。最重要的是迈出第一步,启动这个过程。
本文将为您梳理一些基于 R 的数据科学项目思路,并提供上手示例。同时,我们还会介绍 R 语言,以及它在数据分析和数据科学中的用法。
为什么使用 R?
R 是一门用于数据分析、数据科学和机器学习的编程语言,同时也是一个用于统计计算与图形的环境。R 专为高阶、快速的统计计算、数据建模和高影响力可视化而设计,这正是其真正实力所在。
此外,R:
- 提供免费且开源的访问:R 对所有人免费开放,其源代码可自由修改与分发。
- 拥有庞大的扩展包生态:截至 2026 年 2 月,R 已配备近 20,000 个文档完善的数据科学扩展包,覆盖广泛应用场景。
- 确保良好兼容性:R 兼容多种操作系统,可在各类平台上灵活使用。
- 具备强大的社区支持:R 拥有优秀的在线社区,提供丰富资源、论坛和用户贡献的扩展包。
关于 R 语言以及如何学习它的更多信息,请参阅我们的《What is R? - The Statistical Computing Powerhouse》和《How to Get Started with R》文章。您也可以学习 DataCamp 课程Introduction to R。
无论是从零开始学习 R,还是精进特定技术技能,都可以查看我们的多种学习资源,包括课程、技能路径和职业路径。尤其是,如果您希望系统、均衡地学习 R,可考虑职业路径Data Scientist with R和Machine Learning Scientist with R。
面向数据分析的 R 项目
进行数据分析是任何数据科学项目的第一步。这很合乎逻辑:在使用机器学习和深度学习方法预测未来之前,我们需要先揭示当前(和过去)的状况。
另一方面,数据分析也可以是一个独立任务。无论哪种情况,R 都为分析目的提供了大量特别适配的实用库。
借助 R,我们可以从网站解析数据,对其进行清洗与整理、可视化、统计探索、提出并检验假设,并从原始数据中提炼有价值的洞见与模式。在这些任务中,统计分析和出色的可视化是 R 的王牌,这也常常是它在此方面胜过主要竞争对手 Python 的原因。
除了通用的多用途 R 扩展包外,还有许多针对各类应用型分析问题的模块。例如:
-
fAssets:用于分析和建模金融资产的扩展包。
-
mdapack:医疗数据分析扩展包。
-
GEOmap:用于地形与地质制图的扩展包。
-
AeRobiology:面向空气生物学数据的计算工具。
-
galigor:面向互联网营销的一组扩展包集合。
-
lingtypology:用于语言类型学与制图的扩展包。
此外,R 还包含一些高度聚焦的库,例如:
- nCov2019:用于探索新冠肺炎(COVID-19)统计数据的扩展包。
面向数据科学的 R 项目
如前所述,R 是面向数据科学的编程语言,提供超过 19,000 个数据科学扩展包。除了上一节列出的纯分析任务,我们还可以使用 R 处理更高级的问题,以便对未知数据进行预测和建模。使用 R,您可以:
- 进行特征选择:从数据集中挑选相关特征以提升模型性能。
- 执行机器学习任务:完成各类机器学习(监督、半监督、无监督与强化学习)和深度学习任务。
- 应用多种方法:采用分类、回归、聚类、自然语言处理(NLP)或人工神经网络(ANN)等多种机器学习方法。
- 评估模型精度:评估不同模型的准确性以确保可靠性。
同样地,除了常用的数据科学扩展包(如用于分类与回归训练的 caret、实现朴素贝叶斯的 naivebayes、构建随机森林模型的 randomForest、用于深度学习的 deepNN 等),还有许多高度专业化,甚至极其细分的库。例如:
-
OenoKPM:用于建模酒精发酵过程中二氧化碳产生动力学的扩展包。
-
fHMM:用于将隐马尔可夫模型拟合到金融数据的扩展包。
-
paleopop:用于耦合生态位-种群古气候模型的模式导向建模框架。
-
ibdsim2:用于模拟家族成员共享染色体区域的扩展包。
-
rSHAPE:用于模拟单倍体无性繁殖种群进化的扩展包。
R 项目
接下来,我们将看看一些 R 项目的示例,并为初学者与资深用户发掘可进一步发展的有趣创意。
R 项目示例
寻找 R 项目的最佳方式之一,就是亲手创建这些示例!
别担心,这并没有看起来那么可怕。即使您是 R 数据科学的初学者,也可以选择“沙盒”项目:这类项目自带可供分析或建模的数据,介绍问题背景,并在需要时提供有用的步骤指引与原因说明。
如果您已较为进阶,也欢迎从更多角度更深入地探索数据,并远超给定指引来满足您对数据的好奇心。无论如何,边做边学的积极实践,往往比只阅读他人的项目更有效。
DataCamp 提供了大量此类R 数据科学项目,可让您练习多种技术技能。这些示例涵盖数据导入与清洗、数据处理、数据可视化、概率与统计、机器学习等。
除了在各类数据科学课程中常见的热门主题(如探索纽约市 Airbnb 市场、可视化新冠疫情、心脏病患者数据聚类或用随机森林预测出租车车费),您还会在此发现大量新颖有趣的选题。欢迎深入探索:
- 编程语言的兴衰
- 探索 538 的万圣节糖果排名
- 对特朗普推文的文本分析
- 能带来回报的学位
- 气候变化对鸟类的影响
- 是什么让宝可梦成为“传说”级?
- 糟糕的密码与 NIST 指南
- 诺贝尔奖获奖者的可视化历史
R 初学者项目
在浏览现有的 R 项目或亲手完成一些引导式项目之后,您也可以选择从零开始创建自己的项目。这在学习 R 的任何阶段都是不错的主意。
如果这是您最初的非引导式项目之一,首先要考虑的是从哪里获取可供实践的数据。幸运的是,有许多热门在线数据仓库提供大量免费且文档完善的数据集,既有真实世界数据,也有合成数据。值得关注的资源包括 DataLab、Kaggle、UCI 机器学习资料库、Google Dataset Search、Google Cloud Platform、FiveThirtyEight 和 Quandl
既然您已拥有丰富的数据选择,作为 R 初学者该如何入手?由于这些将是您在 R 中的首批数据科学项目,可考虑进行基础的数据清洗与处理、简单的数据探索以及数据可视化。
1. 探索 Spotify 数据
Spotify 是最大的数字音乐、视频和媒体服务之一,收录全球数以百万计的歌曲、视频和播客。
您可以使用现成的数据集 Spotify Music Data,其中包含一段时间内约 600 首热门歌曲,从多个维度探索其统计特征。例如,考虑分析以下因素与问题,并在必要时配以有意义的图表:
- 口语化词语的数量
- 响度
- 歌曲时长
- 每首歌的能量值
- 哪些艺人最受欢迎
- 哪些曲风最受欢迎
- 多年来全球音乐偏好发生了哪些变化
- 是什么造就了一首“热门歌曲”
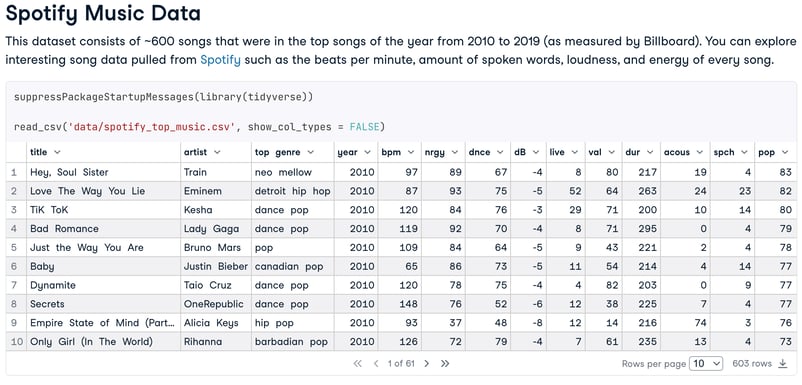
来自 Spotify Music Data R 项目的示例
2. 分析 NBA 投篮统计
美国职业篮球联赛(NBA)是北美的男子职业篮球联赛,共有 30 支球队,是全球最大的联赛之一。
NBA Shooting Data 数据集收录了 2021 年 NBA 季后赛中 4 位球员的数据。您可以分析并可视化这些数据,尝试回答以下问题:
- 每位球员的最佳出手位置是什么?
- 每位球员在哪个距离段最有可能得分?
- 这些球员中谁是最佳防守者?
- 您会让最佳防守者去防守哪位球员?
- 投手效率与防守者之间是否存在相关性?
- 在球场上,命中与未命中的投篮在空间上如何分布?
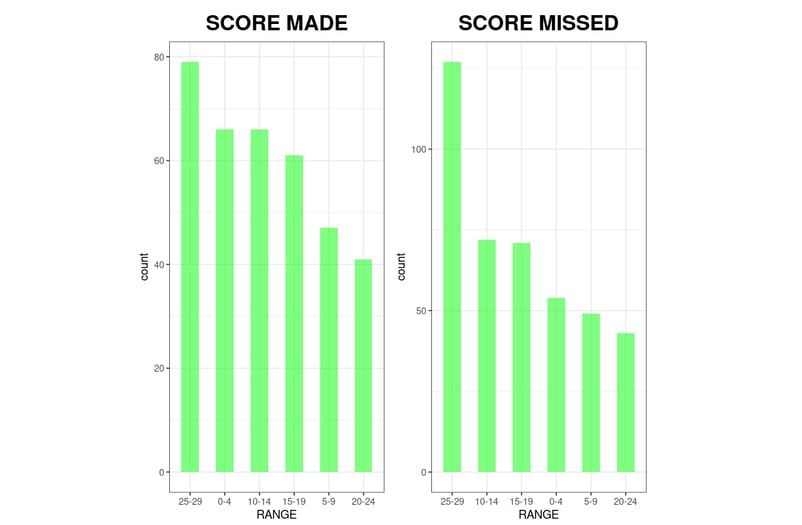
NBA 投篮统计 R 项目的示例
3. 分析世界人口数据
另一个适合初学者的数据科学 R 项目创意,是研究世界人口趋势。
World Population Data 数据集提供了 1960–2020 年各国总人口统计,以及各国的地区、收入组别和特别注记(如有)等附加信息。您可以探索的诸多问题包括:
- 您所在国家(或任一国家)的人口随时间如何变化?
- 世界各地的人口随时间如何变化?
- 哪些国家在人口随时间的增长/下降幅度上最高?
- 在过去五年(或十年)中,哪些国家的人口增长/下降幅度最高?
- 在您出生那一年,您所在国家(或任一国家)有多少人出生?
- 收入组别如何影响一国的人口增长?
- 按地区看,人口增长呈现哪些趋势?
别忘了在合适的地方加入有说服力的图表:它们能帮助读者更好地把握您的分析要点。
更高级的 R 项目
如果您在 R 数据科学学习中已到中段,或许会对构建更复杂的 R 项目感兴趣,在其中既运用数据分析技能,也应用一些机器学习算法。
这些项目可以选哪些主题?下面为您的高级 R 数据科学项目提供一些潜在思路。
4. 预测电信客户流失
客户流失是指客户取消某项服务订阅,从而不再是该服务的客户。它通常以某段时间内流失客户的百分比来计算。
该指标受多种因素影响,反映公司整体的业务健康状况。当流失率过高时,会对任何公司构成严重问题,因为它会导致收入损失并损害公司声誉。因此,能够预测客户流失率以便预防至关重要。
您可以使用 Telecom Customer Churn 数据集,构建一个预测电信公司客户流失率的数据科学项目。
具体来说,您需要基于可用数据预测客户是否会流失,以及哪些因素会增加客户流失的概率。从技术角度看,这是一个典型的机器学习分类问题,即将客户标记为 1(流失)或 0(未流失)。
5. 识别信用卡欺诈
在银行业中,信用卡欺诈是一个严峻挑战,因为该领域传统上涉及大量在线交易。信用卡欺诈检测主要是监督式分类问题,可应用如 K 近邻(KNN)、逻辑回归、支持向量机(SVM)或决策树等方法。
不过,也可以采用聚类、异常检测或人工神经网络等方法来求解。
该问题对银行业而言之所以困难,还在于欺诈模式与不法分子的策略不断演化,因此欺诈检测系统必须快速适应这些变化。
对数据科学家或机器学习科学家而言,挑战还在于此类数据集的性质:它们总是存在类别不平衡,因为欺诈案例(幸好)始终占少数,而且(不幸地)被巧妙地隐藏在真实交易之中。
Credit Card Fraud 数据集包含美国西部地区的信用卡交易信息。考虑用分类方法来检测信用卡欺诈。
作为补充提示,模型应更偏保守:为安全起见,将非欺诈的交易误判为欺诈并非大问题。您也可以研究不同州之间欺诈率的地理分布。
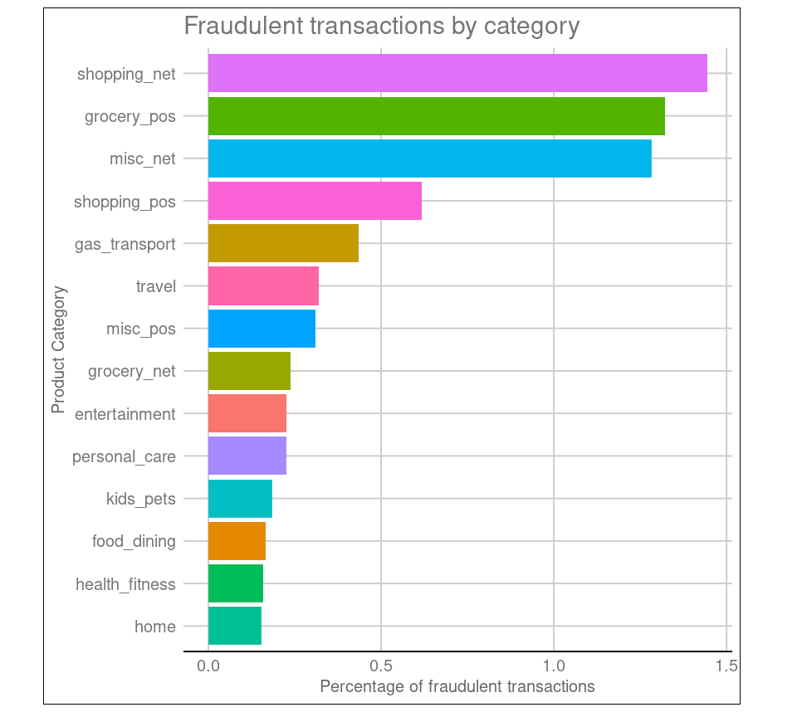
来自 DataCamp 的另一个 R 项目示例
6. 预测共享单车需求
前两个项目与将数据记录归入预定义类别的分类任务相关,而此处您需要基于输入特征预测连续型结果。换言之,您需要解决一个回归问题,可应用线性回归、岭回归、Lasso 回归、决策树或支持向量机(SVM)等方法。
Bike Sharing Demand 数据集包含首尔共享单车系统的按小时租赁数量、天气、日期、时间、是否为公共假日等信息。您的任务是根据这些信息预测将被租用的单车数量。
您还可以借此项目比较四季中一天不同时段(早晨、下午、傍晚)的平均租车数量,探索气温与租车数量之间的关系等。在合适之处加入有洞见的可视化,以支撑您的结论。
7. 电子商务数据聚类
在作品集中至少包含一个展示您能应用无监督学习方法的项目,总是个好主意。
为此,考虑使用 E-Commerce Data 数据集,它包含一家总部位于英国的在线零售商在一定时期内来自不同国家客户的购买记录。
一个设想场景是:零售商希望对现有商品进行盘点。作为该公司的数据科学家,您需要根据一些共同特征(价格、销售数量等)的相似性,将产品分为少量类别。这是一个无监督学习中的聚类问题,其中 k-means 是最常用的算法。
您还可以分析其他问题,例如:利润最高的五个国家是哪些;英国以外国家的订单规模是否显著大于英国境内的订单等。
8. 识别短信垃圾信息
最后,考虑在您的某个项目中锻炼R 中的自然语言处理(NLP)技能。
SMS Spam Collection 数据集收录了 5,500 多条英文短信,并将其相应标注为垃圾(spam)或非垃圾(“ham”)。
基于这些数据,创建一个能准确区分垃圾信息与普通信息的过滤器。为此,您需要使用 R 的 NLP 扩展包(例如 koRpus),在短信文本中寻找语言与上下文模式,弄清是什么使一条短信成为 spam 或 ham,进而将这些观察推广到新数据上。
可选地,您可以通过制作词云来研究最常见的易引发垃圾判定的词汇。
结语
总而言之,我们讨论了为何构建项目作品集对开启数据科学职业生涯至关重要、为何以及如何在数据分析与数据科学中使用 R、到哪里寻找相关数据与 R 项目示例,以及无论您是初学者还是进阶学习者,都可以在这些项目中拓展的主题。
当然,本文给出的项目创意只是冰山一角。使用 R,您可以做得更多:构建推荐系统、进行客户分群、预测股票汇率、开展客户情感分析、优化出租车的站位布局等等。
无论您希望成为一名Data Scientist with R、Data Analyst with R、Machine Learning Scientist with R,还是Statistician with R,通过实践项目展示您的技能都弥足珍贵。R 的庞大库生态与社区支持,使其成为数据分析、机器学习与高级统计计算的理想之选。
从简单项目起步,逐步挑战更复杂的问题,您便能构建一个不仅展现技术实力、还能体现从数据中提炼重要洞见能力的作品集。这种亲身实践的经验,不仅会打动潜在雇主,也能让您为数据科学职业生涯中多样而动态的挑战做好准备。
获取更多灵感,欢迎访问 DataLab,这是一款预载数据集与预设代码模板的在线 IDE,助您从学习走向数据科学的实作。
关于 R 的常见问题
使用 R 有哪些优势?
R 在高阶且快速的统计计算、数据建模与构建富有洞见的可视化方面表现突出。此外,它免费且开源,配备了超过 18,000 个文档完善的数据科学扩展包,兼容多种操作系统,并有一个乐于助人的在线社区提供支持。
如何使用 R 进行数据分析?
用于从网站解析数据、读取、清洗与整理数据,对其进行可视化与统计探索,提出并检验假设,并从原始数据中提炼有意义的洞见与模式。R 还具备大量面向特定领域与任务的数据分析能力。
如何使用 R 进行数据科学?
用于执行分析任务、进行特征选择、开展各类机器学习与深度学习任务、应用多种机器学习与深度学习方法、评估模型准确性并选择最佳模型。R 同样拥有大量高度专业化的数据科学能力。
为什么需要在 R 中构建项目?
用于练习您在 R 中的数据科学技能,从学习走向实作,并在面试中向潜在雇主展示您的能力。
到哪里为我的 R 项目寻找数据?
可以在热门的免费在线数据仓库找到,例如 DataCamp Workspace、Kaggle、UCI 机器学习资料库、Google Dataset Search、Google Cloud Platform、FiveThirtyEight 和 Quandl。
在哪里可以找到 R 项目示例?
在 DataCamp R Projects、GitHub、Kaggle等平台。您可以在 DataCamp 的 R 项目目录中,使用预载数据集自行创建此类项目示例,按照清晰的分步指引了解做什么与为什么,并练习广泛的技术技能。
作为数据科学初学者,我可以创建哪些 R 项目?
包含基础数据清洗、数据处理、数据探索与数据可视化的项目,例如探索 Spotify 数据、分析 NBA 投篮统计或分析世界人口数据。
更高级的 R 项目主题有哪些?
那些需要应用各类机器学习算法并使用多种方法的项目。例如预测电信客户流失、检测信用卡欺诈、预测共享单车需求、电子商务数据聚类、识别短信垃圾信息、创建推荐系统等。