
Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google
Chỉ riêng việc tạo một CV ấn tượng là chưa đủ để bước vào thị trường việc làm khoa học dữ liệu. Nếu bạn muốn bắt đầu sự nghiệp trong lĩnh vực này, một bước quan trọng là xây dựng danh mục dự án phù hợp để thể hiện kỹ năng dữ liệu của bạn trong buổi phỏng vấn.
Tin tốt là không bao giờ là quá sớm hay quá muộn để tạo danh mục như vậy. Dù bạn là người mới hoàn toàn hay đã học được một nửa chặng đường, bạn có thể bắt tay vào các dự án R ngay bây giờ.
Hoàn toàn bình thường nếu những dự án đầu tay trông còn non nớt. Bạn luôn có thể quay lại, phát triển thêm, chỉnh sửa, hoặc thậm chí xóa chúng khi bạn làm ra các dự án nâng cao hơn. Điều quan trọng nhất là bắt đầu.
Trong bài viết này, chúng tôi sẽ gợi ý một số ý tưởng hữu ích cho các dự án khoa học dữ liệu bằng R và xem qua vài ví dụ để bạn khởi động. Chúng tôi cũng bàn về ngôn ngữ R và cách nó được dùng cho phân tích dữ liệu và khoa học dữ liệu.
R là một ngôn ngữ lập trình dùng cho phân tích dữ liệu, khoa học dữ liệu và học máy, đồng thời bao gồm môi trường cho tính toán và đồ họa thống kê. R được thiết kế chuyên biệt cho tính toán thống kê nâng cao và nhanh, mô hình hóa dữ liệu và tạo các trực quan hóa giàu ý nghĩa. Đây là nơi ngôn ngữ này phát huy sức mạnh thực sự.
Ngoài ra, R:
Bạn sẽ tìm thấy thêm thông tin về R và cách học nó qua các bài viết R là gì? - Cỗ máy tính toán thống kê và Bắt đầu với R. Bạn cũng có thể học khóa của DataCamp Giới thiệu về R.
Để học R từ con số 0 hoặc nắm vững kỹ năng kỹ thuật cụ thể, hãy xem các tài nguyên học tập của chúng tôi, gồm khóa học, lộ trình kỹ năng và lộ trình nghề nghiệp. Đặc biệt, để có lộ trình cân bằng và toàn diện, hãy cân nhắc các lộ trình nghề nghiệp Data Scientist với R và Machine Learning Scientist với R.
Thực hiện phân tích dữ liệu là bước đầu tiên của mọi dự án khoa học dữ liệu. Điều này hợp lý: trước khi dự đoán tương lai bằng các kỹ thuật học máy và học sâu, chúng ta phải làm rõ trạng thái hiện tại (và quá khứ).
Mặt khác, phân tích dữ liệu cũng có thể là một nhiệm vụ độc lập. Trong cả hai trường hợp, R cung cấp nhiều thư viện hữu ích được điều chỉnh riêng cho mục đích phân tích.
Với R, chúng ta có thể lấy dữ liệu từ website, làm sạch và xử lý, trực quan hóa, khám phá thống kê, xây dựng và kiểm định giả thuyết, và rút ra các insight, mẫu hình có ý nghĩa từ dữ liệu ban đầu. Trong số đó, phân tích thống kê và trực quan hóa ấn tượng là thế mạnh thực sự của R, thường giúp ngôn ngữ này vượt qua đối thủ chính là Python.
Bên cạnh các gói đa dụng phổ biến của R, còn có rất nhiều mô-đun dành cho các bài toán phân tích ứng dụng khác nhau. Ví dụ:
fAssets: Gói này dùng để phân tích và mô hình hóa tài sản tài chính.
mdapack: Gói dành cho phân tích dữ liệu y tế.
GEOmap: Gói dùng cho bản đồ địa hình và địa chất.
AeRobiology: Công cụ tính toán cho dữ liệu sinh học không khí.
galigor: Tập hợp các gói cho tiếp thị trên Internet.
lingtypology: Gói dùng cho kiểu loại học ngôn ngữ và lập bản đồ.
Ngoài ra, R còn có cả các thư viện siêu chuyên biệt như:
Như đã đề cập, R là ngôn ngữ định hướng khoa học dữ liệu với hơn 19.000 gói. Bên cạnh các tác vụ phân tích thuần túy, chúng ta có thể dùng R cho các bài toán nâng cao nhằm dự báo và mô hình hóa dữ liệu chưa biết. Dùng R cho phép chúng ta:
Một lần nữa, bên cạnh các gói khoa học dữ liệu thường dùng (caret cho huấn luyện phân loại và hồi quy, naivebayes cho thuật toán Naive Bayes, randomForest cho mô hình rừng ngẫu nhiên, deepNN cho học sâu, v.v.), còn có rất nhiều thư viện chuyên biệt, đến mức rất cụ thể. Có thể kể đến:
OenoKPM: Gói dùng để mô hình động học sinh CO2 trong quá trình lên men rượu.
fHMM: Gói dùng để khớp mô hình Markov ẩn vào dữ liệu tài chính.
paleopop: Khung mô hình định hướng mẫu cho các mô hình hốc sinh thái - quần thể trong bối cảnh cổ khí hậu.
ibdsim2: Gói dùng để mô phỏng các vùng nhiễm sắc thể được các thành viên gia đình chia sẻ.
rSHAPE: Gói dùng để mô phỏng tiến hóa quần thể đơn bội sinh sản vô tính.
Bây giờ, chúng ta sẽ xem một số ví dụ dự án R và tìm ra những ý tưởng thú vị để phát triển thêm, cho cả người mới bắt đầu lẫn người dùng giàu kinh nghiệm.
Một trong những cách đáng giá nhất để tìm dự án R là tự tạo các ví dụ như vậy!
Đừng lo, không đáng sợ như bạn nghĩ. Ngay cả khi bạn mới bắt đầu với khoa học dữ liệu bằng R, bạn có thể chọn các dự án “sandbox” đi kèm dữ liệu sẵn sàng để phân tích hoặc mô hình hóa, giới thiệu bối cảnh vấn đề và đưa ra hướng dẫn hữu ích về các bước cần làm và lý do.
Nếu bạn đã ở mức nâng cao hơn, bạn luôn có thể đi sâu dữ liệu từ nhiều góc độ và vượt xa các chỉ dẫn gợi ý để thỏa mãn sự tò mò. Dù thế nào, học thông qua thực hành luôn tốt hơn chỉ đọc dự án của người khác.
DataCamp cung cấp rất nhiều dự án khoa học dữ liệu bằng R giúp bạn luyện tập nhiều kỹ năng kỹ thuật. Các ví dụ bao gồm nhập và làm sạch dữ liệu, thao tác dữ liệu, trực quan hóa dữ liệu, xác suất & thống kê, học máy và hơn thế nữa.
Bên cạnh các chủ đề phổ biến (như Khám phá thị trường Airbnb NYC, Trực quan hóa COVID-19, Phân cụm dữ liệu bệnh nhân tim mạch, hoặc Dự đoán cước taxi với Random Forest) thường được phân tích trong các trường khoa học dữ liệu, bạn cũng sẽ tìm thấy nhiều chủ đề mới mẻ, thú vị. Hãy thoải mái khám phá sâu hơn:
Sau khi xem qua các dự án R hiện có hoặc tự làm vài dự án có hướng dẫn, bạn có thể quyết định bắt tay tạo dự án của riêng mình từ đầu. Đây luôn là một ý tưởng hay, ở bất kỳ giai đoạn học R nào.
Nếu bạn đang thực hiện một trong những dự án đầu tiên không có hướng dẫn, điều đầu tiên cần nghĩ là tìm dữ liệu ở đâu. May mắn là có rất nhiều kho trực tuyến phổ biến cung cấp bộ dữ liệu miễn phí, được tài liệu hóa tốt, cả dữ liệu thực lẫn dữ liệu tổng hợp. Một số nguồn đáng chú ý là DataLab, Kaggle, UCI Machine Learning Repository, Google Dataset Search, Google Cloud Platform, FiveThirtyEight và Quandl
Giờ bạn đã có rất nhiều lựa chọn dữ liệu, bạn có thể làm gì với chúng khi là người mới bắt đầu với R? Vì đây sẽ là các dự án khoa học dữ liệu đầu tiên bằng R, hãy cân nhắc thực hiện làm sạch và thao tác dữ liệu cơ bản, khám phá dữ liệu đơn giản và trực quan hóa dữ liệu.
Spotify là một trong những dịch vụ nhạc, video và nội dung số lớn nhất, nơi bạn có thể tìm thấy hàng triệu bài hát, video và podcast từ khắp thế giới.
Bạn có thể dùng bộ dữ liệu đã sẵn sàng Spotify Music Data, chứa khoảng 600 bài hát hàng đầu theo thời gian và khám phá thống kê của chúng từ nhiều khía cạnh. Ví dụ, hãy phân tích các yếu tố và câu hỏi sau, kèm các biểu đồ phù hợp khi cần:
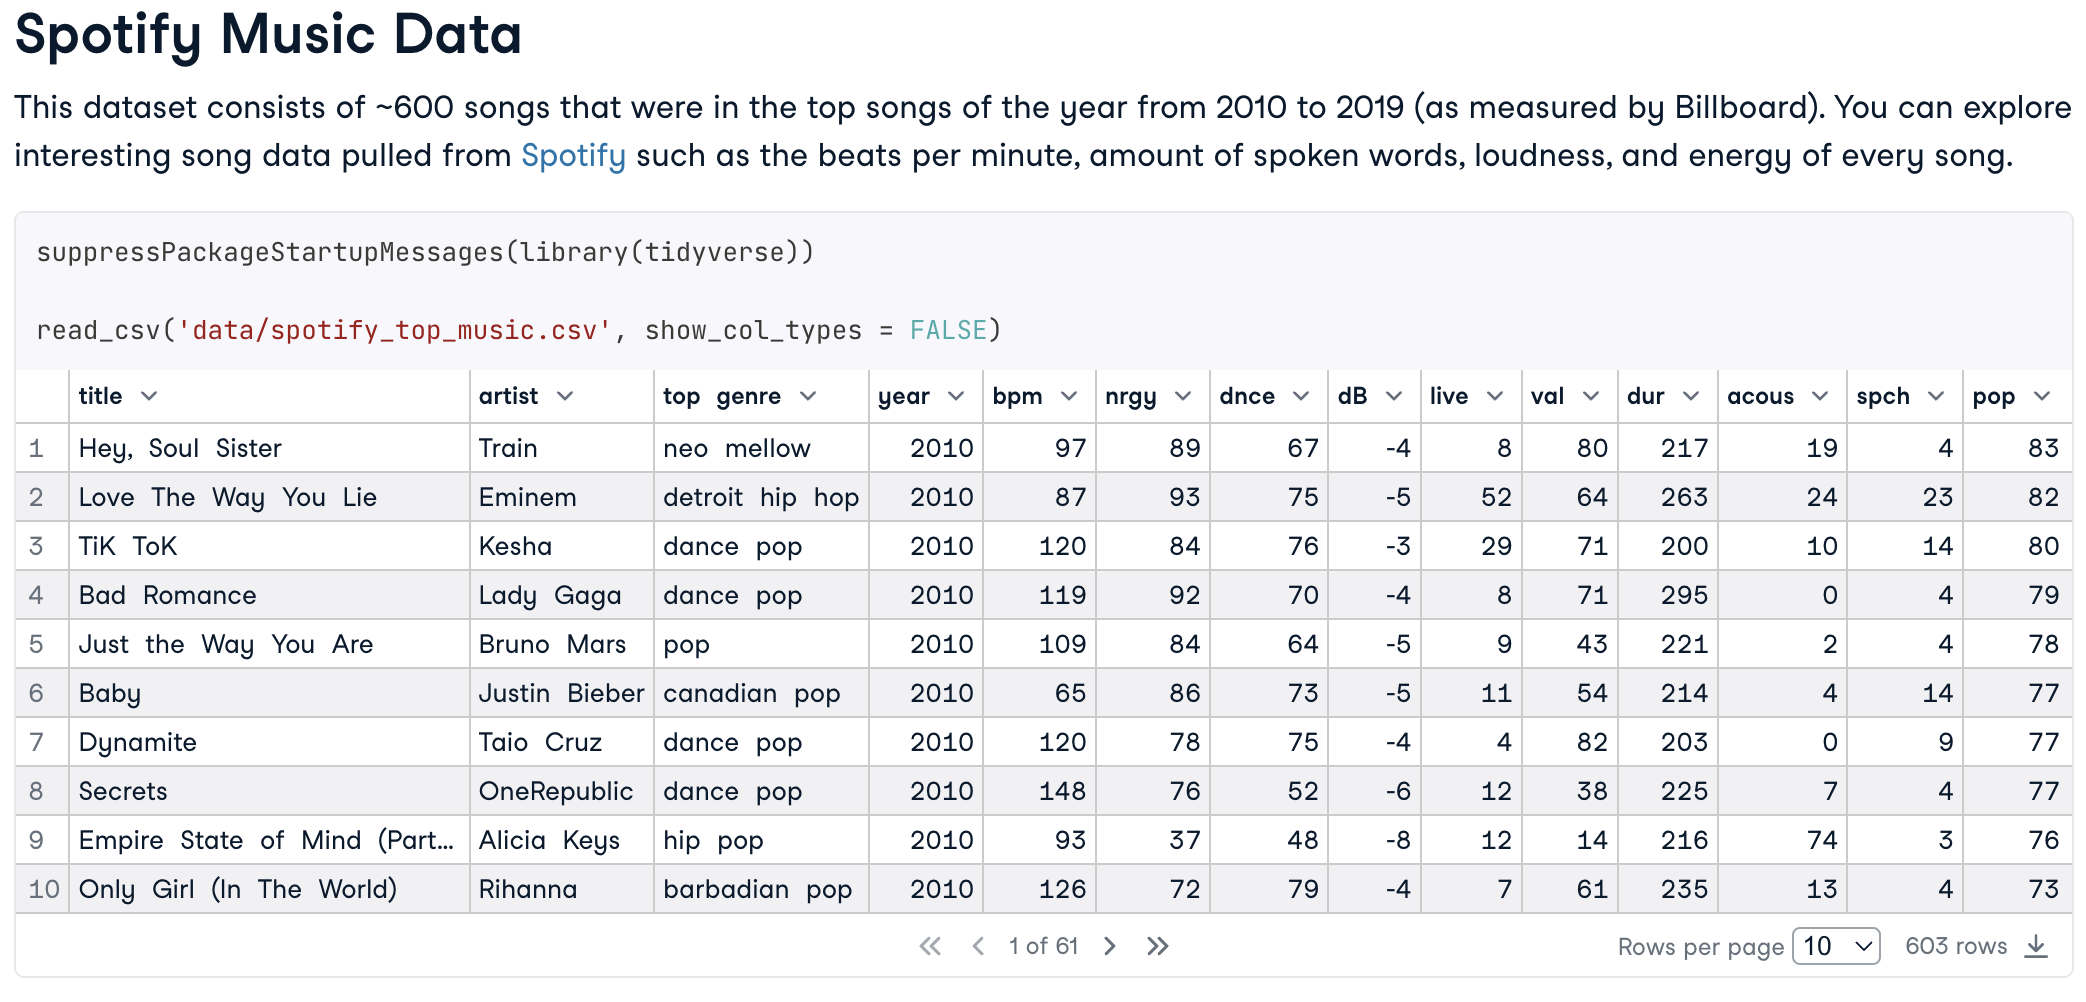
Ví dụ từ dự án R sử dụng Spotify Music Data
Hiệp hội Bóng rổ Quốc gia (NBA) là giải bóng rổ nhà nghề nam Bắc Mỹ gồm 30 đội, một trong những giải lớn nhất thế giới.
Bộ dữ liệu NBA Shooting Data chứa dữ liệu thu thập cho bốn cầu thủ khác nhau tại vòng play-off NBA 2021. Bạn có thể phân tích và trực quan hóa dữ liệu này, cố gắng trả lời các câu hỏi sau:
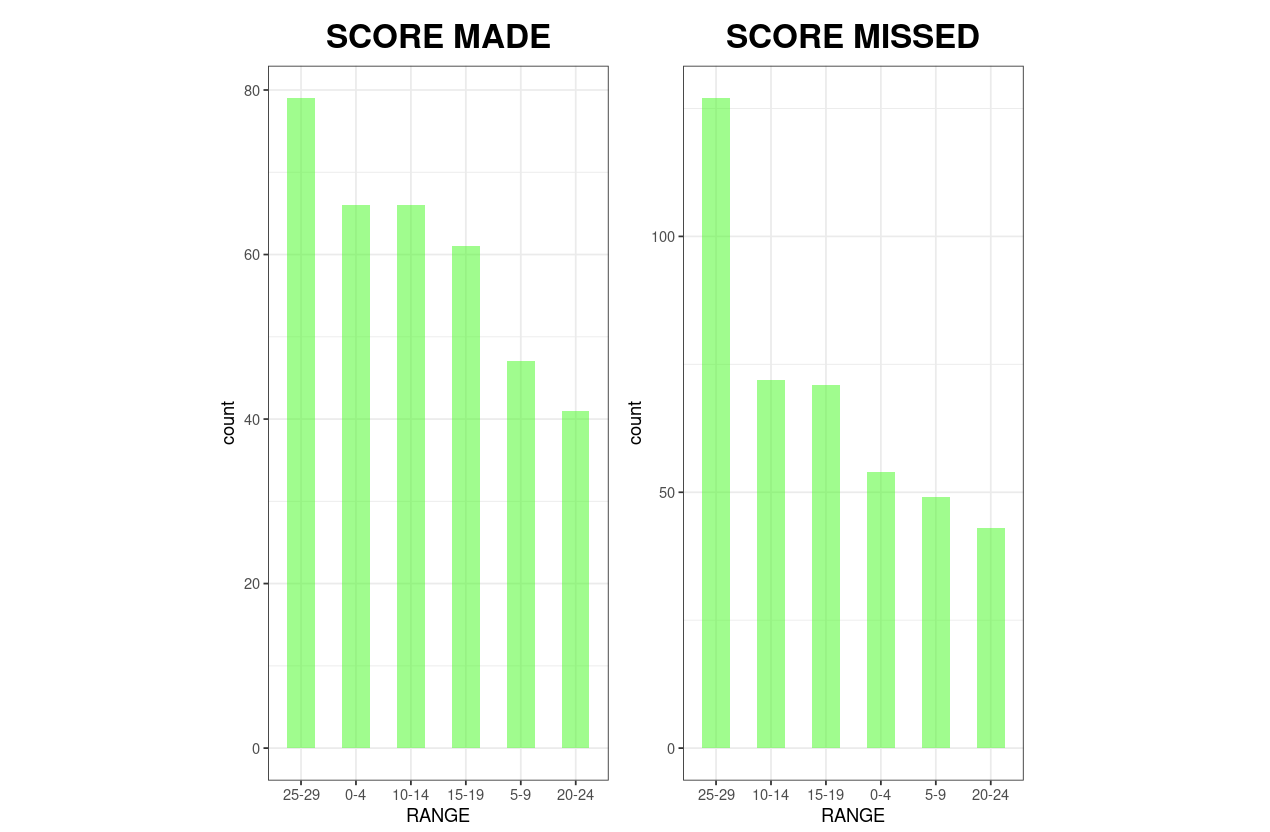
Ví dụ từ dự án R về thống kê ném rổ NBA
Một ý tưởng thú vị khác cho người mới là khảo sát xu hướng dân số thế giới.
Bộ dữ liệu World Population Data cung cấp thống kê dân số tổng cho từng quốc gia từ 1960 đến 2020, cùng một số thông tin bổ sung theo quốc gia như khu vực, nhóm thu nhập và ghi chú đặc biệt (nếu có). Có nhiều câu hỏi bạn có thể khám phá:
Đừng quên bổ sung các biểu đồ thuyết phục ở nơi phù hợp: chúng sẽ giúp độc giả nắm bắt tốt hơn các insight chính từ phân tích của bạn.
Nếu bạn đang học R ở mức trung cấp, có thể bạn sẽ hứng thú xây dựng các dự án R phức tạp hơn, nơi bạn áp dụng cả kỹ năng phân tích dữ liệu và một số thuật toán học máy.
Bạn có thể chọn chủ đề gì? Hãy xem một số ý tưởng tiềm năng cho các dự án R nâng cao.
Rời bỏ (churn) là xu hướng khách hàng hủy đăng ký dịch vụ và do đó ngừng là khách hàng. Chỉ số này được tính bằng phần trăm khách hàng rời bỏ trong một khoảng thời gian nhất định.
Chỉ số này phụ thuộc nhiều yếu tố và phản ánh sức khỏe kinh doanh tổng thể. Khi quá cao, tỷ lệ rời bỏ là vấn đề nghiêm trọng vì dẫn đến thất thu và ảnh hưởng danh tiếng công ty. Do đó, dự đoán tỷ lệ rời bỏ để phòng ngừa là rất quan trọng.
Bạn có thể dùng bộ dữ liệu Telecom Customer Churn để xây dựng dự án dự đoán rời bỏ trong một công ty viễn thông.
Cụ thể, bạn cần dự đoán liệu một khách hàng có rời bỏ hay không dựa trên dữ liệu sẵn có và những yếu tố nào làm tăng xác suất rời bỏ. Về kỹ thuật, đây là một bài toán phân loại điển hình, khi khách hàng được gán nhãn 1 (rời bỏ) hoặc 0 (không rời bỏ).
Gian lận thẻ tín dụng là thách thức nghiêm trọng trong ngân hàng vì ngành này xử lý rất nhiều giao dịch trực tuyến. Phát hiện gian lận thẻ tín dụng chủ yếu là bài toán phân loại có giám sát, nơi có thể áp dụng các phương pháp như k-láng giềng gần nhất (KNN), hồi quy logistic, máy vector hỗ trợ (SVM) hoặc cây quyết định.
Tuy nhiên, cũng có thể giải bằng phân cụm, nhận dạng bất thường hoặc mạng nơ-ron nhân tạo.
Bài toán này khó cho ngành ngân hàng nói chung vì các mẫu gian lận và chiến thuật của kẻ gian liên tục tinh vi hơn, nên hệ thống phải thích ứng nhanh.
Với nhà khoa học dữ liệu hoặc học máy, thách thức còn nằm ở bản chất dữ liệu: luôn mất cân bằng lớp, vì các trường hợp gian lận luôn là thiểu số (may mắn thay) và bị che giấu giữa các giao dịch thật (đáng tiếc).
Bộ dữ liệu Credit Card Fraud chứa thông tin về các giao dịch thẻ tín dụng ở miền Tây Hoa Kỳ. Hãy dùng nó để phát hiện gian lận bằng cách áp dụng phương pháp phân loại.
Gợi ý thêm: mô hình nên thiên về thận trọng, tức vì an toàn, việc gắn nhãn nhầm một số giao dịch hợp lệ là gian lận không phải vấn đề quá lớn. Bạn cũng có thể khảo sát phân bố không gian địa lý của tỷ lệ gian lận giữa các bang.
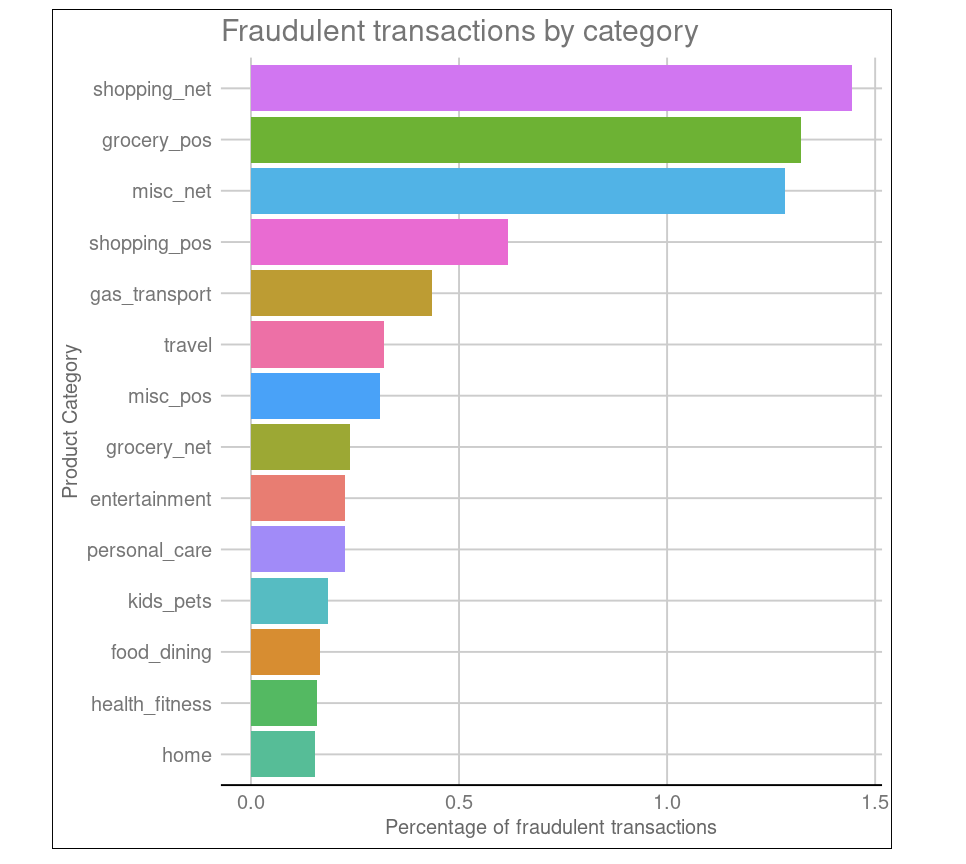
Một ví dụ dự án R khác từ DataCamp
Trong khi hai dự án trước liên quan đến phân loại các bản ghi vào nhóm định sẵn, ở đây bạn cần dự đoán biến liên tục dựa trên các đặc trưng đầu vào. Nói cách khác, bạn cần giải bài toán hồi quy với các phương pháp như hồi quy tuyến tính, ridge, lasso, cây quyết định hoặc SVM.
Bộ dữ liệu Bike Sharing Demand bao gồm thông tin về số xe đạp công cộng được thuê theo giờ trong hệ thống chia sẻ xe đạp của Seoul, thời tiết, ngày tháng, thời gian, có phải ngày nghỉ lễ hay không, v.v. Nhiệm vụ của bạn là dự đoán số xe sẽ được thuê dựa trên thông tin đó.
Bạn cũng có thể so sánh số xe thuê trung bình theo thời điểm trong ngày (sáng, trưa, tối) giữa bốn mùa, khám phá mối quan hệ giữa nhiệt độ và số xe được thuê, v.v. Ở nơi phù hợp, thêm các trực quan hóa giàu thông tin để hỗ trợ phát hiện của bạn.
Luôn là ý tưởng hay khi có ít nhất một dự án trong danh mục thể hiện khả năng áp dụng học không giám sát.
Vì mục đích này, hãy xem xét bộ dữ liệu E-Commerce Data gồm các giao dịch mua tại một nhà bán lẻ trực tuyến ở Anh bởi khách hàng từ nhiều quốc gia trong một khoảng thời gian.
Một kịch bản giả định là nhà bán lẻ muốn kiểm kê hàng hóa. Là nhà khoa học dữ liệu tiềm năng tại công ty, bạn cần nhóm sản phẩm thành một số ít danh mục theo mức độ tương đồng dựa trên vài đặc trưng chung (giá, số lượng bán, v.v.). Đây là bài toán phân cụm trong học không giám sát, với k-means là thuật toán phổ biến nhất.
Bạn cũng có thể phân tích các câu hỏi bổ sung, như năm quốc gia nào mang lại lợi nhuận nhiều nhất, hoặc quy mô đơn hàng từ ngoài Vương quốc Anh có lớn hơn đáng kể so với trong nước hay không.
Cuối cùng, hãy vận dụng kỹ năng xử lý ngôn ngữ tự nhiên (NLP) trong R của bạn trong một dự án.
Bộ dữ liệu SMS Spam Collection chứa hơn 5.500 tin nhắn tiếng Anh, được gán nhãn spam hoặc không spam ("ham").
Dựa trên dữ liệu này, hãy tạo bộ lọc có thể phân biệt chính xác giữa spam và tin nhắn thường. Để làm vậy, bạn sẽ cần một gói NLP của R (ví dụ, koRpus) để tìm các mẫu ngôn ngữ và ngữ cảnh trong văn bản, xác định điều gì khiến một tin nhắn là spam hay ham, rồi khái quát các quan sát đó lên dữ liệu mới.
Tùy chọn, bạn có thể khảo sát các từ dễ xuất hiện trong spam nhất bằng cách tạo đám mây từ.
Tóm lại, chúng ta đã bàn về lý do cần xây dựng danh mục dự án để bắt đầu sự nghiệp khoa học dữ liệu, vì sao và cách dùng R cho phân tích và khoa học dữ liệu, nơi tìm dữ liệu và ví dụ dự án R, cũng như các chủ đề bạn có thể phát triển dù là người mới hay đã nâng cao.
Dĩ nhiên, các ý tưởng gợi ý chỉ là phần nổi của tảng băng. Với R, bạn có thể làm nhiều hơn nữa: tạo hệ thống gợi ý, phân khúc khách hàng, dự báo tỷ giá chứng khoán, phân tích cảm xúc khách hàng, xác định vị trí tối ưu cho taxi, và nhiều điều khác.
Dù bạn đang hướng tới trở thành Data Scientist với R, Data Analyst với R, Machine Learning Scientist với R, hay Statistician với R, việc thể hiện kỹ năng qua các dự án thực tế là vô giá. Thư viện phong phú và cộng đồng hỗ trợ của R khiến nó trở thành lựa chọn lý tưởng cho phân tích dữ liệu, học máy và tính toán thống kê nâng cao.
Bắt đầu từ các dự án đơn giản và từng bước chinh phục thử thách phức tạp hơn, bạn có thể xây dựng danh mục dự án vừa thể hiện năng lực kỹ thuật vừa cho thấy khả năng rút ra insight có ý nghĩa từ dữ liệu. Trải nghiệm thực hành này không chỉ gây ấn tượng với nhà tuyển dụng mà còn chuẩn bị cho bạn trước những thách thức đa dạng, năng động trong sự nghiệp khoa học dữ liệu.
Để có thêm cảm hứng, hãy truy cập DataLab, một IDE trực tuyến với dữ liệu tải sẵn và mẫu mã nguồn định sẵn giúp bạn chuyển từ học sang thực hành khoa học dữ liệu.
Khóa học về R
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
