Kursus
Pengantar R
4 jam
3.1M
Regresi linear adalah salah satu teknik statistik yang paling penting dan mendasar. Menguasai teknik ini sangat penting bagi setiap analis data dan data scientist karena, seperti yang akan Anda lihat, teknik ini menjadi dasar bagi banyak metode yang lebih lanjut.
Tutorial ini akan memandu Anda melalui proses melakukan regresi linear di R, yang merupakan bahasa pemrograman penting. Di akhir tutorial ini, Anda akan memahami cara menerapkan dan menafsirkan model regresi linear, sehingga lebih mudah menerapkan pengetahuan ini pada tugas analisis data Anda.
Jika Anda belum familiar dengan bahasa pemrograman R, kami sarankan tutorial berikut untuk memulai: Exploratory Data Analysis in R for Absolute Beginners dan Mastering Data Structures in the R Programming Language.
Regresi linear adalah model statistik yang menganalisis hubungan antara variabel respons (sering disebut y) dan satu atau lebih variabel beserta interaksinya (sering disebut x atau variabel penjelas). Anda kerap membangun hubungan semacam ini secara intuitif, misalnya saat Anda memperkirakan usia seorang anak berdasarkan tinggi badannya, Anda berasumsi semakin tua usianya, semakin tinggi pula badannya.
Regresi linear adalah salah satu model statistik paling dasar. Hasilnya bisa ditafsirkan oleh hampir semua orang, dan telah ada sejak awal abad ke-19. Inilah yang membuat regresi linear begitu populer. Model ini sederhana, dan telah bertahan selama ratusan tahun. Meskipun tidak secanggih algoritme lain seperti jaringan saraf tiruan atau random forest, menurut survei KD Nuggets, regresi merupakan algoritme yang paling banyak digunakan oleh data scientist pada 2016 dan 2017. Bahkan diperkirakan algoritme ini masih akan digunakan pada tahun 2118!
Dalam tutorial regresi linear ini, kita akan mempelajari cara membuat regresi linear di R, menelusuri langkah-langkah yang perlu Anda lakukan dengan contoh yang bisa Anda praktikkan.
Untuk menjalankan semua contoh kode dalam tutorial ini dengan mudah, Anda bisa membuat workbook DataLab secara gratis yang sudah berisi R dan mencakup semua contoh kode. Untuk latihan lebih lanjut tentang regresi linear, lihat latihan praktis DataCamp kami.
Tidak semua masalah bisa diselesaikan dengan algoritme yang sama. Regresi linear dikenal baik digunakan ketika ada hubungan linear antara respons dan luaran. Dengan kata lain, regresi linear mengasumsikan bahwa terdapat hubungan linear antara variabel respons dan variabel penjelas. Pada kasus dua variabel, ini berarti Anda bisa memadankan sebuah garis di antara keduanya. Kembali ke contoh usia anak tadi, jelas ada hubungan antara usia anak dan tinggi badannya.
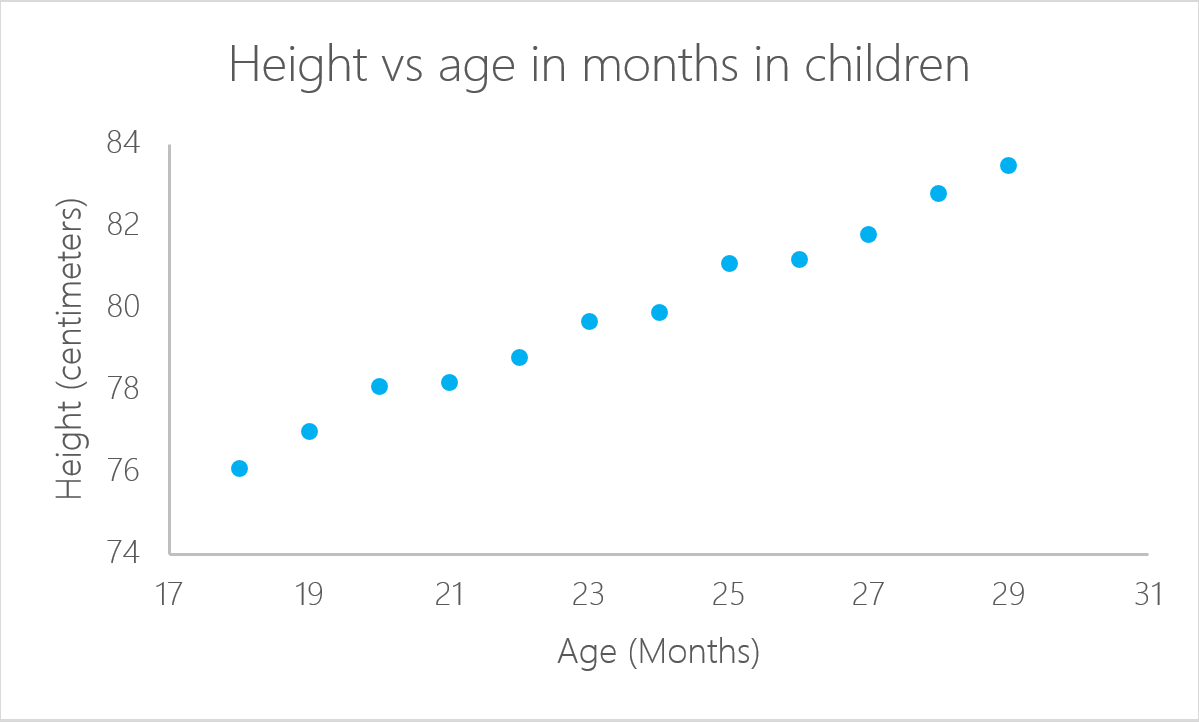
Pada contoh khusus ini, Anda dapat menghitung tinggi seorang anak jika Anda mengetahui usianya:
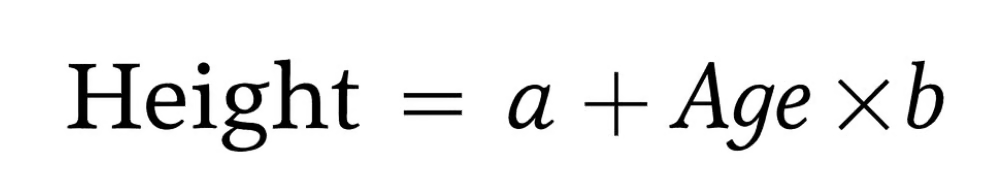
Dalam hal ini, a dan b masing-masing disebut intersep dan kemiringan (slope). Dengan contoh yang sama, a, atau intersep, adalah nilai titik awal pengukuran. Bayi yang baru lahir dengan usia nol bulan tidak memiliki tinggi nol sentimeter. Inilah fungsi intersep. Kemiringan mengukur perubahan tinggi terhadap usia dalam bulan. Secara umum, setiap kali usia anak bertambah satu bulan, tinggi badannya akan bertambah sebesar b.
Regresi linear dapat dihitung di R dengan perintah lm(). Pada contoh berikut, kita menggunakan perintah ini untuk menghitung perkiraan tinggi berdasarkan usia anak.
Pertama, impor pustaka readxl untuk membaca file Microsoft Excel. Kursus Introduction to Importing Data in R kami merupakan sumber yang bagus jika Anda belum familiar dengan cara mengimpor file Excel atau CSV ke lingkungan R seperti RStudio.
Anda dapat mengunduh data yang digunakan untuk tutorial ini sebelum memulai. Unduh data ke sebuah objek bernama ageandheight lalu buat regresi linear pada baris ketiga. Fungsi lm() menerima variabel dalam format:
lm([target] ~ [predictor], data = [data source])Pada kode berikut, kita menggunakan fungsi lm() untuk membuat objek model linear, yang kita sebut lmHeight. Kita kemudian menggunakan fungsi summary() pada lmHeight untuk melihat informasi terperinci tentang kinerja model dan koefisiennya.
library(readxl)

ageandheight <- read_excel("ageandheight.xls", sheet = "Hoja2") #Upload the data

lmHeight = lm(height~age, data = ageandheight) #Create the linear regression

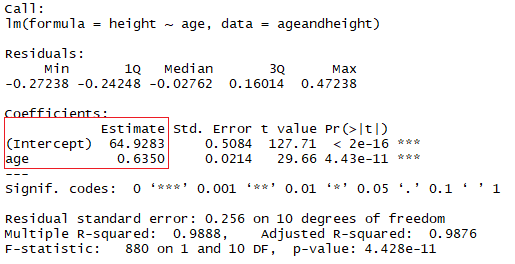
summary(lmHeight) #Review the resultsPada kotak merah, Anda dapat melihat nilai intersep (nilai “a”) dan kemiringan (nilai “b”) untuk usia. Nilai “a” dan “b” ini memplot sebuah garis di antara semua titik data. Jadi, dalam kasus ini, jika ada seorang anak berusia 20,5 bulan, a adalah 64,92, dan b adalah 0,635, maka model memprediksi (rata-rata) tinggi badannya dalam sentimeter sekitar 64,92 + (0,635 * 20,5) = 77,93 cm.
Ketika sebuah regresi mempertimbangkan dua atau lebih prediktor untuk membentuk regresi linear, itu disebut regresi linear berganda. Dengan logika yang sama seperti contoh sederhana sebelumnya, tinggi badan anak akan diukur oleh:
Tinggi = a + Usia × b1 + (Jumlah Saudara} × b2
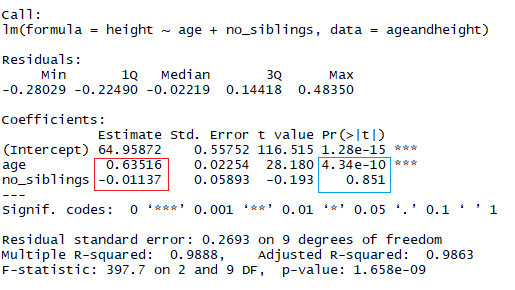
Sekarang Anda melihat tinggi badan sebagai fungsi dari usia dalam bulan dan jumlah saudara yang dimiliki anak. Pada gambar di atas, persegi panjang merah menunjukkan koefisien (b1 dan b2). Anda dapat menafsirkan koefisien ini sebagai berikut:
Saat membandingkan anak-anak dengan jumlah saudara yang sama, tinggi badan rata-rata yang diprediksi meningkat sebesar 0,63 cm untuk setiap pertambahan satu bulan usia. Demikian pula, saat membandingkan anak-anak dengan usia yang sama, tinggi badan menurun (karena koefisiennya negatif) sebesar -0,01 cm untuk setiap kenaikan jumlah saudara.
Di R, untuk menambahkan koefisien lain, tambahkan simbol "+" untuk setiap variabel tambahan yang ingin Anda masukkan ke dalam model.
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results
Seperti yang mungkin sudah Anda perhatikan, melihat jumlah saudara adalah cara yang kurang masuk akal untuk memprediksi tinggi seorang anak. Aspek lain yang perlu diperhatikan dalam model linear Anda adalah nilai p dari koefisien. Pada contoh sebelumnya, persegi panjang biru menunjukkan nilai p untuk koefisien usia dan jumlah saudara. Secara sederhana, nilai p menunjukkan apakah Anda dapat menolak atau menerima sebuah hipotesis. Hipotesis, dalam hal ini, adalah bahwa prediktor tidak bermakna bagi model Anda.
Cara standar untuk menguji apakah prediktor tidak bermakna adalah dengan melihat apakah nilai p lebih kecil dari 0,05.
Cara yang baik untuk menguji kualitas kecocokan model adalah dengan melihat residual atau selisih antara nilai sebenarnya dan nilai yang diprediksi. Garis lurus pada gambar di atas merepresentasikan nilai yang diprediksi. Garis vertikal merah dari garis lurus ke nilai data teramati adalah residual.
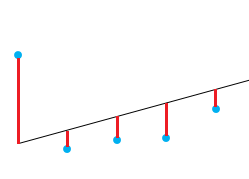
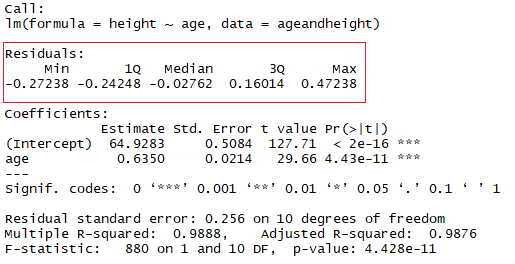
Gagasannya adalah jumlah residual kira-kira nol atau serendah mungkin. Dalam praktik, sebagian besar kasus tidak akan mengikuti garis lurus yang sempurna, sehingga residual dapat diharapkan. Pada ringkasan fungsi lm() di R, Anda bisa melihat statistik deskriptif tentang residual model; pada contoh yang sama, kotak merah menunjukkan bagaimana residual kira-kira bernilai nol.
Salah satu ukuran yang sangat umum digunakan untuk menguji seberapa baik model Anda adalah koefisien determinasi atau R². Ukuran ini didefinisikan sebagai proporsi variabilitas total yang dijelaskan oleh model regresi.
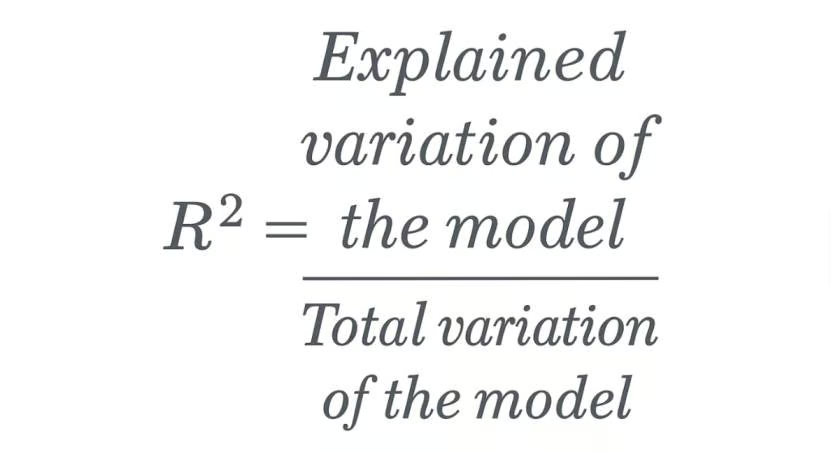
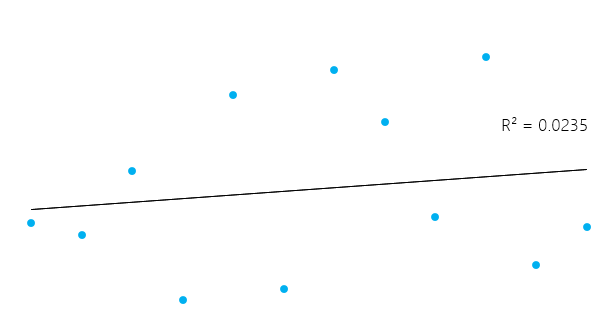
Ini mungkin terlihat agak rumit, tetapi secara umum, untuk model yang sesuai dengan data dengan baik, R² mendekati 1. Model yang kurang sesuai dengan data memiliki R² mendekati 0. Pada contoh di bawah, yang pertama memiliki R² sebesar 0,02; ini berarti model hanya menjelaskan 2% dari variabilitas data. Yang kedua memiliki R² sebesar 0,99, dan model dapat menjelaskan 99% dari variabilitas total.**
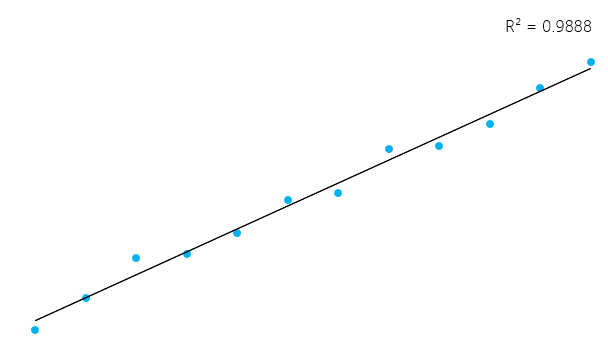
Namun, penting diingat bahwa terkadang R² yang tinggi tidak selalu berarti bagus (lihat plot residual di bawah) dan R² yang rendah tidak selalu buruk. Dalam kehidupan nyata, kejadian tidak selalu pas pada garis lurus sempurna. Misalnya, Anda bisa saja menemukan anak yang lebih tinggi atau lebih pendek pada usia yang sama. Di beberapa bidang, R² sebesar 0,5 sudah dianggap baik.
Dengan contoh yang sama seperti di atas, lihat ringkasan model linear untuk melihat nilai R²-nya.
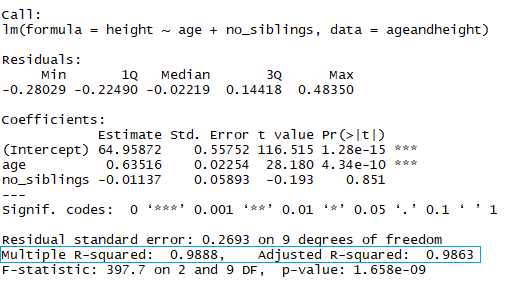
Pada persegi panjang biru, perhatikan ada dua R² yang berbeda, yaitu multiple dan adjusted. Multiple adalah R² yang Anda lihat sebelumnya. Satu masalah dengan R² ini adalah nilainya tidak dapat menurun saat Anda menambahkan lebih banyak variabel independen ke model; nilainya akan terus meningkat seiring model makin kompleks, bahkan jika variabel-variabel tersebut tidak menambah apa pun pada prediksi Anda (seperti contoh jumlah saudara). Karena alasan ini, adjusted R² kemungkinan lebih baik dilihat jika Anda menambahkan lebih dari satu variabel ke dalam model, karena ia hanya meningkat jika benar-benar mengurangi galat keseluruhan dari prediksi.
Anda bisa saja memiliki R² yang cukup baik pada model Anda, tetapi jangan buru-buru mengambil kesimpulan. Mari lihat contohnya. Anda akan memprediksi tekanan suatu material di laboratorium berdasarkan temperaturnya.
Mari plot datanya (dalam scatterplot sederhana) dan tambahkan garis yang Anda bangun dengan model linear Anda. Dalam contoh ini, biarkan R membaca data terlebih dahulu, lagi-lagi dengan perintah read_excel, untuk membuat sebuah dataframe berisi data, lalu buat regresi linear dengan data baru Anda. Perintah plot() menerima sebuah data frame dan memplot variabel-variabel di dalamnya. Dalam hal ini, ia memplot tekanan terhadap temperatur material. Lalu, tambahkan garis yang dibuat oleh regresi linear dengan perintah abline.
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
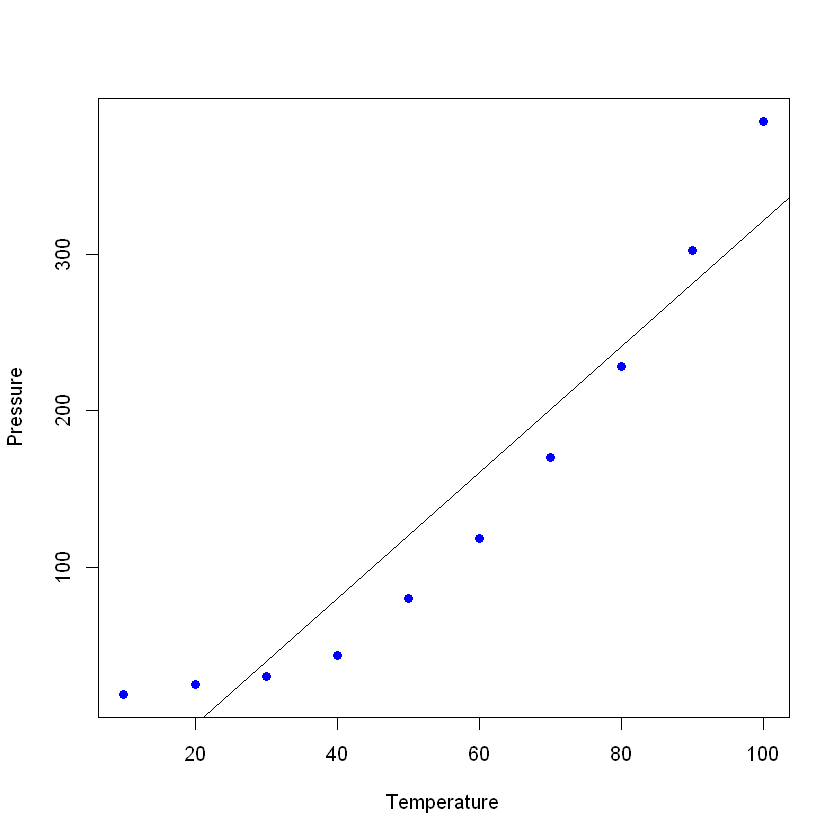
Jika Anda melihat ringkasan model baru Anda, Anda akan melihat hasil yang cukup baik (lihat R² dan adjusted R²)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)

Residuals:
   Min     1Q Median     3Q    Max
-41.85 -34.72 -10.90  24.69  63.51

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000    29.1395  -2.797   0.0233 *
Temperature   4.0309     0.4696   8.583 2.62e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared:  0.902,    Adjusted R-squared:  0.8898
F-statistic: 73.67 on 1 and 8 DF,  p-value: 2.622e-05
Idealnya, saat Anda memplot residual, tampilannya acak. Jika tidak, bisa jadi ada pola tersembunyi yang tidak dipertimbangkan oleh model linear. Untuk memplot residual, gunakan perintah plot(lmTemp$residuals).
plot(lmTemp$residuals, pch = 16, col = "red")
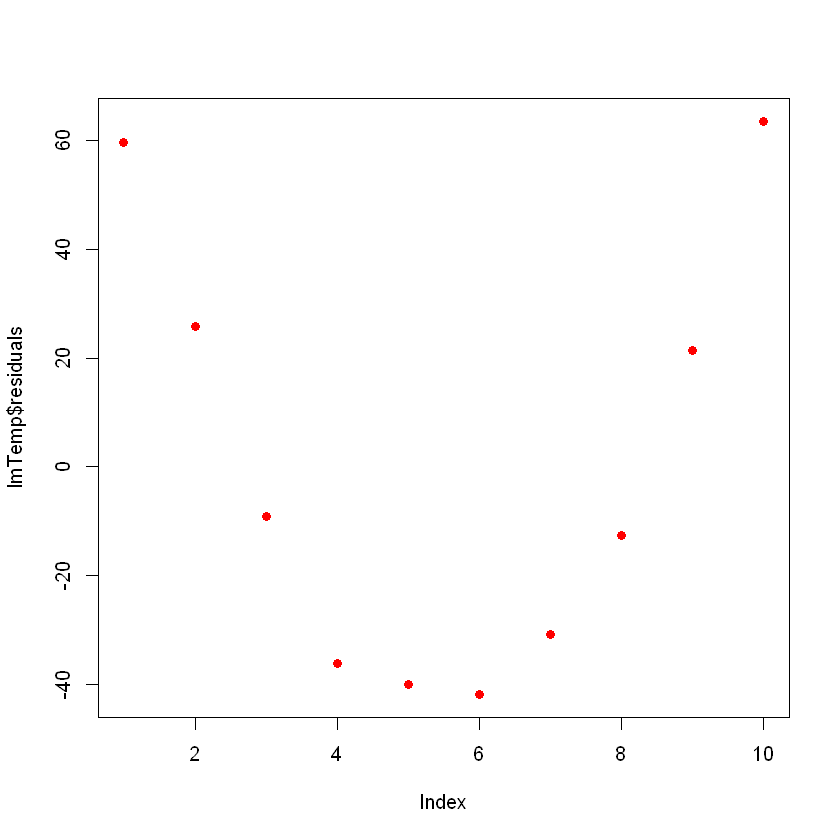
Ini bisa menjadi masalah. Jika Anda memiliki lebih banyak data, model linear sederhana Anda tidak akan mampu melakukan generalisasi dengan baik. Pada gambar sebelumnya, perhatikan adanya pola (seperti kurva pada residual). Ini sama sekali tidak acak.
Yang dapat Anda lakukan adalah melakukan transformasi variabel. Ada banyak kemungkinan transformasi yang dapat diterapkan pada data Anda, seperti menambahkan suku kuadratik (x2), kubik (x3), atau yang lebih kompleks seperti ln(X), ln(X+1), sqrt(X), 1/x, Exp(X). Pemilihan transformasi yang tepat memerlukan sedikit pengetahuan fungsi aljabar, latihan, serta coba-coba.
Mari coba dengan suku kuadratik. Untuk ini, tambahkan istilah “I” (huruf kapital "I") sebelum transformasi Anda, misalnya ini akan menjadi rumus regresi linear normal:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)

Residuals:
    Min      1Q  Median      3Q     Max
-4.6045 -1.6330  0.5545  1.1795  4.8273

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)      33.750000   3.615591   9.335 3.36e-05 ***
Temperature      -1.731591   0.151002 -11.467 8.62e-06 ***
I(Temperature^2)  0.052386   0.001338  39.158 1.84e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared:  0.9996,    Adjusted R-squared:  0.9994
F-statistic:  7859 on 2 and 7 DF,  p-value: 1.861e-12
Perhatikan bahwa model meningkat secara signifikan. Jika Anda memplot residual model baru, tampilannya akan seperti ini:
plot(lmTemp2$residuals, pch = 16, col = "red")
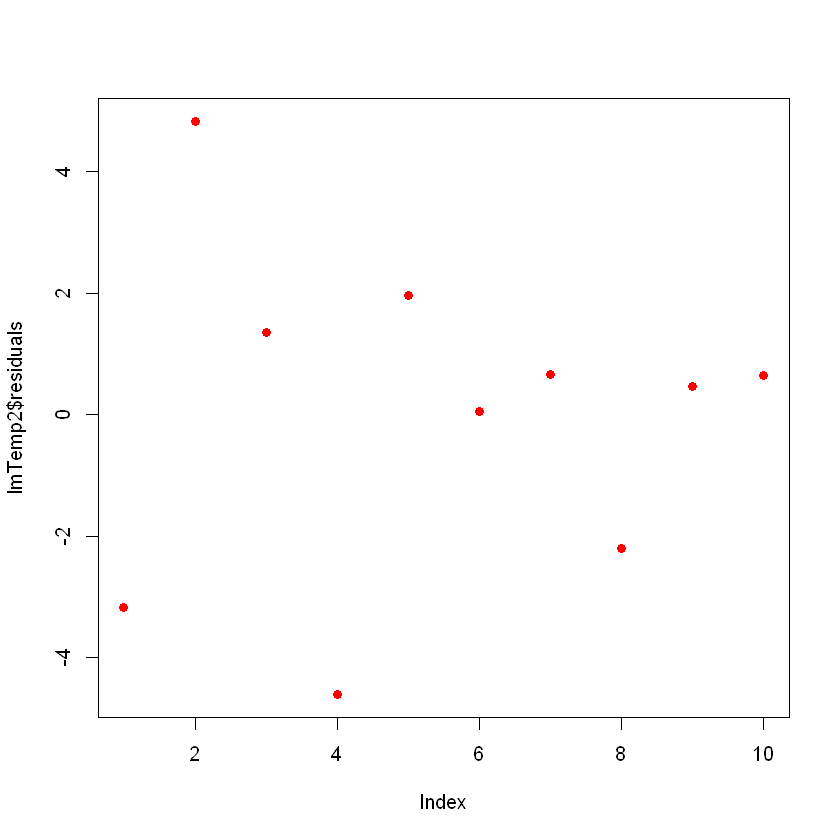
Sekarang Anda tidak melihat pola yang jelas pada residual, dan itu bagus!
Pada data Anda, mungkin ada titik berpengaruh yang dapat menyimpangkan model, terkadang tanpa perlu. Bayangkan terjadi kesalahan entri data, dan alih-alih menulis “2,3” tertulis “23”. Jenis titik berpengaruh yang paling umum adalah outlier, yaitu titik data di mana respons teramati tidak tampak mengikuti pola yang dibentuk oleh data lainnya.
Anda dapat mendeteksi titik berpengaruh dengan melihat objek yang memuat model linear, menggunakan fungsi cooks.distance() lalu memplot jarak ini. Ubah sebuah nilai dengan sengaja untuk melihat tampilannya pada plot Cook’s Distance. Untuk mengubah nilai tertentu, Anda dapat menunjuknya langsung dengan ageandheight[nomor baris, nomor kolom] = [nilai baru]. Dalam kasus ini, tinggi pada contoh kedua diubah menjadi 7,7:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
Buat kembali modelnya dan lihat bagaimana ringkasan model menunjukkan kecocokan yang buruk, lalu plot Cook’s Distances. Untuk ini, setelah membuat regresi linear, gunakan perintah cooks.distance([linear model] , dan kemudian, jika Anda mau, Anda dapat memplot jarak ini dengan perintah plot().
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)

Residuals:
    Min      1Q  Median      3Q     Max
-53.704  -2.584   3.609   9.503  17.512

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.905     38.319   0.206    0.841
age            2.816      1.613   1.745    0.112

Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared:  0.2335,    Adjusted R-squared:  0.1568
F-statistic: 3.046 on 1 and 10 DF,  p-value: 0.1115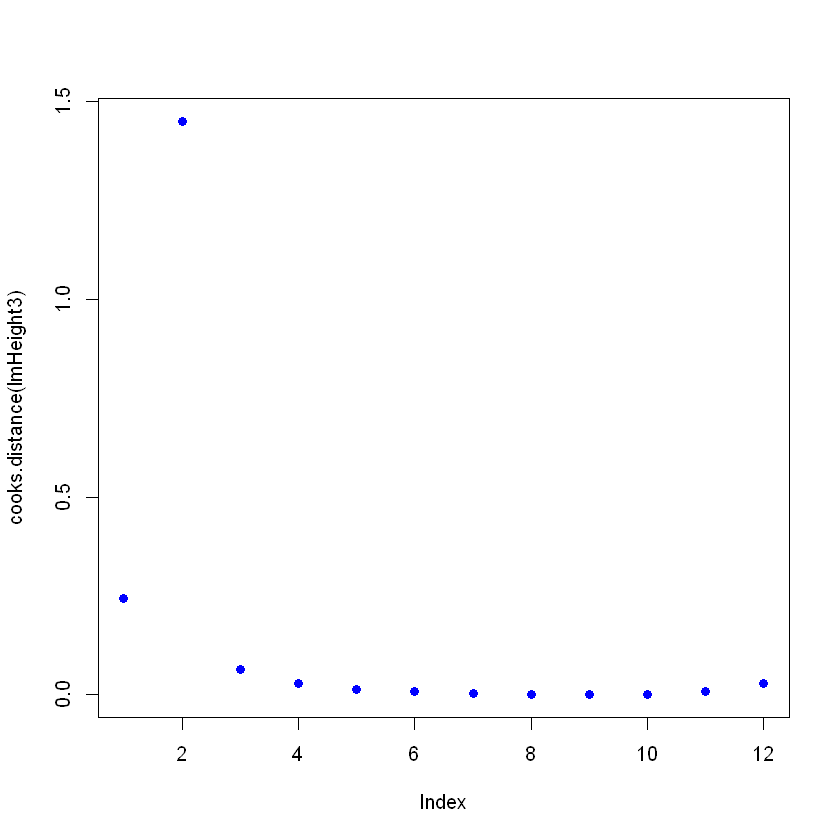
Perhatikan bahwa ada satu titik yang tidak mengikuti pola, dan mungkin memengaruhi model. Di sini Anda dapat mengambil keputusan terkait titik ini; secara umum, ada tiga alasan mengapa sebuah titik sangat berpengaruh:
Jika kejadiannya 1 atau 2, maka Anda bisa menghapus (atau memperbaiki) titik tersebut. Jika 3, tidak ada gunanya menghapus titik yang valid; mungkin Anda bisa mencoba model non-linear alih-alih model linear seperti regresi linear.
Waspadalah bahwa titik berpengaruh bisa jadi merupakan titik yang valid; pastikan untuk memeriksa data dan sumbernya sebelum menghapus. Dalam buku-buku statistik, sering dijumpai kutipan ini: “Terkadang kita membuang data yang sebenarnya baik ketika yang seharusnya dibuang adalah model yang meragukan.”
Anda sampai di akhir! Regresi linear adalah topik besar, dan akan terus relevan. Di sini, kami menyajikan beberapa kiat yang dapat membantu menyetel dan memaksimalkan manfaat dari algoritme yang kuat namun sederhana ini. Anda juga mempelajari cara memahami apa yang ada di balik model statistik sederhana ini dan bagaimana Anda dapat memodifikasinya sesuai kebutuhan. Anda juga dapat mengeksplorasi opsi lain dengan mengetik ?lm pada konsol R dan melihat parameter berbeda yang tidak dibahas di sini. Lihat juga Regularization Tutorial: Ridge, Lasso and Elastic Net. Jika Anda tertarik mendalami model statistik, silakan lihat kursus Statistical Modeling in R.
Karena regresi linear menjadi fondasi banyak teknik analitis tingkat lanjut, memastikan tim Anda memiliki pemahaman yang kuat tentang ini dan keterampilan penting lainnya sangat krusial untuk kesuksesan jangka panjang.
DataCamp for Business menyediakan solusi yang disesuaikan bagi organisasi yang ingin meningkatkan keterampilan timnya dalam data science dan analitik. Dengan jalur pembelajaran khusus dan kursus praktis yang mencakup beragam metode statistik, termasuk regresi dan pemodelan prediktif, tim Anda dapat dengan percaya diri menangani tantangan data yang kompleks.
Minta demo hari ini dan berinvestasilah pada masa depan organisasi Anda dengan memungkinkan tim Anda untuk tetap mengikuti alat dan teknik terbaru dalam analisis data.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



