
Corso
Introduzione a R
4 ore
3.1M
Pratica and corso your progress.
Continua Con Google
Creare un curriculum efficace da solo non basta per entrare nel mercato del lavoro della data science. Se vuoi iniziare una carriera nella data science, è fondamentale costruire un portfolio di dati con progetti pertinenti che mettano in mostra le tue competenze durante il colloquio.
La buona notizia è che non è mai troppo presto né troppo tardi per iniziare a creare un portfolio. Che tu sia alle prime armi o già a metà del percorso di apprendimento, puoi iniziare subito a lavorare ai tuoi progetti in R.
Va benissimo se i primi progetti sembrano amatoriali. Potrai sempre tornarci sopra, migliorarli, rifinirli o persino eliminarli quando realizzerai progetti più avanzati. La cosa più importante è iniziare.
In questo articolo, vedremo alcune idee utili per i tuoi progetti di data science con R e alcuni esempi per partire. Parleremo anche del linguaggio R e di come viene usato per l’analisi dei dati e la data science.
R è un linguaggio di programmazione usato per analisi dei dati, data science e machine learning, e include anche un ambiente per il calcolo statistico e la grafica. R è progettato specificamente per il calcolo statistico avanzato e veloce, la modellazione dei dati e la creazione di visualizzazioni efficaci. È qui che questo linguaggio mostra la sua vera forza.
Inoltre, R:
Troverai maggiori informazioni sul linguaggio R e su come impararlo nei nostri articoli Che cos’è R? - Il motore del calcolo statistico e Come iniziare con R. Puoi anche seguire il corso DataCamp Introduzione a R.
Per iniziare da zero o per padroneggiare competenze tecniche specifiche, dai un’occhiata alle nostre risorse di apprendimento, tra cui corsi, percorsi di competenza e percorsi di carriera. In particolare, per un percorso completo ed equilibrato su R, valuta i career track Data Scientist with R e Machine Learning Scientist with R.
Eseguire l’analisi dei dati è il primo passo di qualsiasi progetto di data science. È logico: prima di passare a prevedere scenari futuri con tecniche di machine learning e deep learning, dobbiamo far luce sullo stato attuale (e passato) delle cose.
D’altra parte, l’analisi dei dati può anche essere un’attività a sé. In entrambi i casi, R offre un ampio ventaglio di librerie utili adattate specificamente agli scopi analitici.
Con R possiamo acquisire dati da siti web, pulirli e trasformarli, visualizzarli, esplorarne le statistiche, formulare e testare ipotesi ed estrarre insight e pattern significativi dai dati iniziali. Tra questi compiti, l’analisi statistica e le visualizzazioni eccellenti sono il vero asso nella manica di R, ed è qui che questo linguaggio spesso supera il suo principale rivale, Python.
Oltre ai package generici e multiuso di R, esistono molti moduli pensati per svariate problematiche analitiche applicate. Ad esempio:
fAssets: package pensato per analizzare e modellare asset finanziari.
mdapack: package per l’analisi di dati medici.
GEOmap: package usato per la mappatura topografica e geologica.
AeRobiology: strumento computazionale per dati aerobiologici.
galigor: raccolta di package per il marketing su Internet.
lingtypology: package per tipologia linguistica e mappatura.
Inoltre, R include anche librerie estremamente specializzate come:
Come accennato, R è un linguaggio orientato alla data science che offre più di 19.000 package per la data science. Oltre ai compiti puramente analitici elencati in precedenza, possiamo usare R per problemi più avanzati con l’obiettivo di prevedere e modellare dati sconosciuti. Con R possiamo:
Ancora una volta, oltre ai package di data science più comuni (caret per il training di classificazione e regressione, naivebayes per l’algoritmo di Naive Bayes, randomForest per i modelli di foreste casuali, deepNN per il deep learning, ecc.), esistono molte librerie altamente specializzate, fino a casi davvero specifici. Per citarne alcune:
OenoKPM: package usato per modellare la cinetica di produzione di CO2 nella fermentazione alcolica.
fHMM: package progettato per adattare modelli di Markov nascosti a dati finanziari.
paleopop: framework di modellazione orientato ai pattern per modelli paleo-climatici accoppiati nicchia-popolazione.
ibdsim2: package usato per simulare regioni cromosomiche condivise tra membri di una famiglia.
rSHAPE: package progettato per simulare l’evoluzione di popolazioni aplodi asessuate.
Ora daremo un’occhiata ad alcuni esempi di progetti in R e individueremo idee interessanti da sviluppare, sia per principianti che per utenti esperti.
Uno dei modi più proficui per trovare progetti in R è crearne tu stessǝ!
Nessun timore, non è così spaventoso come sembra. Anche se sei alle prime armi con la data science in R, puoi scegliere progetti da "sandbox" che forniscono dati pronti per essere analizzati o modellati, introducono il contesto del problema e offrono indicazioni utili sui passaggi da seguire e sul perché.
Se sei più avanzato, sei sempre il benvenuto ad approfondire i dati da diverse angolazioni e andare ben oltre le istruzioni suggerite per soddisfare la tua curiosità. In ogni caso, l’apprendimento attivo facendo è un’alternativa migliore rispetto a leggere soltanto i progetti altrui.
DataCamp offre un’ampia scelta di progetti di data science in R che ti permetteranno di esercitare molte competenze tecniche. Questi esempi includono importazione e pulizia dei dati, manipolazione dei dati, visualizzazione, probabilità e statistica, machine learning e altro.
Oltre agli argomenti popolari (come Esplorare il mercato Airbnb di NYC, Visualizzare il COVID-19, Clustering dei dati di pazienti con malattie cardiache o Prevedere le tariffe dei taxi con Random Forest) tradizionalmente trattati nelle scuole di data science, qui troverai anche numerosi temi nuovi e curiosi. Sentiti liberǝ di esplorarli più a fondo:
Dopo aver esplorato i progetti esistenti o averne realizzati alcuni guidati, puoi decidere di creare i tuoi progetti da zero. È sempre una buona idea, qualunque sia il tuo livello con R.
Se stai lavorando a uno dei tuoi primi progetti non guidati, la prima cosa da considerare è dove trovare i dati su cui lavorare. Per fortuna, esistono molti repository online popolari che offrono grandi collezioni di dataset gratuiti e ben documentati, sia reali che sintetici. Alcuni esempi degni di nota sono DataLab, Kaggle, UCI Machine Learning Repository, Google Dataset Search, Google Cloud Platform, FiveThirtyEight e Quandl
Ora che hai a disposizione molti dati, cosa puoi farne come principiante in R? Dato che questi saranno i tuoi primi progetti di data science in R, considera di eseguire pulizia e manipolazione di base, semplici esplorazioni e visualizzazioni dei dati.
Spotify è uno dei maggiori servizi digitali di musica, video e media, dove puoi trovare milioni di canzoni, video e podcast da tutto il mondo.
Puoi usare il dataset già pronto Spotify Music Data, che contiene circa 600 canzoni top in un certo periodo, ed esplorarne le statistiche da molti punti di vista. Ad esempio, puoi analizzare i seguenti aspetti e domande, accompagnando le tue scoperte con grafici significativi quando necessario:
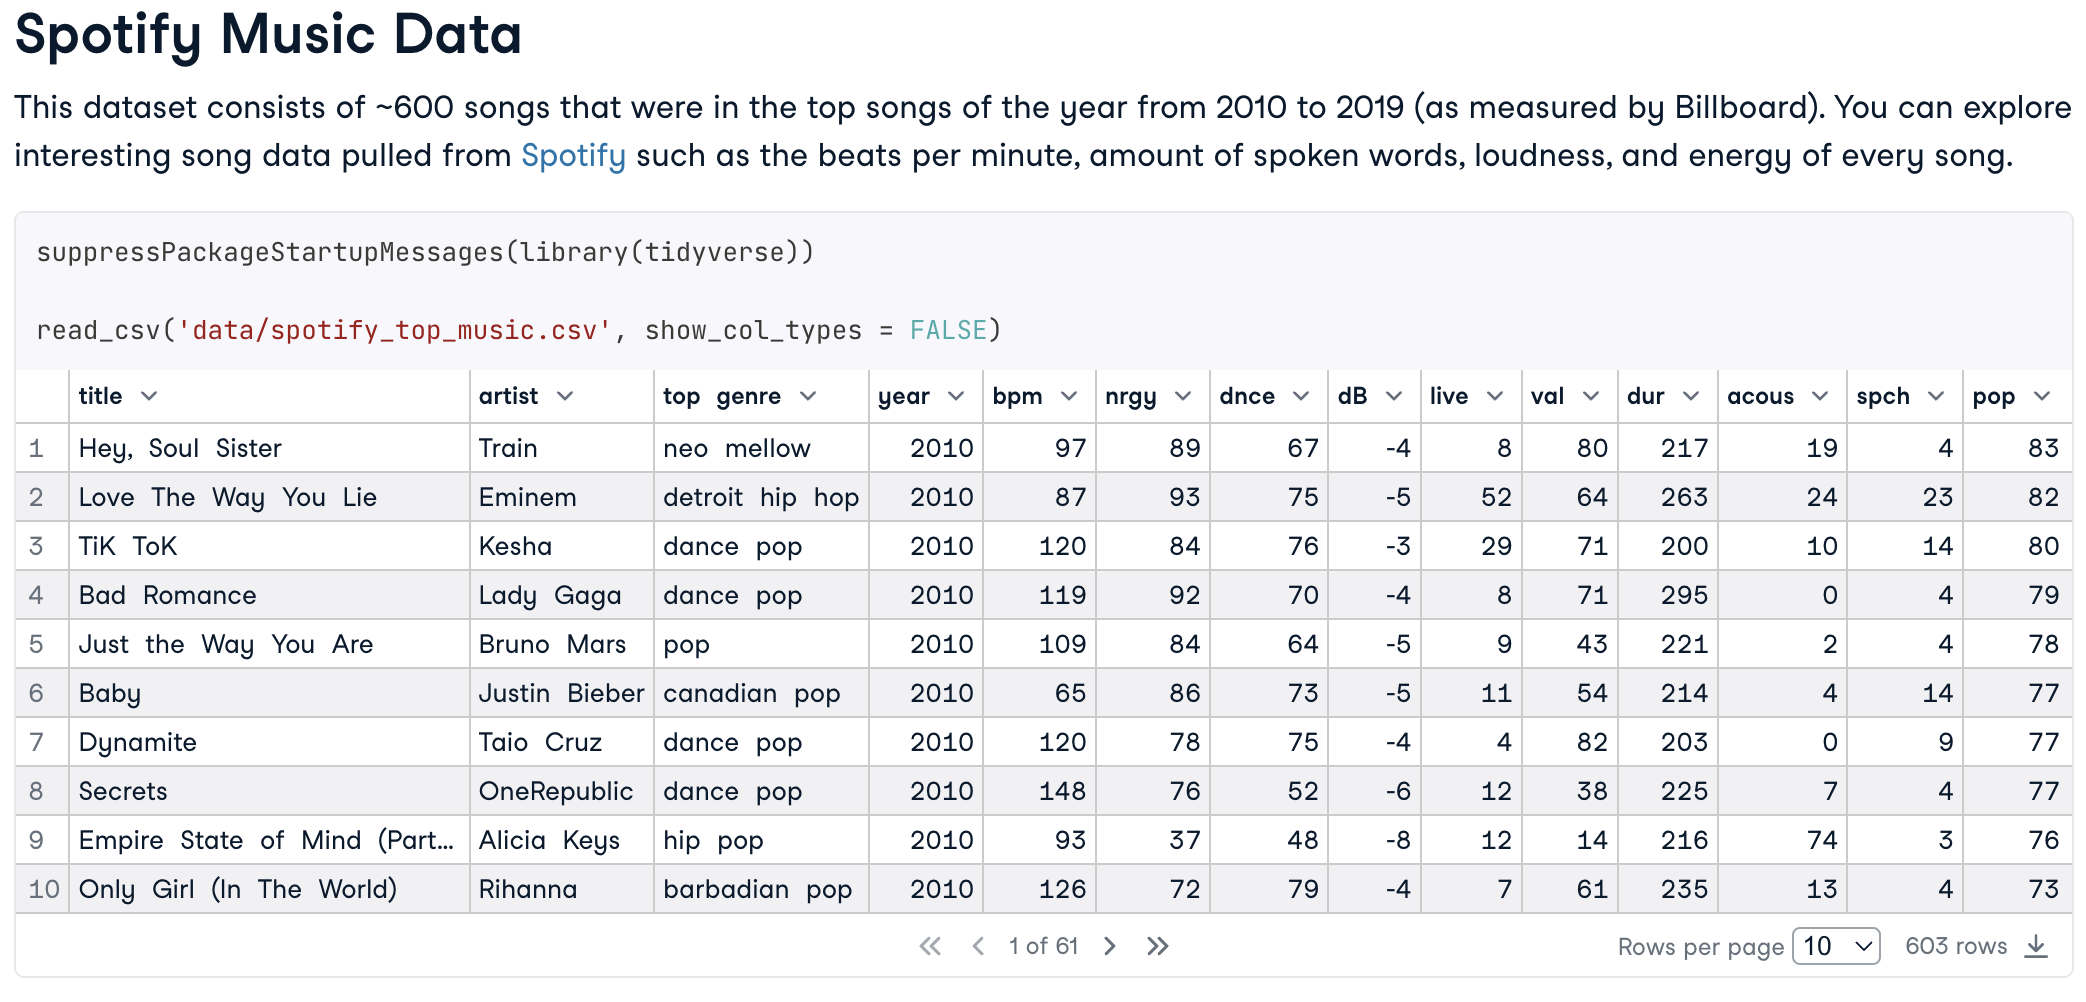
Un esempio dal progetto in R sui dati di Spotify
La National Basketball Association (NBA) è una lega professionistica nordamericana di basket maschile con 30 squadre, tra le più grandi al mondo.
Il dataset NBA Shooting Data contiene dati raccolti per quattro diversi giocatori nei playoff NBA 2021. Puoi analizzare e visualizzare questi dati e provare a rispondere alle seguenti domande:
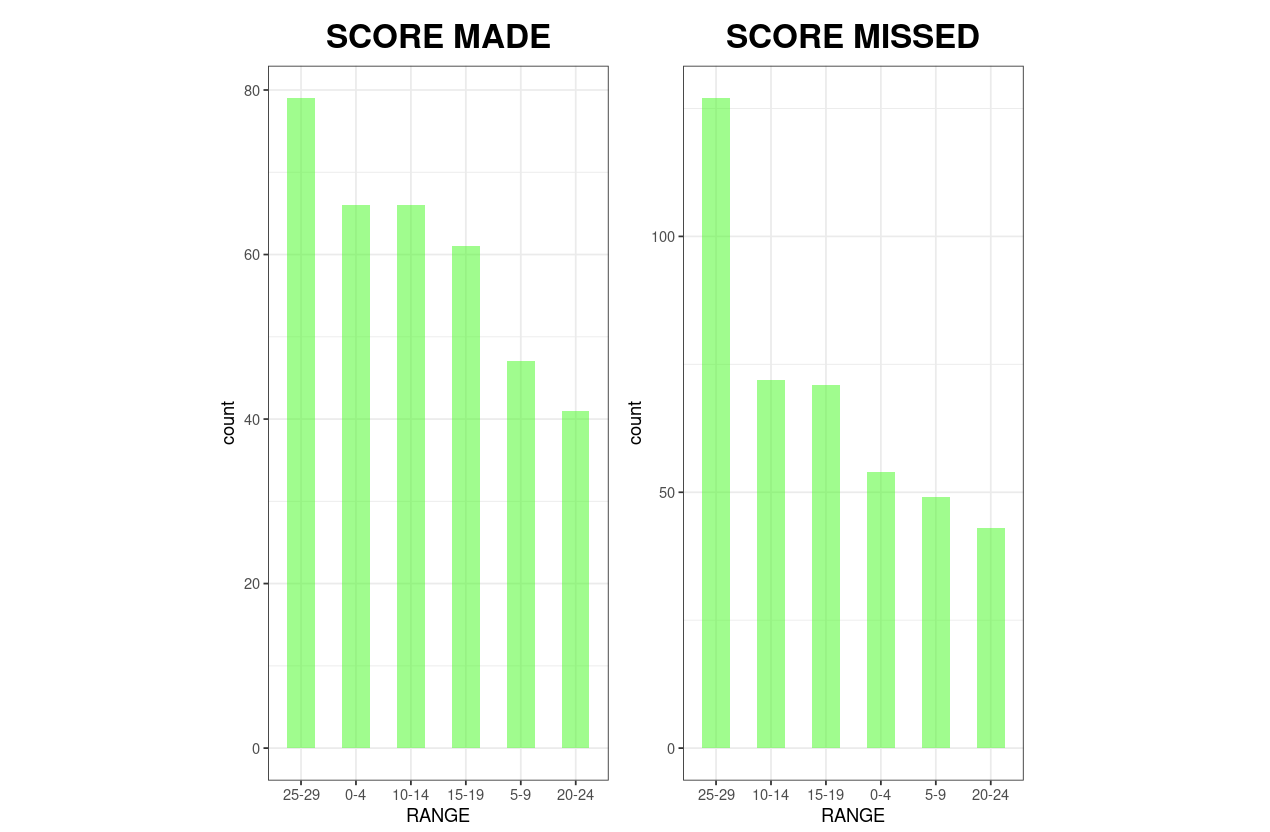
Un esempio dal progetto in R sulle statistiche di tiro NBA
Un’altra idea interessante per un progetto R da principiante è indagare le tendenze della popolazione mondiale.
Il dataset World Population Data fornisce le statistiche della popolazione totale per ogni paese dal 1960 al 2020, oltre ad alcune informazioni aggiuntive per paese, come regione, fascia di reddito e note speciali (se presenti). Qui puoi esplorare molte domande:
Non dimenticare di aggiungere grafici efficaci quando utili: aiuteranno chi legge a cogliere meglio i principali insight della tua analisi.
Se sei a metà del percorso di apprendimento della data science in R, potresti essere interessatǝ a costruire progetti più sofisticati, in cui applicare sia competenze di analisi dei dati sia alcuni algoritmi di machine learning.
Quali argomenti puoi scegliere? Vediamo alcune idee potenziali per i tuoi progetti avanzati in R.
Il churn dei clienti è la tendenza degli utenti a cancellare l’abbonamento a un servizio e, di conseguenza, a non essere più clienti. Si calcola come percentuale di clienti persi in un certo periodo.
Questo indicatore dipende da molti fattori e mostra la salute complessiva del business. Quando è troppo alto, rappresenta un grave problema per qualsiasi azienda perché porta a perdita di ricavi e danneggia la reputazione. È quindi molto importante saper prevedere il churn per prevenirlo.
Puoi usare il dataset Telecom Customer Churn per costruire un progetto di data science sulla previsione del churn in un’azienda di telecomunicazioni.
In particolare, qui devi prevedere se un cliente effettuerà il churn o meno in base ai dati disponibili e quali fattori aumentano la probabilità di churn. Tecnicamente, è un tipico problema di classificazione di machine learning in cui i clienti sono etichettati come 1 (churn) o 0 (non churn).
La frode con carta di credito è una sfida seria nel banking, dato l’elevato numero di transazioni online. Il rilevamento delle frodi con carta è per lo più un problema di classificazione supervisionata in cui si possono applicare metodi come k-nearest neighbors (KNN), regressione logistica, support vector machine (SVM) o alberi decisionali.
Tuttavia, può essere affrontato anche con tecniche di clustering, riconoscimento di anomalie o reti neurali artificiali.
Questo problema è difficile per il settore bancario in generale perché gli schemi di frode e le tattiche dei frodatori evolvono costantemente, quindi i sistemi di rilevamento devono adattarsi rapidamente a questi cambiamenti.
Per un data scientist o un machine learning scientist, la sfida sta anche nella natura di questi dataset: implicano sempre uno sbilanciamento di classe, dato che i casi di frode sono sempre minoritari (per fortuna) e ben nascosti tra le transazioni reali (purtroppo).
Il dataset Credit Card Fraud contiene informazioni sulle transazioni con carta di credito nell’ovest degli Stati Uniti. Valuta di usarlo per rilevare le frodi applicando un approccio di classificazione.
Come ulteriore spunto, il modello dovrebbe tendere a essere più conservativo: per ragioni di sicurezza, non è un grosso problema etichettare come fraudolente transazioni che non lo sono. Potresti anche indagare la distribuzione geospaziale dei tassi di frode nei vari stati.
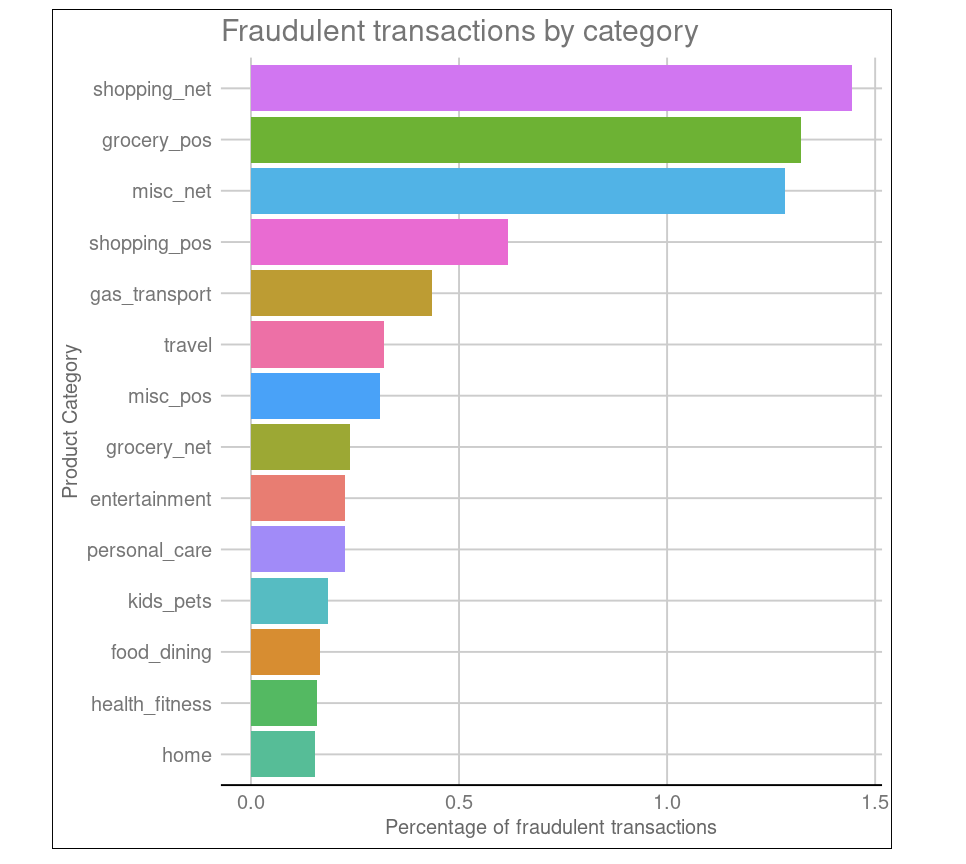
Un altro esempio di progetto in R da DataCamp
Mentre i due progetti precedenti riguardavano la classificazione di voci di dati in categorie predefinite, qui devi prevedere risultati continui a partire da feature in input. In altre parole, devi risolvere un problema di regressione applicando metodi come regressione lineare, ridge regression, lasso, alberi decisionali o support vector machine (SVM).
Il dataset Bike Sharing Demand include informazioni sul numero di biciclette pubbliche noleggiate, ora per ora, nel sistema di bike sharing di Seul, oltre a meteo, data, ora, presenza o meno di festività, e altro. Il tuo compito è prevedere il numero di bici che verranno noleggiate sulla base di queste informazioni.
Puoi anche usare questo progetto per confrontare il numero medio di bici noleggiate nei diversi momenti della giornata (mattina, pomeriggio e sera) nelle quattro stagioni, esplorare la relazione tra temperatura e numero di noleggi, ecc. Dove opportuno, aggiungi visualizzazioni informative a supporto delle tue conclusioni.
È sempre una buona idea avere nel tuo portfolio almeno un progetto che dimostri la capacità di applicare approcci di apprendimento non supervisionato.
A questo scopo, considera il dataset E-Commerce Data, che consiste in acquisti effettuati in un retailer online con sede nel Regno Unito da clienti di diversi paesi in un certo periodo di tempo.
Uno scenario ipotetico è che il retailer voglia fare l’inventario degli articoli disponibili. Come presunto data scientist della compagnia, devi raggruppare i prodotti in un numero ridotto di categorie in base alla loro somiglianza per alcune caratteristiche comuni (prezzo, quantità venduta, ecc.). Si tratta di un problema di clustering di apprendimento non supervisionato, con k-means come algoritmo più popolare.
Puoi anche analizzare domande extra, come quali cinque paesi generano più profitto, o se le dimensioni degli ordini dai paesi fuori dal Regno Unito sono significativamente maggiori rispetto a quelli interni.
Infine, valuta di mettere alla prova le tue competenze di elaborazione del linguaggio naturale (NLP) in R in uno dei tuoi progetti.
Il dataset SMS Spam Collection contiene una raccolta di oltre 5.500 messaggi in inglese etichettati come spam o non spam ("ham").
Sulla base di questi dati, crea un filtro in grado di distinguere con precisione tra messaggi spam e regolari. Per farlo, dovrai usare un package NLP di R (ad esempio, koRpus) per individuare pattern linguistici e contestuali nel testo dei messaggi e capire cosa rende un messaggio spam o ham, per poi generalizzare queste osservazioni su nuovi dati.
In alternativa, puoi indagare quali sono le parole più comuni associate allo spam creando una word cloud.
In sintesi, abbiamo visto perché è importante costruire un portfolio di progetti per iniziare una carriera nella data science, perché e come usare R per analisi dei dati e data science, dove trovare dati pertinenti ed esempi di progetti in R, e quali temi puoi sviluppare, che tu sia principiante o avanzato.
Naturalmente, le idee proposte sono solo la punta dell’iceberg. Con R puoi fare molto di più: creare sistemi di raccomandazione, eseguire segmentazione dei clienti, prevedere i tassi di cambio in borsa, condurre analisi del sentiment dei clienti, identificare il posizionamento ottimale dei taxi e molto altro.
Che tu punti a diventare Data Scientist with R, Data Analyst with R, Machine Learning Scientist with R o Statistician with R, dimostrare le tue abilità attraverso progetti pratici è impagabile. L’ampia libreria di R e il supporto della community lo rendono una scelta ideale per analisi dei dati, machine learning e calcolo statistico avanzato.
Partendo da progetti semplici e affrontando via via sfide più complesse, puoi costruire un portfolio che non solo dimostri le tue capacità tecniche, ma anche la tua abilità nel ricavare insight significativi dai dati. Questa esperienza pratica non solo impressionerà i potenziali datori di lavoro, ma ti preparerà anche alle sfide diverse e dinamiche che incontrerai nella tua carriera nella data science.
Per altra ispirazione, visita DataLab, un IDE online con dataset precaricati e template predefiniti per scrivere codice e analizzare dati, che ti aiuta a passare dall’apprendimento alla pratica.
Corsi per R
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



