
Cursus
Introductie tot R
4 uur
3.1M
Oefen en volg je voortgang.
Ga Verder Met Google
Een indrukwekkend cv opstellen alleen is niet genoeg om de arbeidsmarkt voor data scientists te betreden. Als je een carrière in data science wilt starten, is het cruciaal om een dataportfolio op te bouwen met relevante projecten die je datavaardigheden laten zien tijdens het sollicitatiegesprek.
Het goede nieuws is dat het nooit te vroeg of te laat is om zo’n portfolio te maken. Of je nu een complete beginner bent of al halverwege je leerpad in data science, je kunt nu al beginnen met je R-projecten.
Het is helemaal prima als je eerste projecten wat amateuristisch ogen. Je kunt er later altijd op terugkomen, ze uitwerken, verfijnen of zelfs verwijderen zodra je meer geavanceerde projecten maakt. Het belangrijkste is dat je begint.
In dit artikel geven we een aantal nuttige ideeën voor je data science-projecten met R en bekijken we enkele voorbeelden om je op weg te helpen. We bespreken ook de programmeertaal R en hoe die wordt gebruikt voor data-analyse en data science.
R is een programmeertaal voor data-analyse, data science en machine learning, en omvat ook een omgeving voor statistisch rekenen en grafieken. R is specifiek ontworpen voor geavanceerd en snel statistisch rekenen, datamodellering en het bouwen van impactvolle visualisaties. Dáár laat de taal echt zijn kracht zien.
Daarnaast biedt R:
Meer informatie over de programmeertaal R en hoe je die leert vind je in onze artikelen What is R? - The Statistical Computing Powerhouse en How to Get Started with R. Je kunt ook de DataCamp-cursus Introduction to R volgen.
Om R vanaf nul te leren of om specifieke technische skills te beheersen, bekijk onze verschillende leermiddelen, waaronder cursussen, skill tracks en career tracks. Voor een uitgebalanceerd en compleet leerpad in R zijn met name de career tracks Data Scientist with R en Machine Learning Scientist with R het overwegen waard.
Data-analyse uitvoeren is de eerste stap van elk data science-project. Logisch: voordat we ons storten op het voorspellen van toekomstige scenario’s met machine learning- en deep learning-technieken, moeten we eerst de huidige (en eerdere) stand van zaken blootleggen.
Aan de andere kant kan data-analyse ook op zichzelf staan. In beide gevallen biedt R ons een breed scala aan nuttige libraries die specifiek zijn afgestemd op analytische doeleinden.
Met R kunnen we data van websites ophalen, opschonen en transformeren, visualiseren, statistisch verkennen, hypothesen opstellen en testen, en betekenisvolle inzichten en patronen uit de ruwe data halen. Van al deze taken zijn statistische analyse en geweldige visualisaties echt het winnende kaartje van R, en hierin verslaat deze programmeertaal vaak zijn grootste rivaal, Python.
Naast algemene, veelzijdige R-pakketten zijn er tal van modules ontworpen voor uiteenlopende toegepaste analytische vraagstukken. Bijvoorbeeld:
fAssets: Dit pakket is bedoeld voor het analyseren en modelleren van financiële activa.
mdapack: Dit is een pakket voor medische data-analyse.
GEOmap: Dit pakket wordt gebruikt voor topografische en geologische kaartvorming.
AeRobiology: Deze computationele tool is voor aerobiologische data.
galigor: Dit is een verzameling pakketten voor internetmarketing.
lingtypology: Dit pakket wordt gebruikt voor linguïstische typologie en kaartvorming.
Bovendien heeft R zelfs hypergespecialiseerde libraries zoals:
Zoals eerder genoemd is R een op data science gerichte programmeertaal met meer dan 19.000 data science-pakketten. Naast de puur analytische taken uit de vorige sectie kunnen we R gebruiken voor geavanceerdere problemen, gericht op het voorspellen en modelleren van onbekende data. Met R kun je:
Naast veelgebruikte data science-pakketten (caret voor classificatie- en regressietraining, naivebayes voor het implementeren van het Naive Bayes-algoritme, randomForest voor het bouwen van random forest-modellen, deepNN voor deep learning, enz.) zijn er talloze hooggespecialiseerde libraries, tot en met sterk nichespecifieke. Enkele voorbeelden:
OenoKPM: Dit pakket modelleert de kinetiek van CO2-productie bij alcoholische fermentatie.
fHMM: Dit pakket is ontworpen om hidden Markov-modellen op financiële data te fitten.
paleopop: Dit is een patroon-georiënteerd modelleringsframework voor gekoppelde niche-populatie paleoklimatologische modellen.
ibdsim2: Dit pakket simuleert chromosomale regio’s die door familieleden worden gedeeld.
rSHAPE: Dit pakket is bedoeld om de evolutie van haploïde aseksuele populaties te simuleren.
We gaan nu kijken naar enkele voorbeelden van R-projecten en interessante ideeën voor verdere uitwerking, zowel voor beginners als voor gevorderde gebruikers.
Een van de meest zinvolle manieren om naar R-projecten te zoeken, is door zulke voorbeelden zelf te maken!
Geen zorgen, het is niet zo eng als het lijkt. Ook als je een beginner bent in data science met R, kun je kiezen voor “sandbox”-projecten: de data is dan al klaar om te analyseren of te modelleren, je krijgt context bij het probleem en nuttige aanwijzingen over welke stappen je zet en waarom.
Ben je al wat verder, dan ben je altijd vrij om de data dieper en vanuit verschillende invalshoeken te verkennen, en veel verder te gaan dan de voorgestelde instructies om je nieuwsgierigheid te voeden. In alle gevallen is actief leren door te doen een beter alternatief dan alleen andermans projecten lezen.
DataCamp biedt een grote keuze aan data science-projecten in R waarmee je veel technische skills kunt oefenen. Zulke voorbeelden omvatten het importeren en opschonen van data, datamanipulatie, datavisualisatie, kansrekening & statistiek, machine learning en meer.
Naast populaire onderwerpen (zoals Exploring the NYC Airbnb Market, Visualizing COVID-19, Clustering Heart Disease Patient Data of Predict Taxi Fares with Random Forests) die traditioneel aan bod komen in diverse data science-opleidingen, vind je hier ook tal van frisse en prikkelende thema’s. Verken ze gerust grondiger:
Na bestaande R-projecten te hebben bekeken of zelf enkele begeleide projecten te hebben gemaakt, kun je besluiten om je eigen projecten from scratch te bouwen. Dat is altijd een goed idee, op welk punt je ook bent in het leren van R.
Als je een van je eerste ongeleide projecten maakt, is het eerste waar je aan denkt: waar vind ik data om mee te werken? Gelukkig zijn er talloze populaire online repositories met grote collecties gratis en goed gedocumenteerde datasets, zowel uit de echte wereld als synthetisch. Enkele noemenswaardige bronnen zijn DataLab, Kaggle, UCI Machine Learning Repository, Google Dataset Search, Google Cloud Platform, FiveThirtyEight en Quandl
Nu je ruime keuze aan data hebt, wat kun je er als beginner in R precies mee doen? Omdat dit je eerste data science-projecten in R zijn, kun je denken aan basis data cleaning en -manipulatie, eenvoudige data-exploratie en datavisualisatie.
Spotify is een van de grootste digitale muziek-, video- en mediadiensten met miljoenen nummers, video’s en podcasts van over de hele wereld.
Je kunt een kant-en-klaar dataset gebruiken, Spotify Music Data, met zo’n 600 topnummers over een bepaalde periode, en de statistieken van meerdere kanten bekijken. Analyseer bijvoorbeeld de volgende factoren en vragen, en ondersteun je bevindingen waar nodig met duidelijke grafieken:
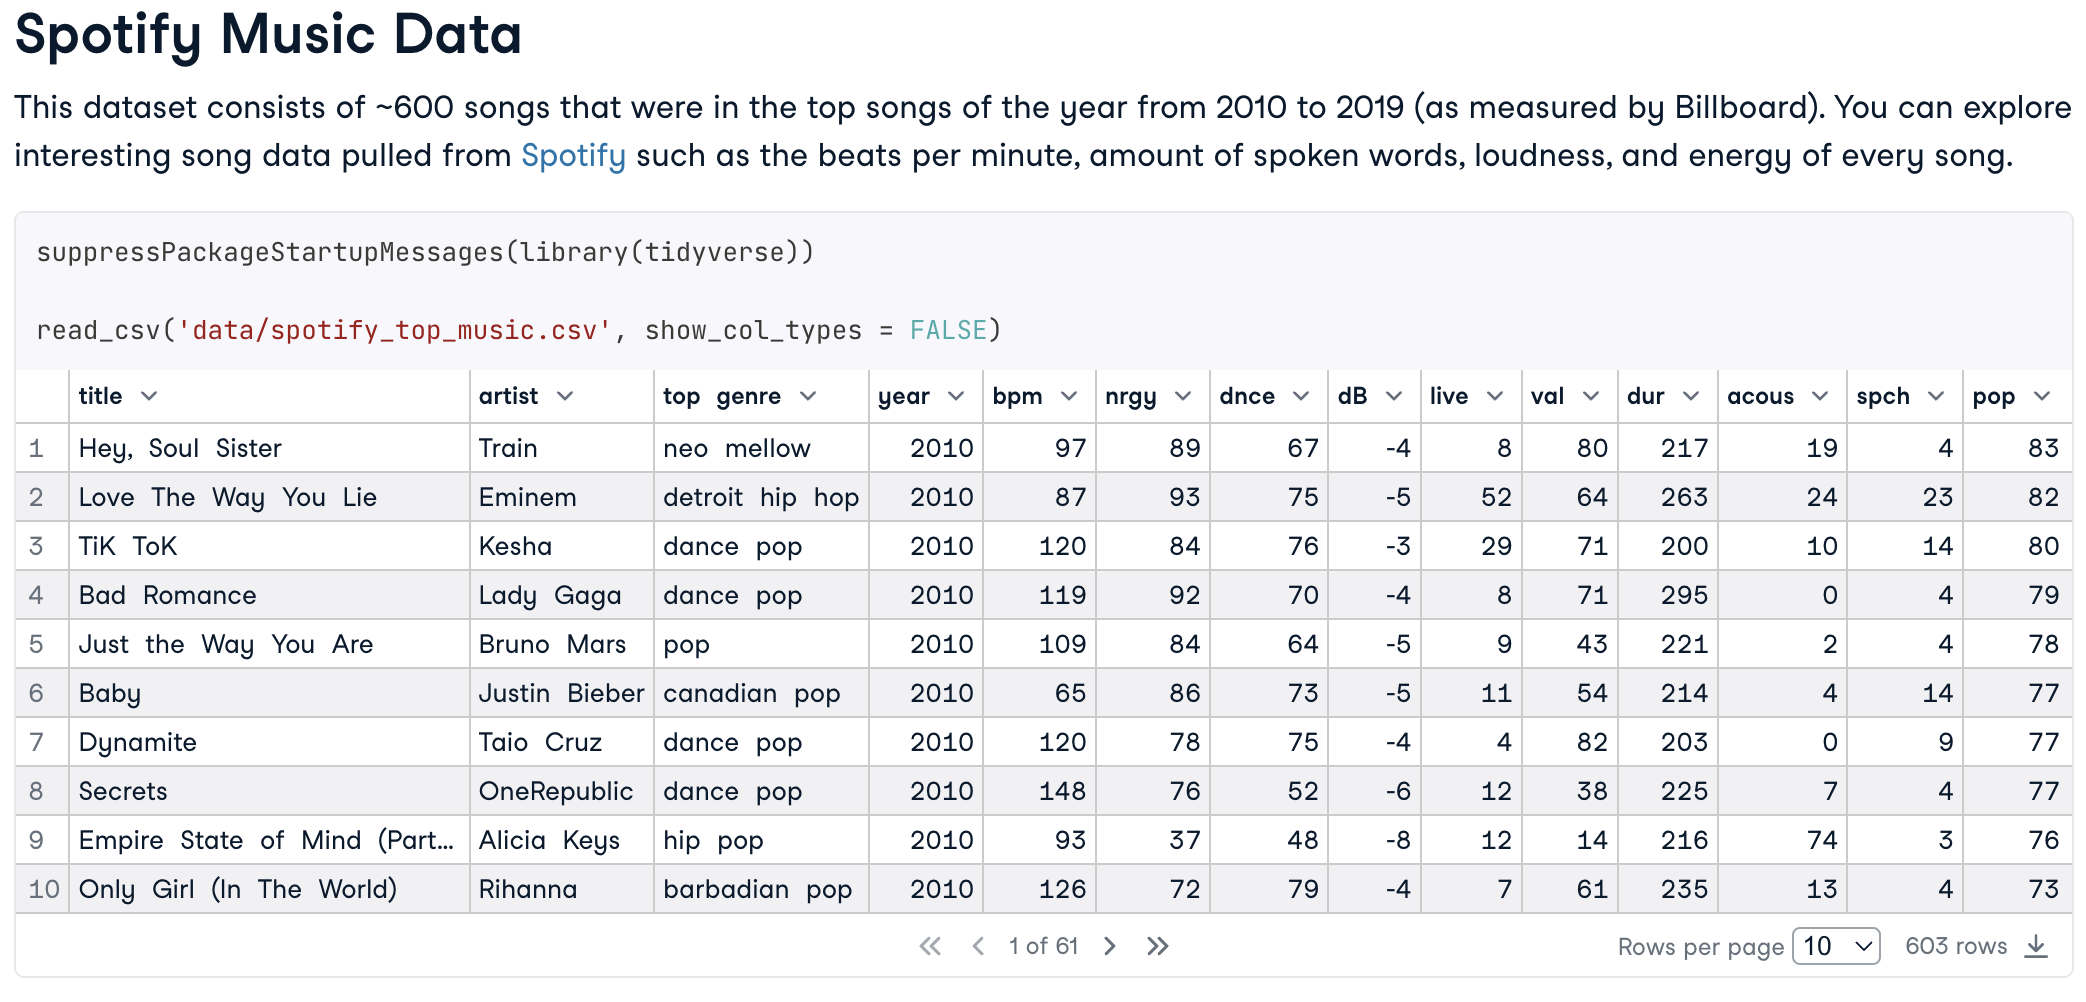
Een voorbeeld uit het R-project Spotify Music Data
De National Basketball Association (NBA) is een Noord-Amerikaanse professionele basketbalcompetitie voor mannen met 30 teams, een van de grootste ter wereld.
De dataset NBA Shooting Data bevat gegevens die zijn verzameld voor vier verschillende spelers tijdens de play-offs van de NBA 2021. Je kunt deze data analyseren en visualiseren en proberen de volgende vragen te beantwoorden:
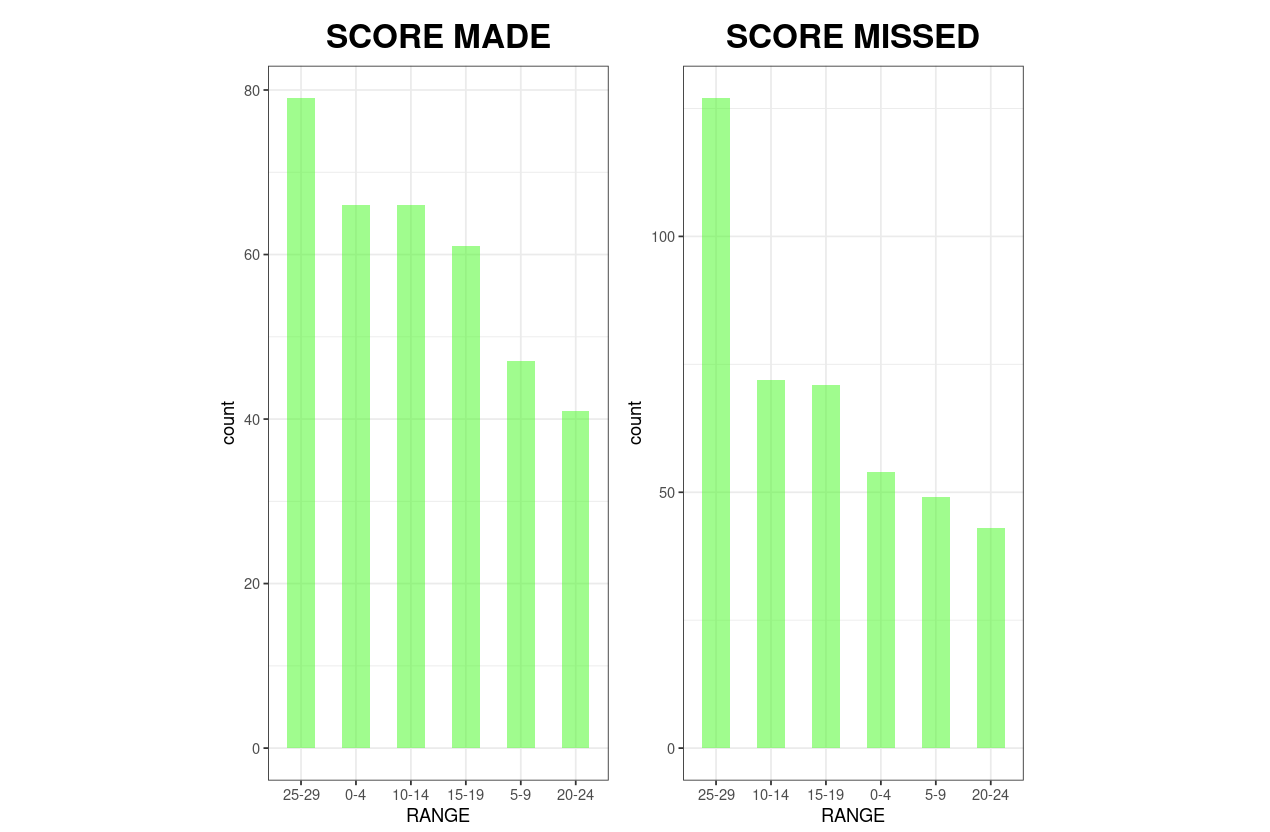
Een voorbeeld uit het R-project over NBA-schietstatistieken
Nog een interessant idee voor een R-project voor beginners is het onderzoeken van trends in de wereldbevolking.
De dataset World Population Data bevat de totale bevolkingsstatistieken per land van 1960 tot 2020, plus extra informatie per land, zoals regio, inkomensgroep en eventuele opmerkingen. Er zijn hier meerdere vragen te verkennen:
Vergeet niet om waar nuttig overtuigende grafieken toe te voegen: die helpen je lezers de belangrijkste inzichten uit je analyse beter te begrijpen.
Als je halverwege bent met het leren van data science in R, wil je misschien meer verfijnde R-projecten bouwen waarin je zowel je data-analysevaardigheden als enkele machine learning-algoritmen toepast.
Welke onderwerpen kun je daarvoor kiezen? Laten we kijken naar enkele mogelijke ideeën voor je geavanceerde data science-projecten in R.
Klantverloop is de neiging van klanten om hun abonnement op een dienst op te zeggen en daardoor geen klant meer te zijn. Het wordt berekend als het percentage klanten dat in een bepaalde periode is afgehaakt.
Deze indicator hangt van veel factoren af en weerspiegelt de algehele gezondheid van een bedrijf. Als het te hoog is, vormt het klantverloop een serieus probleem voor elk bedrijf, omdat het leidt tot omzetverlies en reputatieschade. Daarom is het belangrijk om klantverloop te kunnen voorspellen om het te voorkomen.
Je kunt de dataset Telecom Customer Churn gebruiken om een data science-project te bouwen dat het klantverloop bij een telecombedrijf voorspelt.
Concreet moet je hier voorspellen of een klant zal afhaken of niet op basis van de beschikbare data, en welke factoren de kans op afhaken vergroten. Technisch gezien is dit een typisch classificatieprobleem in machine learning, waarbij klanten worden gelabeld als 1 (churn) of 0 (non-churn).
Creditcardfraude is een serieuze uitdaging in het bankwezen, omdat daar traditioneel veel online transacties plaatsvinden. Detectie van creditcardfraude is meestal een supervised-classificatieprobleem waarbij methoden als k-nearest neighbors (KNN), logistische regressie, support vector machines (SVM) of decision trees kunnen worden toegepast.
Het kan echter ook worden opgelost met clustering-, anomaliedetectie- of neurale netwerkbenaderingen.
Dit probleem is lastig voor banken in het algemeen, omdat fraudepatronen en de tactieken van fraudeurs voortdurend evolueren, waardoor fraudedetectiesystemen zich snel moeten aanpassen.
Voor een data scientist of machine learning scientist zit de uitdaging ook in de aard van zulke datasets: er is altijd sprake van klassenonevenwicht, omdat fraudegevallen (gelukkig) in de minderheid zijn en (helaas) goed verborgen tussen de echte transacties.
De dataset Credit Card Fraud bevat informatie over creditcardtransacties in het westen van de Verenigde Staten. Overweeg deze te gebruiken om creditcardfraude te detecteren met een classificatieaanpak.
Als extra hint: het model mag best conservatiever zijn; uit veiligheidsoverwegingen is het niet erg om transacties soms onterecht als fraude te bestempelen. Je kunt ook de geospatiale verdeling van fraudecijfers per staat onderzoeken.
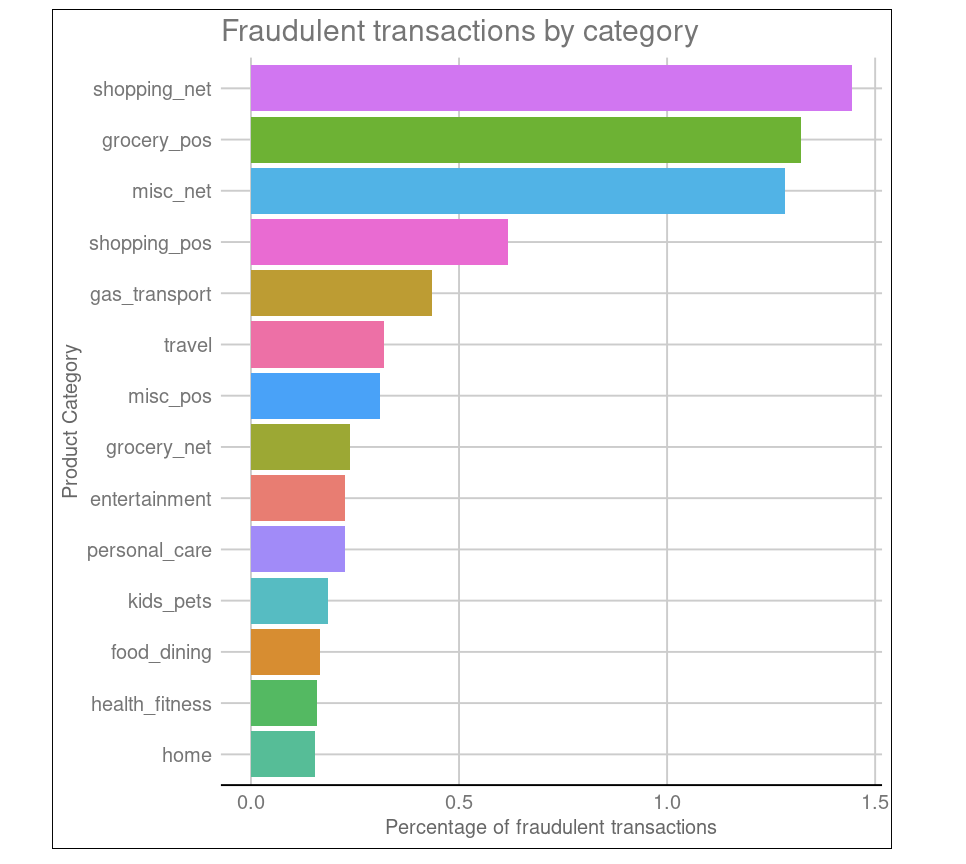
Nog een R-projectvoorbeeld van DataCamp
Waar de vorige twee projecten gingen over het classificeren van data in vooraf gedefinieerde categorieën, voorspel je hier continue uitkomsten op basis van inputkenmerken. Met andere woorden, je lost een regressieprobleem op met methoden als lineaire regressie, ridge-regressie, lasso-regressie, decision tree of support vector machines (SVM).
De dataset Bike Sharing Demand bevat informatie over het aantal publieke fietsen dat per uur is verhuurd in het deelfietsensysteem van Seoel, het weer, datum, tijd, of het een feestdag was, en meer. Jouw taak is om het aantal te verhuren fietsen te voorspellen op basis van die informatie.
Je kunt dit project ook gebruiken om het gemiddelde aantal gehuurde fietsen per dagdeel (ochtend, middag, avond) in de vier seizoenen te vergelijken, de relatie tussen temperatuur en het aantal gehuurde fietsen te onderzoeken, enzovoort. Voeg waar passend inzichtelijke visualisaties toe ter ondersteuning van je bevindingen.
Het is altijd een goed idee om in je portfolio minstens één project te hebben dat laat zien dat je unsupervised learning kunt toepassen.
Overweeg hiervoor de dataset E-Commerce Data, die bestaat uit aankopen bij een Britse online retailer door klanten uit verschillende landen over een bepaalde periode.
Een mogelijk scenario is dat de retailer de voorraad wil ordenen. Als veronderstelde data scientist in dit bedrijf moet je producten indelen in een klein aantal categorieën op basis van hun overeenkomst in enkele gemeenschappelijke kenmerken (prijs, verkochte hoeveelheid, enz.). Dit is een clusteringprobleem binnen unsupervised learning, met k-means als meest gebruikte algoritme.
Je kunt ook extra vragen analyseren, zoals welke vijf landen voor de meeste winst zorgen, of bestellingen van buiten het VK significant groter zijn dan bestellingen binnen het VK.
Tot slot kun je in een van je projecten je natural language processing (NLP)-skills in R laten zien.
De dataset SMS Spam Collection bevat een collectie van meer dan 5.500 Engelstalige berichten die zijn gelabeld als spam of niet-spam ("ham").
Maak op basis van deze data een filter dat spam en reguliere berichten nauwkeurig kan onderscheiden. Hiervoor heb je een NLP-pakket in R nodig (bijvoorbeeld koRpus) om linguïstische en contextuele patronen in de berichtteksten te zoeken en te achterhalen wat een bericht spam of ham maakt, om die inzichten vervolgens te generaliseren naar nieuwe data.
Optioneel kun je onderzoeken welke woorden het vaakst in spam voorkomen door een wordcloud te maken.
Samenvattend bespraken we waarom het belangrijk is om een portfolio met projecten op te bouwen om een carrière in data science te starten, waarom en hoe je R gebruikt voor data-analyse en data science, waar je relevante data en voorbeelden van R-projecten vindt en welke onderwerpen je kunt uitwerken in die projecten, of je nu beginner bent of al verder gevorderd.
Natuurlijk zijn de voorgestelde projectideeën slechts het topje van de ijsberg. Met R kun je nog veel meer: aanbevelingssystemen bouwen, klantsegmentatie uitvoeren, beurskoersen voorspellen, klantsentiment analyseren, de optimale positionering van taxi’s bepalen, en nog veel meer.
Of je nu mikt op een Data Scientist with R, een Data Analyst with R, een Machine Learning Scientist with R of een Statistician with R-pad, het tonen van je skills met praktijkprojecten is van onschatbare waarde. Door de uitgebreide bibliotheek en community-ondersteuning is R een ideale keuze voor data-analyse, machine learning en geavanceerd statistisch rekenen.
Door te beginnen met simpele projecten en geleidelijk complexere uitdagingen aan te gaan, bouw je een portfolio op dat niet alleen je technische kunde laat zien, maar ook je vermogen om betekenisvolle inzichten uit data te halen. Deze hands-on ervaring maakt niet alleen indruk op potentiële werkgevers, maar bereidt je ook voor op de diverse en dynamische uitdagingen in je data science-carrière.
Voor meer inspiratie, bezoek DataLab, een online IDE met vooringeladen datasets en vooraf gedefinieerde templates om code te schrijven en data te analyseren, zodat je de stap zet van leren naar doen in data science.
Cursussen voor R
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

