
Kursus
Intermediate Deep Learning with PyTorch
4 jam
30K
Fungsi aktivasi seperti Rectified Linear Unit (ReLU) adalah pilar dari jaringan saraf modern. Tanpa fungsi ini, banyak aplikasi AI di dunia nyata—dari pengenalan gambar hingga sistem rekomendasi—tidak akan mungkin terjadi. Panduan ini membahas dasar-dasar ReLU, kelebihan, keterbatasan, dan implementasinya.
Beberapa aplikasi AI yang paling kuat tidak akan mungkin tanpa jaringan saraf tiruan. Jaringan saraf adalah model komputasi yang terinspirasi oleh otak manusia. Jaringan ini terdiri dari node yang saling terhubung, atau "neuron," yang bekerja bersama untuk memproses informasi dan membuat keputusan. Yang membuat jaringan saraf menjadi "dalam" adalah jumlah lapisan antara input dan output. Jaringan saraf dalam memiliki banyak lapisan, memungkinkan jaringan mempelajari fitur yang lebih kompleks dan membuat prediksi yang lebih akurat.
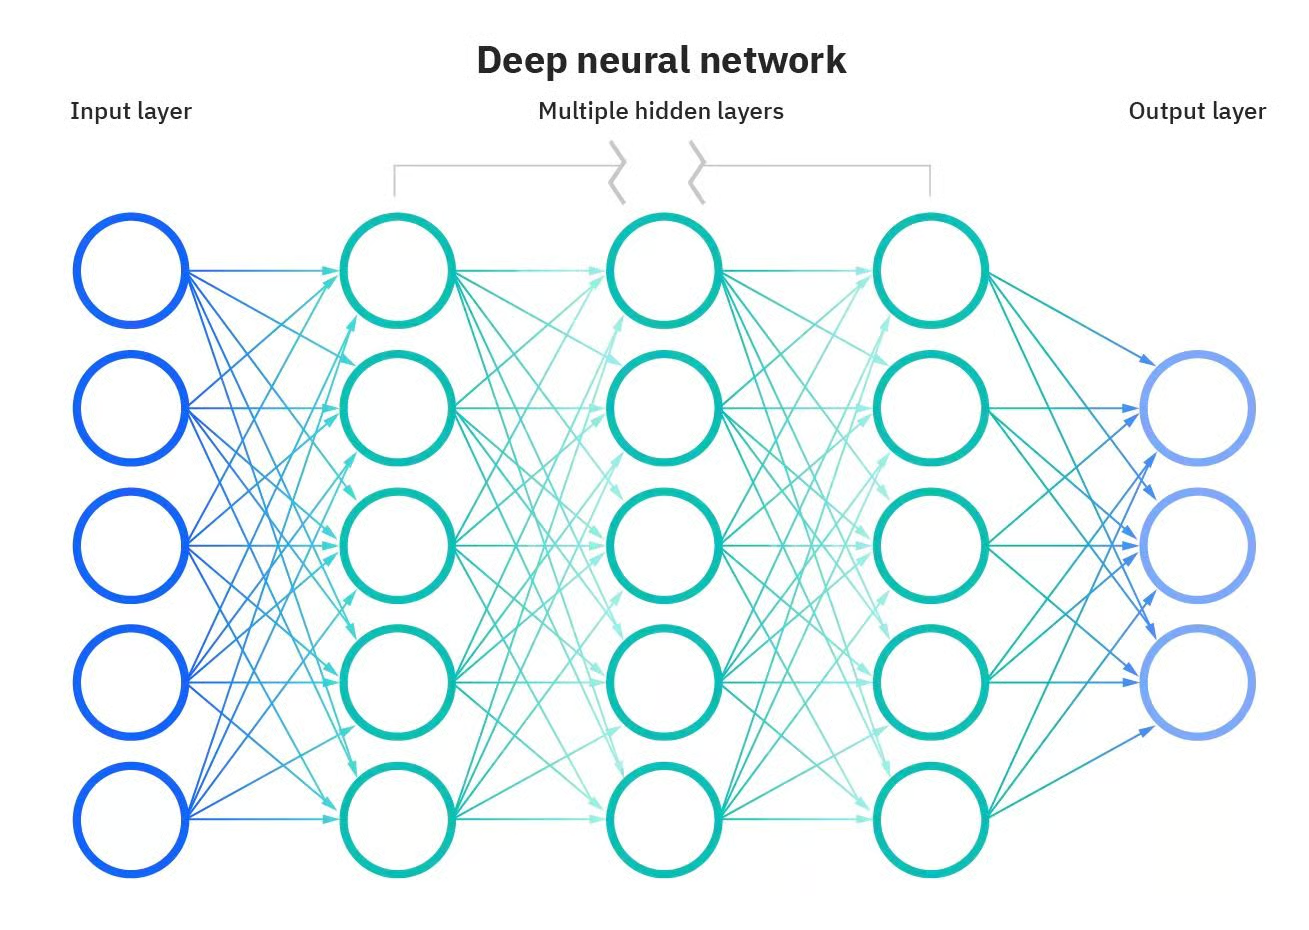
Jaringan Saraf Dalam. Sumber: DataCamp
Namun, model-model ini jauh lebih dari sekadar lapisan sederhana. Komponen lain juga krusial agar jaringan saraf dapat bekerja dengan baik.
Salah satu komponen tersebut adalah fungsi aktivasi. Anda dapat memandang fungsi aktivasi sebagai pengambil keputusan; fungsi ini menentukan informasi apa yang harus diteruskan ke lapisan berikutnya, memberikan tingkat kompleksitas baru yang memungkinkan jaringan saraf membuat keputusan yang lebih bernuansa.
Di sini, kami akan memperkenalkan salah satu fungsi aktivasi yang paling populer dan banyak digunakan: Rectified Linear Unit (ReLU). Kami akan menjelaskan dasar-dasar fungsi aktivasi ini dan beberapa variannya, kelebihan dan keterbatasannya, serta cara mengimplementasikannya dengan Pytorch. Lanjut membaca?
Fungsi aktivasi adalah blok pembangun integral dari jaringan saraf. Fungsi ini mengubah sinyal masukan dari sebuah node dalam jaringan saraf menjadi sinyal keluaran yang kemudian diteruskan ke lapisan berikutnya. Tanpa fungsi aktivasi, jaringan saraf hanya bisa memodelkan hubungan linear antara input dan output, misalnya melalui perkalian matriks.
Namun, sebagian besar data dunia nyata tidak dapat dimodelkan hanya dengan linearitas. Non-linearitas menangkap pola seperti bagaimana transisi dari tidak memiliki anak menjadi memiliki satu anak mungkin memengaruhi transaksi perbankan Anda secara berbeda dibanding dari tiga anak menjadi empat. Jika jaringan saraf tidak memiliki fungsi aktivasi, jaringan akan gagal mempelajari pola non-linear yang kompleks yang ada dalam peristiwa dunia nyata.
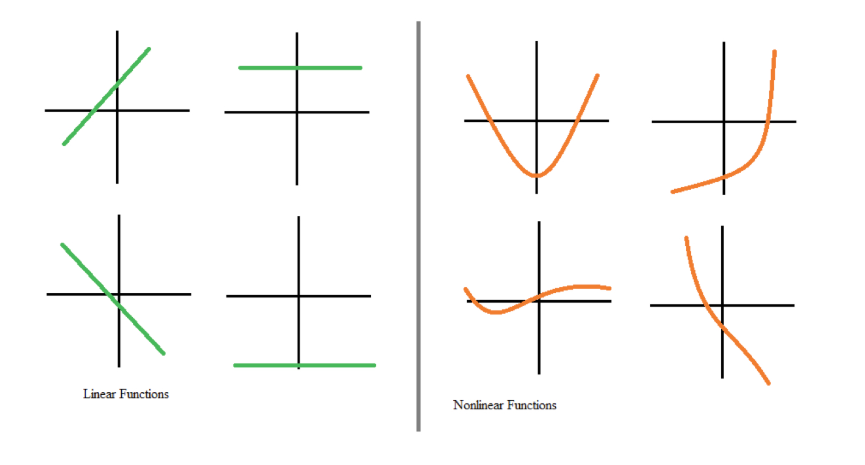
Fungsi linear vs non-linear. Sumber: DataCamp
Fungsi aktivasi memungkinkan jaringan saraf mempelajari hubungan dengan memperkenalkan perilaku non-linear. Dengan kata lain, fungsi aktivasi menciptakan ambang numerik untuk memutuskan apakah akan mengaktifkan sebuah neuron, memperkenalkan tingkat keluwesan yang penting bagi jaringan saraf untuk memodelkan data yang kompleks dan bernuansa.
Salah satu fungsi aktivasi yang paling populer dan banyak digunakan adalah ReLU (rectified linear unit). Seperti fungsi aktivasi lainnya, ReLU memberikan non-linearitas pada model untuk kinerja komputasi yang lebih baik.
Fungsi aktivasi ReLU berbentuk:
f(x) = max(0, x)
Fungsi ReLU mengeluarkan nilai maksimum antara inputnya dan nol, seperti yang ditunjukkan pada grafik. Untuk input positif, output fungsi sama dengan input. Untuk input yang benar-benar negatif, output fungsi sama dengan nol.
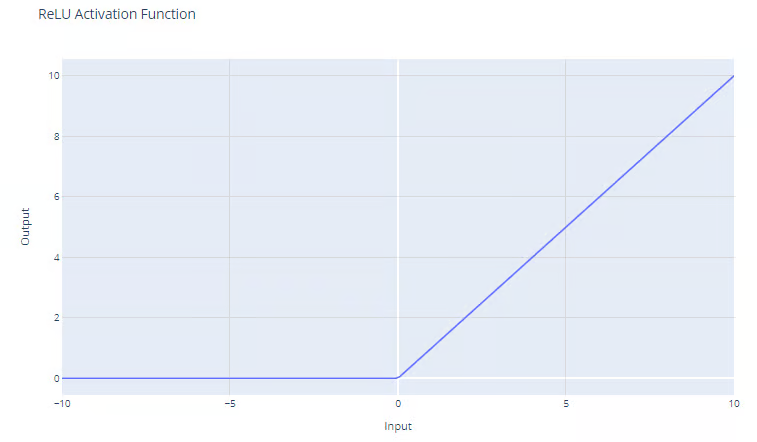
Fungsi aktivasi Rectified Linear Unit (ReLU). Sumber: DataCamp
Salah satu kelebihan paling signifikan dari ReLU adalah membantu mengurangi masalah vanishing gradient. Masalah vanishing gradient adalah tantangan yang terjadi saat melatih jaringan saraf dalam menggunakan backpropagation. Masalah ini muncul ketika gradien yang digunakan untuk memperbarui bobot jaringan menjadi sangat kecil atau "menghilang" saat bergerak mundur melalui jaringan. Hal ini mencegah bobot diperbarui dengan benar, yang dapat memperlambat atau menghentikan proses pembelajaran. Anda dapat membaca penjelasan lengkap tentang masalah vanishing gradient dalam Kursus Pengantar Deep Learning di PyTorch kami.
Karena fungsi ReLU tidak memiliki batas atas dan gradien tidak konvergen ke nol untuk nilai x yang tinggi, ReLU mengatasi masalah vanishing gradient yang umum terjadi saat menggunakan fungsi aktivasi sigmoid dan softmax. Lihat artikel terpisah kami untuk menemukan fungsi aktivasi populer lainnya.
Selain itu, karena ReLU menghasilkan nol untuk semua input negatif, fungsi ini secara alami menghasilkan aktivasi yang jarang (sparse). Dengan kata lain, karena hanya sebagian neuron yang aktif selama pelatihan, hal ini menghasilkan komputasi yang lebih efisien.
Terakhir, perilaku ini memungkinkan jaringan diskalakan ke banyak lapisan tanpa peningkatan beban komputasi yang signifikan, dibandingkan fungsi yang lebih kompleks seperti tanh atau sigmoid. Ini menjadikan ReLU sebagai fungsi aktivasi standar paling umum dan biasanya pilihan yang baik jika Anda tidak yakin fungsi aktivasi apa yang akan digunakan dalam model Anda.
Mengimplementasikan ReLU di PyTorch cukup mudah. Anda hanya perlu menggunakan fungsi nn.ReLU() untuk membuat fungsinya dan menambahkannya ke model Anda.
Pada contoh berikut, kami menerapkan fungsi ReLU pada sebuah neuron sederhana dan menghitung gradien dalam kasus nilai negatif.
# Create a ReLU function with PyTorch
relu_pytorch = nn.ReLU()

# Apply your ReLU function on x, and calculate gradients
x = torch.tensor(-1.0, requires_grad=True)
y = relu_pytorch(x)
y.backward()

# Print the gradient of the ReLU function for x
gradient = x.grad
print(gradient)
>>> tensor(0.)
Perhatikan bahwa nilai input adalah -1, dan fungsi ReLU mengembalikan nol. Ingat bahwa untuk nilai x negatif, output ReLU selalu nol, dan memang, gradien bernilai nol di mana-mana karena tidak ada perubahan pada fungsi untuk nilai x negatif mana pun.
ReLU bisa dibilang fungsi aktivasi yang paling banyak digunakan, tetapi terkadang fungsi ini mungkin tidak bekerja untuk masalah yang ingin Anda selesaikan. Untungnya, peneliti deep learning telah mengembangkan beberapa varian ReLU yang mungkin layak diuji pada model Anda. Berikut alternatif yang paling populer
Leaky ReLU berbentuk:
f(x) = max(0.01x, x)
Tujuan Leaky ReLU adalah mengatasi masalah "dying ReLU". Kami sudah menyebutkan bahwa ReLU selalu menghasilkan nilai nol untuk input negatif. Ketika ini terjadi, gradien node dengan nilai negatif akan diatur ke nol untuk sisa pelatihan, yang akan mencegah parameter ini belajar. Untuk mengatasi tantangan ini, Leaky ReLU menggunakan faktor pengali untuk input negatif. Akibatnya, fungsi tidak akan nol, melainkan memiliki kemiringan negatif kecil, seperti yang ditunjukkan pada grafik berikut:
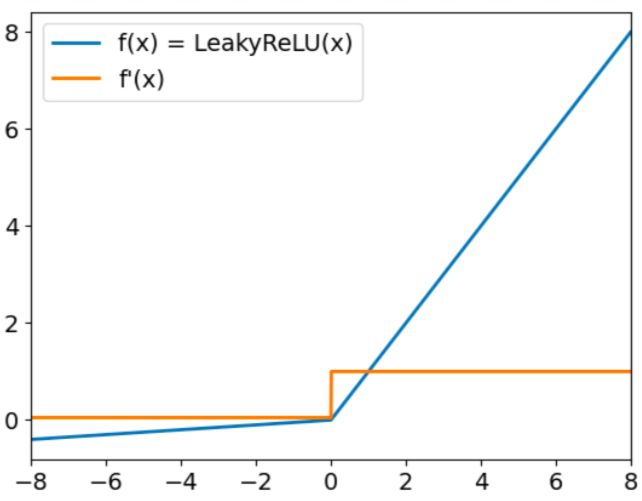
Fungsi aktivasi Leaky ReLU. Sumber: DataCamp
Leaky ReLU menawarkan faktor pengali untuk mengatasi masalah dying ReLU. Parametric ReLU (PReLU) melangkah lebih jauh, menawarkan parameter yang dapat dipelajari (a) alih-alih konstanta sederhana untuk menghitung nilai input negatif:
f(x) = max(ax, x)
Walaupun PReLU menawarkan peningkatan dibanding ReLU dan Leaky ReLU dalam hal akurasi dan kemampuan beradaptasi (sangat cocok untuk menangkap pola dalam tugas kompleks, seperti computer vision atau pengenalan suara), PReLU juga menambah kompleksitas model. Melatih parameter ini dapat memakan waktu dan memerlukan pengaturan serta regularisasi yang cermat.
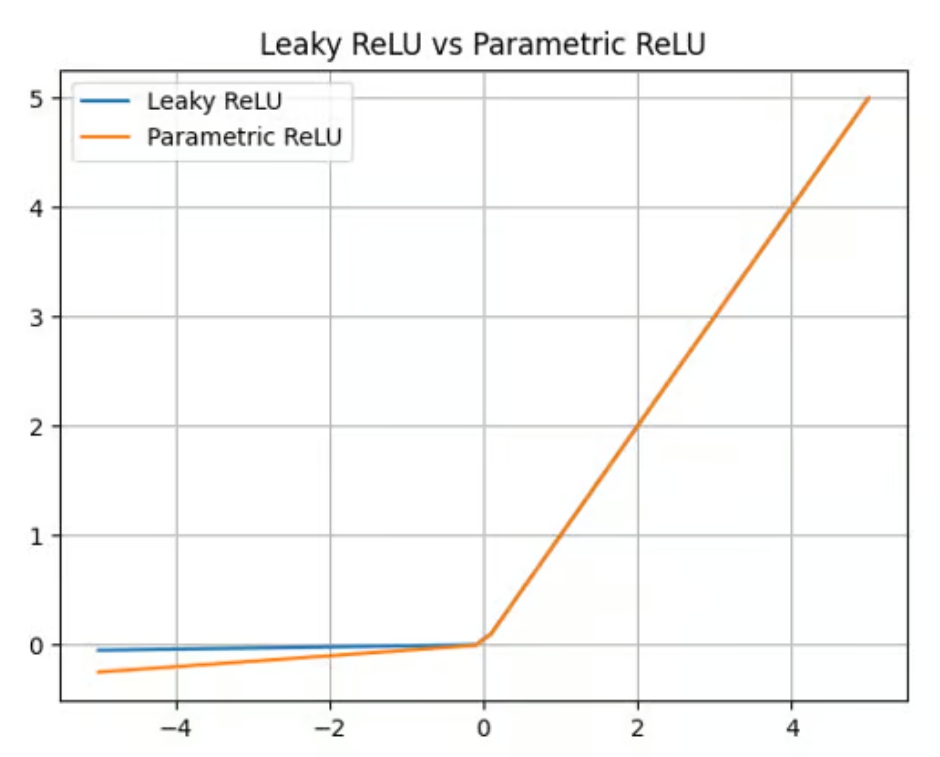
Fungsi aktivasi Parametric ReLU. Sumber: DataCamp
Alternatif hebat lainnya untuk ReLU adalah Exponential linear unit (ELU), yang memiliki rumus berikut:
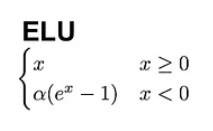
Berbeda dengan ReLU, ELU memiliki nilai negatif, yang memungkinkan fungsi ini mendorong rata-rata aktivasi unit mendekati nol, sehingga membuatnya kurang rentan terhadap vanishing gradient. Selain itu, rata-rata aktivasi yang lebih dekat ke nol menyebabkan pembelajaran dan konvergensi yang lebih cepat.
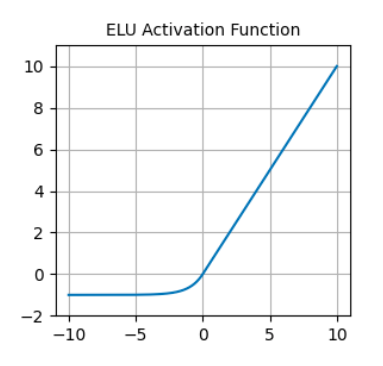
Fungsi aktivasi ELU. Sumber: DataCamp
ReLU adalah fungsi aktivasi yang hebat, tetapi bukan peluru perak. Secara khusus, ReLU dapat mengalami dua masalah yang terkenal.
Yang pertama adalah masalah dying ReLU. Seperti telah disebutkan, ReLU selalu menghasilkan nilai nol untuk input negatif. Ini dapat menyebabkan bobot diperbarui sedemikian rupa sehingga neuron tidak akan pernah aktif lagi pada titik data mana pun.
Jika hal ini terjadi, maka gradien yang mengalir melalui unit tersebut akan selamanya nol sejak saat itu, mencegah parameter ini untuk belajar. Varian ReLU, seperti Leaky ReLU dan PReLU, dibuat untuk mengatasi masalah ini.
Gradien yang tidak stabil juga dapat terjadi di sisi lain. Masalah exploding gradients terjadi ketika gradien menjadi semakin besar, yang menyebabkan pembaruan parameter sangat besar dan pelatihan menjadi divergen.
Dalam kasus ini, gradien galat yang lebih besar menumpuk, dan bobot model menjadi terlalu besar. Masalah ini dapat menyebabkan waktu pelatihan lebih lama dan kinerja model yang buruk. Ada beberapa teknik untuk mengatasi masalah exploding gradient, termasuk gradient clipping dan batch normalization.
Berkat sifat uniknya, ReLU menjadi fungsi aktivasi paling populer, menjadi opsi default di kerangka kerja seperti PyTorch dan TensorFlow, serta banyak digunakan dalam berbagai aplikasi deep learning, termasuk:
Kami telah membahas peran penting fungsi aktivasi ReLU selama pelatihan jaringan saraf. Terlepas dari kesederhanaannya, ReLU adalah salah satu fungsi aktivasi paling efektif yang ada, dan bisa dibilang yang paling populer.
Seiring jaringan saraf terus berkembang, eksplorasi fungsi aktivasi pasti akan meluas, mungkin mencakup bentuk baru yang menangani tantangan spesifik dari arsitektur yang sedang muncul.
Pemilihan fungsi aktivasi yang cermat adalah tindakan menyeimbangkan—perpaduan antara pemahaman ilmiah dan intuisi terampil—yang dapat berdampak signifikan pada kinerja jaringan saraf.
Tertarik mempelajari lebih lanjut tentang deep learning? Lihat materi khusus kami dan bersiaplah untuk salah satu teknologi paling transformatif dalam AI:
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt




