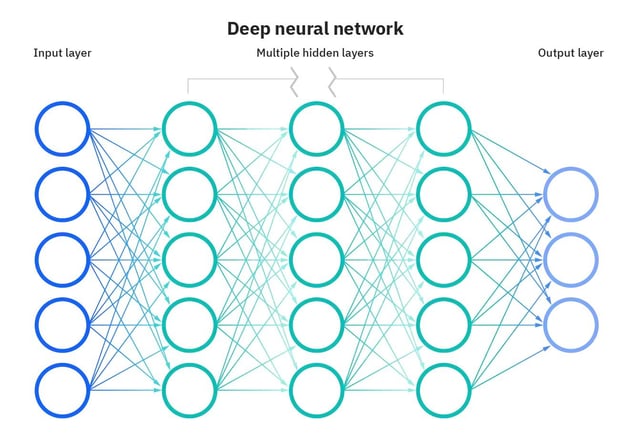
Representasi Jaringan Saraf. Sumber Gambar
Apa Itu Fungsi Aktivasi?
Fungsi aktivasi adalah blok bangunan integral dari jaringan saraf yang memungkinkannya mempelajari pola kompleks dalam data. Fungsi ini mengubah sinyal masukan sebuah node di jaringan saraf menjadi sinyal keluaran yang kemudian diteruskan ke lapisan berikutnya. Tanpa fungsi aktivasi, jaringan saraf akan terbatas pada pemodelan hubungan linear antara masukan dan keluaran.
Fungsi aktivasi memperkenalkan non-linearitas, sehingga jaringan saraf dapat mempelajari pemetaan yang sangat kompleks antara masukan dan keluaran.
Memilih fungsi aktivasi yang tepat sangat penting untuk melatih jaringan saraf yang mampu melakukan generalisasi dengan baik dan memberikan prediksi akurat. Dalam artikel ini, kami akan memberikan gambaran umum tentang fungsi aktivasi paling umum, perannya, dan cara memilih fungsi aktivasi yang sesuai untuk berbagai kasus penggunaan.
Baik Anda baru memulai di bidang deep learning maupun sudah berpengalaman, memahami fungsi aktivasi secara mendalam akan membangun intuisi Anda dan meningkatkan penerapan jaringan saraf.
Mengapa Fungsi Aktivasi Esensial?
Tanpa fungsi aktivasi, jaringan saraf hanya akan terdiri dari operasi linear seperti perkalian matriks. Semua lapisan akan melakukan transformasi linear atas masukan, dan tidak ada non-linearitas yang diperkenalkan.
Sebagian besar data dunia nyata bersifat non-linear. Misalnya, hubungan antara harga rumah dan ukuran, pendapatan dan pembelian, dan sebagainya, adalah non-linear. Jika jaringan saraf tidak memiliki fungsi aktivasi, jaringan akan gagal mempelajari pola non-linear kompleks yang ada pada data dunia nyata.
Fungsi aktivasi memungkinkan jaringan saraf mempelajari hubungan non-linear ini dengan memperkenalkan perilaku non-linear melalui fungsi aktivasi. Hal ini sangat meningkatkan fleksibilitas dan kemampuan jaringan saraf untuk memodelkan data yang kompleks dan bernuansa.
Jenis-Jenis Fungsi Aktivasi
Jaringan saraf memanfaatkan berbagai jenis fungsi aktivasi untuk memperkenalkan non-linearitas dan memungkinkan pembelajaran pola yang kompleks. Setiap fungsi aktivasi memiliki karakteristik unik dan cocok untuk kasus penggunaan tertentu.
Sebagai contoh, fungsi sigmoid ideal untuk masalah klasifikasi biner, softmax berguna untuk prediksi multi-kelas, dan ReLU membantu mengatasi masalah vanishing gradient.
Menggunakan fungsi aktivasi yang tepat untuk tugasnya menghasilkan pelatihan yang lebih cepat dan kinerja yang lebih baik.
Mari kita lihat beberapa fungsi aktivasi yang umum:
Aktivasi linear
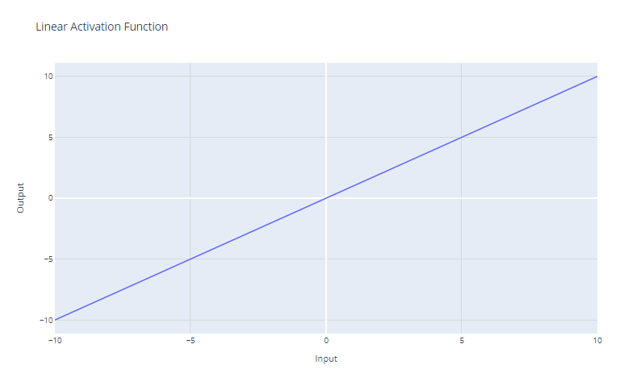
Fungsi aktivasi linear. Gambar oleh Penulis
Fungsi aktivasi linear adalah fungsi aktivasi paling sederhana, didefinisikan sebagai:
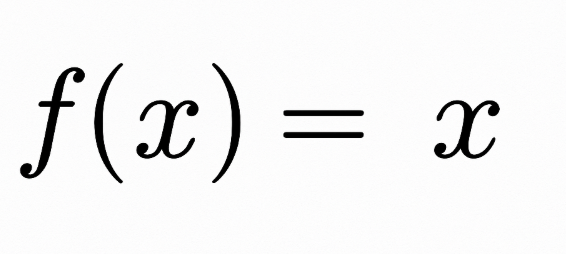
Fungsi ini hanya mengembalikan masukan x sebagai keluaran. Secara grafis, terlihat seperti garis lurus dengan kemiringan 1.
Kasus penggunaan utama fungsi aktivasi linear adalah pada lapisan keluaran jaringan saraf untuk regresi. Untuk masalah regresi di mana kita ingin memprediksi nilai numerik, menggunakan fungsi aktivasi linear pada lapisan keluaran memastikan jaringan saraf menghasilkan nilai numerik. Fungsi aktivasi linear tidak mengompresi atau mentransformasi keluaran, sehingga nilai prediksi aktual dikembalikan.
Namun, fungsi aktivasi linear jarang digunakan di lapisan tersembunyi jaringan saraf. Ini karena tidak memberikan non-linearitas apa pun. Tujuan utama lapisan tersembunyi adalah mempelajari kombinasi non-linear dari fitur masukan. Menggunakan aktivasi linear di seluruh jaringan akan membatasi model untuk hanya mempelajari transformasi linear dari masukan.
Aktivasi sigmoid
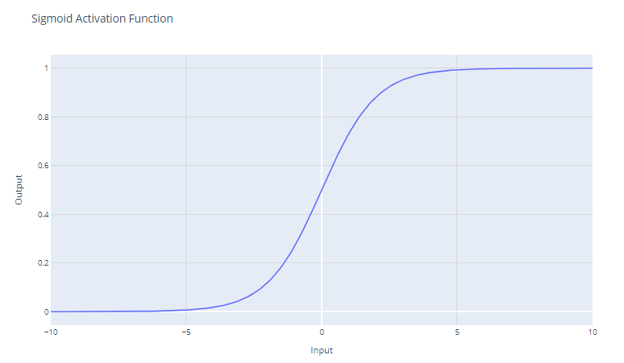
Fungsi aktivasi sigmoid. Gambar oleh Penulis
Fungsi aktivasi sigmoid, sering dilambangkan sebagai σ(x), adalah fungsi yang halus dan terdiferensiasi secara kontinu yang secara historis penting dalam perkembangan jaringan saraf. Fungsi aktivasi sigmoid memiliki bentuk matematis:
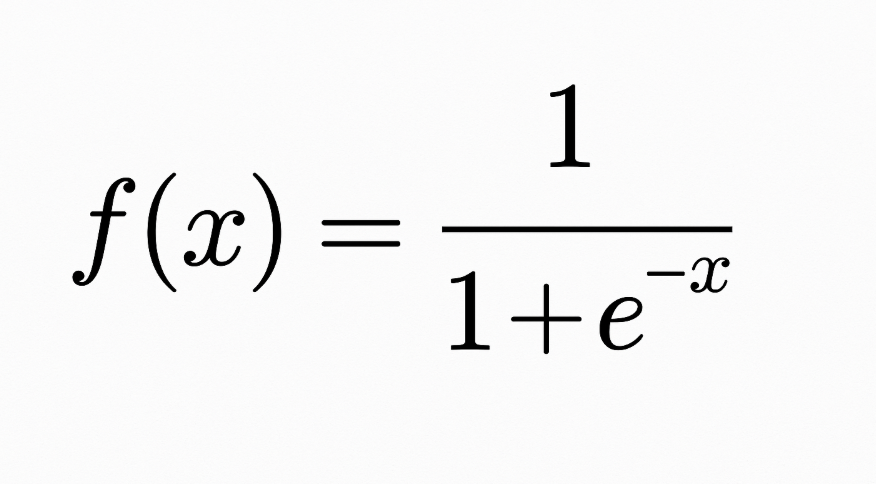
Fungsi ini menerima masukan bernilai real dan mengompresinya ke nilai antara 0 dan 1. Kurva sigmoid berbentuk "S" yang mendekati 0 untuk bilangan negatif besar dan 1 untuk bilangan positif besar. Keluaran mudah ditafsirkan sebagai probabilitas, yang membuatnya alami untuk masalah klasifikasi biner.
Unit sigmoid populer pada jaringan saraf awal karena gradien paling kuat ketika keluaran unit mendekati 0,5, memungkinkan pelatihan backpropagation yang efisien. Namun, unit sigmoid mengalami masalah "vanishing gradient" yang menghambat pembelajaran pada jaringan saraf yang dalam.
Saat nilai masukan menjadi sangat positif atau negatif, fungsi menjadi jenuh pada 0 atau 1, dengan kemiringan yang sangat datar. Di wilayah ini, gradien sangat mendekati nol. Ini menghasilkan perubahan bobot yang sangat kecil selama backpropagation, khususnya untuk neuron di lapisan awal jaringan yang dalam, yang membuat pembelajaran sangat lambat atau bahkan terhenti. Ini disebut masalah vanishing gradient pada jaringan saraf.
Kasus penggunaan utama fungsi sigmoid adalah sebagai aktivasi untuk lapisan keluaran model klasifikasi biner. Fungsi ini mengompresi keluaran menjadi nilai probabilitas antara 0 dan 1, yang dapat ditafsirkan sebagai probabilitas masukan termasuk dalam kelas tertentu.
Aktivasi tanh (tangen hiperbolik)
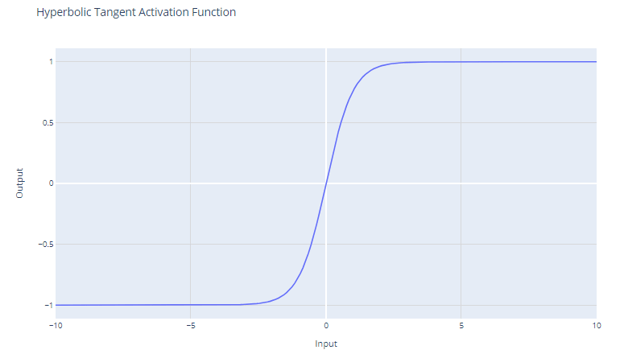
Fungsi aktivasi tanh. Gambar oleh Penulis
Fungsi aktivasi tanh (tangen hiperbolik) didefinisikan sebagai:
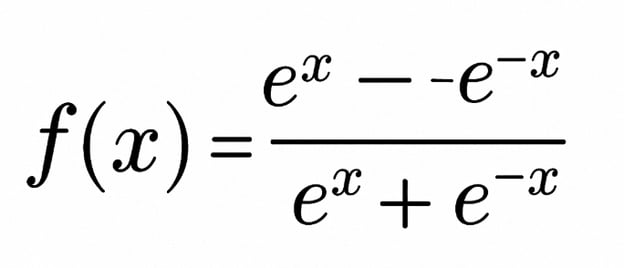
Fungsi tanh menghasilkan nilai dalam rentang -1 hingga +1. Ini berarti dapat menangani nilai negatif lebih efektif dibandingkan fungsi sigmoid, yang rentangnya 0 hingga 1.
Tidak seperti fungsi sigmoid, tanh berpusat di nol, yang berarti keluarannya simetris terhadap titik asal sistem koordinat. Ini sering dianggap sebagai keuntungan karena dapat membantu algoritma pembelajaran berkonsvergensi lebih cepat.
Karena keluaran tanh berada di antara -1 dan +1, gradiennya lebih kuat daripada fungsi sigmoid. Gradien yang lebih kuat sering kali menghasilkan pembelajaran dan konvergensi yang lebih cepat selama pelatihan karena cenderung lebih tahan terhadap masalah vanishing gradient dibandingkan gradien fungsi sigmoid.
Terlepas dari keunggulan ini, fungsi tanh tetap mengalami masalah vanishing gradient. Selama backpropagation, gradien fungsi tanh dapat menjadi sangat kecil (mendekati nol). Masalah ini sangat mengganggu untuk jaringan dalam dengan banyak lapisan; gradien fungsi rugi dapat menjadi terlalu kecil untuk membuat perubahan bobot yang signifikan selama pelatihan saat merambat kembali ke lapisan awal. Ini dapat memperlambat proses pelatihan secara drastis dan menyebabkan sifat konvergensi yang buruk.
Fungsi tanh sering digunakan pada lapisan tersembunyi jaringan saraf. Karena sifatnya yang berpusat di nol, ketika data juga dinormalisasi agar memiliki mean nol, hal ini dapat menghasilkan pelatihan yang lebih efisien.
Jika harus memilih antara sigmoid dan tanh tanpa alasan khusus untuk memihak salah satunya, tanh sering menjadi pilihan yang lebih baik karena alasan yang disebutkan di atas. Namun, keputusan juga dapat dipengaruhi oleh kasus penggunaan spesifik dan perilaku jaringan selama eksperimen pelatihan awal.
Anda dapat membangun Jaringan Saraf Sederhana dari nol menggunakan PyTorch dengan mengikuti tutorial kami oleh Kurtis Pykes, atau, jika Anda pengguna tingkat lanjut, kursus Deep Learning with PyTorch kami cocok untuk Anda. .
Aktivasi ReLU (rectified linear unit)
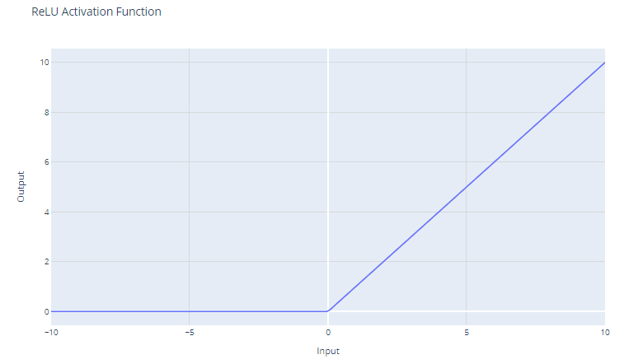
Fungsi aktivasi Rectified Linear Unit (ReLU). Gambar oleh Penulis
Fungsi aktivasi Rectified Linear Unit (ReLU) memiliki bentuk:
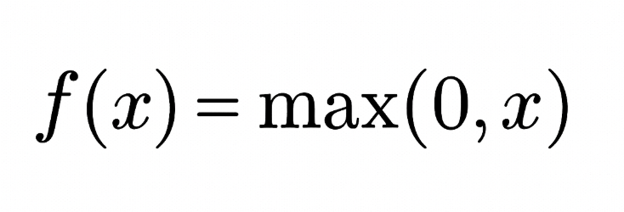
Fungsi ini memberi ambang pada masukan di nol, mengembalikan 0 untuk nilai negatif dan masukan itu sendiri untuk nilai positif.
Untuk masukan lebih besar dari 0, ReLU bertindak sebagai fungsi linear dengan gradien 1. Ini berarti tidak mengubah skala masukan positif dan memungkinkan gradien melewati tanpa berubah selama backpropagation. Properti ini penting untuk mengurangi masalah vanishing gradient.
Meskipun ReLU linear untuk setengah ruang masukannya, secara teknis ia adalah fungsi non-linear karena memiliki titik yang tidak terdiferensiasi pada x=0, tempat ia berubah secara tiba-tiba dari x. Non-linearitas ini memungkinkan jaringan saraf mempelajari pola yang kompleks.
Karena ReLU menghasilkan nol untuk semua masukan negatif, fungsi ini secara alami mengarah pada aktivasi yang jarang; pada suatu waktu, hanya sebagian neuron yang aktif, sehingga komputasi lebih efisien.
Fungsi ReLU secara komputasional murah karena hanya melibatkan pengambangan sederhana di nol. Ini memungkinkan jaringan ditingkatkan ke banyak lapisan tanpa peningkatan beban komputasi yang signifikan, dibandingkan dengan fungsi yang lebih kompleks seperti tanh atau sigmoid.
Aktivasi softmax
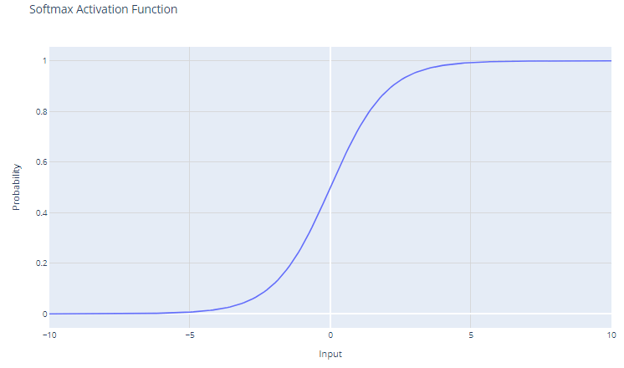
Fungsi aktivasi softmax. Gambar oleh Penulis
Fungsi aktivasi softmax, juga dikenal sebagai fungsi eksponensial ternormalisasi, sangat berguna dalam konteks masalah klasifikasi multi-kelas. Fungsi ini bekerja pada sebuah vektor, sering disebut logits, yang merepresentasikan prediksi mentah atau skor untuk setiap kelas yang dihitung oleh lapisan sebelumnya dari jaringan saraf.
Untuk vektor masukan x dengan elemen x1, x2, ..., xC, fungsi softmax didefinisikan sebagai:
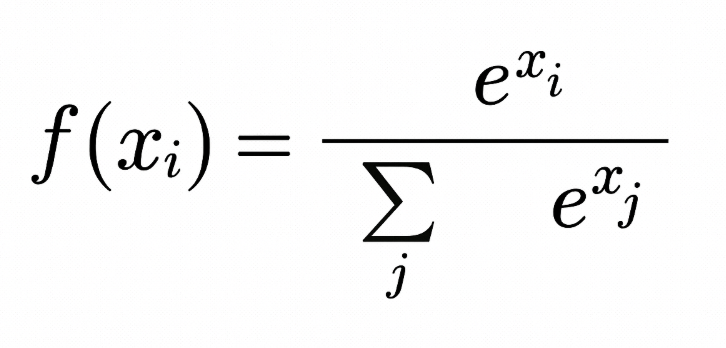
Keluaran fungsi softmax adalah distribusi probabilitas yang jumlahnya mencapai satu. Setiap elemen keluaran mewakili probabilitas bahwa masukan termasuk dalam kelas tertentu.
Penggunaan fungsi eksponensial memastikan semua nilai keluaran tidak negatif. Ini krusial karena probabilitas tidak boleh negatif.
Softmax memperkuat perbedaan dalam vektor masukan. Bahkan perbedaan kecil pada nilai masukan dapat menyebabkan perbedaan besar pada probabilitas keluaran, dengan nilai masukan tertinggi cenderung mendominasi dalam distribusi probabilitas yang dihasilkan.
Softmax biasanya digunakan pada lapisan keluaran jaringan saraf ketika tugasnya melibatkan pengklasifikasian masukan ke dalam salah satu dari beberapa (lebih dari dua) kategori yang mungkin (klasifikasi multi-kelas).
Probabilitas yang dihasilkan oleh fungsi softmax dapat ditafsirkan sebagai skor keyakinan untuk setiap kelas, memberikan wawasan tentang tingkat kepastian model terhadap prediksinya.
Karena softmax memperkuat perbedaan, fungsi ini dapat sensitif terhadap pencilan atau nilai ekstrem. Misalnya, jika vektor masukan memiliki nilai yang sangat besar, softmax dapat "mengompresi" probabilitas kelas lain, sehingga menghasilkan model yang terlalu percaya diri.
Memilih Fungsi Aktivasi yang Tepat
Pilihan fungsi aktivasi bergantung pada jenis masalah yang ingin Anda selesaikan. Berikut beberapa panduan:
Untuk klasifikasi biner
Gunakan fungsi aktivasi sigmoid pada lapisan keluaran. Fungsi ini akan mengompresi keluaran antara 0 dan 1, merepresentasikan probabilitas untuk dua kelas.
Untuk klasifikasi multi-kelas
Gunakan fungsi aktivasi softmax pada lapisan keluaran. Fungsi ini akan menghasilkan distribusi probabilitas atas semua kelas.
Jika belum yakin
Gunakan fungsi aktivasi ReLU pada lapisan tersembunyi. ReLU adalah fungsi aktivasi default yang paling umum dan biasanya merupakan pilihan yang baik.
Kesimpulan
Kita telah menelaah peran penting yang dimainkan fungsi aktivasi dalam pelatihan jaringan saraf. Kita telah melihat bahwa fungsi ini bukan sekadar pelengkap, melainkan elemen esensial yang memungkinkan jaringan saraf menangkap dan memodelkan kompleksitas yang melekat pada data dunia nyata. Dari ReLU yang sederhana namun efektif hingga interpretasi probabilistik yang disediakan oleh fungsi softmax, setiap fungsi aktivasi memiliki tempat dan tujuannya di berbagai lapisan jaringan dan lintas beragam domain masalah.
Seiring jaringan saraf terus berkembang, eksplorasi fungsi aktivasi pasti akan meluas, mungkin mencakup bentuk-bentuk baru yang menangani tantangan spesifik dari arsitektur yang muncul. Namun, prinsip dan fungsi yang dibahas dalam blog ini kemungkinan akan tetap menjadi inti dari perancangan jaringan saraf untuk masa mendatang.
Pemilihan fungsi aktivasi yang cermat adalah tindakan menyeimbangkan—perpaduan antara pemahaman ilmiah dan intuisi terasah—yang dapat berdampak signifikan pada kinerja jaringan saraf.
Tertarik mempelajari deep learning dengan kerangka kerja Keras? Lihat kursus kami Introduction to Deep Learning with Keras.




Representasi Jaringan Saraf. Sumber Gambar
Apa Itu Fungsi Aktivasi?
Fungsi aktivasi adalah blok bangunan integral dari jaringan saraf yang memungkinkannya mempelajari pola kompleks dalam data. Fungsi ini mengubah sinyal masukan sebuah node di jaringan saraf menjadi sinyal keluaran yang kemudian diteruskan ke lapisan berikutnya. Tanpa fungsi aktivasi, jaringan saraf akan terbatas pada pemodelan hubungan linear antara masukan dan keluaran.
Fungsi aktivasi memperkenalkan non-linearitas, sehingga jaringan saraf dapat mempelajari pemetaan yang sangat kompleks antara masukan dan keluaran.
Memilih fungsi aktivasi yang tepat sangat penting untuk melatih jaringan saraf yang mampu melakukan generalisasi dengan baik dan memberikan prediksi akurat. Dalam artikel ini, kami akan memberikan gambaran umum tentang fungsi aktivasi paling umum, perannya, dan cara memilih fungsi aktivasi yang sesuai untuk berbagai kasus penggunaan.
Baik Anda baru memulai di bidang deep learning maupun sudah berpengalaman, memahami fungsi aktivasi secara mendalam akan membangun intuisi Anda dan meningkatkan penerapan jaringan saraf.
Mengapa Fungsi Aktivasi Esensial?
Tanpa fungsi aktivasi, jaringan saraf hanya akan terdiri dari operasi linear seperti perkalian matriks. Semua lapisan akan melakukan transformasi linear atas masukan, dan tidak ada non-linearitas yang diperkenalkan.
Sebagian besar data dunia nyata bersifat non-linear. Misalnya, hubungan antara harga rumah dan ukuran, pendapatan dan pembelian, dan sebagainya, adalah non-linear. Jika jaringan saraf tidak memiliki fungsi aktivasi, jaringan akan gagal mempelajari pola non-linear kompleks yang ada pada data dunia nyata.
Fungsi aktivasi memungkinkan jaringan saraf mempelajari hubungan non-linear ini dengan memperkenalkan perilaku non-linear melalui fungsi aktivasi. Hal ini sangat meningkatkan fleksibilitas dan kemampuan jaringan saraf untuk memodelkan data yang kompleks dan bernuansa.
Jenis-Jenis Fungsi Aktivasi
Jaringan saraf memanfaatkan berbagai jenis fungsi aktivasi untuk memperkenalkan non-linearitas dan memungkinkan pembelajaran pola yang kompleks. Setiap fungsi aktivasi memiliki karakteristik unik dan cocok untuk kasus penggunaan tertentu.
Sebagai contoh, fungsi sigmoid ideal untuk masalah klasifikasi biner, softmax berguna untuk prediksi multi-kelas, dan ReLU membantu mengatasi masalah vanishing gradient.
Menggunakan fungsi aktivasi yang tepat untuk tugasnya menghasilkan pelatihan yang lebih cepat dan kinerja yang lebih baik.
Mari kita lihat beberapa fungsi aktivasi yang umum:
Aktivasi linear
Fungsi aktivasi linear. Gambar oleh Penulis
Fungsi aktivasi linear adalah fungsi aktivasi paling sederhana, didefinisikan sebagai:
Fungsi ini hanya mengembalikan masukan x sebagai keluaran. Secara grafis, terlihat seperti garis lurus dengan kemiringan 1.
Kasus penggunaan utama fungsi aktivasi linear adalah pada lapisan keluaran jaringan saraf untuk regresi. Untuk masalah regresi di mana kita ingin memprediksi nilai numerik, menggunakan fungsi aktivasi linear pada lapisan keluaran memastikan jaringan saraf menghasilkan nilai numerik. Fungsi aktivasi linear tidak mengompresi atau mentransformasi keluaran, sehingga nilai prediksi aktual dikembalikan.
Namun, fungsi aktivasi linear jarang digunakan di lapisan tersembunyi jaringan saraf. Ini karena tidak memberikan non-linearitas apa pun. Tujuan utama lapisan tersembunyi adalah mempelajari kombinasi non-linear dari fitur masukan. Menggunakan aktivasi linear di seluruh jaringan akan membatasi model untuk hanya mempelajari transformasi linear dari masukan.
Aktivasi sigmoid
Fungsi aktivasi sigmoid. Gambar oleh Penulis
Fungsi aktivasi sigmoid, sering dilambangkan sebagai σ(x), adalah fungsi yang halus dan terdiferensiasi secara kontinu yang secara historis penting dalam perkembangan jaringan saraf. Fungsi aktivasi sigmoid memiliki bentuk matematis:
Fungsi ini menerima masukan bernilai real dan mengompresinya ke nilai antara 0 dan 1. Kurva sigmoid berbentuk "S" yang mendekati 0 untuk bilangan negatif besar dan 1 untuk bilangan positif besar. Keluaran mudah ditafsirkan sebagai probabilitas, yang membuatnya alami untuk masalah klasifikasi biner.
Unit sigmoid populer pada jaringan saraf awal karena gradien paling kuat ketika keluaran unit mendekati 0,5, memungkinkan pelatihan backpropagation yang efisien. Namun, unit sigmoid mengalami masalah "vanishing gradient" yang menghambat pembelajaran pada jaringan saraf yang dalam.
Saat nilai masukan menjadi sangat positif atau negatif, fungsi menjadi jenuh pada 0 atau 1, dengan kemiringan yang sangat datar. Di wilayah ini, gradien sangat mendekati nol. Ini menghasilkan perubahan bobot yang sangat kecil selama backpropagation, khususnya untuk neuron di lapisan awal jaringan yang dalam, yang membuat pembelajaran sangat lambat atau bahkan terhenti. Ini disebut masalah vanishing gradient pada jaringan saraf.
Kasus penggunaan utama fungsi sigmoid adalah sebagai aktivasi untuk lapisan keluaran model klasifikasi biner. Fungsi ini mengompresi keluaran menjadi nilai probabilitas antara 0 dan 1, yang dapat ditafsirkan sebagai probabilitas masukan termasuk dalam kelas tertentu.
Aktivasi tanh (tangen hiperbolik)
Fungsi aktivasi tanh. Gambar oleh Penulis
Fungsi aktivasi tanh (tangen hiperbolik) didefinisikan sebagai:
Fungsi tanh menghasilkan nilai dalam rentang -1 hingga +1. Ini berarti dapat menangani nilai negatif lebih efektif dibandingkan fungsi sigmoid, yang rentangnya 0 hingga 1.
Tidak seperti fungsi sigmoid, tanh berpusat di nol, yang berarti keluarannya simetris terhadap titik asal sistem koordinat. Ini sering dianggap sebagai keuntungan karena dapat membantu algoritma pembelajaran berkonsvergensi lebih cepat.
Karena keluaran tanh berada di antara -1 dan +1, gradiennya lebih kuat daripada fungsi sigmoid. Gradien yang lebih kuat sering kali menghasilkan pembelajaran dan konvergensi yang lebih cepat selama pelatihan karena cenderung lebih tahan terhadap masalah vanishing gradient dibandingkan gradien fungsi sigmoid.
Terlepas dari keunggulan ini, fungsi tanh tetap mengalami masalah vanishing gradient. Selama backpropagation, gradien fungsi tanh dapat menjadi sangat kecil (mendekati nol). Masalah ini sangat mengganggu untuk jaringan dalam dengan banyak lapisan; gradien fungsi rugi dapat menjadi terlalu kecil untuk membuat perubahan bobot yang signifikan selama pelatihan saat merambat kembali ke lapisan awal. Ini dapat memperlambat proses pelatihan secara drastis dan menyebabkan sifat konvergensi yang buruk.
Fungsi tanh sering digunakan pada lapisan tersembunyi jaringan saraf. Karena sifatnya yang berpusat di nol, ketika data juga dinormalisasi agar memiliki mean nol, hal ini dapat menghasilkan pelatihan yang lebih efisien.
Jika harus memilih antara sigmoid dan tanh tanpa alasan khusus untuk memihak salah satunya, tanh sering menjadi pilihan yang lebih baik karena alasan yang disebutkan di atas. Namun, keputusan juga dapat dipengaruhi oleh kasus penggunaan spesifik dan perilaku jaringan selama eksperimen pelatihan awal.
Anda dapat membangun Jaringan Saraf Sederhana dari nol menggunakan PyTorch dengan mengikuti tutorial kami oleh Kurtis Pykes, atau, jika Anda pengguna tingkat lanjut, kursus Deep Learning with PyTorch kami cocok untuk Anda. .
Aktivasi ReLU (rectified linear unit)
Fungsi aktivasi Rectified Linear Unit (ReLU). Gambar oleh Penulis
Fungsi aktivasi Rectified Linear Unit (ReLU) memiliki bentuk:
Fungsi ini memberi ambang pada masukan di nol, mengembalikan 0 untuk nilai negatif dan masukan itu sendiri untuk nilai positif.
Untuk masukan lebih besar dari 0, ReLU bertindak sebagai fungsi linear dengan gradien 1. Ini berarti tidak mengubah skala masukan positif dan memungkinkan gradien melewati tanpa berubah selama backpropagation. Properti ini penting untuk mengurangi masalah vanishing gradient.
Meskipun ReLU linear untuk setengah ruang masukannya, secara teknis ia adalah fungsi non-linear karena memiliki titik yang tidak terdiferensiasi pada x=0, tempat ia berubah secara tiba-tiba dari x. Non-linearitas ini memungkinkan jaringan saraf mempelajari pola yang kompleks.
Karena ReLU menghasilkan nol untuk semua masukan negatif, fungsi ini secara alami mengarah pada aktivasi yang jarang; pada suatu waktu, hanya sebagian neuron yang aktif, sehingga komputasi lebih efisien.
Fungsi ReLU secara komputasional murah karena hanya melibatkan pengambangan sederhana di nol. Ini memungkinkan jaringan ditingkatkan ke banyak lapisan tanpa peningkatan beban komputasi yang signifikan, dibandingkan dengan fungsi yang lebih kompleks seperti tanh atau sigmoid.
Aktivasi softmax
Fungsi aktivasi softmax. Gambar oleh Penulis
Fungsi aktivasi softmax, juga dikenal sebagai fungsi eksponensial ternormalisasi, sangat berguna dalam konteks masalah klasifikasi multi-kelas. Fungsi ini bekerja pada sebuah vektor, sering disebut logits, yang merepresentasikan prediksi mentah atau skor untuk setiap kelas yang dihitung oleh lapisan sebelumnya dari jaringan saraf.
Untuk vektor masukan x dengan elemen x1, x2, ..., xC, fungsi softmax didefinisikan sebagai:
Keluaran fungsi softmax adalah distribusi probabilitas yang jumlahnya mencapai satu. Setiap elemen keluaran mewakili probabilitas bahwa masukan termasuk dalam kelas tertentu.
Penggunaan fungsi eksponensial memastikan semua nilai keluaran tidak negatif. Ini krusial karena probabilitas tidak boleh negatif.
Softmax memperkuat perbedaan dalam vektor masukan. Bahkan perbedaan kecil pada nilai masukan dapat menyebabkan perbedaan besar pada probabilitas keluaran, dengan nilai masukan tertinggi cenderung mendominasi dalam distribusi probabilitas yang dihasilkan.
Softmax biasanya digunakan pada lapisan keluaran jaringan saraf ketika tugasnya melibatkan pengklasifikasian masukan ke dalam salah satu dari beberapa (lebih dari dua) kategori yang mungkin (klasifikasi multi-kelas).
Probabilitas yang dihasilkan oleh fungsi softmax dapat ditafsirkan sebagai skor keyakinan untuk setiap kelas, memberikan wawasan tentang tingkat kepastian model terhadap prediksinya.
Karena softmax memperkuat perbedaan, fungsi ini dapat sensitif terhadap pencilan atau nilai ekstrem. Misalnya, jika vektor masukan memiliki nilai yang sangat besar, softmax dapat "mengompresi" probabilitas kelas lain, sehingga menghasilkan model yang terlalu percaya diri.
Memilih Fungsi Aktivasi yang Tepat
Pilihan fungsi aktivasi bergantung pada jenis masalah yang ingin Anda selesaikan. Berikut beberapa panduan:
Untuk klasifikasi biner
Gunakan fungsi aktivasi sigmoid pada lapisan keluaran. Fungsi ini akan mengompresi keluaran antara 0 dan 1, merepresentasikan probabilitas untuk dua kelas.
Untuk klasifikasi multi-kelas
Gunakan fungsi aktivasi softmax pada lapisan keluaran. Fungsi ini akan menghasilkan distribusi probabilitas atas semua kelas.
Jika belum yakin
Gunakan fungsi aktivasi ReLU pada lapisan tersembunyi. ReLU adalah fungsi aktivasi default yang paling umum dan biasanya merupakan pilihan yang baik.
Kesimpulan
Kita telah menelaah peran penting yang dimainkan fungsi aktivasi dalam pelatihan jaringan saraf. Kita telah melihat bahwa fungsi ini bukan sekadar pelengkap, melainkan elemen esensial yang memungkinkan jaringan saraf menangkap dan memodelkan kompleksitas yang melekat pada data dunia nyata. Dari ReLU yang sederhana namun efektif hingga interpretasi probabilistik yang disediakan oleh fungsi softmax, setiap fungsi aktivasi memiliki tempat dan tujuannya di berbagai lapisan jaringan dan lintas beragam domain masalah.
Seiring jaringan saraf terus berkembang, eksplorasi fungsi aktivasi pasti akan meluas, mungkin mencakup bentuk-bentuk baru yang menangani tantangan spesifik dari arsitektur yang muncul. Namun, prinsip dan fungsi yang dibahas dalam blog ini kemungkinan akan tetap menjadi inti dari perancangan jaringan saraf untuk masa mendatang.
Pemilihan fungsi aktivasi yang cermat adalah tindakan menyeimbangkan—perpaduan antara pemahaman ilmiah dan intuisi terasah—yang dapat berdampak signifikan pada kinerja jaringan saraf.
Tertarik mempelajari deep learning dengan kerangka kerja Keras? Lihat kursus kami Introduction to Deep Learning with Keras.