Backpropagation adalah bagian penting dari pelatihan jaringan saraf modern, yang memungkinkan algoritme canggih ini belajar dari dataset pelatihan dan membaik seiring waktu.
Memahami dan menguasai algoritme backpropagation sangat penting bagi siapa pun di bidang jaringan saraf dan pembelajaran mendalam. Tutorial ini memberikan penjelasan mendalam tentang backpropagation.
Dimulai dengan menjelaskan apa itu backpropagation dan bagaimana cara kerjanya, beserta kelebihan dan keterbatasannya, sebelum berlanjut ke pengalaman praktis menerapkannya pada dataset yang banyak digunakan.
Apa itu backpropagation?
Diperkenalkan pada tahun 1970-an, algoritme backpropagation adalah metode untuk menyetel bobot jaringan saraf secara halus sehubungan dengan tingkat galat yang diperoleh pada iterasi atau epoch sebelumnya, dan ini merupakan metode standar untuk melatih jaringan saraf tiruan.
Anda dapat menganggapnya sebagai sistem umpan balik di mana, setelah setiap putaran pelatihan atau 'epoch', jaringan meninjau kinerjanya pada tugas. Jaringan menghitung selisih antara keluarannya dan jawaban yang benar, yang disebut galat. Lalu, jaringan menyesuaikan parameter internalnya, atau 'bobot', untuk mengurangi galat ini pada kesempatan berikutnya. Metode ini penting untuk menyetel ketepatan jaringan saraf dan merupakan strategi dasar dalam belajar membuat prediksi atau keputusan yang lebih baik
Bagaimana Cara Kerja Backpropagation?
Sekarang setelah Anda tahu apa itu backpropagation, mari kita telusuri cara kerjanya. Di bawah ini adalah ilustrasi algoritme backpropagation yang diterapkan pada jaringan saraf dengan:
- Dua masukan X1 dan X2
- Dua lapisan tersembunyi N1X dan N2X, di mana X bernilai 1, 2, dan 3
- Satu lapisan keluaran
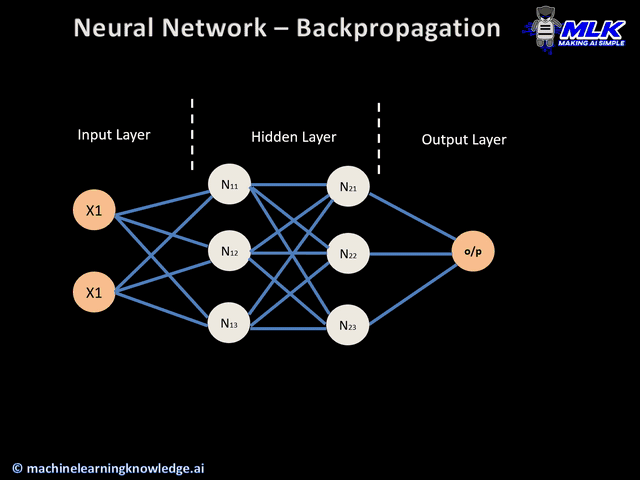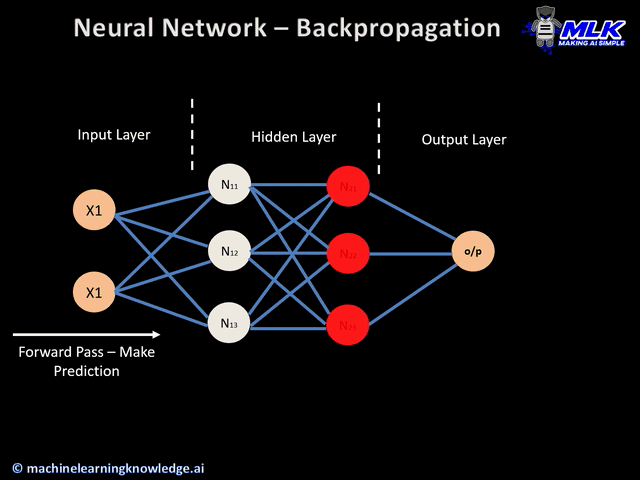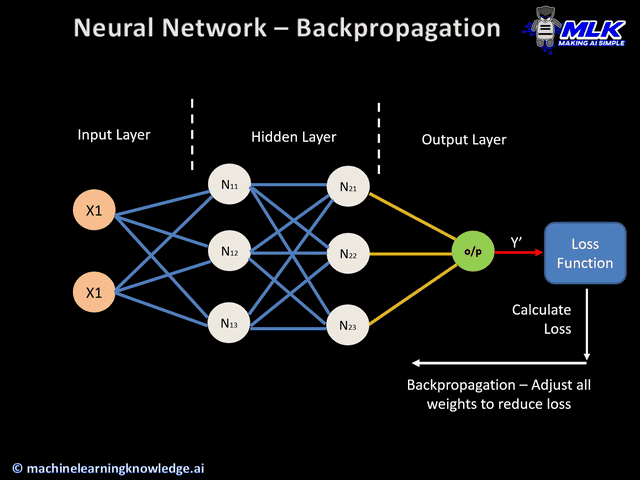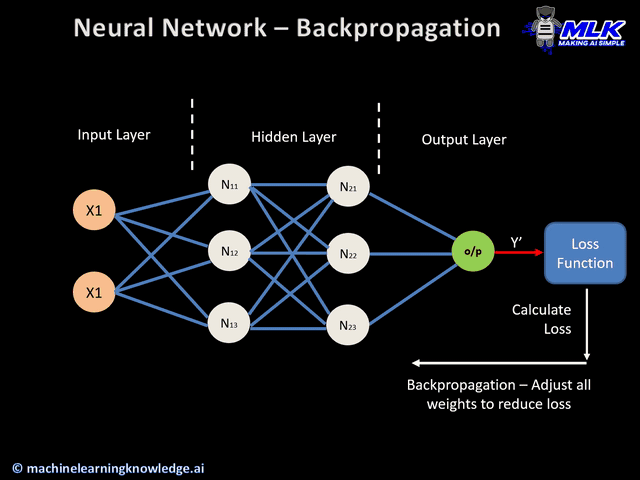
Ilustrasi backpropagation (sumber: machinelearningknowledge)
Secara keseluruhan ada empat langkah utama dalam algoritme backpropagation:
- Forward pass
- Perhitungan galat
- Backward pass
- Pembaruan bobot
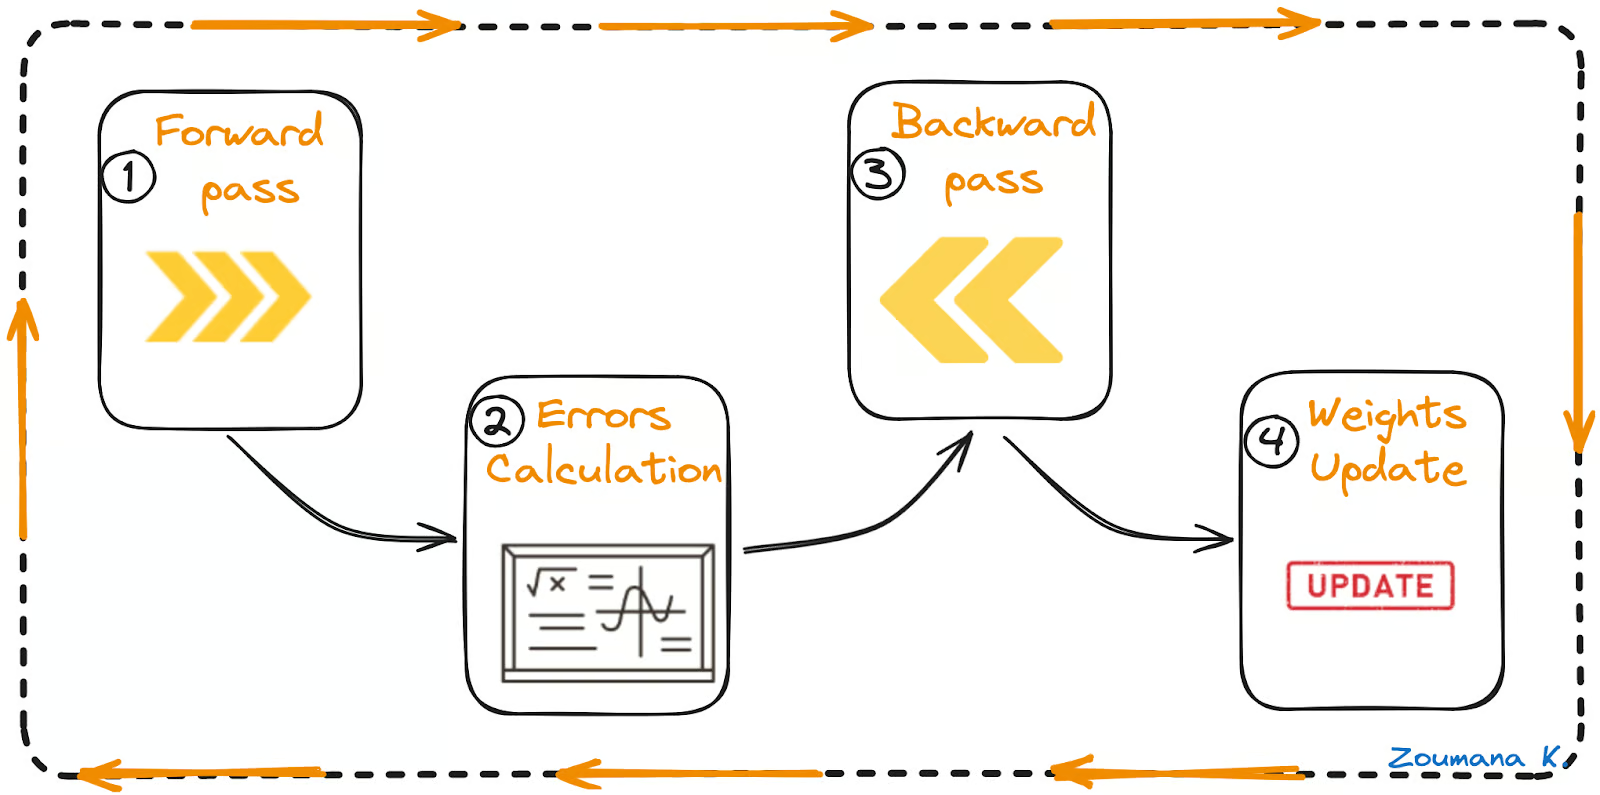
Forward pass, perhitungan galat, backward pass, dan pembaruan bobot
Mari pahami masing-masing langkah dari animasi di atas.
Forward pass
Ini adalah langkah pertama dari proses backpropagation, dan digambarkan sebagai berikut:
- Data (masukan X1 dan X2) diberikan ke lapisan input
- Kemudian, setiap masukan dikalikan dengan bobot masing-masing, dan hasilnya diteruskan ke neuron N1X dan N2X pada lapisan tersembunyi.
- Neuron-neuron tersebut menerapkan fungsi aktivasi pada masukan berbobot yang mereka terima, dan hasilnya diteruskan ke lapisan berikutnya.
Perhitungan galat
- Proses berlanjut hingga lapisan keluaran menghasilkan keluaran akhir (o/p).
- Keluaran jaringan kemudian dibandingkan dengan ground truth (keluaran yang diinginkan), dan selisihnya dihitung sehingga menghasilkan nilai galat.
Backward pass
Ini adalah langkah backpropagation yang sesungguhnya, dan tidak dapat dilakukan tanpa langkah forward dan perhitungan galat di atas. Berikut cara kerjanya:
- Nilai galat yang diperoleh sebelumnya digunakan untuk menghitung gradien fungsi loss.
- Gradien galat dipropagasikan kembali melalui jaringan, mulai dari lapisan keluaran ke lapisan tersembunyi.
- Saat gradien galat dipropagasikan kembali, bobot (digambarkan oleh garis yang menghubungkan node) diperbarui sesuai kontribusinya terhadap galat. Ini melibatkan pengambilan turunan galat terhadap setiap bobot, yang menunjukkan seberapa besar perubahan pada bobot akan mengubah galat.
- Laju pembelajaran (learning rate) menentukan besarnya pembaruan bobot. Laju pembelajaran yang lebih kecil berarti bobot diperbarui dalam jumlah yang lebih kecil, dan sebaliknya.
Pembaruan bobot
- Bobot diperbarui ke arah yang berlawanan dengan gradien, sehingga dinamakan “penurunan gradien” (gradient descent). Tujuannya adalah mengurangi galat pada forward pass berikutnya.
- Proses forward pass, perhitungan galat, backward pass, dan pembaruan bobot ini berlanjut selama beberapa epoch hingga kinerja jaringan mencapai tingkat yang memadai atau berhenti meningkat secara signifikan.
Kelebihan Backpropagation
Backpropagation adalah teknik dasar dalam pelatihan jaringan saraf, yang banyak diapresiasi karena penerapannya yang lugas, kemudahan pemrograman, dan aplikasi yang serbaguna di berbagai arsitektur jaringan.
Tutorial Membangun Model Neural Network (NN) di R kami adalah titik awal yang bagus bagi siapa pun yang ingin mempelajari jaringan saraf. Tutorial ini mengajarkan cara membuat model jaringan saraf di R.
Untuk pemrogram Python, tutorial Recurrent Neural Network (RNN) menyediakan panduan komprehensif tentang model deep learning populer RNN dengan pengalaman praktis membangun prediktor harga saham MasterCard.
Sekarang, mari kita uraikan masing-masing manfaat yang disebutkan sebelumnya:
- Mudah diimplementasikan: dapat diakses melalui berbagai pustaka deep learning seperti Pytorch dan Keras, sehingga memudahkan penggunaannya di beragam aplikasi.
- Kesederhanaan pemrograman: pengodean yang dipermudah dengan abstraksi framework, mengurangi kebutuhan matematika yang kompleks.
- Fleksibel: dapat beradaptasi dengan beragam arsitektur, cocok untuk spektrum tantangan AI yang luas.
Keterbatasan dan Tantangan
Terlepas dari keberhasilan algoritme backpropagation, algoritme ini tidak luput dari keterbatasan yang dapat memengaruhi efisiensi dan efektivitas proses pelatihan jaringan saraf. Mari kita telusuri beberapa kendalanya:
- Kualitas data: kualitas data yang buruk, termasuk derau, ketidaklengkapan, atau bias, dapat menghasilkan model yang tidak akurat, karena backpropagation belajar persis dari apa yang diberikan.
- Durasi pelatihan: backpropagation sering memerlukan waktu pelatihan yang panjang, yang bisa jadi tidak praktis saat menangani jaringan besar.
- Kompleksitas berbasis matriks: operasi matriks pada backpropagation meningkat seiring ukuran jaringan, yang meningkatkan kebutuhan komputasi dan berpotensi melampaui sumber daya yang tersedia.
Mengimplementasikan Backpropagation
Dengan semua wawasan tentang algoritme backpropagation ini, saatnya mendalami penerapannya pada skenario dunia nyata dengan mengimplementasikan jaringan saraf untuk mengenali digit tulisan tangan dari dataset MNIST.
Bagian ini mencakup semua langkah, dari visualisasi data hingga pelatihan dan evaluasi model. Kode sumber lengkap tersedia di buku kerja DataLab ini; Anda dapat dengan mudah membuat salinan buku kerja sendiri untuk menjalankan kode di browser, tanpa menginstal apa pun di komputer Anda.
Tentang dataset
Dataset MNIST banyak digunakan di bidang pengenalan gambar. Dataset ini terdiri dari 70000 gambar skala abu-abu berisi digit tulisan tangan dari 0 hingga 9, dan setiap gambar berukuran 28x28 piksel.
Dataset tersedia dalam fungsi mnist dari modul Keras.datasets, dan dimuat sebagai berikut setelah mengimpor pustaka mnist:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Analisis data eksploratif
Analisis data eksploratif adalah langkah utama sebelum membangun model machine learning atau deep learning apa pun karena membantu memahami sifat data yang ada, sehingga memandu pemilihan jenis model yang akan digunakan.
Tugas utamanya meliputi:
- Mengidentifikasi jumlah total data pada dataset pelatihan dan pengujian.
- Visualisasi acak beberapa digit dari dataset pelatihan.
- Memvisualisasikan distribusi label dari dataset pelatihan.
Secara keseluruhan dataset terdiri dari 70000 gambar. Pemisahan tipikal dari dataset asli diberikan sebagai berikut, dan tidak ada aturan baku untuk hal ini:
- 70% atau 80% untuk dataset pelatihan
- 30% atau 20% untuk dataset pengujian
Beberapa pemisahan bahkan bisa 90% untuk pelatihan dan 10% untuk pengujian.
Dalam skenario kami, dataset pelatihan dan pengujian keduanya dimuat, jadi tidak perlu pemisahan. Mari amati ukuran dataset tersebut.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")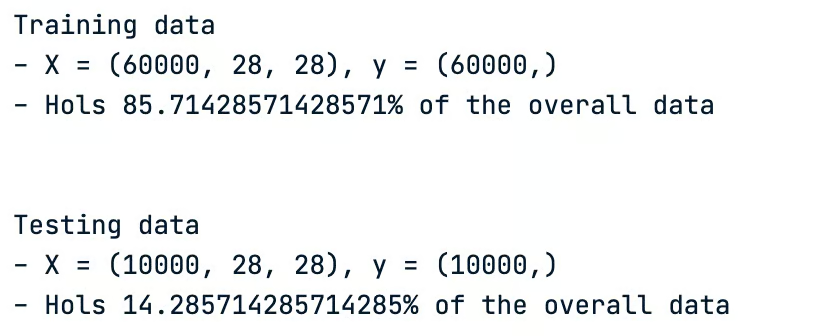
Karakteristik dataset pelatihan dan pengujian
- Dataset pelatihan memiliki 60000 gambar dan setara dengan 85,71% dari dataset asli.
- Dataset pengujian, di sisi lain, memiliki sisa 10000 gambar, yaitu 14,28% dari dataset asli.
Sekarang, mari visualisasikan beberapa digit secara acak. Ini dilakukan dengan fungsi pembantu plot_images, yang menerima dua parameter utama:
- Jumlah gambar yang akan ditampilkan, dan
- Dataset yang akan digunakan untuk visualisasi
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Kita ingin menampilkan sembilan gambar dari data pelatihan, yang sesuai dengan potongan kode berikut:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Eksekusi kode di atas yang berhasil menghasilkan sembilan digit berikut.
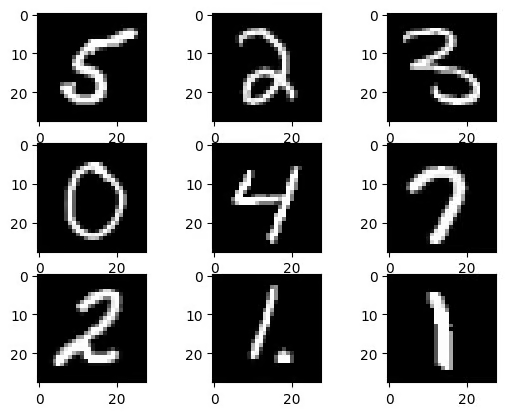
Sembilan gambar acak dari dataset pelatihan
Digit berikut ditampilkan setelah menjalankan fungsi yang sama untuk kedua kalinya, dan kita perhatikan bahwa digitnya tidak sama; ini karena sifat acak dari fungsi pembantu.
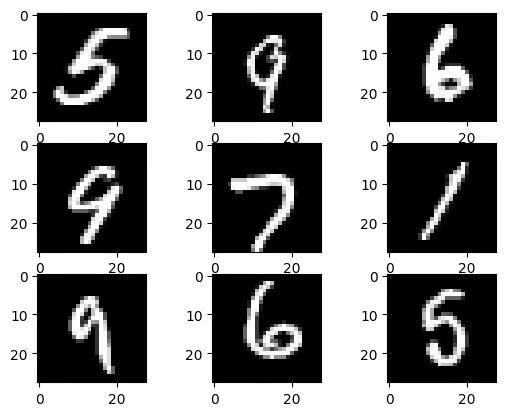
Sembilan gambar acak dari dataset pelatihan setelah fungsi dijalankan untuk kedua kalinya
Tugas terakhir untuk analisis data adalah memvisualisasikan distribusi label dari dataset pelatihan menggunakan fungsi pembantu plot_labels_distribution.
- Pada sumbu X, terdapat semua digit yang memungkinkan
- Pada sumbu Y, terdapat jumlah total masing-masing digit
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
Fungsi tersebut diterapkan pada dataset pelatihan dengan memberikan labelnya sebagai berikut:
plot_labels_distribution(train_labels)Hasilnya ada di bawah, dan kita perhatikan bahwa semua sepuluh digit hampir terdistribusi merata di seluruh dataset, yang merupakan kabar baik, artinya tidak diperlukan tindakan lebih lanjut untuk menyeimbangkan distribusi label.
Prapemrosesan data
Data dunia nyata biasanya memerlukan beberapa prapemrosesan agar sesuai untuk melatih model. Ada tiga tugas prapemrosesan utama yang diterapkan pada gambar pelatihan dan pengujian:
- Normalisasi gambar: mengonversi semua nilai piksel dari 0–255 menjadi 0–1. Ini relevan untuk konvergensi yang lebih cepat selama proses pelatihan
- Melakukan reshaping pada gambar: alih-alih memiliki matriks persegi 28 kali 28 untuk setiap gambar, kita meratakan masing-masing menjadi vektor 784 elemen agar sesuai untuk input jaringan saraf.
- Pengodean label: mengonversi label ke vektor one-hot encoded. Ini akan menghindari masalah yang mungkin muncul dengan hierarki numerik. Dengan cara ini, model tidak akan bias terhadap digit yang lebih besar.
Logika prapemrosesan keseluruhan diimplementasikan dalam fungsi pembantu preprocess_data di bawah ini:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
Fungsi tersebut diterapkan pada dataset menggunakan potongan kode berikut:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Sekarang, mari amati nilai piksel maksimum dan minimum saat ini dari kedua dataset:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Hasil kode ditunjukkan di bawah, dan kita perhatikan bahwa normalisasi berhasil dilakukan.
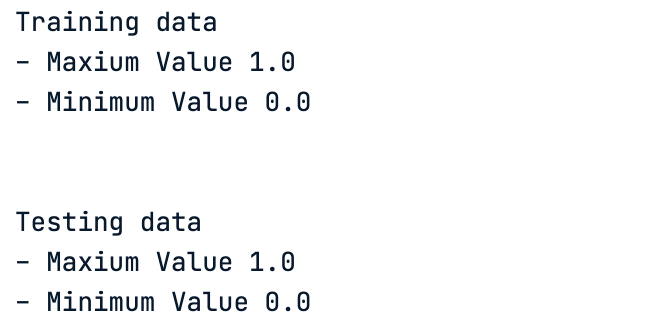
Nilai piksel minimum dan maksimum setelah normalisasi
Serupa dengan label, akhirnya kita memiliki matriks berisi angka satu dan nol, yang sesuai dengan nilai one-hot encoded dari label tersebut.
# One hot encoding of the test data labels
test_images
Hasil di bawah:
One hot encoding dari label data uji
# One hot encoding of the train data labels
train_labels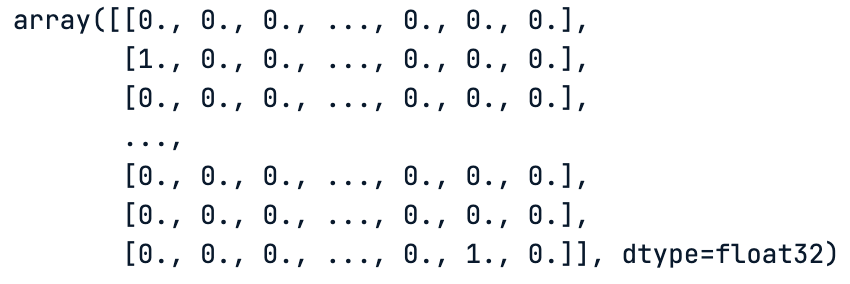
One hot encoding dari label data latih
Struktur jaringan
Karena kita menggunakan tugas klasifikasi gambar, convolutional neural network lebih sesuai untuk skenario seperti ini. Sebelum menulis kode apa pun, penting untuk menentukan arsitektur model, dan itulah inti bagian ini.
Untuk mempelajari lebih lanjut tentang convolutional neural network, tutorial Pengantar Convolutional Neural Networks (CNN) kami adalah sumber awal yang sangat baik. Ini adalah panduan lengkap untuk memahami CNN, dampaknya pada analisis gambar, dan beberapa strategi kunci untuk melawan overfitting guna aplikasi CNN vs deep learning yang tangguh.
Arsitektur untuk kasus penggunaan ini menggabungkan berbagai jenis lapisan untuk klasifikasi gambar yang efektif. Berikut adalah komponen kunci model:
- Lapisan Konvolusi: Mulai dengan lapisan yang menggunakan ukuran filter 3x3 kecil dan 32 filter untuk memroses gambar.
- Lapisan Max Pooling: Setelah lapisan konvolusi, sertakan lapisan max pooling untuk mengurangi ukuran peta fitur.
- Flattening: Ratakan keluaran dari lapisan pooling menjadi satu vektor, menyiapkannya untuk proses klasifikasi.
- Lapisan Dense: Tambahkan lapisan dense dengan 100 node antara keluaran yang telah diratakan dan lapisan akhir untuk menafsirkan fitur yang diekstrak.
- Lapisan Keluaran: Gunakan lapisan keluaran dengan 10 node, sesuai dengan 10 kategori gambar. Setiap node menghitung probabilitas suatu gambar termasuk dalam salah satu kategori ini.
- Aktivasi Softmax: Pada lapisan keluaran, terapkan fungsi aktivasi softmax untuk klasifikasi multikelas.
- Fungsi Aktivasi ReLU: Gunakan fungsi aktivasi ReLU (Rectified Linear Unit) di semua lapisan untuk pemrosesan nonlinier.
- Optimizer: Gunakan optimizer stochastic gradient descent dengan learning rate 0,001 dan momentum 0,95 untuk menyesuaikan model selama pelatihan.
- Fungsi Loss: Gunakan fungsi loss categorical cross-entropy, ideal untuk tugas klasifikasi multikelas.
- Metrik Akurasi: Fokus pada metrik akurasi klasifikasi, mengingat distribusi kelas yang seimbang.
Semua informasi ini diimplementasikan dalam fungsi pembantu define_network_architecture. Namun sebelum itu, kita perlu mengimpor semua pustaka yang diperlukan:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Berikut implementasi fungsi pembantu tersebut.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Implementasi kode sumbernya sudah baik, tetapi akan lebih baik lagi jika kita memiliki visualisasi grafis dari jaringan, dan ini dicapai menggunakan fungsi plot_model dari modul keras.utils.vis_utils.
Pertama, hasilkan jaringan dari fungsi pembantu.
network = define_network_architecture()Lalu, tampilkan representasi grafis. Kita terlebih dahulu menyimpan hasilnya ke file PNG sebelum menampilkannya; ini memudahkan untuk dibagikan kepada orang lain.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Hasilnya ditunjukkan di bawah.
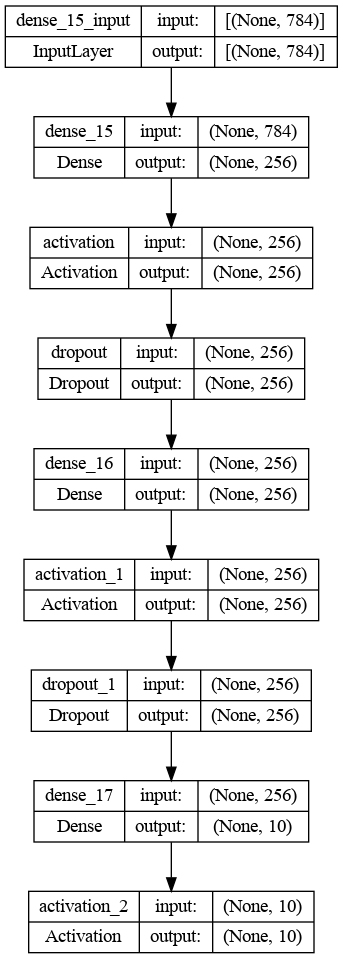
Arsitektur grafis convolutional neural network
Menghitung delta
Sebelum masuk ke proses pelatihan model, mari pahami bagaimana distribusi galat delta dihitung menggunakan arsitektur jaringan.
Distribusi galat delta adalah turunan dari fungsi loss terhadap fungsi aktivasi setiap node, dan menunjukkan seberapa besar kontribusi aktivasi setiap node terhadap galat akhir.
Arsitektur di atas terdiri dari tiga lapisan utama:
- Lapisan input berisi 784 unit yang sesuai dengan gambar input 28x28
- Lapisan tersembunyi berisi 512 unit dengan aktivasi ReLU
- Lapisan keluaran dengan 10 unit, yang sesuai dengan jumlah label unik dengan fungsi aktivasi softmax
Sekarang, mari lanjutkan perhitungan galat delta untuk setiap lapisan.
Lapisan keluaran
Anggap keluaran lapisan softmax sebagai O dan label sebenarnya sebagai Y. Dengan menggunakan loss cross-entropy δ output , galat delta menjadi:
δ output = O - Y
Rumus ini berasal dari perhitungan dasar tentang bagaimana loss cross-entropy berubah saat keluaran softmax berubah.
Lapisan tersembunyi
Untuk lapisan tersembunyi, galat delta menjadi δ hidden dan bergantung pada galat lapisan berikutnya, yaitu lapisan keluaran, serta turunan fungsi aktivasi ReLU.
Turunan ReLU bernilai 1 untuk masukan positif, dan 0 untuk masukan negatif, seperti terlihat di bawah.
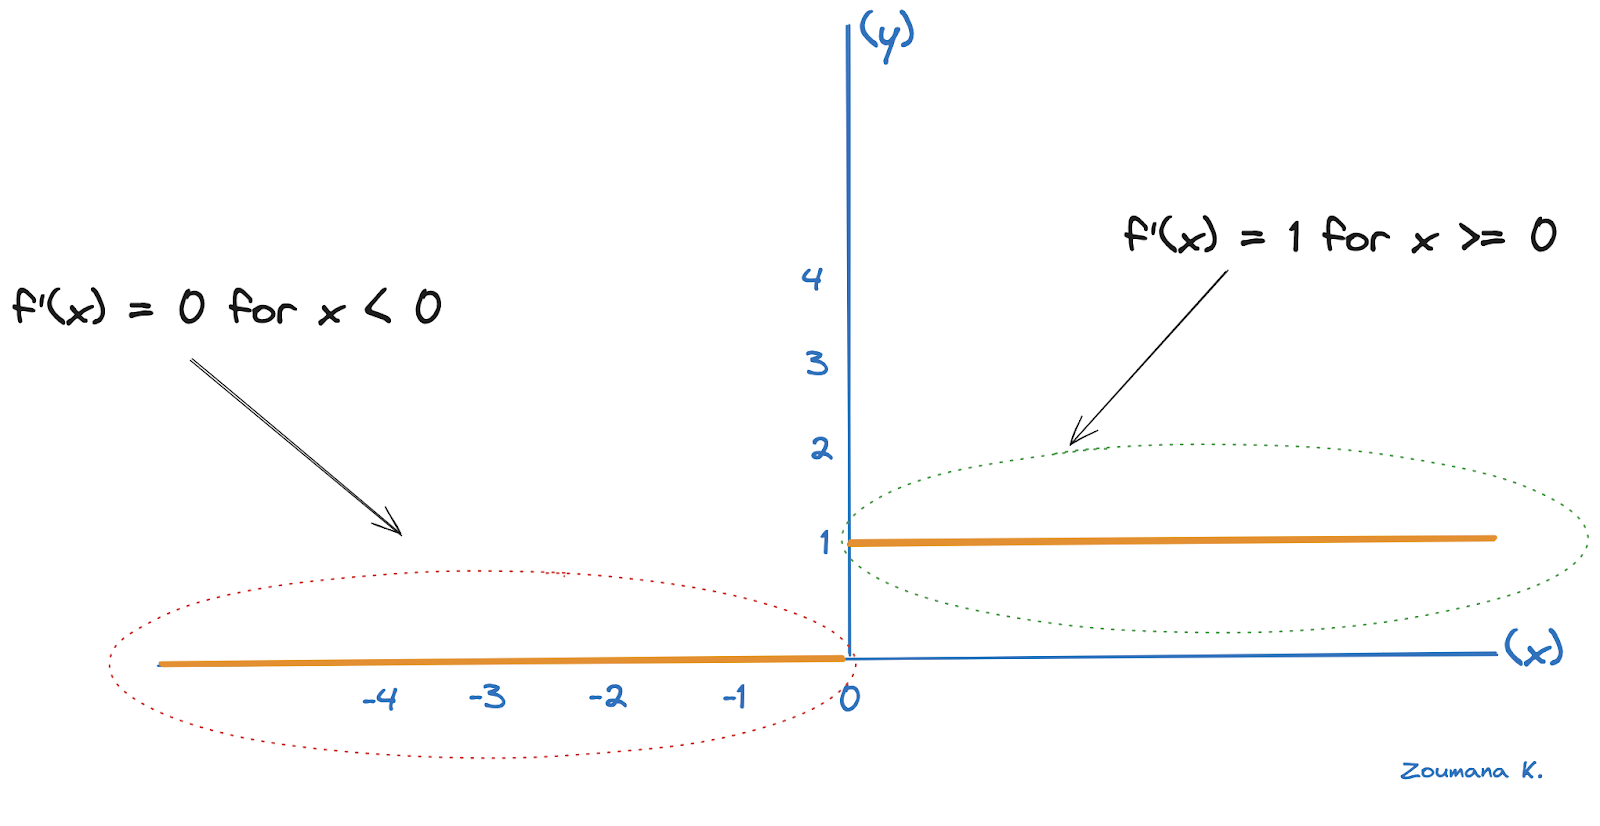
Ilustrasi turunan ReLU
Anggap Zhidden sebagai masukan ke fungsi ReLU pada lapisan tersembunyi dan Woutput sebagai bobot yang menghubungkan lapisan tersembunyi ke lapisan keluaran. Galat delta untuk lapisan tersembunyi, dalam kasus ini, menjadi:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- Tanda titik “.” menyatakan perkalian matriks
- Tanda ⊙ menyatakan perkalian elemen-per-elemen
- ReLU’(Zhidden) menyatakan turunan ReLU pada Zhidden
Lapisan input
Demikian pula, jika kita memiliki lebih banyak lapisan tersembunyi, proses akan terus berlanjut ke belakang dengan galat delta setiap lapisan bergantung pada galat delta lapisan berikutnya dan turunan fungsi aktivasinya.
Dalam skenario yang lebih umum, untuk setiap lapisan k pada jaringan (kecuali lapisan keluaran), rumus perhitungan galat delta adalah:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 menyatakan transpose matriks bobot dari lapisan berikutnya
- f’ adalah turunan fungsi aktivasi untuk lapisan k dan
- Zk adalah masukan ke fungsi aktivasi pada lapisan k
Kompilasi jaringan
Dengan pemahaman tentang perhitungan galat ini, mari kompilasi jaringan untuk mengoptimalkan strukturnya bagi proses pelatihan.
Selama kompilasi, kita perlu membuat beberapa pilihan penting:
- Pilihan Algoritme Optimasi: ini melibatkan pemilihan algoritme untuk optimasi penurunan gradien. Ada beberapa opsi, seperti Stochastic Gradient Descent (SGD), Adagrad, dan RMSprop, yang digunakan dalam artikel ini.
- Pemilihan Fungsi Loss: Fungsi loss, juga dikenal sebagai fungsi biaya, merupakan bagian penting dari pelatihan. Fungsi ini mengukur seberapa baik kinerja jaringan, dan pilihan fungsi loss harus selaras dengan sifat masalah klasifikasi atau regresi. Fokus dilakukan pada categorical cross entropy karena sifat masalah yang multikelas.
- Pilihan Metrik Kinerja: Walau mirip dengan fungsi loss, metrik kinerja terutama digunakan untuk mengevaluasi efektivitas model pada dataset uji, dan kami menggunakan akurasi
Kode untuk tiga pilihan di atas diberikan di bawah:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Pelatihan jaringan
Salah satu masalah terbesar dalam melatih model adalah overfitting, dan penting untuk memantau model selama proses pelatihan agar memiliki generalisasi yang lebih baik, dan salah satu caranya adalah konsep early stopping.
Logika lengkap digambarkan di bawah ini:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Model dilatih selama 15 epoch menggunakan ukuran batch 256, dan 20% data pelatihan digunakan untuk validasi model.
Setelah melatih model, riwayat kinerja pelatihan dan validasi diplot di bawah ini.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()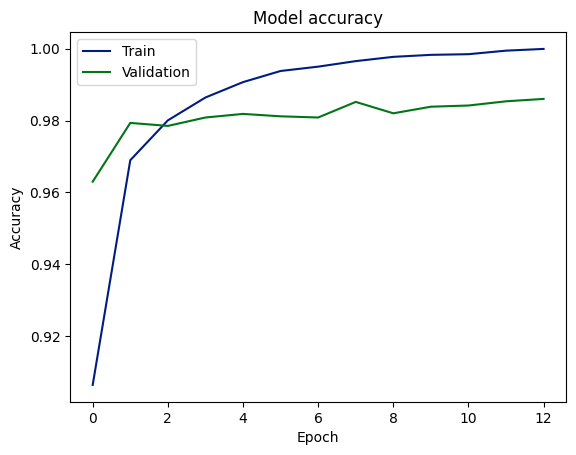
Skor akurasi pelatihan dan validasi
Evaluasi pada data uji
Sekarang, kita dapat mengevaluasi kinerja model pada data uji menggunakan fungsi evaluate dari model.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))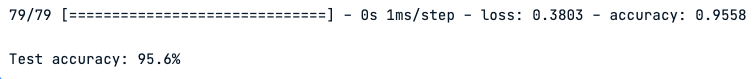
Kinerja model pada data uji
Grafik menunjukkan bahwa model telah belajar memprediksi keluaran dengan akurasi tinggi, mencapai sekitar 98% pada data validasi dan uji. Ini menyiratkan generalisasi yang baik dari pelatihan ke data yang belum terlihat. Namun, kesenjangan antara akurasi pelatihan dan validasi bisa menjadi tanda overfitting, meskipun konsistensi antara akurasi validasi dan uji dapat mengurangi kekhawatiran ini.
Rekomendasi
Meskipun model menunjukkan akurasi dan kemampuan generalisasi yang tinggi, masih ada ruang untuk perbaikan, dan di bawah ini beberapa langkah yang dapat ditindaklanjuti untuk semakin meningkatkan kinerja.
- Regularisasi: Integrasikan metode regularisasi untuk mengurangi overfitting.
- Early Stopping: Gunakan early stopping selama pelatihan untuk mencegah overfitting.
- Analisis Galat: Analisis prediksi yang keliru untuk mengidentifikasi dan memperbaiki masalah yang mendasarinya.
- Pengujian Keberagaman: Uji model pada dataset yang beragam untuk memastikan ketangguhannya.
- Metrik yang Lebih Luas: Gunakan precision, recall, dan F1-score untuk evaluasi kinerja yang lengkap, terutama jika data tidak seimbang.
Kesimpulan
Singkatnya, artikel ini telah memberikan penjelasan komprehensif tentang backpropagation, teknik penting di bidang machine learning. Kita mulai dengan definisi jelas tentang apa itu backpropagation dan menguraikan perannya yang krusial dalam kemajuan kecerdasan buatan.
Berikutnya, kita menelusuri cara kerja backpropagation beserta beberapa kelebihannya, seperti efisiensi pembelajaran yang meningkat, sekaligus mengakui keterbatasan dan tantangannya.
Lalu, artikel ini memberikan panduan terperinci tentang menyiapkan dan membangun jaringan saraf, menekankan pentingnya forward propagation.
Pada bagian penutup, kita membahas langkah-langkah menghitung delta dan memperbarui bobot jaringan, yang penting untuk menyempurnakan proses pembelajaran.
Secara keseluruhan, artikel ini menjadi sumber berharga bagi siapa pun yang ingin memahami dan secara efektif mengimplementasikan backpropagation pada jaringan saraf.
Ingin memperkuat keterampilan Anda dalam deep learning? Kursus Deep Learning with PyTorch kami akan membantu Anda memperoleh kepercayaan diri untuk menyelami jaringan saraf lebih dalam dan mengembangkan pengetahuan lebih jauh.




