Snowflake adalah platform data berbasis cloud yang mengatasi tantangan mendasar dalam pengelolaan data modern. Diluncurkan pada 2014, platform ini menyediakan solusi terpusat bagi organisasi untuk menyimpan dan memproses operasi data skala besar.
Sistem pengelolaan data tradisional sering kali menghadirkan keterbatasan signifikan bagi organisasi. Sistem ini biasanya mengharuskan perusahaan memilih antara kinerja kueri, akses pengguna bersamaan, dan efektivitas biaya. Arsitektur Snowflake dikembangkan untuk menghilangkan batasan-batasan ini melalui pendekatannya terhadap penyimpanan data dan komputasi.
Panduan ini mengulas kerangka arsitektur dan mekanisme operasional Snowflake. Meskipun platform ini menggabungkan teknologi yang kompleks, penjelasan ini akan berfokus pada penyampaian konsep-konsep tersebut agar mudah dipahami oleh pembaca dengan pemahaman dasar sistem data.
Panduan ini akan membahas:
- Prinsip-prinsip dasar sistem penyimpanan data Snowflake
- Komponen arsitektural yang membentuk infrastrukturnya
- Pendekatan platform terhadap akses data secara bersamaan
- Keunggulan teknis yang mendorong adopsinya
Analisis ini akan memberi Anda pemahaman mendasar tentang bagaimana Snowflake berfungsi dalam infrastruktur data modern.
Bagi pembaca yang baru mengenal Snowflake, Pengantar Snowflake untuk Pemula menyediakan pengetahuan latar yang esensial.
Konsep Inti Arsitektur Snowflake
Arsitektur Snowflake berbeda dari desain gudang data tradisional dengan menerapkan prinsip cloud modern untuk menyelesaikan tantangan skalabilitas dan kinerja. Arsitektur ini mengimplementasikan pendekatan multi-lapis yang memisahkan storage, compute, dan services ke dalam komponen terpisah namun saling terhubung.
Lapisan arsitektur Snowflake
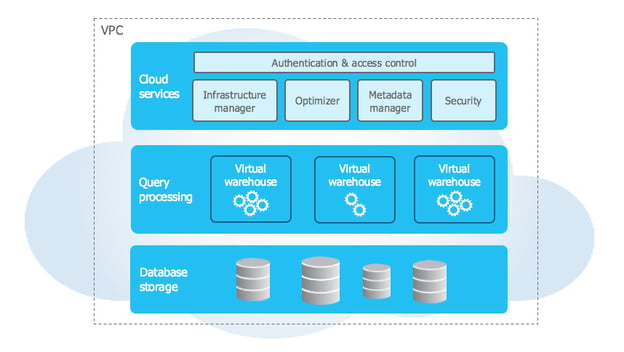
Sumber: dokumentasi Snowflake
Arsitektur Snowflake menggunakan desain tiga lapis yang unik untuk memisahkan fungsi inti sambil mempertahankan integrasi yang mulus. Mari kita bahas tiap lapisan secara rinci:
1. Lapisan storage
Lapisan storage Snowflake bergantung pada penyimpanan objek cloud (Amazon S3, Azure Blob Storage, atau Google Cloud Storage) dan mengorganisasi data menjadi micro-partition yang tidak dapat diubah (50–500MB) dalam format kolumnar terkompresi. Micro-partition ini menyimpan metadata seperti nilai minimum/maksimum kolom, sehingga memungkinkan pemangkasan kueri yang efisien.
Lapisan ini mengoptimalkan dirinya sendiri, tanpa memerlukan pemeliharaan manual. Ia secara cerdas memilih algoritma kompresi terbaik per kolom berdasarkan tipe dan pola data, memastikan rasio kompresi tinggi dan kueri analitis cepat dengan hanya membaca kolom yang diperlukan.
2. Lapisan compute
Lapisan compute terdiri dari virtual warehouse—klaster MPP independen yang mengeksekusi kueri SQL dan operasi DML. Setiap warehouse menjalankan banyak node secara paralel, beroperasi dalam isolasi penuh untuk mencegah saling memengaruhi kinerja.
Sumber daya tanpa status ini dapat dijalankan, dihentikan, diubah ukurannya, atau dikloning tanpa memengaruhi data. Pengubahan ukuran akan mendistribusikan ulang beban kerja secara otomatis, sementara fitur auto-suspension menjeda warehouse yang tidak aktif dan melanjutkannya dalam hitungan detik saat dibutuhkan.
3. Lapisan services
Lapisan services mengorkestrasi operasi Snowflake, mengelola penyimpanan metadata terdistribusi yang melacak tabel, view, kebijakan keamanan, dan kueri. Pengoptimal kueri memanfaatkan metadata ini untuk menghasilkan rencana eksekusi yang efisien berdasarkan distribusi data, sumber daya komputasi, dan pola akses.
Lapisan ini memastikan kepatuhan ACID dengan kontrol konkurensi tingkat lanjut sekaligus menangani autentikasi melalui SSO, MFA, dan kontrol akses berbasis peran di semua level. Lapisan ini juga mengelola penanganan sesi dan penegakan keamanan.
Cara kerja antar lapisan
Interaksi antar lapisan Snowflake memungkinkan kemampuan kuat seperti berbagi data yang aman, komputasi multi-klaster, dan skalabilitas dinamis. Berbagi data digerakkan oleh metadata—hanya pointer yang dipertukarkan, sementara akses dikendalikan dengan kebijakan keamanan berbutir halus. Konsumen dapat mengkueri data bersama menggunakan sumber daya komputasi mereka sendiri tanpa duplikasi.
Komputasi multi-klaster memungkinkan klaster komputasi independen mengakses lapisan storage yang sama sambil mempertahankan cache terpisah dan memastikan konsistensi. Beban kerja dapat diisolasi dengan mendedikasikan warehouse untuk ETL, BI, atau data science. Arsitektur Snowflake juga mendukung skalabilitas dinamis, memungkinkan storage dan compute diskalakan secara independen sementara lapisan services mengoptimalkan alokasi sumber daya dan kinerja kueri.
Untuk pendalaman lebih lanjut tentang konsep-konsep ini dan lainnya, Anda dapat menjelajahi kursus Introduction to Snowflake.
Arsitektur Data Warehouse Snowflake
Arsitektur gudang data Snowflake dibangun di atas desain tiga lapisnya untuk menyediakan pemodelan data yang fleksibel dan pemrosesan kueri yang efisien. Platform ini mendukung data terstruktur dan semi-terstruktur sambil mengoptimalkan kinerja dan menyederhanakan pengelolaan.
Model data
Snowflake mengakomodasi data terstruktur menggunakan konsep basis data relasional, mendukung tipe data SQL, constraint, dan relasi melalui primary key dan foreign key. Informasi sensitif mendapatkan manfaat dari enkripsi tingkat kolom. Untuk data semi-terstruktur, Snowflake secara native menangani JSON, XML, Parquet, dan Avro menggunakan tipe data VARIANT, secara otomatis menyimpulkan skema dan memungkinkan pengkuerian yang efisien dengan fungsi khusus seperti FLATTEN dan PARSE_JSON.
Pada level penyimpanan, data secara otomatis dibagi menjadi micro-partition berukuran 50–500MB, masing-masing menyimpan metadata seperti nilai minimum/maksimum kolom dan frekuensi null. Snowflake melacak pengelompokan alami dan secara berkala menata ulang data untuk meningkatkan efisiensi kueri, menghilangkan kebutuhan pengelolaan partisi manual.
Arsitektur pemrosesan kueri
Snowflake memproses kueri melalui beberapa lapisan terkoordinasi yang mengoptimalkan eksekusi. Pengoptimal kueri mengubah kueri SQL menjadi rencana eksekusi logis dan mengevaluasi beberapa rencana fisik berdasarkan ukuran tabel, pengindeksan, dan caching. Dengan model biaya, ia memilih pendekatan paling efisien, menentukan algoritma join, metode penyortiran, dan strategi pergerakan data.
Mesin eksekusi mendistribusikan kueri ke seluruh node pemrosesan paralel. Dengan memanfaatkan metadata, ia memangkas partisi yang tidak diperlukan dan hanya membaca kolom relevan dalam format penyimpanan kolumnar Snowflake, sehingga meningkatkan efisiensi. Cache hasil 24 jam semakin meningkatkan kinerja dengan menggunakan kembali hasil kueri yang telah dihitung sebelumnya ketika data dasar tidak berubah.
Arsitektur Snowflake memungkinkan pola akses data yang efisien. Zero-copy cloning memungkinkan duplikasi tabel seketika tanpa menyalin data, sementara time travel mempertahankan versi historis untuk kueri pada titik waktu tertentu. Multi-version concurrency control (MVCC) memastikan konsistensi transaksi, memungkinkan beban kerja berkonkurensi tinggi tanpa konflik penguncian. Optimalisasi ini, dikombinasikan dengan caching cerdas dan pemangkasan partisi, memungkinkan Snowflake menghadirkan analitik yang dapat diskalakan dan berkinerja tinggi dengan intervensi manual minimal.
Fitur Lanjutan Snowflake
Snowflake menawarkan fitur lanjutan di seluruh manajemen sumber daya, keamanan, integrasi, dan pemantauan untuk meningkatkan kapabilitas enterprise.
Manajemen sumber daya
Manajemen sumber dayanya yang dinamis mencakup penjadwalan warehouse dan auto-scaling, yang secara otomatis menjeda warehouse tidak aktif dan menyesuaikan sumber daya komputasi berdasarkan permintaan beban kerja. Administrator dapat mengatur jadwal mulai/berhenti otomatis dan memanfaatkan metrik sumber daya terperinci untuk mengoptimalkan biaya dan kinerja.
Tata kelola kueri
Fitur tata kelola kueri menyediakan kontrol presisi atas konsumsi sumber daya, termasuk batas dinamis, antrean cerdas, dan perutean kueri khusus, sehingga memastikan pengelolaan beban kerja yang efisien.
Integrasi Enterprise
Untuk integrasi enterprise, Snowflake mendukung stored procedure dalam JavaScript dan Java, memungkinkan pengembang menerapkan logika bisnis yang kompleks di luar SQL.
Kontrol versi memungkinkan rollback dengan mudah, sementara penanganan error memastikan eksekusi yang mulus dengan pencatatan mendetail. Kerangka kerja pertukaran data aman platform ini memungkinkan organisasi berbagi dan memonetisasi dataset melalui marketplace data privat.
Perusahaan dapat mengontrol akses, melacak penggunaan, dan menerapkan penagihan otomatis, menciptakan peluang pendapatan baru sambil mempertahankan kepatuhan dan keamanan.
Fitur-fitur ini secara kolektif memperkuat posisi Snowflake sebagai platform data yang komprehensif, menawarkan skalabilitas, otomasi, dan keamanan. Dengan manajemen beban kerja yang cerdas, integrasi tanpa hambatan, dan alat tata kelola yang tangguh, organisasi dapat mengoptimalkan kinerja, menurunkan biaya, dan berkolaborasi secara aman pada aset data.
Perbandingan Arsitektur
Mari bandingkan arsitektur Snowflake dengan gudang data tradisional dan kompetitor modern untuk memahami proposisi nilai uniknya.
Gudang data tradisional
Perbedaan arsitektural kunci:
- Sistem tradisional menggabungkan storage dan compute secara ketat
- Partisi data fisik memerlukan pemeliharaan manual
- Perencanaan kapasitas hardware diperlukan untuk beban puncak
- Kemampuan terbatas untuk menangani data semi-terstruktur
Perbandingan model biaya:
- Tradisional memerlukan investasi hardware di muka
- Kapasitas harus memperhitungkan pertumbuhan di masa depan
- Biaya pemeliharaan mencakup hardware dan fasilitas
- Biaya lisensi biasanya berbasis jumlah core prosesor
Karakteristik kinerja:
- Dibatasi oleh kendala hardware fisik
- Skalabilitas pengguna bersamaan memerlukan peningkatan hardware
- Kinerja kueri menurun seiring jumlah pengguna
- Perebutan sumber daya antar beban kerja
Kompetitor modern
1. Amazon Redshift
- Arsitektur: Berbasis klaster; operasi vacuum manual; menggunakan zone map
- Biaya: Harga per jam berbasis node; terbatas pada ekosistem AWS
2. Google BigQuery
- Arsitektur: Serverless dengan penetapan harga berbasis slot; caching kueri otomatis (retensi 24 jam)
- Biaya: Bayar per byte yang dipindai; kontrol compute terbatas
3. Azure Synapse
- Arsitektur: Hibrida (serverless & dedicated pool); manajemen sumber daya kompleks; mendukung rowstore dan columnstore
- Biaya: Penetapan harga berbasis DTU atau vCore; integrasi dengan layanan Azure
Pertimbangan kinerja tambahan:
1. Optimasi kueri
- BigQuery: Optimasi otomatis, kontrol pengguna terbatas
- Redshift: Operasi vacuum dan analyze manual
- Synapse: Memerlukan pembaruan statistik dan pengindeksan
2. Penanganan konkurensi
- BigQuery: Sistem alokasi slot
- Redshift: Manajemen beban kerja berbasis antrean
- Synapse: Penetapan kelas sumber daya
3. Arsitektur penyimpanan
- BigQuery: Penyimpanan kolumnar dengan sharding otomatis
- Redshift: Distribusi berbasis node dengan manajemen slice
- Synapse: Opsi rowstore dan columnstore
4. Variasi struktur biaya
- BigQuery: Bayar per byte yang dipindai
- Redshift: Harga per jam berbasis node
- Synapse: Penetapan harga berbasis DTU atau vCore
5. Kapabilitas integrasi
- BigQuery: Integrasi layanan GCP native
- Redshift: Integrasi ekosistem AWS
- Synapse: Layanan platform Azure
Perbedaan arsitektural ini berdampak pada:
- Kompleksitas operasional
- Manajemen sumber daya
- Prediktabilitas biaya
- Optimasi kinerja
- Integrasi ekosistem
Untuk pendekatan terstruktur dalam menguasai konsep-konsep ini, rujuk panduan pembelajaran Snowflake yang komprehensif.
Berikut tabel yang merangkum perbedaan ini:
| Aspek | BigQuery | Redshift | Synapse | Snowflake |
|---|
| Arsitektur | Serverless | Berbasis klaster | Hibrida (serverless & dedicated) | Multi-klaster, data bersama |
| Penyimpanan | Kolumnar dengan auto-sharding | Distribusi berbasis node | Rowstore & columnstore | Kolumnar micro-partitioned |
| Optimasi Kueri | Otomatis, kontrol terbatas | Vacuum/analyze manual | Pengindeksan & statistik manual | Optimasi otomatis |
| Konkurensi | Alokasi berbasis slot | WLM berbasis antrean | Kelas sumber daya | Penskalaan virtual warehouse |
| Model Harga | Per byte yang dipindai | Per jam berbasis node | Berbasis DTU/vCore | Penggunaan warehouse per detik |
| Integrasi | Layanan GCP native | Ekosistem AWS | Platform Azure | Dukungan multi-cloud |
| Manajemen Sumber Daya | Terotomatisasi | Manajemen node manual | Manajemen pool kompleks | Otomatis dengan kontrol manual |
| Dukungan Jenis Data | Semi-terstruktur kuat | Semi-terstruktur terbatas | Semi-terstruktur terbatas | Semi-terstruktur native |
| Pemeliharaan | Minimal | Vacuum rutin diperlukan | Perlu pemeliharaan indeks | Nol pemeliharaan |
| Caching | Otomatis 24 jam | Dikelola pengguna | Bawaan terbatas | Cache hasil otomatis |
Kesimpulan
Snowflake telah mengubah cara perusahaan bekerja dengan data di cloud dengan membuatnya lebih mudah dan lebih efisien dibandingkan sistem lama. Cara Snowflake dibangun memungkinkan perusahaan menyimpan dan memproses data secara terpisah, yang membantu menghemat biaya sekaligus tetap mendapatkan hasil yang cepat. Berkat fitur keamanan Snowflake yang kuat, perusahaan dapat merasa yakin bahwa data mereka aman. Sistem ini berjalan mulus di berbagai penyedia cloud, memberikan bisnis fleksibilitas lebih dalam menentukan lokasi penyimpanan data.
Bagi siapa pun yang ingin mempelajari lebih lanjut tentang Snowflake, tersedia banyak sumber daya dan materi pelatihan bermanfaat di DataCamp.
Platform ini terus berkembang dengan fitur-fitur baru seperti kapabilitas kecerdasan buatan yang membuatnya semakin kuat bagi bisnis. Perusahaan yang menggunakan Snowflake dapat beradaptasi cepat seiring kebutuhan data mereka berubah dari waktu ke waktu. Masa depan Snowflake terlihat cerah karena semakin banyak organisasi yang memilihnya sebagai platform utama untuk mengelola data.





Snowflake adalah platform data berbasis cloud yang mengatasi tantangan mendasar dalam pengelolaan data modern. Diluncurkan pada 2014, platform ini menyediakan solusi terpusat bagi organisasi untuk menyimpan dan memproses operasi data skala besar.
Sistem pengelolaan data tradisional sering kali menghadirkan keterbatasan signifikan bagi organisasi. Sistem ini biasanya mengharuskan perusahaan memilih antara kinerja kueri, akses pengguna bersamaan, dan efektivitas biaya. Arsitektur Snowflake dikembangkan untuk menghilangkan batasan-batasan ini melalui pendekatannya terhadap penyimpanan data dan komputasi.
Panduan ini mengulas kerangka arsitektur dan mekanisme operasional Snowflake. Meskipun platform ini menggabungkan teknologi yang kompleks, penjelasan ini akan berfokus pada penyampaian konsep-konsep tersebut agar mudah dipahami oleh pembaca dengan pemahaman dasar sistem data.
Panduan ini akan membahas:
Analisis ini akan memberi Anda pemahaman mendasar tentang bagaimana Snowflake berfungsi dalam infrastruktur data modern.
Bagi pembaca yang baru mengenal Snowflake, Pengantar Snowflake untuk Pemula menyediakan pengetahuan latar yang esensial.
Konsep Inti Arsitektur Snowflake
Arsitektur Snowflake berbeda dari desain gudang data tradisional dengan menerapkan prinsip cloud modern untuk menyelesaikan tantangan skalabilitas dan kinerja. Arsitektur ini mengimplementasikan pendekatan multi-lapis yang memisahkan storage, compute, dan services ke dalam komponen terpisah namun saling terhubung.
Lapisan arsitektur Snowflake
Sumber: dokumentasi Snowflake
Arsitektur Snowflake menggunakan desain tiga lapis yang unik untuk memisahkan fungsi inti sambil mempertahankan integrasi yang mulus. Mari kita bahas tiap lapisan secara rinci:
1. Lapisan storage
Lapisan storage Snowflake bergantung pada penyimpanan objek cloud (Amazon S3, Azure Blob Storage, atau Google Cloud Storage) dan mengorganisasi data menjadi micro-partition yang tidak dapat diubah (50–500MB) dalam format kolumnar terkompresi. Micro-partition ini menyimpan metadata seperti nilai minimum/maksimum kolom, sehingga memungkinkan pemangkasan kueri yang efisien.
Lapisan ini mengoptimalkan dirinya sendiri, tanpa memerlukan pemeliharaan manual. Ia secara cerdas memilih algoritma kompresi terbaik per kolom berdasarkan tipe dan pola data, memastikan rasio kompresi tinggi dan kueri analitis cepat dengan hanya membaca kolom yang diperlukan.
2. Lapisan compute
Lapisan compute terdiri dari virtual warehouse—klaster MPP independen yang mengeksekusi kueri SQL dan operasi DML. Setiap warehouse menjalankan banyak node secara paralel, beroperasi dalam isolasi penuh untuk mencegah saling memengaruhi kinerja.
Sumber daya tanpa status ini dapat dijalankan, dihentikan, diubah ukurannya, atau dikloning tanpa memengaruhi data. Pengubahan ukuran akan mendistribusikan ulang beban kerja secara otomatis, sementara fitur auto-suspension menjeda warehouse yang tidak aktif dan melanjutkannya dalam hitungan detik saat dibutuhkan.
3. Lapisan services
Lapisan services mengorkestrasi operasi Snowflake, mengelola penyimpanan metadata terdistribusi yang melacak tabel, view, kebijakan keamanan, dan kueri. Pengoptimal kueri memanfaatkan metadata ini untuk menghasilkan rencana eksekusi yang efisien berdasarkan distribusi data, sumber daya komputasi, dan pola akses.
Lapisan ini memastikan kepatuhan ACID dengan kontrol konkurensi tingkat lanjut sekaligus menangani autentikasi melalui SSO, MFA, dan kontrol akses berbasis peran di semua level. Lapisan ini juga mengelola penanganan sesi dan penegakan keamanan.
Cara kerja antar lapisan
Interaksi antar lapisan Snowflake memungkinkan kemampuan kuat seperti berbagi data yang aman, komputasi multi-klaster, dan skalabilitas dinamis. Berbagi data digerakkan oleh metadata—hanya pointer yang dipertukarkan, sementara akses dikendalikan dengan kebijakan keamanan berbutir halus. Konsumen dapat mengkueri data bersama menggunakan sumber daya komputasi mereka sendiri tanpa duplikasi.
Komputasi multi-klaster memungkinkan klaster komputasi independen mengakses lapisan storage yang sama sambil mempertahankan cache terpisah dan memastikan konsistensi. Beban kerja dapat diisolasi dengan mendedikasikan warehouse untuk ETL, BI, atau data science. Arsitektur Snowflake juga mendukung skalabilitas dinamis, memungkinkan storage dan compute diskalakan secara independen sementara lapisan services mengoptimalkan alokasi sumber daya dan kinerja kueri.
Untuk pendalaman lebih lanjut tentang konsep-konsep ini dan lainnya, Anda dapat menjelajahi kursus Introduction to Snowflake.
Arsitektur Data Warehouse Snowflake
Arsitektur gudang data Snowflake dibangun di atas desain tiga lapisnya untuk menyediakan pemodelan data yang fleksibel dan pemrosesan kueri yang efisien. Platform ini mendukung data terstruktur dan semi-terstruktur sambil mengoptimalkan kinerja dan menyederhanakan pengelolaan.
Model data
Snowflake mengakomodasi data terstruktur menggunakan konsep basis data relasional, mendukung tipe data SQL, constraint, dan relasi melalui primary key dan foreign key. Informasi sensitif mendapatkan manfaat dari enkripsi tingkat kolom. Untuk data semi-terstruktur, Snowflake secara native menangani JSON, XML, Parquet, dan Avro menggunakan tipe data VARIANT, secara otomatis menyimpulkan skema dan memungkinkan pengkuerian yang efisien dengan fungsi khusus seperti FLATTEN dan PARSE_JSON.
Pada level penyimpanan, data secara otomatis dibagi menjadi micro-partition berukuran 50–500MB, masing-masing menyimpan metadata seperti nilai minimum/maksimum kolom dan frekuensi null. Snowflake melacak pengelompokan alami dan secara berkala menata ulang data untuk meningkatkan efisiensi kueri, menghilangkan kebutuhan pengelolaan partisi manual.
Arsitektur pemrosesan kueri
Snowflake memproses kueri melalui beberapa lapisan terkoordinasi yang mengoptimalkan eksekusi. Pengoptimal kueri mengubah kueri SQL menjadi rencana eksekusi logis dan mengevaluasi beberapa rencana fisik berdasarkan ukuran tabel, pengindeksan, dan caching. Dengan model biaya, ia memilih pendekatan paling efisien, menentukan algoritma join, metode penyortiran, dan strategi pergerakan data.
Mesin eksekusi mendistribusikan kueri ke seluruh node pemrosesan paralel. Dengan memanfaatkan metadata, ia memangkas partisi yang tidak diperlukan dan hanya membaca kolom relevan dalam format penyimpanan kolumnar Snowflake, sehingga meningkatkan efisiensi. Cache hasil 24 jam semakin meningkatkan kinerja dengan menggunakan kembali hasil kueri yang telah dihitung sebelumnya ketika data dasar tidak berubah.
Arsitektur Snowflake memungkinkan pola akses data yang efisien. Zero-copy cloning memungkinkan duplikasi tabel seketika tanpa menyalin data, sementara time travel mempertahankan versi historis untuk kueri pada titik waktu tertentu. Multi-version concurrency control (MVCC) memastikan konsistensi transaksi, memungkinkan beban kerja berkonkurensi tinggi tanpa konflik penguncian. Optimalisasi ini, dikombinasikan dengan caching cerdas dan pemangkasan partisi, memungkinkan Snowflake menghadirkan analitik yang dapat diskalakan dan berkinerja tinggi dengan intervensi manual minimal.
Fitur Lanjutan Snowflake
Snowflake menawarkan fitur lanjutan di seluruh manajemen sumber daya, keamanan, integrasi, dan pemantauan untuk meningkatkan kapabilitas enterprise.
Manajemen sumber daya
Manajemen sumber dayanya yang dinamis mencakup penjadwalan warehouse dan auto-scaling, yang secara otomatis menjeda warehouse tidak aktif dan menyesuaikan sumber daya komputasi berdasarkan permintaan beban kerja. Administrator dapat mengatur jadwal mulai/berhenti otomatis dan memanfaatkan metrik sumber daya terperinci untuk mengoptimalkan biaya dan kinerja.
Tata kelola kueri
Fitur tata kelola kueri menyediakan kontrol presisi atas konsumsi sumber daya, termasuk batas dinamis, antrean cerdas, dan perutean kueri khusus, sehingga memastikan pengelolaan beban kerja yang efisien.
Integrasi Enterprise
Untuk integrasi enterprise, Snowflake mendukung stored procedure dalam JavaScript dan Java, memungkinkan pengembang menerapkan logika bisnis yang kompleks di luar SQL.
Kontrol versi memungkinkan rollback dengan mudah, sementara penanganan error memastikan eksekusi yang mulus dengan pencatatan mendetail. Kerangka kerja pertukaran data aman platform ini memungkinkan organisasi berbagi dan memonetisasi dataset melalui marketplace data privat.
Perusahaan dapat mengontrol akses, melacak penggunaan, dan menerapkan penagihan otomatis, menciptakan peluang pendapatan baru sambil mempertahankan kepatuhan dan keamanan.
Fitur-fitur ini secara kolektif memperkuat posisi Snowflake sebagai platform data yang komprehensif, menawarkan skalabilitas, otomasi, dan keamanan. Dengan manajemen beban kerja yang cerdas, integrasi tanpa hambatan, dan alat tata kelola yang tangguh, organisasi dapat mengoptimalkan kinerja, menurunkan biaya, dan berkolaborasi secara aman pada aset data.
Perbandingan Arsitektur
Mari bandingkan arsitektur Snowflake dengan gudang data tradisional dan kompetitor modern untuk memahami proposisi nilai uniknya.
Gudang data tradisional
Perbedaan arsitektural kunci:
Perbandingan model biaya:
Karakteristik kinerja:
Kompetitor modern
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
Pertimbangan kinerja tambahan:
1. Optimasi kueri
2. Penanganan konkurensi
3. Arsitektur penyimpanan
4. Variasi struktur biaya
5. Kapabilitas integrasi
Perbedaan arsitektural ini berdampak pada:
Untuk pendekatan terstruktur dalam menguasai konsep-konsep ini, rujuk panduan pembelajaran Snowflake yang komprehensif.
Berikut tabel yang merangkum perbedaan ini:
Kesimpulan
Snowflake telah mengubah cara perusahaan bekerja dengan data di cloud dengan membuatnya lebih mudah dan lebih efisien dibandingkan sistem lama. Cara Snowflake dibangun memungkinkan perusahaan menyimpan dan memproses data secara terpisah, yang membantu menghemat biaya sekaligus tetap mendapatkan hasil yang cepat. Berkat fitur keamanan Snowflake yang kuat, perusahaan dapat merasa yakin bahwa data mereka aman. Sistem ini berjalan mulus di berbagai penyedia cloud, memberikan bisnis fleksibilitas lebih dalam menentukan lokasi penyimpanan data.
Bagi siapa pun yang ingin mempelajari lebih lanjut tentang Snowflake, tersedia banyak sumber daya dan materi pelatihan bermanfaat di DataCamp.
Platform ini terus berkembang dengan fitur-fitur baru seperti kapabilitas kecerdasan buatan yang membuatnya semakin kuat bagi bisnis. Perusahaan yang menggunakan Snowflake dapat beradaptasi cepat seiring kebutuhan data mereka berubah dari waktu ke waktu. Masa depan Snowflake terlihat cerah karena semakin banyak organisasi yang memilihnya sebagai platform utama untuk mengelola data.