Snowflake là một nền tảng dữ liệu dựa trên đám mây giải quyết các thách thức cốt lõi của quản lý dữ liệu hiện đại. Ra mắt năm 2014, nền tảng này cung cấp cho tổ chức một giải pháp tập trung để lưu trữ và xử lý các hoạt động dữ liệu quy mô lớn.
Các hệ thống quản lý dữ liệu truyền thống thường đặt ra nhiều giới hạn đáng kể. Chúng buộc doanh nghiệp phải đánh đổi giữa hiệu năng truy vấn, khả năng truy cập đồng thời của người dùng và tính hiệu quả về chi phí. Kiến trúc của Snowflake được phát triển nhằm loại bỏ những ràng buộc này thông qua cách tiếp cận đối với lưu trữ dữ liệu và tính toán.
Tài liệu này xem xét khung kiến trúc và cơ chế vận hành của Snowflake. Mặc dù nền tảng tích hợp nhiều công nghệ phức tạp, phần giải thích sẽ tập trung giúp các khái niệm trở nên dễ hiểu với độc giả có kiến thức cơ bản về hệ thống dữ liệu.
Tài liệu sẽ đề cập đến:
- Nguyên lý cơ bản của hệ thống lưu trữ dữ liệu Snowflake
- Các thành phần kiến trúc cấu thành hạ tầng
- Cách nền tảng xử lý truy cập dữ liệu đồng thời
- Các lợi thế kỹ thuật thúc đẩy việc áp dụng
Phân tích này sẽ giúp bạn nắm được nền tảng về cách Snowflake vận hành trong hạ tầng dữ liệu hiện đại.
Đối với độc giả mới làm quen với Snowflake, Giới thiệu Snowflake cho người mới bắt đầu cung cấp kiến thức nền tảng cần thiết.
Các khái niệm cốt lõi của kiến trúc Snowflake
Kiến trúc của Snowflake khác với thiết kế kho dữ liệu truyền thống bằng cách sử dụng các nguyên tắc đám mây hiện đại để giải quyết thách thức về khả năng mở rộng và hiệu năng. Kiến trúc này áp dụng cách tiếp cận đa lớp, tách lưu trữ, tính toán và dịch vụ thành các thành phần riêng biệt nhưng kết nối với nhau.
Các lớp kiến trúc Snowflake
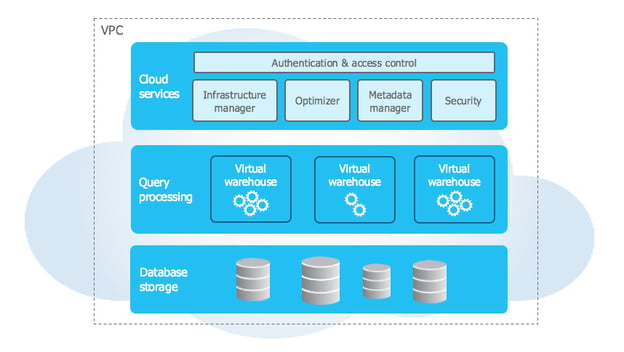
Nguồn: Tài liệu Snowflake
Kiến trúc của Snowflake sử dụng thiết kế ba lớp độc đáo tách biệt các chức năng cốt lõi đồng thời duy trì tích hợp liền mạch. Hãy cùng xem xét chi tiết từng lớp:
1. Lớp lưu trữ
Lớp lưu trữ của Snowflake dựa trên lưu trữ đối tượng đám mây (Amazon S3, Azure Blob Storage hoặc Google Cloud Storage) và tổ chức dữ liệu thành các vi phân vùng (micro-partition) bất biến (50–500MB) theo định dạng cột nén. Các vi phân vùng này lưu siêu dữ liệu như giá trị nhỏ nhất/lớn nhất của cột, cho phép cắt tỉa truy vấn hiệu quả.
Lớp này tự tối ưu, không cần bảo trì thủ công. Hệ thống thông minh chọn thuật toán nén tốt nhất theo từng cột dựa trên kiểu và mẫu dữ liệu, đảm bảo tỷ lệ nén cao và truy vấn phân tích nhanh bằng cách chỉ đọc các cột cần thiết.
2. Lớp tính toán
Lớp tính toán bao gồm các kho ảo (virtual warehouse)—những cụm MPP độc lập thực thi truy vấn SQL và các thao tác DML. Mỗi kho chạy nhiều nút song song, hoạt động tách biệt hoàn toàn để tránh can nhiễu hiệu năng.
Các tài nguyên không trạng thái này có thể khởi động, dừng, thay đổi kích thước hoặc nhân bản mà không ảnh hưởng đến dữ liệu. Việc thay đổi kích thước sẽ tự động phân phối lại khối lượng công việc, trong khi tính năng tự tạm dừng sẽ dừng các kho không hoạt động và khôi phục trong vài giây khi cần.
3. Lớp dịch vụ
Lớp dịch vụ điều phối hoạt động của Snowflake, quản lý kho siêu dữ liệu phân tán theo dõi bảng, view, chính sách bảo mật và truy vấn. Trình tối ưu hóa truy vấn tận dụng siêu dữ liệu này để tạo kế hoạch thực thi hiệu quả dựa trên phân bố dữ liệu, tài nguyên tính toán và mẫu truy cập.
Lớp này đảm bảo tuân thủ ACID với kiểm soát đồng thời nâng cao đồng thời xử lý xác thực qua SSO, MFA và kiểm soát truy cập dựa trên vai trò trên mọi cấp độ. Nó cũng quản lý phiên làm việc và thực thi bảo mật.
Cách các lớp hoạt động cùng nhau
Sự tương tác giữa các lớp của Snowflake kích hoạt các khả năng mạnh mẽ như chia sẻ dữ liệu an toàn, tính toán đa cụm và khả năng mở rộng động. Chia sẻ dữ liệu dựa trên siêu dữ liệu—chỉ trao đổi con trỏ, trong khi quyền truy cập được kiểm soát bằng các chính sách bảo mật chi tiết. Bên nhận có thể truy vấn dữ liệu được chia sẻ bằng tài nguyên tính toán của riêng họ mà không cần sao chép.
Tính toán đa cụm cho phép các cụm tính toán độc lập truy cập cùng lớp lưu trữ trong khi vẫn duy trì bộ nhớ đệm riêng và đảm bảo tính nhất quán. Có thể cô lập khối lượng công việc bằng cách dành riêng các kho cho ETL, BI hoặc khoa học dữ liệu. Kiến trúc của Snowflake cũng hỗ trợ mở rộng động, cho phép lưu trữ và tính toán mở rộng độc lập trong khi lớp dịch vụ tối ưu phân bổ tài nguyên và hiệu năng truy vấn.
Để tìm hiểu sâu hơn về các khái niệm này và nhiều nội dung khác, bạn có thể khám phá khóa học Giới thiệu Snowflake.
Kiến trúc kho dữ liệu của Snowflake
Kiến trúc kho dữ liệu của Snowflake xây dựng dựa trên thiết kế ba lớp để cung cấp mô hình hóa dữ liệu linh hoạt và xử lý truy vấn hiệu quả. Nó hỗ trợ dữ liệu có cấu trúc và bán cấu trúc đồng thời tối ưu hiệu năng và đơn giản hóa quản trị.
Mô hình dữ liệu
Snowflake đáp ứng dữ liệu có cấu trúc bằng các khái niệm cơ sở dữ liệu quan hệ, hỗ trợ kiểu dữ liệu SQL, ràng buộc và quan hệ qua khóa chính và khóa ngoại. Thông tin nhạy cảm được hưởng lợi từ mã hóa ở cấp cột. Với dữ liệu bán cấu trúc, Snowflake xử lý tự nhiên JSON, XML, Parquet và Avro thông qua kiểu dữ liệu VARIANT, tự động suy luận lược đồ và cho phép truy vấn hiệu quả với các hàm chuyên biệt như FLATTEN và PARSE_JSON.
Ở cấp lưu trữ, dữ liệu được tự động chia thành các vi phân vùng 50–500MB, mỗi phân vùng lưu siêu dữ liệu như giá trị nhỏ nhất/lớn nhất của cột và tần suất giá trị null. Snowflake theo dõi cụm tự nhiên và định kỳ tổ chức lại dữ liệu để cải thiện hiệu quả truy vấn, loại bỏ nhu cầu quản lý phân vùng thủ công.
Kiến trúc xử lý truy vấn
Snowflake xử lý truy vấn qua nhiều lớp phối hợp để tối ưu thực thi. Trình tối ưu hóa truy vấn chuyển truy vấn SQL thành kế hoạch thực thi logic và đánh giá nhiều kế hoạch vật lý dựa trên kích thước bảng, lập chỉ mục và bộ nhớ đệm. Sử dụng mô hình chi phí, nó chọn cách tiếp cận hiệu quả nhất, xác định thuật toán nối, phương thức sắp xếp và chiến lược di chuyển dữ liệu.
Công cụ thực thi phân phối truy vấn qua các nút xử lý song song. Bằng cách tận dụng siêu dữ liệu, nó cắt tỉa các phân vùng không cần thiết và chỉ đọc những cột liên quan trong định dạng lưu trữ dạng cột của Snowflake, nâng cao hiệu quả. Bộ nhớ đệm kết quả trong 24 giờ giúp cải thiện hiệu năng hơn nữa bằng cách tái sử dụng kết quả truy vấn đã tính trước khi dữ liệu nền không thay đổi.
Kiến trúc của Snowflake cho phép các mẫu truy cập dữ liệu hiệu quả. Sao chép không cần bản sao (zero-copy cloning) cho phép nhân bản bảng tức thì mà không sao chép dữ liệu, trong khi du hành thời gian (time travel) bảo toàn phiên bản lịch sử để truy vấn theo thời điểm. Kiểm soát đồng thời đa phiên bản (MVCC) đảm bảo tính nhất quán giao dịch, cho phép khối lượng công việc có mức đồng thời cao mà không xung đột khóa. Các tối ưu hóa này, kết hợp với bộ nhớ đệm thông minh và cắt tỉa phân vùng, giúp Snowflake cung cấp phân tích có thể mở rộng, hiệu năng cao với can thiệp thủ công tối thiểu.
Các tính năng nâng cao của Snowflake
Snowflake cung cấp các tính năng nâng cao về quản lý tài nguyên, bảo mật, tích hợp và giám sát để tăng cường năng lực doanh nghiệp.
Quản lý tài nguyên
Quản lý tài nguyên động bao gồm lập lịch kho và tự động mở rộng, tự động tạm dừng các kho không hoạt động và điều chỉnh tài nguyên tính toán dựa trên nhu cầu khối lượng công việc. Quản trị viên có thể đặt lịch khởi động/dừng tự động và tận dụng số liệu tài nguyên chi tiết để tối ưu chi phí và hiệu năng.
Quản trị truy vấn
Các tính năng quản trị truy vấn cung cấp khả năng kiểm soát chính xác việc tiêu thụ tài nguyên, bao gồm giới hạn động, xếp hàng thông minh và định tuyến truy vấn tùy chỉnh, đảm bảo quản lý khối lượng công việc hiệu quả.
Tích hợp doanh nghiệp
Về tích hợp doanh nghiệp, Snowflake hỗ trợ stored procedure bằng JavaScript và Java, cho phép nhà phát triển triển khai logic nghiệp vụ phức tạp vượt ngoài SQL.
Quản lý phiên bản cho phép quay lui dễ dàng, trong khi xử lý lỗi đảm bảo thực thi trơn tru với ghi log chi tiết. Khung trao đổi dữ liệu an toàn của nền tảng cho phép tổ chức chia sẻ và kiếm tiền từ bộ dữ liệu qua các chợ dữ liệu riêng.
Doanh nghiệp có thể kiểm soát truy cập, theo dõi sử dụng và triển khai lập hóa đơn tự động, tạo cơ hội doanh thu mới đồng thời duy trì tuân thủ và an toàn.
Các tính năng này cùng nhau củng cố vị thế của Snowflake như một nền tảng dữ liệu toàn diện, mang lại khả năng mở rộng, tự động hóa và bảo mật. Với quản lý khối lượng công việc thông minh, tích hợp liền mạch và công cụ quản trị vững chắc, tổ chức có thể tối ưu hiệu năng, giảm chi phí và hợp tác an toàn trên tài sản dữ liệu.
So sánh kiến trúc
Hãy so sánh kiến trúc của Snowflake với các kho dữ liệu truyền thống và các đối thủ hiện đại để hiểu đề xuất giá trị khác biệt của nó.
Kho dữ liệu truyền thống
Khác biệt kiến trúc chính:
- Hệ thống truyền thống gắn chặt lưu trữ và tính toán
- Phân vùng dữ liệu vật lý cần bảo trì thủ công
- Cần lập kế hoạch dung lượng phần cứng cho tải đỉnh
- Khả năng xử lý dữ liệu bán cấu trúc hạn chế
So sánh mô hình chi phí:
- Truyền thống cần đầu tư phần cứng ban đầu
- Dung lượng phải tính đến tăng trưởng tương lai
- Chi phí bảo trì gồm phần cứng và cơ sở vật chất
- Chi phí bản quyền thường dựa trên số lõi xử lý
Đặc tính hiệu năng:
- Bị giới hạn bởi ràng buộc phần cứng vật lý
- Mở rộng người dùng đồng thời đòi hỏi nâng cấp phần cứng
- Hiệu năng truy vấn suy giảm theo số lượng người dùng
- Tranh chấp tài nguyên giữa các khối lượng công việc
Đối thủ hiện đại
1. Amazon Redshift
- Kiến trúc: Dựa trên cụm; cần thao tác vacuum thủ công; dùng zone map
- Chi phí: Tính theo giờ trên mỗi node; giới hạn trong hệ sinh thái AWS
2. Google BigQuery
- Kiến trúc: Không máy chủ với định giá theo slot; tự động lưu đệm truy vấn (giữ 24 giờ)
- Chi phí: Trả theo số byte quét; kiểm soát tính toán hạn chế
3. Azure Synapse
- Kiến trúc: Lai (không máy chủ & cụm chuyên dụng); quản lý tài nguyên phức tạp; hỗ trợ cả rowstore và columnstore
- Chi phí: Định giá dựa trên DTU hoặc vCore; tích hợp với các dịch vụ Azure
Các lưu ý hiệu năng bổ sung:
1. Tối ưu hóa truy vấn
- BigQuery: Tối ưu hóa tự động, người dùng kiểm soát hạn chế
- Redshift: Thao tác vacuum và analyze thủ công
- Synapse: Cần cập nhật thống kê và lập chỉ mục
2. Xử lý đồng thời
- BigQuery: Hệ thống phân bổ slot
- Redshift: Quản lý khối lượng công việc dựa trên hàng đợi
- Synapse: Gán lớp tài nguyên
3. Kiến trúc lưu trữ
- BigQuery: Lưu trữ dạng cột với phân mảnh tự động
- Redshift: Phân phối theo node với quản lý lát cắt
- Synapse: Tùy chọn rowstore và columnstore
4. Biến thể cấu trúc chi phí
- BigQuery: Trả theo số byte quét
- Redshift: Tính phí theo giờ trên mỗi node
- Synapse: Định giá dựa trên DTU hoặc vCore
5. Khả năng tích hợp
- BigQuery: Tích hợp gốc các dịch vụ GCP
- Redshift: Tích hợp hệ sinh thái AWS
- Synapse: Dịch vụ nền tảng Azure
Những khác biệt kiến trúc này ảnh hưởng đến:
- Độ phức tạp vận hành
- Quản lý tài nguyên
- Tính dự đoán chi phí
- Tối ưu hóa hiệu năng
- Tích hợp hệ sinh thái
Để tiếp cận có hệ thống nhằm làm chủ các khái niệm này, hãy tham khảo hướng dẫn học Snowflake toàn diện.
Dưới đây là bảng tóm tắt những khác biệt này:
| Khía cạnh | BigQuery | Redshift | Synapse | Snowflake |
|---|
| Kiến trúc | Không máy chủ | Dựa trên cụm | Lai (không máy chủ & chuyên dụng) | Đa cụm, dữ liệu dùng chung |
| Lưu trữ | Dạng cột với tự động phân mảnh | Phân phối theo node | Rowstore & columnstore | Dạng cột vi phân vùng |
| Tối ưu hóa truy vấn | Tự động, kiểm soát hạn chế | Vacuum/analyze thủ công | Lập chỉ mục & thống kê thủ công | Tối ưu hóa tự động |
| Đồng thời | Phân bổ theo slot | WLM dựa trên hàng đợi | Lớp tài nguyên | Mở rộng kho ảo |
| Mô hình định giá | Theo byte được quét | Tính theo giờ trên mỗi node | Dựa trên DTU/vCore | Theo giây sử dụng kho |
| Tích hợp | Dịch vụ gốc GCP | Hệ sinh thái AWS | Nền tảng Azure | Hỗ trợ đa đám mây |
| Quản lý tài nguyên | Tự động | Quản lý node thủ công | Quản lý pool phức tạp | Tự động kèm kiểm soát thủ công |
| Hỗ trợ loại dữ liệu | Mạnh về bán cấu trúc | Hạn chế bán cấu trúc | Hạn chế bán cấu trúc | Bản địa bán cấu trúc |
| Bảo trì | Tối thiểu | Cần vacuum thường xuyên | Cần bảo trì chỉ mục | Không cần bảo trì |
| Bộ nhớ đệm | Tự động 24 giờ | Người dùng tự quản | Tích hợp sẵn hạn chế | Tự động lưu đệm kết quả |
Kết luận
Snowflake đã thay đổi cách doanh nghiệp làm việc với dữ liệu trên đám mây bằng cách khiến mọi thứ trở nên dễ dàng và hiệu quả hơn so với các hệ thống cũ. Cách Snowflake được xây dựng cho phép doanh nghiệp lưu trữ và xử lý dữ liệu một cách tách biệt, giúp tiết kiệm chi phí đồng thời vẫn mang lại kết quả nhanh. Nhờ các tính năng bảo mật mạnh mẽ, doanh nghiệp có thể yên tâm rằng dữ liệu của mình được bảo vệ an toàn. Hệ thống hoạt động trơn tru trên nhiều nhà cung cấp đám mây, mang lại cho doanh nghiệp sự linh hoạt hơn về nơi lưu trữ dữ liệu.
Với bất kỳ ai muốn tìm hiểu thêm về Snowflake, có rất nhiều tài nguyên và tài liệu đào tạo hữu ích trên DataCamp.
Nền tảng tiếp tục phát triển với các tính năng mới như khả năng trí tuệ nhân tạo, khiến nó càng mạnh mẽ hơn cho doanh nghiệp. Các công ty sử dụng Snowflake có thể thích ứng nhanh khi nhu cầu dữ liệu thay đổi theo thời gian. Tương lai của Snowflake tỏ ra tươi sáng khi ngày càng nhiều tổ chức lựa chọn nó làm nền tảng chính để quản lý dữ liệu.


Snowflake là một nền tảng dữ liệu dựa trên đám mây giải quyết các thách thức cốt lõi của quản lý dữ liệu hiện đại. Ra mắt năm 2014, nền tảng này cung cấp cho tổ chức một giải pháp tập trung để lưu trữ và xử lý các hoạt động dữ liệu quy mô lớn.
Các hệ thống quản lý dữ liệu truyền thống thường đặt ra nhiều giới hạn đáng kể. Chúng buộc doanh nghiệp phải đánh đổi giữa hiệu năng truy vấn, khả năng truy cập đồng thời của người dùng và tính hiệu quả về chi phí. Kiến trúc của Snowflake được phát triển nhằm loại bỏ những ràng buộc này thông qua cách tiếp cận đối với lưu trữ dữ liệu và tính toán.
Tài liệu này xem xét khung kiến trúc và cơ chế vận hành của Snowflake. Mặc dù nền tảng tích hợp nhiều công nghệ phức tạp, phần giải thích sẽ tập trung giúp các khái niệm trở nên dễ hiểu với độc giả có kiến thức cơ bản về hệ thống dữ liệu.
Tài liệu sẽ đề cập đến:
Phân tích này sẽ giúp bạn nắm được nền tảng về cách Snowflake vận hành trong hạ tầng dữ liệu hiện đại.
Đối với độc giả mới làm quen với Snowflake, Giới thiệu Snowflake cho người mới bắt đầu cung cấp kiến thức nền tảng cần thiết.
Các khái niệm cốt lõi của kiến trúc Snowflake
Kiến trúc của Snowflake khác với thiết kế kho dữ liệu truyền thống bằng cách sử dụng các nguyên tắc đám mây hiện đại để giải quyết thách thức về khả năng mở rộng và hiệu năng. Kiến trúc này áp dụng cách tiếp cận đa lớp, tách lưu trữ, tính toán và dịch vụ thành các thành phần riêng biệt nhưng kết nối với nhau.
Các lớp kiến trúc Snowflake
Nguồn: Tài liệu Snowflake
Kiến trúc của Snowflake sử dụng thiết kế ba lớp độc đáo tách biệt các chức năng cốt lõi đồng thời duy trì tích hợp liền mạch. Hãy cùng xem xét chi tiết từng lớp:
1. Lớp lưu trữ
Lớp lưu trữ của Snowflake dựa trên lưu trữ đối tượng đám mây (Amazon S3, Azure Blob Storage hoặc Google Cloud Storage) và tổ chức dữ liệu thành các vi phân vùng (micro-partition) bất biến (50–500MB) theo định dạng cột nén. Các vi phân vùng này lưu siêu dữ liệu như giá trị nhỏ nhất/lớn nhất của cột, cho phép cắt tỉa truy vấn hiệu quả.
Lớp này tự tối ưu, không cần bảo trì thủ công. Hệ thống thông minh chọn thuật toán nén tốt nhất theo từng cột dựa trên kiểu và mẫu dữ liệu, đảm bảo tỷ lệ nén cao và truy vấn phân tích nhanh bằng cách chỉ đọc các cột cần thiết.
2. Lớp tính toán
Lớp tính toán bao gồm các kho ảo (virtual warehouse)—những cụm MPP độc lập thực thi truy vấn SQL và các thao tác DML. Mỗi kho chạy nhiều nút song song, hoạt động tách biệt hoàn toàn để tránh can nhiễu hiệu năng.
Các tài nguyên không trạng thái này có thể khởi động, dừng, thay đổi kích thước hoặc nhân bản mà không ảnh hưởng đến dữ liệu. Việc thay đổi kích thước sẽ tự động phân phối lại khối lượng công việc, trong khi tính năng tự tạm dừng sẽ dừng các kho không hoạt động và khôi phục trong vài giây khi cần.
3. Lớp dịch vụ
Lớp dịch vụ điều phối hoạt động của Snowflake, quản lý kho siêu dữ liệu phân tán theo dõi bảng, view, chính sách bảo mật và truy vấn. Trình tối ưu hóa truy vấn tận dụng siêu dữ liệu này để tạo kế hoạch thực thi hiệu quả dựa trên phân bố dữ liệu, tài nguyên tính toán và mẫu truy cập.
Lớp này đảm bảo tuân thủ ACID với kiểm soát đồng thời nâng cao đồng thời xử lý xác thực qua SSO, MFA và kiểm soát truy cập dựa trên vai trò trên mọi cấp độ. Nó cũng quản lý phiên làm việc và thực thi bảo mật.
Cách các lớp hoạt động cùng nhau
Sự tương tác giữa các lớp của Snowflake kích hoạt các khả năng mạnh mẽ như chia sẻ dữ liệu an toàn, tính toán đa cụm và khả năng mở rộng động. Chia sẻ dữ liệu dựa trên siêu dữ liệu—chỉ trao đổi con trỏ, trong khi quyền truy cập được kiểm soát bằng các chính sách bảo mật chi tiết. Bên nhận có thể truy vấn dữ liệu được chia sẻ bằng tài nguyên tính toán của riêng họ mà không cần sao chép.
Tính toán đa cụm cho phép các cụm tính toán độc lập truy cập cùng lớp lưu trữ trong khi vẫn duy trì bộ nhớ đệm riêng và đảm bảo tính nhất quán. Có thể cô lập khối lượng công việc bằng cách dành riêng các kho cho ETL, BI hoặc khoa học dữ liệu. Kiến trúc của Snowflake cũng hỗ trợ mở rộng động, cho phép lưu trữ và tính toán mở rộng độc lập trong khi lớp dịch vụ tối ưu phân bổ tài nguyên và hiệu năng truy vấn.
Để tìm hiểu sâu hơn về các khái niệm này và nhiều nội dung khác, bạn có thể khám phá khóa học Giới thiệu Snowflake.
Kiến trúc kho dữ liệu của Snowflake
Kiến trúc kho dữ liệu của Snowflake xây dựng dựa trên thiết kế ba lớp để cung cấp mô hình hóa dữ liệu linh hoạt và xử lý truy vấn hiệu quả. Nó hỗ trợ dữ liệu có cấu trúc và bán cấu trúc đồng thời tối ưu hiệu năng và đơn giản hóa quản trị.
Mô hình dữ liệu
Snowflake đáp ứng dữ liệu có cấu trúc bằng các khái niệm cơ sở dữ liệu quan hệ, hỗ trợ kiểu dữ liệu SQL, ràng buộc và quan hệ qua khóa chính và khóa ngoại. Thông tin nhạy cảm được hưởng lợi từ mã hóa ở cấp cột. Với dữ liệu bán cấu trúc, Snowflake xử lý tự nhiên JSON, XML, Parquet và Avro thông qua kiểu dữ liệu VARIANT, tự động suy luận lược đồ và cho phép truy vấn hiệu quả với các hàm chuyên biệt như FLATTEN và PARSE_JSON.
Ở cấp lưu trữ, dữ liệu được tự động chia thành các vi phân vùng 50–500MB, mỗi phân vùng lưu siêu dữ liệu như giá trị nhỏ nhất/lớn nhất của cột và tần suất giá trị null. Snowflake theo dõi cụm tự nhiên và định kỳ tổ chức lại dữ liệu để cải thiện hiệu quả truy vấn, loại bỏ nhu cầu quản lý phân vùng thủ công.
Kiến trúc xử lý truy vấn
Snowflake xử lý truy vấn qua nhiều lớp phối hợp để tối ưu thực thi. Trình tối ưu hóa truy vấn chuyển truy vấn SQL thành kế hoạch thực thi logic và đánh giá nhiều kế hoạch vật lý dựa trên kích thước bảng, lập chỉ mục và bộ nhớ đệm. Sử dụng mô hình chi phí, nó chọn cách tiếp cận hiệu quả nhất, xác định thuật toán nối, phương thức sắp xếp và chiến lược di chuyển dữ liệu.
Công cụ thực thi phân phối truy vấn qua các nút xử lý song song. Bằng cách tận dụng siêu dữ liệu, nó cắt tỉa các phân vùng không cần thiết và chỉ đọc những cột liên quan trong định dạng lưu trữ dạng cột của Snowflake, nâng cao hiệu quả. Bộ nhớ đệm kết quả trong 24 giờ giúp cải thiện hiệu năng hơn nữa bằng cách tái sử dụng kết quả truy vấn đã tính trước khi dữ liệu nền không thay đổi.
Kiến trúc của Snowflake cho phép các mẫu truy cập dữ liệu hiệu quả. Sao chép không cần bản sao (zero-copy cloning) cho phép nhân bản bảng tức thì mà không sao chép dữ liệu, trong khi du hành thời gian (time travel) bảo toàn phiên bản lịch sử để truy vấn theo thời điểm. Kiểm soát đồng thời đa phiên bản (MVCC) đảm bảo tính nhất quán giao dịch, cho phép khối lượng công việc có mức đồng thời cao mà không xung đột khóa. Các tối ưu hóa này, kết hợp với bộ nhớ đệm thông minh và cắt tỉa phân vùng, giúp Snowflake cung cấp phân tích có thể mở rộng, hiệu năng cao với can thiệp thủ công tối thiểu.
Các tính năng nâng cao của Snowflake
Snowflake cung cấp các tính năng nâng cao về quản lý tài nguyên, bảo mật, tích hợp và giám sát để tăng cường năng lực doanh nghiệp.
Quản lý tài nguyên
Quản lý tài nguyên động bao gồm lập lịch kho và tự động mở rộng, tự động tạm dừng các kho không hoạt động và điều chỉnh tài nguyên tính toán dựa trên nhu cầu khối lượng công việc. Quản trị viên có thể đặt lịch khởi động/dừng tự động và tận dụng số liệu tài nguyên chi tiết để tối ưu chi phí và hiệu năng.
Quản trị truy vấn
Các tính năng quản trị truy vấn cung cấp khả năng kiểm soát chính xác việc tiêu thụ tài nguyên, bao gồm giới hạn động, xếp hàng thông minh và định tuyến truy vấn tùy chỉnh, đảm bảo quản lý khối lượng công việc hiệu quả.
Tích hợp doanh nghiệp
Về tích hợp doanh nghiệp, Snowflake hỗ trợ stored procedure bằng JavaScript và Java, cho phép nhà phát triển triển khai logic nghiệp vụ phức tạp vượt ngoài SQL.
Quản lý phiên bản cho phép quay lui dễ dàng, trong khi xử lý lỗi đảm bảo thực thi trơn tru với ghi log chi tiết. Khung trao đổi dữ liệu an toàn của nền tảng cho phép tổ chức chia sẻ và kiếm tiền từ bộ dữ liệu qua các chợ dữ liệu riêng.
Doanh nghiệp có thể kiểm soát truy cập, theo dõi sử dụng và triển khai lập hóa đơn tự động, tạo cơ hội doanh thu mới đồng thời duy trì tuân thủ và an toàn.
Các tính năng này cùng nhau củng cố vị thế của Snowflake như một nền tảng dữ liệu toàn diện, mang lại khả năng mở rộng, tự động hóa và bảo mật. Với quản lý khối lượng công việc thông minh, tích hợp liền mạch và công cụ quản trị vững chắc, tổ chức có thể tối ưu hiệu năng, giảm chi phí và hợp tác an toàn trên tài sản dữ liệu.
So sánh kiến trúc
Hãy so sánh kiến trúc của Snowflake với các kho dữ liệu truyền thống và các đối thủ hiện đại để hiểu đề xuất giá trị khác biệt của nó.
Kho dữ liệu truyền thống
Khác biệt kiến trúc chính:
So sánh mô hình chi phí:
Đặc tính hiệu năng:
Đối thủ hiện đại
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
Các lưu ý hiệu năng bổ sung:
1. Tối ưu hóa truy vấn
2. Xử lý đồng thời
3. Kiến trúc lưu trữ
4. Biến thể cấu trúc chi phí
5. Khả năng tích hợp
Những khác biệt kiến trúc này ảnh hưởng đến:
Để tiếp cận có hệ thống nhằm làm chủ các khái niệm này, hãy tham khảo hướng dẫn học Snowflake toàn diện.
Dưới đây là bảng tóm tắt những khác biệt này:
Kết luận
Snowflake đã thay đổi cách doanh nghiệp làm việc với dữ liệu trên đám mây bằng cách khiến mọi thứ trở nên dễ dàng và hiệu quả hơn so với các hệ thống cũ. Cách Snowflake được xây dựng cho phép doanh nghiệp lưu trữ và xử lý dữ liệu một cách tách biệt, giúp tiết kiệm chi phí đồng thời vẫn mang lại kết quả nhanh. Nhờ các tính năng bảo mật mạnh mẽ, doanh nghiệp có thể yên tâm rằng dữ liệu của mình được bảo vệ an toàn. Hệ thống hoạt động trơn tru trên nhiều nhà cung cấp đám mây, mang lại cho doanh nghiệp sự linh hoạt hơn về nơi lưu trữ dữ liệu.
Với bất kỳ ai muốn tìm hiểu thêm về Snowflake, có rất nhiều tài nguyên và tài liệu đào tạo hữu ích trên DataCamp.
Nền tảng tiếp tục phát triển với các tính năng mới như khả năng trí tuệ nhân tạo, khiến nó càng mạnh mẽ hơn cho doanh nghiệp. Các công ty sử dụng Snowflake có thể thích ứng nhanh khi nhu cầu dữ liệu thay đổi theo thời gian. Tương lai của Snowflake tỏ ra tươi sáng khi ngày càng nhiều tổ chức lựa chọn nó làm nền tảng chính để quản lý dữ liệu.