Snowflake एक क्लाउड-आधारित डेटा प्लेटफ़ॉर्म है जो आधुनिक डेटा प्रबंधन की बुनियादी चुनौतियों का समाधान करता है। 2014 में लॉन्च हुआ, यह बड़े पैमाने पर डेटा संचालन को संग्रहीत करने और प्रोसेस करने के लिए संगठनों को एक केंद्रीकृत समाधान प्रदान करता है।
पारंपरिक डेटा प्रबंधन प्रणालियाँ अक्सर संगठनों के लिए महत्वपूर्ण सीमाएँ पेश करती हैं। ये प्रणालियाँ आमतौर पर कंपनियों को क्वेरी प्रदर्शन, समवर्ती उपयोगकर्ता पहुँच और लागत-प्रभावशीलता के बीच चुनाव करने पर मजबूर करती हैं। Snowflake की आर्किटेक्चर को डेटा स्टोरेज और कंप्यूटेशन के अपने दृष्टिकोण के माध्यम से इन बाधाओं को समाप्त करने के लिए विकसित किया गया था।
यह गाइड Snowflake की आर्किटेक्चरल रूपरेखा और ऑपरेशनल तंत्र की पड़ताल करता है। जबकि प्लेटफ़ॉर्म में जटिल तकनीकें शामिल हैं, यह व्याख्या डेटा सिस्टम की बुनियादी समझ रखने वाले पाठकों के लिए इन अवधारणाओं को सुलभ बनाने पर केंद्रित होगी।
यह गाइड इन विषयों को कवर करेगा:
- Snowflake के डेटा स्टोरेज सिस्टम के बुनियादी सिद्धांत
- वे आर्किटेक्चरल घटक जो इसकी अवसंरचना बनाते हैं
- समवर्ती डेटा अभिगम के लिए प्लेटफ़ॉर्म का दृष्टिकोण
- वे तकनीकी लाभ जो इसके अपनाने को प्रेरित करते हैं
यह विश्लेषण आपको आधुनिक डेटा अवसंरचना में Snowflake कैसे कार्य करता है, इसकी बुनियादी समझ प्रदान करेगा।
जो पाठक Snowflake के लिए नए हैं, उनके लिए Introduction to Snowflake for Beginners आवश्यक पृष्ठभूमि ज्ञान प्रदान करता है।
Snowflake आर्किटेक्चर के मुख्य सिद्धांत
Snowflake की आर्किटेक्चर पारंपरिक डेटा वेयरहाउस डिज़ाइनों से अलग है क्योंकि यह स्केलेबिलिटी और प्रदर्शन संबंधी चुनौतियों को हल करने के लिए आधुनिक क्लाउड सिद्धांतों का उपयोग करती है। यह आर्किटेक्चर एक बहु-परत दृष्टिकोण लागू करती है जो स्टोरेज, कंप्यूट और सर्विसेज़ को अलग-अलग लेकिन आपस में जुड़े घटकों में विभाजित करती है।
Snowflake की आर्किटेक्चर परतें
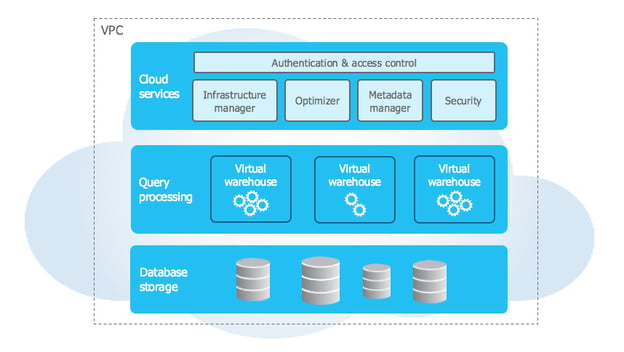
स्रोत: Snowflake प्रलेखन
Snowflake की आर्किटेक्चर एक अनोखी तीन-परत डिज़ाइन अपनाती है जो मुख्य कार्यक्षमताओं को अलग करते हुए निर्बाध एकीकरण बनाए रखती है। आइए प्रत्येक परत को विस्तार से देखें:
1. स्टोरेज परत
Snowflake की स्टोरेज परत क्लाउड ऑब्जेक्ट स्टोरेज (Amazon S3, Azure Blob Storage या Google Cloud Storage) पर निर्भर करती है और डेटा को 50–500MB के अपरिवर्तनीय माइक्रो-पार्टिशन में संपीड़ित कॉलमनर फ़ॉर्मेट में व्यवस्थित करती है। ये माइक्रो-पार्टिशन मेटाडेटा जैसे न्यूनतम/अधिकतम कॉलम मान संग्रहीत करते हैं, जिससे कुशल क्वेरी प्रूनिंग संभव होती है।
यह परत स्व-ऑप्टिमाइज़िंग है और किसी मैन्युअल मेंटेनेंस की आवश्यकता नहीं होती। यह डेटा प्रकार और पैटर्न के आधार पर प्रति कॉलम सर्वश्रेष्ठ कंप्रेशन एल्गोरिद्म बुद्धिमानी से चुनती है, जिससे उच्च कंप्रेशन अनुपात और तेज़ विश्लेषणात्मक क्वेरी सुनिश्चित होती हैं, क्योंकि केवल आवश्यक कॉलम पढ़े जाते हैं।
2. कंप्यूट परत
कंप्यूट परत वर्चुअल वेयरहाउसों से बनी होती है—स्वतंत्र MPP क्लस्टर जो SQL क्वेरियाँ और DML ऑपरेशंस निष्पादित करते हैं। प्रत्येक वेयरहाउस कई नोड्स पर समानांतर रूप से चलता है और पूर्ण पृथकता में कार्य करता है ताकि प्रदर्शन में बाधा न आए।
ये स्टेटलेस संसाधन डेटा को प्रभावित किए बिना शुरू, बंद, रीसायज़ या क्लोन किए जा सकते हैं। रीसायज़िंग स्वतः वर्कलोड को पुनर्वितरित करती है, जबकि ऑटो-सस्पेंशन सुविधा निष्क्रिय वेयरहाउसों को रोकती है और आवश्यकता होने पर उन्हें कुछ ही सेकंड में फिर शुरू कर देती है।
3. सर्विसेज़ परत
सर्विसेज़ परत Snowflake के संचालन का समन्वयन करती है, एक वितरित मेटाडेटा स्टोर का प्रबंधन करती है जो टेबल्स, व्यूज़, सुरक्षा नीतियों और क्वेरियों को ट्रैक करता है। क्वेरी ऑप्टिमाइज़र इस मेटाडेटा का लाभ उठाकर डेटा वितरण, कंप्यूट संसाधन और एक्सेस पैटर्न के आधार पर कुशल निष्पादन योजनाएँ बनाता है।
यह उन्नत समवर्तीता नियंत्रण के साथ ACID अनुपालन सुनिश्चित करती है, साथ ही SSO, MFA और रोल-आधारित एक्सेस कंट्रोल के माध्यम से सभी स्तरों पर प्रमाणीकरण संभालती है। यह परत सत्र प्रबंधन और सुरक्षा प्रवर्तन भी करती है।
परतें साथ मिलकर कैसे काम करती हैं
Snowflake की परतों के बीच की अंतःक्रिया सुरक्षित डेटा शेयरिंग, मल्टी-क्लस्टर कंप्यूटिंग और डायनेमिक स्केलेबिलिटी जैसी शक्तिशाली क्षमताएँ सक्षम करती है। डेटा शेयरिंग मेटाडेटा-चालित होती है—केवल पॉइंटर्स का आदान-प्रदान होता है, जबकि अभिगम को सूक्ष्म-स्तरीय सुरक्षा नीतियों से नियंत्रित किया जाता है। उपभोक्ता अपने स्वयं के कंप्यूट संसाधनों का उपयोग करके बिना डुप्लीकेशन के साझा डेटा पर क्वेरी चला सकते हैं।
मल्टी-क्लस्टर कंप्यूटिंग स्वतंत्र कंप्यूट क्लस्टरों को एक ही स्टोरेज परत तक पहुँचने देती है, जबकि अलग-अलग कैश बनाए रखती है और सुसंगतता सुनिश्चित करती है। ETL, BI या डेटा साइंस के लिए समर्पित वेयरहाउस आवंटित करके वर्कलोड्स को अलग किया जा सकता है। Snowflake की आर्किटेक्चर डायनेमिक स्केलेबिलिटी को भी सपोर्ट करती है, जिससे स्टोरेज और कंप्यूट स्वतंत्र रूप से स्केल हो सकते हैं, और सर्विसेज़ परत संसाधन आवंटन व क्वेरी प्रदर्शन का अनुकूलन करती है।
इन अवधारणाओं और अन्य विषयों में गहराई से जाने के लिए, आप Introduction to Snowflake कोर्स देख सकते हैं।
Snowflake की डेटा वेयरहाउस आर्किटेक्चर
Snowflake की डेटा वेयरहाउस आर्किटेक्चर अपनी तीन-परत डिज़ाइन पर आधारित है, जो लचीला डेटा मॉडलिंग और कुशल क्वेरी प्रोसेसिंग प्रदान करती है। यह स्ट्रक्चर्ड और सेमी-स्ट्रक्चर्ड डेटा दोनों को सपोर्ट करती है, प्रदर्शन को अनुकूलित करते हुए प्रबंधन को सरल बनाती है।
डेटा मॉडल
Snowflake रिलेशनल डेटाबेस अवधारणाओं का उपयोग करके संरचित डेटा को समायोजित करता है, SQL डेटा प्रकारों, बाधाओं और प्राथमिक तथा विदेशी कुंजियों के माध्यम से संबंधों का समर्थन करता है। संवेदनशील जानकारी के लिए कॉलम-स्तरीय एन्क्रिप्शन लाभकारी होता है। सेमी-स्ट्रक्चर्ड डेटा के लिए, Snowflake मूल रूप से VARIANT डेटा प्रकार का उपयोग करके JSON, XML, Parquet और Avro को संभालता है, स्वतः स्कीमा का अनुमान लगाता है और FLATTEN तथा PARSE_JSON जैसी विशेष फ़ंक्शनों के साथ कुशल क्वेरी सक्षम करता है।
स्टोरेज स्तर पर, डेटा स्वतः 50–500MB के माइक्रो-पार्टिशन में विभाजित हो जाता है, जिनमें से प्रत्येक में न्यूनतम/अधिकतम कॉलम मान और नल आवृत्तियों जैसे मेटाडेटा संग्रहीत होते हैं। Snowflake नैचुरल क्लस्टरिंग को ट्रैक करता है और समय-समय पर डेटा को पुनर्गठित करता है ताकि क्वेरी दक्षता में सुधार हो, जिससे मैन्युअल पार्टिशन प्रबंधन की आवश्यकता समाप्त हो जाती है।
क्वेरी प्रोसेसिंग आर्किटेक्चर
Snowflake कई समन्वित परतों के माध्यम से क्वेरियों को प्रोसेस करता है जो निष्पादन का अनुकूलन करती हैं। क्वेरी ऑप्टिमाइज़र SQL क्वेरियों को लॉजिकल निष्पादन योजनाओं में बदलता है और तालिका आकार, इंडेक्सिंग और कैशिंग के आधार पर कई भौतिक योजनाओं का मूल्यांकन करता है। एक कॉस्ट मॉडल का उपयोग करके, यह सबसे कुशल दृष्टिकोण का चयन करता है, जॉइन एल्गोरिद्म, सॉर्टिंग विधियाँ और डेटा मूवमेंट रणनीतियाँ निर्धारित करता है।
एक्ज़ीक्यूशन इंजन क्वेरियों को समानांतर प्रोसेसिंग नोड्स पर वितरित करता है। मेटाडेटा का लाभ उठाकर, यह अनावश्यक पार्टिशन को प्रून करता है और Snowflake के कॉलमनर स्टोरेज फ़ॉर्मेट में केवल प्रासंगिक कॉलम पढ़ता है, जिससे दक्षता बढ़ती है। 24 घंटे का रिज़ल्ट कैश अंतर्निहित डेटा अपरिवर्तित रहने पर पहले से गणना किए गए क्वेरी परिणामों का पुन: उपयोग करके प्रदर्शन को और बेहतर बनाता है।
Snowflake की आर्किटेक्चर कुशल डेटा अभिगम पैटर्न सक्षम करती है। ज़ीरो-कॉपी क्लोनिंग बिना डेटा कॉपी किए तालिकाओं की त्वरित प्रतिकृति की अनुमति देती है, जबकि टाइम ट्रैवल पॉइंट-इन-टाइम क्वेरियों के लिए ऐतिहासिक संस्करण सुरक्षित रखता है। मल्टी-वर्ज़न कंकरेन्सी कंट्रोल (MVCC) लेनदेन सुसंगतता सुनिश्चित करता है, जिससे लॉकिंग संघर्षों के बिना उच्च समवर्ती वर्कलोड संभव होते हैं। ये ऑप्टिमाइज़ेशन, बुद्धिमान कैशिंग और पार्टिशन प्रूनिंग के साथ मिलकर, Snowflake को न्यूनतम मैन्युअल हस्तक्षेप के साथ स्केलेबल, उच्च-प्रदर्शन विश्लेषिकी देने में सक्षम बनाते हैं।
उन्नत Snowflake फीचर्स
एंटरप्राइज़ क्षमताओं को बढ़ाने के लिए Snowflake संसाधन प्रबंधन, सुरक्षा, इंटीग्रेशन और मॉनिटरिंग में उन्नत फीचर्स प्रदान करता है।
संसाधन प्रबंधन
इसका डायनेमिक रिसोर्स मैनेजमेंट वेयरहाउस शेड्यूलिंग और ऑटो-स्केलिंग शामिल करता है, जो निष्क्रिय वेयरहाउसों को स्वतः रोकता है और वर्कलोड मांगों के आधार पर कंप्यूट संसाधनों को समायोजित करता है। प्रशासक स्वचालित स्टार्ट/स्टॉप शेड्यूल सेट कर सकते हैं और लागत व प्रदर्शन को अनुकूलित करने के लिए विस्तृत संसाधन मीट्रिक्स का लाभ उठा सकते हैं।
क्वेरी गवर्नेंस
क्वेरी गवर्नेंस फीचर्स संसाधन खपत पर सटीक नियंत्रण देते हैं, जिनमें डायनेमिक लिमिट्स, इंटेलिजेंट क्यूइंग और कस्टम क्वेरी रूटिंग शामिल हैं, जिससे प्रभावी वर्कलोड प्रबंधन सुनिश्चित होता है।
एंटरप्राइज़ इंटीग्रेशन
एंटरप्राइज़ इंटीग्रेशन के लिए, Snowflake JavaScript और Java में स्टोर्ड प्रोसीजर्स का समर्थन करता है, जिससे डेवलपर्स SQL से परे जटिल व्यावसायिक लॉजिक लागू कर सकते हैं।
वर्ज़न कंट्रोल आसान रोलबैक सक्षम करता है, जबकि एरर हैंडलिंग विस्तृत लॉगिंग के साथ सुचारु निष्पादन सुनिश्चित करती है। प्लेटफ़ॉर्म का सुरक्षित डेटा एक्सचेंज फ़्रेमवर्क संगठनों को निजी डेटा मार्केटप्लेस के माध्यम से डेटासेट साझा करने और उनसे कमाई करने की अनुमति देता है।
कंपनियाँ अभिगम को नियंत्रित कर सकती हैं, उपयोग को ट्रैक कर सकती हैं और स्वचालित बिलिंग लागू कर सकती हैं, जिससे अनुपालन और सुरक्षा बनाए रखते हुए नए राजस्व अवसर बनते हैं।
ये फीचर्स मिलकर Snowflake की स्थिति को एक समग्र डेटा प्लेटफ़ॉर्म के रूप में मज़बूत करते हैं, जो स्केलेबिलिटी, स्वचालन और सुरक्षा प्रदान करता है। बुद्धिमान वर्कलोड प्रबंधन, निर्बाध इंटीग्रेशन और मज़बूत गवर्नेंस टूल्स के साथ, संगठन प्रदर्शन का अनुकूलन कर सकते हैं, लागत घटा सकते हैं और डेटा एसेट्स पर सुरक्षित रूप से सहयोग कर सकते हैं।
आर्किटेक्चर तुलना
आइए Snowflake की आर्किटेक्चर की पारंपरिक डेटा वेयरहाउस और आधुनिक प्रतिस्पर्धियों से तुलना करके इसके विशिष्ट मूल्य प्रस्ताव को समझें।
पारंपरिक डेटा वेयरहाउस
मुख्य आर्किटेक्चरल अंतर:
- पारंपरिक सिस्टम स्टोरेज और कंप्यूट को कसकर जोड़ते हैं
- भौतिक डेटा पार्टिशनिंग के लिए मैन्युअल मेंटेनेंस आवश्यक
- पीक वर्कलोड के लिए हार्डवेयर क्षमता नियोजन आवश्यक
- सेमी-स्ट्रक्चर्ड डेटा संभालने की सीमित क्षमता
लागत मॉडल तुलना:
- पारंपरिक में अग्रिम हार्डवेयर निवेश आवश्यक
- क्षमता को भविष्य की वृद्धि के हिसाब से रखना पड़ता है
- मेंटेनेंस लागत में हार्डवेयर और सुविधाएँ शामिल
- लाइसेंस लागत आमतौर पर प्रोसेसर कोर पर आधारित
प्रदर्शन विशेषताएँ:
- भौतिक हार्डवेयर सीमाओं से बाधित
- समवर्ती उपयोगकर्ता स्केलिंग के लिए हार्डवेयर अपग्रेड आवश्यक
- उपयोगकर्ता संख्या बढ़ने पर क्वेरी प्रदर्शन घटता है
- वर्कलोड्स के बीच संसाधन प्रतिस्पर्धा
आधुनिक प्रतिस्पर्धी
1. Amazon Redshift
- आर्किटेक्चर: क्लस्टर-आधारित; मैन्युअल वैक्यूम ऑपरेशंस; ज़ोन मैप्स का उपयोग
- लागत: नोड-आधारित प्रति घंटा प्राइसिंग; AWS इकोसिस्टम तक सीमित
2. Google BigQuery
- आर्किटेक्चर: सर्वरलेस, स्लॉट-आधारित प्राइसिंग; स्वचालित क्वेरी कैशिंग (24 घंटे रिटेंशन)
- लागत: प्रति-बाइट स्कैन पर भुगतान; कंप्यूट नियंत्रण सीमित
3. Azure Synapse
- आर्किटेक्चर: हाइब्रिड (सर्वरलेस और डेडिकेटेड पूल); जटिल संसाधन प्रबंधन; रोस्टोर और कॉलमनस्टोर दोनों का समर्थन
- लागत: DTU या vCore-आधारित प्राइसिंग; Azure सेवाओं के साथ इंटीग्रेशन
अतिरिक्त प्रदर्शन संबंधी विचार:
1. क्वेरी ऑप्टिमाइज़ेशन
- BigQuery: स्वचालित ऑप्टिमाइज़ेशन, उपयोगकर्ता नियंत्रण सीमित
- Redshift: मैन्युअल वैक्यूम और एनालाइज़ ऑपरेशंस
- Synapse: सांख्यिकी अपडेट और इंडेक्सिंग आवश्यक
2. कंकरेन्सी हैंडलिंग
- BigQuery: स्लॉट आवंटन प्रणाली
- Redshift: क्यू-आधारित वर्कलोड प्रबंधन
- Synapse: रिसोर्स क्लास असाइनमेंट
3. स्टोरेज आर्किटेक्चर
- BigQuery: स्वचालित शार्डिंग के साथ कॉलमनर स्टोरेज
- Redshift: स्लाइस प्रबंधन के साथ नोड-आधारित वितरण
- Synapse: रोस्टोर और कॉलमनस्टोर विकल्प
4. लागत संरचना में भिन्नताएँ
- BigQuery: प्रति बाइट स्कैन पर भुगतान
- Redshift: नोड-आधारित प्रति घंटा
- Synapse: DTU या vCore-आधारित प्राइसिंग
5. इंटीग्रेशन क्षमताएँ
- BigQuery: नैटिव GCP सेवा इंटीग्रेशन
- Redshift: AWS इकोसिस्टम इंटीग्रेशन
- Synapse: Azure प्लेटफ़ॉर्म सेवाएँ
ये आर्किटेक्चरल अंतर निम्न पर प्रभाव डालते हैं:
- संचालन जटिलता
- संसाधन प्रबंधन
- लागत की पूर्वानुमेयता
- प्रदर्शन अनुकूलन
- इकोसिस्टम इंटीग्रेशन
इन अवधारणाओं में महारत हासिल करने के लिए एक संरचित दृष्टिकोण के लिए, देखें व्यापक Snowflake सीखने की गाइड।
यहाँ इन अंतरों का सार प्रस्तुत करने वाली एक तालिका है:
| पहलू | BigQuery | Redshift | Synapse | Snowflake |
|---|
| आर्किटेक्चर | सर्वरलेस | क्लस्टर-आधारित | हाइब्रिड (सर्वरलेस और डेडिकेटेड) | मल्टी-क्लस्टर, साझा डेटा |
| स्टोरेज | ऑटो-शार्डिंग के साथ कॉलमनर | नोड-आधारित वितरण | रोस्टोर और कॉलमनस्टोर | माइक्रो-पार्टिशन्ड कॉलमनर |
| क्वेरी ऑप्टिमाइज़ेशन | स्वचालित, नियंत्रण सीमित | मैन्युअल वैक्यूम/एनालाइज़ | मैन्युअल इंडेक्सिंग और सांख्यिकी | स्वचालित ऑप्टिमाइज़ेशन |
| समवर्तीता | स्लॉट-आधारित आवंटन | क्यू-आधारित WLM | रिसोर्स क्लासेस | वर्चुअल वेयरहाउस स्केलिंग |
| प्राइसिंग मॉडल | प्रति बाइट स्कैन | नोड-आधारित प्रति घंटा | DTU/vCore-आधारित | प्रति सेकंड वेयरहाउस उपयोग |
| इंटीग्रेशन | GCP नैटिव सेवाएँ | AWS इकोसिस्टम | Azure प्लेटफ़ॉर्म | मल्टी-क्लाउड सपोर्ट |
| रिसोर्स मैनेजमेंट | स्वचालित | मैन्युअल नोड प्रबंधन | जटिल पूल प्रबंधन | स्वचालित, मैन्युअल नियंत्रण सहित |
| डेटा प्रकार समर्थन | मज़बूत सेमी-स्ट्रक्चर्ड | सीमित सेमी-स्ट्रक्चर्ड | सीमित सेमी-स्ट्रक्चर्ड | मूल (नेेटिव) सेमी-स्ट्रक्चर्ड |
| मेंटेनेंस | न्यूनतम | नियमित वैक्यूम आवश्यक | इंडेक्स मेंटेनेंस आवश्यक | शून्य मेंटेनेंस |
| कैशिंग | 24 घंटे स्वचालित | उपयोगकर्ता-प्रबंधित | सीमित बिल्ट-इन | स्वचालित परिणाम कैशिंग |
निष्कर्ष
Snowflake ने क्लाउड में कंपनियों के डेटा के साथ काम करने के तरीके को बदल दिया है, इसे पुराने सिस्टम की तुलना में आसान और अधिक कुशल बना दिया है। Snowflake की बनावट कंपनियों को अपने डेटा के स्टोरेज और प्रोसेसिंग को अलग-अलग रखने देती है, जिससे वे तेज़ परिणाम पाते हुए लागत बचा सकते हैं। Snowflake की मज़बूत सुरक्षा विशेषताओं की बदौलत कंपनियाँ आश्वस्त रह सकती हैं कि उनका डेटा सुरक्षित है। यह सिस्टम विभिन्न क्लाउड प्रदाताओं पर सुचारु रूप से काम करता है, जिससे व्यवसायों को यह लचीलापन मिलता है कि वे अपना डेटा कहाँ रखें।
जो भी Snowflake के बारे में और सीखना चाहते हैं, उनके लिए DataCamp पर अनेक सहायक संसाधन और प्रशिक्षण सामग्री उपलब्ध हैं।
प्लेटफ़ॉर्म निरंतर विकसित हो रहा है, और कृत्रिम बुद्धिमत्ता जैसी नई क्षमताओं के साथ व्यवसायों के लिए और भी शक्तिशाली बनता जा रहा है। Snowflake का उपयोग करने वाली कंपनियाँ समय के साथ अपनी बदलती डेटा ज़रूरतों के अनुसार तेज़ी से अनुकूल हो सकती हैं। जैसे-जैसे अधिक संगठन इसे अपने प्रमुख डेटा प्रबंधन प्लेटफ़ॉर्म के रूप में चुनते हैं, Snowflake का भविष्य उज्ज्वल दिखता है।


Snowflake एक क्लाउड-आधारित डेटा प्लेटफ़ॉर्म है जो आधुनिक डेटा प्रबंधन की बुनियादी चुनौतियों का समाधान करता है। 2014 में लॉन्च हुआ, यह बड़े पैमाने पर डेटा संचालन को संग्रहीत करने और प्रोसेस करने के लिए संगठनों को एक केंद्रीकृत समाधान प्रदान करता है।
पारंपरिक डेटा प्रबंधन प्रणालियाँ अक्सर संगठनों के लिए महत्वपूर्ण सीमाएँ पेश करती हैं। ये प्रणालियाँ आमतौर पर कंपनियों को क्वेरी प्रदर्शन, समवर्ती उपयोगकर्ता पहुँच और लागत-प्रभावशीलता के बीच चुनाव करने पर मजबूर करती हैं। Snowflake की आर्किटेक्चर को डेटा स्टोरेज और कंप्यूटेशन के अपने दृष्टिकोण के माध्यम से इन बाधाओं को समाप्त करने के लिए विकसित किया गया था।
यह गाइड Snowflake की आर्किटेक्चरल रूपरेखा और ऑपरेशनल तंत्र की पड़ताल करता है। जबकि प्लेटफ़ॉर्म में जटिल तकनीकें शामिल हैं, यह व्याख्या डेटा सिस्टम की बुनियादी समझ रखने वाले पाठकों के लिए इन अवधारणाओं को सुलभ बनाने पर केंद्रित होगी।
यह गाइड इन विषयों को कवर करेगा:
यह विश्लेषण आपको आधुनिक डेटा अवसंरचना में Snowflake कैसे कार्य करता है, इसकी बुनियादी समझ प्रदान करेगा।
जो पाठक Snowflake के लिए नए हैं, उनके लिए Introduction to Snowflake for Beginners आवश्यक पृष्ठभूमि ज्ञान प्रदान करता है।
Snowflake आर्किटेक्चर के मुख्य सिद्धांत
Snowflake की आर्किटेक्चर पारंपरिक डेटा वेयरहाउस डिज़ाइनों से अलग है क्योंकि यह स्केलेबिलिटी और प्रदर्शन संबंधी चुनौतियों को हल करने के लिए आधुनिक क्लाउड सिद्धांतों का उपयोग करती है। यह आर्किटेक्चर एक बहु-परत दृष्टिकोण लागू करती है जो स्टोरेज, कंप्यूट और सर्विसेज़ को अलग-अलग लेकिन आपस में जुड़े घटकों में विभाजित करती है।
Snowflake की आर्किटेक्चर परतें
स्रोत: Snowflake प्रलेखन
Snowflake की आर्किटेक्चर एक अनोखी तीन-परत डिज़ाइन अपनाती है जो मुख्य कार्यक्षमताओं को अलग करते हुए निर्बाध एकीकरण बनाए रखती है। आइए प्रत्येक परत को विस्तार से देखें:
1. स्टोरेज परत
Snowflake की स्टोरेज परत क्लाउड ऑब्जेक्ट स्टोरेज (Amazon S3, Azure Blob Storage या Google Cloud Storage) पर निर्भर करती है और डेटा को 50–500MB के अपरिवर्तनीय माइक्रो-पार्टिशन में संपीड़ित कॉलमनर फ़ॉर्मेट में व्यवस्थित करती है। ये माइक्रो-पार्टिशन मेटाडेटा जैसे न्यूनतम/अधिकतम कॉलम मान संग्रहीत करते हैं, जिससे कुशल क्वेरी प्रूनिंग संभव होती है।
यह परत स्व-ऑप्टिमाइज़िंग है और किसी मैन्युअल मेंटेनेंस की आवश्यकता नहीं होती। यह डेटा प्रकार और पैटर्न के आधार पर प्रति कॉलम सर्वश्रेष्ठ कंप्रेशन एल्गोरिद्म बुद्धिमानी से चुनती है, जिससे उच्च कंप्रेशन अनुपात और तेज़ विश्लेषणात्मक क्वेरी सुनिश्चित होती हैं, क्योंकि केवल आवश्यक कॉलम पढ़े जाते हैं।
2. कंप्यूट परत
कंप्यूट परत वर्चुअल वेयरहाउसों से बनी होती है—स्वतंत्र MPP क्लस्टर जो SQL क्वेरियाँ और DML ऑपरेशंस निष्पादित करते हैं। प्रत्येक वेयरहाउस कई नोड्स पर समानांतर रूप से चलता है और पूर्ण पृथकता में कार्य करता है ताकि प्रदर्शन में बाधा न आए।
ये स्टेटलेस संसाधन डेटा को प्रभावित किए बिना शुरू, बंद, रीसायज़ या क्लोन किए जा सकते हैं। रीसायज़िंग स्वतः वर्कलोड को पुनर्वितरित करती है, जबकि ऑटो-सस्पेंशन सुविधा निष्क्रिय वेयरहाउसों को रोकती है और आवश्यकता होने पर उन्हें कुछ ही सेकंड में फिर शुरू कर देती है।
3. सर्विसेज़ परत
सर्विसेज़ परत Snowflake के संचालन का समन्वयन करती है, एक वितरित मेटाडेटा स्टोर का प्रबंधन करती है जो टेबल्स, व्यूज़, सुरक्षा नीतियों और क्वेरियों को ट्रैक करता है। क्वेरी ऑप्टिमाइज़र इस मेटाडेटा का लाभ उठाकर डेटा वितरण, कंप्यूट संसाधन और एक्सेस पैटर्न के आधार पर कुशल निष्पादन योजनाएँ बनाता है।
यह उन्नत समवर्तीता नियंत्रण के साथ ACID अनुपालन सुनिश्चित करती है, साथ ही SSO, MFA और रोल-आधारित एक्सेस कंट्रोल के माध्यम से सभी स्तरों पर प्रमाणीकरण संभालती है। यह परत सत्र प्रबंधन और सुरक्षा प्रवर्तन भी करती है।
परतें साथ मिलकर कैसे काम करती हैं
Snowflake की परतों के बीच की अंतःक्रिया सुरक्षित डेटा शेयरिंग, मल्टी-क्लस्टर कंप्यूटिंग और डायनेमिक स्केलेबिलिटी जैसी शक्तिशाली क्षमताएँ सक्षम करती है। डेटा शेयरिंग मेटाडेटा-चालित होती है—केवल पॉइंटर्स का आदान-प्रदान होता है, जबकि अभिगम को सूक्ष्म-स्तरीय सुरक्षा नीतियों से नियंत्रित किया जाता है। उपभोक्ता अपने स्वयं के कंप्यूट संसाधनों का उपयोग करके बिना डुप्लीकेशन के साझा डेटा पर क्वेरी चला सकते हैं।
मल्टी-क्लस्टर कंप्यूटिंग स्वतंत्र कंप्यूट क्लस्टरों को एक ही स्टोरेज परत तक पहुँचने देती है, जबकि अलग-अलग कैश बनाए रखती है और सुसंगतता सुनिश्चित करती है। ETL, BI या डेटा साइंस के लिए समर्पित वेयरहाउस आवंटित करके वर्कलोड्स को अलग किया जा सकता है। Snowflake की आर्किटेक्चर डायनेमिक स्केलेबिलिटी को भी सपोर्ट करती है, जिससे स्टोरेज और कंप्यूट स्वतंत्र रूप से स्केल हो सकते हैं, और सर्विसेज़ परत संसाधन आवंटन व क्वेरी प्रदर्शन का अनुकूलन करती है।
इन अवधारणाओं और अन्य विषयों में गहराई से जाने के लिए, आप Introduction to Snowflake कोर्स देख सकते हैं।
Snowflake की डेटा वेयरहाउस आर्किटेक्चर
Snowflake की डेटा वेयरहाउस आर्किटेक्चर अपनी तीन-परत डिज़ाइन पर आधारित है, जो लचीला डेटा मॉडलिंग और कुशल क्वेरी प्रोसेसिंग प्रदान करती है। यह स्ट्रक्चर्ड और सेमी-स्ट्रक्चर्ड डेटा दोनों को सपोर्ट करती है, प्रदर्शन को अनुकूलित करते हुए प्रबंधन को सरल बनाती है।
डेटा मॉडल
Snowflake रिलेशनल डेटाबेस अवधारणाओं का उपयोग करके संरचित डेटा को समायोजित करता है, SQL डेटा प्रकारों, बाधाओं और प्राथमिक तथा विदेशी कुंजियों के माध्यम से संबंधों का समर्थन करता है। संवेदनशील जानकारी के लिए कॉलम-स्तरीय एन्क्रिप्शन लाभकारी होता है। सेमी-स्ट्रक्चर्ड डेटा के लिए, Snowflake मूल रूप से VARIANT डेटा प्रकार का उपयोग करके JSON, XML, Parquet और Avro को संभालता है, स्वतः स्कीमा का अनुमान लगाता है और FLATTEN तथा PARSE_JSON जैसी विशेष फ़ंक्शनों के साथ कुशल क्वेरी सक्षम करता है।
स्टोरेज स्तर पर, डेटा स्वतः 50–500MB के माइक्रो-पार्टिशन में विभाजित हो जाता है, जिनमें से प्रत्येक में न्यूनतम/अधिकतम कॉलम मान और नल आवृत्तियों जैसे मेटाडेटा संग्रहीत होते हैं। Snowflake नैचुरल क्लस्टरिंग को ट्रैक करता है और समय-समय पर डेटा को पुनर्गठित करता है ताकि क्वेरी दक्षता में सुधार हो, जिससे मैन्युअल पार्टिशन प्रबंधन की आवश्यकता समाप्त हो जाती है।
क्वेरी प्रोसेसिंग आर्किटेक्चर
Snowflake कई समन्वित परतों के माध्यम से क्वेरियों को प्रोसेस करता है जो निष्पादन का अनुकूलन करती हैं। क्वेरी ऑप्टिमाइज़र SQL क्वेरियों को लॉजिकल निष्पादन योजनाओं में बदलता है और तालिका आकार, इंडेक्सिंग और कैशिंग के आधार पर कई भौतिक योजनाओं का मूल्यांकन करता है। एक कॉस्ट मॉडल का उपयोग करके, यह सबसे कुशल दृष्टिकोण का चयन करता है, जॉइन एल्गोरिद्म, सॉर्टिंग विधियाँ और डेटा मूवमेंट रणनीतियाँ निर्धारित करता है।
एक्ज़ीक्यूशन इंजन क्वेरियों को समानांतर प्रोसेसिंग नोड्स पर वितरित करता है। मेटाडेटा का लाभ उठाकर, यह अनावश्यक पार्टिशन को प्रून करता है और Snowflake के कॉलमनर स्टोरेज फ़ॉर्मेट में केवल प्रासंगिक कॉलम पढ़ता है, जिससे दक्षता बढ़ती है। 24 घंटे का रिज़ल्ट कैश अंतर्निहित डेटा अपरिवर्तित रहने पर पहले से गणना किए गए क्वेरी परिणामों का पुन: उपयोग करके प्रदर्शन को और बेहतर बनाता है।
Snowflake की आर्किटेक्चर कुशल डेटा अभिगम पैटर्न सक्षम करती है। ज़ीरो-कॉपी क्लोनिंग बिना डेटा कॉपी किए तालिकाओं की त्वरित प्रतिकृति की अनुमति देती है, जबकि टाइम ट्रैवल पॉइंट-इन-टाइम क्वेरियों के लिए ऐतिहासिक संस्करण सुरक्षित रखता है। मल्टी-वर्ज़न कंकरेन्सी कंट्रोल (MVCC) लेनदेन सुसंगतता सुनिश्चित करता है, जिससे लॉकिंग संघर्षों के बिना उच्च समवर्ती वर्कलोड संभव होते हैं। ये ऑप्टिमाइज़ेशन, बुद्धिमान कैशिंग और पार्टिशन प्रूनिंग के साथ मिलकर, Snowflake को न्यूनतम मैन्युअल हस्तक्षेप के साथ स्केलेबल, उच्च-प्रदर्शन विश्लेषिकी देने में सक्षम बनाते हैं।
उन्नत Snowflake फीचर्स
एंटरप्राइज़ क्षमताओं को बढ़ाने के लिए Snowflake संसाधन प्रबंधन, सुरक्षा, इंटीग्रेशन और मॉनिटरिंग में उन्नत फीचर्स प्रदान करता है।
संसाधन प्रबंधन
इसका डायनेमिक रिसोर्स मैनेजमेंट वेयरहाउस शेड्यूलिंग और ऑटो-स्केलिंग शामिल करता है, जो निष्क्रिय वेयरहाउसों को स्वतः रोकता है और वर्कलोड मांगों के आधार पर कंप्यूट संसाधनों को समायोजित करता है। प्रशासक स्वचालित स्टार्ट/स्टॉप शेड्यूल सेट कर सकते हैं और लागत व प्रदर्शन को अनुकूलित करने के लिए विस्तृत संसाधन मीट्रिक्स का लाभ उठा सकते हैं।
क्वेरी गवर्नेंस
क्वेरी गवर्नेंस फीचर्स संसाधन खपत पर सटीक नियंत्रण देते हैं, जिनमें डायनेमिक लिमिट्स, इंटेलिजेंट क्यूइंग और कस्टम क्वेरी रूटिंग शामिल हैं, जिससे प्रभावी वर्कलोड प्रबंधन सुनिश्चित होता है।
एंटरप्राइज़ इंटीग्रेशन
एंटरप्राइज़ इंटीग्रेशन के लिए, Snowflake JavaScript और Java में स्टोर्ड प्रोसीजर्स का समर्थन करता है, जिससे डेवलपर्स SQL से परे जटिल व्यावसायिक लॉजिक लागू कर सकते हैं।
वर्ज़न कंट्रोल आसान रोलबैक सक्षम करता है, जबकि एरर हैंडलिंग विस्तृत लॉगिंग के साथ सुचारु निष्पादन सुनिश्चित करती है। प्लेटफ़ॉर्म का सुरक्षित डेटा एक्सचेंज फ़्रेमवर्क संगठनों को निजी डेटा मार्केटप्लेस के माध्यम से डेटासेट साझा करने और उनसे कमाई करने की अनुमति देता है।
कंपनियाँ अभिगम को नियंत्रित कर सकती हैं, उपयोग को ट्रैक कर सकती हैं और स्वचालित बिलिंग लागू कर सकती हैं, जिससे अनुपालन और सुरक्षा बनाए रखते हुए नए राजस्व अवसर बनते हैं।
ये फीचर्स मिलकर Snowflake की स्थिति को एक समग्र डेटा प्लेटफ़ॉर्म के रूप में मज़बूत करते हैं, जो स्केलेबिलिटी, स्वचालन और सुरक्षा प्रदान करता है। बुद्धिमान वर्कलोड प्रबंधन, निर्बाध इंटीग्रेशन और मज़बूत गवर्नेंस टूल्स के साथ, संगठन प्रदर्शन का अनुकूलन कर सकते हैं, लागत घटा सकते हैं और डेटा एसेट्स पर सुरक्षित रूप से सहयोग कर सकते हैं।
आर्किटेक्चर तुलना
आइए Snowflake की आर्किटेक्चर की पारंपरिक डेटा वेयरहाउस और आधुनिक प्रतिस्पर्धियों से तुलना करके इसके विशिष्ट मूल्य प्रस्ताव को समझें।
पारंपरिक डेटा वेयरहाउस
मुख्य आर्किटेक्चरल अंतर:
लागत मॉडल तुलना:
प्रदर्शन विशेषताएँ:
आधुनिक प्रतिस्पर्धी
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
अतिरिक्त प्रदर्शन संबंधी विचार:
1. क्वेरी ऑप्टिमाइज़ेशन
2. कंकरेन्सी हैंडलिंग
3. स्टोरेज आर्किटेक्चर
4. लागत संरचना में भिन्नताएँ
5. इंटीग्रेशन क्षमताएँ
ये आर्किटेक्चरल अंतर निम्न पर प्रभाव डालते हैं:
इन अवधारणाओं में महारत हासिल करने के लिए एक संरचित दृष्टिकोण के लिए, देखें व्यापक Snowflake सीखने की गाइड।
यहाँ इन अंतरों का सार प्रस्तुत करने वाली एक तालिका है:
निष्कर्ष
Snowflake ने क्लाउड में कंपनियों के डेटा के साथ काम करने के तरीके को बदल दिया है, इसे पुराने सिस्टम की तुलना में आसान और अधिक कुशल बना दिया है। Snowflake की बनावट कंपनियों को अपने डेटा के स्टोरेज और प्रोसेसिंग को अलग-अलग रखने देती है, जिससे वे तेज़ परिणाम पाते हुए लागत बचा सकते हैं। Snowflake की मज़बूत सुरक्षा विशेषताओं की बदौलत कंपनियाँ आश्वस्त रह सकती हैं कि उनका डेटा सुरक्षित है। यह सिस्टम विभिन्न क्लाउड प्रदाताओं पर सुचारु रूप से काम करता है, जिससे व्यवसायों को यह लचीलापन मिलता है कि वे अपना डेटा कहाँ रखें।
जो भी Snowflake के बारे में और सीखना चाहते हैं, उनके लिए DataCamp पर अनेक सहायक संसाधन और प्रशिक्षण सामग्री उपलब्ध हैं।
प्लेटफ़ॉर्म निरंतर विकसित हो रहा है, और कृत्रिम बुद्धिमत्ता जैसी नई क्षमताओं के साथ व्यवसायों के लिए और भी शक्तिशाली बनता जा रहा है। Snowflake का उपयोग करने वाली कंपनियाँ समय के साथ अपनी बदलती डेटा ज़रूरतों के अनुसार तेज़ी से अनुकूल हो सकती हैं। जैसे-जैसे अधिक संगठन इसे अपने प्रमुख डेटा प्रबंधन प्लेटफ़ॉर्म के रूप में चुनते हैं, Snowflake का भविष्य उज्ज्वल दिखता है।