
Corso
Introduzione a Snowflake SQL
2 ore
57.7K
Snowflake è una piattaforma dati basata sul cloud che affronta le sfide fondamentali della gestione dei dati moderna. Lanciata nel 2014, offre alle organizzazioni una soluzione centralizzata per archiviare ed elaborare operazioni dati su larga scala.
I sistemi tradizionali di gestione dei dati presentano spesso limiti significativi. In genere costringono le aziende a scegliere tra prestazioni delle query, accesso concorrente degli utenti ed economicità. L'architettura di Snowflake è stata sviluppata per eliminare questi vincoli grazie al suo approccio all'archiviazione e all'elaborazione dei dati.
Questa guida analizza il framework architetturale e i meccanismi operativi di Snowflake. Anche se la piattaforma integra tecnologie complesse, l'obiettivo qui è rendere questi concetti accessibili a chi ha una conoscenza di base dei sistemi dati.
La guida affronterà:
Questa analisi ti fornirà una comprensione di base di come Snowflake funziona all'interno dell'infrastruttura dati moderna.
Per chi è nuovo a Snowflake, la Introduzione a Snowflake per principianti offre le nozioni di base essenziali.
L'architettura di Snowflake si differenzia dai tradizionali data warehouse adottando principi cloud moderni per risolvere le sfide di scalabilità e prestazioni. L'architettura implementa un approccio multilivello che separa storage, compute e servizi in componenti distinti ma connessi.
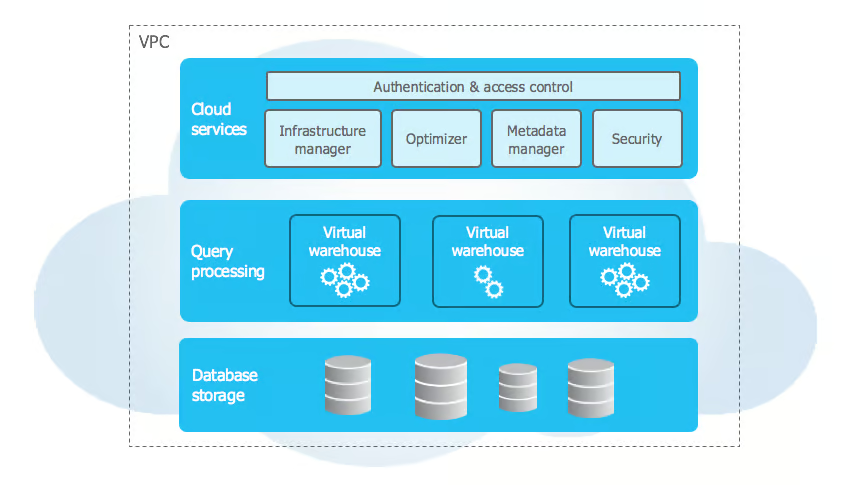
Fonte: documentazione Snowflake
L'architettura di Snowflake utilizza un esclusivo design a tre livelli che separa le funzionalità principali mantenendo un'integrazione fluida. Vediamo ciascun livello nel dettaglio:
Il livello di storage di Snowflake si basa su object storage nel cloud (Amazon S3, Azure Blob Storage o Google Cloud Storage) e organizza i dati in micro-partizioni immutabili (50–500 MB) in formato colonnare compresso. Queste micro-partizioni memorizzano metadati come i valori min/max delle colonne, abilitando un pruning efficiente delle query.
Questo livello si ottimizza da solo e non richiede manutenzione manuale. Seleziona in modo intelligente il miglior algoritmo di compressione per colonna in base al tipo di dato e ai pattern, garantendo alti rapporti di compressione e query analitiche rapide leggendo solo le colonne necessarie.
Il livello di compute è composto da warehouse virtuali—cluster MPP indipendenti che eseguono query SQL e operazioni DML. Ogni warehouse esegue più nodi in parallelo, operando in totale isolamento per evitare interferenze di prestazioni.
Queste risorse stateless possono essere avviate, arrestate, ridimensionate o clonate senza influire sui dati. Il ridimensionamento redistribuisce automaticamente i carichi, mentre la sospensione automatica mette in pausa i warehouse inattivi e li riattiva in pochi secondi quando necessario.
Il livello dei servizi orchestra le operazioni di Snowflake, gestendo un archivio metadati distribuito che tiene traccia di tabelle, viste, policy di sicurezza e query. L'ottimizzatore di query sfrutta questi metadati per generare piani di esecuzione efficienti in base alla distribuzione dei dati, alle risorse di calcolo e ai pattern di accesso.
Garantisce la conformità ACID con un controllo della concorrenza avanzato, gestendo al contempo l'autenticazione tramite SSO, MFA e controllo degli accessi basato sui ruoli a tutti i livelli. Questo livello gestisce anche le sessioni e l'applicazione delle misure di sicurezza.
L'interazione tra i livelli di Snowflake abilita funzionalità potenti come la condivisione sicura dei dati, il calcolo multi-cluster e la scalabilità dinamica. La condivisione dei dati è guidata dai metadati—vengono scambiati solo puntatori, mentre l'accesso è controllato con policy di sicurezza granulari. I consumer possono interrogare i dati condivisi utilizzando le proprie risorse di calcolo senza duplicazioni.
Il calcolo multi-cluster consente a cluster di compute indipendenti di accedere allo stesso livello di storage mantenendo cache separate e garantendo la consistenza. I carichi possono essere isolati dedicando warehouse a ETL, BI o data science. L'architettura di Snowflake supporta anche la scalabilità dinamica, permettendo a storage e compute di scalare in modo indipendente mentre il livello dei servizi ottimizza l'allocazione delle risorse e le prestazioni delle query.
Per approfondire questi concetti e altro ancora, esplora il corso Introduction to Snowflake.
L'architettura del data warehouse di Snowflake si basa sul design a tre livelli per offrire modellazione dati flessibile ed elaborazione efficiente delle query. Supporta dati strutturati e semi-strutturati ottimizzando le prestazioni e semplificando la gestione.
Snowflake gestisce i dati strutturati utilizzando concetti di database relazionali, supportando tipi di dato SQL, vincoli e relazioni tramite chiavi primarie ed esterne. Le informazioni sensibili beneficiano della crittografia a livello di colonna. Per i dati semi-strutturati, Snowflake gestisce nativamente JSON, XML, Parquet e Avro usando il tipo di dato VARIANT, inferendo automaticamente gli schemi e abilitando query efficienti con funzioni specializzate come FLATTEN e PARSE_JSON.
A livello di storage, i dati sono automaticamente suddivisi in micro-partizioni da 50–500 MB, ognuna con metadati come valori min/max delle colonne e frequenza dei null. Snowflake tiene traccia del clustering naturale e riorganizza periodicamente i dati per migliorare l'efficienza delle query, eliminando la necessità di gestire manualmente le partizioni.
Snowflake elabora le query attraverso più livelli coordinati che ne ottimizzano l'esecuzione. L'ottimizzatore trasforma le query SQL in piani di esecuzione logici e valuta più piani fisici in base a dimensione delle tabelle, indicizzazione e caching. Utilizzando un modello di costi, seleziona l'approccio più efficiente, determinando algoritmi di join, metodi di ordinamento e strategie di movimentazione dei dati.
Il motore di esecuzione distribuisce le query tra nodi di elaborazione paralleli. Sfruttando i metadati, elimina le partizioni non necessarie e legge solo le colonne pertinenti nel formato colonnare di Snowflake, migliorando l'efficienza. Una cache dei risultati di 24 ore migliora ulteriormente le prestazioni riutilizzando i risultati di query già calcolati quando i dati sottostanti non sono cambiati.
L'architettura di Snowflake abilita pattern di accesso ai dati efficienti. Il cloning senza copia consente la duplicazione istantanea delle tabelle senza copiare i dati, mentre il time travel preserva le versioni storiche per query puntuali. Il controllo della concorrenza multi-versione (MVCC) garantisce la consistenza delle transazioni, permettendo carichi ad alta concorrenza senza conflitti di lock. Queste ottimizzazioni, unite a caching intelligente e pruning delle partizioni, consentono a Snowflake di offrire analytics scalabili e ad alte prestazioni con un intervento manuale minimo.
Snowflake offre funzionalità avanzate in ambito gestione delle risorse, sicurezza, integrazione e monitoraggio per potenziare le capacità enterprise.
La gestione dinamica delle risorse include pianificazione dei warehouse e auto-scaling, mettendo automaticamente in pausa i warehouse inattivi e regolando le risorse di calcolo in base ai carichi. Gli amministratori possono impostare pianificazioni di avvio/arresto automatiche e sfruttare metriche dettagliate per ottimizzare costi e prestazioni.
Le funzionalità di governance delle query offrono un controllo preciso sul consumo di risorse, con limiti dinamici, accodamento intelligente e routing personalizzato delle query, garantendo una gestione efficiente dei carichi.
Per l'integrazione enterprise, Snowflake supporta stored procedure in JavaScript e Java, permettendo agli sviluppatori di implementare logiche di business complesse oltre SQL.
Il controllo di versione consente rollback semplici, mentre la gestione degli errori assicura un'esecuzione fluida con log dettagliati. Il framework sicuro di scambio dati della piattaforma permette alle organizzazioni di condividere e monetizzare dataset tramite marketplace privati.
Le aziende possono controllare gli accessi, tracciare l'utilizzo e implementare la fatturazione automatizzata, creando nuove opportunità di ricavo mantenendo conformità e sicurezza.
Queste funzionalità rafforzano la posizione di Snowflake come piattaforma dati completa, offrendo scalabilità, automazione e sicurezza. Con una gestione intelligente dei carichi, integrazioni fluide e strumenti di governance solidi, le organizzazioni possono ottimizzare le prestazioni, ridurre i costi e collaborare in sicurezza sugli asset dati.
Confrontiamo l'architettura di Snowflake con i data warehouse tradizionali e con i concorrenti moderni per comprenderne la proposta di valore unica.
Differenze architetturali chiave:
Confronto dei modelli di costo:
Caratteristiche prestazionali:
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
Altre considerazioni sulle prestazioni:
Queste differenze architetturali influenzano:
Per un approccio strutturato a questi concetti, consulta la guida completa all'apprendimento di Snowflake.
Ecco una tabella riepilogativa di queste differenze:
| Aspetto | BigQuery | Redshift | Synapse | Snowflake |
|---|---|---|---|---|
| Architettura | Serverless | Basata su cluster | Ibrida (serverless e dedicata) | Multi-cluster, dati condivisi |
| Storage | Colonnare con auto-sharding | Distribuzione basata su nodi | Rowstore e columnstore | Colonnare a micro-partizioni |
| Ottimizzazione delle query | Automatica, controllo limitato | Vacuum/analyze manuali | Indicizzazione e statistiche manuali | Ottimizzazione automatica |
| Concorrenza | Allocazione basata su slot | WLM basato su code | Classi di risorse | Scalabilità dei warehouse virtuali |
| Modello di prezzo | Per byte scansionato | Orario per nodo | Basato su DTU/vCore | Per secondo di utilizzo del warehouse |
| Integrazione | Servizi nativi GCP | Ecosistema AWS | Piattaforma Azure | Supporto multi-cloud |
| Gestione delle risorse | Automatizzata | Gestione manuale dei nodi | Gestione complessa dei pool | Automatica con controllo manuale |
| Supporto tipi di dato | Forte per semi-strutturati | Limitato per semi-strutturati | Limitato per semi-strutturati | Nativo per semi-strutturati |
| Manutenzione | Minima | Richiede vacuum regolare | Necessaria manutenzione degli indici | Zero manutenzione |
| Caching | Automatico 24 ore | Gestito dall'utente | Limitato integrato | Caching automatico dei risultati |
Snowflake ha cambiato il modo in cui le aziende lavorano con i dati nel cloud, rendendolo più semplice ed efficiente rispetto ai sistemi precedenti. Il modo in cui Snowflake è costruito permette di archiviare ed elaborare i dati separatamente, aiutando a risparmiare pur mantenendo risultati rapidi. Grazie alle solide funzionalità di sicurezza di Snowflake, le aziende possono sentirsi sicure che i propri dati siano protetti. Il sistema funziona senza problemi su diversi provider cloud, offrendo alle imprese maggiore flessibilità su dove conservare i dati.
Per chi vuole saperne di più su Snowflake, su DataCamp sono disponibili molte risorse utili e materiali di formazione.
La piattaforma continua a crescere con nuove funzionalità, come capacità di intelligenza artificiale, che la rendono ancora più potente per le aziende. Le organizzazioni che utilizzano Snowflake possono adattarsi rapidamente man mano che le loro esigenze dati cambiano nel tempo. Il futuro appare promettente per Snowflake, dato che sempre più realtà la scelgono come piattaforma principale per la gestione dei dati.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



