
{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Snowflake SQL
{hours} uur
58K
Snowflake is een cloudgebaseerd dataplatform dat de fundamentele uitdagingen van modern databeheer aanpakt. Het werd gelanceerd in 2014 en biedt organisaties een gecentraliseerde oplossing voor het opslaan en verwerken van grootschalige data-operaties.
Traditionele databeheersystemen brengen vaak flinke beperkingen met zich mee. Bedrijven moeten in zulke systemen doorgaans kiezen tussen queryprestaties, gelijktijdige gebruikerstoegang en kostenefficiëntie. De architectuur van Snowflake is ontwikkeld om deze beperkingen weg te nemen met zijn aanpak van dataopslag en -verwerking.
Deze gids onderzoekt het architecturale raamwerk en de operationele mechanismen van Snowflake. Hoewel het platform complexe technologieën omvat, richt deze uitleg zich op het toegankelijk maken van de concepten voor lezers met een basiskennis van datasystemen.
De gids behandelt:
Deze analyse geeft je een basisbegrip van hoe Snowflake functioneert binnen moderne datainfrastructuren.
Voor lezers die nieuw zijn met Snowflake biedt de Introduction to Snowflake for Beginners essentiële achtergrondkennis.
De architectuur van Snowflake verschilt van traditionele datawarehouses door moderne cloudprincipes te gebruiken om schaalbaarheids- en prestatieproblemen op te lossen. De architectuur implementeert een meerlagige aanpak die storage, compute en services opdeelt in afzonderlijke maar verbonden componenten.
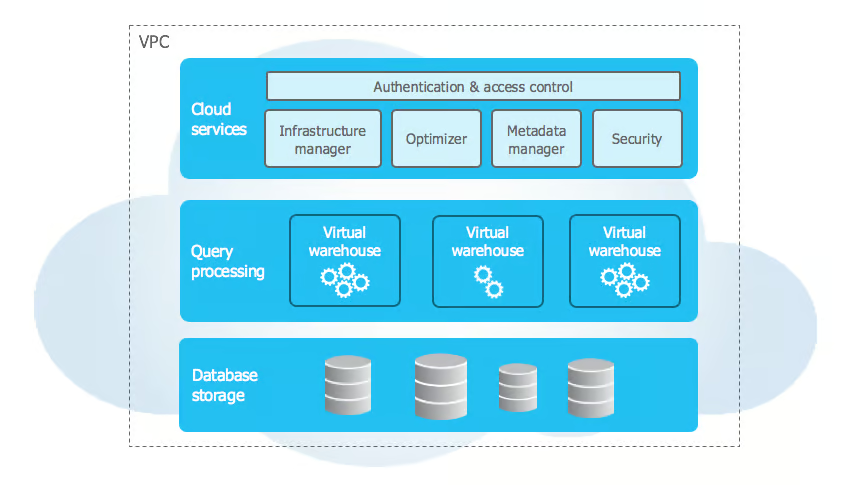
De architectuur van Snowflake gebruikt een unieke drielagenopzet die kernfunctionaliteiten scheidt en toch naadloos integreert. Laten we elke laag in detail bekijken:
De opslaglaag van Snowflake vertrouwt op cloudobjectopslag (Amazon S3, Azure Blob Storage of Google Cloud Storage) en organiseert data in onveranderlijke micro-partities (50–500 MB) in een gecomprimeerd kolomformaat. Deze micro-partities slaan metadata op, zoals min/max-waarden per kolom, wat efficiënt query-prunen mogelijk maakt.
Deze laag optimaliseert zichzelf en vereist geen handmatig onderhoud. Per kolom wordt intelligent het beste compressie-algoritme gekozen op basis van datatype en patronen, wat hoge compressieratio’s en snelle analytische queries oplevert doordat alleen de benodigde kolommen worden gelezen.
De compute-laag bestaat uit virtuele warehouses—onafhankelijke MPP-clusters die SQL-queries en DML-bewerkingen uitvoeren. Elk warehouse draait meerdere nodes parallel en werkt volledig geïsoleerd om prestatie-interferentie te voorkomen.
Deze stateless resources kunnen worden gestart, gestopt, vergroot/verkleind of gekloond zonder de data te beïnvloeden. Resizing verdeelt workloads automatisch opnieuw, terwijl de auto-suspensionfunctie inactieve warehouses pauzeert en ze binnen seconden hervat wanneer nodig.
De services-laag orkestreert de werking van Snowflake en beheert een gedistribueerde metadatastore die tabellen, views, beveiligingsbeleid en queries bijhoudt. De queryoptimizer benut deze metadata om efficiënte uitvoeringsplannen te genereren, gebaseerd op datadistributie, compute-resources en toegangspatronen.
Het waarborgt ACID-naleving met geavanceerde gelijktijdigheidscontrole en handelt authenticatie af via SSO, MFA en role-based access control op alle niveaus. Deze laag beheert ook sessieafhandeling en handhaving van beveiliging.
De interactie tussen Snowflake’s lagen maakt krachtige mogelijkheden mogelijk, zoals veilig datadelen, multi-cluster computing en dynamische schaalbaarheid. Datadeling is metadatagestuurd—alleen verwijzingen worden uitgewisseld, terwijl toegang wordt beheerst met fijnmazige beveiligingsregels. Afnemers kunnen gedeelde data query’en met hun eigen compute-resources zonder duplicatie.
Multi-cluster computing laat onafhankelijke compute-clusters dezelfde opslaglaag benaderen, met behoud van gescheiden caches en gegarandeerde consistentie. Workloads kunnen worden geïsoleerd door warehouses toe te wijzen aan ETL, BI of data science. De architectuur van Snowflake ondersteunt bovendien dynamische schaalbaarheid, waarbij storage en compute onafhankelijk kunnen opschalen, terwijl de services-laag resourceallocatie en queryprestaties optimaliseert.
Voor een verdiepende duik in deze en andere concepten kun je de Introduction to Snowflake-cursus verkennen.
De datawarehouse-architectuur van Snowflake bouwt voort op de drielagenopzet om flexibel datamodelleren en efficiënte queryverwerking te bieden. Het ondersteunt gestructureerde en semi-gestructureerde data, optimaliseert prestaties en vereenvoudigt beheer.
Snowflake ondersteunt gestructureerde data met relationele databaseconcepten, inclusief SQL-datatypen, constraints en relaties via primaire en vreemde sleutels. Gevoelige informatie profiteert van versleuteling op kolomniveau. Voor semi-gestructureerde data verwerkt Snowflake native JSON, XML, Parquet en Avro via het VARIANT-datatype, waarbij schema’s automatisch worden afgeleid en efficiënt query’en mogelijk is met functies als FLATTEN en PARSE_JSON.
Op opslagniveau wordt data automatisch verdeeld in micro-partities van 50–500 MB, die metadata opslaan zoals min/max-waarden en de frequentie van nulls per kolom. Snowflake volgt natuurlijke clustering en herorganiseert data periodiek om query-efficiëntie te verbeteren, waardoor handmatig partitiebeheer overbodig is.
Snowflake verwerkt queries via meerdere gecoördineerde lagen die de uitvoering optimaliseren. De queryoptimizer zet SQL-queries om in logische uitvoeringsplannen en evalueert meerdere fysieke plannen op basis van tabelgrootte, indexing en caching. Met een kostenmodel kiest hij de meest efficiënte aanpak en bepaalt join-algoritmen, sorteermethoden en databewegingsstrategieën.
De execution engine verdeelt queries over parallelle verwerkingsnodes. Door metadata te benutten snoeit hij overbodige partities en leest hij alleen relevante kolommen in het kolomformaat van Snowflake, wat de efficiëntie verbetert. Een resultatencache van 24 uur verhoogt de prestaties verder door eerder berekende queryresultaten te hergebruiken wanneer de onderliggende data ongewijzigd is.
De architectuur van Snowflake maakt efficiënte datatoegangspatronen mogelijk. Zero-copy cloning biedt directe duplicatie van tabellen zonder data te kopiëren, terwijl time travel historische versies bewaart voor point-in-time-queries. Multi-version concurrency control (MVCC) zorgt voor transactieregulariteit, waardoor workloads met hoge gelijktijdigheid mogelijk zijn zonder lockconflicten. Deze optimalisaties, gecombineerd met slimme caching en partitiepruning, stellen Snowflake in staat schaalbare analytics met hoge prestaties te leveren met minimale handmatige interventie.
Snowflake biedt geavanceerde features op het gebied van resourcebeheer, beveiliging, integratie en monitoring om enterprisemogelijkheden te versterken.
Het dynamische resourcebeheer omvat warehouseplanning en autoscaling, waarbij inactieve warehouses automatisch worden gepauzeerd en compute-resources worden aangepast op basis van workloadbehoeften. Beheerders kunnen automatische start/stop-schema’s instellen en gedetailleerde resourcemetrics gebruiken om kosten en prestaties te optimaliseren.
De querygovernancefuncties bieden nauwkeurige controle over resourceverbruik, inclusief dynamische limieten, intelligente wachtrijen en aangepaste queryrouting, voor efficiënt workloadbeheer.
Voor enterprise-integratie ondersteunt Snowflake stored procedures in JavaScript en Java, zodat ontwikkelaars complexe bedrijfslogica buiten SQL kunnen implementeren.
Versiebeheer maakt eenvoudig rollback mogelijk, terwijl foutafhandeling zorgt voor soepele uitvoering met gedetailleerde logging. Het veilige raamwerk voor data-uitwisseling van het platform stelt organisaties in staat datasets te delen en te gelde te maken via private datamarktplaatsen.
Bedrijven kunnen toegang beheren, gebruik bijhouden en geautomatiseerde facturatie implementeren, wat nieuwe inkomstenkansen creëert met behoud van compliance en beveiliging.
Deze features versterken samen Snowflake’s positie als een compleet dataplatform, met schaalbaarheid, automatisering en beveiliging. Met intelligent workloadbeheer, naadloze integraties en robuuste governancetools kunnen organisaties prestaties optimaliseren, kosten verlagen en veilig samenwerken aan data-assets.
Laten we de architectuur van Snowflake vergelijken met traditionele datawarehouses en moderne concurrenten om de unieke waardepropositie te begrijpen.
Belangrijkste architectuurverschillen:
Kostenmodelvergelijking:
Prestatiekenmerken:
1. Amazon Redshift
2. Google BigQuery
3. Azure Synapse
Aanvullende prestatie-overwegingen:
Deze architectuurverschillen hebben impact op:
Voor een gestructureerde aanpak om deze concepten onder de knie te krijgen, raadpleeg de uitgebreide Snowflake-leidraad.
Hier is een tabel die deze verschillen samenvat:
| Aspect | BigQuery | Redshift | Synapse | Snowflake |
|---|---|---|---|---|
| Architectuur | Serverless | Clustergebaseerd | Hybride (serverless & dedicated) | Multi-cluster, gedeelde data |
| Opslag | Kolomgebaseerd met auto-sharding | Nodegebaseerde distributie | Rowstore & columnstore | Micro-gepartitioneerde kolomopslag |
| Queryoptimalisatie | Automatisch, beperkte controle | Handmatig vacuum/analyze | Handmatige indexing & stats | Automatische optimalisatie |
| Gelijktijdigheid | Slotgebaseerde toewijzing | Wachtrijgebaseerde WLM | Resourceclasses | Schaalbare virtuele warehouses |
| Prijsmodel | Per gescande byte | Nodegebaseerd per uur | DTU/vCore-gebaseerd | Per seconde warehouse-gebruik |
| Integratie | GCP-native services | AWS-ecosysteem | Azure-platform | Multi-cloudondersteuning |
| Resourcebeheer | Geautomatiseerd | Handmatig nodenbeheer | Complex poolbeheer | Geautomatiseerd met handmatige controle |
| Ondersteuning datatypes | Sterk in semi-gestructureerd | Beperkt in semi-gestructureerd | Beperkt in semi-gestructureerd | Native semi-gestructureerd |
| Onderhoud | Minimaal | Regelmatig vacuum vereist | Indexonderhoud nodig | Nul onderhoud |
| Caching | Automatisch 24 uur | Door gebruiker beheerd | Beperkt ingebouwd | Automatische result caching |
Snowflake heeft de manier waarop bedrijven met data in de cloud werken veranderd, door het eenvoudiger en efficiënter te maken dan oudere systemen. De manier waarop Snowflake is opgebouwd, maakt het mogelijk om opslag en verwerking te scheiden, zodat bedrijven kosten besparen en toch snelle resultaten behalen. Dankzij de sterke beveiligingsfuncties van Snowflake kunnen bedrijven erop vertrouwen dat hun data veilig is. Het systeem werkt soepel over verschillende cloudproviders heen, waardoor organisaties meer flexibiliteit krijgen in waar ze hun data onderbrengen.
Voor iedereen die meer wil leren over Snowflake zijn er veel nuttige resources en trainingsmaterialen beschikbaar op DataCamp.
Het platform blijft groeien met nieuwe features, zoals mogelijkheden op het gebied van artificiële intelligentie, die het nog krachtiger maken voor bedrijven. Organisaties die Snowflake gebruiken kunnen zich snel aanpassen wanneer hun databehoeften in de loop van de tijd veranderen. De toekomst ziet er rooskleurig uit voor Snowflake nu steeds meer organisaties het kiezen als hun belangrijkste platform voor databeheer.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

