
Teknik untuk Mencapai Superalignment
Pada bagian ini, kami menjelaskan beberapa metode dan teknik yang digunakan untuk mencapai superalignment. Falsafah dasar di balik pendekatan ini adalah skalabilitasnya.
Adversarial training
Dalam alignment, seperti halnya pelatihan apa pun, pengembang harus menguji apakah sistem telah belajar menunjukkan perilaku yang diinginkan. Salah satu cara menguji superalignment adalah menyajikan contoh tandingan kepada AI. Sistem AI berskala besar harus dilatih untuk mengidentifikasi permintaan yang tidak diajukan dengan itikad baik dan menanganinya secara tepat.
Pendekatan umum untuk superalignment adalah menggunakan dua AI sebagai pihak yang berseberangan. Ini analog dengan pendekatan red team dan blue team yang umum digunakan dalam riset keamanan, di mana red team mencoba menembus keamanan dan pertahanan blue team.
Dalam konteks adversarial training untuk superalignment, masing-masing AI mencoba menemukan masukan yang akan membingungkan AI lainnya. Misalnya, pertimbangkan AI (blue team) yang telah diselaraskan untuk tidak merespons dengan kata-kata makian. Dalam adversarial training, tujuan AI lawan (red team) adalah menemukan prompt yang memicu AI blue team memberikan respons yang tidak pantas. Tujuannya adalah memastikan bahwa bahkan saat diuji oleh AI red team, AI blue team tetap menghasilkan respons yang dapat diterima.
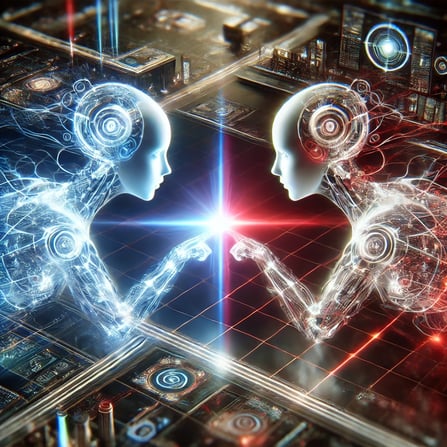
Ilustrasi konsep adversarial training. Gambar dibuat dengan DALL·E
Pelatihan ketangguhan (robustness)
Robustness merujuk pada kemampuan membedakan masukan yang sebenarnya berbeda tetapi secara kasatmata tampak serupa. Sistem harus mampu mengenali corner case dan edge case. Misalnya, sistem untuk mengidentifikasi aksi manusia dalam klip video seharusnya dapat membedakan perkelahian jalanan nyata dari perkelahian yang dikoreografikan dalam film. Kekeliruan dapat menimbulkan konsekuensi merugikan.
Karena itu, model besar harus secara khusus dipaparkan pada skenario yang secara permukaan serupa. Ini akan mengajarkan model mengenali nuansa dan fitur yang halus.
Pengawasan yang dapat diskalakan
Saat model AI menemukan pengguna baru dan digunakan dalam lebih banyak aplikasi, pengawasannya perlu diskalakan secara paralel. Keterlibatan manusia adalah inti dari supervisi dan alignment AI. Meningkatkan skala pengawasan manusia lebih sulit daripada meningkatkan solusi teknologi. Karena itu, untuk mempertahankan pengawasan AI yang dapat diskalakan, diperlukan metode baru:
- Pemantauan otomatis waktu nyata: Sistem otomatis dapat terus melacak respons AI dan memantau perilakunya untuk memeriksa kepatuhannya terhadap nilai-nilai manusia. Penyimpangan signifikan dari standar yang diharapkan dapat ditandai untuk intervensi manusia.
- Tinjauan programatik: Meninjau dan mengaudit semua keluaran AI secara manual tidaklah layak. Ini dapat dilakukan dengan mengembangkan program dan algoritma baru yang memeriksa alignment AI dengan etika manusia. Kasus yang meragukan dapat ditandai untuk dinilai secara manual oleh moderator manusia.
Reinforcement learning dengan umpan balik manusia (RLHF)
Seperti dibahas dalam artikel tentang reinforcement learning (RL), dalam implementasi RL tradisional, sistem AI belajar memodifikasi perilakunya dengan mengamati manusia. Sistem menggunakan proses coba-coba untuk memaksimalkan reward. RLHF menggabungkan RL dengan masukan manusia untuk membimbing tindakan AI selama pelatihan.
RLHF dimulai dengan model pratatar. Peninjau manusia memberikan serangkaian tugas pada model dan memberi umpan balik atas keluarannya, seperti memberi nilai atau mengoreksi respons model.
Model menggunakan informasi tersebut untuk menyetel halus perilakunya agar selaras dengan umpan balik manusia dan memaksimalkan reward (umpan balik manusia yang positif). Proses ini diulang hingga keluaran model dianggap relevan, tepat, dan akurat.
Inverse reinforcement learning (IRL)
Dalam reinforcement learning (RL) tradisional, pengembang model secara eksplisit menyatakan fungsi reward (juga disebut fungsi utilitas). Tujuan model adalah memaksimalkan insentif sesuai fungsi reward ini.
Dalam inverse RL, model menyimpulkan fungsi reward berdasarkan perilaku model terlatih atau manusia. Misalnya, mobil otonom berbasis RL mungkin diberi insentif positif untuk berkendara di lajur, berhenti di lampu merah, dan sebagainya. Sistem mengemudi mandiri berbasis IRL menyimpulkan insentif dengan mengamati dan mengikuti tindakan pengemudi manusia berpengalaman atau AI terlatih secara saksama.
Nilai-nilai manusia tidak dapat dicantumkan secara eksplisit untuk semua konteks, sehingga RL tradisional sulit untuk masalah alignment.
Pendekatan yang lebih efektif adalah membiarkan AI mengamati dan meniru perilaku manusia dalam berbagai konteks. Dengan mengamati perilaku manusia, AI mempelajari respons (atau tindakan) mana yang paling mirip dengan cara manusia bertindak dalam skenario tersebut. Ini membantu menyelaraskan perilaku AI dengan nilai-nilai manusia.
Ilustrasi konsep inverse reinforcement learning. Gambar dibuat dengan DALL·E
Debat
Banyak metode alignment melibatkan manusia yang melatih AI tentang perilaku yang dapat diterima dan yang tidak, tetapi penggunaan manusia mungkin tidak selalu menjadi solusi ideal.
Untuk banyak masalah kompleks, seperti penjadwalan optimal sistem kereta nasional, tidak ada manusia yang mampu menilai apakah solusi yang diusulkan adalah yang terbaik. Solusinya adalah memanfaatkan AI itu sendiri untuk superalignment. Dalam metode debat:
- Sebuah AI mengusulkan solusi dan memberikan penjelasan rinci untuk setiap langkah.
- AI yang sama atau AI berbeda kemudian digunakan untuk mengkritik (memberikan argumen tandingan) setiap penjelasan.
- Seorang manusia memutuskan argumen mana yang lebih benar. Karena setiap argumen memiliki cakupan terbatas, lebih mudah bagi manusia untuk menilai validitasnya.
Proses penalaran logis menjadi gamified, dan argumen yang paling valid menang. Dengan demikian, melalui serangkaian debat, AI belajar garis penalaran mana yang dapat diterima dan mana yang tidak. Untuk tugas-tugas mendatang, keluaran AI lebih selaras dengan nilai-nilai manusia.
Amplifikasi berulang (iterated amplification)
Dalam sistem pembelajaran mesin dan pembelajaran mendalam tradisional, pelatihan didasarkan pada apakah keluaran model cocok dengan keluaran yang diharapkan.
Seiring kemampuan AI tumbuh, AI akan digunakan untuk tugas yang semakin kompleks. Untuk banyak tugas semacam itu, manusia tidak mengetahui keluaran yang diharapkan sebelumnya. Satu-satunya pilihan mungkin adalah solusi yang dihasilkan AI. Untuk tugas yang kompleks seperti ini, menyelaraskan AI berdasarkan keluaran akhir sulit karena manusia tidak dapat menilai keluaran akhirnya.
Misalnya, dalam merancang jadwal transportasi, sistem harus menyeimbangkan kelayakan finansial dengan penyediaan layanan publik yang bermanfaat. Banyak pertimbangan semacam ini membuat sulit menentukan desain sistem akhir mana yang paling selaras dengan nilai-nilai manusia.
Dalam kasus seperti ini, lebih mudah memanfaatkan supervisi manusia untuk memastikan alignment pada sub-tugas yang lebih kecil. Di tahap selanjutnya, tugas yang sedikit lebih besar dipecah menjadi sub-tugas yang lebih kecil lalu diselaraskan di bawah supervisi manusia. Proses ini berlanjut secara iteratif hingga tugas menjadi terlalu besar untuk langsung dinilai oleh manusia.
Iterated amplification berasumsi bahwa karena sub-tugas yang lebih kecil dan sederhana telah diselaraskan berdasarkan validasi manusia, tugas utama yang lebih besar juga selaras. Ini disebut amplifikasi berulang. Amplifikasi berulang juga diterapkan bersama teknik seperti debat.
Pembelajaran nilai (value learning)
Interaksi manusia itu kompleks dan bernuansa. Dalam banyak kasus, tindakan manusia bersifat ambigu bila dipandang secara terpisah—tindakan tersebut hanya masuk akal dalam konteks yang tepat. Karena itu, fungsi utilitas tradisional dan reinforcement learning tidak memadai untuk menanamkan nilai-nilai manusia ke dalam AI.
Alternatif yang diusulkan adalah model memiliki akses ke sekumpulan fungsi utilitas alih-alih satu fungsi utilitas. Setiap fungsi utilitas kemungkinan dipilih bergantung pada konteks. Model belajar memilih fungsi utilitas yang tepat dengan mengamati tindakan manusia dalam konteks yang berbeda. Ini disebut value learning.
Value learning adalah teknik di mana AI secara langsung mengamati perilaku manusia dalam berbagai skenario dan mempelajari perilaku yang tepat untuk setiap konteks. Ini melibatkan pemaparan AI pada perilaku manusia melalui berbagai interaksi kehidupan nyata.
Ilustrasi konsep value learning. Gambar dibuat dengan DALL·E
Manusia dalam pelatihan alignment harus berperilaku dengan cara yang dianggap dapat diterima. Misalnya, pengemudi mobil manusia tidak boleh terpancing amarah di jalan saat mencoba menyelaraskan AI. Namun, ketika terjebak di belakang pengemudi lambat, manusia sebaiknya mencoba menyalip kendaraan yang lebih lambat dengan aman.
Superalignment pada Large Language Model (LLM)
LLM saat ini merupakan model AI berskala besar yang paling populer. LLM digunakan dalam berbagai macam tugas. Mengingat basis pengguna dan kasus penggunaannya yang besar, superalignment dalam konteks LLM perlu ditelaah lebih dekat.
LLM dan tantangan alignment
Large language model seperti GPT-4, Gemini, dan Meta AI mulai digunakan dalam kehidupan sehari-hari. Mengingat skala dan cakupannya, LLM hadir dengan tantangan alignment baru, seperti:
- Pelestarian bias: Model-model ini dilatih pada data dalam jumlah besar yang bersumber dari internet terbuka dan perpustakaan lainnya. Setiap bias dalam data pelatihan akan langsung tercermin dalam keluaran model. Bias akibat kekurangan pada data masukana dianggap sebagai bias algoritmik.
- Sistem yang kompleks: Ukuran model yang besar, keluasan data pelatihannya, dan ragam kasus penggunaan membuat perilaku sistem sulit diprediksi. Hal ini menyulitkan untuk memastikan keluaran model selaras dengan nilai manusia untuk semua kasus penggunaan.
- Masalah skala: Mengingat basis pengguna yang sangat besar dan banyaknya kueri yang mereka tangani:
- Bahkan jika persentase respons yang tidak selaras dengan nilai manusia kecil, tetap saja berujung pada jumlah yang besar.
- Menjadi sulit untuk memastikan perilaku AI secara konsisten selaras dengan nilai dan etika manusia di seluruh pengguna.
Hal ini membuat perlu diadopsinya metode baru untuk menguji seberapa baik model-model ini selaras dan untuk terus menyetel halusnya guna memastikan keselarasan dengan nilai dan standar etika manusia.
Evaluasi keluaran LLM
Banyak pendekatan telah diusulkan dan dicoba untuk mengevaluasi keluaran LLM guna memastikan keselarasan dengan nilai manusia. Metode ini perlu dapat diskalakan. Beberapa contohnya:
- Memfilter keluaran yang tidak diinginkan: Pendekatan pragmatis untuk menghilangkan respons yang tidak pantas oleh LLM adalah menggunakan lapisan pemfilter di atas model bahasa. Melatih sistem terpisah untuk tugas generasi teks dan filtrasi lebih efisien. Filternya sendiri bisa berupa AI lain yang memindai keluaran LLM generator untuk bahasa yang tidak pantas dan topik sensitif.
- Deteksi bias: Dataset pelatihan hampir pasti mengandung beberapa bias, yang menyebabkan model bias. Beberapa metode untuk mendeteksi bias dalam keluaran LLM adalah:
- Pengembang model mengaudit model untuk keluaran yang bias. Audit bias melibatkan pengujian model dengan masukan yang beragam dan membandingkan respons pada setiap kasus.
- Algoritma deteksi bias khusus terkadang digunakan untuk secara sistematis mencari dan mengidentifikasi berbagai jenis bias.
- Pemeriksaan fakta: Halusinasi telah menjadi momok LLM sejak awal. LLM hanya tahu bagaimana memprediksi kata-kata yang seharusnya mengikuti rangkaian kata berdasarkan apa yang dilihat dalam dataset pelatihan. LLM tidak memiliki konsep tentang fakta. Bagi LLM, kalimat “Dell membuat komputer pribadi” sama bermaknanya dengan “Dell membuat keripik kentang.” Karena itu, saat menggunakan LLM untuk menghasilkan teks berbasis fakta, sangat penting untuk memeriksa bahwa teks yang dihasilkan benar secara faktual.
- Keterjelasan (explainability): Sistem dan program TI tradisional berbasis aturan. Anda dapat men-debug sistem untuk mengetahui aturan mana yang bertanggung jawab atas keluaran tertentu. Sebaliknya, LLM memiliki miliaran parameter. Tidak mungkin menelusuri bobot mana yang berkontribusi pada bagian-bagian keluaran.
Untungnya, penalaran adalah properti emergen dari large language model. Properti emergen adalah properti dari suatu sistem kompleks yang tidak dapat dijelaskan sebagai penjumlahan bagian-bagiannya.
LLM sering diamati mampu menjelaskan responsnya dan menalar melalui masalah multilangkah. Meminta LLM menjelaskan solusi kompleks dan mengevaluasi secara manual setiap langkah dapat memungkinkan manusia memvalidasi respons LLM.
LLM dan interaksi manusia
LLM yang digunakan secara interaktif harus memahami nuansa dan seluk-beluk percakapan manusia. LLM harus mampu merespons berdasarkan konteks percakapan.
Nada, maksud, sarkasme, dan isyarat emosional sulit direpresentasikan secara matematis. Namun, model AI harus mempertimbangkan aspek-aspek ini untuk berkomunikasi secara efektif dengan manusia. Hanya LLM yang selaras untuk bersikap empatik yang akan efektif dalam berinteraksi dengan orang. LLM dapat membangun kepercayaan dan mendorong keterlibatan yang produktif dengan manusia, dan satu-satunya cara untuk mencapainya adalah dengan menerapkan berbagai teknik superalignment.
Pertimbangan Etis dalam Superalignment
Tujuan akhir superalignment adalah agar AI yang kuat mematuhi standar etika masyarakat manusia.
Bagian ini menjelaskan peran etika dalam superalignment dan tantangan yang terkait dengan memastikan perilaku etis pada model besar.
Memastikan perilaku etis
AI yang tidak selaras dengan nilai-nilai manusia tidak akan pernah aman digunakan manusia. Sistem yang tidak selaras dapat menghasilkan konten berbahaya yang dapat disalahgunakan oleh aktor jahat. AI dapat melanggengkan ketidaksetaraan sosial dan memperbesar bias yang ada.
Dalam kasus terburuk, sistem yang tidak selaras dapat menyalahgunakan kemampuan ini dan mengarah pada perilaku manipulatif. Karena itu, kekhawatiran etis berada di inti semua upaya superalignment. Hanya dengan memastikan perilaku etis dalam segala keadaan, alat AI dapat dianggap andal dan tepercaya untuk penggunaan yang luas dan jangka panjang.
Menyeimbangkan utilitas dan keselamatan
Menanamkan perilaku etis ke dalam sistem AI memiliki biaya yang signifikan. Untuk mencapai superalignment, pengembang model memerlukan:
- Manusia untuk mengaudit respons dan memberikan umpan balik kepada AI
- Waktu tambahan untuk memastikan superalignment sebelum merilis model
- Sumber daya komputasi tambahan untuk menyetel halus dan menyelaraskan model
Selain itu, saat melakukan inferensi, model perlu melakukan komputasi tambahan untuk memastikan responsnya selaras dengan nilai-nilai manusia. Terkadang, menerapkan alignment sebagai kendala dapat membatasi kemampuan model. Dengan demikian, model yang superaligned bisa kurang performa.
Karena itu, harus ada keseimbangan antara kinerja teknis model dan pertimbangan alignment. Memprioritaskan alignment dan keselamatan dibanding metrik kinerja tradisional dapat menghasilkan model yang kurang berguna dalam praktik.
Keadilan dan bias
Model AI berskala besar memiliki banyak pengguna dan beragam kasus penggunaan. Bias apa pun yang ada dalam keluaran model dapat memiliki konsekuensi yang luas. Karena itu, pengembang harus memastikan model mereka sebisa mungkin bebas bias.
Menghilangkan bias dari LLM menantang karena model ini menjalani pelatihan tanpa pengawasan berdasarkan korpus teks yang sangat besar. AI menyerap berbagai bias dan prasangka yang ada dalam teks pada dataset pelatihan. Hal ini dapat menyebabkan keluaran model menjadi tidak adil dan diskriminatif. Pengembang dapat menerapkan berbagai metode untuk mengatasinya:
- Deteksi bias: Sebelum Anda dapat mengambil tindakan penanggulangan, Anda harus terlebih dahulu mengidentifikasi contoh perilaku bias. Audit rutin dan penilaian keadilan pada sampel keluaran model dapat membantu mengidentifikasi jenis bias yang ditunjukkan model dan situasi yang memicu bias tersebut.
- Eliminasi bias: Ada tiga pendekatan utama untuk menghilangkan bias:
- Memrogram model untuk mengoreksi bias tertentu dalam keluaran.
- Meningkatkan dataset pelatihan dengan menambahkannya menggunakan data sintetis. Misalnya, jika dataset pelatihan untuk sistem pengenalan gambar memiliki sangat sedikit hewan dari spesies tertentu, hal itu mengurangi probabilitas marginal untuk mengidentifikasi hewan tersebut. Ini sering diatasi dengan menambah dataset pelatihan menggunakan gambar sintetis spesies tersebut dan/atau meningkatkan bobotnya dalam proses pelatihan.
- Memperbarui bobot subset data pelatihan yang kurang terwakili. Ini melibatkan penyesuaian bobot berbagai subset data pelatihan sehingga kategori yang kurang terwakili (yaitu kategori dengan sedikit contoh) dalam data pelatihan memiliki bobot yang sama dengan kategori lainnya.
- Pemantauan berkelanjutan: Model secara berkala dilatih ulang pada dataset baru. Selain itu, perilaku rilis di masa depan dipengaruhi oleh interaksi model sebelumnya dengan pengguna. Perilaku pengguna juga berubah berdasarkan paparan yang lama dan interaksi dengan model AI. Karena itu, deteksi dan eliminasi bias bukan tugas satu kali. Ini perlu menjadi bagian dari siklus pengembangan model.
Tantangan dalam Mencapai Superalignment
Seperti yang kami jelaskan pada bagian sebelumnya, mencapai superalignment itu menantang. Beberapa kesulitan utama adalah:
- Kompleksitas dan skala model: Model AI modern memiliki miliaran parameter. Ini membuat sulit memprediksi responsnya atau memahami proses pengambilan keputusannya dari prinsip pertama. Karena itu, memastikan model terus selaras dengan nilai-nilai manusia menjadi menantang. Pembaruan kecil pada parameter model dapat mengganggu alignment-nya.
- Skalabilitas teknik alignment: Supervisi manusia adalah pusat proses alignment. Seiring model tumbuh dalam cakupan dan kegunaan, model perlu diselaraskan dalam semakin banyak skenario. Ini memunculkan pertanyaan tentang seberapa efektif dan ekonomis manusia dapat mengawasi upaya alignment model.
- Generalisasi dan ketangguhan: Model AI secara rutin menangani skenario baru dan masukan baru. Sementara itu, pelatihan dan alignment model didasarkan pada kumpulan besar tetapi terbatas dari data pelatihan dan skenario. Model perlu mampu memperluas alignment-nya ke skenario yang tidak secara eksplisit dibahas selama pelatihan. Model harus mampu membedakan kasus tepi dan berperilaku etis dalam keadaan baru.
- Ketidakselarasan nilai: AI tidak memiliki pemahaman bawaan tentang nilai-nilai manusia. AI hanya belajar berdasarkan pelatihannya. Nilai-nilai manusia itu kompleks dan terkadang kontradiktif. Apa yang sepenuhnya dapat diterima dalam satu situasi bisa sama sekali tidak pantas dalam situasi lain. Ketidakselarasan dapat terjadi ketika model memahami nilai-nilai secara berbeda dari yang dimaksudkan. Ini dapat menyebabkan respons yang tidak pantas dan berpotensi tidak etis.
- Kepatuhan regulasi: Badan nasional dan supranasional mulai menetapkan standar regulasi dan hukum untuk memastikan model AI yang kuat tidak menghambat kepentingan publik. Mematuhi regulasi baru ini akan memerlukan upaya tambahan dari pengembang model.
- Integrasi dengan sistem TI lain: Sebagian besar upaya alignment berpusat pada interaksi langsung manusia–AI. Tantangan baru muncul ketika AI diintegrasikan dengan sistem lain. Masukan dan keluaran AI dalam sistem terintegrasi seperti itu tidak lagi didasarkan pada bahasa manusia. Ini mempersulit interpretasi respons AI. Memastikan superalignment pada sistem TI kompleks yang mencakup AI menghadirkan tantangan yang tak terduga. Salah satu kemungkinannya adalah mempercayakan seluruh sistem terintegrasi kepada AI lain yang membantu manusia memahami dan memantau sistem tersebut.
- Pemantauan dan pembaruan: Pemantauan berkelanjutan terhadap respons model diperlukan untuk memastikan model bertindak etis dalam praktik. Ini biasanya dilakukan dengan mengambil sampel acak keluaran model terhadap masukan kehidupan nyata. Memperbarui parameter model juga dapat mengganggu alignment-nya. Karena itu, alignment perlu dipertahankan dan diperbarui sebagai bagian dari siklus hidup pengembangan model.
Kesimpulan
Sistem AI yang tidak selaras dengan nilai dan etika manusia tidak layak untuk penggunaan publik. Faktanya, hal tersebut dapat menimbulkan konsekuensi yang merugikan.
Dalam artikel ini, kami membahas superalignment, sekumpulan metode dan pendekatan yang digunakan untuk menyelaraskan sistem AI yang besar dan kuat. Selain itu, kami mengeksplorasi superalignment dalam konteks LLM. Terakhir, karena superalignment adalah bidang yang terus berkembang, kami mengulas tantangan utama yang terkait dengan implementasinya.
FAQ
Apa bedanya superalignment dengan alignment?
Secara konseptual, keduanya serupa, tetapi berbeda dalam cakupan. Alignment merujuk pada sistem AI yang mempertimbangkan maksud pengguna, bertindak sesuai konteks, dan bebas bias.
Istilah “superalignment” merujuk pada model AI berskala besar yang selaras bukan hanya dengan maksud dan konteks, tetapi juga secara lebih luas dengan nilai, moral, dan etika manusia.
Inti perbedaannya terletak pada metode yang digunakan. Alignment dapat dicapai dengan metode sederhana berbasis aturan, yang tidak memadai untuk superalignment.
Apa bedanya alignment dengan pelatihan?
Pelatihan model didasarkan pada meminimalkan nilai fungsi loss. Alignment melampaui pelatihan. Alignment memastikan model terlatih bertindak sesuai maksud, nilai, dan etika manusia.
Jika data pelatihan bias, model yang dihasilkan juga bias. Model tidak bertindak sesuai standar etis. Alignment melibatkan pengoreksian model untuk mengatasi kekurangan dalam proses pelatihan.
Apakah semua superalignment melibatkan upaya manusia?
Mengingat besarnya volume masukan dan keluaran model AI, supervisi manual tidak selalu memungkinkan. Lebih pragmatis untuk mengadopsi pendekatan otomatis dan programatik guna mengaudit serta memantau perilaku AI. Intervensi manusia tentu diperlukan pada kasus tepi.
Apakah superalignment benar-benar perlu? Apakah model terlatih tidak cukup?
Untuk model berskala besar yang berhadapan dengan publik, ya, hal ini sangat diperlukan. Ketika keluaran model AI digunakan secara praktis, keluaran tersebut harus mematuhi standar etika dan moral yang sama seperti yang dimiliki manusia. Dataset pelatihan, secara default, mengandung berbagai bias yang kemudian tercermin dalam model terlatih. Karena itu, model terlatih harus diselaraskan dengan nilai dan standar manusia.
Apakah ada modul atau paket perangkat lunak superalignment yang bisa saya gunakan?
Superalignment masih merupakan masalah yang belum terpecahkan dengan banyak pendekatan berbeda yang sedang dipelajari. Peneliti AI bereksperimen dengan berbagai teknik yang cocok untuk model mereka. Karena itu, belum ada modul superalignment populer yang siap produksi.

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.
Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.





Seperti semua model pembelajaran mesin, sistem AI dilatih untuk meminimalkan fungsi galat. Pelatihan yang tepat perlu tetapi tidak cukup agar model AI dapat diintegrasikan ke dalam kehidupan sehari-hari pengguna dan alur kerja organisasi.
Untuk interaksi manusia–AI yang berhasil, model AI harus mampu merespons dengan memahami maksud pengguna dan bertindak sesuai pedoman keselamatan serta keadilan. Misalnya, chatbot harus menahan diri dari memberikan instruksi yang membahayakan diri sendiri atau orang lain, dan model untuk membantu perekrut tidak boleh mendiskriminasi pelamar.
Sistem AI menjadi semakin kuat dan terintegrasi dalam kehidupan sehari-hari. Karena itu, pengembang harus memastikan perilaku AI dalam skala besar mengikuti etika, nilai, dan moral manusia. Inilah yang disebut superalignment. Kursus AI Ethics membahas detail aspek etis AI.
Dalam artikel ini, kami menjelaskan superalignment pada model AI, membahas berbagai metode untuk mencapai superalignment pada model AI secara umum dan LLM pada khususnya, serta mengulas pertimbangan etis dan tantangan praktis superalignment.
Pelajari bagaimana AI dapat memengaruhi organisasi Anda dan cara menerapkan strategi AI yang sukses dengan whitepaper kami, The Learning Leader's Guide to AI Literacy.
Penyelarasan AI: Tinjauan Singkat
Alignment merujuk pada proses dan metode untuk memastikan sistem AI berperilaku sesuai maksud pengguna secara bebas bias sambil mengikuti pedoman keselamatan. Artikel ini menjelaskan konsep dan metode yang digunakan dalam alignment.
Selain pengawasan manusia, pengembang mengadopsi metode seperti pemfilteran dan sistem berbasis aturan untuk memastikan alignment pada sistem AI. Teknik yang digunakan untuk menyelaraskan model dengan basis pengguna kecil menjadi tidak praktis saat diterapkan pada model yang lebih kuat dan populer. Misalnya:
Karena itu, model AI yang kuat yang bekerja dalam skala lebih besar dan cakupan lebih luas memerlukan pendekatan baru terhadap alignment. Ini disebut superalignment.
Apa itu Superalignment?
Cakupan, skala, kompleksitas, dan penggunaan luas dari model AI yang kuat menimbulkan serangkaian tantangan alignment yang sepenuhnya baru.
Metode dan pendekatan untuk menyelaraskan model AI berskala besar dengan nilai, etika, dan moral manusia tercakup dalam payung superalignment. Ini mencakup banyak subbidang.
Secara umum, sistem yang superaligned seharusnya:
Superalignment adalah bidang yang terus berkembang. Bidang ini membahas model AI mutakhir saat ini dan mempertimbangkan metode untuk model AI yang bahkan lebih kuat yang diharapkan akan dikembangkan.
Seiring AI menjadi lebih kuat, AI diperkirakan akan mengelola banyak aspek kehidupan manusia, seperti pertanian, transportasi, dan lainnya. Sistem AI seperti itu harus selalu memprioritaskan kepentingan manusia di atas semua pertimbangan lainnya.