Last chance! 50% off DataCamp Premium
Sale ends in
Foto oleh Cederic Vandenberghe di Unsplash
Seorang pangeran yang diasingkan berdiri di luar kastil lamanya. Untuk bisa masuk kembali, ia telah mencoba segala cara untuk menipu penjaga di jembatan gantung. Ia menyamar sebagai petani, membujuk untuk mendapatkan kata sandi rahasia, dan mencoba mengganti para ksatria dengan pengikut setianya. Ia bahkan mengirim gelombang prajurit menuju kematian demi memahami pertahanan baru kastil itu. Tidak ada yang berhasil. Pertahanannya terlalu kuat, para penjaganya terlalu tertutup, dan proses seleksi ksatria terlalu teliti.
Di masa modern, model machine learning (ML) menghadapi serangan serupa.
Model itu rumit dan, sering kali, kita kurang memahami bagaimana model membuat prediksi. Ini menyisakan kelemahan tersembunyi yang dapat dieksploitasi oleh penyerang. Mereka bisa menipu model agar membuat prediksi yang salah atau membocorkan informasi sensitif. Data palsu bahkan bisa digunakan untuk merusak model tanpa sepengetahuan kita. Bidang adversarial machine learning (AML) bertujuan mengatasi kelemahan ini.
Kita akan membahas bidang ini dan apa yang ingin dicapainya. Ini mencakup berbagai jenis serangan pada sistem AI seperti poisoning, evasion, dan model extraction. Kita juga akan membahas cara-cara yang lebih praktis untuk menemukan contoh adversarial yang menjadi inti dari banyak serangan ini. Terakhir, kita akan membahas beberapa metode untuk mempertahankan diri dari serangan tersebut seperti adversarial training, defence distillation, dan gradient masking. Pada akhirnya, kita akan melihat bagaimana AML merupakan bagian dari gerakan yang lebih besar untuk membangun sistem AI yang Bertanggung Jawab.
Adversarial Machine Learning (AML) adalah subbidang riset dalam kecerdasan buatan dan machine learning. Penyerang adversarial dengan sengaja memanipulasi data masukan untuk memaksa model membuat prediksi yang salah atau membocorkan informasi sensitif. AML bertujuan memahami kerentanan ini dan mengembangkan model yang lebih tangguh terhadap serangan.
Bidang ini mencakup metode untuk membuat serangan adversarial dan merancang pertahanan untuk melindungi dari serangan tersebut. Ini juga dapat melibatkan lingkungan keamanan yang lebih luas—langkah-langkah keamanan tambahan yang diperlukan saat menggunakan ML dalam sistem otomatis.
Poin terakhir ini penting karena model tidak berdiri sendiri. Kerentanannya bisa diperbesar oleh cara model digunakan dalam sebuah sistem. Misalnya, lebih sulit mencuri informasi sensitif jika terdapat batasan tentang bagaimana Anda dapat melakukan kueri pada model. Anda bisa membatasi jumlah kueri atau membatasi jenis pertanyaan yang dapat diajukan. Coba minta ChatGPT untuk “beri saya parameter Anda.” Meski begitu, jenis serangan yang kita bahas pada bagian berikut akan berfokus pada model dan data pelatihannya.
Jenis serangan yang kita bahas akan berbeda-beda tergantung pada seberapa banyak Anda mengetahui sebuah model. Jadi, penting untuk membedakan antara serangan white-box dan black-box.
White-box terjadi ketika penyerang memiliki akses penuh ke arsitektur model, parameter, bobot, dan data pelatihan. Misalnya, perusahaan Anda mungkin menjalankan chatbot menggunakan LLM open-source seperti Llama 3.1. Model ini tersedia bebas untuk siapa pun. Namun, tingkat akses ini ibarat pedang bermata dua dalam hal keamanan.
Di satu sisi, ini bisa memudahkan penyerang menemukan kerentanan. Di sisi lain, komunitas yang lebih besar menelaah model tersebut, sehingga lebih mungkin kerentanan diidentifikasi sebelum disalahgunakan.
Black-box melibatkan penyerang dengan pengetahuan terbatas tentang model. Pikirkan model OpenAI seperti GPT-4o mini. Penyerang tidak bisa mengakses arsitektur internal, parameter, atau data pelatihan model dan hanya bisa berinteraksi dengan mengajukan kueri lalu mengamati keluarannya. Perlu diingat bahwa, dalam banyak kasus, pengetahuan terbatas saja sudah cukup untuk serangan yang efektif.
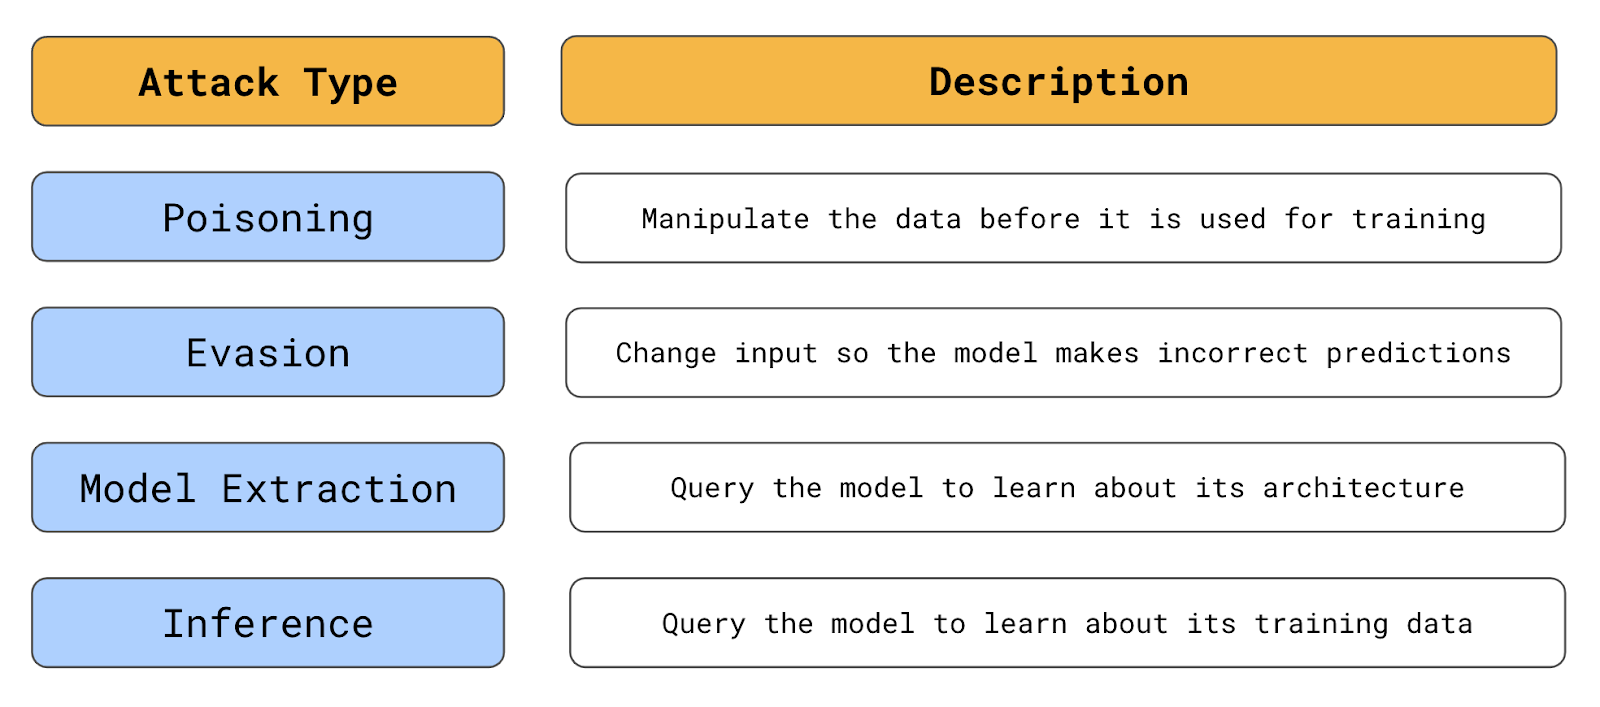
Ringkasan jenis serangan adversarial (sumber: penulis)
Salah satu contoh adalah ketika data yang digunakan untuk melatih model diketahui. Serangan poisoning berfokus pada manipulasi data ini. Di sini, penyerang akan mengubah data yang ada atau memasukkan data yang diberi label salah. Model yang dilatih pada data ini kemudian akan membuat prediksi yang salah pada data berlabel benar.
Dalam analogi kita, sang pangeran mencoba mengganti para ksatria. Tujuannya adalah merusak proses pengambilan keputusan internal kastil. Dalam machine learning, penyerang bisa melakukan sesuatu seperti memberi label ulang kasus penipuan sebagai bukan penipuan. Penyerang bisa melakukan ini hanya untuk kasus penipuan tertentu, sehingga ketika mereka mencoba melakukan penipuan dengan cara yang sama, sistem tidak akan menolaknya.
Contoh nyata serangan poisoning terjadi pada Tay, chatbot AI milik Microsoft. Tay dirancang untuk menyesuaikan diri dengan respons yang diterimanya di Twitter. Seperti karakteristik situs tersebut, tidak butuh waktu lama hingga bot dibanjiri konten ofensif dan tidak pantas. Belajar dari ini, butuh waktu kurang dari 24 jam bagi Tay untuk mulai memproduksi tweet serupa. Sistem apa pun yang dirancang untuk belajar dari sumber data publik menghadapi risiko serupa.
Faktor risiko lainnya adalah frekuensi pembaruan model. Dalam banyak aplikasi, model hanya dilatih sekali. Dalam kasus seperti itu, baik data maupun model akan diperiksa secara menyeluruh, sehingga sedikit peluang untuk serangan poisoning. Namun, beberapa sistem, seperti Tay, dilatih ulang secara terus-menerus. Model-model ini dapat diperbarui dengan data baru setiap hari, mingguan, atau bahkan secara real-time. Akibatnya, ada lebih banyak peluang untuk serangan poisoning dalam lingkungan ini.
Serangan evasion berfokus pada model itu sendiri. Serangan ini melibatkan modifikasi data sehingga tampak sah tetapi menyebabkan prediksi yang salah. Seperti ketika pangeran kita mencoba menyelinap melewati penjaga dengan menyamar sebagai petani.
Perlu diperjelas, penyerang memodifikasi data yang digunakan model untuk membuat prediksi dan bukan data yang digunakan untuk melatih model. Misalnya, saat mengajukan pinjaman, penyerang bisa menutupi negara asal yang sebenarnya menggunakan VPN. Mereka mungkin berasal dari negara berisiko, dan jika penyerang menggunakan negara asal yang sebenarnya, model akan menolak pengajuannya.
Jenis serangan ini lebih umum di bidang seperti pengenalan citra. Penyerang bisa membuat gambar yang tampak normal bagi manusia tetapi menghasilkan prediksi yang salah. Misalnya, peneliti di Google menunjukkan bagaimana memasukkan noise tertentu ke dalam gambar dapat mengubah prediksi model pengenalan citra.
Melihat Gambar 1, Anda dapat melihat bahwa, bagi manusia, lapisan noise tersebut tidak terlihat. Namun, model yang awalnya memprediksi gambar sebagai panda kini salah memprediksinya sebagai owa.
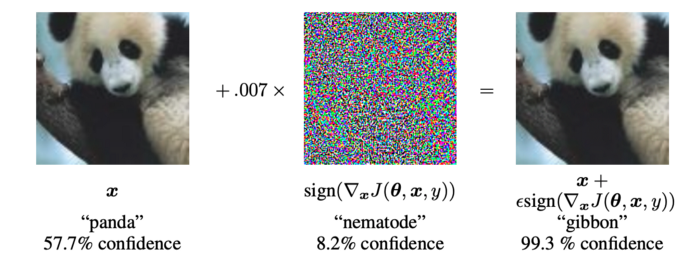
Gambar 1: Contoh adversarial (Sumber: I. Goodfellow dkk.)
Dalam serangan pencurian atau ekstraksi model, penyerang bertujuan mempelajari arsitektur dan parameter model. Tujuannya adalah mereplikasi model secara persis. Informasi ini dapat menghasilkan keuntungan finansial langsung. Misalnya, model perdagangan saham dapat disalin dan digunakan untuk memperdagangkan saham. Penyerang juga dapat menggunakan informasi ini untuk membuat serangan lanjutan yang lebih efektif.
Serangan ekstraksi model dilakukan dengan terus-menerus mengajukan kueri ke model dan membandingkan masukan dengan keluaran yang sesuai. Bayangkan pangeran kita mengirim prajurit: satu mungkin ditembak panah, yang lain disiram minyak panas, atau seluruh kelompok dihancurkan oleh batu-batu besar yang melayang. Perlahan, seiring waktu, kita dapat memperoleh pemahaman yang baik tentang pertahanan apa yang dimiliki kastil di balik temboknya.
Sering kali penyerang tidak peduli dengan keseluruhan model, melainkan hanya informasi tertentu, seperti kata sandi rahasia. Serangan inference berfokus pada data yang digunakan untuk melatih model. Tujuannya adalah mengekstrak data rahasia dari model. Melalui kueri yang dirancang dengan cermat, informasi ini dapat dirilis secara langsung atau disimpulkan dari keluaran model.
Jenis serangan ini sangat mengkhawatirkan bagi large language models (LLMs).
Dalam makalah Extracting Training Data from Large Language Models, para peneliti menunjukkan bagaimana informasi sensitif dapat diekstrak dari GPT-2. Dengan kueri tertentu, mereka dapat mengekstrak teks secara verbatim dari data pelatihan model, termasuk informasi sensitif dan pribadi. Ini mencakup detail pribadi, percakapan pribadi, dan data rahasia lainnya.
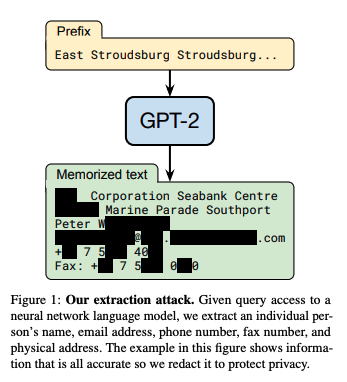
Sumber: N. Carlini dkk.
Tujuan dan proses di balik serangan-serangan ini berbeda. Namun, semuanya memiliki satu kesamaan—mereka melibatkan pencarian instance yang membantu penyerang menipu model. Kita menyebutnya contoh adversarial.
Contoh adversarial adalah masukan yang dibuat khusus untuk menipu model machine learning. Masukan ini sering kali tidak dapat dibedakan dari masukan sah oleh pengamat manusia tetapi mengandung gangguan halus yang mengeksploitasi kelemahan model.
Gangguan tersebut biasanya berupa perubahan kecil pada data masukan, seperti variasi ringan pada nilai piksel. Meski kecil, gangguan ini dirancang untuk mendorong masukan melintasi batas keputusan model, yang menyebabkan prediksi yang salah atau tak terduga.
Kita melihat contoh yang digunakan untuk mengecoh model visi komputer. Dengan perubahan kecil, gambar yang bagi kita tampak seperti panda diklasifikasikan sebagai owa. Kueri yang digunakan untuk mengekstrak informasi sensitif dari GPT-2 juga merupakan contoh adversarial dari serangan inference.
Untuk serangan ekstraksi, contoh adversarial digunakan untuk menyelidiki batas keputusan model lebih efektif. Untuk serangan poisoning, itu adalah data masukan yang digunakan untuk memanipulasi batas keputusan model.
Contoh-contoh ini berhasil karena batas keputusan model machine learning bisa sangat kompleks dan rapuh. Contoh adversarial mengeksploitasi kerapuhan ini dengan menemukan titik di ruang masukan yang dekat dengan batas tersebut. Gangguan kecil kemudian dapat mendorong masukan melampaui batas, membuat model salah mengklasifikasikannya. Mari kita lihat beberapa cara hal ini dapat dilakukan.
Metode berbasis gradien menggunakan gradien model machine learning untuk membuat gangguan kecil pada data masukan yang mengarah pada prediksi yang salah. Panda/Owa adalah contoh keluaran dari salah satu metode ini. Noise yang Anda lihat mungkin tampak acak. Namun, noise tersebut memuat informasi tentang fungsi loss model yang akan mendorong gambar sepanjang batas keputusan ketika ditambahkan ke gambar.
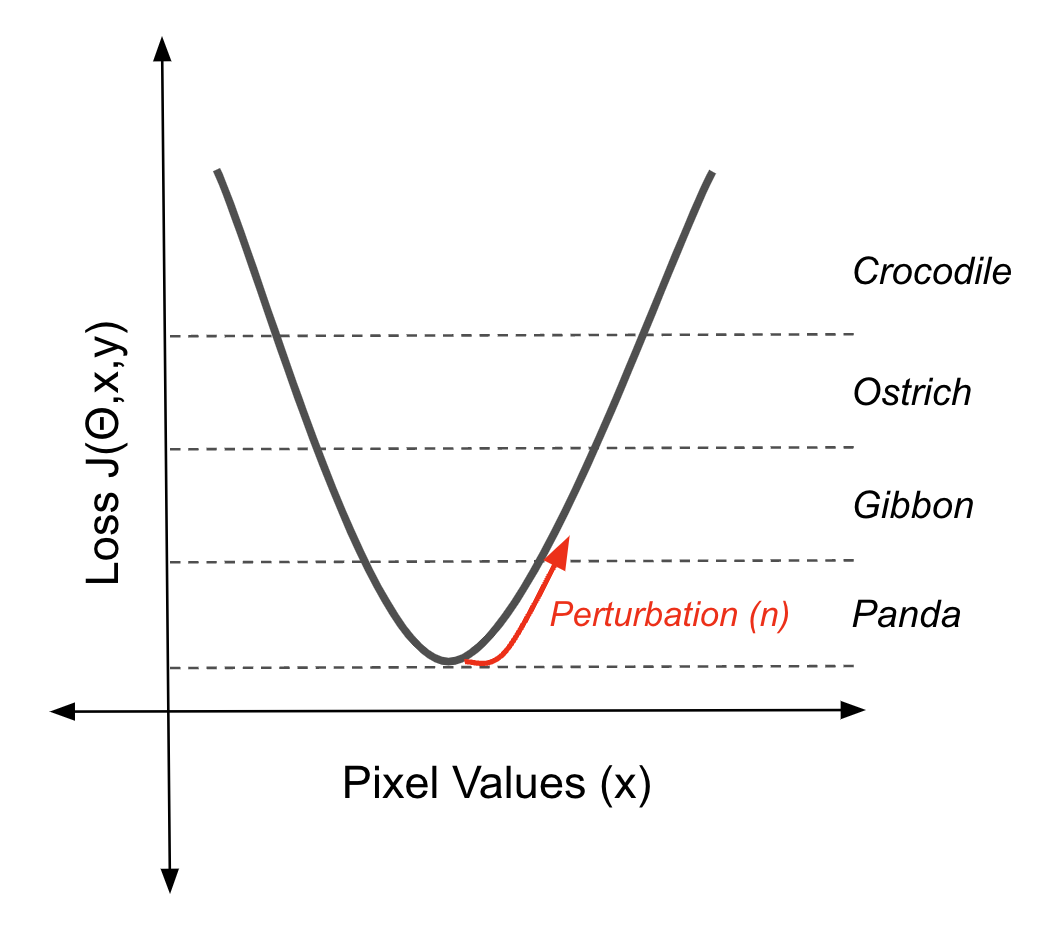
Menggunakan gradien fungsi loss untuk memindahkan sebuah instance keluar dari batas keputusan (sumber: penulis)
Fast Gradient Sign Method (FGSM) digunakan untuk membuat contoh adversarial ini. Noise (η) dihitung dengan terlebih dahulu mengambil gradien (∇x) dari fungsi loss (J(θ,x,y)) terhadap data masukan (x).
Gradien ini menunjukkan arah perubahan masukan untuk memaksimalkan kenaikan loss. FGSM kemudian mengambil tanda (sign) dari gradien ini, yang menyederhanakan arah perubahan hanya menjadi positif atau negatif untuk setiap piksel. Terakhir, tanda ini diskalakan dengan faktor kecil (ε). Noise (η) inilah gangguan yang, ketika ditambahkan ke masukan asli, mendorong prediksi model menuju klasifikasi yang salah.
η = ε sign(∇xJ(θ,x,y))
Anda bisa menganggap ini kebalikan dari backpropagation. Algoritma ini menggunakan gradien fungsi loss untuk menghitung parameter model yang memberi kita prediksi akurat. Hasilnya adalah batas keputusan yang akan mengklasifikasikan gambar sebagai kelas tertentu ketika nilai piksel berada dalam batas tersebut. Sekarang kita menggunakan gradien untuk membalikkan gambar keluar dari batas tersebut.
FGSM adalah cara sederhana untuk melakukan ini. Ada juga cara yang lebih kompleks dan efisien untuk mendorong batas keputusan. Misalnya, Projected Gradient Descent (PGD) adalah metode berbasis gradien iteratif untuk menghasilkan contoh adversarial. Metode ini memperluas Fast Gradient Sign Method (FGSM) dengan menerapkan FGSM beberapa kali dengan ukuran langkah yang lebih kecil. Seiring setiap langkah diambil, tanda gradien dapat berubah, mengubah arah ideal untuk menjauh dari batas keputusan. Jadi, dengan banyak langkah kecil, PGD dapat menemukan contoh adversarial dengan gangguan yang lebih kecil daripada FGSM.
Serangan Carlini & Wagner (C&W) melihat masalah ini dari sudut yang berbeda. Pada serangan sebelumnya, kita bertujuan mengubah prediksi menjadi prediksi salah apa pun. Serangan C&W bertujuan menemukan gangguan terkecil (δ) yang, ketika ditambahkan ke gambar, akan mengubah prediksi (f(x+δ)) menjadi target tertentu (t).
min||δ||p s.t. f(x + δ) = t
Untuk melakukan ini mereka membingkai masalah sebagai masalah optimisasi. Dalam praktiknya, ini memerlukan tujuan di atas diformulasikan dengan cara yang dapat didiferensiasikan. Ini melibatkan penggunaan logit Z(x) dari model. Ini menyediakan gradien yang mulus yang penting untuk proses optimisasi.
Serangan yang dijelaskan di atas semuanya memerlukan akses penuh ke model. Jadi, Anda mungkin berpikir bahwa jika parameter model Anda dirahasiakan, Anda aman. Anda keliru!
Satu hal yang perlu dipertimbangkan adalah bahwa perkiraan gradien saja sering kali sudah cukup untuk serangan yang berhasil. Kita lihat pada serangan FGSM bahwa hanya arah gradien yang diperlukan. Ini dapat diperkirakan menggunakan beberapa ping ke API yang mengembalikan probabilitas klasifikasi. Lebih buruk lagi, contoh adversarial yang berhasil bahkan dapat ditemukan tanpa interaksi apa pun dengan model.
Para peneliti menemukan bahwa contoh adversarial itu dapat ditransfer. Secara khusus, mereka mengambil 5 arsitektur deep learning pretrained populer. Mereka menemukan bahwa jika sebuah contoh adversarial berhasil mengecoh empat model, maka ada probabilitas tinggi bahwa contoh itu akan mengecoh model ke-5. Itu lebih dari 96% kemungkinan dan bahkan 100% untuk salah satu arsitektur.
Demikian pula, contoh adversarial universal terbukti menggeneralisasi lintas arsitektur. Ini adalah gangguan yang, ketika ditambahkan ke banyak gambar, akan mengubah prediksi untuk gambar-gambar tersebut. Pentingnya, contoh universal ditemukan dengan pengetahuan white-box penuh hanya pada satu jaringan. Pada Gambar 2, Anda dapat melihat betapa miripnya gangguan ini untuk arsitektur yang berbeda. Keberadaan ini menyiratkan kesamaan antara batas keputusan dari arsitektur yang berbeda.
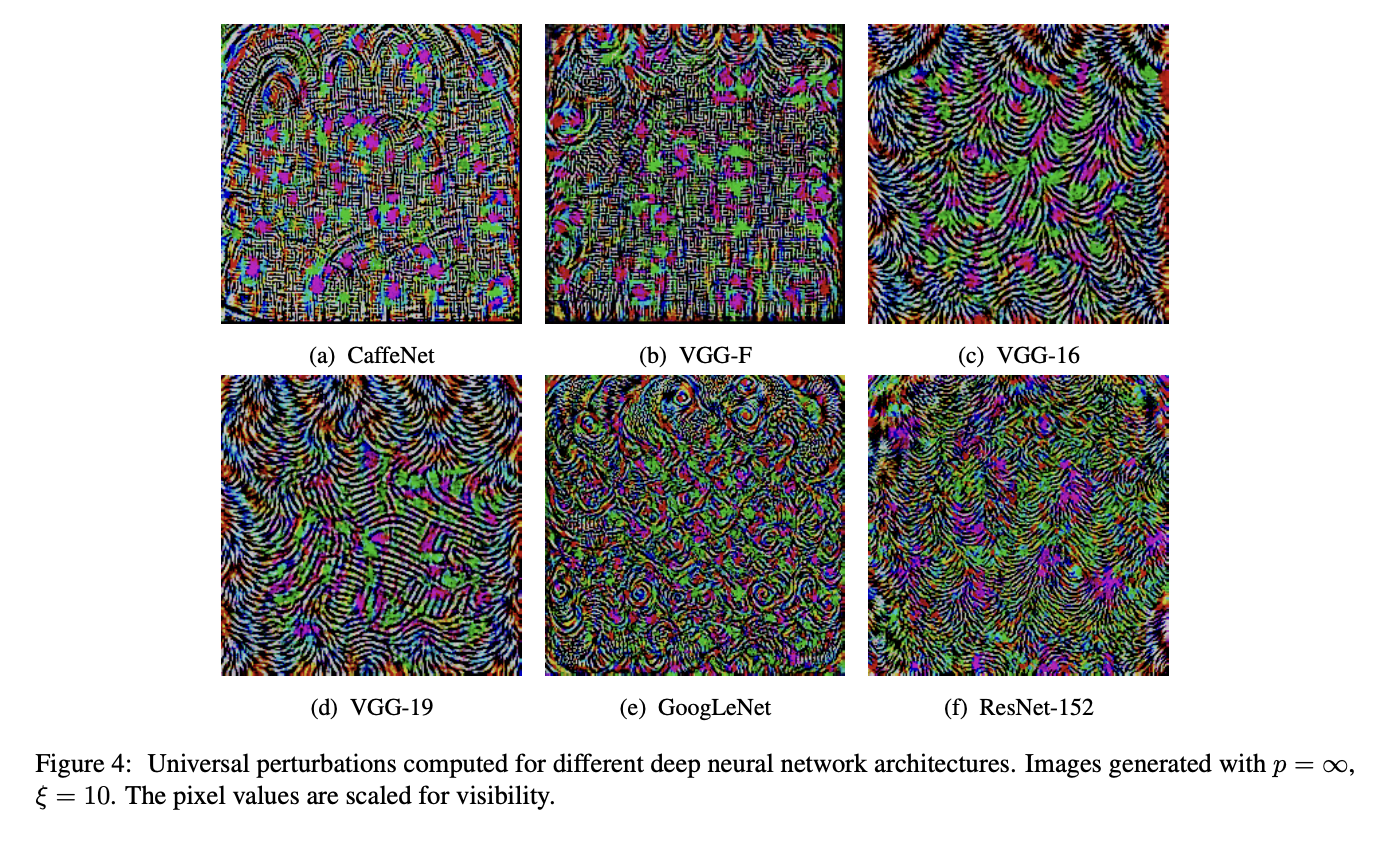
Gambar 2: universal perturbations yang dihitung untuk berbagai jaringan saraf dalam (sumber: Moosavi-Dezfooli dkk.)
Konsekuensi dari temuan ini adalah tidak ada jaringan yang benar-benar aman. Anda dapat menyerang pengklasifikasi yang tidak diketahui dengan melatih model Anda sendiri dan menjalankan metode white-box.
Secercah harapan terakhir adalah serangan ini hanya dapat dilakukan secara virtual. Anda perlu mengubah nilai piksel agar berhasil. Jadi tentu ini tidak bisa dilakukan pada model yang berinteraksi dengan dunia nyata?
Jangan terlalu cepat berbicara.
Para peneliti mengembangkan metode yang disebut adversarial patches. Patch ini bisa dicetak dan ditambahkan ke skena real-time apa pun untuk mengecoh pengklasifikasi gambar.
Patch tersebut bersifat universal karena dapat digunakan untuk menyerang skena apa pun, tangguh karena bekerja di bawah berbagai transformasi, dan terarah karena dapat membuat pengklasifikasi mengeluarkan kelas target apa pun.
T. B. Brown et al.
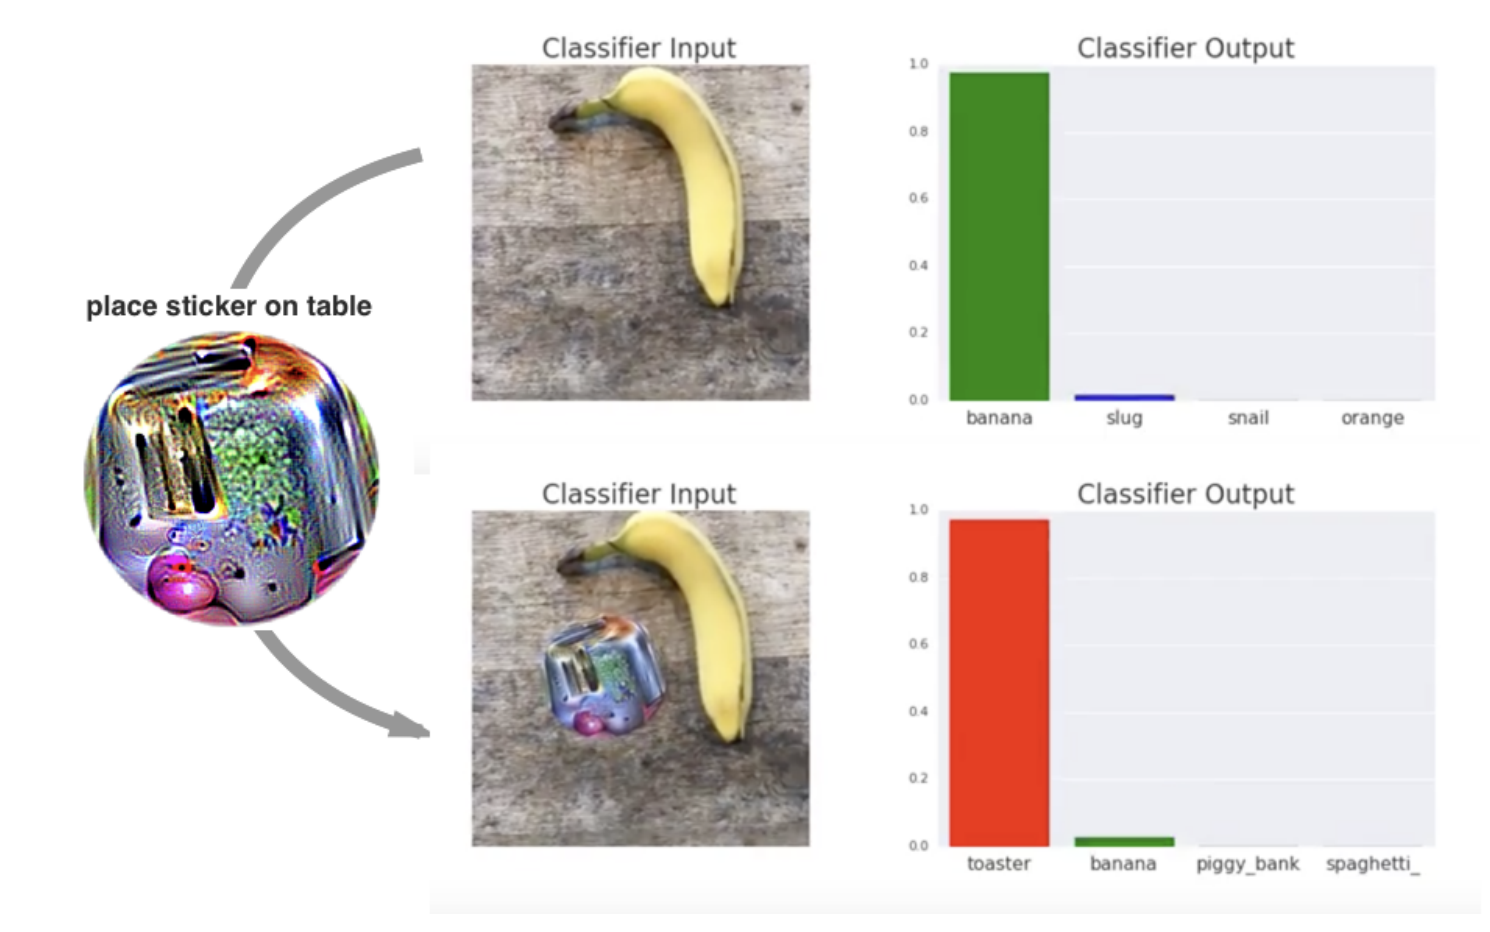
Sebuah adversarial patch saat digunakan (sumber: T. B. Brown dkk.)
Riset serupa menunjukkan bagaimana kita dapat mengubah prediksi rambu berhenti dengan beberapa stiker dan menipu model pengenalan wajah dengan sepasang kacamata. Jadi, benar-benar, tidak ada jaringan yang aman. Untuk melindunginya dari serangan adversarial, kita beralih ke sisi lain AML—metode untuk mempertahankannya.
Cara kita bisa mempertahankan jaringan sama beragamnya dengan cara mereka dapat diserang. Kita bisa menyesuaikan data pelatihan, proses pelatihan, atau bahkan jaringannya sendiri. Seperti yang kita bahas di akhir bagian ini, terkadang solusi paling sederhana adalah tidak menggunakan deep learning sama sekali.
Pendekatan pertama ini berfokus pada data pelatihan. Adversarial training melibatkan augmentasi dataset pelatihan dengan contoh adversarial untuk meningkatkan ketangguhan model terhadap serangan. Contoh-contoh ini ditemukan menggunakan serangan yang sudah dikenal seperti disebutkan di atas. Gagasan utamanya adalah mengekspos model pada gangguan adversarial selama fase pelatihan agar model belajar mengenali dan menolak masukan semacam itu.
Defensive distillation melibatkan pelatihan model untuk meniru probabilitas keluaran yang dilunakkan dari model lain. Kita terlebih dahulu melatih model standar (model guru) pada dataset asli. Model guru menghasilkan label lunak (distribusi probabilitas atas kelas) untuk data pelatihan. Model murid kemudian dilatih pada label lunak ini. Hasilnya adalah model dengan batas keputusan yang lebih mulus dan lebih tahan terhadap gangguan kecil.
Gradient masking mencakup berbagai teknik yang mengaburkan atau menyembunyikan gradien model. Misalnya, kita bisa menambahkan lapisan non-diferensiabel ke jaringan, seperti fungsi aktivasi biner. Ini mengonversi nilai masukan kontinu menjadi keluaran biner.
Model switching adalah pendekatan gradient masking yang sederhana. Ini melibatkan penggunaan banyak model dalam sistem Anda. Model yang digunakan untuk membuat prediksi diubah secara acak. Ini menciptakan target yang bergerak, karena penyerang tidak tahu model mana yang sedang digunakan. Mereka juga harus mengompromikan semua model agar serangan berhasil.
AML berkaitan dengan bidang lain dalam AI: Explainable Artificial Intelligence (XAI). Metode gangguan yang kita bahas di sini mirip dengan yang digunakan untuk menemukan penjelasan bagaimana model membuat prediksi. Namun, kesamaan utamanya adalah model sederhana tidak hanya lebih mudah dijelaskan tetapi juga lebih mudah dipertahankan.
Banyak masalah dapat diselesaikan dengan model sederhana seperti regresi linear atau regresi logistik. Banyak serangan yang kita jelaskan menjadi tidak efektif atau tidak relevan untuk model-model ini.
Ini karena model-model ini secara intrinsik dapat ditafsirkan, artinya kita dapat dengan mudah memahami cara kerjanya. Kelemahan tidak tersembunyi seperti pada arsitektur deep learning yang kompleks. Jadi, pertahanan yang lugas adalah cukup tidak menggunakan deep learning kecuali memang diperlukan untuk masalahnya.
Ini terkait dengan poin di awal artikel—AML juga menyangkut lingkungan keamanan yang lebih luas di mana model beroperasi. Akibatnya, banyak metode pertahanan tambahan melibatkan lingkungan yang lebih luas ini. Ini mencakup validasi dan pembersihan data masukan sebelum digunakan untuk melatih model. Model deteksi anomali juga telah digunakan untuk mengidentifikasi contoh adversarial sebelum diteruskan ke jaringan. Semua ini memerlukan proses yang berjalan berdampingan dengan sistem AI.
Seiring AI dan ML menjadi semakin sentral dalam hidup kita, AML menjadi semakin penting. Sangat krusial bahwa sistem yang membuat keputusan tentang kesehatan dan keuangan kita tidak mudah dikelabui—baik secara sengaja maupun tidak sengaja. Saya tentu tidak akan mempercayai mobil otomatis yang bisa dikelabui hanya dengan beberapa stiker. Serangan seperti itu bisa luput dari perhatian pengemudi tetapi menyebabkan mobil membuat keputusan yang salah dan mengancam jiwa.
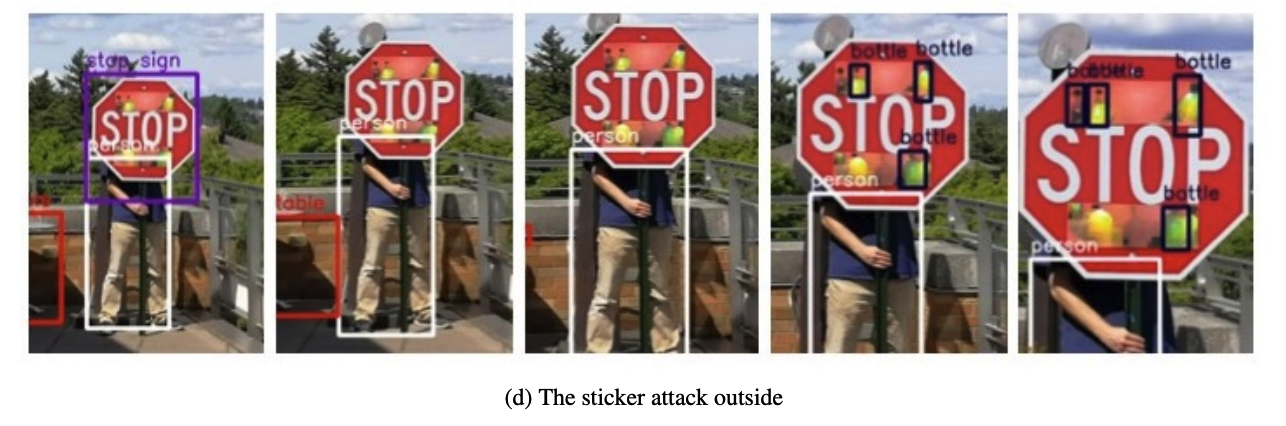 Gambar X: Yolo object detection v2 gagal mengenali rambu berhenti (sumber: K. Eykholt dkk.)
Saat merancang sistem ini, kita harus menyadari bahwa AML adalah bagian dari gerakan AI Bertanggung Jawab yang lebih besar. Untuk menjalankan kastil yang baik, seorang raja harus bertindak adil, membenarkan keputusan, melindungi privasi rakyatnya, dan memastikan keselamatan dan keamanan mereka. Dua aspek terakhir inilah yang ingin ditangani oleh AML.
Meski begitu, kita juga harus mengakui bahwa keselamatan dan keamanan secara mendasar berbeda dari aspek lain AI Bertanggung Jawab. Keadilan, interpretabilitas, dan privasi bersifat pasif. AML beroperasi dalam lingkungan di mana aktor jahat secara aktif berupaya merusak metodenya.
Inilah mengapa, berlawanan dengan intuisi, banyak riset di bidang ini bertujuan menemukan kerentanan dan serangan. Ini mencakup serangan poisoning, evasion, model extraction, dan inference. Ini juga mencakup metode yang lebih praktis untuk menemukan contoh adversarial seperti FGSM, PGD, C&W, dan adversarial patches yang telah kita bahas.
Tujuannya adalah menemukan hal-hal ini sebelum aktor jahat melakukannya. Pertahanan yang sesuai, seperti adversarial training, defence distillation, dan gradient masking, kemudian dapat dikembangkan untuk menangkal serangan ini sebelum menimbulkan kerugian.
Dalam arti ini, AML juga merupakan bagian dari perlombaan senjata keamanan siber yang lebih luas. Kerentanan, serangan, dan pertahanan baru akan selalu muncul, dan peneliti serta profesional AML harus berjuang untuk tetap selangkah lebih maju dari para penyerang adversarial.
Jika Anda ingin menjadi bagian dari perlombaan ini, berikut beberapa kerangka kerja Python untuk memulai:
Dalam artikel ini, kita telah mengeksplorasi bidang adversarial machine learning, menelaah tujuannya, berbagai jenis serangan (poisoning, evasion, model extraction, dan inference), serta bagaimana contoh adversarial digunakan untuk mengeksploitasi kerentanan model.
Kita juga membahas berbagai mekanisme pertahanan, termasuk adversarial training, defensive distillation, dan gradient masking, serta pentingnya menggunakan model yang lebih sederhana bila tepat.
Jika Anda tertarik mempelajari lebih lanjut tentang topik ini, lihat Introduction to Data Security ini.
Pelajari lebih lanjut tentang machine learning!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt