
Lewati ke konten utama

Apa itu Reinforcement Learning from Human Feedback?

Pelajari dasar-dasar teknik penting di balik keberhasilan alat AI generasi berikutnya seperti ChatGPT
Diperbarui 28 Sep 2026  · 8 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Adopsi besar-besaran alat seperti ChatGPT dan alat AI generatif lainnya telah memicu perdebatan besar tentang manfaat dan tantangan AI serta bagaimana AI akan membentuk kembali masyarakat kita. Untuk menilai pertanyaan-pertanyaan ini dengan lebih baik, penting untuk mengetahui cara kerja Large Language Models (LLM) yang menjadi tulang punggung alat AI generasi berikutnya.

Artikel ini memberikan pengantar tentang Reinforcement Learning from Human Feedback (RLHF), sebuah teknik inovatif yang memadukan teknik reinforcement learning dan bimbingan manusia untuk membantu LLM seperti ChatGPT menghasilkan keluaran yang mengesankan. Kami akan membahas apa itu RLHF, manfaatnya, keterbatasannya, dan relevansinya dalam pengembangan masa depan bidang AI generatif yang serba cepat. Teruskan membaca!

Memahami RLHF

Untuk memahami peran RLHF, pertama-tama kita perlu membahas proses pelatihan LLM.

Teknologi dasar dari LLM paling populer adalah transformer. Sejak dikembangkan oleh para peneliti Google, transformer menjadi model mutakhir di bidang AI dan deep learning, karena menyediakan metode yang lebih efektif untuk menangani data berurutan, seperti kata-kata dalam sebuah frasa.

Untuk mendapatkan pengantar yang lebih mendalam tentang LLM dan transformer, lihat Kursus Konsep Large Language Models (LLM) kami.

Transformer dipra-latih dengan korpus teks yang sangat besar yang dikumpulkan dari Internet menggunakan pembelajaran swasupervisi, yaitu jenis pelatihan inovatif yang tidak memerlukan tindakan manusia untuk memberi label data. Transformer yang dipra-latih mampu menyelesaikan beragam masalah pemrosesan bahasa alami (NLP).

Namun, agar alat AI seperti ChatGPT dapat memberikan jawaban yang menarik, akurat, dan mirip manusia, menggunakan LLM pra-latih saja tidaklah cukup. Pada akhirnya, komunikasi manusia adalah proses kreatif dan subjektif. Apa yang membuat sebuah teks “bagus” sangat dipengaruhi oleh nilai dan preferensi manusia, sehingga sangat sulit diukur atau ditangkap menggunakan solusi algoritmik yang jelas.

Gagasan di balik RLHF adalah menggunakan umpan balik manusia untuk mengukur dan meningkatkan kinerja model. Yang membuat RLHF unik dibandingkan teknik reinforcement learning lainnya adalah penggunaan partisipasi manusia untuk mengoptimalkan model, alih-alih fungsi yang ditetapkan secara statistik untuk memaksimalkan imbalan agen.

Strategi ini memungkinkan pengalaman belajar yang lebih adaptif dan personal, membuat LLM cocok untuk berbagai aplikasi spesifik sektor, seperti asistensi kode, riset hukum, penulisan esai, dan pembuatan puisi.

Bagaimana RLHF Bekerja?

RLHF adalah proses yang menantang yang melibatkan pelatihan multi-model dan berbagai tahap penerapan. Intinya, proses ini dapat diuraikan menjadi tiga langkah.

1. Memilih model pra-latih

Tahap pertama mencakup pemilihan LLM pra-latih yang nantinya akan disetel lebih lanjut menggunakan RLHF.

Anda juga bisa melatih LLM dari nol, tetapi ini adalah proses yang mahal dan memakan waktu. Karena itu, kami sangat menyarankan memilih salah satu dari banyak LLM pra-latih yang tersedia untuk publik.

Jika Anda ingin tahu lebih banyak tentang cara melatih LLM, tutorial kami Cara Melatih LLM dengan PyTorch memberikan contoh ilustratif.

Perhatikan bahwa, untuk memenuhi kebutuhan spesifik model Anda, sebelum memulai fase fine-tuning menggunakan umpan balik manusia, Anda dapat melakukan fine-tuning model pada teks atau kondisi tambahan.

Sebagai contoh, jika Anda ingin mengembangkan asisten hukum AI, Anda dapat melakukan fine-tuning model dengan korpus teks hukum agar LLM Anda lebih akrab dengan istilah dan konsep hukum.

2. Umpan balik manusia

Alih-alih menggunakan model imbalan yang telah ditentukan secara statistik (yang akan sangat membatasi dalam mengalibrasi preferensi manusia), RLHF menggunakan umpan balik manusia untuk membantu model mengembangkan model imbalan yang lebih halus. Prosesnya sebagai berikut:

  • Pertama, himpunan pelatihan berpasangan masukan-prompt/teks-tergenerasi dibuat oleh model pra-latih dengan mengambil sampel sejumlah prompt.
  • Selanjutnya, penguji manusia memberikan peringkat untuk teks yang dihasilkan, menggunakan pedoman tertentu untuk menyelaraskan model dengan nilai dan preferensi manusia serta menjaga keamanannya. Peringkat ini kemudian dapat diubah menjadi keluaran skor menggunakan berbagai teknik, seperti sistem peringkat Elo.
  • Terakhir, umpan balik manusia yang terakumulasi digunakan oleh sistem untuk mengevaluasi kinerjanya dan mengembangkan model imbalan.

Gambar berikut mengilustrasikan keseluruhan proses:
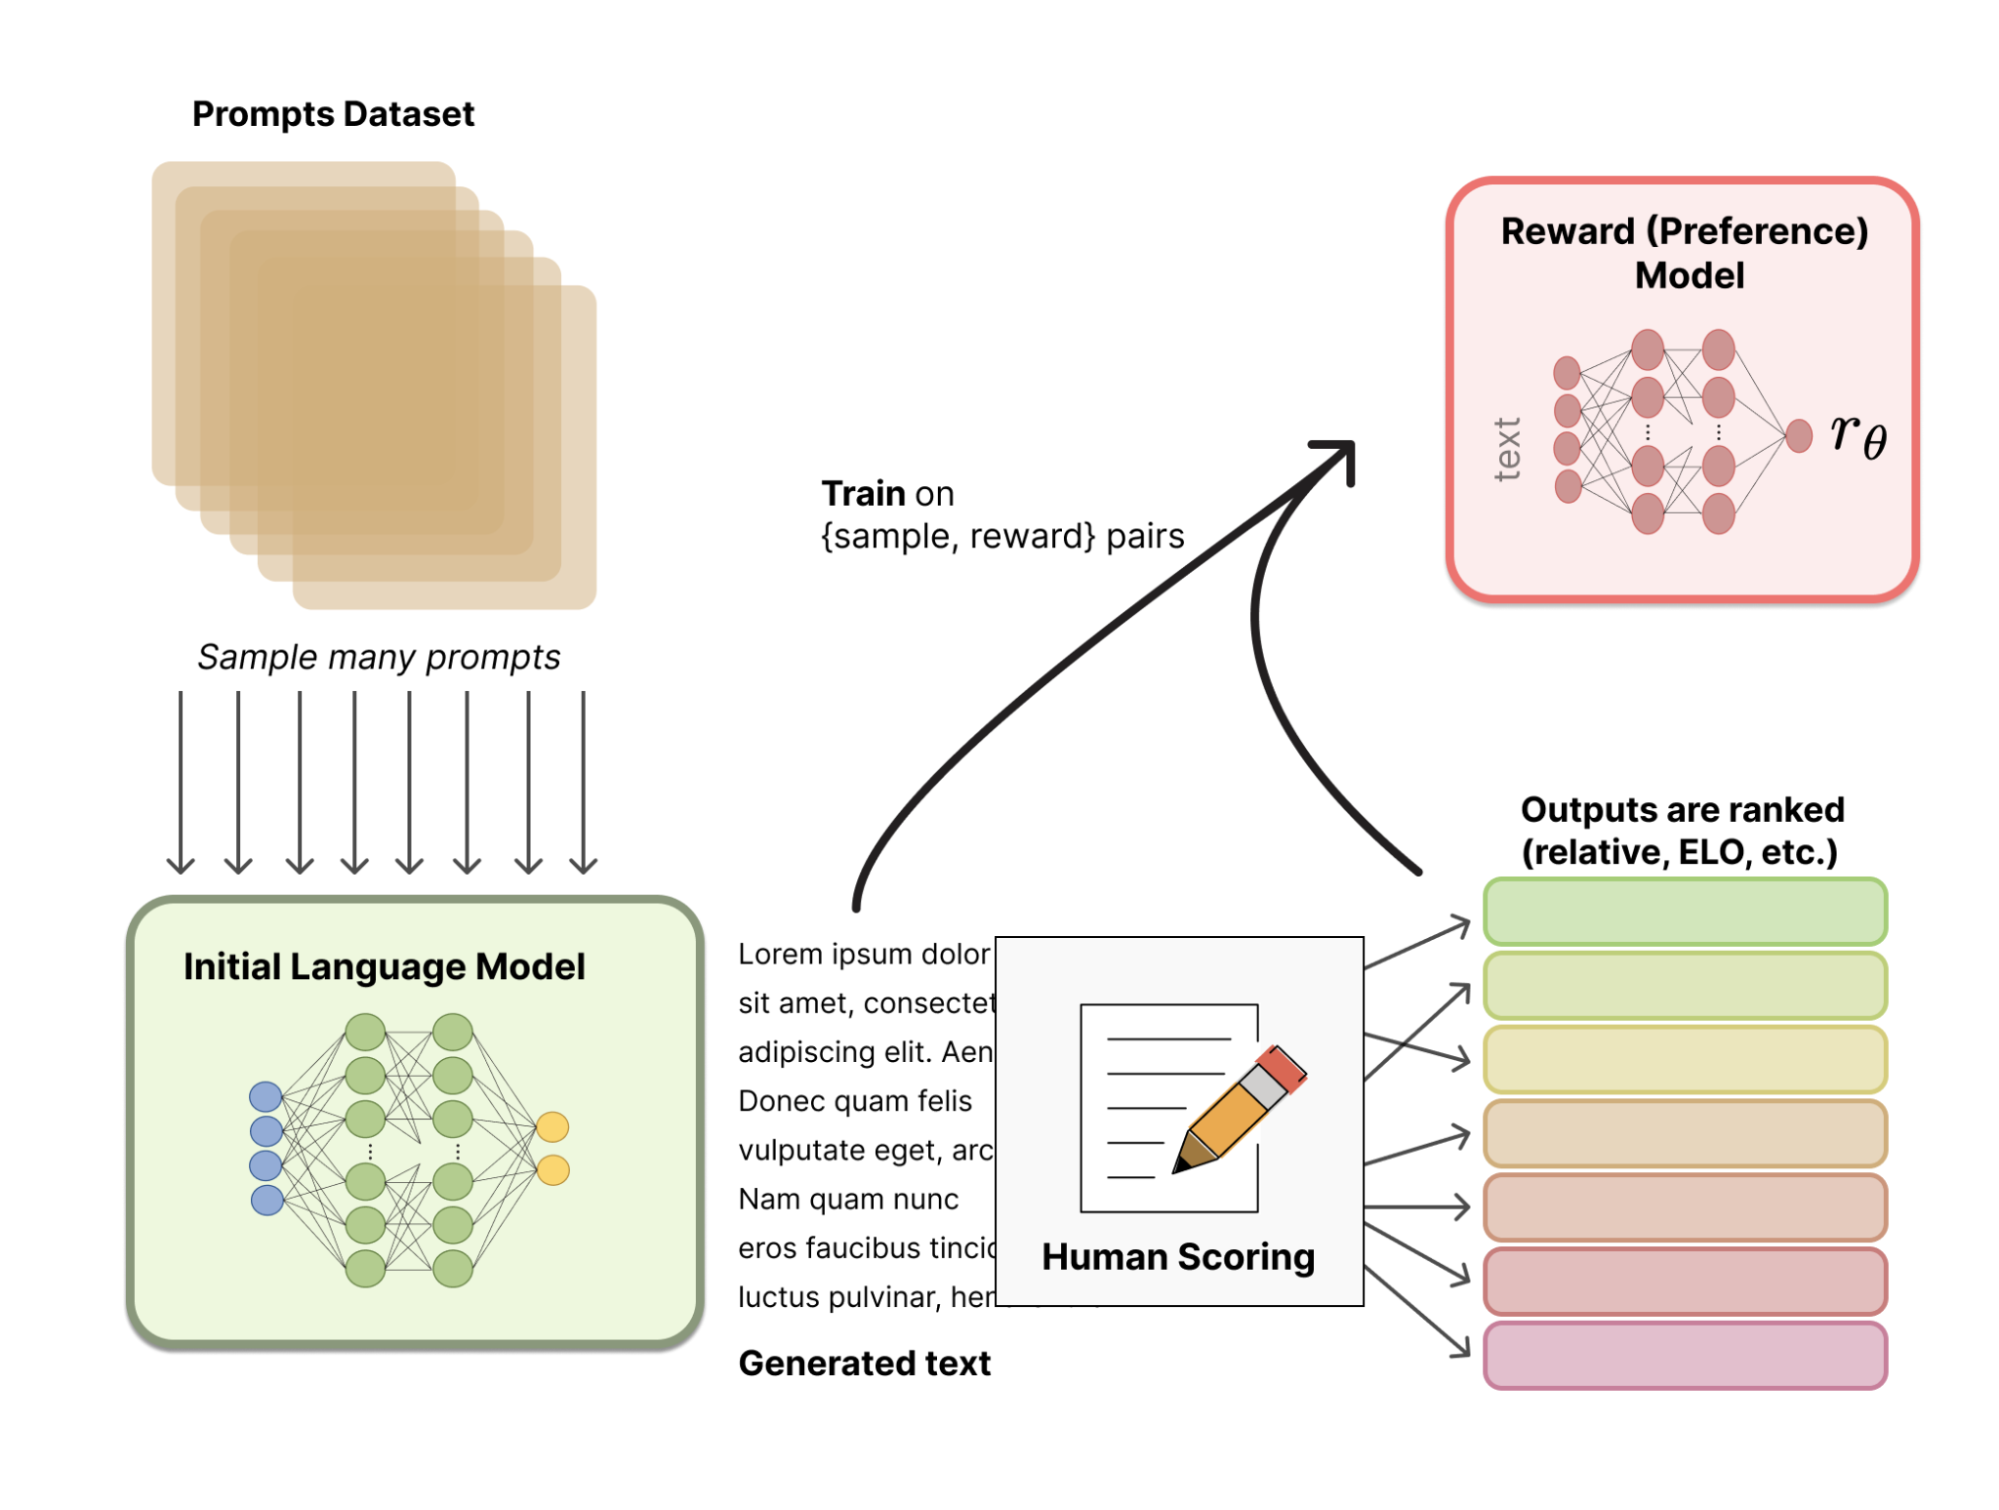
Sumber. Hugging Face

Sumber: Hugging Face

3. Fine-tuning dengan reinforcement learning

Pada tahap terakhir, LLM menghasilkan teks baru dan menggunakan model imbalan berbasis umpan balik manusia untuk menghasilkan skor kualitas. Skor tersebut kemudian digunakan oleh model untuk meningkatkan kinerjanya pada prompt berikutnya.

Umpan balik manusia dan fine-tuning dengan teknik reinforcement learning dikombinasikan dalam proses iteratif yang berlanjut hingga tingkat akurasi tertentu tercapai.

Aplikasi Reinforcement Learning from Human Feedback

RLHF adalah teknik mutakhir untuk melakukan fine-tuning pada LLM, seperti ChatGPT. Namun, RLHF adalah topik populer, dengan literatur yang terus berkembang yang mengeksplorasi kemungkinan lain di luar masalah NLP. Di bawah ini Anda dapat menemukan daftar bidang lain di mana RLHF telah berhasil diterapkan:

  • Chatbot. ChatGPT adalah contoh paling menonjol dari kemungkinan RLHF. Untuk mengetahui lebih lanjut tentang bagaimana ChatGPT menggunakan RLHF, lihat artikel, 'apa itu ChatGPT?' ini, di mana kami bertanya langsung kepada ChatGPT bagaimana cara kerjanya.
  • Robotika. Robotika adalah salah satu area utama di mana RLHF memberikan hasil yang menjanjikan. Penggunaan umpan balik manusia dapat membantu robot melakukan tugas dan gerakan yang sulit ditentukan dalam fungsi imbalan. Peneliti OpenAI berhasil mengajarkan robot untuk melakukan backflip – tugas yang sangat sulit untuk dimodelkan – menggunakan RLHF.
  • Permainan. Teknik reinforcement learning telah digunakan untuk mengembangkan bot video gim. Namun, RLHF dapat digunakan untuk melatih bot berdasarkan preferensi manusia, menjadikannya pemain yang lebih mirip manusia alih-alih sekadar mesin pemaksimal imbalan. Misalnya, OpenAI dan DeepMind melatih bot untuk memainkan gim Atari dengan RLHF.

Manfaat RLHF

RLHF adalah teknik yang kuat dan menjanjikan yang tanpanya alat AI generasi berikutnya tidak akan mungkin ada. Berikut beberapa manfaat RLHF:

  • Kinerja meningkat. Umpan balik manusia adalah kunci bagi LLM seperti ChatGPT untuk “berpikir” dan terdengar seperti manusia. RLHF memungkinkan mesin menangani tugas kompleks, seperti masalah NLP, yang melibatkan nilai atau preferensi manusia.
  • Adaptabilitas. Karena LLM disetel lebih lanjut menggunakan umpan balik manusia pada berbagai jenis prompt, RLHF memungkinkan mesin melakukan beragam tugas dan beradaptasi dengan situasi yang diharapkan. Ini membuat LLM membawa kita lebih dekat ke ambang AI tujuan umum.
  • Peningkatan berkelanjutan. RLHF adalah proses iteratif, artinya sistem terus ditingkatkan seiring fungsi belajarnya diperbarui mengikuti umpan balik manusia yang baru.
  • Keamanan yang lebih baik. Dengan menerima umpan balik manusia, sistem tidak hanya belajar cara melakukan sesuatu, tetapi juga belajar apa yang tidak boleh dilakukan, memastikan sistem yang efektif, lebih aman, dan dapat dipercaya.

Keterbatasan RLHF

Namun, RLHF bukan tanpa cela. Teknik ini juga memiliki risiko dan keterbatasan tertentu. Di bawah ini adalah beberapa yang paling relevan:

  • Umpan balik manusia terbatas dan mahal. RLHF bergantung pada kualitas dan ketersediaan umpan balik manusia. Namun, menyelesaikan pekerjaan bisa lambat, menguras tenaga, dan mahal, terutama jika pekerjaan membutuhkan banyak umpan balik.
  • Bias dalam umpan balik manusia. Terlepas dari penggunaan pedoman standar untuk memberikan umpan balik, penilaian atau pemeringkatan pada akhirnya dipengaruhi oleh preferensi dan nilai manusia. Jika tugas pemeringkatan tidak dirumuskan dengan baik, atau kualitas umpan balik manusia buruk, model dapat menjadi bias, atau memperkuat keluaran yang tidak diinginkan.
  • Generalisasi ke konteks baru. Bahkan jika LLM disetel lebih lanjut dengan umpan balik manusia yang substansial, konteks tak terduga selalu dapat muncul. Dalam kasus ini, tantangannya adalah membuat agen menjadi tangguh terhadap situasi dengan umpan balik terbatas.
  • Halusinasi. Ketika umpan balik manusia terbatas atau buruk, agen dapat mengalami apa yang disebut halusinasi, yaitu perilaku yang tidak diinginkan, keliru, atau tidak masuk akal.

Tren dan Perkembangan Masa Depan dalam RLHF

RLHF adalah salah satu tulang punggung alat AI generatif modern, seperti ChatGPT dan GPT-4. Terlepas dari hasilnya yang mengesankan, RLHF adalah teknik yang relatif baru, dan masih ada ruang lebar untuk perbaikan. Riset masa depan tentang teknik RLHF sangat penting untuk membuat LLM lebih efisien, mengurangi jejak lingkungannya, dan mengatasi beberapa risiko serta keterbatasan LLM.

Untuk tetap mengikuti perkembangan terbaru dalam AI generatif, machine learning, dan LLM, kami sangat menyarankan Anda melihat materi pembelajaran terkurasi kami:


Javier Canales Luna's photo
Author
Javier Canales Luna
LinkedIn

Saya adalah analis data lepas yang berkolaborasi dengan perusahaan dan organisasi di seluruh dunia dalam proyek ilmu data. Saya juga instruktur ilmu data dengan pengalaman lebih dari 2 tahun. Saya rutin menulis artikel terkait ilmu data dalam bahasa Inggris dan Spanyol, beberapa di antaranya telah diterbitkan di situs tepercaya seperti DataCamp, Towards Data Science, dan Analytics Vidhya. Sebagai ilmuwan data dengan latar belakang ilmu politik dan hukum, tujuan saya adalah bekerja pada irisan kebijakan publik, hukum, dan teknologi, memanfaatkan kekuatan gagasan untuk mendorong solusi serta narasi inovatif yang dapat membantu kita menghadapi tantangan mendesak, khususnya krisis iklim. Saya menganggap diri saya seorang autodidak, pembelajar sepanjang hayat, dan pendukung kuat pendekatan multidisipliner. Tidak pernah ada kata terlambat untuk mempelajari hal baru.

Topik
Kecerdasan Buatan

Pelajari Topik yang Disebutkan dalam Artikel Ini!

Kursus

Pengantar Deep Learning dengan Python

4 jam
264.6K
Pelajari dasar-dasar jaringan saraf tiruan dan cara membangun model pembelajaran mendalam menggunakan Keras 2.0 dalam Python.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

Lihat SelengkapnyaLihat Selengkapnya
