Kurs
Wie alle Machine-Learning-Modelle werden KI-Systeme darauf trainiert, eine Fehlermetrik zu minimieren. Sauberes Training ist nötig, reicht aber nicht aus, damit ein KI-Modell im Alltag von Nutzenden und in den Workflows von Organisationen ankommt.
Für gelungene Interaktionen zwischen Mensch und KI sollten Modelle die Nutzerintention erkennen und gemäß Sicherheits- und Fairnessrichtlinien handeln. Ein Chatbot sollte zum Beispiel keine Anleitungen zur Selbst- oder Fremdgefährdung geben, und ein Recruiting-Modell darf Bewerbende nicht benachteiligen.
KI-Systeme werden immer leistungsfähiger und durchdringen den Alltag. Deshalb müssen Entwickler sicherstellen, dass sich KI im großen Maßstab an menschlicher Ethik, Werten und Moral orientiert. Das nennt man Superalignment. Der Kurs AI Ethics vertieft die ethischen Aspekte von KI.
In diesem Artikel erläutern wir das Superalignment von KI-Modellen, stellen verschiedene Methoden vor, um Superalignment allgemein und für LLMs im Besonderen zu erreichen, und beleuchten ethische Überlegungen sowie praktische Hürden.
Entdecke, wie KI deine Organisation beeinflusst und wie du erfolgreiche KI-Strategien umsetzt – mit unserem Whitepaper The Learning Leader's Guide to AI Literacy.
KI-Alignment: Ein schneller Überblick
Alignment bezeichnet Prozesse und Methoden, die sicherstellen, dass ein KI-System der Nutzerintention entsprechend handelt, frei von Verzerrungen ist und Sicherheitsrichtlinien beachtet. Dieser Artikel erklärt die Konzepte und Methoden des Alignments.
Neben menschlicher Aufsicht nutzen Entwickler Methoden wie Filterung und regelbasierte Systeme, um Alignment sicherzustellen. Techniken, die für ein Modell mit kleinem Nutzerkreis funktionieren, werden bei mächtigeren und verbreiteteren Modellen unpraktikabel. Zum Beispiel:
- Content-Filter setzen Algorithmen ein, damit das Modell keine schädlichen Inhalte produziert. Sie filtern etwa Schimpfwörter und explizite Bilder. Sie sind jedoch auf das beschränkt, was vorab definiert wurde, und schützen nicht vor neuartigen unerwünschten Inhalten.
- Regelbasierte Systeme nutzen vordefinierte Regeln, um Missbrauch wie Anleitungen zur Selbst- oder Fremdgefährdung zu verhindern. Unerwartetes Verhalten von Nutzenden oder Modellen können sie jedoch nicht adaptiv abfangen.
- Klassische Bias-Minderungsmethoden wie das Umgewichten von Trainingsdaten wirken gegen bekannte Verzerrungen, reichen aber möglicherweise nicht, um neue, subtilere Verzerrungen in komplexen, neuen Kontexten zu erkennen.
Leistungsstarke KI-Modelle, die in größerem Umfang und breiter eingesetzt werden, brauchen daher einen neuen Ansatz für Alignment: Superalignment.
Was ist Superalignment?
Reichweite, Maßstab, Komplexität und breite Nutzung starker KI-Modelle bringen völlig neue Alignment-Herausforderungen mit sich.
Methoden und Ansätze, mit denen großskalige KI-Modelle an menschliche Werte, Ethik und Moral angepasst werden, werden unter dem Begriff Superalignment zusammengefasst. Das Feld umfasst viele Teilbereiche.
Generell sollten superalignte Systeme:
- Aktiv die Zusammenarbeit mit Menschen suchen, um auch nach der Erstjustierung aligned zu bleiben.
- Sich fortlaufend ausrichten und nachjustieren, um neue Anwendungsfälle und unausgesprochene Werte zu berücksichtigen. Das ist die Alignment-Pipeline.
- Ihr Handeln erklären und ihre Antworten anhand menschlichen Feedbacks aktualisieren.
Superalignment ist ein sich entwickelndes Feld. Es adressiert aktuelle State-of-the-Art-Modelle und denkt Methoden für noch leistungsfähigere künftige KI mit.
Mit steigender Leistungsfähigkeit wird KI voraussichtlich viele Lebensbereiche steuern – von Landwirtschaft bis Transport. Ein solches System muss die Interessen von Menschen stets über alles andere stellen.
Verbessere die KI-Fähigkeiten deines Teams
Verändere dein Unternehmen, indem du deinem Team mit dem DataCamp for Business fortgeschrittene KI-Kenntnisse vermittelst. Erreiche bessere Einblicke und mehr Effizienz.
Techniken für Superalignment
In diesem Abschnitt erklären wir einige Methoden und Techniken, um Superalignment zu erreichen. Dahinter steht die Philosophie, dass diese Ansätze skalierbar sein müssen.
Adversariales Training
Wie bei jedem Training müssen Entwickler prüfen, ob das System gewünschtes Verhalten gelernt hat. Eine Möglichkeit, Superalignment zu testen, ist, die KI mit Gegenbeispielen zu konfrontieren. Große Systeme müssen erkennen, welche Anfragen nicht in guter Absicht gestellt sind, und angemessen reagieren.
Ein gängiger Ansatz ist, zwei KIs als Gegenspieler einzusetzen – analog zum Red-Team-/Blue-Team-Prinzip aus der Sicherheitsforschung, bei dem das Red Team versucht, die Abwehr des Blue Teams zu überwinden.
Im Kontext von adversarialem Training für Superalignment versucht jede KI, Eingaben zu finden, die die andere verwirren. Beispiel: Eine KI (Blue Team) wurde so ausgerichtet, dass sie nicht mit Schimpfwörtern antwortet. Im adversarialen Training sucht die gegnerische KI (Red Team) nach Prompts, die dennoch unangemessene Antworten provozieren. Ziel ist, dass die Blue-Team-KI selbst unter Red-Team-Prüfung weiterhin akzeptable Antworten liefert.
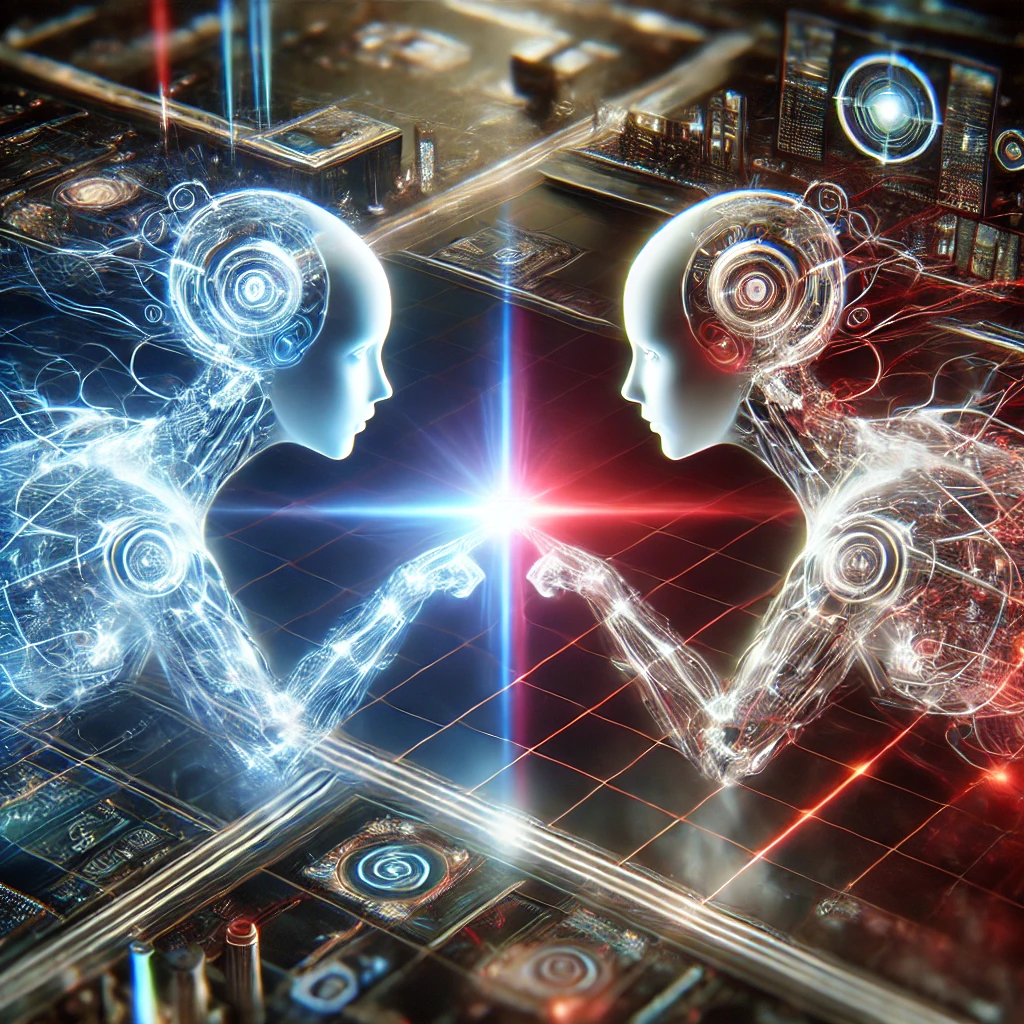
Illustration des Konzepts des adversarialen Trainings. Bild erstellt mit DALL·E
Robustheitstraining
Robustheit bedeutet, zwischen Eingaben zu unterscheiden, die sich tatsächlich unterscheiden, aber oberflächlich ähnlich wirken. Das System sollte Rand- und Eckfälle erkennen können. Ein System zur Erkennung menschlicher Aktionen in Videos sollte etwa einen echten Straßenkampf von einer choreografierten Filmszene unterscheiden. Verwechslungen können gravierende Folgen haben.
Große Modelle sollten daher gezielt mit oberflächlich ähnlichen Szenarien konfrontiert werden. So lernt das Modell, Nuancen und feine Merkmale zu erkennen.
Skalierbare Aufsicht
Wenn KI-Modelle neue Nutzergruppen und Anwendungsfälle finden, muss auch die Aufsicht mitwachsen. Menschliche Beteiligung ist der Kern von Überwachung und Alignment. Menschen in großem Stil einzubinden ist jedoch schwerer als eine technische Lösung zu skalieren. Für skalierbare Aufsicht sind daher neue Methoden nötig:
- Automatisiertes Monitoring in Echtzeit: Automatisierte Systeme können die Antworten der KI kontinuierlich verfolgen und ihr Verhalten überwachen, um die Einhaltung menschlicher Werte zu prüfen. Signifikante Abweichungen werden zur menschlichen Intervention markiert.
- Programmgesteuerte Reviews: Eine manuelle Überprüfung aller Ausgaben ist nicht realistisch. Stattdessen können neue Programme und Algorithmen entwickelt werden, die die Übereinstimmung der KI mit menschlicher Ethik prüfen. Zweifelsfälle werden an menschliche Moderatoren übergeben.
Reinforcement Learning mit menschlichem Feedback (RLHF)
Wie im Artikel zu Reinforcement Learning (RL) beschrieben, lernt das System in klassischen RL-Setups durch Beobachten des Menschen und maximiert per Trial-and-Error die Belohnung. RLHF kombiniert RL mit menschlichem Input, der das Verhalten während des Trainings lenkt.
RLHF startet mit einem vortrainierten Modell. Menschliche Reviewer geben Aufgaben vor und bewerten die Ausgaben, etwa durch Benotung oder Korrekturen.
Das Modell nutzt dieses Feedback, um sein Verhalten zu verfeinern, sich an menschliche Rückmeldungen anzupassen und die Belohnung (positives Feedback) zu maximieren. Der Prozess wird wiederholt, bis die Ausgaben als relevant, angemessen und korrekt gelten.
Inverses Reinforcement Learning (IRL)
Im klassischen Reinforcement Learning legen Entwickler die Belohnungs- bzw. Nutzenfunktion explizit fest. Das Modell maximiert dann diese Belohnung.
Beim inversen RL leitet das Modell die Belohnungsfunktion aus dem Verhalten eines trainierten Modells oder eines Menschen ab. Beispiel: Ein RL-basiertes autonomes Auto bekommt positive Anreize für Spurhalten und Anhalten an roten Ampeln. Ein IRL-System erschließt sich diese Anreize, indem es das Fahrverhalten eines erfahrenen Menschen oder einer trainierten KI genau beobachtet.
Menschliche Werte lassen sich nicht für alle Kontexte explizit auflisten, was klassisches RL für Alignment-Probleme erschwert.
Wirksamer ist es, wenn die KI menschliches Verhalten in unterschiedlichen Kontexten beobachtet und nachahmt. So lernt sie, welche der möglichen Antworten am ehesten dem menschlichen Handeln in der jeweiligen Situation entsprechen. Das hilft, die KI an menschliche Werte anzupassen.
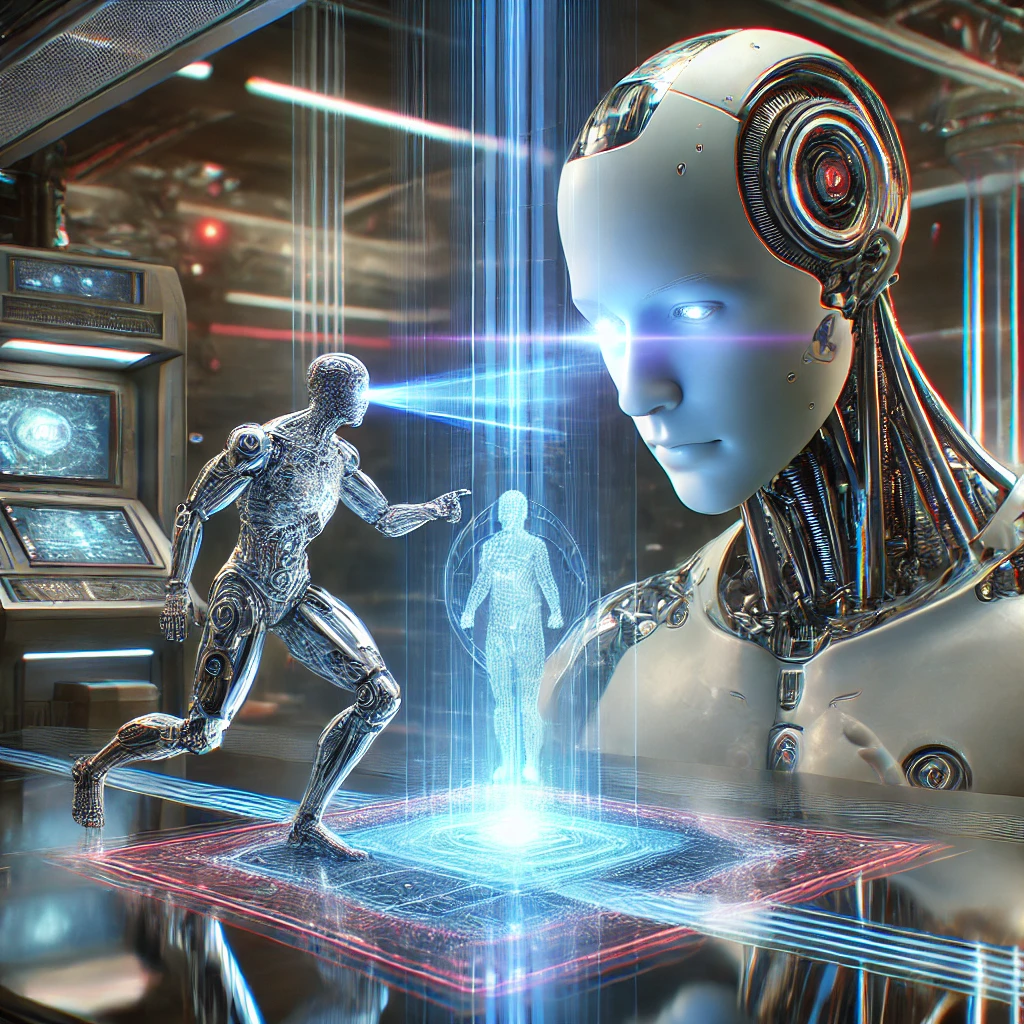
Illustration des Konzepts des inversen Reinforcement Learnings. Bild erstellt mit DALL·E
Debatte
Viele Alignment-Methoden basieren darauf, dass Menschen der KI akzeptables von inakzeptablem Verhalten beibringen. Das ist jedoch nicht immer ideal.
Bei komplexen Problemen, etwa der optimalen Planung eines nationalen Schienennetzes, kann kein Mensch zuverlässig beurteilen, ob eine Lösung die beste ist. Die Lösung: KI für Superalignment selbst nutzen. Beim Debatten-Ansatz:
- Schlägt eine KI eine Lösung vor und erklärt jeden Schritt detailliert.
- Wird dieselbe oder eine andere KI eingesetzt, um jede Erklärung zu kritisieren (Gegenargumente zu liefern).
- Entscheidet ein Mensch, welches Argument stichhaltiger ist. Da jedes Argument begrenzt ist, fällt die Bewertung leichter.
Logisches Schlussfolgern wird spielerisch, das beste Argument gewinnt. Über viele Debatten lernt die KI, welche Argumentationslinien erwünscht sind. Künftige Ausgaben sind besser an menschliche Werte angepasst.
Iterierte Amplifikation
In klassischen ML- und Deep-Learning-Systemen basiert das Training darauf, ob die Ausgabe dem erwarteten Ergebnis entspricht.
Mit wachsender Leistungsfähigkeit wird KI für immer komplexere Aufgaben genutzt. Oft kennt der Mensch das erwartete Ergebnis nicht im Voraus – es gibt nur die KI-Vorschläge. Dann ist Alignment über die Endausgabe schwer, weil diese nicht zuverlässig beurteilbar ist.
Beispiel Transportfahrplan: Das System muss Wirtschaftlichkeit mit öffentlichem Nutzen ausbalancieren. Viele Abwägungen erschweren die Entscheidung, welches Enddesign am besten zu menschlichen Werten passt.
In solchen Fällen ist es einfacher, menschliche Aufsicht für kleinere Teilaufgaben zu nutzen. Später werden etwas größere Aufgaben wieder in kleinere Teile zerlegt und unter menschlicher Aufsicht aligned. Dieser Prozess wird iterativ fortgeführt, bis die Aufgaben zu groß für eine direkte Beurteilung werden.
Die Annahme: Wenn viele kleine, einfache Teilaufgaben menschlich validiert aligned sind, ist auch die übergeordnete Aufgabe ausgerichtet. Das nennt man iterierte Amplifikation, oft kombiniert mit Methoden wie Debatte.
Value Learning
Menschliche Interaktionen sind komplex und nuanciert. Handlungen sind isoliert oft mehrdeutig – Sinn entsteht erst im Kontext. Klassische Nutzenfunktionen und RL reichen daher nicht aus, um KI menschliche Werte zu vermitteln.
Als Alternative erhält das Modell Zugang zu mehreren Nutzenfunktionen statt nur einer. Je nach Kontext wird eine passende gewählt. Das Modell lernt die Wahl, indem es menschliches Verhalten in verschiedenen Situationen beobachtet. Das nennt man Value Learning.
Beim Value Learning beobachtet die KI direkt menschliches Verhalten in unterschiedlichen Szenarien und lernt das angemessene Verhalten für jeden Kontext. Dazu wird sie vielfältigen realen Interaktionen ausgesetzt.
Illustration des Konzepts des Value Learnings. Bild erstellt mit DALL·E
Menschen, die im Alignment-Training agieren, sollten sich vorbildlich verhalten. Eine Autofahrerin sollte z. B. keinem Road Rage nachgeben, aber bei einem sehr langsamen Fahrzeug sicher überholen.
Superalignment bei Large Language Models (LLMs)
LLMs sind aktuell die populärsten großskaligen KI-Modelle – mit breitem Einsatzspektrum. Angesichts Nutzerbasis und Vielfalt der Use Cases verdient Superalignment speziell für LLMs besondere Aufmerksamkeit.
LLMs und Alignment-Herausforderungen
Large Language Models wie GPT-4, Gemini und Meta AI halten Einzug in den Alltag. Aufgrund ihres Maßstabs bringen LLMs neue Alignment-Herausforderungen mit sich, etwa:
- Verzerrungen fortschreiben: Diese Modelle sind auf riesigen Datenmengen aus dem offenen Internet und Bibliotheken trainiert. Verzerrungen in den Trainingsdaten spiegeln sich direkt in den Ausgaben wider. Verzerrungen durch Mängel in Eingabedaten gelten als algorithmischer Bias.
- Komplexe Systeme: Große Modellgrößen, riesige Trainingsdaten und vielfältige Use Cases erschweren die Vorhersage des Systemverhaltens – und damit die Sicherstellung der Wertekonformität in allen Fällen.
- Skalierungsprobleme: Angesichts riesiger Nutzerzahlen und Anfragen:
- Selbst ein kleiner Anteil fehlangepasster Antworten ergibt absolut eine große Zahl.
- Es wird schwierig, werte- und ethikkonformes Verhalten über alle Nutzenden hinweg konsistent sicherzustellen.
Deshalb braucht es neue Methoden, um die Ausrichtung dieser Modelle zu testen, und kontinuierliches Finetuning, damit sie menschlichen Werten und ethischen Standards entsprechen.
LLM-Ausgaben evaluieren
Es gibt viele Vorschläge, LLM-Ausgaben auf Wertekonformität zu prüfen – alle müssen skalierbar sein. Beispiele:
- Unerwünschte Ausgaben filtern: Pragmatisch ist eine Filterebene über dem Sprachmodell. Getrennte Systeme für Texterzeugung und Filterung sind effizienter. Der Filter kann eine weitere KI sein, die die LLM-Ausgabe auf unangebrachte Sprache und sensible Themen prüft.
- Bias-Erkennung: Trainingsdatensätze enthalten unvermeidlich Verzerrungen, die zu verzerrten Modellen führen. Methoden zur Erkennung sind u. a.:
- Audits durch Entwickler mit diversen Eingaben und Vergleich der Antworten.
- Spezialisierte Algorithmen, die systematisch nach unterschiedlichen Verzerrungsarten suchen.
- Faktenprüfung: Halluzinationen begleiten LLMs seit Beginn. Ein LLM kann nur das nächste Wort basierend auf dem Training vorhersagen – es hat kein Faktenverständnis. Für ein LLM ist „Dell stellt PCs her“ genauso plausibel wie „Dell stellt Kartoffelchips her“. Deshalb ist es bei faktenbasierten Texten entscheidend, die inhaltliche Richtigkeit zu prüfen.
- Erklärbarkeit: Traditionelle IT-Systeme sind regelbasiert und debugbar. LLMs haben Milliarden Parameter – es ist unmöglich, die beitragenden Gewichte zu einzelnen Ausgabeteilen nachzuverfolgen.
Zum Glück ist Reasoning eine emergente Eigenschaft großer Sprachmodelle – also eine Systemeigenschaft, die sich nicht als Summe der Teile erklären lässt.
LLMs können oft ihre Antworten erklären und mehrschrittig begründen. Wenn man sich komplexe Lösungen Schritt für Schritt erklären lässt und diese manuell prüft, können Menschen die LLM-Antwort validieren.
LLMs und menschliche Interaktion
Interaktiv genutzte LLMs müssen Nuancen menschlicher Gespräche verstehen und kontextbezogen reagieren.
Tonfall, Intention, Sarkasmus und Emotionen sind mathematisch schwer zu fassen – trotzdem müssen KI-Modelle sie berücksichtigen, um wirksam zu kommunizieren. Nur ein empathisch ausgerichtetes LLM interagiert erfolgreich, baut Vertrauen auf und fördert produktive Zusammenarbeit – erreicht wird das nur durch gezielte Superalignment-Techniken.
Ethische Überlegungen im Superalignment
Ziel von Superalignment ist, dass leistungsstarke KI den ethischen Standards der Gesellschaft entspricht.
Dieser Abschnitt erläutert die Rolle der Ethik im Superalignment und die damit verbundenen Herausforderungen bei großen Modellen.
Ethisches Verhalten sicherstellen
Eine KI, die nicht mit menschlichen Werten übereinstimmt, ist nicht sicher nutzbar. Fehlanpassungen können schädliche Inhalte erzeugen, die missbraucht werden, gesellschaftliche Ungleichheiten verfestigen und bestehende Verzerrungen verstärken.
Im schlimmsten Fall führt Fehlanpassung zu manipulativen Verhaltensweisen. Deshalb stehen ethische Fragen im Zentrum aller Superalignment-Bemühungen. Nur wenn KI sich in allen Situationen ethisch verhält, ist sie langfristig verlässlich und vertrauenswürdig.
Nutzen und Sicherheit ausbalancieren
Ethisches Verhalten in KI-Systeme einzubetten, ist aufwendig. Für Superalignment brauchen Entwickler:
- Menschen, die Antworten auditieren und Feedback geben
- Zusätzliche Zeit vor dem Release für Superalignment
- Mehr Rechenressourcen zum Finetuning und Ausrichten
Auch zur Laufzeit fallen zusätzliche Prüfungen an, um wertekonforme Antworten sicherzustellen. Mitunter begrenzt Alignment als Nebenbedingung die Fähigkeiten des Modells. Ein superaligntes Modell kann also weniger performant wirken.
Es braucht daher eine Balance zwischen technischer Performance und Alignment. Wer Alignment und Sicherheit zu Lasten klassischer Leistungsmetriken priorisiert, riskiert Modelle, die in der Praxis weniger nützlich sind.
Fairness und Bias
Großskalige Modelle bedienen viele Nutzer und vielfältige Use Cases. Jede Verzerrung kann weitreichende Folgen haben. Entwickler sollten daher Modelle so biasarm wie möglich gestalten.
Bias in LLMs zu eliminieren ist schwierig, da sie unüberwacht auf riesigen Textkorpora trainiert werden und dabei auch Vorurteile übernehmen. Das kann zu unfairen, diskriminierenden Ausgaben führen. Gegenmaßnahmen sind u. a.:
- Bias-Erkennung: Bevor gegengesteuert werden kann, müssen Verzerrungen identifiziert werden. Regelmäßige Audits und Fairness-Assessments auf Stichproben der Ausgaben zeigen Verzerrungstypen und auslösende Situationen.
- Bias-Minderung: Drei Hauptansätze:
- Das Modell so programmieren, dass es bestimmte Verzerrungen in der Ausgabe korrigiert.
- Den Trainingsdatensatz mit synthetischen Daten anreichern. Hat z. B. ein Bilddatensatz kaum Exemplare einer Spezies, sinkt die Wahrscheinlichkeit, diese zu erkennen. Abhilfe: synthetische Bilder hinzufügen und/oder die Gewichtung erhöhen.
- Gewichte unterrepräsentierter Teilmengen anpassen, damit Kategorien mit wenigen Beispielen gleich stark zählen wie andere.
- Kontinuierliches Monitoring: Modelle werden regelmäßig neu trainiert; zukünftiges Verhalten wird von vergangenen Interaktionen beeinflusst. Auch Nutzerverhalten ändert sich durch den Umgang mit KI. Bias-Erkennung und -Minderung sind daher kein Einmalprojekt, sondern Teil des Entwicklungszyklus.
Herausforderungen auf dem Weg zum Superalignment
Wie gezeigt, ist Superalignment anspruchsvoll. Zentrale Schwierigkeiten sind:
- Komplexität und Maßstab der Modelle: Moderne Modelle haben Milliarden Parameter. Dadurch sind Antworten und Entscheidungswege schwer vorhersagbar. Konsistentes Alignment ist schwierig; schon kleine Parameterupdates können es stören.
- Skalierbarkeit der Alignment-Techniken: Menschliche Aufsicht ist zentral – doch mit wachsendem Einsatzgebiet steigt die Zahl der Szenarien. Wie effektiv und wirtschaftlich lässt sich diese Aufsicht skalieren?
- Generalisierung und Robustheit: KI trifft auf neue Szenarien und Eingaben, während Training und Alignment auf endlichen Daten beruhen. Das Modell muss seine Ausrichtung auf unbekannte Fälle übertragen, Randfälle erkennen und sich ethisch verhalten.
- Wertemissalignment: KI hat kein eigenes Verständnis menschlicher Werte und lernt nur aus Daten. Werte sind komplex und teils widersprüchlich – in einem Kontext angemessen, im anderen unpassend. Missverständnisse führen zu unangebrachten, potenziell unethischen Antworten.
- Regulatorische Compliance: Nationale und supranationale Institutionen definieren rechtliche Standards für mächtige KI. Die Einhaltung erfordert zusätzlichen Aufwand.
- Integration in andere IT-Systeme: Die meisten Alignment-Bemühungen fokussieren direkte Mensch-KI-Interaktion. Neue Herausforderungen entstehen bei Integration in andere Systeme, wo Ein- und Ausgaben nicht mehr in natürlicher Sprache vorliegen. Das erschwert die Interpretation. Die Superausrichtung eines komplexen, integrierten IT-Systems mit KI birgt unerwartete Hürden. Eine Möglichkeit ist, das Gesamtsystem einer weiteren KI zur Verständlichmachung und Überwachung anzuvertrauen.
- Monitoring und Updates: Kontinuierliches Monitoring ist nötig, um ethisches Verhalten in der Praxis sicherzustellen – typischerweise über Stichproben realer Eingaben. Updates der Modellparameter können das Alignment stören. Daher muss Alignment Teil des Entwicklungszyklus bleiben.
Fazit
Eine KI, die nicht mit menschlichen Werten und Ethik übereinstimmt, ist für den breiten Einsatz ungeeignet – und kann sogar schaden.
Wir haben Superalignment als Sammlung von Methoden vorgestellt, um große, leistungsfähige KI-Systeme auszurichten – inklusive eines Blicks auf LLMs. Zudem haben wir die wichtigsten Herausforderungen eines noch jungen, dynamischen Feldes skizziert.
Verdiene eine Top-KI-Zertifizierung
Lerne mehr über KI mit diesen Kursen!
Worin unterscheidet sich Superalignment von Alignment?
Konzeptionell ähneln sich beide Begriffe, unterscheiden sich aber im Umfang. Alignment bedeutet, dass KI-Systeme die Nutzerintention berücksichtigen, kontextgerecht handeln und frei von Verzerrungen sind.
„Superalignment“ bezieht sich auf großskalige KI-Modelle, die nicht nur an Intention und Kontext, sondern umfassender an menschlichen Werten, Moral und Ethik ausgerichtet sind.
Der Kernunterschied liegt in den Methoden: Einfachere, regelbasierte Verfahren genügen für Alignment, für Superalignment sind sie unzureichend.
Wie unterscheidet sich Alignment vom Training?
Modelltraining zielt auf die Minimierung der Verlustfunktion. Alignment geht darüber hinaus: Es stellt sicher, dass das trainierte Modell im Sinne menschlicher Intentionen, Werte und Ethik handelt.
Sind die Trainingsdaten verzerrt, wird auch das Modell verzerrt und handelt nicht ethisch. Alignment korrigiert das Modell und gleicht Mängel im Trainingsprozess aus.
Umfasst Superalignment immer menschliche Arbeit?
Angesichts der enormen Menge an Ein- und Ausgaben ist manuelle Aufsicht nicht immer möglich. Pragmaticher ist es, automatisierte und programmgesteuerte Ansätze zu nutzen, um KI-Verhalten zu prüfen und zu überwachen. Menschliche Intervention bleibt in Grenzfällen natürlich nötig.
Ist Superalignment zwingend nötig? Reicht ein trainiertes Modell nicht aus?
Für großskalige, öffentlich zugängliche Modelle: ja, unbedingt. Sobald KI-Ausgaben praktisch genutzt werden, müssen sie denselben ethischen und moralischen Standards genügen wie bei Menschen. Trainingsdaten enthalten standardmäßig diverse Verzerrungen, die sich im trainierten Modell niederschlagen. Daher muss das trainierte Modell an menschliche Werte und Standards ausgerichtet werden.
Gibt es Superalignment-Module oder Softwarepakete, die ich nutzen kann?
Superalignment ist weiterhin ein ungelöstes Problem mit vielen erforschten Ansätzen. KI-Forschende experimentieren mit unterschiedlichen, modellabhängigen Techniken. Entsprechend gibt es derzeit keine verbreiteten, produktionsreifen Module für Superalignment.
Arun ist ein ehemaliger Startup-Gründer, der Spaß daran hat, neue Dinge zu entwickeln. Derzeit erforscht er die technischen und mathematischen Grundlagen der Künstlichen Intelligenz. Er liebt es, sein Wissen mit anderen zu teilen, also schreibt er darüber.
Neben dem DataCamp kannst du seine Veröffentlichungen auf Medium, Airbyte und Vultr lesen.
