
Kursus
Reinforcement Learning dengan Gymnasium di Python
4 jam
14K
Model reinforcement learning (RL) dasar dan mendalam sering kali tampak lebih mirip AI fiksi ilmiah dibandingkan model bahasa besar mana pun saat ini. Mari kita lihat bagaimana RL memungkinkan agen ini menuntaskan level yang sangat sulit di Super Mario:
Pada awalnya, agen sama sekali tidak tahu cara memainkan game ini. Ia tidak tahu kontrolnya, bagaimana membuat kemajuan, apa saja rintangannya, atau apa yang mengakhiri permainan. Agen harus mempelajari semua hal ini tanpa campur tangan manusia—semata-mata melalui kekuatan algoritma reinforcement learning.
Agen RL dapat memecahkan masalah tanpa solusi yang telah ditentukan atau tindakan yang diprogram secara eksplisit dan yang terpenting, tanpa membutuhkan banyak data. Itulah sebabnya RL berdampak signifikan pada banyak bidang. Misalnya, digunakan dalam:
Reinforcement learning adalah bidang yang berkembang pesat dengan potensi besar. Seiring kemajuan riset, kita dapat mengharapkan semakin banyak aplikasi terobosan di bidang seperti manajemen sumber daya, layanan kesehatan, dan pembelajaran yang dipersonalisasi.
Karena itu, sekarang waktu yang tepat untuk mempelajari bidang pembelajaran mesin yang menarik ini. Dalam tutorial ini, kami akan membantu Anda memahami dasar-dasar reinforcement learning dan menjelaskan konsep langkah demi langkah seperti agen, lingkungan, aksi, keadaan, penghargaan, dan lainnya.
Misalkan Anda ingin mengajari kucing Anda, Bob, untuk menggunakan beberapa tiang garuk di sebuah ruangan alih-alih furnitur mahal Anda. Dalam istilah reinforcement learning, Bob adalah agen, si pembelajar, dan pengambil keputusan. Ia perlu mempelajari mana yang boleh digaruk (karpet dan tiang) dan mana yang tidak (sofa dan gorden).
Ruangan tersebut disebut lingkungan tempat agen kita berinteraksi. Lingkungan memberikan tantangan (furnitur yang menggoda) dan tujuan yang diinginkan (tiang garuk yang memuaskan).
Ada dua tipe utama lingkungan dalam RL:
Ruangan kita juga merupakan lingkungan statis. Furnitur tidak bergerak, dan tiang garuk tetap di tempatnya.
Namun, jika Anda secara acak memindahkan furnitur dan tiang garuk setiap beberapa jam (seperti level berbeda pada gim Super Mario), ruangan itu akan menjadi lingkungan dinamis, yang lebih rumit bagi agen untuk dipelajari karena segala sesuatunya terus berubah.
Dua aspek penting dari semua masalah reinforcement learning adalah ruang keadaan dan ruang aksi.
Ruang keadaan merepresentasikan semua kemungkinan keadaan (situasi) tempat agen dan lingkungan berada pada momen tertentu. Ukuran ruang keadaan bergantung pada tipe lingkungan:
Ruang aksi adalah semua hal yang dapat dilakukan Bob di lingkungan tersebut. Dalam contoh tiang garuk, aksi Bob bisa berupa menggaruk tiang, tidur siang di sofa, atau bahkan mengejar ekornya.
Serupa dengan ruang keadaan, jumlah aksi yang dapat diambil Bob bergantung pada lingkungan:
Saat Bob memulai petualangan tiang garuknya, lingkungan berada pada keadaan bawaan, sebut saja keadaan nol. Dalam kasus kita, ini mungkin ruangan dengan tiang garuk yang sudah dipasang. Setiap aksi yang diambilnya memindahkan lingkungan ke keadaan-keadaan berikutnya yang baru.
Agar Bob mencapai tujuan keseluruhannya, ia membutuhkan insentif atau penghargaan.
Sebagian besar masalah RL memiliki penghargaan yang telah ditetapkan. Misalnya, dalam catur, menangkap bidak lawan adalah penghargaan positif, sementara skak adalah penghargaan negatif.
Dalam kasus kita, kita bisa memberi Bob camilan jika kita melihat aksi positif, seperti tidak menggaruk furnitur selama beberapa waktu atau jika ia benar-benar menemukan salah satu tiang garuk. Kita juga bisa menghukumnya dengan semprotan air di wajah jika ia mencakar gorden.
Untuk mengukur kemajuan perjalanan belajar Bob, kita dapat memikirkan aksinya dalam istilah langkah waktu. Misalnya, pada langkah waktu t1, Bob mengambil aksi a1, yang menghasilkan keadaan baru s1 (s0 adalah keadaan bawaan). Ia juga mungkin menerima penghargaan r1.
Kumpulan langkah waktu disebut sebuah episode. Episode selalu dimulai pada keadaan bawaan (furnitur dan tiang telah disiapkan) dan berakhir ketika tujuan tercapai (tiang ditemukan) atau agen gagal (menggaruk furnitur). Terkadang, episode juga dapat berakhir berdasarkan berapa banyak waktu yang telah berlalu (seperti pada catur).
Seperti pemain catur andal, Bob tidak seharusnya hanya mencari tiang garuk mana saja. Bob sebaiknya menginginkan yang menghasilkan camilan paling banyak. Ini menyoroti dilema klasik dalam reinforcement learning: eksplorasi vs. eksploitasi.
Meski tiang yang menggoda mungkin menawarkan kepuasan instan, eksplorasi yang lebih strategis bisa mengarah pada camilan jackpot di kemudian hari. Sama seperti pemain catur yang mungkin mengorbankan tangkapan untuk memperoleh posisi yang lebih unggul, Bob mungkin awalnya menggaruk tiang yang kurang optimal (eksplorasi) untuk menemukan surga menggaruk terbaik (eksploitasi). Strategi jangka panjang ini penting agar agen memaksimalkan penghargaan di lingkungan yang kompleks.
Dengan kata lain, Bob harus menyeimbangkan eksploitasi (bertahan pada yang paling efektif) dengan eksplorasi (sesekali menjelajah untuk mencari tiang garuk baru). Terlalu banyak menjelajah bisa membuang waktu, terutama di lingkungan kontinu, sementara terlalu banyak mengeksploitasi bisa membuat Bob melewatkan sesuatu yang lebih baik.
Untungnya, ada beberapa strategi cerdas yang bisa diambil Bob:
Dengan menggunakan strategi-strategi ini (atau yang lain di luar cakupan tutorial kita), Bob dapat menemukan keseimbangan antara menjelajahi hal yang belum diketahui dan bertahan pada yang sudah terbukti baik.
Bob tidak bisa begitu saja mencari cara memaksimalkan jumlah camilan sendirian. Ia membutuhkan metode dan alat untuk membimbing keputusannya di setiap keadaan lingkungan. Di sinilah algoritma reinforcement learning datang membantu Bob.
Dari perspektif yang lebih luas, algoritma reinforcement learning dapat dikategorikan berdasarkan bagaimana mereka membuat agen berinteraksi dengan lingkungan dan belajar dari pengalaman. Dua kategori utama algoritma reinforcement learning adalah berbasis model dan tanpa model.
Dalam algoritma berbasis model, agen (seperti Bob) membangun model internal dari lingkungan. Model ini merepresentasikan dinamika lingkungan, termasuk transisi keadaan dan probabilitas penghargaan. Agen kemudian dapat menggunakan model ini untuk merencanakan dan mengevaluasi berbagai aksi sebelum melakukannya di lingkungan nyata.
Pendekatan ini memiliki keunggulan lebih hemat sampel, terutama di lingkungan kompleks. Artinya, Bob mungkin membutuhkan lebih sedikit percobaan menggaruk untuk mengidentifikasi tiang optimal dibandingkan pendekatan murni coba-coba. Sebab Bob bisa merencanakan dan mengevaluasi sebelum bertindak.
Kelemahannya adalah membangun model yang akurat bisa menantang, terutama untuk lingkungan kompleks. Model mungkin tidak mencerminkan lingkungan nyata secara akurat, yang mengarah pada perilaku suboptimal.
Algoritma RL berbasis model yang umum adalah Dyna-Q, yang sebenarnya menggabungkan pembelajaran berbasis model dan tanpa model. Ia membangun model lingkungan dan memanfaatkannya untuk perencanaan aksi sambil secara bersamaan belajar langsung dari pengalaman melalui Q-learning tanpa model (yang akan kita jelaskan sebentar lagi).
Pendekatan ini berfokus pada pembelajaran langsung dari interaksi dengan lingkungan tanpa secara eksplisit membangun model internal. Agen (Bob) mempelajari nilai dari keadaan dan aksi atau strategi optimal melalui coba-coba.
RL tanpa model menawarkan pendekatan yang lebih sederhana di lingkungan tempat pembangunan model akurat itu menantang. Bagi Bob, ini berarti ia tidak perlu membuat peta mental ruangan yang kompleks—ia dapat belajar melalui menggaruk dan merasakan konsekuensinya.
RL tanpa model unggul di lingkungan dinamis tempat aturannya mungkin berubah. Jika tata letak furnitur ruangan berubah, Bob dapat menyesuaikan eksplorasinya dan mempelajari titik menggaruk optimal yang baru.
Namun, belajar hanya melalui coba-coba bisa kurang hemat sampel. Bob mungkin harus banyak menggaruk furnitur sebelum secara konsisten menemukan tiang yang paling memberi penghargaan.
Beberapa algoritma RL tanpa model yang umum meliputi:
Algoritma yang sebaiknya kita pilih bergantung pada berbagai faktor: kompleksitas lingkungan, ketersediaan sumber daya, atau tingkat keterjelasan yang diinginkan.
Pendekatan berbasis model mungkin lebih disukai untuk lingkungan yang lebih sederhana di mana pembangunan model akurat itu layak. Di sisi lain, pendekatan tanpa model sering kali lebih praktis untuk skenario dunia nyata yang kompleks.
Selain itu, dengan bangkitnya deep learning, Deep Q-Networks (DQN) dan algoritma RL mendalam lainnya makin populer untuk menangani tugas-tugas kompleks dengan ruang keadaan berdimensi tinggi.
Sekarang mari kita fokus pada satu algoritma dan mempelajari lebih lanjut tentang Q-learning.
Q-learning adalah algoritma tanpa model yang mengajarkan strategi menang optimal kepada agen melalui interaksi cerdas dengan lingkungan.
Mari kembali ke contoh kucing kita dan bayangkan kita menyelesaikan versi arkade dari masalah ini dengan lingkungan diskret dan himpunan aksi hingga.
Misalkan kita memberikan Bob sebuah tabel. Kolom-kolom mewakili aksi yang tersedia, sementara setiap baris memetakan aksi ke keadaan tertentu dari ruang keadaan.
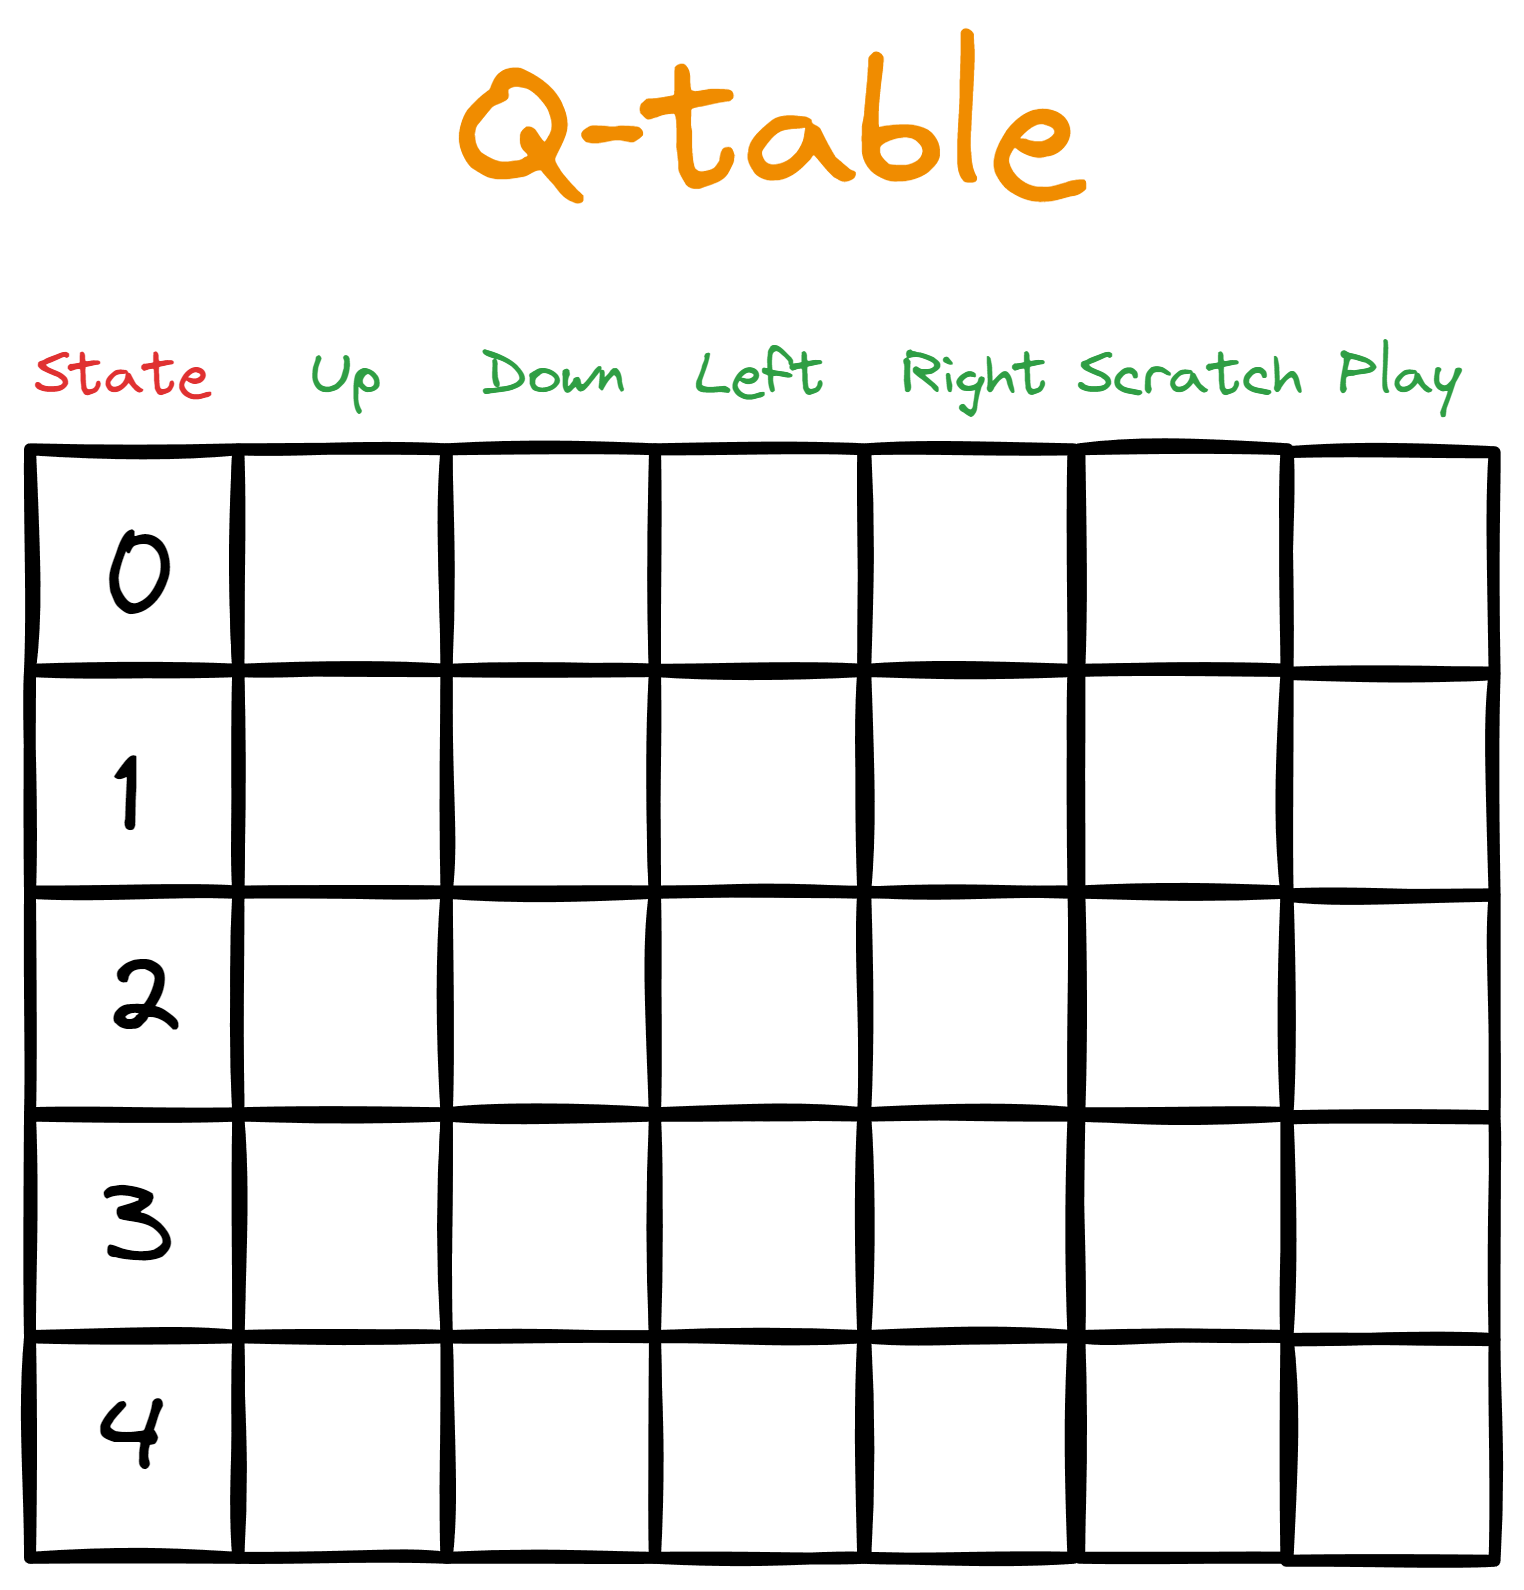
Pada awalnya, kita mengisi tabel dengan nol, yang merepresentasikan nilai Q awal—karena itu, kita menyebutnya Q-table.
Lalu, kita memulai loop interaksi dari keadaan bawaan (awal sebuah episode). Di dalam loop, Bob mengambil aksi dengan nilai Q tertinggi untuk keadaan yang diberikan. Namun, pada putaran pertama loop, tidak akan ada nilai Q tertinggi untuk membimbing aksi Bob karena semua nilai Q awalnya nol.
Di sinilah strategi eksplorasi (seperti eksplorasi acak atau epsilon-greedy) berperan. Strategi-strategi ini membantu Bob mengumpulkan informasi saat Q-table masih kosong.
Setelah Q-table diperbarui, Bob memulai loop interaksi lagi. Aksi yang diambilnya menghasilkan penghargaan dan keadaan baru. Lalu, kita menghitung nilai Q baru untuk setiap aksi yang dapat diambil Bob di keadaan baru tersebut (sebentar lagi kita perlihatkan cara menghitung nilai Q).
Episode berlanjut hingga terminasi (Bob dapat mengambil jumlah langkah berapa pun di setiap episode), lalu kita mulai lagi. Setiap episode berikutnya akan memiliki Q-table yang lebih kaya, membuat Bob makin pintar.
Berikut adalah gambaran tingkat tinggi dari langkah-langkah yang terlibat:
Langkah seperti satu dan dua mungkin mudah, tetapi sisanya membutuhkan penjelasan lebih lanjut.
Pada langkah waktu 1, ketika Bob mengambil aksi pertamanya, itu akan acak, karena semua nilai Q nol. Pada langkah waktu berikutnya, Bob harus mempertimbangkan keseimbangan antara eksplorasi dan eksploitasi.
Untuk membantu hal itu, kita memberi Bob sebuah hiperparameter bernama epsilon dengan nilai kecil—biasanya 0,1. Lalu, kita meminta Bob menghasilkan angka acak antara 0 dan 1 dan jika angkanya lebih kecil dari epsilon, ia akan memilih aksi acak terlepas dari nilai Q-nya.
Jika angkanya lebih tinggi dari epsilon, Bob akan memilih aksi dengan nilai Q tertinggi. Dengan cara ini, Bob akan menjelajah sebesar epsilon (0,1 atau 10%) dari waktu dan mengeksploitasi (1 - epsilon atau 0,9 atau 90%) dari waktu.
Apa yang baru saja kita jelaskan disebut kebijakan epsilon-greedy. Kebijakan mendefinisikan bagaimana agen mengambil aksi dan bagaimana nilai Q dihitung.
Aturan untuk menghitung penghargaan biasanya ditetapkan oleh orang yang membuat lingkungan. Misalnya, Anda mungkin memutuskan memberi Bob satu camilan untuk menggunakan karpet garuk dan lima camilan untuk melompat cukup tinggi agar bisa menggaruk yang di dinding. Ada juga kemungkinan Anda menghukum Bob karena menggaruk objek berharga.
Namun, sebagian besar waktu, tidak akan ada penghargaan karena Bob akan tidur, berjalan, atau bermain.
Rumus untuk menghitung nilai Q bisa terasa menakutkan, jadi mari kita lihat dulu secara lengkap lalu jelaskan langkah demi langkah:
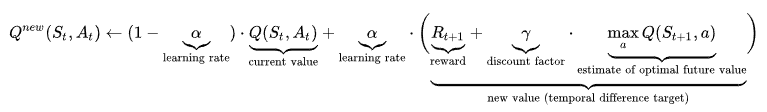
Mari kita lihat awal dari rumus:
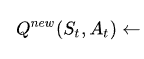
Bagian ini mengatakan, “Diberikan keadaan dan aksi sebelumnya, nilai Q baru dihitung sebagai (...).”
Bagian di bawah ini adalah nilai Q saat ini (yang segera menjadi lama) yang digunakan agen untuk melakukan aksi.

Sekarang mari kita lihat bagian akhirnya:

St+1 adalah keadaan baru yang dihasilkan dari mengambil aksi At. Jadi, bagian ini mencari nilai Q terbesar dari semua aksi (a) pada keadaan baru tersebut. Kita mengalikan nilai itu dengan parameter γ yang disebut gamma (faktor diskonto) dan menambahkan hasilnya ke penghargaan yang diterima.
Jika kita setel gamma mendekati 1, kita memberi bobot lebih berat pada penghargaan masa depan. Jika kita turunkan mendekati nol, kita menekankan penghargaan saat ini Rt+1 lebih banyak. Ini berarti gamma adalah parameter lain yang dapat kita gunakan untuk menyeimbangkan eksplorasi dan eksploitasi.
Terakhir, kita memiliki alpha (α), yang mengontrol kecepatan pelatihan dan berkisar dari 0 hingga 1. Nilai yang mendekati 1 membuat pembaruan nilai Q lebih besar, sehingga agen belajar lebih cepat, membuat sisi kanan tanda plus lebih berat. Sebaliknya, nilai yang mendekati 0 membuat sisi kiri lebih berat, yang memuat nilai Q saat ini.
Menggunakan laju pembelajaran untuk mengontrol kecepatan pelatihan memastikan agen tidak berkembang terlalu cepat dan melupakan informasi lama. Ini juga memastikan ia tidak belajar terlalu lambat, sehingga berisiko melewatkan informasi penting.
Ini adalah bagian paling menantang dari memahami Q-learning, dan saya harap Anda mendapat gambaran tentang cara kerjanya.
Seperti halnya bidang lain, Python memiliki kerangka kerja untuk menyelesaikan masalah reinforcement learning. Yang paling populer adalah Gymnasium, yang hadir dengan lebih dari 2000 lingkungan bawaan (seluruhnya terdokumentasi dengan baik).
$ pip install "gymnasium[atari]"
$ pip install autorom[accept-rom-license]
$ AutoROM --accept-license

import gymnasium as gym
env = gym.make("ALE/Breakout-v5")
Lingkungan yang baru saja kita muat bernama Breakout. Inilah tampilannya:
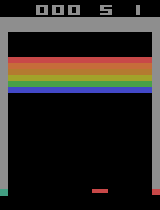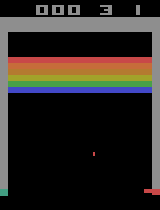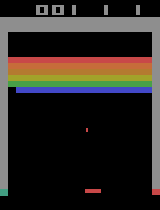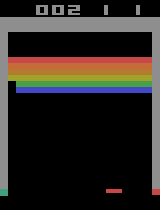
Tujuannya di sini adalah agar papan (agen) belajar bagaimana menghilangkan semua bata melalui coba-coba. Aturan permainan menentukan penalti dan penghargaan.
Kita akan menutup artikel ini dengan menunjukkan cara Anda menjalankan episode interaksi sendiri dan memvisualisasikan kemajuan agen dengan GIF seperti di atas.
Berikut adalah kode untuk loop interaksi:
epochs = 0

frames = []  # for animation
done = False

env = gym.make("ALE/Breakout-v5", render_mode="rgb_array")
observation, info = env.reset()

while not done:
    action = env.action_space.sample()
    observation, reward, terminated, truncated, info = env.step(action)

    # Put each rendered frame into dict for animation
    frames.append(
        {
            "frame": env.render(),
            "state": observation,
            "action": action,
            "reward": reward,
        }
    )

    epochs += 1
    if epochs == 1000:
        break
Kita baru saja menjalankan seribu langkah waktu, atau dengan kata lain, agen melakukan 1000 aksi. Namun, semua aksi ini benar-benar acak—agen tidak belajar dari kesalahan masa lalu. Untuk memverifikasinya, kita bisa menggunakan variabel frames untuk membuat GIF:
from moviepy.editor import ImageSequenceClip
# !pip install moviepy - if you don’t have moviepy

def create_gif(frames: dict, filename, fps=100):
    """
    Creates a GIF animation from a list of RGBA NumPy arrays.

    Args:
        frames: A list of RGBA NumPy arrays representing the animation frames.
        filename: The output filename for the GIF animation.
        fps: The frames per second of the animation (default: 10).
    """
    rgba_frames = [frame["frame"] for frame in frames]

    clip = ImageSequenceClip(rgba_frames, fps=fps)
    clip.write_gif(filename, fps=fps)

# Example usage
create_gif(frames, "animation.gif") #saves the GIF locally
Catatan: Jika Anda mengalami galat “RuntimeError: No ffmpeg exe could be found”, coba tambahkan dua baris kode berikut sebelum mengimpor moviepy:
from moviepy.config import change_settings
change_settings({"FFMPEG_BINARY": "/usr/bin/ffmpeg"})
Potongan kode pertama kita mengembalikan keadaan lingkungan sebagai array RGBA untuk setiap langkah waktu, dan semuanya disimpan di frames. Dengan menyatukan semua frame menggunakan pustaka moviepy, kita dapat membuat GIF seperti yang Anda lihat sebelumnya:

Sebagai catatan tambahan, Anda dapat menyesuaikan parameter fps untuk membuat GIF lebih cepat jika Anda menjalankan banyak langkah waktu.
Sekarang setelah kita melihat agen hanya melakukan aksi acak, saatnya mencoba beberapa algoritma. Anda dapat melakukannya langkah demi langkah dalam kursus Reinforcement Learning with Gymnasium in Python, tempat Anda akan mengeksplorasi banyak algoritma termasuk Q-learning, SARSA, dan lainnya.
Pastikan untuk menggunakan fungsi yang baru saja kita buat untuk menganimasikan kemajuan agen Anda, dan selamat bersenang-senang!
Reinforcement learning adalah salah satu hal paling menarik dalam ilmu komputer dan pembelajaran mesin. Dalam tutorial ini, kita telah mempelajari konsep dasar RL—mulai dari agen dan lingkungan hingga algoritma tanpa model seperti Q-learning.
Namun, membuat agen kelas dunia yang dapat memecahkan masalah kompleks seperti catur atau video gim akan memerlukan waktu dan latihan. Berikut beberapa sumber yang mungkin membantu Anda di perjalanan:
Terima kasih telah membaca!
Pelajari lebih lanjut tentang AI dan reinforcement learning!
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



