Accéder au contenu principal

Comprendre la superalignment : aligner l’IA sur les valeurs humaines

Explorez le concept de superalignment en IA et découvrez pourquoi aligner l’intelligence artificielle sur les valeurs humaines est essentiel pour des systèmes sûrs et utiles. Passez en revue les défis et les solutions pour créer des IA qui comprennent et partagent réellement nos objectifs.
Actualisé 18 sept. 2026  · 15 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Comme tous les modèles d’apprentissage automatique, les systèmes d’IA sont entraînés à minimiser une fonction d’erreur. Un bon entraînement est nécessaire mais ne suffit pas pour intégrer un modèle d’IA dans le quotidien des utilisateurs et les workflows des organisations

Pour des interactions homme-IA réussies, les modèles doivent être capables de décrypter l’intention de l’utilisateur et d’agir selon des principes de sécurité et d’équité. Par exemple, un chatbot doit s’abstenir de fournir des instructions pour se blesser ou nuire à autrui, et un modèle d’aide au recrutement ne doit pas discriminer les candidats. 

Les systèmes d’IA gagnent en puissance et s’intègrent au quotidien. Les développeurs doivent donc s’assurer que le comportement de l’IA, à grande échelle, respecte l’éthique, les valeurs et la morale humaines. C’est ce que l’on appelle la superalignment. Le cours AI Ethics détaille les aspects éthiques de l’IA.

Dans cet article, nous expliquons la superalignment des modèles d’IA, présentons différentes méthodes pour y parvenir, en général et pour les LLM en particulier, et abordons les considérations éthiques ainsi que les défis pratiques de la superalignment. 

Découvrez comment l’IA peut transformer votre organisation et comment déployer des stratégies gagnantes avec notre livre blanc, The Learning Leader's Guide to AI Literacy.

L’alignement de l’IA : un aperçu rapide

L’alignement désigne l’ensemble des processus et méthodes visant à garantir qu’un système d’IA se comporte conformément à l’intention de l’utilisateur, sans biais, tout en respectant les consignes de sécurité. Cet article explique les notions et méthodes utilisées en alignement. 

En complément de la supervision humaine, les développeurs adoptent des méthodes comme le filtrage et les systèmes à règles pour assurer l’alignement des systèmes d’IA. Les techniques efficaces pour un petit nombre d’utilisateurs deviennent toutefois impraticables lorsqu’on les applique à un modèle plus puissant et largement diffusé. Par exemple : 

  • Le filtrage de contenu utilise des algorithmes pour empêcher le modèle de produire des contenus préjudiciables, comme le langage grossier ou des images explicites. Mais ces filtres restent limités à ce qu’ils savent détecter et ne protègent pas contre de nouvelles formes de contenus indésirables. 
  • Les systèmes à règles s’appuient sur des règles prédéfinies pour prévenir certains usages indésirables, comme des instructions pour se blesser ou blesser autrui. Ils ne s’adaptent toutefois pas aux comportements inattendus des utilisateurs ou des modèles. 
  • Les méthodes classiques de réduction des biais, comme le réajustement des pondérations des données d’entraînement, aident à éviter des biais connus, mais peuvent s’avérer insuffisantes pour détecter des biais nouveaux et plus subtils lorsque des systèmes d’IA complexes sont employés dans des contextes inédits. 

Ainsi, des modèles d’IA puissants, opérant à grande échelle et sur un large spectre d’usages, requièrent une nouvelle approche de l’alignement : c’est la superalignment. 

Qu’est-ce que la superalignment ?

L’ampleur, l’échelle, la complexité et la diffusion des modèles d’IA puissants entraînent un ensemble entièrement nouveau de défis d’alignement. 

Les méthodes et approches visant à aligner des modèles d’IA à grande échelle sur les valeurs, l’éthique et la morale humaines relèvent de la superalignment. Elle couvre de nombreux sous-domaines. 

De façon générale, des systèmes « superalignés » devraient : 

  • Rechercher activement la collaboration humaine pour rester alignés au-delà de l’alignement initial.
  • S’aligner et se ré-aligner en continu pour intégrer de nouveaux cas d’usage et des valeurs humaines implicites. C’est le pipeline d’alignement. 
  • Expliquer leurs actions et ajuster leurs réponses sur la base des retours humains. 

La superalignment est un domaine en pleine évolution. Elle traite des modèles d’IA de pointe actuels et anticipe des méthodes pour des modèles encore plus puissants à venir. 

À mesure que l’IA gagne en puissance, on s’attend à ce qu’elle gère de nombreux aspects de la vie humaine, comme l’agriculture, les transports, etc. Un tel système doit toujours placer l’intérêt des humains au-dessus de toute autre considération.

Améliorez les compétences de votre équipe en matière d'IA

Transformez votre entreprise en dotant votre équipe de compétences avancées en matière d'IA grâce à DataCamp for Business. Améliorez vos connaissances et votre efficacité.
Demandez Une Démonstration Dès Aujourd'hui !
business-homepage-hero.png

Techniques pour atteindre la superalignment

Dans cette section, nous présentons plusieurs méthodes et techniques utilisées pour parvenir à la superalignment. L’idée directrice est que ces approches doivent être scalables. 

Entraînement antagoniste

Comme pour tout entraînement, il faut tester si le système a appris les comportements souhaitables. Une façon d’évaluer la superalignment consiste à confronter l’IA à des contre-exemples. Les grands systèmes d’IA doivent apprendre à repérer les demandes formulées de mauvaise foi et à les traiter de manière appropriée. 

Une approche courante est de mettre deux IA en opposition, à l’image des équipes « red team » et « blue team » employées en cybersécurité, où la red team tente de percer les défenses de la blue team. 

Dans le cadre de l’entraînement antagoniste pour la superalignment, chaque IA cherche des entrées qui perturberont l’autre. Par exemple, supposons une IA (blue team) alignée pour éviter tout juron. Pendant l’entraînement antagoniste, l’IA adverse (red team) tente de trouver des invites qui déclenchent des réponses inappropriées. L’objectif est de garantir que, même testée par la red team, la blue team continue de produire des réponses acceptables.
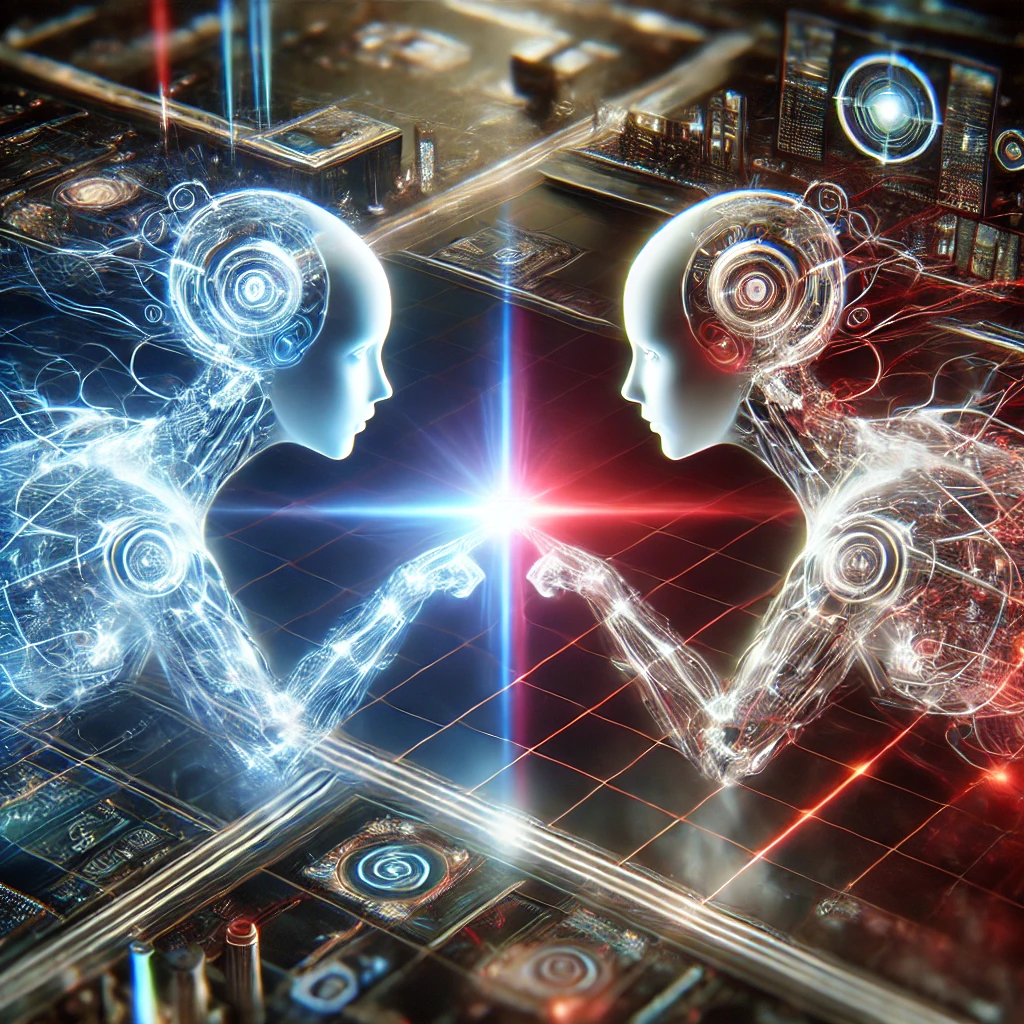
Illustration du concept d’entraînement antagoniste

Illustration du concept d’entraînement antagoniste. Image créée avec DALL·E

Entraînement à la robustesse

La robustesse consiste à distinguer des entrées réellement différentes mais qui paraissent similaires en surface, et à reconnaître les cas limites. Par exemple, un système d’identification d’actions humaines dans des vidéos doit différencier une vraie bagarre de rue d’une scène chorégraphiée au cinéma. Les confondre peut avoir des conséquences néfastes. 

Les grands modèles doivent donc être exposés à des scénarios superficiellement proches pour apprendre les nuances et les subtilités. 

Supervision à l’échelle

À mesure que les modèles trouvent de nouveaux utilisateurs et de nouveaux usages, leur supervision doit évoluer en parallèle. L’intervention humaine est centrale pour superviser et aligner l’IA. Or, augmenter l’échelle de la supervision humaine est plus difficile que de faire évoluer une solution technologique. Pour maintenir une supervision scalable, de nouvelles méthodes sont nécessaires :

  • Surveillance automatisée en temps réel : des systèmes automatisés suivent en continu les réponses de l’IA et contrôlent son comportement pour vérifier sa conformité aux valeurs humaines. Les écarts significatifs par rapport aux attentes sont signalés pour intervention humaine. 
  • Revues programmatiques : au lieu de passer manuellement en revue tous les résultats, on développe des programmes et algorithmes qui vérifient l’alignement de l’IA avec l’éthique humaine. Les cas douteux sont remontés à des modérateurs humains.

Apprentissage par renforcement avec retour humain (RLHF)

Comme expliqué dans l’article sur l’apprentissage par renforcement (RL), dans les implémentations RL traditionnelles, le système d’IA ajuste son comportement en observant l’humain, via l’essai-erreur pour maximiser la récompense. Le RLHF combine RL et retours humains pour guider l’IA pendant l’entraînement. 

Le RLHF part d’un modèle préentraîné. Des réviseurs humains assignent des tâches et fournissent des retours sur les sorties, par exemple en notant ou en corrigeant les réponses du modèle. 

Le modèle utilise ces informations pour affiner son comportement afin de s’aligner sur le feedback humain et maximiser la récompense (retours positifs). Le processus est répété jusqu’à ce que les sorties soient jugées pertinentes, appropriées et exactes. 

Apprentissage par renforcement inverse (IRL)

Dans le RL traditionnel, les concepteurs définissent explicitement la fonction de récompense (ou d’utilité). Le modèle cherche à maximiser l’incitation associée. 

En RL inverse, le modèle déduit la fonction de récompense à partir du comportement d’un humain ou d’un modèle entraîné. Par exemple, une voiture autonome en RL pourrait recevoir des incitations positives pour rester dans sa voie, s’arrêter au feu rouge, etc. Un système IRL, lui, infère ces incitations en observant de près un conducteur humain expérimenté ou une IA déjà entraînée. 

Comme on ne peut pas lister explicitement les valeurs humaines pour tous les contextes, le RL traditionnel est difficile à appliquer aux problèmes d’alignement.

Une approche plus efficace consiste à faire observer et reproduire par l’IA le comportement humain dans différents contextes. En observant l’humain, l’IA apprend, parmi les réponses possibles, lesquelles se rapprochent le plus de ce qu’un humain ferait. Cela aide à aligner le comportement de l’IA sur les valeurs humaines.
Illustration du concept d’apprentissage par renforcement inverse

Illustration du concept d’apprentissage par renforcement inverse. Image créée avec DALL·E

Débat

Beaucoup de méthodes d’alignement impliquent qu’un humain enseigne à l’IA ce qui est acceptable ou non, mais l’humain n’est pas toujours la meilleure solution.

Pour certains problèmes complexes, comme l’optimisation d’un horaire ferroviaire national, aucun humain n’est en mesure de juger si une solution est optimale. Une piste est de s’appuyer sur l’IA elle-même pour la superalignment. Dans la méthode du débat :

  • Une IA propose une solution et explique en détail chaque étape. 
  • La même IA ou une autre IA critique ensuite chaque explication (arguments contraires). 
  • Un humain tranche sur l’argument le plus solide. Comme chaque argument porte sur un périmètre limité, il est plus facile d’en juger la validité. 

Le raisonnement logique devient un jeu où le meilleur argument l’emporte. Au fil des débats, l’IA apprend quelles lignes de raisonnement sont acceptables et lesquelles ne le sont pas. Pour les tâches futures, sa production est mieux alignée avec les valeurs humaines. 

Amplification itérative

Dans l’apprentissage automatique et profond traditionnel, l’entraînement se base sur la correspondance entre sortie attendue et sortie du modèle. 

À mesure que les capacités de l’IA grandissent, elle sera mobilisée sur des tâches toujours plus complexes. Pour nombre d’entre elles, les humains ne connaissent pas à l’avance la sortie attendue : seules les solutions proposées par l’IA existent. Aligner l’IA sur le résultat final devient alors difficile, car les humains ne peuvent pas l’évaluer directement. 

Par exemple, concevoir un plan de transport suppose d’équilibrer viabilité économique et service public. De telles considérations compliquent l’identification du design final le mieux aligné sur les valeurs humaines.

Dans ces cas, il est plus simple de recourir à une supervision humaine sur de plus petites sous-tâches. Ensuite, des tâches un peu plus larges sont décomposées en sous-tâches puis alignées avec supervision humaine. Le processus se répète jusqu’à ce que les tâches deviennent trop vastes pour être jugées directement par des humains. 

L’amplification itérative part du principe que si les sous-tâches simples ont été alignées via validation humaine, la tâche principale l’est aussi. Cette approche peut se combiner à d’autres, comme le débat. 

Apprentissage des valeurs

Les interactions humaines sont complexes et nuancées. Souvent, les actions humaines sont ambiguës hors contexte. Les fonctions d’utilité traditionnelles et le RL ne suffisent donc pas à imprégner l’IA de valeurs humaines. 

Une alternative consiste à doter le modèle d’un ensemble de fonctions d’utilité plutôt que d’une seule. Chaque fonction peut être retenue selon le contexte. Le modèle apprend à choisir la bonne fonction d’utilité en observant des actions humaines dans des contextes variés : c’est l’apprentissage des valeurs. 

L’apprentissage des valeurs consiste à exposer directement l’IA à des comportements humains divers et à lui faire apprendre le comportement adapté à chaque contexte. 
Illustration du concept d’apprentissage des valeurs

Illustration du concept d’apprentissage des valeurs. Image créée avec DALL·E

Les humains impliqués dans l’entraînement à l’alignement doivent adopter des comportements exemplaires. Par exemple, un conducteur ne devrait pas céder à la colère au volant lorsqu’il sert de référence à une IA. En revanche, lorsqu’il est bloqué derrière un véhicule lent, il devrait chercher à le dépasser en toute sécurité.

Superalignment dans les grands modèles de langage (LLM)

Les LLM sont aujourd’hui les modèles d’IA à grande échelle les plus populaires, mobilisés pour une large variété de tâches. Vu l’ampleur de leur base d’utilisateurs et de leurs cas d’usage, la superalignment des LLM mérite une attention particulière. 

LLM et défis d’alignement

Les grands modèles de langage comme GPT-4, Gemini et Meta AI commencent à entrer dans la vie courante.  Compte tenu de leur échelle et de leur portée, ils apportent de nouveaux défis d’alignement, tels que : 

  • Perpétuation des biais : ces modèles sont entraînés sur d’immenses volumes de données issues d’Internet et d’autres corpus. Les biais présents dans les données d’apprentissage se retrouvent directement dans les sorties du modèle. Le biais dû aux carences des données d’entrée est qualifié de biais algorithmique
  • Systèmes complexes : la taille de ces modèles, l’immensité des données d’entraînement et la diversité des usages compliquent la prédiction de leur comportement, et rendent difficile la garantie d’un alignement pour tous les cas d’usage. 
  • Problèmes d’échelle : compte tenu de leur vaste base d’utilisateurs et du volume de requêtes traitées : 
  • Même si le pourcentage de réponses non alignées est faible, cela représente un nombre absolu important.
  • Il devient difficile d’assurer que le comportement de l’IA reste constamment aligné sur les valeurs et l’éthique humaines pour tous les utilisateurs. 

Cela impose d’adopter de nouvelles méthodes pour tester le niveau d’alignement et d’affiner en continu ces modèles afin de garantir leur conformité aux valeurs et standards éthiques humains. 

Évaluer les sorties des LLM

De nombreuses approches ont été proposées et testées pour évaluer les sorties des LLM et garantir leur alignement. Elles doivent être scalables. Exemples : 

  • Filtrage des sorties indésirables : une approche pragmatique consiste à placer une couche de filtrage au-dessus du modèle de langage. Entraîner séparément les systèmes de génération et de filtrage est plus efficace. Le filtre peut être une autre IA qui balaie les sorties du LLM générateur à la recherche de langage inapproprié et de sujets sensibles. 
  • Détection des biais : les jeux d’entraînement comportent inévitablement des biais, qui se transmettent aux modèles. Quelques méthodes pour détecter les biais dans les sorties de LLM : 
    • Les équipes de développement auditent les modèles pour repérer des sorties biaisées, en les testant avec des entrées diverses et en comparant les réponses.
    • Des algorithmes spécialisés de détection des biais peuvent être utilisés pour rechercher et identifier systématiquement différents types de biais. 
  • Vérification des faits : les hallucinations sont un écueil majeur des LLM. Un LLM ne sait que prédire les mots qui suivent une séquence, selon ses données d’entraînement ; il n’a aucune conscience des faits. Pour un LLM, « Dell fabrique des ordinateurs personnels » et « Dell fabrique des chips de pomme de terre » sont également plausibles. Ainsi, lorsqu’on utilise un LLM pour générer du texte factuel, il est crucial de vérifier l’exactitude des informations.
  • Explicabilité : les systèmes informatiques traditionnels sont fondés sur des règles, qu’on peut déboguer pour identifier l’origine d’une sortie. Les LLM, eux, comptent des milliards de paramètres : il est impossible d’identifier précisément quelles pondérations contribuent à telle ou telle partie de la réponse. 

Heureusement, le raisonnement est une propriété émergente des grands modèles de langage. Une propriété émergente est une caractéristique d’un système complexe qui ne s’explique pas par la somme de ses parties. 

On observe souvent que les LLM savent expliquer leurs réponses et raisonner en plusieurs étapes. Leur demander d’expliciter une solution complexe, puis évaluer manuellement chaque étape, permet aux humains de valider la réponse du LLM. 

LLM et interaction humaine

Les LLM utilisés de manière interactive doivent comprendre les nuances et subtilités des conversations humaines et répondre en fonction du contexte. 

Le ton, l’intention, l’ironie et les signaux émotionnels sont difficiles à formaliser, mais les modèles d’IA doivent en tenir compte pour communiquer efficacement. Seul un LLM aligné pour faire preuve d’empathie sera réellement efficace en interaction, capable de bâtir la confiance et de favoriser des échanges productifs. La voie pour y parvenir repose sur l’application des différentes techniques de superalignment. 

Considérations éthiques de la superalignment

L’objectif ultime de la superalignment est que des IA puissantes se conforment aux standards éthiques de la société humaine. 

Cette section explique le rôle de l’éthique dans la superalignment et les défis à relever pour garantir un comportement éthique des grands modèles. 

Garantir un comportement éthique

Une IA non alignée sur les valeurs humaines ne peut pas être sûre pour les utilisateurs. Un système mal aligné peut produire des contenus nuisibles exploitables par des acteurs malveillants, perpétuer des inégalités sociales et amplifier des biais existants. 

Dans le pire des cas, un système mal aligné peut détourner ses capacités et adopter des comportements manipulateurs. Les enjeux éthiques sont donc au cœur de tous les efforts de superalignment. Ce n’est qu’en garantissant un comportement éthique en toutes circonstances que les outils d’IA pourront être considérés comme fiables et dignes de confiance à grande échelle et sur le long terme. 

Trouver l’équilibre entre utilité et sécurité

Intégrer l’éthique dans les systèmes d’IA a un coût significatif. Pour atteindre la superalignment, les équipes ont besoin :

  • D’humains pour auditer les réponses et fournir des retours
  • De temps supplémentaire avant la mise à disposition du modèle
  • De ressources de calcul additionnelles pour l’affinage et l’alignement 

En phase d’inférence, le modèle doit en outre effectuer des calculs supplémentaires pour s’assurer que ses réponses restent alignées. Parfois, imposer l’alignement comme contrainte peut limiter ses capacités. Un modèle superaligné peut donc être moins performant. 

Il faut donc équilibrer performance technique et exigences d’alignement. Prioriser l’alignement et la sécurité au détriment des métriques de performance classiques peut conduire à des modèles peu utiles en pratique. 

Équité et biais

Les modèles d’IA à grande échelle ont de nombreux utilisateurs et des usages variés. Tout biais dans leurs sorties peut avoir des conséquences étendues. Les développeurs doivent donc veiller à réduire autant que possible ces biais. 

Éliminer les biais des LLM est difficile, car ces modèles sont préentraînés de façon non supervisée sur d’immenses corpus. L’IA absorbe les biais et préjugés présents dans ces textes, ce qui peut engendrer des résultats injustes et discriminatoires. Plusieurs leviers existent :

  • Détection des biais : avant toute contre-mesure, il faut identifier les occurrences biaisées. Des audits réguliers et des évaluations d’équité sur des échantillons de sorties aident à repérer les types de biais et les situations qui les déclenchent. 
  • Élimination des biais : trois approches principales :
    • Programmer le modèle pour corriger certains biais dans la sortie.
    • Enrichir les données d’entraînement par des données synthétiques. Par exemple, si un système de reconnaissance d’images contient très peu d’exemples d’une espèce animale, la probabilité de l’identifier diminue. On compense souvent par de nouvelles images synthétiques et/ou une pondération accrue pendant l’entraînement. 
    • Réajuster les poids des sous-ensembles sous-représentés des données d’entraînement, afin que ces catégories disposent d’une pondération équivalente aux autres. 
  • Suivi continu : les modèles sont réentraînés périodiquement sur de nouvelles données. Le comportement des versions futures est aussi influencé par les interactions passées. En parallèle, le comportement des utilisateurs évolue au contact des IA. La détection et l’élimination des biais doivent donc s’inscrire en continu dans le cycle de développement. 

Défis pour atteindre la superalignment

Comme expliqué précédemment, atteindre la superalignment est exigeant. Parmi les principales difficultés : 

  • Complexité et échelle des modèles : les modèles modernes comptent des milliards de paramètres, rendant leurs réponses difficiles à prévoir et leurs décisions ardues à expliquer. Assurer un alignement constant est donc complexe, et de petites mises à jour peuvent le perturber. 
  • Scalabilité des techniques d’alignement : la supervision humaine est centrale. À mesure que les modèles s’étendent, ils doivent être alignés dans un nombre croissant de scénarios, posant des questions d’efficacité et de coût de la supervision. 
  • Généralisation et robustesse : les modèles traitent régulièrement des scénarios nouveaux, alors que l’entraînement et l’alignement reposent sur des données et contextes finis. Le modèle doit étendre son alignement à des situations non couvertes, distinguer les cas limites et se comporter de façon éthique dans de nouvelles circonstances.
  • Mésalignement des valeurs : l’IA n’a pas de compréhension native des valeurs humaines et n’apprend qu’à partir de ses données. Or ces valeurs sont complexes et parfois contradictoires : ce qui est acceptable dans un contexte peut être inapproprié dans un autre. Des incompréhensions peuvent conduire à des réponses inadaptées, voire non éthiques. 
  • Conformité réglementaire : des autorités nationales et supranationales instaurent des cadres juridiques pour que les modèles puissants ne nuisent pas à l’intérêt général. S’y conformer exigera des efforts supplémentaires.
  • Intégration à d’autres systèmes informatiques : la plupart des efforts d’alignement portent sur l’interaction directe humain-IA. De nouveaux défis émergent quand l’IA est intégrée à d’autres systèmes : ses entrées et sorties ne passent plus par le langage naturel, ce qui complique l’interprétation. Assurer la superalignment d’un SI complexe incluant de l’IA soulève des défis inédits. Une piste est de confier l’ensemble à une autre IA, chargée d’aider les humains à le comprendre et le superviser. 
  • Surveillance et mises à jour : le suivi continu des réponses est nécessaire pour garantir un comportement éthique en pratique, via l’échantillonnage aléatoire de sorties sur des entrées réelles. Les mises à jour de paramètres peuvent aussi perturber l’alignement, qui doit donc être maintenu et révisé tout au long du cycle de développement. 

Conclusion

Un système d’IA non aligné avec les valeurs et l’éthique humaines n’est pas adapté à un usage public et peut avoir des conséquences néfastes. 

Dans cet article, nous avons présenté la superalignment, un ensemble de méthodes et d’approches pour aligner des systèmes d’IA puissants, puis nous avons exploré sa mise en œuvre pour les LLM. Enfin, puisque la superalignment est un domaine en évolution, nous avons passé en revue ses principaux défis de mise en pratique.

Obtenez une certification de haut niveau en matière d'IA

Démontrez que vous pouvez utiliser l'IA de manière efficace et responsable.

FAQs

En quoi la superalignment est-elle différente de l’alignement ?

Conceptuellement, elles sont proches mais diffèrent par l’ampleur. L’alignement désigne des systèmes d’IA qui prennent en compte l’intention de l’utilisateur, agissent en contexte et sont exempts de biais.

Le terme « superalignment » renvoie à des modèles d’IA à grande échelle alignés non seulement sur l’intention et le contexte, mais plus largement sur les valeurs, la morale et l’éthique humaines. 

La différence clé tient aux méthodes utilisées : l’alignement peut reposer sur des règles simples, insuffisantes pour la superalignment.

En quoi l’alignement diffère-t-il de l’entraînement ?

L’entraînement d’un modèle vise à minimiser la fonction de perte. L’alignement va au-delà : il garantit que le modèle entraîné agit selon les intentions, valeurs et principes éthiques humains. 

Si les données d’entraînement sont biaisées, le modèle résultant l’est aussi et ne respecte pas les standards éthiques. L’alignement consiste à corriger le modèle pour pallier les lacunes du processus d’entraînement.

La superalignment implique-t-elle toujours des efforts humains ?

Compte tenu du volume colossal d’entrées et de sorties, une supervision manuelle n’est pas toujours possible. Il est plus pragmatique d’adopter des approches automatisées et programmatiques pour auditer et surveiller le comportement de l’IA. L’intervention humaine reste bien sûr nécessaire pour les cas limites.

La superalignment est-elle strictement nécessaire ? Un modèle entraîné ne suffit-il pas ?

Pour des modèles publics à grande échelle, oui, c’est strictement nécessaire. Dès lors que les sorties sont utilisées en pratique, elles doivent respecter les mêmes standards éthiques et moraux que celles d’un humain. Les jeux d’entraînement contiennent par défaut divers biais qui se répercutent sur le modèle entraîné. Il faut donc aligner ce modèle sur les valeurs et standards humains.

Existe-t-il des modules ou logiciels de superalignment prêts à l’emploi ?

La superalignment reste un problème ouvert, avec de nombreuses approches à l’étude. Les chercheurs testent différentes techniques adaptées à leurs modèles. Il n’existe donc pas, à ce jour, de modules standard grand public prêts pour la production.


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun est un ancien fondateur de startup qui aime construire de nouvelles choses. Il étudie actuellement les fondements techniques et mathématiques de l'intelligence artificielle. Il aime partager ce qu'il a appris, alors il écrit à ce sujet.

En plus de DataCamp, vous pouvez lire ses publications sur Medium, Airbyte et Vultr.

Sujets
Intelligence artificielle
L'IA pour les entreprises
Cloud

Approfondissez vos connaissances en IA avec ces cours !

Cours

Éthique de l'IA

1 h
150.5K
Explorez les principes éthiques de l’IA : équité, réduction des biais et confiance dans le design responsable.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow