
Technieken om superalignment te bereiken
In deze sectie leggen we enkele methoden en technieken uit die worden gebruikt om superalignment te bereiken. De onderliggende filosofie achter deze benaderingen is dat ze schaalbaar moeten zijn.
Adversarial training
Bij alignment, zoals bij elke training, moeten ontwikkelaars testen of het systeem wenselijk gedrag heeft geleerd te vertonen. Een manier om superalignment te testen is door de AI tegenvoorbeelden voor te leggen. Grote AI-systemen moeten worden getraind om te herkennen welke verzoeken niet te goeder trouw zijn en die correct af te handelen.
Een veelgebruikte benadering van superalignment is het inzetten van twee AI’s als tegenstanders. Dit is analoog aan de redteam- en blueteam-aanpak die vaak in security-onderzoek wordt gebruikt, waarbij het redteam probeert de beveiliging en verdediging van het blueteam te doorbreken.
In de context van adversarial training voor superalignment probeert elke AI invoer te vinden die de andere AI in de war brengt. Stel bijvoorbeeld een AI (blueteam) voor die is afgestemd om niet met scheldwoorden te reageren. Bij adversarial training is het doel van de tegenstander-AI (redteam) om prompts te vinden die de blueteam-AI tot ongepaste reacties aanzetten. Het doel is ervoor te zorgen dat de blueteam-AI zelfs bij testen door de redteam-AI acceptabele reacties blijft genereren.
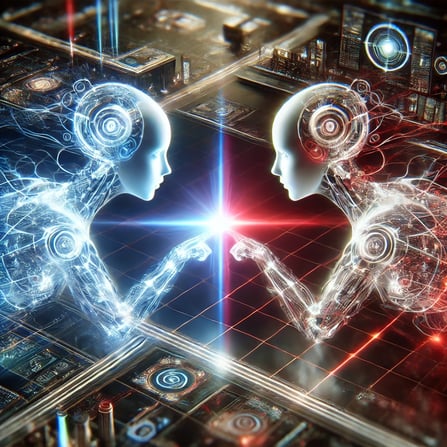
Illustratie van het concept van adversarial training. Afbeelding gemaakt met DALL·E
Robustness training
Robuustheid betekent dat je onderscheid kunt maken tussen invoer die daadwerkelijk verschilt maar oppervlakkig gezien vergelijkbaar is. Het systeem moet hoekgevallen en randgevallen kunnen herkennen. Een systeem dat menselijke acties in videoclips identificeert, moet bijvoorbeeld een echt straatgevecht kunnen onderscheiden van een gechoreografeerd gevecht in een film. Het een voor het ander aanzien kan schadelijke gevolgen hebben.
Grote modellen moeten daarom specifiek worden blootgesteld aan scenario’s die oppervlakkig vergelijkbaar zijn. Dit leert het model nuance en subtiele kenmerken te herkennen.
Schaalbare oversight
Naarmate AI-modellen nieuwe gebruikers vinden en in meer toepassingen worden gebruikt, moet ook de controle daarop evenredig opschalen. Menselijke betrokkenheid is de kern van toezicht en alignment van AI. Het opschalen van menselijke oversight is moeilijker dan het opschalen van een technologische oplossing. Er zijn daarom nieuwe methoden nodig om schaalbare oversight van AI te behouden:
- Geautomatiseerde realtime monitoring: Geautomatiseerde systemen kunnen continu de reacties van de AI volgen en het gedrag monitoren om te controleren of het overeenkomt met menselijke waarden. Aanzienlijke afwijkingen van de verwachte normen kunnen worden gemarkeerd voor menselijke tussenkomst.
- Programmatische reviews: Handmatig alle AI-uitvoer reviewen en auditen is haalbaar. Dit kan door nieuwe programma’s en algoritmen te ontwikkelen die de alignment van de AI met menselijke ethiek controleren. Twijfelgevallen kunnen worden gemarkeerd voor handmatige beoordeling door menselijke moderators.
Reinforcement learning met menselijke feedback (RLHF)
Zoals besproken in het artikel over reinforcement learning (RL), leert het AI-systeem in traditionele RL-implementaties zijn gedrag aan te passen door een mens te observeren. Het gebruikt een trial-and-errorproces om de beloning te maximaliseren. RLHF combineert RL met menselijke input om de acties van de AI tijdens de training te sturen.
RLHF begint met een voorgetraind model. Menselijke beoordelaars geven het model een set taken en leveren feedback op de output, zoals het beoordelen of corrigeren van de reacties van het model.
Het model gebruikt deze informatie om zijn gedrag bij te sturen zodat het aansluit op menselijke feedback en de beloning (positieve menselijke feedback) maximaliseert. Dit proces wordt herhaald totdat de output van het model als relevant, passend en accuraat wordt beschouwd.
Inverse reinforcement learning (IRL)
Bij traditioneel reinforcement learning (RL) specificeren de modelontwikkelaars expliciet de beloningsfunctie (ook wel de utilityfunctie genoemd). Het doel van het model is de prikkel volgens deze beloningsfunctie te maximaliseren.
Bij inverse RL leidt het model de beloningsfunctie af op basis van het gedrag van een getraind model of een mens. Zo kan een op RL gebaseerde autonome auto positieve prikkels krijgen om in de rijbaan te blijven, voor rood licht te stoppen, enzovoort. Een op IRL gebaseerd zelfrijdend systeem achterhaalt de prikkels door nauwkeurig de acties van een ervaren menselijke bestuurder of een getrainde AI te observeren en te volgen.
Menselijke waarden kunnen niet expliciet voor alle contexten worden opgesomd, waardoor traditionele RL lastig is voor alignmentproblemen.
Een effectievere aanpak is dat de AI menselijk gedrag in verschillende contexten observeert en nabootst. Door het gedrag van mensen te observeren, leert de AI welke van de verschillende mogelijke reacties (of handelingsopties) het meest lijken op hoe een mens in dat scenario zou handelen. Dit helpt het gedrag van de AI af te stemmen op menselijke waarden.
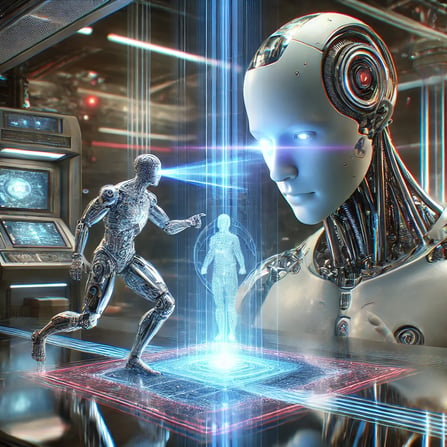
Illustratie van het concept van inverse reinforcement learning. Afbeelding gemaakt met DALL·E
Debat
Veel alignmentmethoden omvatten een mens die de AI traint in wat acceptabel gedrag is en wat niet, maar een mens inzetten is niet altijd de ideale oplossing.
Voor veel complexe problemen, zoals de optimale planning van een nationaal treinsysteem, is er mogelijk geen mens die kan beoordelen of een voorgestelde oplossing de beste is. Een oplossing is om AI zelf in te zetten voor superalignment. Bij de debatmethode:
- Stelt een AI een oplossing voor en geeft die een gedetailleerde uitleg van elke stap.
- Wordt vervolgens dezelfde AI of een andere AI gebruikt om elke uitleg te bekritiseren (tegenargumenten te geven).
- Beslist een mens welk argument juister is. Omdat elk argument een beperkte scope heeft, is het voor mensen eenvoudiger om de geldigheid ervan te beoordelen.
Het proces van logisch redeneren wordt als het ware gegamified, en het meest valide argument wint. Zo leert de AI in een reeks debatten welke redeneringslijnen acceptabel zijn en welke niet. Voor toekomstige taken sluit de output van de AI beter aan op menselijke waarden.
Geïtereerde amplificatie
In traditionele machinelearning- en deep-learningsystemen is de training gebaseerd op de vraag of de output van het model overeenkomt met de verwachte output.
Naarmate de capaciteiten van AI groeien, zal het worden ingezet voor steeds complexere taken. Voor veel van deze taken kennen mensen de verwachte output niet vooraf. De enige opties zijn mogelijk de oplossingen die de AI genereert. Voor dergelijke complexe taken is het lastig om de AI te alignen op basis van de eindoutput, omdat mensen die eindoutput niet kunnen beoordelen.
Bijvoorbeeld: bij het ontwerpen van een transportschema moet het systeem financiële haalbaarheid in balans brengen met het leveren van een nuttige publieke dienst. Veel van zulke overwegingen maken het moeilijk te bepalen welk eindontwerp het beste aansluit bij menselijke waarden.
In zulke gevallen is het eenvoudiger om menselijke supervisie in te zetten om alignment op kleinere subtaken te waarborgen. Later in het proces worden iets grotere taken weer opgesplitst in kleinere subtaken en onder menselijke supervisie gealignet. Dit proces gaat iteratief door totdat de taken te groot worden om direct door mensen te beoordelen.
Geïtereerde amplificatie gaat ervan uit dat, omdat kleinere en eenvoudigere subtaken zijn gealigneerd op basis van menselijke validatie, de grotere primaire taak ook gealigneerd is. Dit heet iterated amplification. Geïtereerde amplificatie wordt ook toegepast in combinatie met technieken zoals debat.
Value learning
Menselijke interacties zijn complex en genuanceerd. In veel gevallen zijn menselijke handelingen ambigu wanneer ze geïsoleerd worden bekeken – ze hebben alleen betekenis in de juiste context. Daarom zijn traditionele utilityfuncties en reinforcement learning ontoereikend om AI menselijke waarden bij te brengen.
Een voorgesteld alternatief is dat het model toegang heeft tot een set utilityfuncties in plaats van één enkele utilityfunctie. Afhankelijk van de context wordt steeds de juiste utilityfunctie gekozen. Het model leert de juiste utilityfunctie te kiezen door menselijk handelen in verschillende contexten te observeren. Dit heet value learning.
Value learning is een techniek waarbij de AI direct menselijk gedrag in verschillende scenario’s observeert en het juiste gedrag per context leert. Dit houdt in dat de AI wordt blootgesteld aan menselijk gedrag via een grote variëteit aan real-life interacties.
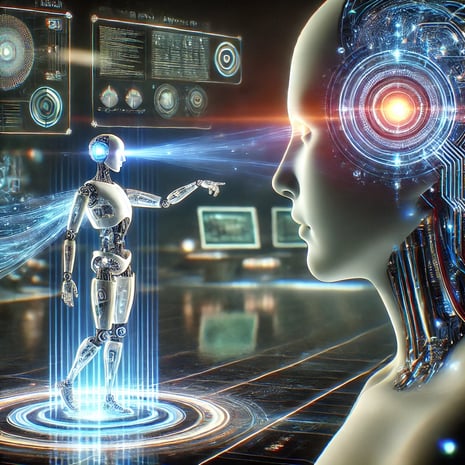
Illustratie van het concept van value learning. Afbeelding gemaakt met DALL·E
De mensen die betrokken zijn bij de alignmenttraining moeten zich gedragen op een manier die als acceptabel wordt beschouwd. Iemand die een auto bestuurt, mag bijvoorbeeld niet toegeven aan verkeersagressie terwijl hij een AI probeert af te stemmen. Maar als je vastzit achter een langzame bestuurder, moet je proberen het langzamere voertuig veilig in te halen.
Superalignment in Large Language Models (LLM’s)
LLM’s zijn momenteel de populairste grootschalige AI-modellen. Ze worden ingezet voor een breed scala aan taken. Gezien hun grote gebruikersbasis en use-cases verdient superalignment in de context van LLM’s extra aandacht.
LLM’s en alignmentuitdagingen
Large language models zoals GPT-4, Gemini en Meta AI beginnen in het dagelijks leven gebruikt te worden. Gezien hun schaal en reikwijdte brengen LLM’s nieuwe alignmentuitdagingen met zich mee, zoals:
- Voortzetting van bias: Deze modellen zijn getraind op grote hoeveelheden data afkomstig van het open internet en andere bibliotheken. Eventuele biases in de trainingsdata worden direct weerspiegeld in de output van het model. Bias door tekortkomingen in invoerdataa wordt beschouwd als algoritmische bias.
- Complexe systemen: De grote omvang van deze modellen, de omvang van hun trainingsdata en de grote verscheidenheid aan use-cases maken het uitdagend om het gedrag van het systeem te voorspellen. Het maakt het moeilijk om te garanderen dat de output van het model voor alle use-cases is afgestemd op menselijke waarden.
- Schaalproblemen: Gezien hun enorme gebruikersbasis en het grote aantal vragen dat ze verwerken:
- Zelfs als het percentage reacties dat niet is afgestemd op menselijke waarden klein is, vertaalt zich dat nog steeds naar een groot aantal.
- Het wordt lastig om te waarborgen dat het gedrag van AI consistent aansluit bij menselijke waarden en ethiek voor alle gebruikers.
Daarom is het nodig om nieuwe methoden te hanteren om te testen hoe goed deze modellen gealigneerd zijn en om ze continu te fine-tunen om te waarborgen dat ze aansluiten bij menselijke waarden en ethische standaarden.
LLM-uitvoer evalueren
Er zijn veel benaderingen voorgesteld en beproefd om LLM-uitvoer te evalueren en zo alignment met menselijke waarden te garanderen. Deze methoden moeten schaalbaar zijn. Enkele voorbeelden:
- Ongewenste output filteren: Een pragmatische aanpak om ongepaste reacties van een LLM te elimineren, is het gebruik van een filterlaag bovenop het taalmodel. Het apart trainen van systemen voor tekstopwekking en filtertaken is efficiënter. De filter kan zelf een andere AI zijn die de output van de genererende LLM scant op ongepaste taal en gevoelige onderwerpen.
- Biasdetectie: Trainingsdatasets bevatten onvermijdelijk enige bias, wat leidt tot bevooroordeelde modellen. Enkele methoden om biases in LLM-uitvoer te detecteren zijn:
- Modelontwikkelaars auditen modellen op bevooroordeelde output. Biasaudits omvatten het testen van een model met diverse invoer en het vergelijken van de reactie in elk geval.
- Gespecialiseerde biasdetectie-algoritmen worden soms gebruikt om systematisch naar verschillende soorten bias te zoeken en die te identificeren.
- Factchecking: Hallucinatie is sinds het begin de achilleshiel van LLM’s. Een LLM kan alleen voorspellen welke woorden op een reeks woorden zouden moeten volgen op basis van wat hij in de trainingsdataset heeft gezien. Het heeft geen concept van feiten. Voor een LLM is de zin “Dell maakt personal computers” net zo betekenisvol als “Dell maakt chips.” Daarom is het bij het gebruiken van LLM’s voor feitelijke tekstgeneratie cruciaal om te controleren of de gegenereerde tekst feitelijk klopt.
- Verklaarbaarheid: Traditionele IT-systemen en programma’s zijn regelgebaseerd. Je kunt het systeem debuggen om precies te achterhalen welke regels verantwoordelijk zijn voor een bepaalde output. LLM’s daarentegen hebben miljarden parameters. Het is onmogelijk om te achterhalen welke gewichten bijdragen aan verschillende delen van de output.
Gelukkig is redeneren een emergente eigenschap van large language models. Een emergente eigenschap is een eigenschap van een complex systeem die niet kan worden verklaard als de som der delen.
LLM’s blijken vaak in staat hun reacties toe te lichten en meerstapsproblemen te doorgronden. Een LLM vragen om een complexe oplossing uit te leggen en elke stap handmatig te evalueren, stelt mensen in staat de respons van de LLM te valideren.
LLM’s en menselijke interactie
LLM’s die interactief worden gebruikt, moeten de nuances en subtiliteiten van menselijke gesprekken begrijpen. Ze moeten kunnen reageren op basis van de context van het gesprek.
Toon, intentie, sarcasme en emotionele signalen zijn lastig wiskundig te representeren. Toch moeten AI-modellen met deze aspecten rekening houden om effectief met mensen te communiceren. Alleen een LLM die is afgestemd om empathisch te zijn, zal effectief zijn in interactie met mensen. Het kan vertrouwen opbouwen en productieve interacties bevorderen, en de enige manier om dit te bereiken is door verschillende superalignmenttechnieken toe te passen.
Ethische overwegingen bij superalignment
Het ultieme doel van superalignment is dat krachtige AI zich conformeert aan de ethische standaarden van de menselijke samenleving.
Deze sectie legt de rol van ethiek uit bij superalignment en de uitdagingen die gepaard gaan met het waarborgen van ethisch gedrag in grote modellen.
Ethisch gedrag waarborgen
Een AI die niet is afgestemd op menselijke waarden, kan nooit veilig zijn voor menselijk gebruik. Een misaligned systeem kan schadelijke content produceren die door kwaadwillenden kan worden misbruikt. Het kan sociale ongelijkheden bestendigen en bestaande biases versterken.
In het slechtste geval kan een misaligned systeem deze capaciteit misbruiken en leiden tot manipulatief gedrag. Daarom staan ethische zorgen centraal in alle superalignmentinspanningen. Alleen door ethisch gedrag onder alle omstandigheden te waarborgen, kunnen AI-tools als betrouwbaar worden beschouwd voor grootschalig en langdurig gebruik.
Nut en veiligheid in balans
Ethisch gedrag in AI-systemen verankeren brengt aanzienlijke kosten met zich mee. Om superalignment te bereiken, hebben modelontwikkelaars nodig:
- Mensen om de reacties te auditen en feedback te geven aan de AI
- Extra tijd om superalignment te waarborgen vóór release van het model
- Extra rekenbronnen om het model te fine-tunen en af te stemmen
Daarnaast moet het model tijdens inferentie extra berekeningen uitvoeren om te waarborgen dat de reacties aansluiten bij menselijke waarden. Soms kan het opleggen van alignment als beperking de capaciteiten van het model inperken. Een super-aligned model kan dus minder performant zijn.
Er moet daarom een balans zijn tussen de technische prestaties van het model en alignmentoverwegingen. Als je alignment en veiligheid boven traditionele prestatie-indicatoren stelt, kan dat leiden tot modellen die in de praktijk minder bruikbaar zijn.
Eerlijkheid en bias
Grootchalige AI-modellen hebben veel gebruikers en uiteenlopende use-cases. Elke bias in de output van het model kan verstrekkende gevolgen hebben. Ontwikkelaars moeten er dus op letten dat hun modellen zo vrij mogelijk zijn van bias.
Bias uit LLM’s halen is uitdagend omdat deze modellen onbegeleid worden getraind op een enorme hoeveelheid tekstdata. De AI neemt alle verschillende biases en vooroordelen over die in de tekst van de trainingsdataset aanwezig zijn. Dit kan ertoe leiden dat de output van het model oneerlijk en discriminerend is. Ontwikkelaars kunnen verschillende methoden inzetten om dit aan te pakken:
- Biasdetectie: Voor je tegenmaatregelen kunt nemen, moet je eerst gevallen van bevooroordeeld gedrag identificeren. Regelmatige audits en fairnessbeoordelingen op steekproeven van modeloutput kunnen helpen de soorten bias te identificeren die het model vertoont en de situaties die deze biases triggeren.
- Biaseliminatie: Er zijn drie hoofdbenaderingen om bias te elimineren:
- Het model programmeren om specifieke biases in de output te corrigeren.
- De trainingsdataset verbeteren door deze aan te vullen met synthetische data. Als de trainingsdataset voor een beeldherkenningssysteem bijvoorbeeld erg weinig dieren van een bepaalde soort bevat, verkleint dat de marginale kans om dit dier te identificeren. Dit wordt vaak aangepakt door de trainingsdataset aan te vullen met synthetisch gegenereerde afbeeldingen van deze soort en/of het gewicht ervan in het trainingsproces te verhogen.
- Het bijwerken van de gewichten van ondervertegenwoordigde subsets van de trainingsdata. Dit omvat het aanpassen van het gewicht van verschillende subsets van de trainingsdata zodat ondervertegenwoordigde categorieën (d.w.z. categorieën met weinig voorbeelden) in de trainingsdata hetzelfde gewicht krijgen als andere categorieën.
- Doorlopende monitoring: Modellen worden periodiek opnieuw getraind op nieuwe datasets. Bovendien wordt het gedrag van toekomstige releases beïnvloed door de eerdere interacties van het model met gebruikers. Ook het gedrag van gebruikers verandert door langdurige blootstelling aan en interactie met AI-modellen. Biasdetectie en -eliminatie is dus geen eenmalige taak. Het moet onderdeel worden van de modelontwikkelingscyclus.
Uitdagingen bij het bereiken van superalignment
Zoals we in de vorige secties hebben uitgelegd, is het bereiken van superalignment uitdagend. Enkele van de belangrijkste moeilijkheden zijn:
- Complexiteit en schaal van modellen: Moderne AI-modellen hebben miljarden parameters. Dit maakt het moeilijk om hun reacties te voorspellen of hun besluitvormingsproces vanuit eerste principes te begrijpen. Het is dus een uitdaging om ervoor te zorgen dat het model consistent is afgestemd op menselijke waarden. Kleine updates aan de modelparameters kunnen de alignment verstoren.
- Schaalbaarheid van alignmenttechnieken: Menselijke supervisie staat centraal in het alignmentproces. Naarmate modellen in reikwijdte en bruikbaarheid groeien, moeten ze in steeds meer scenario’s worden afgestemd. Dit roept vragen op over hoe effectief en economisch mensen de alignmentinspanningen van het model kunnen superviseren.
- Generaliseerbaarheid en robuustheid: AI-modellen verwerken routinematig nieuwe scenario’s en nieuwe input. De training en alignment van het model is daarentegen gebaseerd op een grote maar beperkte set trainingsdata en scenario’s. Het model moet zijn alignment kunnen uitbreiden naar scenario’s die niet expliciet tijdens de training zijn behandeld. Het moet randgevallen kunnen onderscheiden en zich ethisch gedragen onder nieuwe omstandigheden.
- Waardenmisalignment: AI heeft geen aangeboren begrip van menselijke waarden. Het leert alleen op basis van zijn training. Menselijke waarden zijn complex en soms tegenstrijdig. Wat in de ene situatie volkomen acceptabel is, kan in een andere totaal ongepast zijn. Misalignment kan optreden wanneer het model de waarden anders begrijpt dan bedoeld. Dit kan leiden tot ongepaste reacties en potentieel onethisch gedrag.
- Naleving van regelgeving: Nationale en supranationale instanties beginnen regelgevende en juridische standaarden vast te stellen om te waarborgen dat krachtige AI-modellen het publieke belang niet schaden. Het naleven van deze nieuwe regelgeving vergt extra inspanning van modelontwikkelaars.
- Integratie met andere IT-systemen: De meeste alignmentinspanningen zijn gericht op directe mens-AI-interactie. Er ontstaan nieuwe uitdagingen wanneer AI wordt geïntegreerd met andere systemen. De input en output van de AI in dergelijke geïntegreerde systemen zijn niet langer gebaseerd op menselijke taal. Dit maakt het moeilijk om de reacties van de AI te interpreteren. Het waarborgen van de superalignment van een complex IT-systeem inclusief AI brengt onvoorziene uitdagingen met zich mee. Een mogelijkheid is om het volledige geïntegreerde systeem toe te vertrouwen aan een andere AI, die mensen helpt het te begrijpen en te monitoren.
- Monitoring en updates: Het continu monitoren van de reacties van het model is noodzakelijk om te waarborgen dat het model zich in de praktijk ethisch gedraagt. Dit gebeurt doorgaans door willekeurig de output van het model te bemonsteren op real-life input. Het bijwerken van de parameters van het model kan de alignment ook verstoren. Alignment moet daarom worden onderhouden en bijgewerkt als onderdeel van de levenscyclus van modelontwikkeling.
Conclusie
Een AI-systeem dat niet is afgestemd op menselijke waarden en ethiek is ongeschikt voor publiek gebruik. Sterker nog, het kan schadelijke gevolgen hebben.
In dit artikel hebben we superalignment besproken, een verzameling methoden en benaderingen die wordt gebruikt om grote en krachtige AI-systemen af te stemmen. Daarnaast hebben we superalignment in de context van LLM’s verkend. Tot slot, omdat superalignment een zich ontwikkelend vakgebied is, hebben we de belangrijkste uitdagingen bij de implementatie ervan behandeld.
<p>Leer meer over AI met deze cursussen!</p>
How is superalignment different from alignment?
Conceptually, they are similar, but they differ in scope. Alignment refers to AI systems accounting for user intent, acting according to the context, and being free of bias.
The term “super alignment " refers to large-scale AI models that are aligned not just to the intent and context but also more broadly with human values, morals, and ethics.
The crux of the difference lies in the methods used. Alignment can be achieved using simpler rule-based methods, which are inadequate for superalignment.
How is alignment different from training?
Model training is based on minimizing the value of the loss function. Alignment goes beyond training. It ensures the trained model acts according to human intents, values, and ethics.
If the training data is biased, the resulting model is also biased. The model does not act according to ethical standards. Alignment involves correcting the model to account for the shortcomings in the training process.
Does all superalignment involve human efforts?
Given the huge volume of inputs and outputs of AI models, manual supervision is not always possible. It is more pragmatic to adopt automated and programmatic approaches to audit and monitor AI behavior. Human intervention is of course necessary in edge cases.
Is superalignment strictly necessary? Is a trained model not sufficient?
For large-scale public-facing models, yes, it is strictly necessary. When the output of AI models is put to practical use, the output must conform to the same ethical and moral standards that a human would have. Training datasets, by default, contain various biases which are then reflected in the trained model. Thus, the trained model must be aligned with human values and standards.
Are there superalignment modules or software packages that I can use?
Superalignment is still an unsolved problem with many different approaches being studied. AI researchers experiment with different techniques suitable to their models. As such, there are no popular production-grade modules for superalignment.



Net als alle machinelearningmodellen worden AI-systemen getraind om een foutfunctie te minimaliseren. Goede training is noodzakelijk, maar niet voldoende om een AI-model te integreren in het dagelijks leven van gebruikers en de workflows van organisaties.
Voor succesvolle mens-AI-interacties moeten AI-modellen kunnen reageren door gebruikersintentie te doorgronden en te handelen volgens richtlijnen voor veiligheid en eerlijkheid. Zo moet een chatbot geen instructies geven om jezelf of anderen te schaden, en mag een model dat recruiters ondersteunt niet discrimineren tussen sollicitanten.
AI-systemen worden krachtiger en raken meer verweven met het dagelijks leven. Daarom moeten ontwikkelaars ervoor zorgen dat het gedrag van AI op schaal de menselijke ethiek, waarden en moraal volgt. Dit heet superalignment. De cursus AI Ethics gaat in op de ethische aspecten van AI.
In dit artikel leggen we de superalignment van AI-modellen uit, bespreken we verschillende methoden om superalignment te bereiken voor AI-modellen in het algemeen en LLM’s in het bijzonder, en behandelen we de ethische overwegingen en praktische uitdagingen van superalignment.
Ontdek hoe AI impact kan hebben op jouw organisatie en hoe je succesvolle AI-strategieën implementeert met onze whitepaper, The Learning Leader's Guide to AI Literacy.
AI-alignment: een snelle kennismaking
Alignment verwijst naar het proces en de methoden om ervoor te zorgen dat een AI-systeem zich gedraagt volgens de gebruikersintentie, zonder bias, en binnen veiligheidsrichtlijnen. Dit artikel legt de concepten en methoden uit die bij alignment worden gebruikt.
Naast menselijke controle passen ontwikkelaars methoden toe zoals filtering en regelgebaseerde systemen om alignment in AI-systemen te waarborgen. De technieken die worden gebruikt om een model voor een kleine gebruikersgroep af te stemmen, worden onpraktisch wanneer ze worden toegepast op een krachtiger en populairder model. Bijvoorbeeld:
Krachtige AI-modellen die op grotere schaal en met een bredere reikwijdte werken, hebben dus een nieuwe benadering van alignment nodig. Dit heet superalignment.
Wat is superalignment?
De reikwijdte, schaal, complexiteit en wijdverbreide inzet van krachtige AI-modellen leiden tot een geheel nieuwe set alignmentuitdagingen.
Methoden en benaderingen om grootschalige AI-modellen af te stemmen op menselijke waarden, ethiek en moraal vallen onder de paraplu van superalignment. Het omvat veel deelgebieden.
In het algemeen moeten super-aligned systemen:
Superalignment is een zich ontwikkelend vakgebied. Het richt zich op de huidige state-of-the-art AI-modellen en houdt rekening met methoden voor nog krachtigere AI-modellen die naar verwachting worden ontwikkeld.
Naarmate AI krachtiger wordt, zal het naar verwachting veel aspecten van het menselijk leven aansturen, zoals landbouw, transport en meer. Zo’n AI-systeem moet altijd de belangen van mensen boven alle andere overwegingen stellen.