
Kursus
Mengembangkan Sistem AI dengan OpenAI API
3 Hr
22.8K
TypeSafe keluar dari mode stealth pada 15 September 2026 dengan Jev, model yang mereka sebut sebagai model System One: Anda mengirimkan state program dan pertanyaan bertipe, lalu ia mengembalikan keputusan dengan probabilitas terkalibrasi alih-alih teks. Dua belas hari sebelumnya, OpenAI merilis GPT-6 Astra, yang digambarkan sebagai modelnya yang paling cerdas dan paling selaras, dibangun untuk penggunaan komputer, coding, dan pekerjaan profesional ujung-ke-ujung.
Dalam artikel ini, saya akan membandingkan Jev dan GPT-6 Astra pada reliabilitas output, akurasi keputusan, kecepatan, cakupan agensi, dan harga, lalu menyarankan panggilan mana dalam pipeline perangkat lunak yang sebaiknya menggunakan masing-masing model.
Jev adalah model keputusan hosted yang dirilis TypeSafe AI dalam akses awal pada September 2026, yang pertama dari apa yang mereka sebut model System One.
Nilai jualnya adalah ia melepas generasi teks: Anda mendefinisikan ruang jawaban di muka sebagai pertanyaan Choice, Score, atau Noul (ya/tidak), dan ia mengembalikan nilai bertipe dengan probabilitas terkalibrasi yang bisa langsung dijadikan cabang oleh perangkat lunak. Panduan Jev kami membahas peluncuran dan klaim evaluasi TypeSafe.
GPT-6 Astra adalah andalan frontier OpenAI, dirilis pada 3 September 2026 sebagai penerus GPT-5.6 Sol.
Posisioningnya adalah eksekusi otonom: OpenAI menyebutnya model penggunaan komputer terbaik di dunia dan yang paling selaras, dilatih untuk mengisi formulir, memperbarui CRM, membangun dan QA situs web, serta menghasilkan dokumen yang mengikuti templat Anda. Panduan GPT-6 Astra kami membahas peluncurannya; tutorial API GPT-6 Astra kami membangun agen pemeriksa rilis dengan tools async.
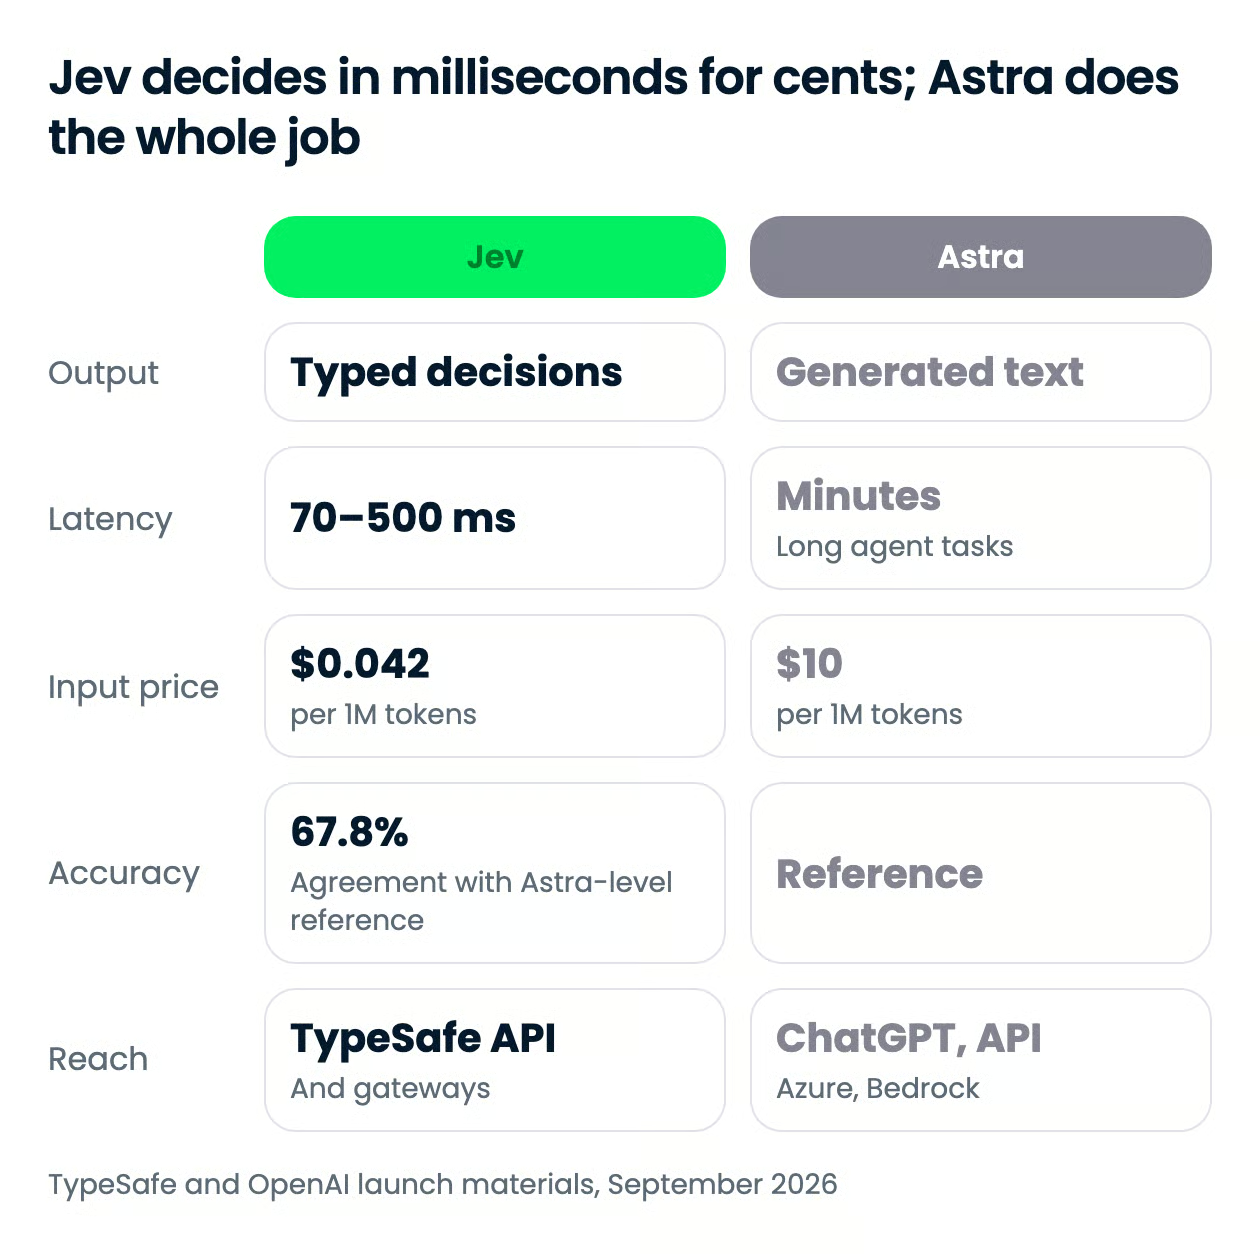
Kedua model berada di ujung berlawanan dari satu trade-off: Jev membeli kecepatan, harga, dan keselamatan tipe dengan menolak menghasilkan teks, dan Astra membeli keluasan serta kedalaman dengan menghasilkan segalanya. Sebagian besar baris di bawah ini mengikuti dari satu pilihan desain itu.
| Fitur | Jev | GPT-6 Astra |
|---|---|---|
| Output | Keputusan bertipe (Choice, Score, Noul) dengan probabilitas; tanpa teks | Teks terhasilkan; output terstruktur dan pemanggilan fungsi didukung |
| Kesalahan tipe atau skema | 0% secara konstruksi | Dimungkinkan; 4,2% pada tolok ukur halusinasi internal OpenAI |
| Input | Teks, objek JSON, array; tanpa gambar | Teks dan gambar |
| Jendela konteks | Tidak disebutkan dalam dokumentasi TypeSafe; 32.000 token pada listing OpenRouter dan Vercel AI Gateway | 1.050.000 token; 128.000 output maks |
| Latensi ujung-ke-ujung | 70 hingga 500 ms per panggilan (laporan vendor) | Menit pada tugas agen; sekitar 40 menit per tugas OSWorld 2.0 |
| Akurasi keputusan | 67,8% kesesuaian dengan referensi Astra + Fable 5.1 pada evaluasi 4-workflow TypeSafe | Menjadi referensi; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Agen dan tools | Tidak ada; sebuah keputusan di dalam kode Anda | Penggunaan komputer, shell hosted, penelusuran web, code interpreter; 72,6% OSWorld 2.0 |
| Kepercayaan | Probabilitas terkalibrasi pada setiap jawaban, plus skor kepercayaan turunan | Tidak diekspos sebagai field |
| Harga per 1M token | $0,042 input; output gratis | $10 input; $50 output |
| Ketersediaan | Akses awal via TypeSafe API, OpenRouter, Vercel AI Gateway | Tingkat berbayar ChatGPT, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev tidak bisa menghasilkan nilai yang tidak valid, dan Astra bisa. Fakta tunggal itu yang membuat keduanya berakhir di lapisan berbeda dalam sebuah sistem alih-alih di slot yang sama.
Permintaan Jev adalah blok state plus peta pertanyaan bertipe:
Ruang jawaban ditetapkan sebelum inferensi, sehingga kecocokan skema terjamin; TypeSafe menempatkan tingkat kesalahan output terstruktur dan pemanggilan tool pada 0% dan menyebut angka tersebut non-empiris.
Astra mewakili LLM klasik dan mengembalikan teks. Meski mendukung output terstruktur dan pemanggilan fungsi, serta memangkas tingkat kesalahan Sol menjadi sekitar sepertiga pada tolok ukur halusinasi internal OpenAI, outputnya tetap harus diurai dan divalidasi. Grafik TypeSafe menempatkan kesalahan output terstruktur LLM frontier antara 0,58% dan 45,5%; angka Astra sendiri tidak dipublikasikan, jadi saya tidak akan mengasumsikan ia berada di ujung bawah.
Biaya dari jaminan Jev adalah Anda tidak mendapatkan alasan, hanya probabilitas: baik untuk lapisan perutean, tidak untuk peninjau kepatuhan, jadi rencanakan untuk mengeskalasi kasus berkepercayaan rendah ke model yang bisa menulis.
Dua kaveat pada angka reliabilitas:
Untuk output yang harus bisa diurai pada percobaan pertama, kontrak Jev menang; untuk apa pun yang dibaca manusia, hanya Astra yang bisa menjawab.
Astra lebih akurat. Pada empat workflow produksi TypeSafe (respons insiden, observabilitas jejak agen, pemrosesan faktur, layanan pelanggan), Jev sejalan dengan rata-rata Astra dan Claude Fable 5.1 sebesar 67,8% dari waktu, setara dengan GPT-5.6 Terra dan tertinggal 5 hingga 6 poin dari GPT-5.6 Sol dan Claude Opus 5.
Astra adalah referensinya, jadi tidak memiliki skor kesesuaian sendiri. Pada tolok ukurnya sendiri, ia menyaturasi FrontierMath Tier 4, GPQA Diamond, dan ARC-AGI-3, meski yang terakhir bergantung pada harness stateful. Jev tidak bernalar lintas giliran, merencanakan, atau menjelaskan, dan menilainya berdasarkan kesesuaian dengan LLM alih-alih kebenaran dasar, seperti yang dilakukan TypeSafe, berisiko mewarisi bias model referensi.
Jika akurasi puncak pada keputusan ber-volume rendah yang Anda perlukan, LLM masih menang.
Jev menjawab dalam 70 hingga 500 milidetik ujung-ke-ujung, menurut pengukuran TypeSafe, dibandingkan 3 hingga 329 detik untuk LLM frontier pada jenis kueri yang sama. Ia melakukan sampling semua jawaban secara paralel alih-alih satu token per waktu dan menerima hingga 255 opsi per Choice.
Astra cepat untuk kelasnya: sekitar 47% waktu lebih sedikit per tugas OSWorld 2.0 dibanding Sol, dan mode Fast memberikan hingga 2x kecepatan dengan 2x harga. Tugas-tugas itu tetap memakan waktu puluhan menit. Bot Doom seorang engineer TypeSafe menjalankan 10 kueri per detik dengan biaya sekitar $7 per jam, anggaran yang tidak bisa ditandingi LLM frontier mana pun.
Untuk jalur permintaan keputusan dengan anggaran 100 ms, Jev adalah satu-satunya kandidat di sini.
Astra melakukan semua yang tidak dilakukan Jev:
Jev menerima teks, JSON, atau array teks, bukan gambar, dan tidak memanggil tool. Ia adalah if-statement fuzzy di dalam workflow yang dimiliki kode Anda: klasifikasikan, rute, skor, ekstrak, atau verifikasi output model lain, termasuk deteksi jailbreak pada prompt LLM.
Astra menang telak pada dimensi ini karena Jev memang tidak ikut serta.
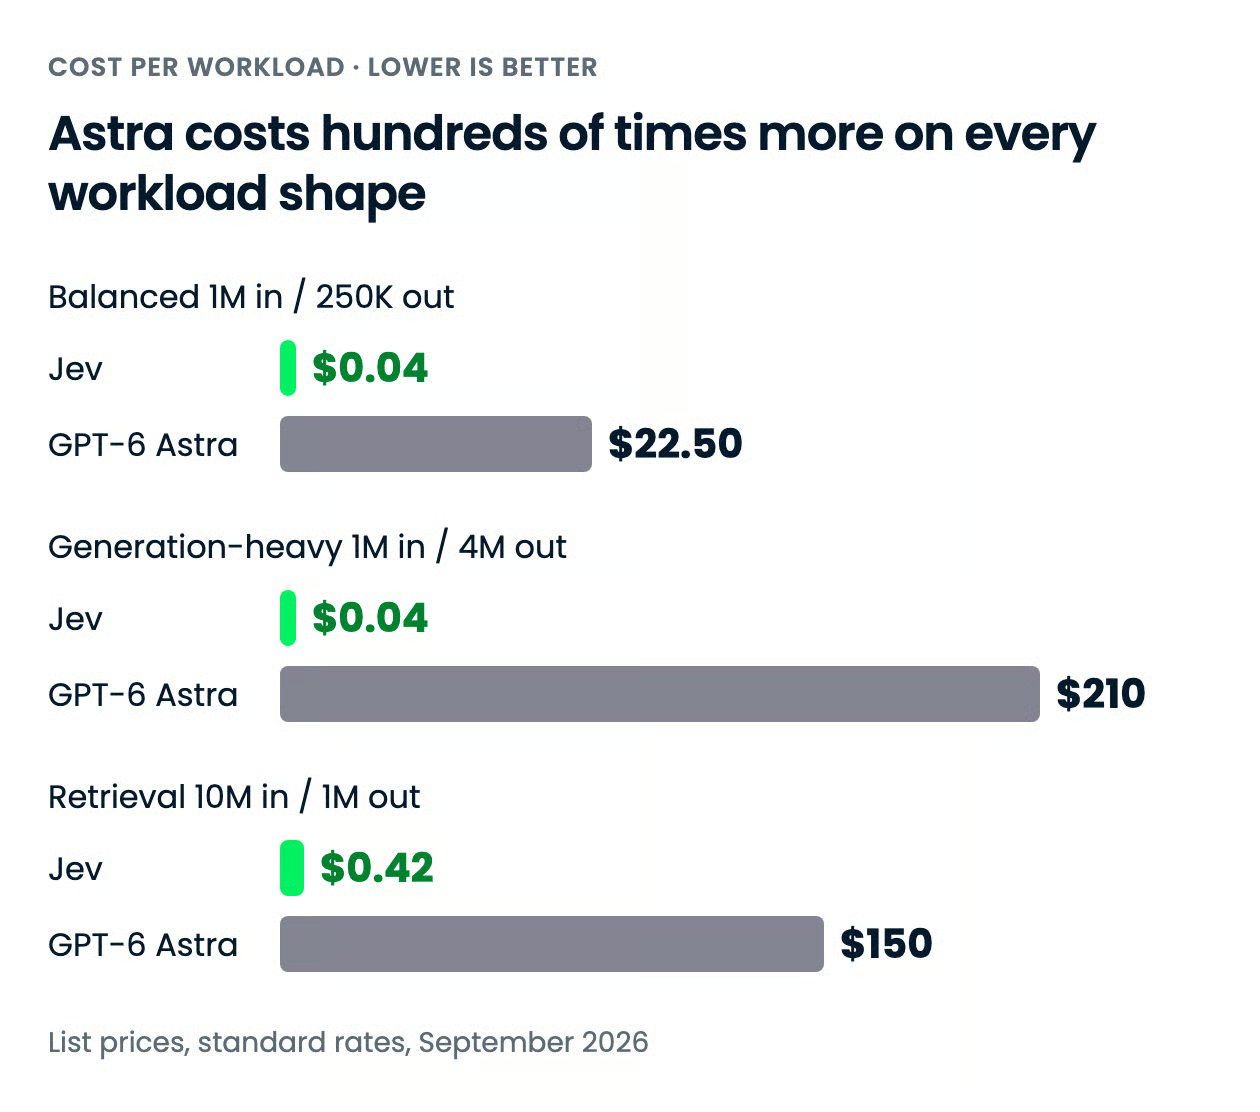
Astra berbiaya beberapa ratus kali lebih mahal daripada Jev pada bentuk beban kerja apa pun, dan kesenjangannya melebar semakin banyak output yang dihasilkan tugas, karena Jev tidak menagih output sama sekali.
| Tarif | Jev | GPT-6 Astra |
|---|---|---|
| Input, per 1M token | $0,042 | $10,00 |
| Output, per 1M token | Gratis | $50,00 |
| Baca input cache, per 1M token | Tidak dipublikasikan | $1,00 |
| Tulis cache, per 1M token | Tidak dipublikasikan | $12,50 |
| Diskon batch | Tidak dipublikasikan | 50% (Batch dan Flex) |
| Biaya tambahan konteks panjang | Tidak dipublikasikan | 2x input dan cache, 1,5x output, di atas 272K token input |
| Mode cepat | Tidak berlaku | 2x tarif yang berlaku |
| Tingkat konsumen | Tidak berlaku; hanya API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro pada Pro dan di atasnya) |
Bentuk perbedaan sama pentingnya dengan ukurannya. Tarif output Astra adalah 5x tarif inputnya, dan token penalarannya ditagih sebagai output, jadi pekerjaan yang berat berpikir atau verbose adalah tempat tagihannya tumbuh paling cepat. Jev hanya menagih input, dan jawaban tipikal adalah beberapa lusin token output, sehingga biayanya merupakan fungsi dari seberapa banyak state yang Anda kirim dan tidak ada yang lain.
TypeSafe terbuka bahwa mereka tidak dapat membuktikan harga ini tidak disubsidi, dan memperkirakan harganya turun alih-alih naik.
| Beban kerja | Jev | GPT-6 Astra | Perbedaan |
|---|---|---|---|
| Asisten seimbang: 1M masuk / 250K keluar | $0,04 | $22,50 | $22,46, Jev 99,8% lebih murah |
| Generasi berat: 1M masuk / 4M keluar | $0,04 | $210 | $209,96, Jev 99,98% lebih murah |
| Retrieval, sub-ambang: 10M masuk / 1M keluar | $0,42 | $150 | $149,58, Jev 99,7% lebih murah |
Formulanya adalah (volume ÷ 1M) × tarif, dijumlahkan antara input dan output, pada tarif standar. Baris generasi berat adalah outlier karena output Jev gratis, meski juga paling tidak realistis untuk Jev: model ini tidak pernah memancarkan 4M token output, jadi bacalah sebagai dampak premi output semata pada Astra. Baris retrieval adalah yang paling cocok dengan penggunaan Jev sebenarnya, banyak state masuk dan segelintir probabilitas keluar, dan tetap berbeda 357x.
Tidak ada baris retrieval di atas ambang karena dokumen TypeSafe menyatakan tidak ada biaya tambahan konteks panjang, dan jendela konteks yang tercantum router untuk Jev berada jauh di bawah ambang Astra, sehingga pengali 2x input dan 1,5x output Astra tidak punya pembanding. Tidak ada vendor yang memublikasikan hitungan token untuk beban kerja bersama, dan tokenizer Jev tidak didokumentasikan, jadi anggap total ini sebagai perbandingan tarif alih-alih tagihan.
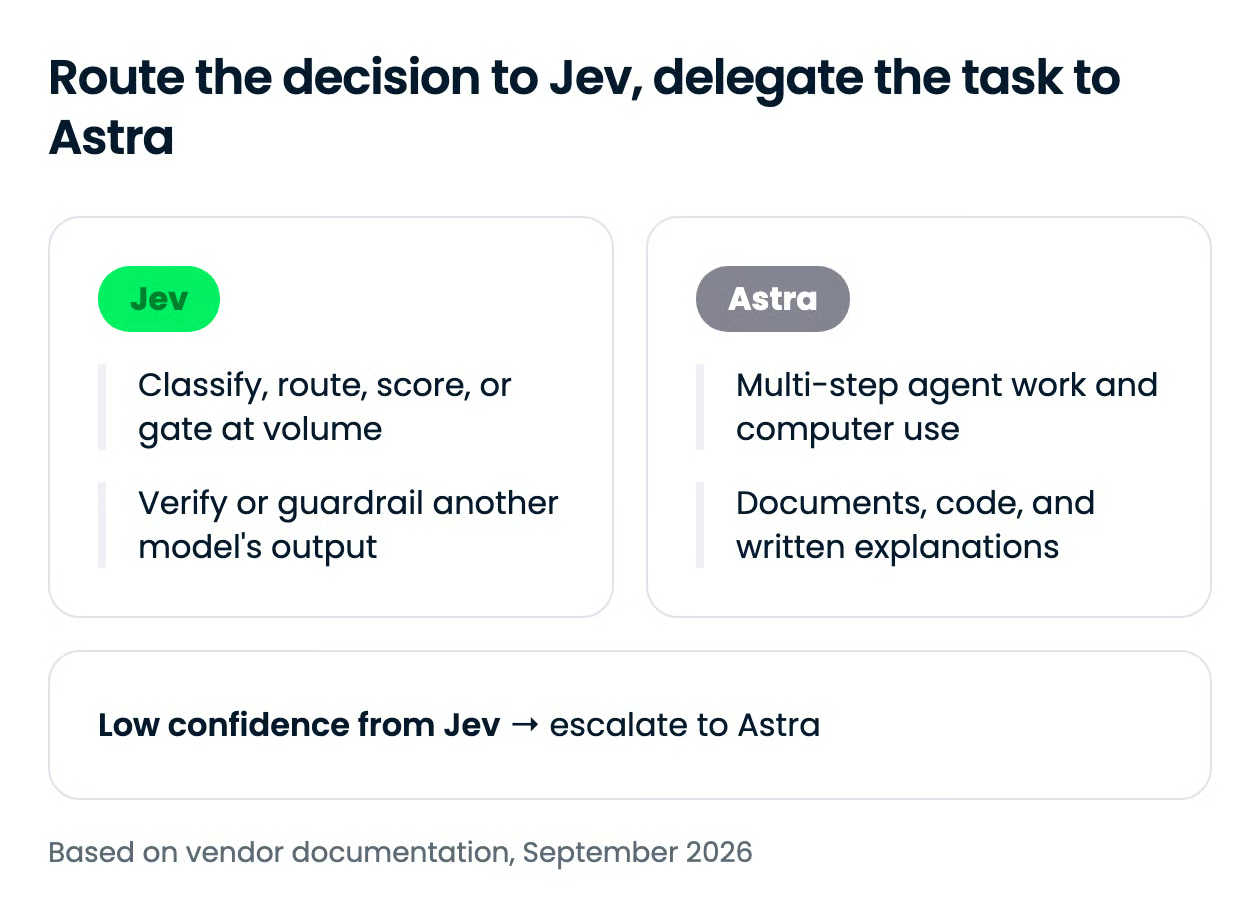
Pemisahnya bukan akurasi atau harga secara terpisah, melainkan apakah langkahnya berakhir pada keputusan atau sebuah artefak. Keputusan milik Jev; apa pun yang akan dibaca, dijalankan, atau dibuka seseorang milik Astra.
Jangkauan adalah dimensi paling timpang di artikel ini: Astra ada di mana pun model OpenAI biasanya berada, dan Jev adalah API ber-gate daftar tunggu yang satu-satunya rute tanpa undangan adalah listing OpenRouter dan Vercel AI Gateway.
| Permukaan | Jev | GPT-6 Astra |
|---|---|---|
| Aplikasi konsumen | Tidak ada; hanya konsol pengembang | ChatGPT Plus, Pro, Business, dan Enterprise; nonaktif secara default untuk workspace Enterprise saat peluncuran |
| API pihak pertama | TypeSafe API, akses awal via daftar tunggu saja; tidak ada pendaftaran swalayan | OpenAI API (Responses dan Chat Completions), digelarkan bertahap setelah peluncuran |
| Platform cloud | Tidak ada | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agen coding | Tidak berlaku; tidak menghasilkan teks atau panggilan tool | Codex, GitHub Copilot; tidak tercantum di dokumen Cursor per 21 September 2026 |
| Router pihak ketiga | OpenRouter (typesafe/jev-1.13, melalui endpoint systemone khusus), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID model API | jev-latest (alias untuk jev-1.13.0) |
gpt-6-astra |
ID modelnya adalah jev-latest, yang menjadi default SDK TypeSafe dan saat ini merujuk ke jev-1.13.0, serta gpt-6-astra. TypeSafe merekomendasikan mem-pin ID berversi jika Anda telah menyetel ambang kepercayaan, karena alias akan berpindah saat rilis baru dikirim. Batas laju Jev adalah 250.000 token per detik dan 1.200 permintaan per menit, dan TypeSafe mengatakan keduanya dapat berubah tanpa pemberitahuan saat mereka melakukan skala.
Ini bukan pertukaran satu-string. Astra menerima prompt dan mengembalikan teks melalui Responses API; Jev menerima state dan peta pertanyaan bertipe melalui satu endpoint dan mengembalikan probabilitas. Dua blok di bawah ini mengajukan permintaan pengembalian yang sama ke masing-masing model, sehingga Anda bisa melihat perbedaan bentuknya.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidenceUntuk penyiapan Astra lengkap, termasuk tools async dan pengarah di tengah giliran, ikuti tutorial API GPT-6 Astra kami; untuk JSON terstruktur dari model OpenAI, lihat tutorial output terstruktur kami.
Jika langkahnya berakhir pada keputusan yang dijalankan kode Anda, gunakan Jev; jika berakhir pada sesuatu yang dibaca atau dijalankan orang, gunakan GPT-6 Astra. Arsitektur yang disarankan peluncuran ini adalah keduanya sekaligus: Jev sebagai router murah dan terkalibrasi di depan, Astra sebagai spesialis yang menjadi eskalasi saat kepercayaan turun.
Hal yang paling mencolok bagi saya adalah TypeSafe menilai Jev terhadap jawaban Astra. OpenAI menyatakan bahwa frontier adalah eksekusi otonom; TypeSafe bertaruh bahwa sebagian besar yang diminta perangkat lunak kepada model adalah pertanyaan terbatas yang disamarkan. Pertanyaan terbuka untuk Jev adalah apakah tolok ukur independen mengonfirmasi paritas dan apakah harga bertahan dari subsidi.
Untuk membangun lapisan keputusan tempat salah satu model berada, saya merekomendasikan kursus Developing AI Systems with the OpenAI API kami dan track AI Agent Fundamentals kami.
Belajar Rekayasa AI Bersama DataCamp!
Kursus
Program
Kursus