
Curso
Desarrollar sistemas de IA con la API OpenAI
3 h
22.8K
TypeSafe salió del modo sigilo el 15 de septiembre de 2026 con Jev, un modelo que denomina de Sistema Uno: le envías el estado del programa y preguntas tipadas, y devuelve decisiones con probabilidades calibradas en lugar de texto. Doce días antes, OpenAI lanzó GPT-6 Astra, descrito como su modelo más inteligente y alineado, pensado para uso en ordenador, programación y trabajo profesional de extremo a extremo.
En este artículo, compararé Jev y GPT-6 Astra en fiabilidad del output, precisión de las decisiones, velocidad, alcance agentico y precios, y luego diré qué llamadas en una canalización de software corresponden a cada modelo.
Jev es un modelo de decisión alojado que TypeSafe AI lanzó en acceso anticipado en septiembre de 2026, el primero de lo que llama modelos de Sistema Uno.
Su propuesta de valor es que renuncia a generar texto: defines el espacio de respuesta por adelantado como preguntas de Choice, Score o Noul (sí/no), y devuelve valores tipados con probabilidades calibradas sobre las que el software puede ramificar directamente. Nuestra guía de Jev cubre el lanzamiento y las métricas de evaluación de TypeSafe.
GPT-6 Astra es el buque insignia de OpenAI en la frontera, lanzado el 3 de septiembre de 2026 como sucesor de GPT-5.6 Sol.
Su posicionamiento es la ejecución autónoma: OpenAI lo presenta como el mejor modelo del mundo en uso de ordenador y el más alineado, entrenado para cumplimentar formularios, actualizar un CRM, crear y asegurar la calidad de un sitio web y producir documentos que sigan tus plantillas. Nuestra guía de GPT-6 Astra cubre el lanzamiento; nuestro tutorial del API de GPT-6 Astra crea un agente de comprobación de releases con herramientas asíncronas.
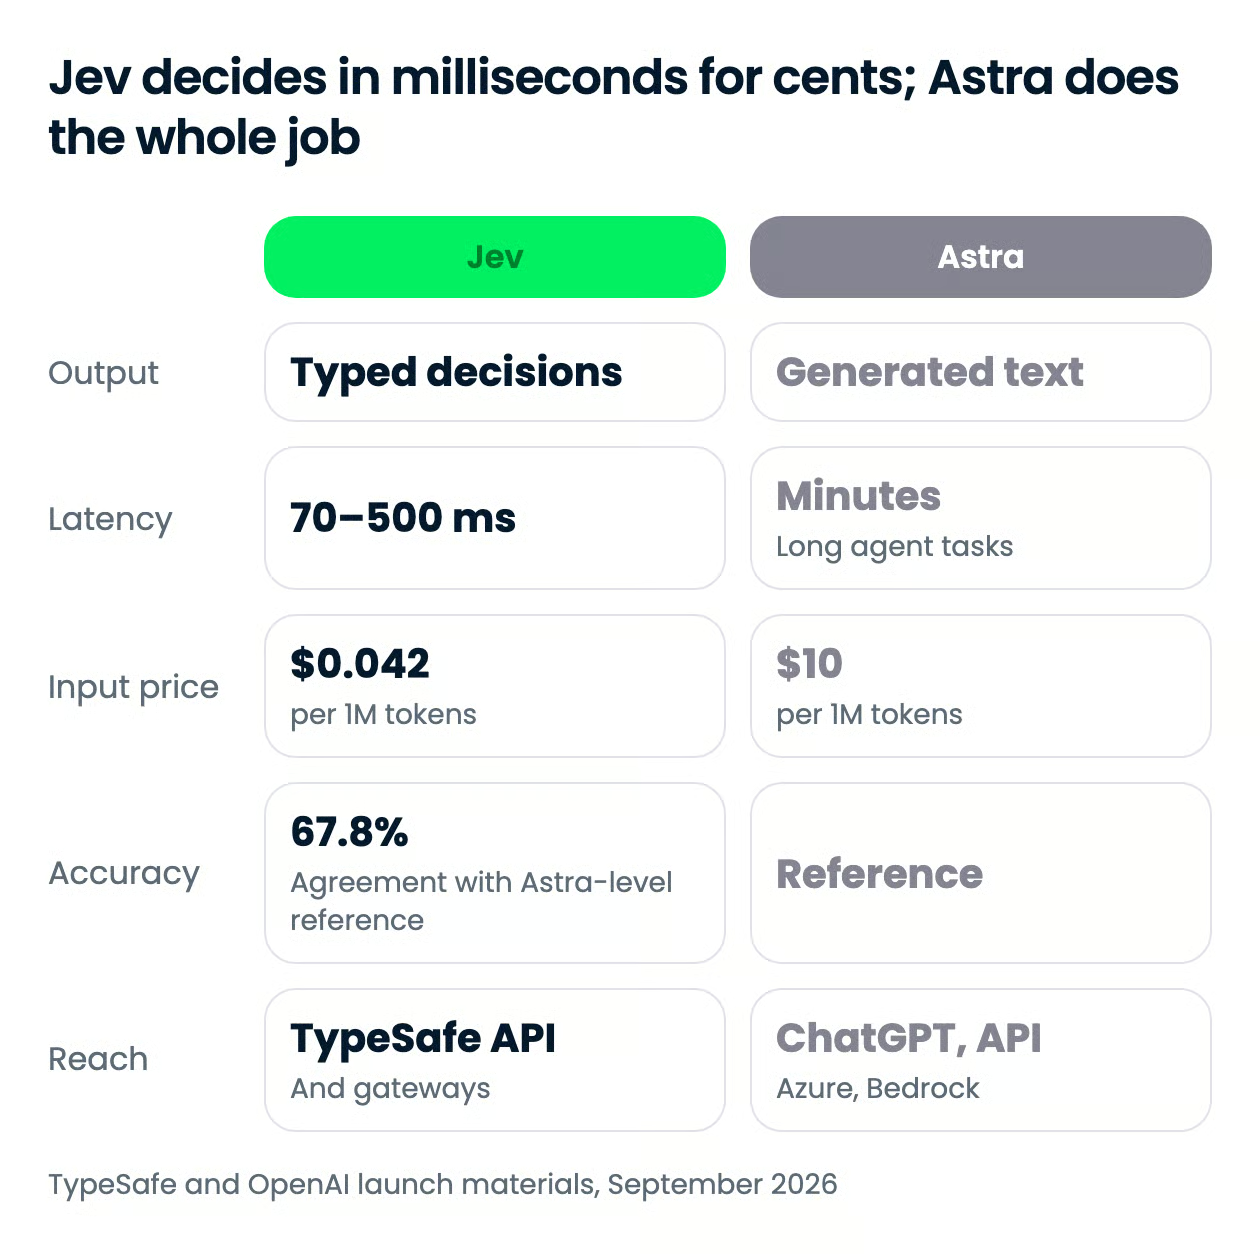
Los dos modelos se sitúan en extremos opuestos de una misma compensación: Jev compra velocidad, precio y seguridad de tipos al negarse a generar texto, y Astra compra amplitud y profundidad generándolo todo. La mayoría de filas de abajo se derivan de esa única decisión de diseño.
| Función | Jev | GPT-6 Astra |
|---|---|---|
| Salida | Decisiones tipadas (Choice, Score, Noul) con probabilidades; sin texto | Texto generado; outputs estructurados y llamadas a funciones compatibles |
| Errores de tipo o de esquema | 0% por construcción | Posibles; 4,2% en el benchmark interno de alucinaciones de OpenAI |
| Entrada | Texto, objetos JSON, arrays; sin imágenes | Texto e imágenes |
| Ventana de contexto | No indicado en la documentación de TypeSafe; 32.000 tokens en los listados de OpenRouter y Vercel AI Gateway | 1.050.000 tokens; 128.000 de salida máxima |
| Latencia de extremo a extremo | 70 a 500 ms por llamada (según el proveedor) | Minutos en tareas de agente; unos 40 minutos por tarea de OSWorld 2.0 |
| Precisión de decisión | 67,8% de acuerdo con una referencia Astra + Fable 5.1 en la evaluación de 4 flujos de TypeSafe | Es la referencia; 96,0% en GPQA Diamond, 97,6% en FrontierMath Tier 4 |
| Agentes y herramientas | Ninguna; una decisión dentro de tu código | Uso de ordenador, shell alojado, búsqueda web, intérprete de código; 72,6% en OSWorld 2.0 |
| Confianza | Probabilidad calibrada en cada respuesta, más una puntuación de confianza derivada | No expuesta como campo |
| Precio por 1M de tokens | $0,042 entrada; salida gratis | $10 entrada; $50 salida |
| Disponibilidad | Acceso anticipado vía TypeSafe API, OpenRouter, Vercel AI Gateway | Niveles de pago de ChatGPT, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev no puede producir un valor inválido, y Astra sí. Ese único hecho es la razón por la que acaban en capas distintas de un sistema en lugar de competir por el mismo hueco.
Una solicitud a Jev es un bloque de estado más un mapa de preguntas tipadas:
El espacio de respuesta está fijado antes de la inferencia, así que la coincidencia de esquema está garantizada; TypeSafe sitúa su tasa de error en outputs estructurados y llamadas a herramientas en 0% y califica la cifra de no empírica.
Astra representa un LLM clásico y devuelve texto. Aunque admite outputs estructurados y llamadas a funciones, y reduce a aproximadamente un tercio la tasa de error de Sol en el benchmark interno de alucinaciones de OpenAI, la salida sigue teniendo que parsearse y validarse. El gráfico de TypeSafe sitúa el error de output estructurado de los LLM de frontera entre 0,58% y 45,5%; la cifra propia de Astra no está publicada, así que no asumiría que está en el extremo bajo.
El coste de la garantía de Jev es que no obtienes razonamiento, solo una probabilidad: perfecto para una capa de enrutado, no para una revisión de cumplimiento, así que planifica escalar los casos de baja confianza a un modelo que pueda escribir.
Dos advertencias sobre las cifras de fiabilidad:
Para outputs que deben parsear a la primera, gana el contrato de Jev; para cualquier cosa que vaya a leer una persona, solo Astra puede responder.
Astra es más preciso. En los cuatro flujos en producción de TypeSafe (respuesta a incidentes, observabilidad de trazas de agentes, procesamiento de facturas, atención al cliente), Jev coincide con la media de Astra y Claude Fable 5.1 el 67,8% de las veces, empatado con GPT-5.6 Terra y a 5 o 6 puntos de GPT-5.6 Sol y Claude Opus 5.
Astra es la referencia ahí, por lo que no tiene una puntuación de acuerdo propia. En sus propios benchmarks, satura FrontierMath Tier 4, GPQA Diamond y ARC-AGI-3, aunque el último depende de un arnés con estado. Jev no razona a través de turnos, no planifica ni explica, y evaluarlo por acuerdo con LLMs en lugar de contra verdad de terreno, como hace TypeSafe, corre el riesgo de heredar sesgos de los modelos de referencia.
Si necesitas la máxima precisión en una decisión de bajo volumen, el LLM sigue ganando.
Jev responde en 70 a 500 milisegundos de extremo a extremo, según las mediciones de TypeSafe, frente a 3 a 329 segundos para LLMs de frontera en el mismo tipo de consulta. Muestrea todas las respuestas en paralelo en lugar de token a token y admite hasta 255 opciones por Choice.
Astra es rápido para lo que es: alrededor de un 47% menos de tiempo por tarea de OSWorld 2.0 que Sol, y el modo Fast ofrece hasta 2 veces más velocidad a 2 veces el precio. Aun así, esas tareas tardan decenas de minutos. El bot de Doom de un ingeniero de TypeSafe ejecuta 10 consultas por segundo por unos $7 la hora, un presupuesto al que ningún LLM de frontera puede acercarse.
Para una ruta de decisión con un presupuesto de 100 ms, aquí el único candidato es Jev.
Astra hace todo lo que Jev no hace:
Jev acepta texto, JSON o arrays de texto, no imágenes, y no invoca herramientas. Es el if difuso dentro de un flujo de trabajo que tu código controla: clasificar, enrutar, puntuar, extraer o verificar el output de otro modelo, incluido detectar jailbreaks en prompts de LLM.
Astra gana esta dimensión de forma clara porque Jev ni compite en ella.
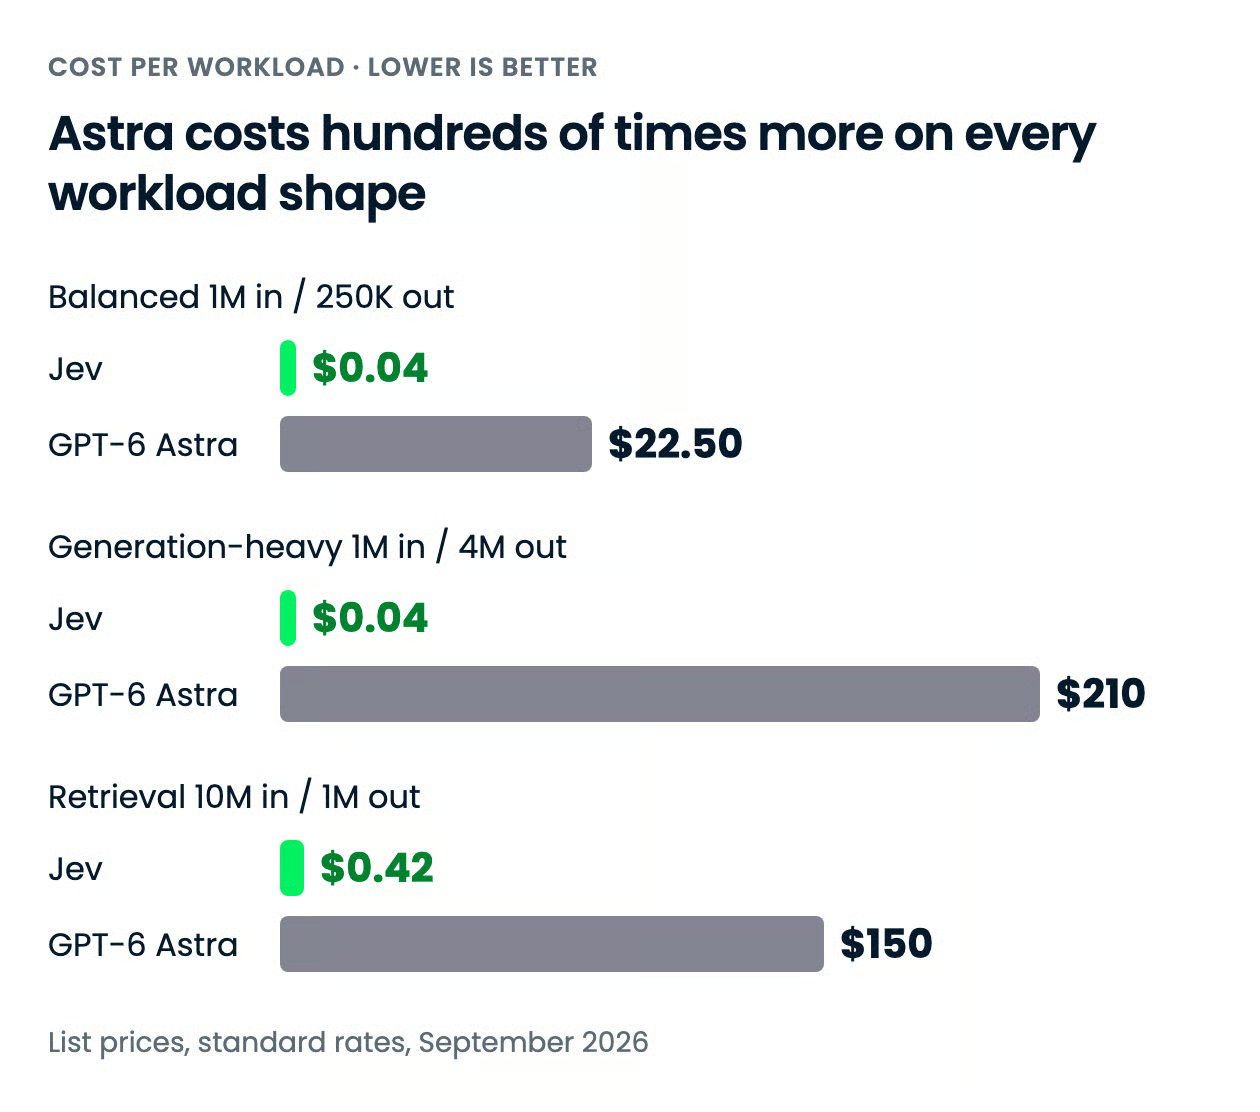
Astra cuesta varios cientos de veces más que Jev en cualquier forma de carga, y la brecha se amplía cuanto más output genera la tarea, porque Jev no factura salida.
| Tarifa | Jev | GPT-6 Astra |
|---|---|---|
| Entrada, por 1M de tokens | $0,042 | $10,00 |
| Salida, por 1M de tokens | Gratis | $50,00 |
| Lectura de entrada en caché, por 1M | No publicado | $1,00 |
| Escritura en caché, por 1M | No publicado | $12,50 |
| Descuento por lotes | No publicado | 50% (Batch y Flex) |
| Recargo por contexto largo | No publicado | 2x en entrada y caché, 1,5x en salida, por encima de 272K tokens de entrada |
| Modo Fast | No aplicable | 2x las tarifas aplicables |
| Plan de consumo | No aplicable; solo API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro en Pro y superiores) |
La forma de la diferencia importa tanto como el tamaño. La tarifa de salida de Astra es 5 veces su tarifa de entrada, y sus tokens de razonamiento se facturan como salida, así que el trabajo con mucho pensamiento o muy prolijo es donde la factura crece más rápido. Jev solo factura la entrada, y una respuesta típica son unas decenas de tokens de salida, así que su coste depende de cuánto estado envías y nada más.
TypeSafe admite que no puede demostrar que el precio no esté subvencionado y espera que baje antes que suba.
| Carga | Jev | GPT-6 Astra | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M in / 250K out | $0,04 | $22,50 | $22,46; Jev un 99,8% más barato |
| Generación intensiva: 1M in / 4M out | $0,04 | $210 | $209,96; Jev un 99,98% más barato |
| Recuperación, bajo umbral: 10M in / 1M out | $0,42 | $150 | $149,58; Jev un 99,7% más barato |
La fórmula es (volumen ÷ 1M) × tarifa, sumada entre entrada y salida, a tarifas estándar. La fila de generación intensiva es la atípica porque la salida de Jev es gratis, aunque también es la menos realista para Jev: el modelo nunca emite 4M tokens de salida, así que léela como el efecto del premium de salida en Astra. La fila de recuperación es la que encaja con el uso real de Jev: mucho estado de entrada y un puñado de probabilidades de salida, y aun así hay 357x de diferencia.
No hay fila de recuperación sobre umbral porque la documentación de TypeSafe no indica recargo por contexto largo, y la ventana de contexto que listan los routers para Jev está muy por debajo del umbral de Astra, así que los multiplicadores de 2x en entrada y 1,5x en salida de Astra no tienen con qué compararse. Ningún proveedor ha publicado conteos de tokens para una carga compartida, y el tokenizador de Jev no está documentado, así que trata estos totales como una comparación de tarifas, no como una factura.
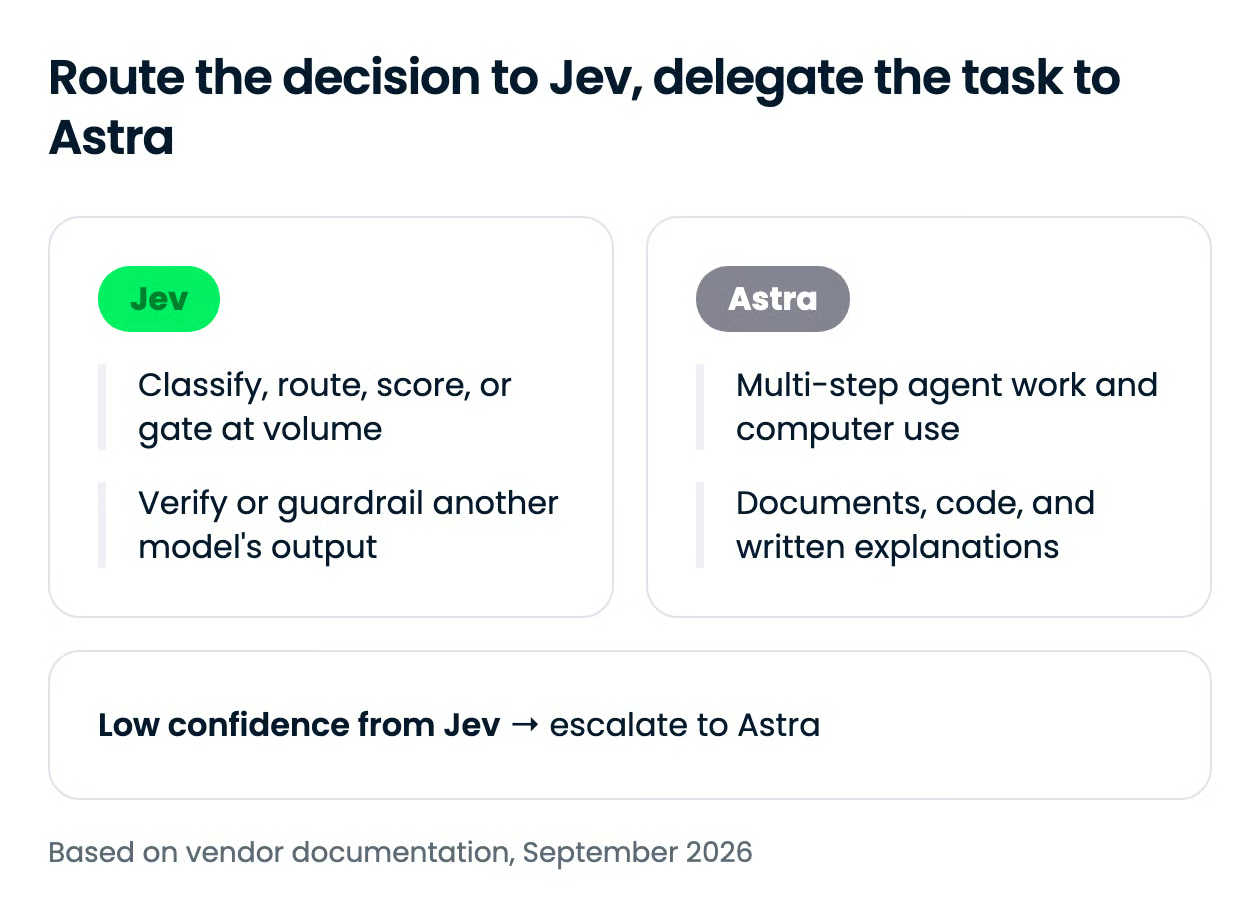
La bifurcación no va de precisión o precio por sí solos, sino de si el paso termina en una decisión o en un artefacto. Una decisión pertenece a Jev; cualquier cosa que alguien vaya a leer, ejecutar o abrir pertenece a Astra.
El alcance es la dimensión más desequilibrada de este artículo: Astra está en todos los sitios habituales de los modelos de OpenAI, y Jev es una API con lista de espera cuyas únicas rutas sin invitación son los listados de OpenRouter y Vercel AI Gateway.
| Superficie | Jev | GPT-6 Astra |
|---|---|---|
| App de consumo | Ninguna; solo consola para desarrolladores | ChatGPT Plus, Pro, Business y Enterprise; desactivado por defecto para workspaces Enterprise en el lanzamiento |
| API de primera parte | TypeSafe API, acceso anticipado solo por lista de espera; sin alta autoservicio | OpenAI API (Responses y Chat Completions), despliegue progresivo tras el lanzamiento |
| Plataformas cloud | Ninguna | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agentes de código | No aplicable; no produce texto ni llamadas a herramientas | Codex, GitHub Copilot; no aparece en la documentación de Cursor a 21 de septiembre de 2026 |
| Routers de terceros | OpenRouter (typesafe/jev-1.13, vía un endpoint systemone dedicado), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID de modelo en la API | jev-latest (alias de jev-1.13.0) |
gpt-6-astra |
Los IDs de modelo son jev-latest, que es el valor por defecto en los SDK de TypeSafe y que actualmente resuelve a jev-1.13.0, y gpt-6-astra. TypeSafe recomienda fijar la versión si tienes umbrales de confianza ajustados, porque el alias cambia cuando sale una nueva versión. Los límites de tasa de Jev son 250.000 tokens por segundo y 1.200 solicitudes por minuto, y TypeSafe indica que ambos pueden cambiar sin aviso mientras escala.
No son intercambiables con una sola cadena. Astra recibe un prompt y devuelve texto a través de la Responses API; Jev recibe estado y un mapa de preguntas tipadas en un único endpoint y devuelve probabilidades. Los dos bloques de abajo hacen la misma solicitud de devoluciones a cada modelo para que veas la diferencia de forma.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidencePara la configuración completa de Astra, incluidas herramientas asíncronas y control a mitad de turno, sigue nuestro tutorial del API de GPT-6 Astra; para JSON estructurado con modelos de OpenAI, consulta nuestro tutorial de outputs estructurados.
Si el paso termina en una decisión sobre la que actúa tu código, usa Jev; si termina en algo que una persona lee o ejecuta, usa GPT-6 Astra. La arquitectura que sugiere este lanzamiento combina ambos: Jev como ruteador barato y calibrado delante, y Astra como especialista al que se escala cuando cae la confianza.
Lo más revelador para mí es que TypeSafe califique Jev contra las respuestas de Astra. OpenAI está diciendo que la frontera es la ejecución autónoma; TypeSafe apuesta a que la mayoría de lo que el software pregunta a un modelo es una pregunta acotada disfrazada. La incógnita para Jev es si un benchmark independiente confirma la paridad y si el precio sobrevive a la subvención.
Para construir la capa de decisión en la que se apoya cualquiera de los dos modelos, te recomiendo nuestro curso Developing AI Systems with the OpenAI API y nuestro itinerario AI Agent Fundamentals.
¡Aprende ingeniería de IA con DataCamp!
Curso
programa
Curso