course
Tworzenie systemów AI z OpenAI API
3 godz.
22.8K
TypeSafe wyszło z ukrycia 15 września 2026 z Jev, modelem, który określa jako model System One: wysyłasz do niego stan programu i typowane pytania, a on zwraca decyzje ze skalibrowanymi prawdopodobieństwami zamiast tekstu. Dwanaście dni wcześniej OpenAI wypuściło GPT-6 Astra, które opisuje jako swój najbardziej inteligentny i zestrojony model, zbudowany do obsługi komputera, kodowania i pracy profesjonalnej end-to-end.
W tym artykule porównam Jev i GPT-6 Astra pod kątem wiarygodności wyjścia, trafności decyzji, szybkości, zasięgu agentowego i cen, a następnie wskażę, które wywołania w potoku oprogramowania należą do którego modelu.
Jev to hostowany model decyzyjny, który TypeSafe AI udostępniło we wczesnym dostępie we wrześniu 2026, pierwszy z tego, co nazywa modelami System One.
Jego wyróżnikiem jest rezygnacja z generowania tekstu: definiujesz przestrzeń odpowiedzi z góry jako pytania Choice, Score lub Noul (tak/nie), a on zwraca typowane wartości ze skalibrowanymi prawdopodobieństwami, na których oprogramowanie może od razu się rozgałęziać. Nasz przewodnik po Jev omawia premierę i deklaracje ewaluacyjne TypeSafe.
GPT-6 Astra to flagowy model OpenAI na granicy możliwości, wydany 3 września 2026 jako następca GPT-5.6 Sol.
Jego pozycjonowanie to autonomiczne wykonywanie zadań: OpenAI nazywa go najlepszym na świecie modelem do obsługi komputera i swoim najbardziej zestrojonym, wytrenowanym do wypełniania formularzy, aktualizacji CRM, budowy i QA strony internetowej oraz tworzenia dokumentów zgodnych z twoimi szablonami. Nasz przewodnik po GPT-6 Astra omawia premierę; nasz tutorial API GPT-6 Astra buduje agenta do sprawdzania wydań z użyciem narzędzi asynchronicznych.
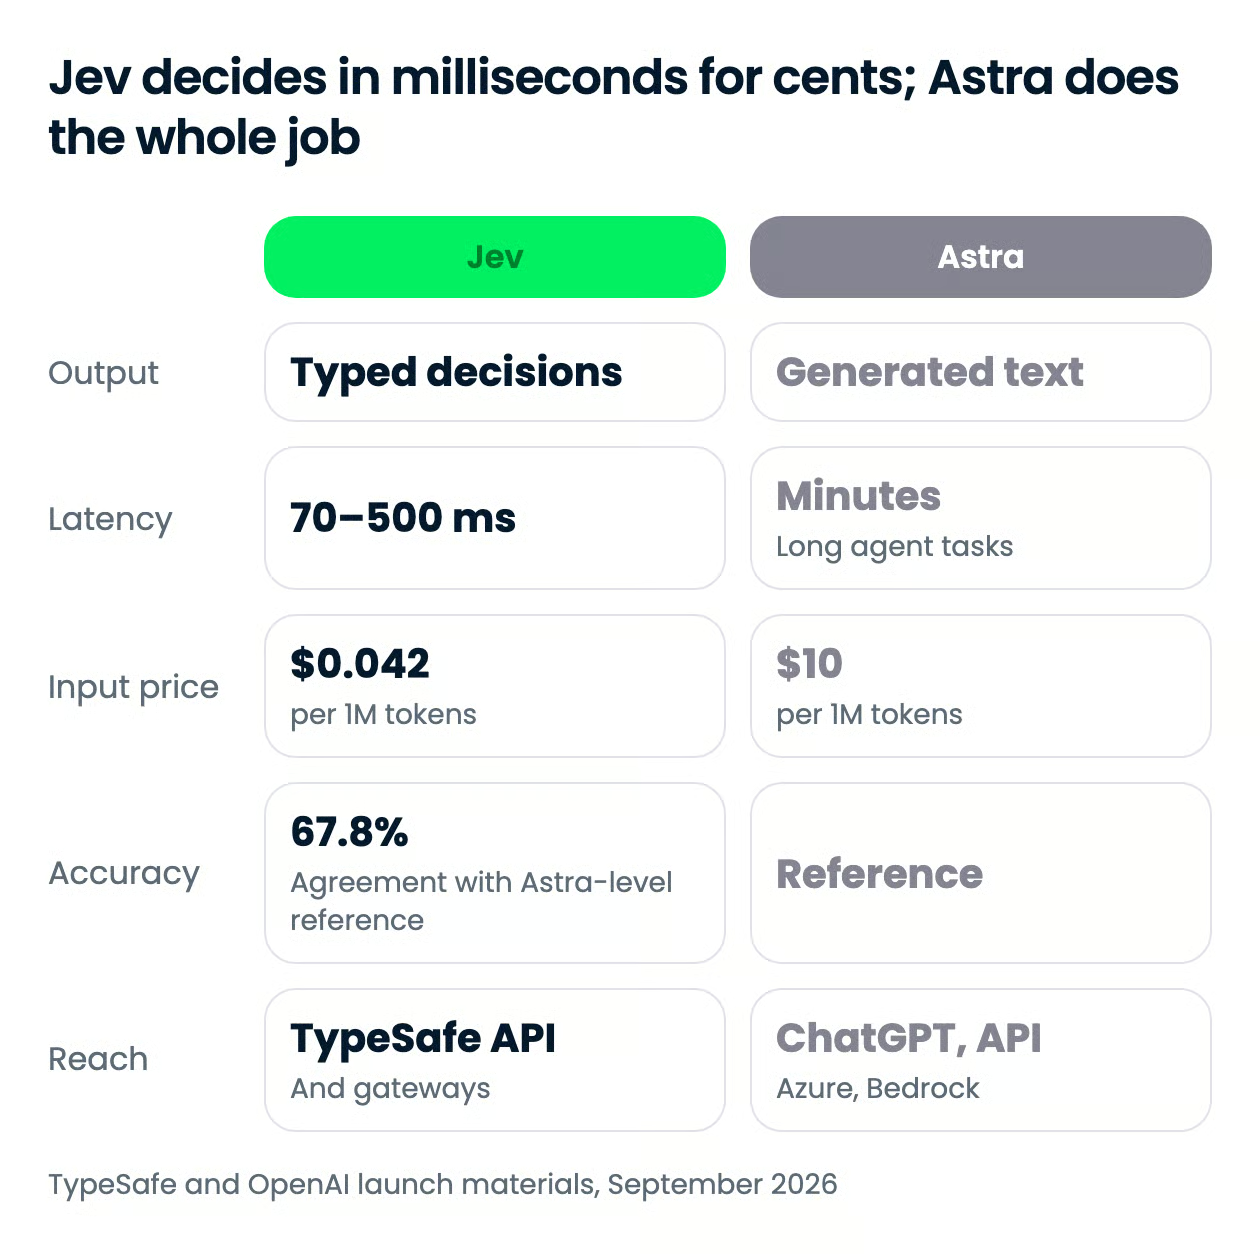
Te dwa modele siedzą na przeciwnych końcach jednego kompromisu: Jev kupuje szybkość, cenę i bezpieczeństwo typów, odmawiając generowania tekstu, a Astra kupuje szerokość i głębię, generując wszystko. Większość poniższych wierszy wynika z tej jednej decyzji projektowej.
| Cecha | Jev | GPT-6 Astra |
|---|---|---|
| Wyjście | Typowane decyzje (Choice, Score, Noul) z prawdopodobieństwami; bez tekstu | Generowany tekst; obsługiwane wyjścia strukturalne i wywołania funkcji |
| Błędy typu lub schematu | 0% z definicji | Możliwe; 4,2% w wewnętrznym benchmarku halucynacji OpenAI |
| Wejście | Tekst, obiekty JSON, tablice; bez obrazów | Tekst i obrazy |
| Okno kontekstu | Nie podano w dokumentacji TypeSafe; 32 000 tokenów w listingach OpenRouter i Vercel AI Gateway | 1 050 000 tokenów; maks. 128 000 na wyjściu |
| Opóźnienie end-to-end | 70–500 ms na wywołanie (zgodnie z danymi dostawcy) | Minuty przy zadaniach agentowych; około 40 minut na zadanie OSWorld 2.0 |
| Dokładność decyzji | 67,8% zgodności z odpowiedzią referencyjną Astra + Fable 5.1 w 4‑workflowowym teście TypeSafe | Jest referencją; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Agenci i narzędzia | Brak; decyzja wewnątrz twojego kodu | Obsługa komputera, hostowana powłoka, wyszukiwarka WWW, interpreter kodu; 72,6% OSWorld 2.0 |
| Pewność | Skalibrowane prawdopodobieństwo przy każdej odpowiedzi plus pochodna ocena pewności | Nieudostępniane jako pole |
| Cena za 1M tokenów | $0,042 wejście; wyjście bezpłatne | $10 wejście; $50 wyjście |
| Dostępność | Wczesny dostęp przez TypeSafe API, OpenRouter, Vercel AI Gateway | Płatne plany ChatGPT, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev nie może zwrócić nieprawidłowej wartości, a Astra może. Ten pojedynczy fakt sprawia, że trafiają do różnych warstw systemu, a nie na to samo miejsce.
Żądanie do Jev to blok stanu plus mapa typowanych pytań:
Przestrzeń odpowiedzi jest ustalona przed inferencją, więc dopasowanie do schematu jest gwarantowane; TypeSafe podaje swój wskaźnik błędów wyjść strukturalnych i wywołań narzędzi jako 0% i określa tę liczbę jako nieempiryczną.
Astra reprezentuje klasyczny LLM i zwraca tekst. Choć obsługuje wyjścia strukturalne i wywołania funkcji oraz obniża wskaźnik błędów Sol do około jednej trzeciej w wewnętrznym benchmarku halucynacji OpenAI, wyjście wciąż trzeba sparsować i zwalidować. Wykres TypeSafe umieszcza błąd wyjść strukturalnych w LLM-ach granicznych między 0,58% a 45,5%; własna liczba Astry nie jest opublikowana, więc nie zakładałbym, że jest na dolnym krańcu.
Kosztem gwarancji Jev jest brak uzasadnienia, tylko prawdopodobieństwo: w sam raz dla warstwy routingu, nie dla recenzenta zgodności, więc zaplanuj eskalację przypadków o niskiej pewności do modelu, który potrafi pisać.
Dwa zastrzeżenia do liczb dotyczących niezawodności:
Dla wyjść, które muszą parsować się za pierwszym razem, wygrywa kontrakt Jev; dla wszystkiego, co czyta człowiek, odpowiedzieć może tylko Astra.
Astra jest dokładniejsza. W czterech produkcyjnych workflowach TypeSafe (reakcja na incydenty, obserwowalność śladów agentów, przetwarzanie faktur, obsługa klienta) Jev zgadza się ze średnią z Astry i Claude Fable 5.1 w 67,8% przypadków, remisując z GPT-5.6 Terra i tracąc 5–6 punktów do GPT-5.6 Sol oraz Claude Opus 5.
Astra jest tu referencją, więc nie ma własnego wyniku zgodności. Na swoich benchmarkach nasyca FrontierMath Tier 4, GPQA Diamond i ARC-AGI-3, choć ostatni zależy od stanowego harnessa. Jev nie rozumuje przez tury, nie planuje ani nie wyjaśnia, a ocenianie go na zgodność z LLM-ami zamiast z prawdą podstawową, jak robi TypeSafe, grozi dziedziczeniem uprzedzeń modeli referencyjnych.
Jeśli potrzebujesz szczytowej dokładności przy decyzji o niskiej liczbie przypadków, LLM wciąż wygrywa.
Jev odpowiada w 70–500 milisekund end-to-end według pomiarów TypeSafe, w porównaniu z 3–329 sekundami dla czołowych LLM-ów przy tym samym typie zapytania. Próbkuje wszystkie odpowiedzi równolegle, a nie token po tokenie, i akceptuje do 255 opcji na Choice.
Astra jest szybka jak na to, czym jest: około 47% mniej czasu na zadanie OSWorld 2.0 niż Sol, a tryb Fast daje do 2× większą szybkość przy 2× cenie. Te zadania wciąż trwają dziesiątki minut. Bot Dooma inżyniera TypeSafe wykonuje 10 zapytań na sekundę za około $7 na godzinę — budżet, którego żaden LLM z czołówki nie spełni.
Dla ścieżki żądania decyzji z budżetem 100 ms, jedynym kandydatem tutaj jest Jev.
Astra robi wszystko, czego Jev nie robi:
Jev przyjmuje tekst, JSON lub tablice tekstu, nie obrazy, i nie wywołuje narzędzi. Jest rozmytym if‑statementem wewnątrz workflowa, którego właścicielem jest twój kod: klasyfikuj, trasuj, oceniaj, ekstraktuj lub weryfikuj wyjście innego modelu, w tym wykrywaj jailbreaki w promptach do LLM‑ów.
Astra wygrywa w tym wymiarze bezapelacyjnie, bo Jev w nim nie startuje.
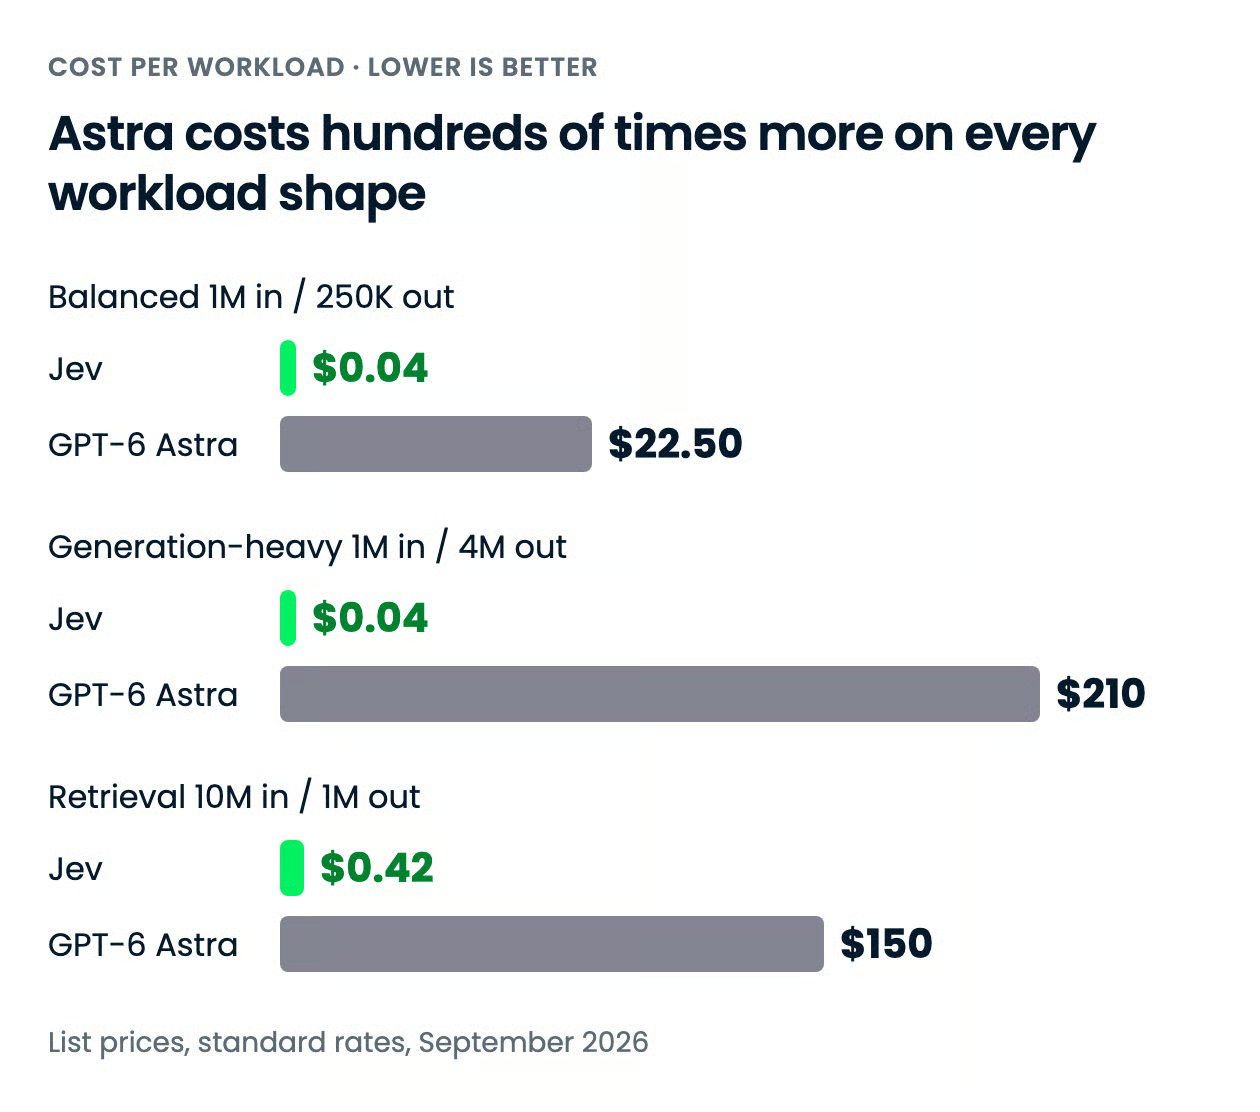
Astra kosztuje kilkaset razy więcej niż Jev przy dowolnym kształcie obciążenia, a różnica rośnie wraz z ilością wyjścia, bo Jev w ogóle nie nalicza opłat za wyjście.
| Stawka | Jev | GPT-6 Astra |
|---|---|---|
| Wejście, za 1M tokenów | $0,042 | $10,00 |
| Wyjście, za 1M tokenów | Bezpłatne | $50,00 |
| Odczyt z cache, za 1M tokenów | Nieopublikowane | $1,00 |
| Zapis do cache, za 1M tokenów | Nieopublikowane | $12,50 |
| Rabat na batch | Nieopublikowany | 50% (Batch i Flex) |
| Dopłata za długi kontekst | Nieopublikowana | 2× wejście i cache, 1,5× wyjście powyżej 272K tokenów wejściowych |
| Tryb Fast | Nie dotyczy | 2× odpowiednie stawki |
| Plan konsumencki | Nie dotyczy; tylko API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro w Pro i wyżej) |
Liczy się nie tylko wielkość różnicy, ale też jej kształt. Stawka wyjścia Astry to 5× stawki wejścia, a tokeny rozumowania są rozliczane jako wyjście, więc prace ciężkie obliczeniowo lub gadatliwe najszybciej podnoszą rachunek. Jev rozlicza tylko wejście, a typowa odpowiedź to kilkadziesiąt tokenów wyjścia, więc koszt zależy wyłącznie od tego, ile stanu wyślesz, i niczego więcej.
TypeSafe otwarcie przyznaje, że nie może dowieść, iż cennik nie jest subsydiowany, i spodziewa się spadków, a nie wzrostów.
| Obciążenie | Jev | GPT-6 Astra | Różnica |
|---|---|---|---|
| Zbalansowany asystent: 1M in / 250K out | $0,04 | $22,50 | $22,46, Jev tańszy o 99,8% |
| Generowanie ciężkie: 1M in / 4M out | $0,04 | $210 | $209,96, Jev tańszy o 99,98% |
| Wyszukiwanie, poniżej progu: 10M in / 1M out | $0,42 | $150 | $149,58, Jev tańszy o 99,7% |
Wzór to (wolumen ÷ 1M) × stawka, zsumowane dla wejścia i wyjścia, przy stawkach standardowych. Wiersz „generowanie ciężkie” jest odstępstwem, bo wyjście Jev jest darmowe, choć to też najmniej realistyczny wiersz dla Jev: model nigdy nie emituje 4M tokenów wyjścia, więc czytaj to jako wpływ samej premii za wyjście na Astrę. Wiersz „wyszukiwanie” odpowiada temu, jak Jev jest faktycznie używany — dużo stanu na wejściu i garść prawdopodobieństw na wyjściu — i nadal różnica wynosi 357×.
Nie ma wiersza powyżej progu, bo dokumentacja TypeSafe nie podaje dopłaty za długi kontekst, a okno kontekstu podawane przez routery dla Jev jest znacznie poniżej progu Astry, więc mnożniki 2× dla wejścia i 1,5× dla wyjścia Astry nie mają z czym porównać. Żaden z dostawców nie opublikował liczby tokenów dla wspólnego obciążenia, a tokenizator Jev nie jest udokumentowany, więc traktuj te sumy jako porównanie stawek, a nie rachunku.
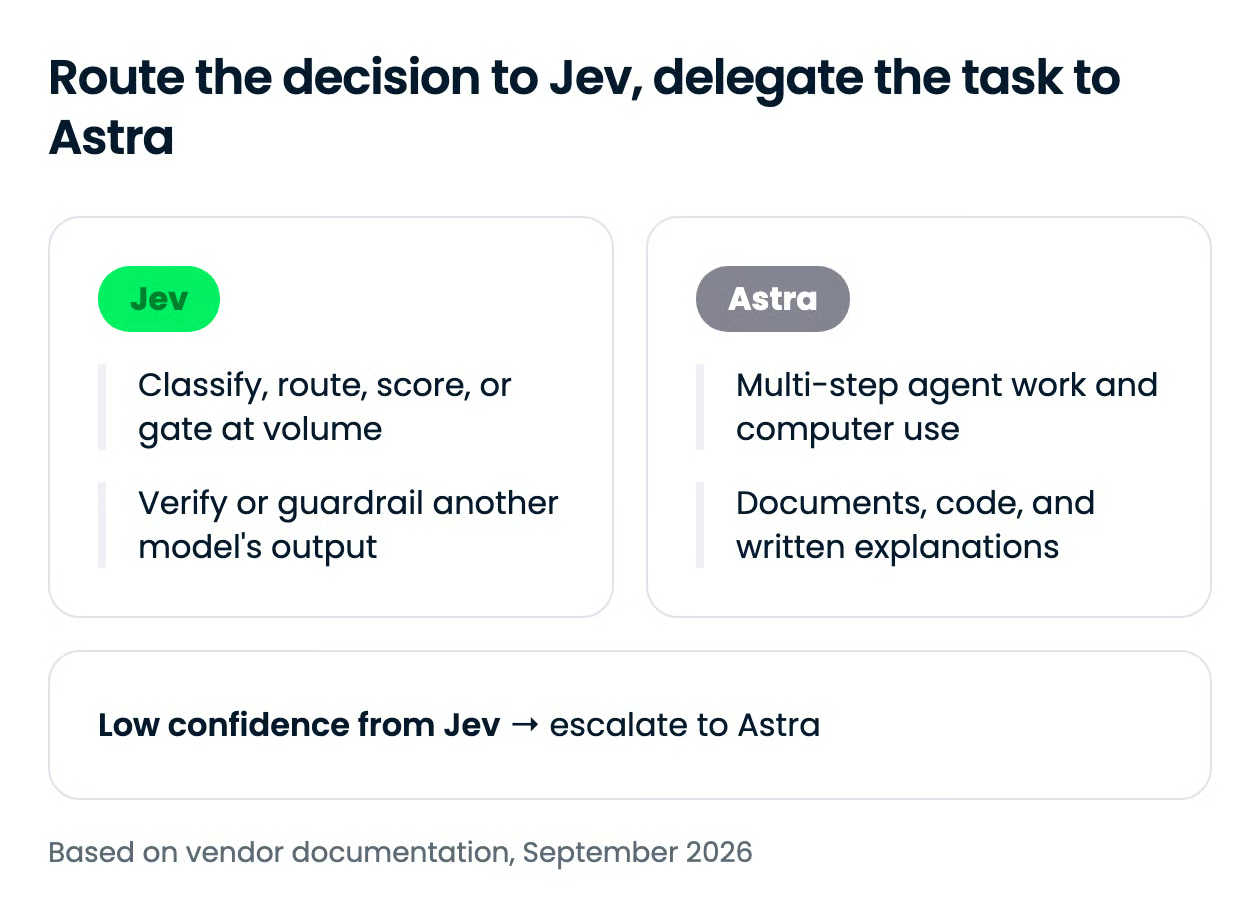
Rozgałęzienie nie dotyczy samej dokładności ani ceny, tylko tego, czy krok kończy się decyzją, czy artefaktem. Decyzja należy do Jev; wszystko, co ktoś będzie czytać, uruchamiać lub otwierać, należy do Astry.
Zasięg to najbardziej jednostronny wymiar w tym artykule: Astra jest wszędzie tam, gdzie zwykle są modele OpenAI, a Jev to API z listą oczekujących, którego jedyne trasy bez zaproszenia to listingi w OpenRouter i Vercel AI Gateway.
| Powierzchnia | Jev | GPT-6 Astra |
|---|---|---|
| Aplikacja konsumencka | Brak; tylko konsola deweloperska | ChatGPT Plus, Pro, Business i Enterprise; domyślnie wyłączone dla przestrzeni Enterprise na starcie |
| API pierwszej strony | TypeSafe API, wczesny dostęp tylko przez listę oczekujących; brak samoobsługowej rejestracji | OpenAI API (Responses i Chat Completions), wdrażane w dniach po premierze |
| Platformy chmurowe | Brak | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agenci do kodu | Nie dotyczy; nie produkuje tekstu ani wywołań narzędzi | Codex, GitHub Copilot; niewymienione w dokumentacji Cursor na 21 września 2026 |
| Routery zewnętrzne | OpenRouter (typesafe/jev-1.13, przez dedykowany endpoint systemone), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID modelu w API | jev-latest (alias dla jev-1.13.0) |
gpt-6-astra |
ID modeli to jev-latest, do którego domyślnie odwołują się SDK TypeSafe i który obecnie rozwiązuje się do jev-1.13.0, oraz gpt-6-astra. TypeSafe zaleca przypinanie wersjonowanego ID, jeśli masz dostrojone progi pewności, bo alias przesuwa się wraz z nowym wydaniem. Limity Jev to 250 000 tokenów na sekundę i 1 200 żądań na minutę i TypeSafe mówi, że oba mogą zmieniać się bez powiadomienia w trakcie skalowania.
To nie jest podmiana jednego stringa. Astra przyjmuje prompt i zwraca tekst przez Responses API; Jev przyjmuje stan i mapę typowanych pytań przez jeden endpoint i zwraca prawdopodobieństwa. Dwa bloki poniżej składają to samo żądanie dotyczące zwrotu do obu modeli, żebyś zobaczył różnicę w kształcie.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidencePełną konfigurację Astry, w tym narzędzia asynchroniczne i sterowanie w trakcie tury, znajdziesz w naszym tutorialu API GPT-6 Astra; dla strukturalnego JSON z modeli OpenAI zobacz nasz tutorial o wyjściach strukturalnych.
Jeśli krok kończy się decyzją, na podstawie której działa twój kod, użyj Jev; jeśli kończy się czymś, co człowiek czyta lub uruchamia, użyj GPT-6 Astra. Architektura, którą sugeruje ta premiera, to oba naraz: Jev jako tani, skalibrowany router z przodu, Astra jako specjalista, do którego eskaluje, gdy pewność spada.
Najbardziej wymowne jest dla mnie to, że TypeSafe ocenia Jev względem odpowiedzi Astry. OpenAI składa deklarację, że granica to autonomiczne wykonywanie; TypeSafe stawia na to, że większość tego, o co oprogramowanie prosi model, to w przebraniu pytanie o ograniczonej przestrzeni. Otwarte pytanie dla Jev brzmi, czy niezależny benchmark potwierdzi parytet i czy cennik przetrwa bez subsydiów.
Aby zbudować warstwę decyzyjną, w której siedzi którykolwiek model, polecam nasz kurs Developing AI Systems with the OpenAI API i naszą ścieżkę AI Agent Fundamentals.
Naucz się inżynierii AI z DataCamp!
course
Track
course