Courses
使用 OpenAI API 构建 AI 系统
3小时
22.8K
TypeSafe 于 2026 年 9 月 15 日正式发布 Jev,这是一款其称之为 System One 的模型:您向它发送程序状态和带类型的问题,它返回带有校准概率的决策而非文本。早于 12 天,OpenAI 推出了 GPT-6 Astra,被描述为其最智能、最对齐的模型,面向计算机使用、编码与端到端的专业工作。
本文将从输出可靠性、决策准确性、速度、智能体能力范围和定价等方面对 Jev 和 GPT-6 Astra 进行比较,并给出在软件流水线中各类调用应归属哪一模型。
Jev 是 TypeSafe AI 于 2026 年 9 月以抢先体验发布的托管决策模型,也是其首个 System One 模型。
其卖点在于放弃文本生成:您预先将答案空间定义为 Choice、Score 或 Noul(是/否)问题,它返回可直接在软件中分支的带类型值与校准概率。我们的 Jev 指南涵盖了发布概况与 TypeSafe 的评测结论。
GPT-6 Astra 是 OpenAI 的前沿旗舰,于 2026 年 9 月 3 日发布,是 GPT-5.6 Sol 的继任者。
其定位是自主执行:OpenAI 称其为全球最佳的计算机使用模型,也是其对齐度最高的模型,训练目标包括填写表单、更新 CRM、搭建与质检网站,以及按您的模板生成文档。我们的 GPT-6 Astra 指南介绍了发布内容;我们的 GPT-6 Astra API 教程用异步工具构建了一个发布检查智能体。
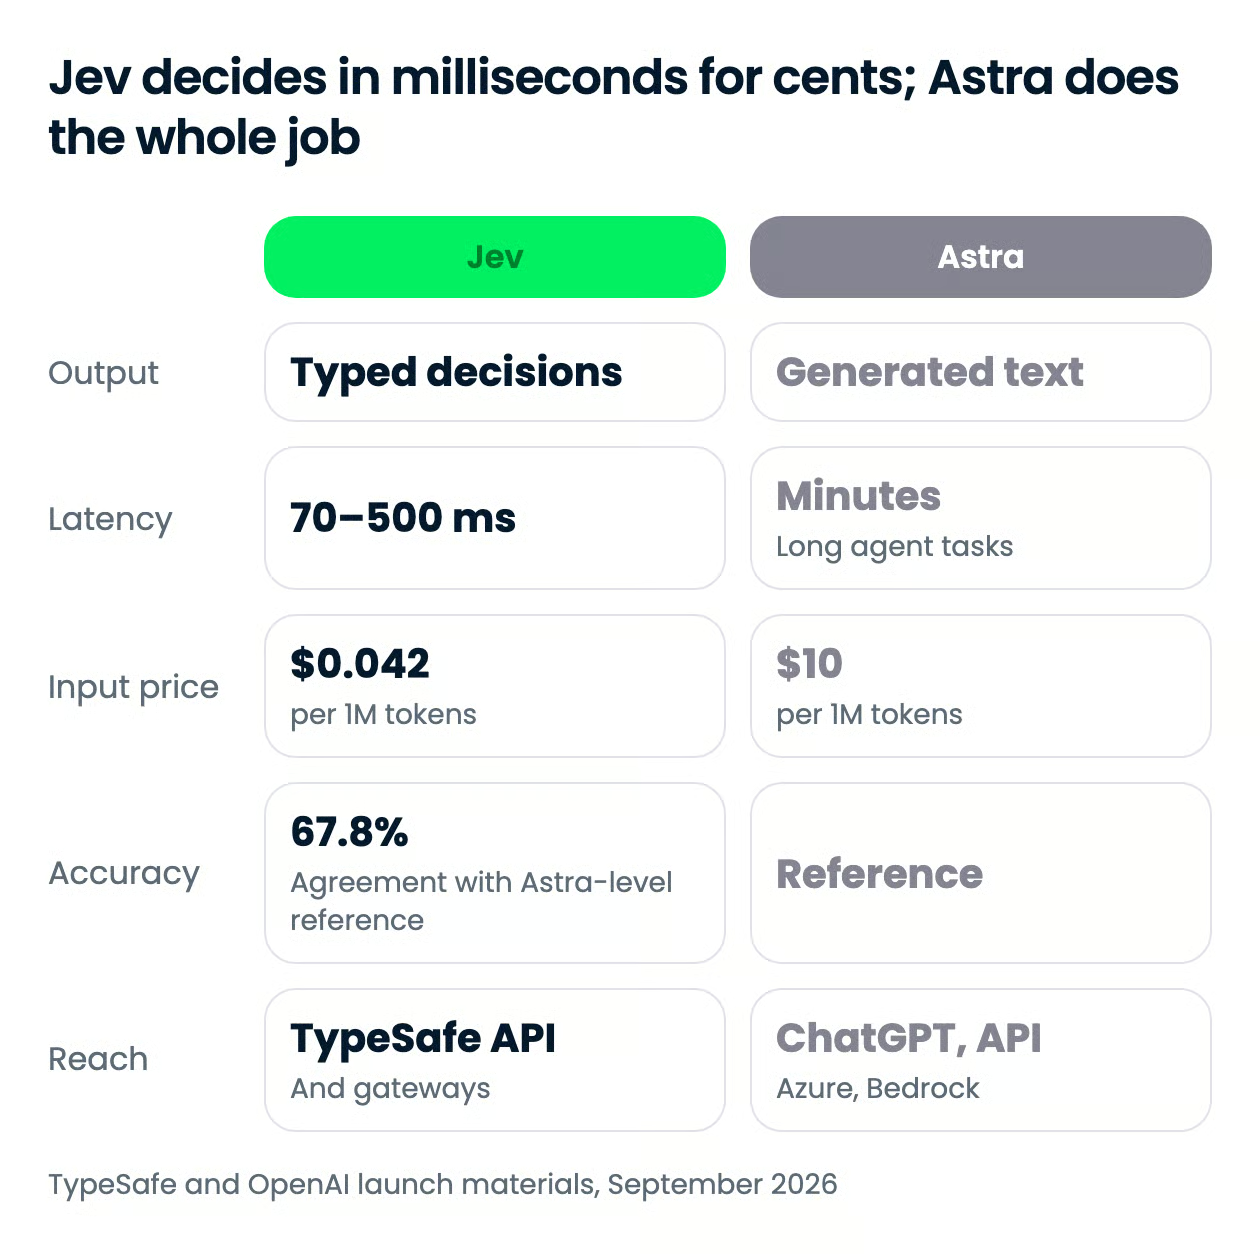
两者分处一项权衡的两端:Jev 通过拒绝生成文本来换取速度、价格与类型安全;Astra 通过生成一切来换取广度与深度。下方多数差异均源于这一单一设计选择。
| 特性 | Jev | GPT-6 Astra |
|---|---|---|
| 输出 | 带概率的带类型决策(Choice、Score、Noul);不生成文本 | 生成文本;支持结构化输出与函数调用 |
| 类型或架构错误 | 按构造为 0% | 可能发生;在 OpenAI 内部幻觉基准上为 4.2% |
| 输入 | 文本、JSON 对象、数组;不支持图像 | 文本与图像 |
| 上下文窗口 | TypeSafe 文档未说明;OpenRouter 与 Vercel AI Gateway 标注为 32,000 tokens | 1,050,000 tokens;最大输出 128,000 |
| 端到端时延 | 每次调用 70–500 毫秒(厂商报告) | 智能体任务为数分钟;每个 OSWorld 2.0 任务约 40 分钟 |
| 决策准确性 | 在 TypeSafe 的 4 流程评测上与 Astra + Fable 5.1 参考平均值一致率为 67.8% | 为参考本身;GPQA Diamond 96.0%,FrontierMath Tier 4 为 97.6% |
| 智能体与工具 | 无;作为您代码中的一个决策 | 计算机使用、托管 shell、网页搜索、代码解释器;OSWorld 2.0 得分 72.6% |
| 置信度 | 每个答案提供校准概率与派生置信分数 | 未作为字段暴露 |
| 每 100 万 tokens 价格 | $0.042 输入;输出免费 | $10 输入;$50 输出 |
| 可用性 | 通过 TypeSafe API、OpenRouter、Vercel AI Gateway 的抢先体验 | ChatGPT 付费层、OpenAI API、Azure、AWS Bedrock、GitHub Copilot、OpenRouter |
Jev 不会产生无效值,而 Astra 可能。这一事实决定了两者更适合处于系统的不同层,而非同一位置互相替代。
一次 Jev 请求由一块状态加上一组带类型的问题构成:
答案空间在推理前已固定,因而保证契合架构;TypeSafe 将其结构化输出与工具调用的错误率标为 0%,并称该数字为非实证。
Astra 是经典 LLM,返回文本。尽管其支持结构化输出与函数调用,并将 Sol 在 OpenAI 内部幻觉基准上的错误率降至约三分之一,但输出仍需解析与校验。TypeSafe 的图表显示前沿 LLM 的结构化输出错误率介于 0.58% 与 45.5% 之间;Astra 自身的数字未公开,因此不应假设其位于低端。
Jev 的保证代价是不给出理由,只有概率:这对路由层很好,但不适用于合规复核,因此应计划将低置信度案例上拨给能写作的模型。
关于可靠性数据有两点注意:
对于必须一次解析成功的输出,Jev 的契约胜出;凡是供人阅读的内容,只有 Astra 能回答。
Astra 更为准确。在 TypeSafe 的四个生产工作流(事件响应、智能体追踪可观测性、发票处理、客户服务)上,Jev 与 Astra 和 Claude Fable 5.1 的平均值一致率为 67.8%,与 GPT-5.6 Terra 持平,落后 GPT-5.6 Sol 与 Claude Opus 5 5–6 个百分点。
Astra 在该测试中为参考模型,因而没有自身一致率数据。在其自有基准上,它在 FrontierMath Tier 4、GPQA Diamond 与 ARC-AGI-3 上接近饱和,尽管最后一项依赖有状态的测试框架。Jev 不进行跨轮推理、规划或解释,且如 TypeSafe 所做,以与 LLM 的一致性而非与真值对比来评分,存在继承参考模型偏差的风险。
若您需要在低频决策上追求峰值准确率,仍应选择 LLM。
按 TypeSafe 的测量,Jev 端到端响应为 70–500 毫秒;对于同类查询,前沿 LLM 为 3–329 秒。它并行采样所有答案,而非逐 token 生成,并支持每次 Choice 最多 255 个选项。
Astra 在其定位中已算快速:每个 OSWorld 2.0 任务耗时比 Sol 少约 47%,Fast 模式可在价格翻倍的情况下将速度最高提升 2 倍。但这些任务仍需几十分钟。一位 TypeSafe 工程师的 Doom 机器人每秒可跑 10 次查询,约每小时 $7,前沿 LLM 难以匹配该预算。
对于 100 毫秒预算的决策请求路径,此处只有 Jev 合格。
Astra 覆盖了 Jev 不做的一切:
Jev 接受文本、JSON 或文本数组,不支持图像,也不调用工具。它是您工作流中由代码掌控的模糊 if 语句:分类、路由、打分、抽取,或校验另一模型的输出,包括对 LLM 提示的越狱检测。
在此维度上 Astra 直接取胜,因为 Jev 并未参赛。
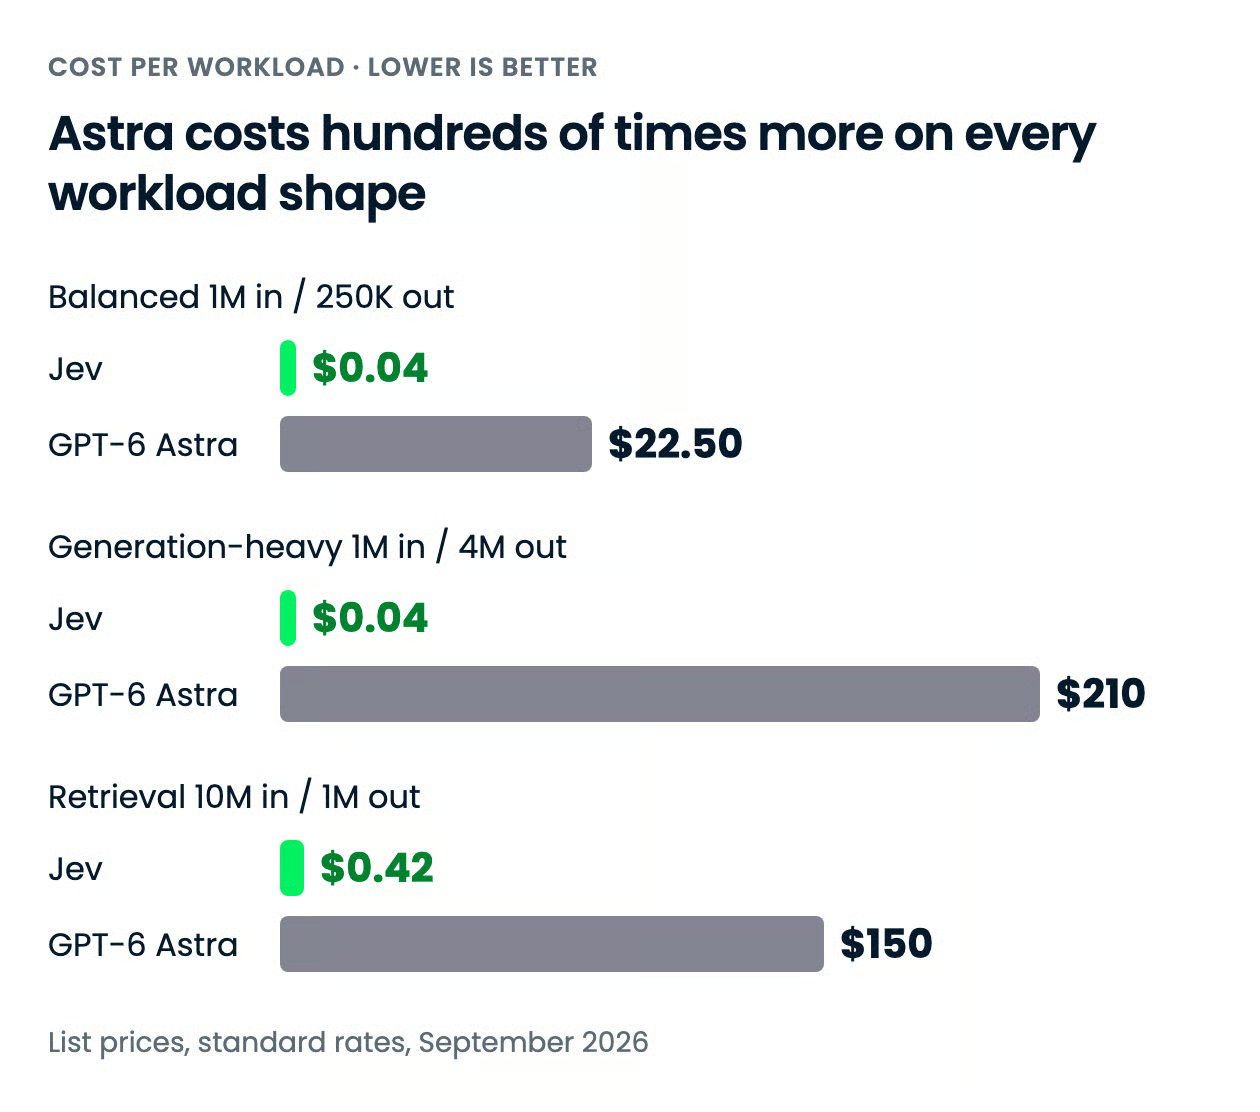
在任何工作负载形态下,Astra 的成本都比 Jev 高出数百倍,且任务输出越多差距越大,因为 Jev 不对输出计费。
| 费率 | Jev | GPT-6 Astra |
|---|---|---|
| 输入,每 100 万 tokens | $0.042 | $10.00 |
| 输出,每 100 万 tokens | 免费 | $50.00 |
| 缓存输入读取,每 100 万 tokens | 未公布 | $1.00 |
| 缓存写入,每 100 万 tokens | 未公布 | $12.50 |
| 批处理折扣 | 未公布 | 50%(Batch 与 Flex) |
| 长上下文附加费 | 未公布 | 输入与缓存 2 倍、输出 1.5 倍,适用于超过 272K 输入 tokens |
| 快速模式 | 不适用 | 适用费率的 2 倍 |
| 消费者层 | 不适用;仅 API | ChatGPT Plus、Pro、Business、Enterprise(Astra Pro 在 Pro 及以上开放) |
差异的形状与规模同等重要。Astra 的输出费率是输入的 5 倍,且推理 tokens 计入输出,因此思考密集或冗长的工作将最易推高账单。Jev 仅对输入计费,而其典型答案只有几十个输出 tokens,故成本仅与您传入的状态量相关。
TypeSafe 坦言无法证明其定价未被补贴,并预期价格将下降而非上升。
| 工作负载 | Jev | GPT-6 Astra | 差额 |
|---|---|---|---|
| 均衡助手:100 万入 / 25 万出 | $0.04 | $22.50 | $22.46,Jev 便宜 99.8% |
| 生成密集:100 万入 / 400 万出 | $0.04 | $210 | $209.96,Jev 便宜 99.98% |
| 检索,低于阈值:1000 万入 / 100 万出 | $0.42 | $150 | $149.58,Jev 便宜 99.7% |
计算公式为(体量 ÷ 100 万)× 费率,在标准费率下对输入与输出求和。生成密集一行是离群值,因为 Jev 输出免费,同时这对 Jev 也最不现实:该模型从不产出 400 万输出 tokens,因此可理解为仅输出溢价对 Astra 带来的影响。检索一行更贴近 Jev 的实际用法:大量状态输入与少量概率输出,差距仍达 357 倍。
没有超阈值检索一行,因为 TypeSafe 文档未说明长上下文附加费,而路由商为 Jev 标注的上下文窗口远低于 Astra 的阈值,因此 Astra 的输入 2 倍与输出 1.5 倍附加无法对比。两家厂商均未公布共享工作负载的 token 统计,且 Jev 的分词器未文档化,因此将上述总额视为费率对比而非实际账单。
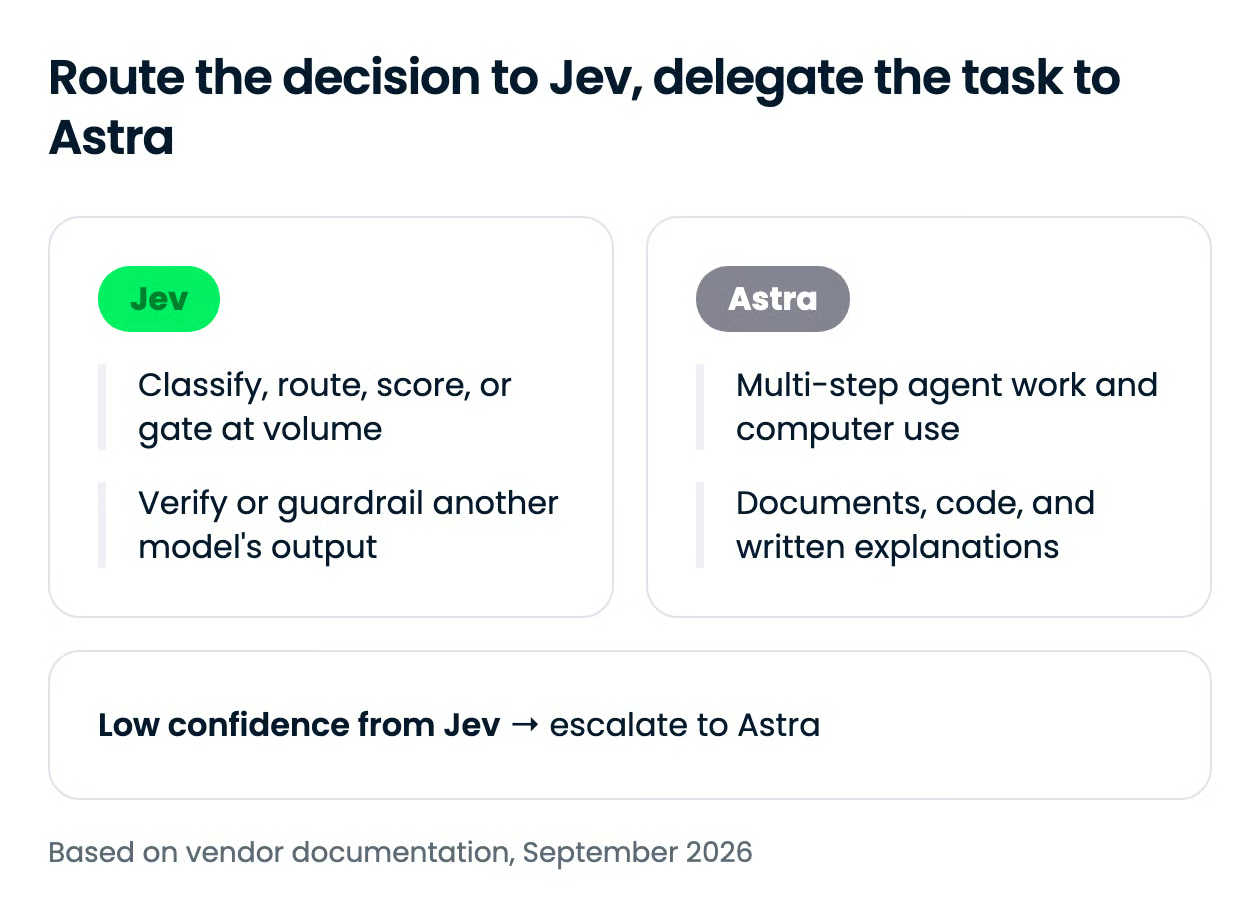
分野不在于各自能否独立做到“准”或“省”,而在于该步骤的终点是一个决策还是一个成果。以决策为终点的交给 Jev;凡是需要被阅读、运行或打开的成果,交给 Astra。
覆盖面是本文最不对称的维度:Astra 几乎在 OpenAI 模型常见的所有渠道可用,而 Jev 是一个受等候名单限制的 API,未获邀请的唯一通路是 OpenRouter 与 Vercel AI Gateway 的上架。
| 渠道 | Jev | GPT-6 Astra |
|---|---|---|
| 消费者应用 | 无;仅开发者控制台 | ChatGPT Plus、Pro、Business 与 Enterprise;发布时对 Enterprise 工作区默认关闭 |
| 一方 API | TypeSafe API,需等候名单抢先体验;不支持自助注册 | OpenAI API(Responses 与 Chat Completions),发布后数日内逐步开放 |
| 云平台 | 无 | Microsoft Azure AI Foundry、AWS Bedrock(us.openai.gpt-6-astra) |
| 编码智能体 | 不适用;不产出文本或工具调用 | Codex、GitHub Copilot;截至 2026 年 9 月 21 日未在 Cursor 文档中列出 |
| 第三方路由 | OpenRouter(typesafe/jev-1.13,经专用 systemone 端点),Vercel AI Gateway(typesafe-ai/jev) |
OpenRouter(openai/gpt-6-astra) |
| API 模型 ID | jev-latest(jev-1.13.0 的别名) |
gpt-6-astra |
模型 ID 分别为 jev-latest(TypeSafe SDK 的默认值,目前解析到 jev-1.13.0)与 gpt-6-astra。若您对置信阈值进行了调优,TypeSafe 建议固定到带版本的 ID,因为别名会随新版本发布而更新。Jev 的速率限制为每秒 250,000 tokens、每分钟 1,200 次请求;TypeSafe 表示在扩容期间两者均可能不经通知而变更。
这二者并非“一键替换”。Astra 通过 Responses API 接收提示并返回文本;Jev 通过单一端点接收状态与带类型的问题映射并返回概率。下方两段代码将相同的退货请求分别提交给两种模型,便于您比较其返回结构差异。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidence关于完整的 Astra 设置(含异步工具与中途引导),请参阅我们的 GPT-6 Astra API 教程;若需从 OpenAI 模型获取结构化 JSON,请参阅我们的 结构化输出教程。
如果步骤以您的代码要据此行动的“决策”收尾,用 Jev;如果以供人阅读或运行的“成果”收尾,用 GPT-6 Astra。本次发布所提示的架构是二者兼用:前端用 Jev 作为廉价、校准的路由器,置信度下降时再将其升级给 Astra 这位专家。
最耐人寻味的是 TypeSafe 用 Astra 的答案来给 Jev 打分。OpenAI 在宣告前沿方向是自主执行;TypeSafe 则押注于多数软件向模型发问其实都是伪装的有边界问题。Jev 的开放问题在于,是否有独立基准能证实其对比表现,以及其定价能否在补贴退场后维持。
若要搭建承载两种模型的决策层,推荐我们的 Developing AI Systems with the OpenAI API 课程与 AI Agent Fundamentals 学习路径。
在 DataCamp 学习 AI 工程!
Courses
Tracks
Courses