
Kurs
Entwicklung von KI-Systemen mit der OpenAI-API
3 Std.
22.8K
TypeSafe ist am 15. September 2026 mit Jev aus dem Stealth-Modus gekommen — einem Modell, das es als System-One-Modell bezeichnet: Du sendest Programmzustand und getypte Fragen, und es liefert Entscheidungen mit kalibrierten Wahrscheinlichkeiten statt Text. Zwölf Tage zuvor hat OpenAI GPT-6 Astra veröffentlicht, das es als sein intelligentestes und best-ausgerichtetes Modell beschreibt — gebaut für Computerbedienung, Coding und professionelle Arbeit end-to-end.
In diesem Artikel vergleiche ich Jev und GPT-6 Astra in Bezug auf Output-Zuverlässigkeit, Entscheidungsgenauigkeit, Geschwindigkeit, Agentenfähigkeit und Preise — und zeige dann, welche Aufrufe in einer Software-Pipeline zu welchem Modell gehören.
Jev ist ein gehostetes Entscheidungsmodell, das TypeSafe AI im September 2026 im Early Access veröffentlicht hat — das erste dessen, was es System-One-Modelle nennt.
Das Verkaufsargument: Es verzichtet auf Texterzeugung. Du definierst den Antwortraum vorab als Choice-, Score- oder Noul- (Ja/Nein-)Fragen, und es liefert getypte Werte mit kalibrierten Wahrscheinlichkeiten, auf die Software direkt verzweigen kann. Unser Jev-Guide deckt den Launch und TypeSafes Evaluationsangaben ab.
GPT-6 Astra ist OpenAIs Frontier-Flaggschiff, am 3. September 2026 als Nachfolger von GPT-5.6 Sol erschienen.
Die Positionierung: autonome Ausführung. OpenAI nennt es das weltweit beste Modell für Computerbedienung und sein am besten ausgerichtetes — trainiert, um Formulare auszufüllen, ein CRM zu aktualisieren, eine Website zu bauen und zu testen sowie Dokumente zu erzeugen, die deinen Vorlagen folgen. Unser GPT-6-Astra-Guide deckt den Launch ab; unser GPT-6-Astra-API-Tutorial baut einen Release-Check-Agenten mit asynchronen Tools.
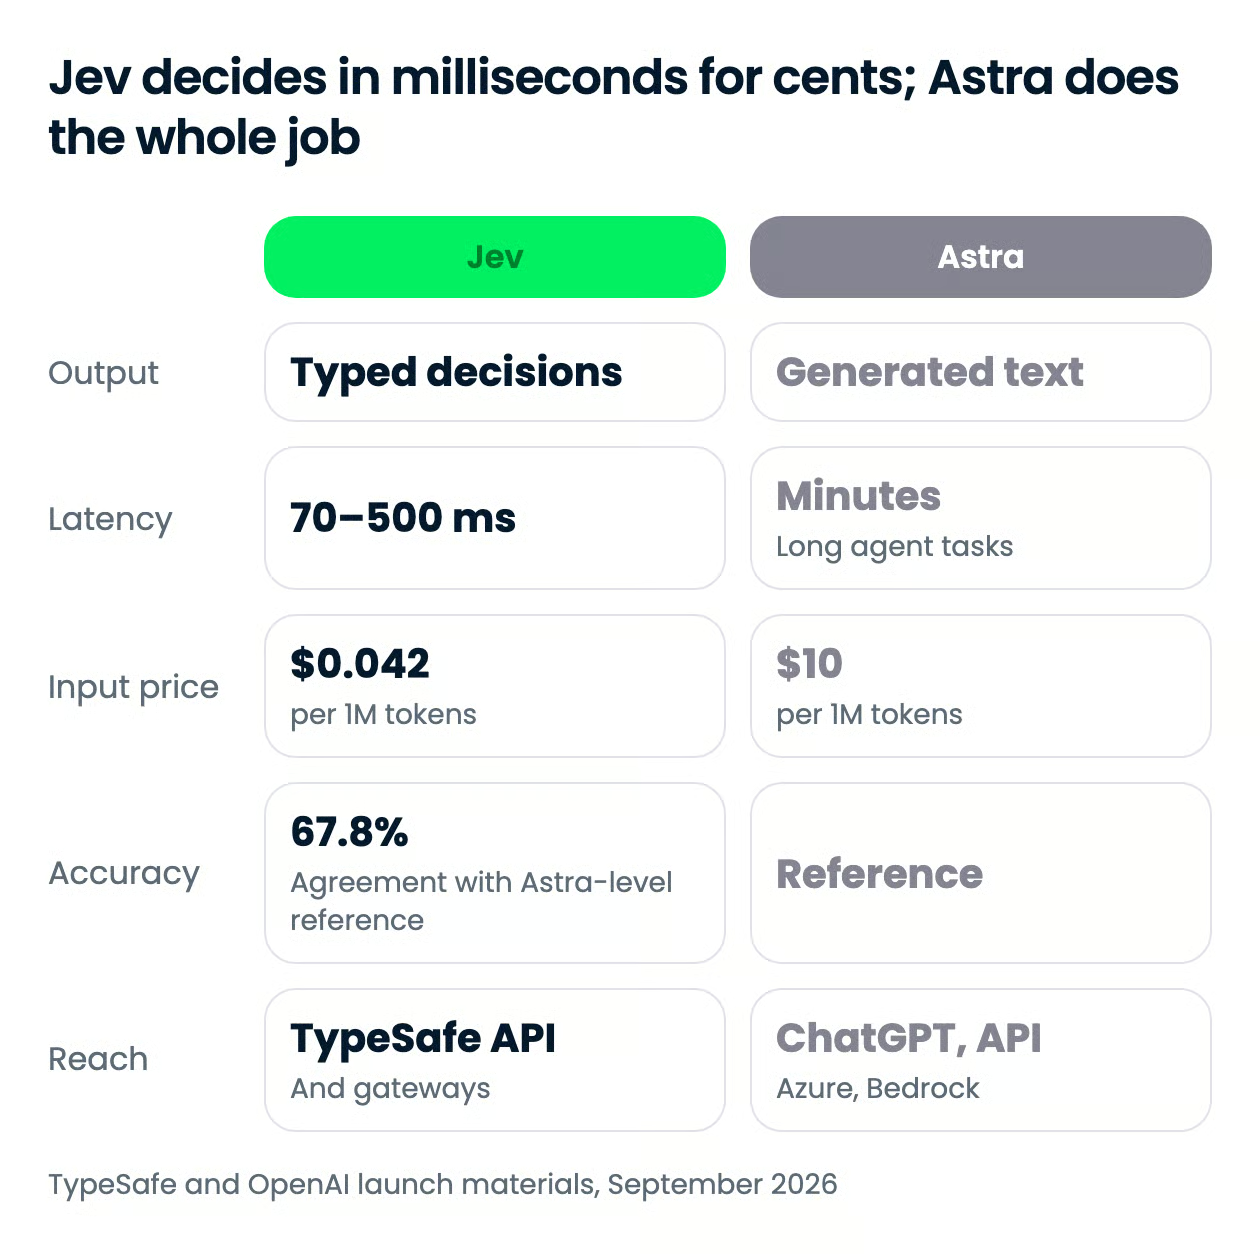
Die beiden Modelle stehen an entgegengesetzten Enden desselben Trade-offs: Jev kauft Geschwindigkeit, Preis und Typsicherheit, indem es keine Texte erzeugt; Astra kauft Breite und Tiefe, indem es alles generiert. Die meisten Punkte unten folgen aus genau dieser Design-Entscheidung.
| Feature | Jev | GPT-6 Astra |
|---|---|---|
| Output | Getypte Entscheidungen (Choice, Score, Noul) mit Wahrscheinlichkeiten; kein Text | Generierter Text; strukturierte Outputs und Function Calling unterstützt |
| Typ- oder Schemafehler | 0% konstruktionsbedingt | Möglich; 4,2% im internen Halluzinations-Benchmark von OpenAI |
| Input | Text, JSON-Objekte, Arrays; keine Bilder | Text und Bilder |
| Kontextfenster | Nicht in TypeSafes Doku angegeben; 32.000 Token laut OpenRouter- und Vercel-AI-Gateway-Listings | 1.050.000 Token; 128.000 max. Output |
| End-to-End-Latenz | 70 bis 500 ms pro Aufruf (vom Anbieter gemeldet) | Minuten bei Agentenaufgaben; etwa 40 Minuten pro OSWorld-2.0-Aufgabe |
| Entscheidungsgenauigkeit | 67,8% Übereinstimmung mit einer Astra- + Fable-5.1-Referenz in TypeSafes 4-Workflow-Eval | Ist die Referenz; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Agenten und Tools | Keine; eine Entscheidung in deinem Code | Computerbedienung, gehostete Shell, Websuche, Code Interpreter; 72,6% OSWorld 2.0 |
| Confidence | Kalibrierte Wahrscheinlichkeit bei jeder Antwort plus abgeleiteter Confidence Score | Nicht als Feld exponiert |
| Preis pro 1 Mio. Token | $0,042 Input; Output kostenlos | $10 Input; $50 Output |
| Verfügbarkeit | Early Access über TypeSafe API, OpenRouter, Vercel AI Gateway | ChatGPT-Bezahlstufen, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev kann keinen ungültigen Wert erzeugen, Astra schon. Dieser eine Fakt erklärt, warum beide in unterschiedlichen Schichten eines Systems landen statt im selben Slot.
Ein Jev-Request ist ein Block aus Zustand plus eine Map getypter Fragen:
Der Antwortraum ist vor der Inferenz fixiert, daher ist das Schema garantiert passend; TypeSafe setzt seine Fehlerquote bei strukturiertem Output und Tool Calls mit 0% an und nennt die Zahl nicht-empirisch.
Astra ist ein klassisches LLM und gibt Text zurück. Zwar unterstützt es strukturierte Outputs und Function Calling und reduziert die Fehlerrate von Sol auf etwa ein Drittel im internen Halluzinations-Benchmark von OpenAI, doch der Output muss weiterhin geparst und validiert werden. TypeSafes Chart verortet die Fehlerquote für strukturierten Output bei Frontier-LLMs zwischen 0,58% und 45,5%; Astras eigener Wert ist nicht veröffentlicht, daher würde ich nicht annehmen, dass er am unteren Ende liegt.
Der Preis für Jevs Garantie ist, dass du keine Begründung bekommst, nur eine Wahrscheinlichkeit: perfekt für eine Routing-Schicht, nicht für eine Compliance-Prüfung. Plane also, Fälle mit niedriger Confidence an ein Modell zu eskalieren, das schreiben kann.
Zwei Vorbehalte zu den Zuverlässigkeitszahlen:
Für Output, der beim ersten Versuch parsebar sein muss, gewinnt Jevs Vertrag; für alles, was jemand liest, kann nur Astra antworten.
Astra ist genauer. In TypeSafes vier Produktiv-Workflows (Incident Response, Agent-Trace-Observability, Rechnungsverarbeitung, Kundenservice) stimmt Jev zu 67,8% mit dem Durchschnitt aus Astra und Claude Fable 5.1 überein, gleichauf mit GPT-5.6 Terra und 5 bis 6 Punkte hinter GPT-5.6 Sol und Claude Opus 5.
Astra ist dort die Referenz und hat daher keine eigene Übereinstimmungsrate. In seinen eigenen Benchmarks saturiert es FrontierMath Tier 4, GPQA Diamond und ARC-AGI-3 — letzteres jedoch in einem zustandsbehafteten Harness. Jev begründet, plant oder erklärt nicht über mehrere Turns, und die Bewertung nach Übereinstimmung mit LLMs statt Ground Truth, wie TypeSafe es tut, birgt das Risiko, die Verzerrungen der Referenzmodelle zu erben.
Wenn maximale Genauigkeit bei einer Entscheidung mit geringem Volumen entscheidend ist, gewinnt weiterhin das LLM.
Jev antwortet laut TypeSafe in 70 bis 500 Millisekunden End-to-End, verglichen mit 3 bis 329 Sekunden für Frontier-LLMs bei derselben Anfrageart. Es sampelt alle Antworten parallel statt Token für Token und akzeptiert bis zu 255 Optionen pro Choice.
Astra ist für das, was es ist, schnell: rund 47% weniger Zeit pro OSWorld-2.0-Aufgabe als Sol, und der Fast-Modus liefert bis zu 2× Speed zum 2× Preis. Diese Aufgaben dauern dennoch Dutzende Minuten. Der Doom-Bot eines TypeSafe-Ingenieurs fährt 10 Queries pro Sekunde für rund $7 pro Stunde — ein Budget, das kein Frontier-LLM erreicht.
Für einen Decision-Request-Path mit 100-ms-Budget ist hier nur Jev ein Kandidat.
Astra kann alles, was Jev nicht kann:
Jev nimmt Text, JSON oder Text-Arrays entgegen, keine Bilder, und ruft keine Tools auf. Es ist die fuzzy If-Anweisung innerhalb eines Workflows, den dein Code steuert: klassifizieren, routen, scoren, extrahieren oder die Ausgabe eines anderen Modells verifizieren — inklusive Jailbreak-Erkennung bei LLM-Prompts.
Astra gewinnt diese Dimension klar, weil Jev darin nicht antritt.
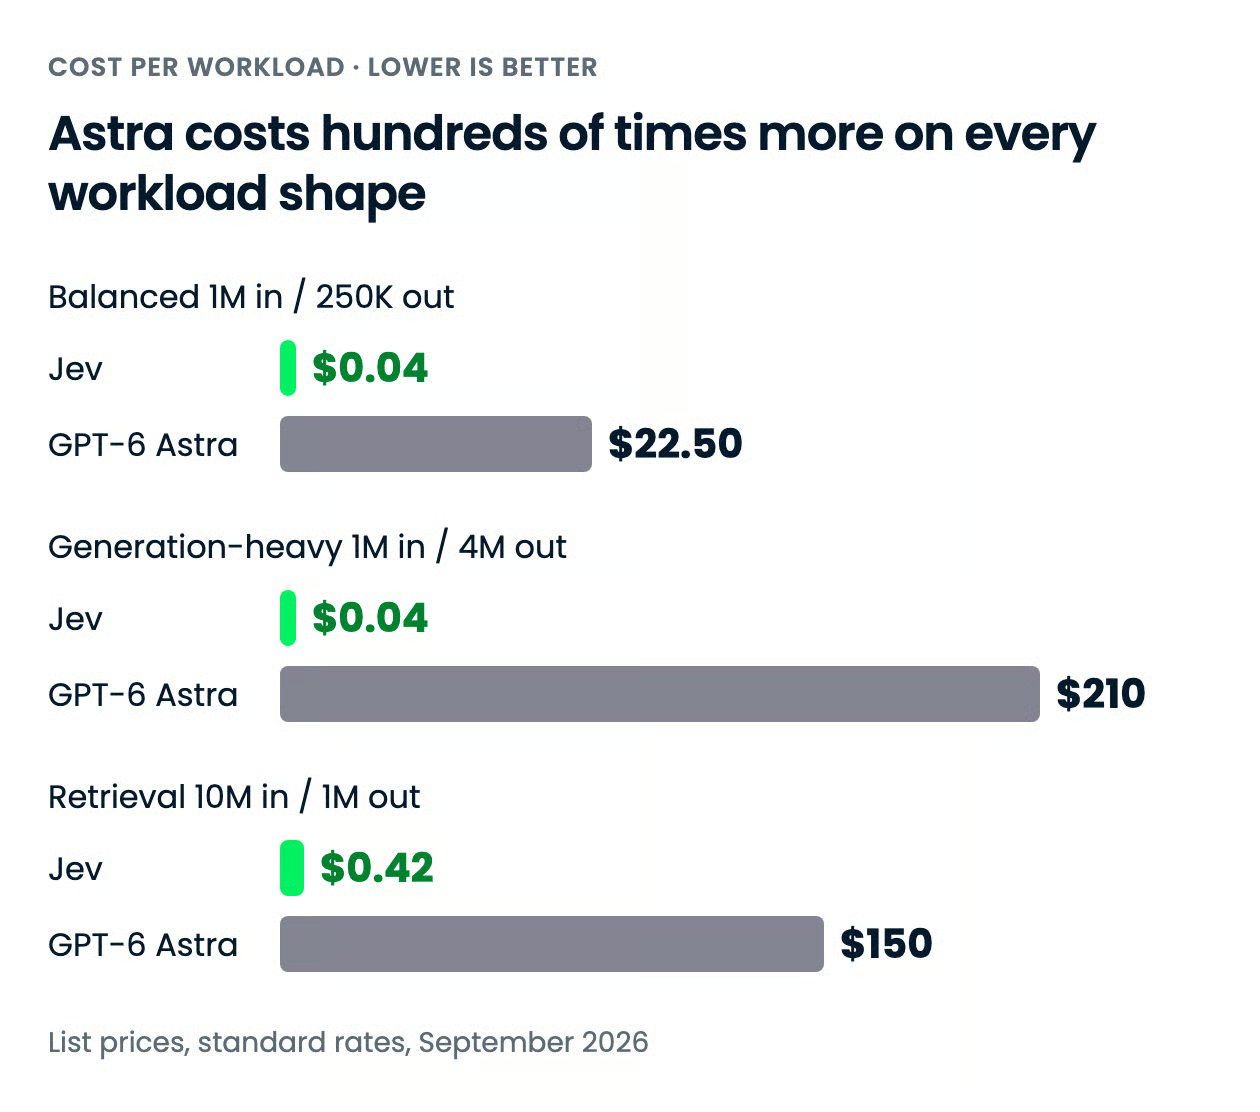
Astra kostet in jeder Workload-Form mehrere Hundert Mal mehr als Jev, und die Lücke wird umso größer, je mehr Output die Aufgabe erzeugt, weil Jev Output gar nicht berechnet.
| Rate | Jev | GPT-6 Astra |
|---|---|---|
| Input, pro 1 Mio. Token | $0,042 | $10,00 |
| Output, pro 1 Mio. Token | Kostenlos | $50,00 |
| Gecachter Input-Read, pro 1 Mio. Token | Nicht veröffentlicht | $1,00 |
| Cache-Write, pro 1 Mio. Token | Nicht veröffentlicht | $12,50 |
| Batch-Rabatt | Nicht veröffentlicht | 50% (Batch und Flex) |
| Long-Context-Zuschlag | Nicht veröffentlicht | 2× Input und Cache, 1,5× Output ab 272K Input-Token |
| Fast Mode | Nicht anwendbar | 2× der jeweils geltenden Raten |
| Consumer-Tier | Nicht anwendbar; nur API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro auf Pro und höher) |
Die Form der Differenz ist so wichtig wie die Höhe. Astras Output-Rate ist 5× der Input-Rate, und Reasoning-Token werden als Output berechnet — denken- oder textlastige Arbeit lässt die Rechnung am schnellsten wachsen. Jev berechnet nur Input, und eine typische Antwort sind ein paar Dutzend Output-Token, daher hängen die Kosten allein vom Umfang des übermittelten Zustands ab.
TypeSafe ist offen, dass es nicht beweisen kann, dass die Preise nicht subventioniert sind, und erwartet eher sinkende als steigende Preise.
| Workload | Jev | GPT-6 Astra | Differenz |
|---|---|---|---|
| Ausgewogener Assistant: 1 Mio. in / 250K out | $0,04 | $22,50 | $22,46, Jev 99,8% günstiger |
| Generierungsstark: 1 Mio. in / 4 Mio. out | $0,04 | $210 | $209,96, Jev 99,98% günstiger |
| Retrieval, unter Schwelle: 10 Mio. in / 1 Mio. out | $0,42 | $150 | $149,58, Jev 99,7% günstiger |
Die Formel lautet (Volumen ÷ 1 Mio.) × Rate, summiert über Input und Output zu Standardraten. Die generierungsstarke Zeile ist der Ausreißer, weil Jevs Output kostenlos ist — zugleich aber die am wenigsten realistische für Jev: Das Modell gibt niemals 4 Mio. Output-Token aus, lies sie daher als Effekt nur des Output-Aufschlags bei Astra. Die Retrieval-Zeile entspricht Jevs realem Einsatz: viel Zustand rein, ein paar Wahrscheinlichkeiten raus — und dennoch 357× Abstand.
Es gibt keine Über-Schwellen-Retrieval-Zeile, weil TypeSafes Doku keinen Long-Context-Zuschlag nennt und das Kontextfenster, das die Router für Jev listen, weit unter Astras Schwelle liegt — daher gibt es bei Astras 2× Input- und 1,5× Output-Multiplikatoren nichts direkt zu vergleichen. Keiner der Anbieter hat Token-Zählungen für eine gemeinsame Workload veröffentlicht, und Jevs Tokenizer ist nicht dokumentiert. Betrachte diese Summen daher als Ratenvergleich, nicht als Rechnung.
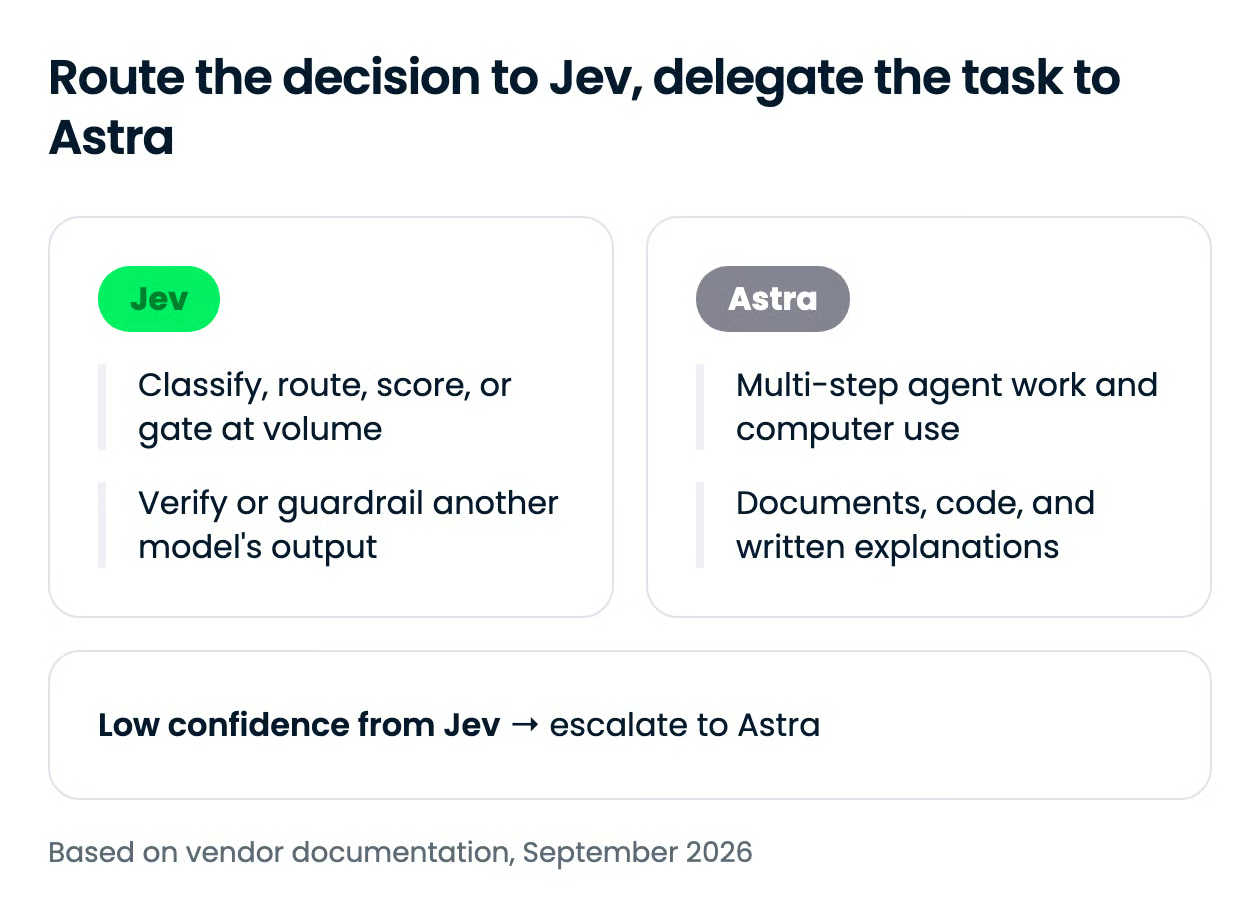
Die Gabelung hängt nicht für sich allein an Genauigkeit oder Preis, sondern daran, ob der Schritt in einer Entscheidung oder in einem Artefakt endet. Eine Entscheidung gehört zu Jev; alles, was jemand liest, ausführt oder öffnet, gehört zu Astra.
Reichweite ist die ungleichste Dimension in diesem Artikel: Astra ist überall, wo OpenAI-Modelle üblich sind, und Jev ist eine per Warteliste gated API, deren einzige Wege ohne Einladung die Listings bei OpenRouter und dem Vercel AI Gateway sind.
| Surface | Jev | GPT-6 Astra |
|---|---|---|
| Consumer-App | Keine; nur Developer Console | ChatGPT Plus, Pro, Business und Enterprise; zum Launch standardmäßig deaktiviert für Enterprise-Workspaces |
| First-Party-API | TypeSafe API, Early Access nur über Warteliste; kein Self-Serve-Signup | OpenAI API (Responses und Chat Completions), Rollout über die Tage nach dem Launch |
| Cloud-Plattformen | Keine | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Coding-Agenten | Nicht anwendbar; erzeugt weder Text noch Tool Calls | Codex, GitHub Copilot; Stand 21. September 2026 nicht in der Cursor-Doku gelistet |
| Third-Party-Router | OpenRouter (typesafe/jev-1.13, über einen dedizierten systemone-Endpoint), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| API Model ID | jev-latest (Alias für jev-1.13.0) |
gpt-6-astra |
Die Model-IDs sind jev-latest, worauf TypeSafes SDKs standardmäßig zeigen und das aktuell auf jev-1.13.0 auflöst, sowie gpt-6-astra. TypeSafe empfiehlt, die versionierte ID zu pinnen, wenn du Confidence-Schwellen getunt hast, da sich der Alias bei neuen Releases bewegt. Jevs Rate Limits liegen bei 250.000 Token pro Sekunde und 1.200 Requests pro Minute; TypeSafe sagt, beide können sich während des Skalierens ohne Vorankündigung ändern.
Das ist kein One-String-Swap. Astra nimmt einen Prompt und liefert Text über die Responses API; Jev nimmt Zustand und eine Map getypter Fragen über einen einzigen Endpoint entgegen und liefert Wahrscheinlichkeiten. Die beiden Blöcke unten stellen dieselbe Retouren-Anfrage an jedes Modell, damit du den Formunterschied siehst.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidenceFür das vollständige Astra-Setup inklusive asynchroner Tools und Steuerung während des Turns folge unserem GPT-6-Astra-API-Tutorial; für strukturiertes JSON aus OpenAI-Modellen siehe unser Tutorial zu strukturierten Outputs.
Endet der Schritt in einer Entscheidung, auf die dein Code reagiert, nimm Jev; endet er in etwas, das eine Person liest oder ausführt, nimm GPT-6 Astra. Die Architektur, die dieser Launch nahelegt, ist beides zugleich: Jev als günstiger, kalibrierter Router vorne, Astra als Spezialist, an den eskaliert wird, wenn die Confidence fällt.
Aufschlussreich finde ich, dass TypeSafe Jev gegen Astras Antworten bewertet. OpenAI setzt das Zeichen, dass die Frontier autonome Ausführung ist; TypeSafe wettet, dass das meiste, was Software ein Modell fragt, eine begrenzte Frage in Verkleidung ist. Die offene Frage für Jev ist, ob ein unabhängiger Benchmark die Parität bestätigt und ob die Preise die Subvention überstehen.
Um die Entscheidungsschicht zu bauen, in der beide Modelle sitzen, empfehle ich unseren Kurs Developing AI Systems with the OpenAI API und unseren Lernpfad AI Agent Fundamentals.
Lerne AI Engineering mit DataCamp!
Kurs
Lernpfad
Kurs