courses
OpenAI API로 AI 시스템 개발하기
3
22.8K
TypeSafe는 2026년 9월 15일, Jev라는 모델과 함께 스텔스 모드에서 공개로 전환했습니다. Jev는 이들이 System One 모델이라고 부르는 것으로, 프로그램 상태와 타입이 지정된 질문을 보내면 텍스트 대신 보정된 확률과 함께 결정을 반환합니다. 그보다 12일 앞서 OpenAI는 GPT-6 Astra를 출시했는데, 컴퓨터 사용, 코딩, 전문 업무를 처음부터 끝까지 수행하도록 설계된 가장 지능적이고 정렬된 모델이라고 소개했습니다.
이 글에서는 Jev와 GPT-6 Astra를 출력 신뢰성, 결정 정확도, 속도, 에이전트 범위, 가격 측면에서 비교한 뒤, 소프트웨어 파이프라인에서 어떤 호출을 어떤 모델에 맡겨야 하는지 정리합니다.
Jev는 TypeSafe AI가 2026년 9월 초기 접근(early access)으로 공개한 호스팅형 결정 모델로, 이들이 말하는 System One 모델의 첫 번째입니다.
핵심 강점은 텍스트 생성을 포기했다는 점입니다. 답변 공간을 미리 Choice, Score, 또는 Noul(예/아니오) 질문으로 정의하면, 소프트웨어가 바로 분기할 수 있는 타입 값과 보정된 확률을 반환합니다. 우리의 Jev 가이드에는 출시 내용과 TypeSafe의 평가 결과가 정리되어 있습니다.
GPT-6 Astra는 OpenAI의 플래그십 프론티어 모델로, 2026년 9월 3일 GPT-5.6 Sol의 후속작으로 공개되었습니다.
포지셔닝은 자율 실행입니다. OpenAI는 이를 세계 최고 수준의 컴퓨터 사용 모델이자 가장 정렬된 모델이라고 소개하며, 양식 작성, CRM 업데이트, 웹사이트 구축 및 QA, 템플릿을 따르는 문서 제작까지 수행하도록 훈련했다고 말합니다. 우리의 GPT-6 Astra 가이드에서 출시를 다루고, GPT-6 Astra API 튜토리얼에서는 비동기 도구로 릴리스 체크 에이전트를 구축합니다.
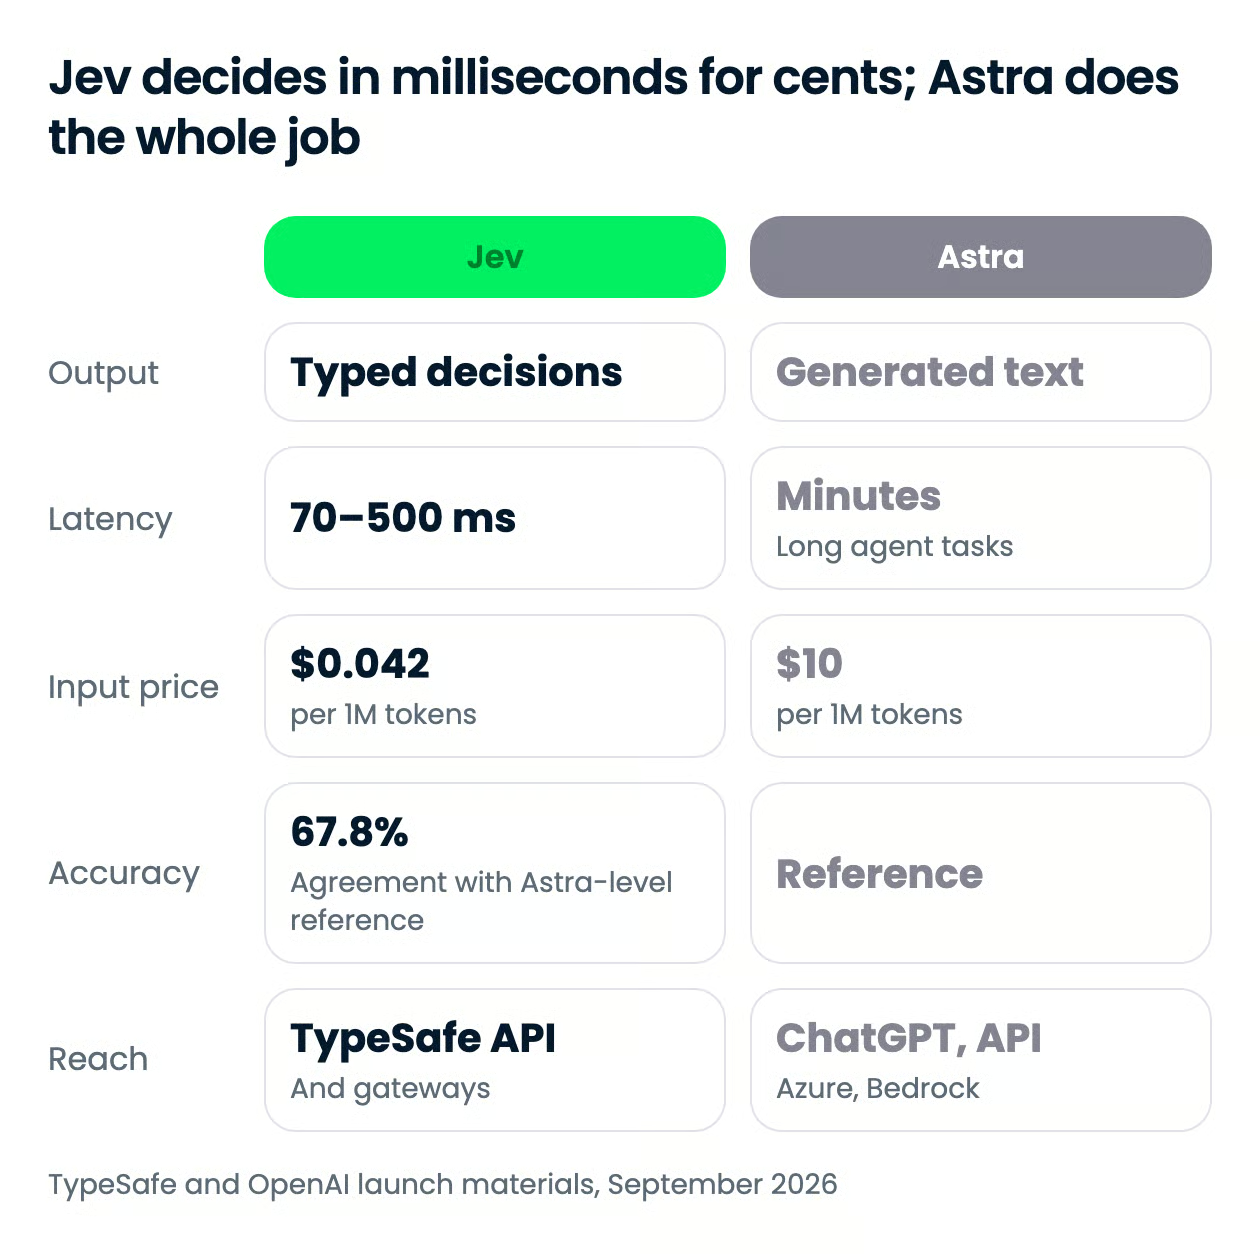
두 모델은 하나의 트레이드오프 양끝에 있습니다. Jev는 텍스트 생성을 거부함으로써 속도, 가격, 타입 안전성을 확보하고, Astra는 모든 것을 생성함으로써 폭과 깊이를 확보합니다. 아래 대부분의 항목은 이 단 하나의 설계 선택에서 파생됩니다.
| 기능 | Jev | GPT-6 Astra |
|---|---|---|
| 출력 | 확률을 포함한 타입 결정(Choice, Score, Noul); 텍스트 없음 | 생성 텍스트; 구조화 출력과 함수 호출 지원 |
| 타입/스키마 오류 | 설계상 0% | 가능; OpenAI 내부 환각 벤치마크에서 4.2% |
| 입력 | 텍스트, JSON 객체, 배열; 이미지 불가 | 텍스트와 이미지 |
| 컨텍스트 윈도우 | TypeSafe 문서에 명시 없음; OpenRouter 및 Vercel AI Gateway 목록에는 32,000 토큰 | 1,050,000 토큰; 최대 출력 128,000 |
| 엔드 투 엔드 지연 | 호출당 70~500ms(벤더 보고) | 에이전트 작업 기준 분 단위; OSWorld 2.0 작업당 약 40분 |
| 결정 정확도 | TypeSafe의 4개 워크플로 평가에서 Astra + Fable 5.1 기준과 67.8% 일치 | 자체가 기준; GPQA Diamond 96.0%, FrontierMath Tier 4 97.6% |
| 에이전트/도구 | 없음; 코드 내부의 결정 | 컴퓨터 사용, 호스팅 셸, 웹 검색, 코드 인터프리터; OSWorld 2.0에서 72.6% |
| 신뢰도 | 모든 답에 보정된 확률과 파생 신뢰 점수 제공 | 필드로 노출되지 않음 |
| 100만 토큰당 가격 | 입력 $0.042; 출력 무료 | 입력 $10; 출력 $50 |
| 가용성 | TypeSafe API, OpenRouter, Vercel AI Gateway를 통한 초기 접근 | ChatGPT 유료 등급, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev는 잘못된 값을 만들 수 없고, Astra는 그럴 수 있습니다. 이 단일 사실 때문에 두 모델은 같은 슬롯이 아니라 시스템의 서로 다른 레이어에 자리하게 됩니다.
Jev 요청은 상태 블록과 타입이 지정된 질문 맵으로 구성됩니다.
추론 전 답변 공간이 고정되므로 스키마 매칭이 보장됩니다. TypeSafe는 구조화 출력 및 도구 호출 오류율을 0%라고 하며, 이는 경험적 수치가 아니라고 덧붙입니다.
Astra는 전통적인 LLM으로 텍스트를 반환합니다. 구조화 출력과 함수 호출을 지원하고, 내부 환각 벤치마크에서 Sol의 오류율을 3분의 1 수준으로 낮췄지만, 출력은 여전히 파싱과 검증이 필요합니다. TypeSafe의 차트는 프론티어 LLM의 구조화 출력 오류를 0.58%에서 45.5% 사이로 제시합니다. Astra의 자체 수치는 공개되지 않았으므로, 낮은 쪽에 있다고 가정하진 않겠습니다.
Jev의 보장 대가는 근거가 아닌 확률만 제공한다는 점입니다. 라우팅 레이어에는 충분하지만 컴플라이언스 검토에는 부족하므로, 신뢰도가 낮은 사례는 글을 쓸 수 있는 모델로 승격시키는 계획이 필요합니다.
신뢰성 수치에 대한 두 가지 유의점:
첫 시도에 반드시 파싱되어야 하는 출력이라면 Jev의 계약이 우세합니다. 사람이 읽을 대상이라면 Astra만이 답할 수 있습니다.
Astra가 더 정확합니다. TypeSafe의 네 가지 프로덕션 워크플로(사고 대응, 에이전트 트레이스 가시성, 청구서 처리, 고객 서비스)에서, Jev는 Astra와 Claude Fable 5.1 평균 답과 67.8% 일치하며, GPT-5.6 Terra와 비슷하고 GPT-5.6 Sol 및 Claude Opus 5보다 5~6포인트 낮습니다.
거기서 Astra는 기준이므로 자체 일치 점수는 없습니다. 자체 벤치마크에서는 FrontierMath Tier 4, GPQA Diamond, ARC-AGI-3를 포화에 가깝게 달성하지만, 마지막 항목은 상태풀 하니스에 의존합니다. Jev는 턴을 넘나드는 추론, 계획, 설명을 하지 않으며, TypeSafe처럼 LLM과의 일치로 채점할 경우 기준 모델의 편향을 상속할 위험이 있습니다.
저빈도 결정에서 정점의 정확도가 필요하다면, LLM이 여전히 우위입니다.
TypeSafe의 측정에 따르면 Jev는 엔드 투 엔드 70~500밀리초 내에 응답합니다. 같은 유형의 쿼리에서 프론티어 LLM은 3~329초가 걸립니다. Jev는 토큰을 하나씩 생성하지 않고 모든 답을 병렬 샘플링하며, Choice당 최대 255개 옵션을 받습니다.
Astra는 그 자체 기준으로는 빠릅니다. OSWorld 2.0 작업당 소요 시간이 Sol 대비 약 47% 감소했고, Fast 모드는 가격 2배에 속도 최대 2배를 제공합니다. 그래도 해당 작업은 수십 분이 걸립니다. TypeSafe 엔지니어의 Doom 봇은 시간당 약 $7 비용으로 초당 10개 쿼리를 처리하며, 이는 어떤 프론티어 LLM도 맞추기 어려운 예산입니다.
지연 예산이 100ms인 결정 요청 경로라면, 여기서는 Jev만이 후보입니다.
Astra는 Jev가 하지 않는 모든 것을 수행합니다.
Jev는 텍스트, JSON, 또는 텍스트 배열을 입력으로 받고(이미지 불가), 도구를 호출하지 않습니다. 이는 워크플로 내부의 퍼지 if 문과 같아서, 분류, 라우팅, 스코어링, 추출, 다른 모델 출력의 검증(LLM 프롬프트 탈옥 감지 포함)에 사용됩니다.
이 차원에서는 Jev가 출전하지 않았으므로 Astra의 완승입니다.
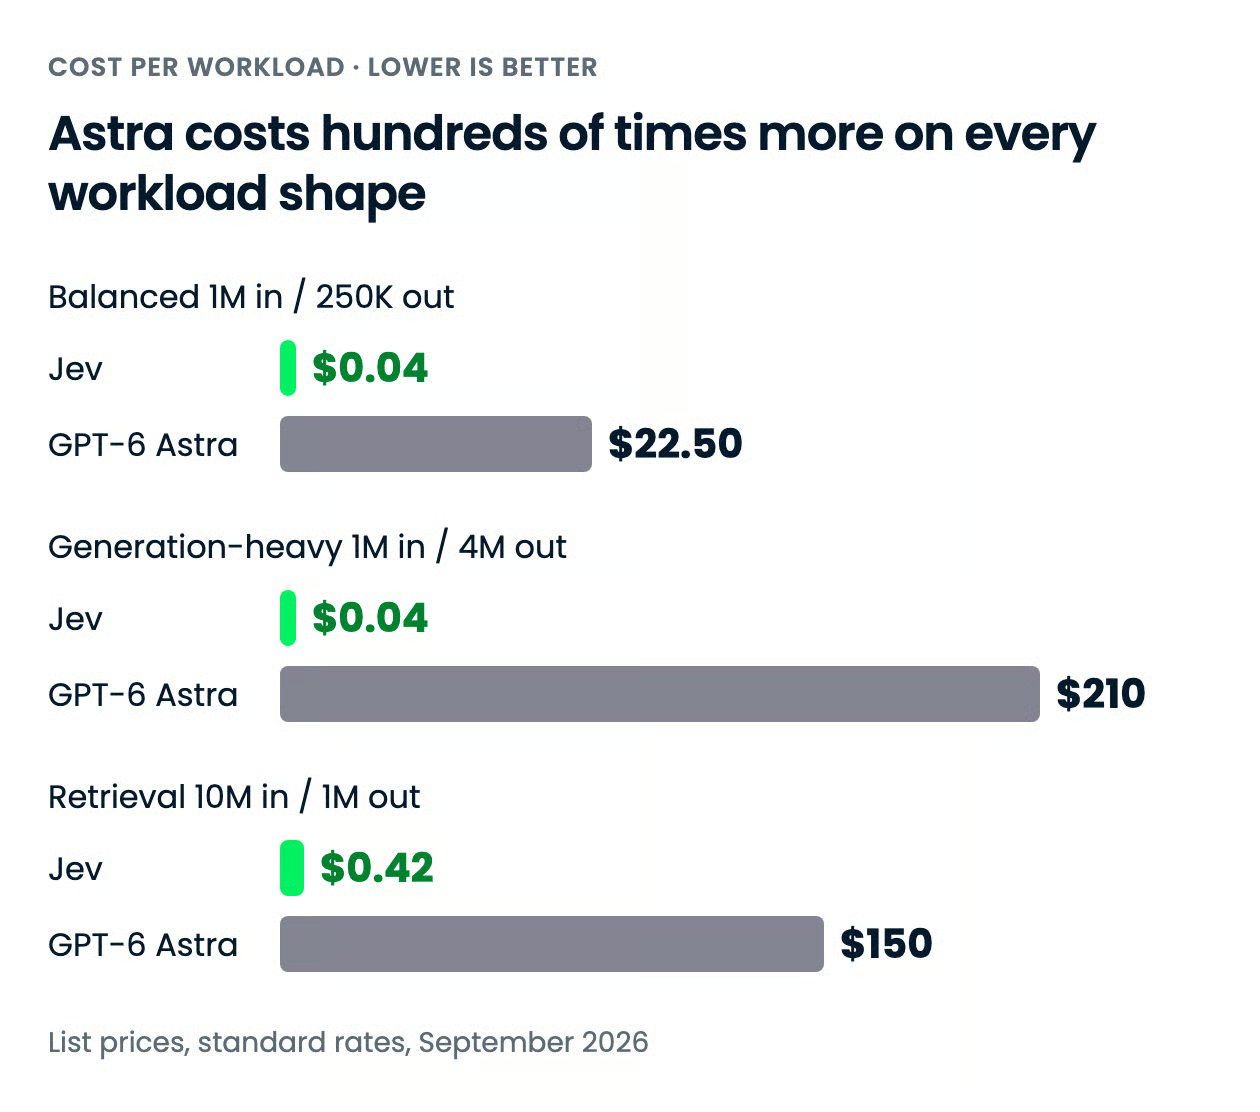
Astra는 어떤 작업 형태에서도 Jev보다 수백 배 비싸며, 작업이 더 많은 출력을 생성할수록 격차가 커집니다. Jev는 출력 비용을 청구하지 않기 때문입니다.
| 단가 | Jev | GPT-6 Astra |
|---|---|---|
| 입력, 100만 토큰당 | $0.042 | $10.00 |
| 출력, 100만 토큰당 | 무료 | $50.00 |
| 캐시된 입력 읽기, 100만 토큰당 | 미공개 | $1.00 |
| 캐시 쓰기, 100만 토큰당 | 미공개 | $12.50 |
| 배치 할인 | 미공개 | 50%(Batch 및 Flex) |
| 장문 컨텍스트 할증 | 미공개 | 입력·캐시 2배, 출력 1.5배(272K 입력 토큰 초과 시) |
| Fast 모드 | 해당 없음 | 해당 요율의 2배 |
| 컨슈머 티어 | 해당 없음; API 전용 | ChatGPT Plus, Pro, Business, Enterprise(Pro 이상에서 Astra Pro) |
격차의 크기만큼이나 모양도 중요합니다. Astra의 출력 단가는 입력의 5배이며, 추론 토큰은 출력으로 과금됩니다. 따라서 사고가 길거나 장황한 작업일수록 비용이 가장 빨리 늘어납니다. Jev는 입력만 과금하고, 전형적인 답변은 수십 개의 출력 토큰에 불과하므로, 비용은 전적으로 보낸 상태의 크기에 의해 결정됩니다.
TypeSafe는 가격이 보조금이 아님을 증명할 수 없다고 솔직히 밝히며, 상승보다는 하락을 예상합니다.
| 워크로드 | Jev | GPT-6 Astra | 차이 |
|---|---|---|---|
| 균형형 어시스턴트: 입력 100만 / 출력 25만 | $0.04 | $22.50 | $22.46, Jev 99.8% 저렴 |
| 생성 편중: 입력 100만 / 출력 400만 | $0.04 | $210 | $209.96, Jev 99.98% 저렴 |
| 검색, 임계 미만: 입력 1천만 / 출력 100만 | $0.42 | $150 | $149.58, Jev 99.7% 저렴 |
계산식은 (물량 ÷ 100만) × 단가를 입력과 출력에 각각 적용해 합산한 것입니다. 생성 편중 행이 특이한 이유는 Jev의 출력이 무료이기 때문이며, Jev에는 비현실적인 행이기도 합니다. Jev는 400만 출력 토큰을 내보내지 않으므로, 이는 출력 프리미엄이 Astra에 미치는 영향만을 보여주는 것으로 보시면 됩니다. 검색 행은 Jev의 실제 사용 형태—상태를 많이 넣고 소수의 확률을 받는 방식—와 일치하며, 그 경우에도 격차는 357배입니다.
임계 초과 검색 행은 없습니다. TypeSafe 문서에는 장문 컨텍스트 할증이 명시되지 않았고, 라우터가 표기한 Jev의 컨텍스트 창은 Astra 임계치보다 훨씬 작기 때문입니다. 따라서 Astra의 입력 2배/출력 1.5배 할증과 비교할 항목이 없습니다. 두 벤더 모두 공통 워크로드에 대한 토큰 수를 공개하지 않았고, Jev의 토크나이저도 문서화되지 않았으므로, 이 총액은 청구서가 아닌 단가 비교로 보시기 바랍니다.
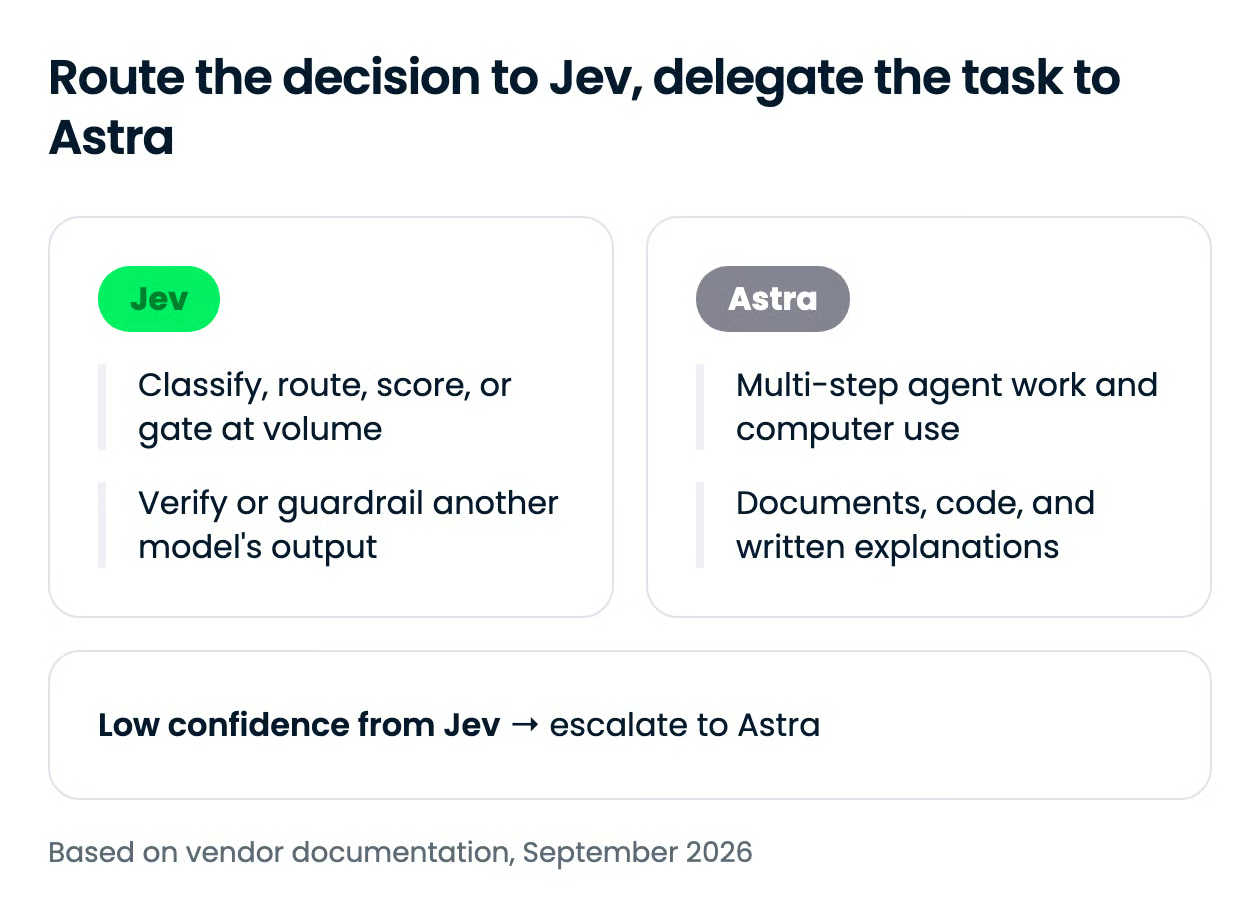
갈림길은 정확도나 가격 자체가 아니라, 그 단계가 결정으로 끝나는지 산출물로 끝나는지입니다. 결정은 Jev의 영역이고, 누군가가 읽거나 실행하거나 열어볼 산출물은 Astra의 영역입니다.
도달성은 이 글에서 가장 불균형한 차원입니다. Astra는 OpenAI 모델이 보통 있는 곳에 거의 모두 존재하는 반면, Jev는 대기명단으로 제한된 API이며 초대 없이 접근 가능한 경로는 OpenRouter와 Vercel AI Gateway 목록뿐입니다.
| 채널 | Jev | GPT-6 Astra |
|---|---|---|
| 소비자 앱 | 없음; 개발자 콘솔 전용 | ChatGPT Plus, Pro, Business, Enterprise; 출시 시 Enterprise 워크스페이스에서는 기본 비활성 |
| 1인자 API | TypeSafe API, 대기명단 기반 초기 접근만; 셀프 서브 가입 없음 | OpenAI API(Responses 및 Chat Completions), 출시 후 며칠에 걸쳐 롤아웃 |
| 클라우드 플랫폼 | 없음 | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| 코딩 에이전트 | 해당 없음; 텍스트나 도구 호출 없음 | Codex, GitHub Copilot; 2026년 9월 21일 기준 Cursor 문서에는 미기재 |
| 서드파티 라우터 | OpenRouter(typesafe/jev-1.13, 전용 systemone 엔드포인트 경유), Vercel AI Gateway(typesafe-ai/jev) |
OpenRouter(openai/gpt-6-astra) |
| API 모델 ID | jev-latest(jev-1.13.0의 별칭) |
gpt-6-astra |
모델 ID는 jev-latest(TypeSafe SDK의 기본이며 현재는 jev-1.13.0으로 해석됨)와 gpt-6-astra입니다. TypeSafe는 신뢰 임계값을 조정해 두었다면 버전 고정 ID를 권장합니다. 별칭은 새 버전이 출시되면 움직이기 때문입니다. Jev의 레이트 리밋은 초당 250,000 토큰, 분당 1,200 요청이며, 확장 과정에서 예고 없이 변경될 수 있다고 TypeSafe는 밝힙니다.
두 모델은 한 줄 교체로 대체되지 않습니다. Astra는 프롬프트를 받아 Responses API를 통해 텍스트를 반환합니다. Jev는 단일 엔드포인트에서 상태와 타입이 지정된 질문 맵을 받아 확률을 반환합니다. 아래 두 블록은 동일한 반품 요청을 각 모델에 보내며, 형태 차이를 보여줍니다.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidence전체 Astra 설정(비동기 도구 및 턴 중 조정 포함)은 우리의 GPT-6 Astra API 튜토리얼을, OpenAI 모델에서 구조화 JSON을 받는 법은 구조화 출력 튜토리얼을 참고하세요.
단계가 코드가 행동할 결정으로 끝나면 Jev를, 사람이 읽거나 실행할 결과물로 끝나면 GPT-6 Astra를 쓰세요. 이번 출시가 시사하는 아키텍처는 둘을 함께 쓰는 것입니다. 앞단에서 Jev가 저렴하고 보정된 라우터 역할을 하고, 신뢰가 떨어지면 Astra로 승격합니다.
가장 상징적인 점은 TypeSafe가 Jev를 Astra의 답에 맞춰 평가한다는 것입니다. OpenAI는 프론티어가 자율 실행이라는 메시지를 전하고, TypeSafe는 소프트웨어가 모델에 요구하는 것의 대부분이 경계가 있는 질문이라고 베팅합니다. Jev의 개방형 과제는 독립 벤치마크가 동등성을 확인하는지, 그리고 가격이 보조금 없이 지속 가능한지입니다.
두 모델이 자리 잡는 결정 레이어를 구축하려면, 우리의 Developing AI Systems with the OpenAI API 강의와 AI Agent Fundamentals 트랙을 추천합니다.
DataCamp으로 AI 엔지니어링을 배우세요!
courses
tracks
courses