
Curso
Desenvolvimento de sistemas de IA com a API OpenAI
3 h
22.8K
A TypeSafe saiu do modo stealth em 15 de setembro de 2026 com o Jev, um modelo que ela chama de System One: você envia o estado do programa e perguntas tipadas, e ele retorna decisões com probabilidades calibradas em vez de texto. Doze dias antes, a OpenAI lançou o GPT-6 Astra, descrito como seu modelo mais inteligente e alinhado, feito para uso em computador, código e trabalho profissional de ponta a ponta.
Neste artigo, vou comparar Jev e GPT-6 Astra em confiabilidade do output, acurácia de decisão, velocidade, escopo agentic e preços, e depois indicar quais chamadas em um pipeline de software pertencem a qual modelo.
Jev é um modelo de decisão hospedado que a TypeSafe AI lançou em early access em setembro de 2026, o primeiro do que chama de modelos System One.
Seu diferencial é abrir mão da geração de texto: você define o espaço de resposta antecipadamente como perguntas de Choice, Score ou Noul (sim/não), e ele retorna valores tipados com probabilidades calibradas que o software pode usar diretamente para ramificar. Nosso guia do Jev cobre o lançamento e as alegações de avaliação da TypeSafe.
GPT-6 Astra é o flagship de fronteira da OpenAI, lançado em 3 de setembro de 2026 como sucessor do GPT-5.6 Sol.
Seu posicionamento é execução autônoma: a OpenAI o chama de o melhor modelo do mundo para uso de computador e o mais alinhado, treinado para preencher formulários, atualizar um CRM, construir e fazer QA de um site e produzir documentos que seguem seus templates. Nosso guia do GPT-6 Astra cobre o lançamento; nosso tutorial da API do GPT-6 Astra constrói um agente de verificação de releases com ferramentas assíncronas.
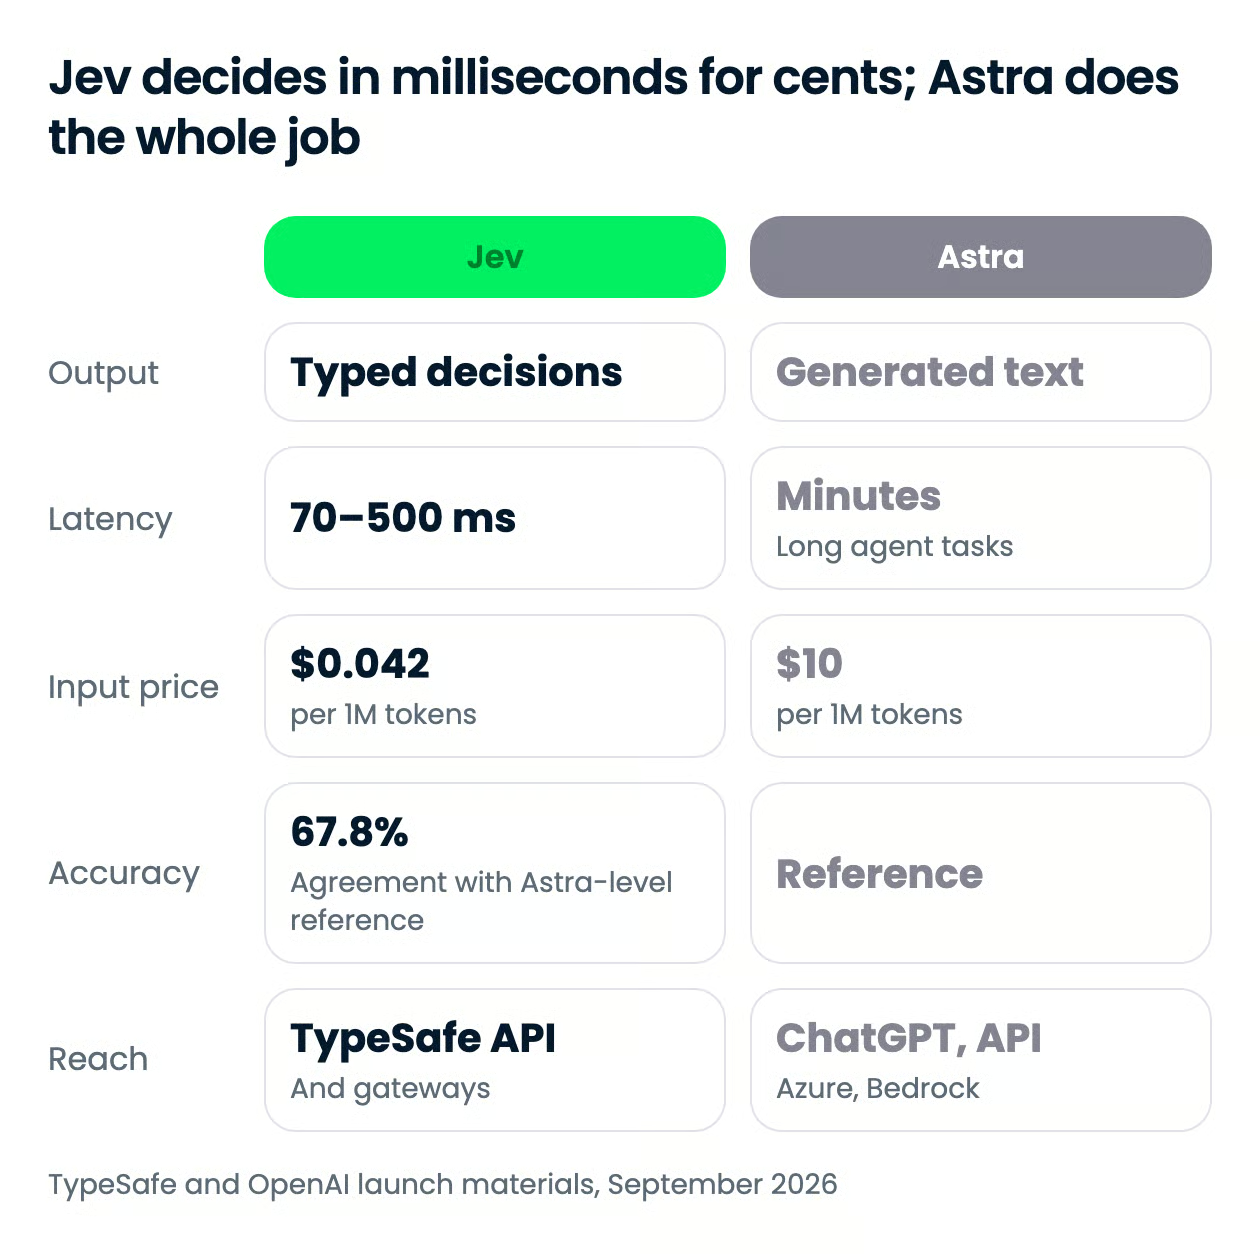
Os dois modelos ocupam extremos opostos de uma mesma troca: o Jev compra velocidade, preço e type safety ao se recusar a gerar texto, e o Astra compra amplitude e profundidade ao gerar tudo. A maioria das linhas abaixo decorre dessa única escolha de design.
| Recurso | Jev | GPT-6 Astra |
|---|---|---|
| Output | Decisões tipadas (Choice, Score, Noul) com probabilidades; sem texto | Texto gerado; outputs estruturados e function calling suportados |
| Erros de tipo ou schema | 0% por construção | Possíveis; 4,2% no benchmark interno de alucinação da OpenAI |
| Input | Texto, objetos JSON, arrays; sem imagens | Texto e imagens |
| Janela de contexto | Não informado na documentação da TypeSafe; 32.000 tokens nas listagens do OpenRouter e do Vercel AI Gateway | 1.050.000 tokens; 128.000 de saída máxima |
| Latência fim a fim | 70 a 500 ms por chamada (reportado pelo fornecedor) | Minutos em tarefas de agente; cerca de 40 minutos por tarefa do OSWorld 2.0 |
| Acurácia de decisão | 67,8% de concordância com uma referência Astra + Fable 5.1 no eval de 4 workflows da TypeSafe | É a referência; 96,0% no GPQA Diamond, 97,6% no FrontierMath Tier 4 |
| Agentes e ferramentas | Nenhum; uma decisão dentro do seu código | Uso de computador, shell hospedado, busca web, code interpreter; 72,6% no OSWorld 2.0 |
| Confiança | Probabilidade calibrada em cada resposta, além de um score de confiança derivado | Não exposta como campo |
| Preço por 1M tokens | US$ 0,042 de input; output gratuito | US$ 10 de input; US$ 50 de output |
| Disponibilidade | Early access via TypeSafe API, OpenRouter, Vercel AI Gateway | Planos pagos do ChatGPT, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
O Jev não pode produzir um valor inválido, e o Astra pode. Esse único fato explica por que os dois acabam em camadas diferentes de um sistema, e não no mesmo slot.
Uma requisição ao Jev é um bloco de estado mais um mapa de perguntas tipadas:
O espaço de resposta é fixado antes da inferência, então o casamento com o schema é garantido; a TypeSafe coloca sua taxa de erro de outputs estruturados e tool-calls em 0% e chama o número de não empírico.
O Astra representa um LLM clássico e retorna texto. Embora suporte outputs estruturados e function calling, e reduza a taxa de erro do Sol para cerca de um terço no benchmark interno de alucinação da OpenAI, o output ainda precisa ser parseado e validado. O gráfico da TypeSafe coloca o erro de output estruturado dos LLMs de fronteira entre 0,58% e 45,5%; o número específico do Astra não foi publicado, então eu não assumiria que esteja no piso.
O custo da garantia do Jev é que você não recebe uma justificativa, apenas uma probabilidade: ótimo para uma camada de roteamento, não para um revisor de compliance, então planeje escalar casos de baixa confiança para um modelo que saiba escrever.
Duas ressalvas sobre os números de confiabilidade:
Para outputs que precisam fazer parse de primeira, o contrato do Jev vence; para qualquer coisa que alguém vá ler, só o Astra responde.
O Astra é mais preciso. Nos quatro workflows de produção da TypeSafe (resposta a incidentes, observabilidade de traços de agentes, processamento de faturas, atendimento ao cliente), o Jev concorda com a média de Astra e Claude Fable 5.1 em 67,8% dos casos, empatado com o GPT-5.6 Terra e 5 a 6 pontos atrás do GPT-5.6 Sol e do Claude Opus 5.
O Astra é a referência ali, então não tem um score de concordância próprio. Em seus próprios benchmarks, ele satura o FrontierMath Tier 4, o GPQA Diamond e o ARC-AGI-3, embora o último dependa de um harness stateful. O Jev não raciocina em múltiplos turnos, não planeja nem explica, e avaliá-lo por concordância com LLMs em vez de ground truth, como a TypeSafe faz, corre o risco de herdar vieses dos modelos de referência.
Se você precisa de acurácia máxima em uma decisão de baixo volume, o LLM ainda vence.
O Jev responde em 70 a 500 milissegundos fim a fim, segundo medições da TypeSafe, contra 3 a 329 segundos para LLMs de fronteira no mesmo tipo de consulta. Ele amostra todas as respostas em paralelo, e não token a token, e aceita até 255 opções por Choice.
O Astra é rápido para o que se propõe: cerca de 47% menos tempo por tarefa do OSWorld 2.0 que o Sol, e o modo Fast entrega até 2x a velocidade por 2x o preço. Essas tarefas ainda levam dezenas de minutos. O bot de Doom de um engenheiro da TypeSafe roda 10 consultas por segundo por cerca de US$ 7 por hora, um orçamento que nenhum LLM de fronteira alcança.
Para um caminho de decisão com orçamento de 100 ms, o Jev é o único candidato aqui.
O Astra faz tudo que o Jev não faz:
O Jev recebe texto, JSON ou arrays de texto, não imagens, e não chama ferramentas. Ele é o if fuzzy dentro de um workflow que seu código controla: classificar, rotear, pontuar, extrair ou verificar o output de outro modelo, incluindo detecção de jailbreak em prompts de LLM.
O Astra vence essa dimensão porque o Jev nem entra nela.
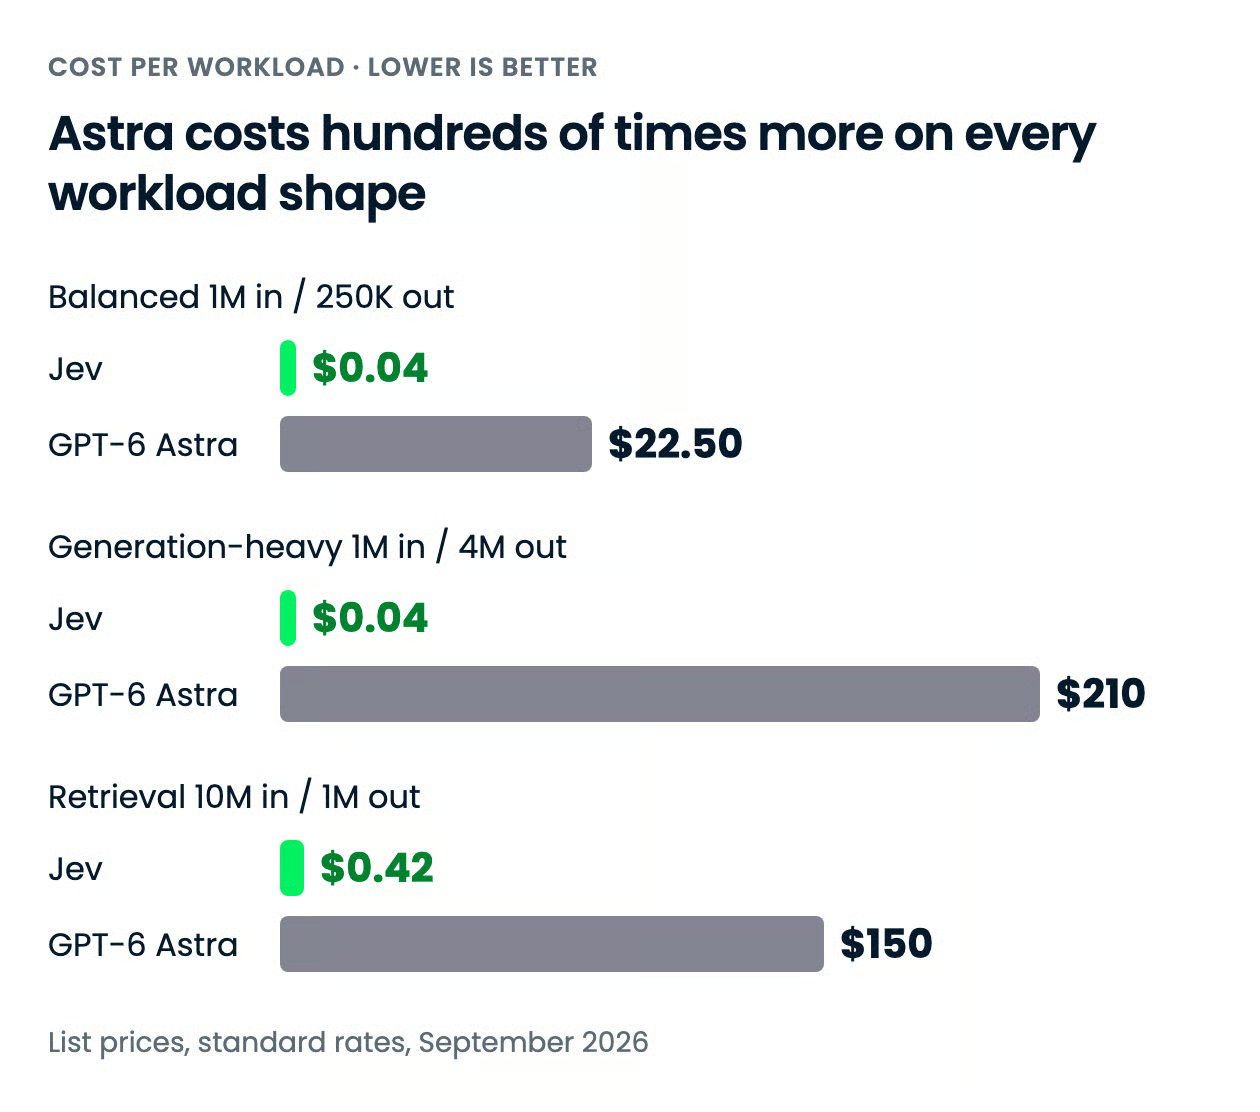
O Astra custa várias centenas de vezes mais que o Jev em qualquer formato de workload, e a diferença aumenta quanto mais output a tarefa produz, porque o Jev não cobra pelo output.
| Tarifa | Jev | GPT-6 Astra |
|---|---|---|
| Input, por 1M tokens | US$ 0,042 | US$ 10,00 |
| Output, por 1M tokens | Grátis | US$ 50,00 |
| Leitura de input em cache, por 1M tokens | Não publicado | US$ 1,00 |
| Gravação em cache, por 1M tokens | Não publicado | US$ 12,50 |
| Desconto em batch | Não publicado | 50% (Batch e Flex) |
| Adicional para contexto longo | Não publicado | 2x em input e cache, 1,5x em output, acima de 272K tokens de input |
| Modo Fast | Não aplicável | 2x as tarifas aplicáveis |
| Plano consumidor | Não aplicável; apenas API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro no Pro e acima) |
A forma da diferença importa tanto quanto o tamanho. A tarifa de output do Astra é 5x a de input, e seus tokens de raciocínio são cobrados como output, então trabalhos verbosos ou com muito raciocínio são onde a conta cresce mais rápido. O Jev cobra só o input, e uma resposta típica tem algumas dezenas de tokens de saída, então seu custo é função apenas do quanto de estado você envia e nada mais.
A TypeSafe é franca ao dizer que não pode provar que o preço não é subsidiado, e espera que ele caia, não suba.
| Workload | Jev | GPT-6 Astra | Diferença |
|---|---|---|---|
| Assistente balanceado: 1M in / 250K out | US$ 0,04 | US$ 22,50 | US$ 22,46, Jev 99,8% mais barato |
| Geração pesada: 1M in / 4M out | US$ 0,04 | US$ 210 | US$ 209,96, Jev 99,98% mais barato |
| Retrieval, abaixo do limiar: 10M in / 1M out | US$ 0,42 | US$ 150 | US$ 149,58, Jev 99,7% mais barato |
A fórmula é (volume ÷ 1M) × tarifa, somada entre input e output, nas taxas padrão. A linha de geração pesada é o outlier porque o output do Jev é grátis, embora também seja a menos realista para o Jev: o modelo nunca emite 4M tokens de saída, então leia-a como o efeito do prêmio de output do Astra. A linha de retrieval é a que mais combina com o uso real do Jev, muito estado de entrada e um punhado de probabilidades de saída, e ainda assim a diferença é de 357x.
Não há linha de retrieval acima do limiar porque a documentação da TypeSafe não indica adicional por contexto longo, e a janela de contexto listada pelos roteadores para o Jev fica bem abaixo do limiar do Astra, então os multiplicadores de 2x em input e 1,5x em output do Astra não têm com o que comparar. Nenhum fornecedor publicou contagens de tokens para um workload compartilhado, e o tokenizador do Jev não é documentado, então trate esses totais como comparação de tarifas, não de fatura.
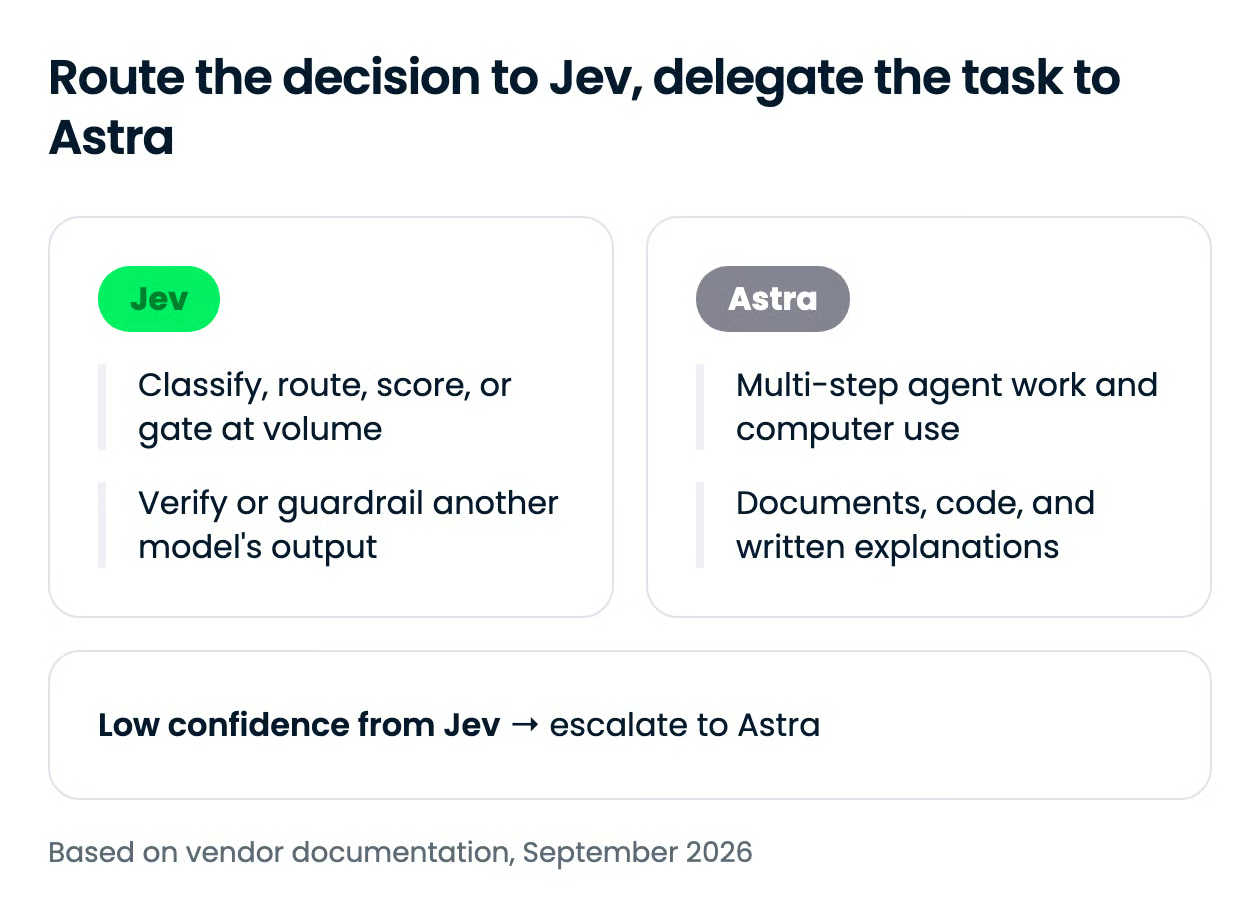
A bifurcação não é por acurácia ou preço isoladamente, mas sim por o passo terminar em uma decisão ou em um artefato. Decisão é do Jev; qualquer coisa que alguém vai ler, rodar ou abrir é do Astra.
Alcance é a dimensão mais desigual deste artigo: o Astra está em todos os lugares onde os modelos da OpenAI costumam estar, e o Jev é uma API com lista de espera cujas únicas rotas sem convite são as listagens no OpenRouter e no Vercel AI Gateway.
| Superfície | Jev | GPT-6 Astra |
|---|---|---|
| App para consumidor | Nenhum; apenas console do desenvolvedor | ChatGPT Plus, Pro, Business e Enterprise; desligado por padrão para workspaces Enterprise no lançamento |
| API de primeira parte | TypeSafe API, early access apenas via lista de espera; sem cadastro self-serve | OpenAI API (Responses e Chat Completions), com rollout nos dias após o lançamento |
| Plataformas de nuvem | Nenhuma | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agentes de código | Não aplicável; não produz texto nem tool calls | Codex, GitHub Copilot; não listado na documentação do Cursor em 21 de setembro de 2026 |
| Roteadores de terceiros | OpenRouter (typesafe/jev-1.13, via endpoint dedicado systemone), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID do modelo na API | jev-latest (alias para jev-1.13.0) |
gpt-6-astra |
Os IDs de modelo são jev-latest, que os SDKs da TypeSafe usam por padrão e que hoje resolve para jev-1.13.0, e gpt-6-astra. A TypeSafe recomenda fixar o ID versionado se você ajustou limiares de confiança, porque o alias muda quando sai um novo release. Os limites de taxa do Jev são 250.000 tokens por segundo e 1.200 requisições por minuto, e a TypeSafe diz que ambos podem mudar sem aviso enquanto escala.
Não é uma troca de uma string só. O Astra recebe um prompt e retorna texto via Responses API; o Jev recebe um estado e um mapa de perguntas tipadas em um único endpoint e retorna probabilidades. Os dois blocos abaixo fazem o mesmo pedido de devolução a cada modelo, para você ver a diferença de formato.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidencePara toda a configuração do Astra, incluindo ferramentas assíncronas e steering no meio do turno, siga nosso tutorial da API do GPT-6 Astra; para JSON estruturado com modelos da OpenAI, veja nosso tutorial de outputs estruturados.
Se o passo termina em uma decisão que seu código executa, use o Jev; se termina em algo que uma pessoa lê ou roda, use o GPT-6 Astra. A arquitetura que este lançamento sugere combina os dois: Jev como roteador barato e calibrado na frente, Astra como o especialista para o qual ele escala quando a confiança cai.
O que acho mais revelador é que a TypeSafe avalia o Jev contra as respostas do Astra. A OpenAI está afirmando que a fronteira é execução autônoma; a TypeSafe aposta que a maior parte do que o software pede a um modelo é uma pergunta limitada disfarçada. A questão em aberto para o Jev é se um benchmark independente confirma a paridade e se o preço sobrevive sem subsídio.
Para construir a camada de decisão em que qualquer modelo se encaixa, recomendo nosso curso Developing AI Systems with the OpenAI API e nossa trilha AI Agent Fundamentals.
Aprenda engenharia de IA com a DataCamp!
Curso
Programa
Curso