
Corso
Sviluppare sistemi di AI con l'API di OpenAI
3 h
22.8K
Il 15 settembre 2026 TypeSafe è uscita dallo stealth con Jev, un modello che definisce di Sistema Uno: gli invii lo stato del programma e domande tipizzate, e lui restituisce decisioni con probabilità calibrate invece di testo. Dodici giorni prima, OpenAI aveva rilasciato GPT-6 Astra, descritto come il suo modello più intelligente e allineato, progettato per l’uso del computer, il coding e il lavoro professionale end to end.
In questo articolo confronterò Jev e GPT-6 Astra su affidabilità dell’output, accuratezza decisionale, velocità, ampiezza agentica e prezzi, per poi indicare quali chiamate in una pipeline software spettano a ciascun modello.
Jev è un modello decisionale hosted che TypeSafe AI ha rilasciato in early access a settembre 2026, il primo di quelli che chiama modelli di Sistema Uno.
Il suo punto di forza è rinunciare alla generazione di testo: definisci in anticipo lo spazio delle risposte come domande di Choice, Score o Noul (sì/no) e lui restituisce valori tipizzati con probabilità calibrate su cui il software può diramarsi direttamente. La nostra guida a Jev copre il lancio e le valutazioni dichiarate da TypeSafe.
GPT-6 Astra è il modello di punta di frontiera di OpenAI, rilasciato il 3 settembre 2026 come successore di GPT-5.6 Sol.
Il suo posizionamento è l’esecuzione autonoma: OpenAI lo definisce il miglior modello al mondo per l’uso del computer e il più allineato, addestrato per compilare moduli, aggiornare un CRM, costruire e fare QA di un sito e produrre documenti che seguono i tuoi template. La nostra guida a GPT-6 Astra copre il lancio; il nostro tutorial sull’API di GPT-6 Astra costruisce un agente di controllo release con strumenti async.
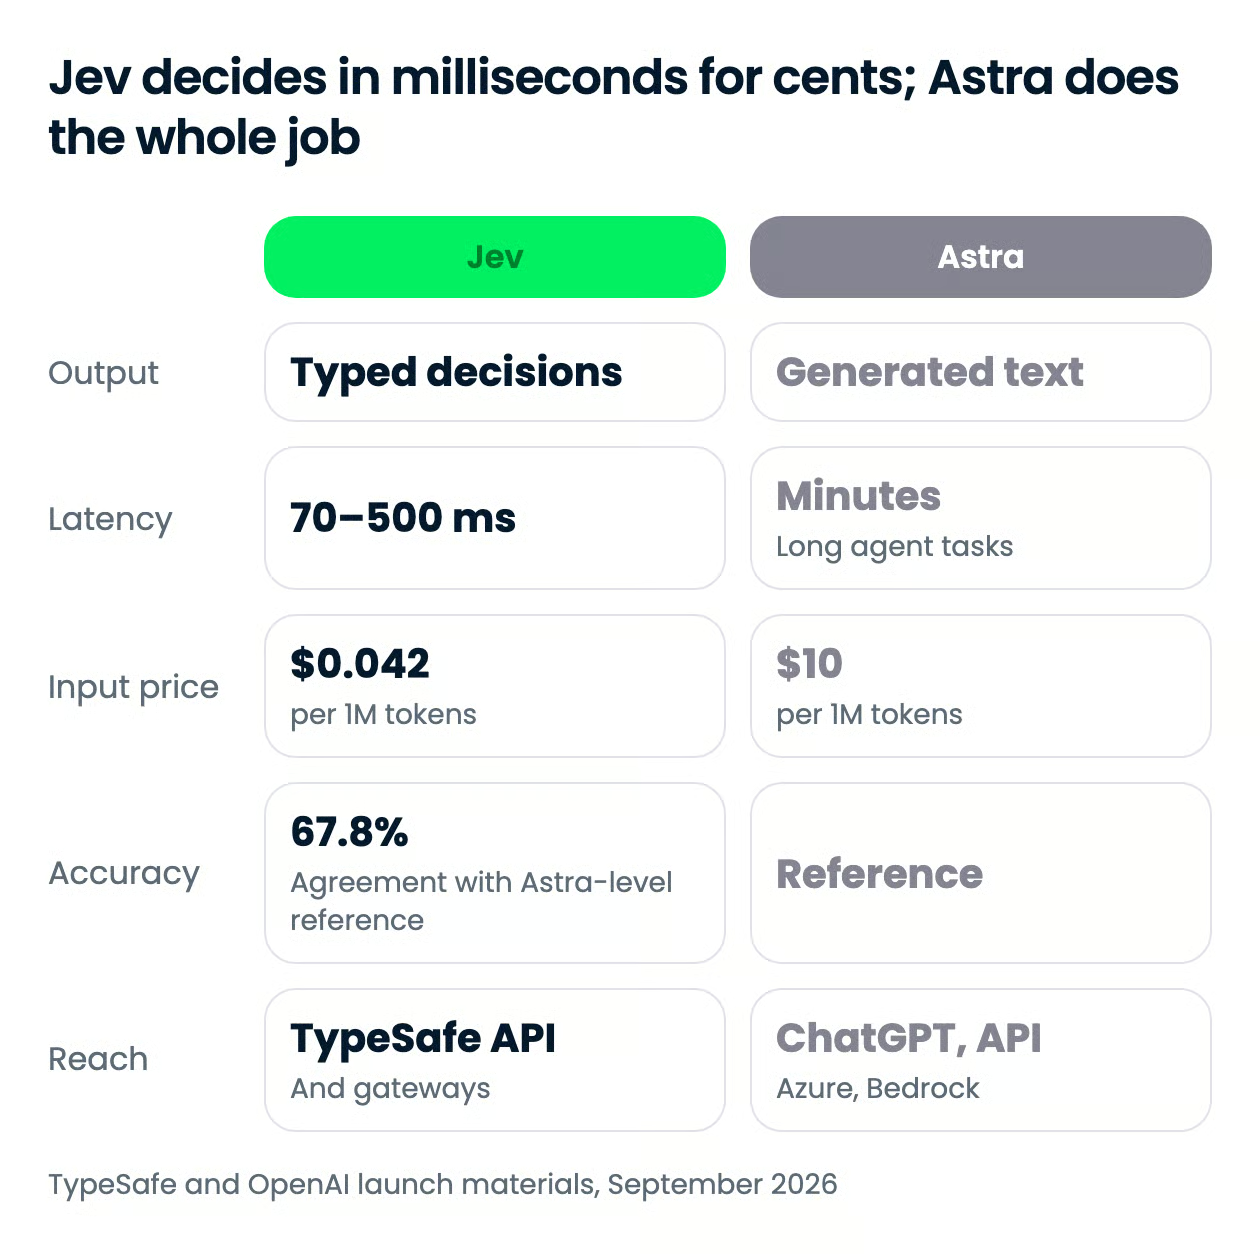
I due modelli si collocano ai lati opposti di un trade-off: Jev compra velocità, prezzo e sicurezza di tipo rifiutando di generare testo, mentre Astra compra ampiezza e profondità generando tutto. Gran parte delle righe qui sotto discende da questa singola scelta progettuale.
| Caratteristica | Jev | GPT-6 Astra |
|---|---|---|
| Output | Decisioni tipizzate (Choice, Score, Noul) con probabilità; niente testo | Testo generato; supporta output strutturati e function calling |
| Errori di tipo o schema | 0% per costruzione | Possibili; 4,2% nel benchmark interno sulle allucinazioni di OpenAI |
| Input | Testo, oggetti JSON, array; niente immagini | Testo e immagini |
| Finestra di contesto | Non indicata nella documentazione di TypeSafe; 32.000 token nelle schede OpenRouter e Vercel AI Gateway | 1.050.000 token; massimo output 128.000 |
| Latenza end-to-end | 70–500 ms per chiamata (dato dal fornitore) | Minuti sui task agentici; circa 40 minuti per task OSWorld 2.0 |
| Accuratezza decisionale | 67,8% di accordo con una risposta di riferimento Astra + Fable 5.1 nella valutazione a 4 workflow di TypeSafe | È il riferimento; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Agenti e strumenti | Nessuno; una decisione dentro al tuo codice | Uso del computer, shell hosted, ricerca web, code interpreter; 72,6% su OSWorld 2.0 |
| Confidenza | Probabilità calibrata su ogni risposta, più un punteggio di confidenza derivato | Non esposta come campo |
| Prezzo per 1M token | $0,042 input; output gratuito | $10 input; $50 output |
| Disponibilità | Early access via TypeSafe API, OpenRouter, Vercel AI Gateway | ChatGPT a pagamento, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev non può produrre un valore non valido, mentre Astra sì. Questo singolo fatto fa sì che finiscano in livelli diversi di un sistema anziché nello stesso slot.
Una richiesta a Jev è un blocco di stato più una mappa di domande tipizzate:
Lo spazio delle risposte è fissato prima dell’inferenza, quindi la corrispondenza allo schema è garantita; TypeSafe indica a 0% il tasso di errore degli output strutturati e delle chiamate agli strumenti e definisce la cifra non empirica.
Astra rappresenta un LLM classico e restituisce testo. Pur supportando output strutturati e function calling, e riducendo a circa un terzo il tasso di errore di Sol nel benchmark interno di OpenAI sulle allucinazioni, l’output va comunque fatto parse e validato. Il grafico di TypeSafe colloca l’errore sugli output strutturati degli LLM di frontiera tra 0,58% e 45,5%; la cifra di Astra non è pubblicata, quindi non darei per scontato che sia all’estremo basso.
Il costo della garanzia di Jev è che non ottieni una motivazione, solo una probabilità: va bene per un livello di routing, non per un revisore compliance, quindi pianifica di inoltrare i casi a bassa confidenza a un modello che sappia scrivere.
Due avvertenze sui numeri di affidabilità:
Per output che devono fare parse al primo colpo, vince il contratto di Jev; per qualsiasi cosa che una persona leggerà, solo Astra può rispondere.
Astra è più accurato. Sui quattro workflow di produzione di TypeSafe (incident response, osservabilità delle tracce agentiche, elaborazione fatture, customer service), Jev concorda con la media di Astra e Claude Fable 5.1 nel 67,8% dei casi, alla pari con GPT-5.6 Terra e 5–6 punti dietro GPT-5.6 Sol e Claude Opus 5.
In quel test Astra è il riferimento, quindi non ha un suo punteggio di accordo. Sui suoi benchmark, satura FrontierMath Tier 4, GPQA Diamond e ARC-AGI-3, sebbene l’ultimo dipenda da un harness stateful. Jev non ragiona su più turni, non pianifica e non spiega, e valutarlo sull’accordo con LLM invece che sulla verità a terra, come fa TypeSafe, rischia di ereditare i bias dei modelli di riferimento.
Se ti serve la massima accuratezza su una decisione a basso volume, l’LLM vince ancora.
Jev risponde in 70–500 millisecondi end-to-end, secondo le misure di TypeSafe, contro 3–329 secondi per gli LLM di frontiera sullo stesso tipo di query. Campiona tutte le risposte in parallelo anziché un token alla volta e accetta fino a 255 opzioni per Choice.
Astra è veloce per ciò che è: circa il 47% di tempo in meno per task OSWorld 2.0 rispetto a Sol, e la modalità Fast offre fino a 2x velocità a 2x prezzo. Quei task richiedono comunque decine di minuti. Il bot di Doom di un ingegnere TypeSafe esegue 10 query al secondo per circa $7 l’ora, un budget che nessun LLM di frontiera può rispettare.
Per un percorso decisionale con budget di 100 ms, qui l’unico candidato è Jev.
Astra fa tutto ciò che Jev non fa:
Jev accetta testo, JSON o array di testo, non immagini, e non chiama strumenti. È l’if fuzzy dentro un workflow di tua proprietà: classificare, instradare, assegnare punteggi, estrarre o verificare l’output di un altro modello, incluso il rilevamento di jailbreak sui prompt degli LLM.
Astra vince nettamente questa dimensione perché Jev non compete in essa.
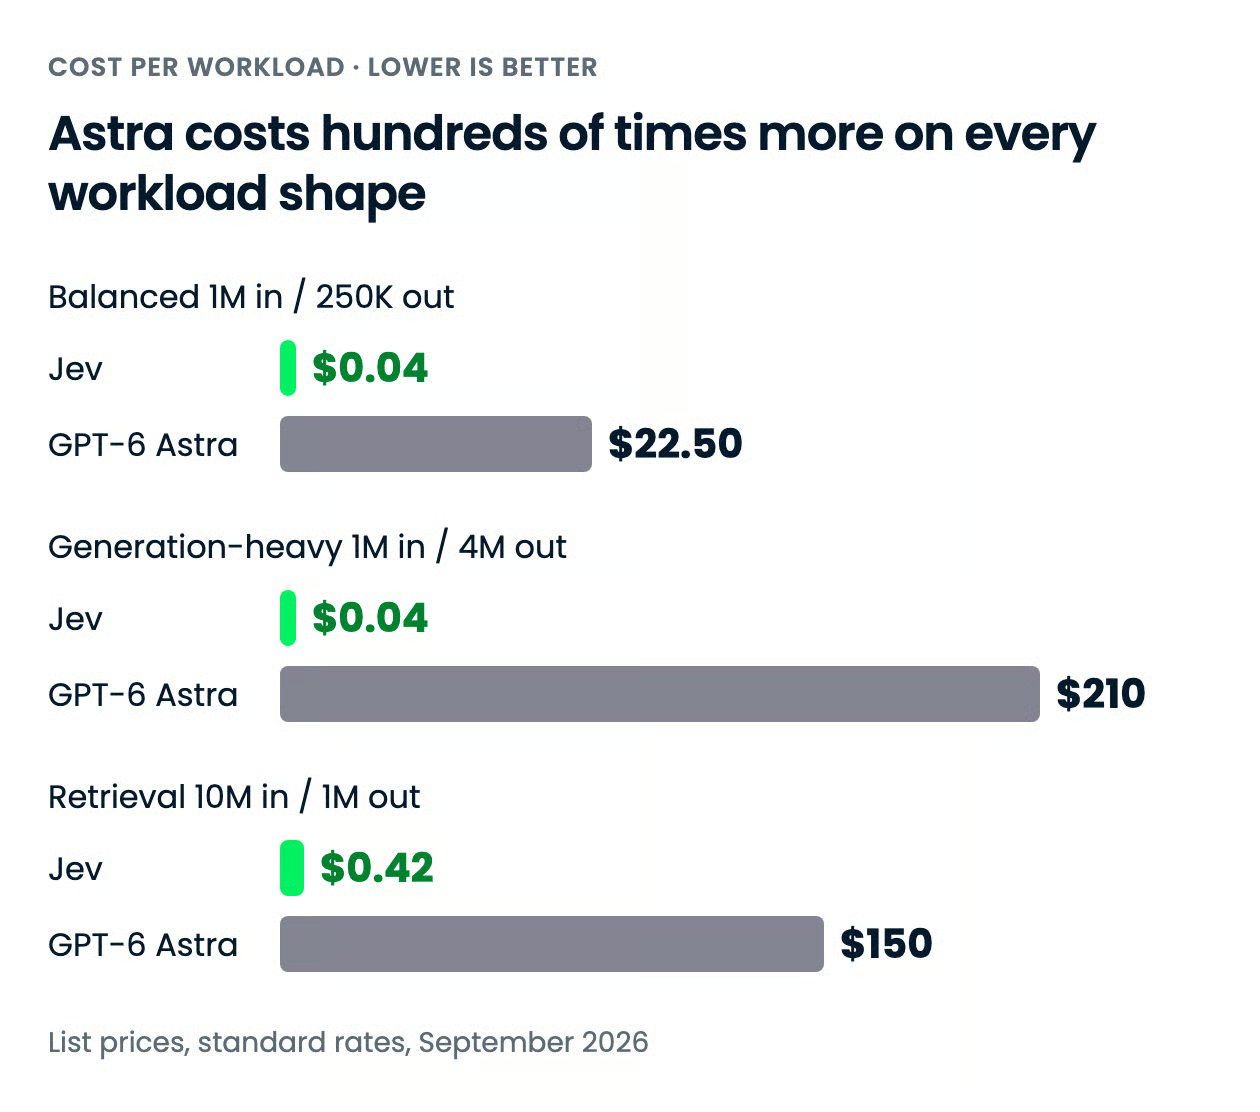
Astra costa svariate centinaia di volte più di Jev su qualsiasi forma di workload, e il divario si allarga quanto più output produce il task, perché Jev non fattura per l’output.
| Tariffa | Jev | GPT-6 Astra |
|---|---|---|
| Input, per 1M token | $0,042 | $10,00 |
| Output, per 1M token | Gratis | $50,00 |
| Lettura input in cache, per 1M token | Non pubblicata | $1,00 |
| Scrittura in cache, per 1M token | Non pubblicata | $12,50 |
| Sconto batch | Non pubblicato | 50% (Batch e Flex) |
| Sovrapprezzo long-context | Non pubblicato | 2x input e cache, 1,5x output, oltre 272K token di input |
| Modalità Fast | Non applicabile | 2x le tariffe applicabili |
| Tier consumer | Non applicabile; solo API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro su Pro e superiori) |
La forma della differenza conta quanto la dimensione. La tariffa output di Astra è 5x la sua tariffa input, e i token di ragionamento sono fatturati come output, quindi i lavori con molto “pensiero” o prolissi fanno crescere il conto più in fretta. Jev fattura solo l’input, e una risposta tipica sono poche decine di token di output, quindi il costo dipende solo da quanto stato invii e basta.
TypeSafe è chiara sul fatto di non poter provare che i prezzi non siano sovvenzionati, e si aspetta che scendano piuttosto che salire.
| Workload | Jev | GPT-6 Astra | Differenza |
|---|---|---|---|
| Assistant bilanciato: 1M in / 250K out | $0,04 | $22,50 | $22,46, Jev costa il 99,8% in meno |
| Generazione pesante: 1M in / 4M out | $0,04 | $210 | $209,96, Jev costa il 99,98% in meno |
| Retrieval, sotto soglia: 10M in / 1M out | $0,42 | $150 | $149,58, Jev costa il 99,7% in meno |
La formula è (volume ÷ 1M) × tariffa, sommata tra input e output, a tariffe standard. La riga “generazione pesante” è l’outlier perché l’output di Jev è gratuito, anche se è anche la riga meno realistica per Jev: il modello non emette mai 4M token di output, quindi leggila come l’effetto del solo premium sull’output di Astra. La riga del retrieval è quella che corrisponde a come Jev è effettivamente usato, tanto stato in ingresso e una manciata di probabilità in uscita, e resta comunque un rapporto di 357x.
Non c’è una riga “retrieval sopra soglia” perché la documentazione di TypeSafe non indica sovrapprezzo long-context, e la finestra di contesto che i router elencano per Jev è ben al di sotto della soglia di Astra, quindi i moltiplicatori 2x input e 1,5x output di Astra non hanno un confronto. Nessun fornitore ha pubblicato conteggi di token per un workload condiviso, e il tokenizer di Jev non è documentato, quindi tratta questi totali come un confronto di tariffe più che di fattura.
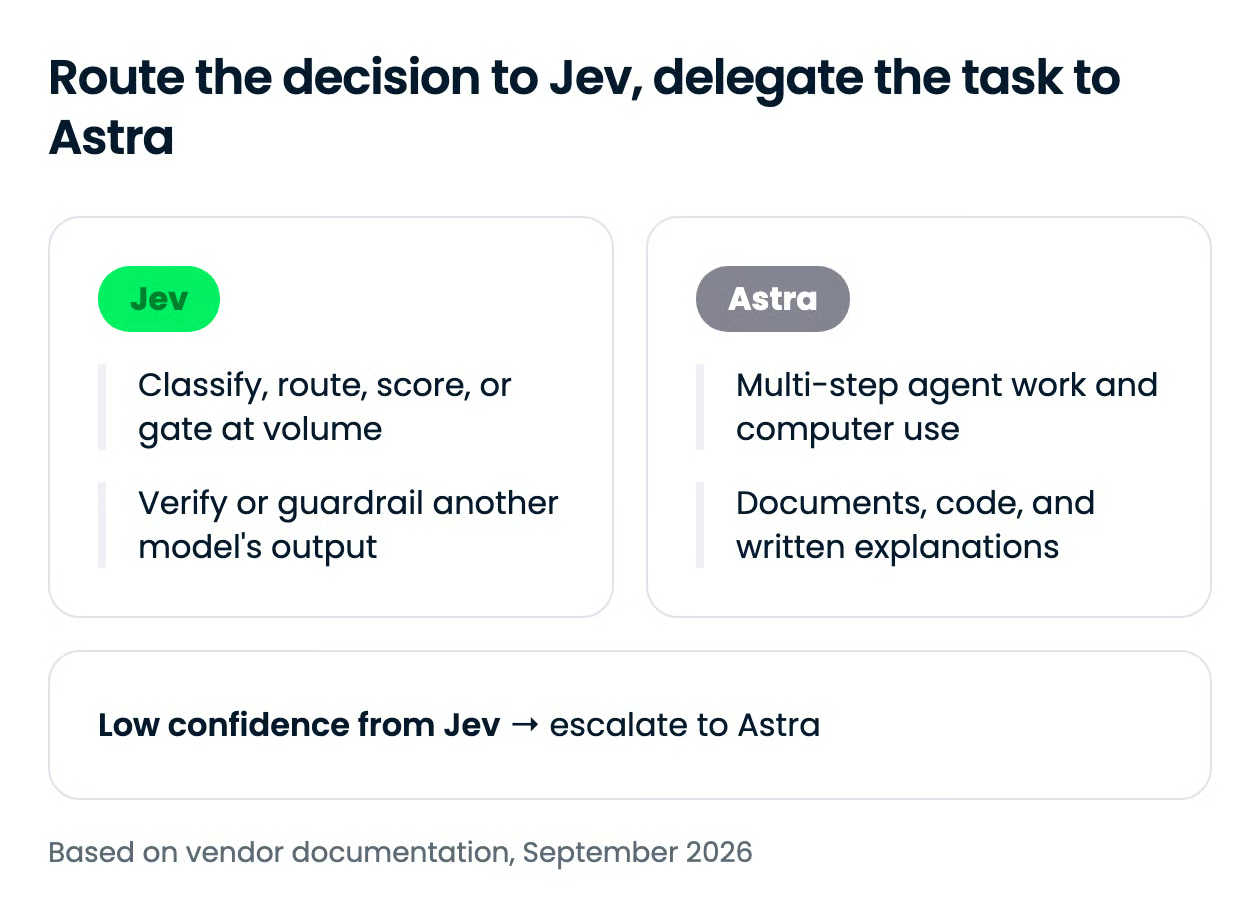
Il bivio non è l’accuratezza o il prezzo in sé, ma se il passaggio si conclude con una decisione o con un artefatto. Una decisione spetta a Jev; qualsiasi cosa che qualcuno leggerà, eseguirà o aprirà spetta ad Astra.
La raggiungibilità è la dimensione più sbilanciata di questo articolo: Astra è ovunque di solito siano i modelli OpenAI, e Jev è un’API con lista d’attesa, i cui unici percorsi senza invito sono le schede OpenRouter e Vercel AI Gateway.
| Superficie | Jev | GPT-6 Astra |
|---|---|---|
| App consumer | Nessuna; solo console sviluppatore | ChatGPT Plus, Pro, Business ed Enterprise; disattivato di default per le workspace Enterprise al lancio |
| API first-party | TypeSafe API, early access solo via waitlist; nessuna registrazione self-serve | OpenAI API (Responses e Chat Completions), rollout nei giorni successivi al lancio |
| Piattaforme cloud | Nessuna | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agenti di coding | Non applicabile; non produce testo o chiamate a strumenti | Codex, GitHub Copilot; non elencato nella documentazione di Cursor al 21 settembre 2026 |
| Router di terze parti | OpenRouter (typesafe/jev-1.13, via un endpoint dedicato systemone), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID modello API | jev-latest (alias di jev-1.13.0) |
gpt-6-astra |
Gli ID modello sono jev-latest, predefinito negli SDK di TypeSafe e che attualmente risolve in jev-1.13.0, e gpt-6-astra. TypeSafe consiglia di fissare la versione puntata se hai tarato soglie di confidenza, perché l’alias si sposta quando esce una nuova release. I rate limit di Jev sono 250.000 token al secondo e 1.200 richieste al minuto, e TypeSafe afferma che entrambi possono cambiare senza preavviso mentre scala.
Non sono intercambiabili con una sola stringa. Astra prende un prompt e restituisce testo tramite le Responses API; Jev prende uno stato e una mappa di domande tipizzate tramite un unico endpoint e restituisce probabilità. I due blocchi sotto inviano la stessa richiesta di reso a ciascun modello, così puoi vedere la differenza di forma.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidencePer l’intera configurazione di Astra, inclusi strumenti async e steering a metà turno, segui il nostro tutorial sull’API di GPT-6 Astra; per JSON strutturato dai modelli OpenAI, vedi il nostro tutorial sugli output strutturati.
Se il passaggio si conclude con una decisione su cui il tuo codice agisce, usa Jev; se si conclude con qualcosa che una persona leggerà o eseguirà, usa GPT-6 Astra. L’architettura suggerita da questo lancio è entrambe le cose: Jev come router economico e calibrato davanti, Astra come specialista a cui escalare quando la confidenza cala.
Ciò che trovo più indicativo è che TypeSafe valuti Jev sulle risposte di Astra. OpenAI sta affermando che la frontiera è l’esecuzione autonoma; TypeSafe scommette che la maggior parte di ciò che il software chiede a un modello è una domanda delimitata travestita. La domanda aperta per Jev è se un benchmark indipendente confermi la parità e se il prezzo sopravviva alla sovvenzione.
Per costruire il livello decisionale in cui si inserisce l’uno o l’altro modello, ti consiglio il nostro corso Developing AI Systems with the OpenAI API e il nostro track AI Agent Fundamentals.
Impara l’AI Engineering con DataCamp!
Corso
Programma
Corso