
Courses
Phát triển hệ thống AI với OpenAI API
3 giờ
22.8K
TypeSafe ra mắt khỏi chế độ ẩn ngày 15 tháng 9 năm 2026 với Jev, một mô hình họ gọi là mô hình Hệ số Một (System One): bạn gửi trạng thái chương trình và các câu hỏi có kiểu, và nó trả về quyết định cùng xác suất được hiệu chuẩn thay vì văn bản. Mười hai ngày trước đó, OpenAI phát hành GPT-6 Astra, mô hình được mô tả là thông minh và tuân thủ nhất của họ, được xây dựng cho việc sử dụng máy tính, lập trình và công việc chuyên nghiệp đầu-cuối.
Trong bài viết này, tôi sẽ so sánh Jev và GPT-6 Astra về độ tin cậy đầu ra, độ chính xác quyết định, tốc độ, phạm vi tác tử, và giá, sau đó nêu xem những lời gọi nào trong pipeline phần mềm nên thuộc về mô hình nào.
Jev là một mô hình quyết định được lưu trữ do TypeSafe AI phát hành ở chế độ truy cập sớm vào tháng 9 năm 2026, là mô hình đầu tiên trong nhóm mà họ gọi là Hệ số Một.
Điểm bán của nó là từ bỏ việc sinh văn bản: bạn xác định không gian câu trả lời trước dưới dạng câu hỏi Choice (Lựa chọn), Score (Điểm), hoặc Noul (có/không), và nó trả về các giá trị có kiểu với xác suất được hiệu chuẩn mà phần mềm có thể rẽ nhánh trực tiếp. Hướng dẫn Jev của chúng tôi bao quát lần ra mắt và các tuyên bố đánh giá của TypeSafe.
GPT-6 Astra là mẫu đầu bảng tiên phong của OpenAI, phát hành ngày 3 tháng 9 năm 2026 kế nhiệm GPT-5.6 Sol.
Định vị của nó là thực thi tự động: OpenAI gọi đây là mô hình sử dụng máy tính tốt nhất thế giới và cũng là mô hình tuân thủ cao nhất của họ, được huấn luyện để điền biểu mẫu, cập nhật CRM, xây và QA một website, và tạo ra tài liệu theo mẫu của bạn. Hướng dẫn GPT-6 Astra của chúng tôi bao quát lần ra mắt; hướng dẫn API GPT-6 Astra của chúng tôi xây một tác tử kiểm tra phát hành với công cụ bất đồng bộ.
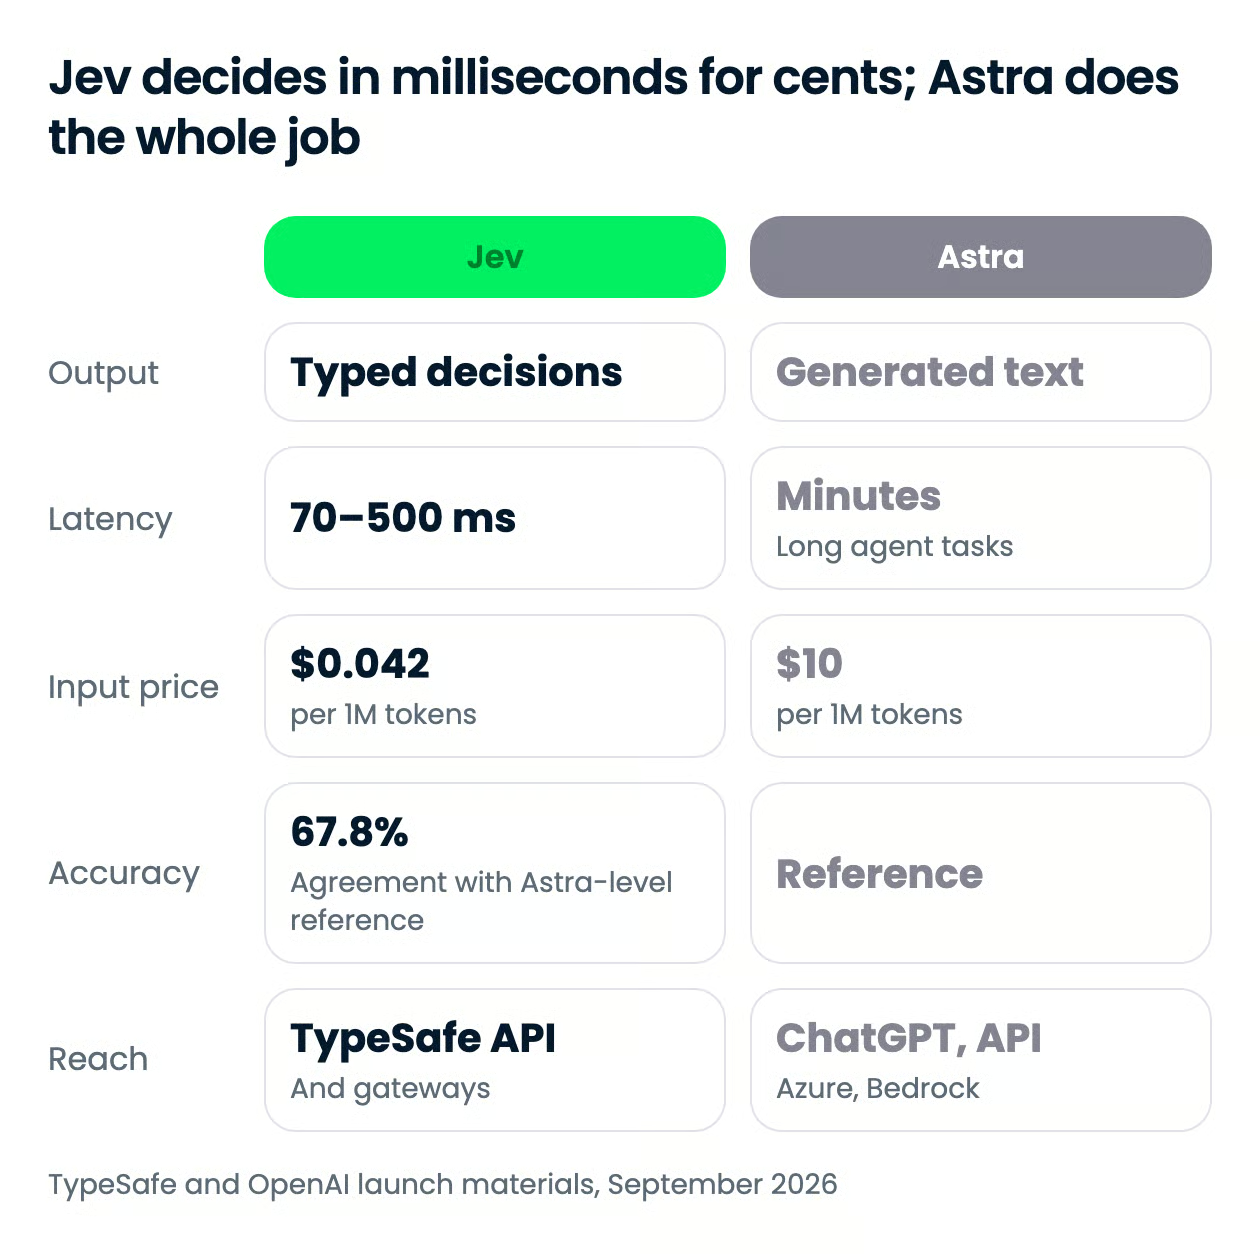
Hai mô hình ở hai đầu của một phép đánh đổi: Jev mua tốc độ, giá và an toàn kiểu bằng cách từ chối sinh văn bản, còn Astra mua độ rộng và chiều sâu bằng cách sinh mọi thứ. Hầu hết các dòng so sánh bên dưới xuất phát từ lựa chọn thiết kế đơn lẻ đó.
| Tính năng | Jev | GPT-6 Astra |
|---|---|---|
| Đầu ra | Quyết định có kiểu (Choice, Score, Noul) kèm xác suất; không có văn bản | Văn bản được sinh; hỗ trợ đầu ra có cấu trúc và gọi hàm |
| Lỗi kiểu hoặc schema | 0% theo cấu trúc | Có thể xảy ra; 4,2% trên benchmark ảo giác nội bộ của OpenAI |
| Đầu vào | Văn bản, đối tượng JSON, mảng; không hỗ trợ hình ảnh | Văn bản và hình ảnh |
| Cửa sổ ngữ cảnh | Không nêu trong tài liệu của TypeSafe; 32.000 token trên danh mục OpenRouter và Vercel AI Gateway | 1.050.000 token; tối đa 128.000 token đầu ra |
| Độ trễ đầu-cuối | 70 đến 500 ms mỗi lời gọi (theo nhà cung cấp báo cáo) | Hàng phút trên các tác vụ tác tử; khoảng 40 phút mỗi tác vụ OSWorld 2.0 |
| Độ chính xác quyết định | 67,8% đồng thuận với tham chiếu Astra + Fable 5.1 trên đánh giá 4 quy trình của TypeSafe | Là tham chiếu; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Tác tử và công cụ | Không; là một quyết định bên trong mã của bạn | Sử dụng máy tính, shell lưu trữ, tìm kiếm web, trình thông dịch mã; 72,6% OSWorld 2.0 |
| Độ tin cậy | Xác suất được hiệu chuẩn trên mọi câu trả lời, kèm điểm tin cậy suy ra | Không lộ ra dưới dạng trường |
| Giá mỗi 1M token | $0,042 đầu vào; đầu ra miễn phí | $10 đầu vào; $50 đầu ra |
| Khả dụng | Truy cập sớm qua TypeSafe API, OpenRouter, Vercel AI Gateway | Các gói trả phí ChatGPT, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev không thể tạo ra một giá trị không hợp lệ, còn Astra có thể. Sự thật đơn giản đó là lý do chúng kết thúc ở các lớp khác nhau của hệ thống thay vì cùng một vị trí.
Một yêu cầu Jev là một khối trạng thái cộng bản đồ các câu hỏi có kiểu:
Không gian câu trả lời được cố định trước suy luận, nên khớp schema là đảm bảo; TypeSafe đưa tỷ lệ lỗi đầu ra có cấu trúc và gọi công cụ là 0% và gọi con số đó là phi thực nghiệm.
Astra đại diện cho một LLM cổ điển và trả về văn bản. Dù hỗ trợ đầu ra có cấu trúc và gọi hàm, và giảm tỷ lệ lỗi của Sol xuống khoảng một phần ba trên benchmark ảo giác nội bộ của OpenAI, đầu ra vẫn phải được phân tích cú pháp và xác thực. Biểu đồ của TypeSafe đặt lỗi đầu ra có cấu trúc của LLM tiên phong từ 0,58% đến 45,5%; con số riêng của Astra không được công bố, nên tôi sẽ không giả định nó ở đáy dải.
Cái giá cho bảo đảm của Jev là bạn không có lập luận, chỉ có xác suất: đủ cho lớp định tuyến, không đủ cho người rà soát tuân thủ, nên hãy lên kế hoạch nâng cấp các trường hợp độ tin cậy thấp lên một mô hình có thể viết.
Hai lưu ý về các con số độ tin cậy:
Với đầu ra phải phân tích cú pháp thành công ngay lần đầu, hợp đồng của Jev thắng; với bất cứ thứ gì con người đọc, chỉ Astra có thể trả lời.
Astra chính xác hơn. Trên bốn quy trình sản xuất của TypeSafe (ứng phó sự cố, quan sát vết tác tử, xử lý hóa đơn, chăm sóc khách hàng), Jev đồng thuận với trung bình của Astra và Claude Fable 5.1 trong 67,8% trường hợp, ngang GPT-5.6 Terra và kém 5 đến 6 điểm so với GPT-5.6 Sol và Claude Opus 5.
Astra là tham chiếu ở đó, nên nó không có điểm đồng thuận riêng. Trên benchmark riêng, nó đạt bão hòa FrontierMath Tier 4, GPQA Diamond, và ARC-AGI-3, dù cái cuối phụ thuộc vào bộ khung có trạng thái. Jev không lập luận qua nhiều lượt, không lập kế hoạch hay giải thích, và việc chấm theo đồng thuận với LLM thay vì chân lý nền như TypeSafe làm có nguy cơ thừa hưởng thiên kiến của mô hình tham chiếu.
Nếu bạn cần độ chính xác đỉnh trên một quyết định khối lượng thấp, LLM vẫn thắng.
Jev trả lời trong 70 đến 500 mili giây đầu-cuối theo đo đạc của TypeSafe, so với 3 đến 329 giây cho các LLM tiên phong trên cùng loại truy vấn. Nó lấy mẫu tất cả câu trả lời song song thay vì từng token một và chấp nhận tới 255 phương án cho Choice.
Astra nhanh trong phạm trù của nó: ít hơn khoảng 47% thời gian mỗi tác vụ OSWorld 2.0 so với Sol, và chế độ Nhanh (Fast) cho tốc độ gấp tới 2 lần với giá gấp 2 lần. Những tác vụ đó vẫn mất hàng chục phút. Bot Doom của một kỹ sư TypeSafe chạy 10 truy vấn một giây với khoảng $7 một giờ, mức ngân sách mà không LLM tiên phong nào đáp ứng được.
Với đường dẫn yêu cầu quyết định có ngân sách 100 ms, Jev là ứng viên duy nhất ở đây.
Astra làm mọi thứ Jev không làm:
Jev nhận văn bản, JSON, hoặc mảng văn bản, không nhận hình ảnh, và không gọi công cụ. Nó là câu lệnh if mơ hồ bên trong một quy trình do mã của bạn sở hữu: phân loại, định tuyến, chấm điểm, trích xuất, hoặc kiểm tra đầu ra của mô hình khác, bao gồm phát hiện jailbreak trên prompt LLM.
Astra thắng tuyệt đối ở chiều này vì Jev không tham gia.
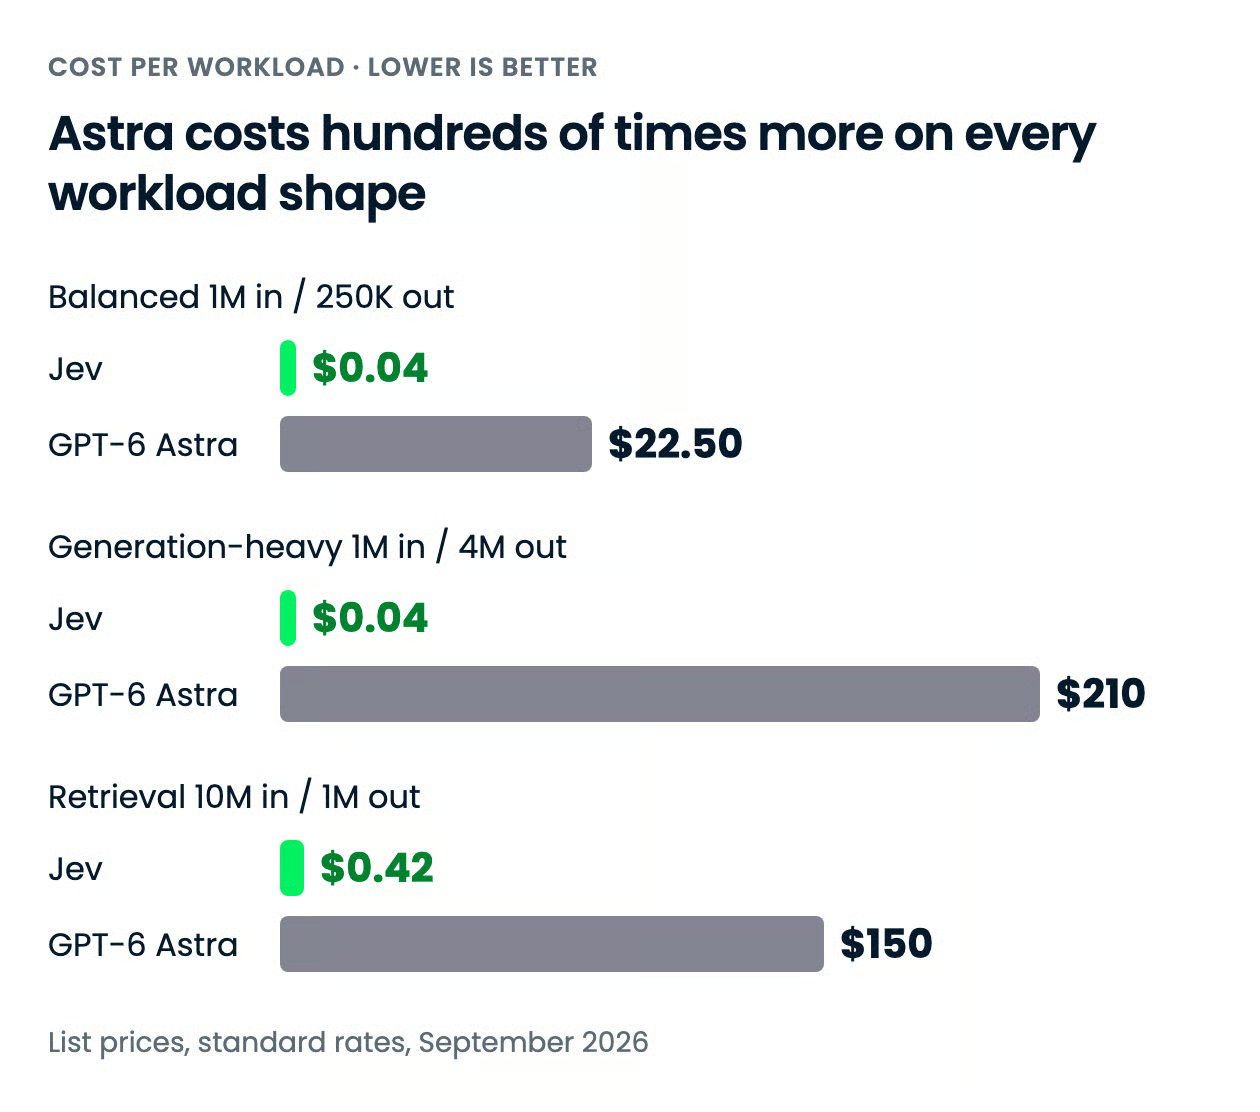
Astra đắt hơn vài trăm lần so với Jev trên bất kỳ dạng khối lượng công việc nào, và khoảng cách càng nới rộng khi tác vụ sinh nhiều đầu ra hơn, vì Jev không tính phí đầu ra.
| Mức | Jev | GPT-6 Astra |
|---|---|---|
| Đầu vào, mỗi 1M token | $0,042 | $10,00 |
| Đầu ra, mỗi 1M token | Miễn phí | $50,00 |
| Đọc bộ nhớ đệm đầu vào, mỗi 1M token | Chưa công bố | $1,00 |
| Ghi bộ nhớ đệm, mỗi 1M token | Chưa công bố | $12,50 |
| Giảm giá theo lô | Chưa công bố | 50% (Batch và Flex) |
| Phụ phí ngữ cảnh dài | Chưa công bố | 2x đầu vào và bộ nhớ đệm, 1,5x đầu ra, trên 272K token đầu vào |
| Chế độ nhanh | Không áp dụng | Gấp 2 lần mức giá áp dụng |
| Tầng người dùng cá nhân | Không áp dụng; chỉ API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro trên Pro trở lên) |
Hình dạng khác biệt quan trọng không kém kích thước. Mức giá đầu ra của Astra gấp 5 lần đầu vào, và token lập luận được tính là đầu ra, nên công việc nặng suy nghĩ hoặc dài dòng là nơi hóa đơn tăng nhanh nhất. Jev chỉ tính phí đầu vào, và câu trả lời điển hình chỉ vài chục token đầu ra, nên chi phí của nó chỉ phụ thuộc vào lượng trạng thái bạn gửi và không gì khác.
TypeSafe thẳng thắn rằng họ không thể chứng minh mức giá không được trợ giá, và kỳ vọng giá sẽ giảm chứ không tăng.
| Khối lượng | Jev | GPT-6 Astra | Chênh lệch |
|---|---|---|---|
| Trợ lý cân bằng: 1M vào / 250K ra | $0,04 | $22,50 | $22,46, Jev rẻ hơn 99,8% |
| Thiên về sinh: 1M vào / 4M ra | $0,04 | $210 | $209,96, Jev rẻ hơn 99,98% |
| Truy hồi, dưới ngưỡng: 10M vào / 1M ra | $0,42 | $150 | $149,58, Jev rẻ hơn 99,7% |
Công thức là (khối lượng ÷ 1M) × mức giá, cộng qua đầu vào và đầu ra, theo mức chuẩn. Hàng thiên về sinh là ngoại lệ vì đầu ra của Jev miễn phí, dù cũng là hàng ít thực tế nhất cho Jev: mô hình không bao giờ phát 4M token đầu ra, nên hãy đọc đó như tác động riêng của phụ phí đầu ra lên Astra. Hàng truy hồi phù hợp với cách Jev thực sự được dùng: nhiều trạng thái vào và một nhúm xác suất ra, và vẫn chênh tới 357 lần.
Không có hàng truy hồi vượt ngưỡng vì tài liệu của TypeSafe không nêu phụ phí ngữ cảnh dài, và cửa sổ ngữ cảnh mà các router liệt kê cho Jev nằm thấp hơn nhiều ngưỡng của Astra, nên hệ số 2x đầu vào và 1,5x đầu ra của Astra không có cái gì để so. Cả hai nhà cung cấp đều chưa công bố số token cho cùng một khối lượng công việc, và bộ tách token của Jev chưa được ghi tài liệu, nên hãy coi các tổng này là so mức giá chứ không phải hóa đơn.
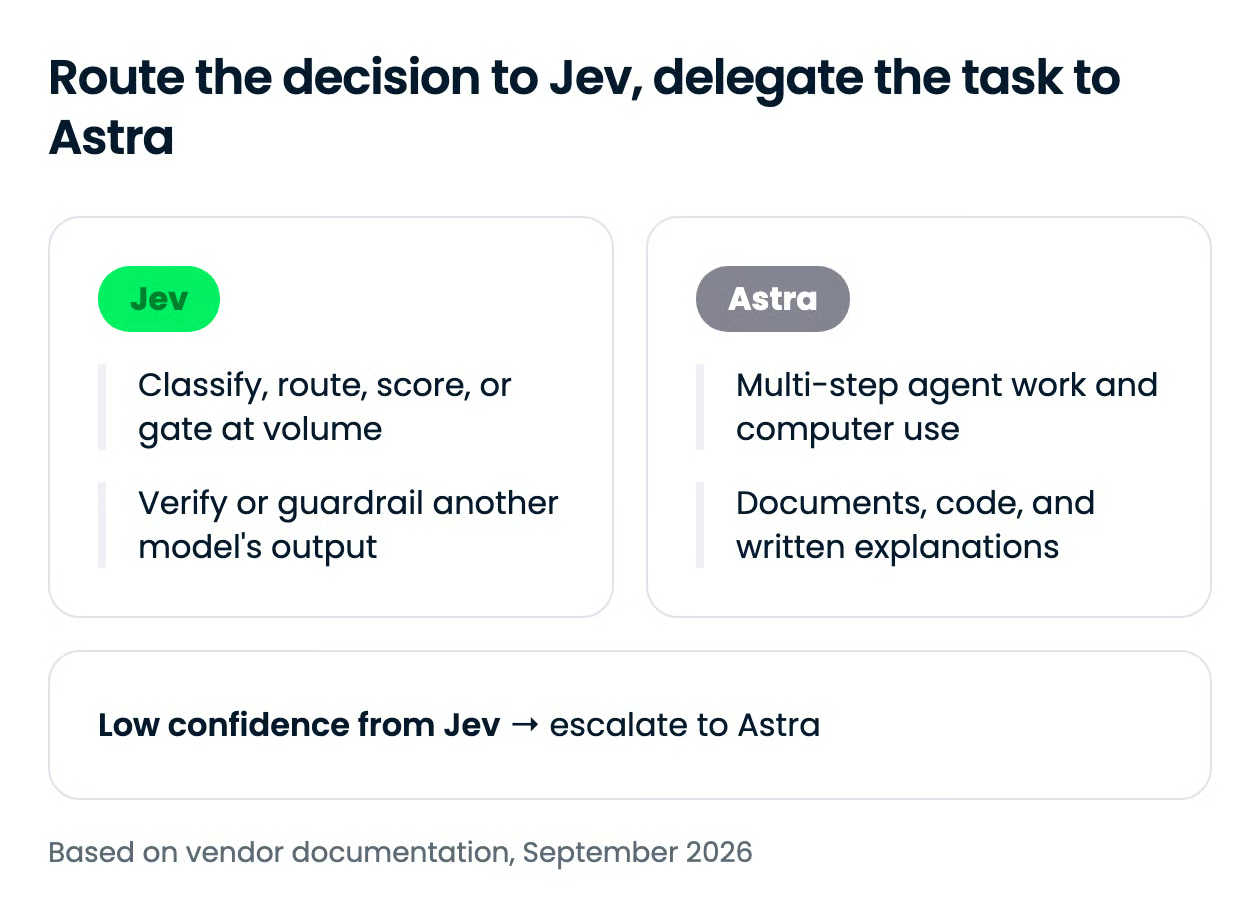
Ngã rẽ không nằm ở độ chính xác hay giá riêng rẽ, mà là bước đó kết thúc ở quyết định hay ở hiện vật. Quyết định thuộc về Jev; bất cứ thứ gì ai đó sẽ đọc, chạy, hoặc mở thuộc về Astra.
Phạm vi tiếp cận là chiều lệch nhất trong bài này: Astra có mặt ở mọi nơi mô hình OpenAI thường có, còn Jev là API có danh sách chờ, những tuyến duy nhất không cần mời là danh mục OpenRouter và Vercel AI Gateway.
| Bề mặt | Jev | GPT-6 Astra |
|---|---|---|
| Ứng dụng người dùng | Không; chỉ bảng điều khiển cho nhà phát triển | ChatGPT Plus, Pro, Business và Enterprise; tắt mặc định cho không gian làm việc Enterprise khi ra mắt |
| API bên thứ nhất | TypeSafe API, truy cập sớm chỉ qua danh sách chờ; không có tự đăng ký | OpenAI API (Responses và Chat Completions), triển khai dần trong vài ngày sau khi ra mắt |
| Nền tảng đám mây | Không có | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Tác tử lập trình | Không áp dụng; không sinh văn bản hay gọi công cụ | Codex, GitHub Copilot; chưa được liệt kê trong tài liệu Cursor tính đến 21 tháng 9 năm 2026 |
| Router bên thứ ba | OpenRouter (typesafe/jev-1.13, qua endpoint systemone chuyên dụng), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID mô hình API | jev-latest (bí danh cho jev-1.13.0) |
gpt-6-astra |
Các ID mô hình là jev-latest, mặc định trong SDK của TypeSafe và hiện trỏ tới jev-1.13.0, và gpt-6-astra. TypeSafe khuyến nghị cố định ID theo phiên bản nếu bạn đã tinh chỉnh ngưỡng tin cậy, vì bí danh sẽ di chuyển khi bản phát hành mới lên sóng. Giới hạn tốc độ của Jev là 250.000 token mỗi giây và 1.200 yêu cầu mỗi phút, và TypeSafe nói cả hai có thể thay đổi không báo trước khi họ mở rộng.
Đây không phải là hoán đổi một chuỗi. Astra nhận prompt và trả về văn bản qua Responses API; Jev nhận trạng thái và bản đồ câu hỏi có kiểu qua một endpoint duy nhất và trả về xác suất. Hai khối dưới đây gửi cùng một yêu cầu hoàn trả tới mỗi mô hình, để bạn thấy khác biệt về hình dạng.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidenceĐể thiết lập Astra đầy đủ, gồm công cụ bất đồng bộ và điều khiển giữa lượt, hãy theo hướng dẫn API GPT-6 Astra của chúng tôi; để có JSON có cấu trúc từ các mô hình OpenAI, xem hướng dẫn đầu ra có cấu trúc của chúng tôi.
Nếu bước kết thúc ở một quyết định mà mã của bạn hành động theo, hãy dùng Jev; nếu nó kết thúc ở thứ ai đó đọc hoặc chạy, hãy dùng GPT-6 Astra. Kiến trúc mà lần ra mắt này gợi ý là dùng cả hai: Jev làm bộ định tuyến rẻ, được hiệu chuẩn ở phía trước, Astra là chuyên gia mà Jev nâng cấp tới khi độ tin cậy giảm.
Điều khiến tôi chú ý nhất là TypeSafe chấm Jev so với câu trả lời của Astra. OpenAI đang đưa ra tuyên bố rằng tuyến đầu là thực thi tự động; TypeSafe đặt cược rằng phần lớn thứ phần mềm hỏi một mô hình là câu hỏi có giới hạn đội lốt. Câu hỏi mở với Jev là liệu một benchmark độc lập có xác nhận mức ngang bằng và liệu mức giá có sống sót nếu không còn trợ giá.
Để xây lớp quyết định nơi mỗi mô hình ngồi, tôi khuyến nghị khóa học Developing AI Systems with the OpenAI API và lộ trình AI Agent Fundamentals của chúng tôi.
Học Kỹ thuật AI với DataCamp!
Courses
Tracks
Courses