Courses
OpenAI API を使った AI システムの開発
3時間
22.8K
TypeSafe は 2026 年 9 月 15 日、ステルスを抜けて Jev を発表しました。Jev は同社が System One モデルと呼ぶモデルで、プログラムの状態と型付きの質問を送ると、テキストではなく較正済みの確率を伴う判断を返します。その 12 日前、OpenAI は GPT-6 Astra をリリースしました。同社史上もっとも知的で整合性の高いモデルで、コンピュータ操作、コーディング、プロフェッショナル業務の端から端までに特化していると説明しています。
本記事では、出力の信頼性、判断の正確性、速度、エージェントとしての範囲、価格を軸に Jev と GPT-6 Astra を比較し、ソフトウェアのパイプラインでどの呼び出しをどちらに割り当てるべきかを示します。
Jev は TypeSafe AI が 2026 年 9 月に早期アクセスとして公開したホスティング型の意思決定モデルで、同社が System One モデルと呼ぶ最初の製品です。
特長はテキスト生成を捨てたことにあります。回答空間をあらかじめ Choice、Score、Noul(はい/いいえ)質問として定義し、ソフトウェアがそのまま分岐できる型付きの値と較正済み確率で返します。詳細は当社のJev ガイドで、ローンチ内容と TypeSafe の評価結果を解説しています。
GPT-6 Astra は OpenAI のフラッグシップ最前線モデルで、GPT-5.6 Sol の後継として 2026 年 9 月 3 日にリリースされました。
位置づけは自律実行です。OpenAI はこれを世界最高のコンピュータ操作モデルであり、もっとも整合性の高いモデルと呼び、フォーム入力、CRM 更新、Web サイトの構築と QA、テンプレート準拠のドキュメント生成までを訓練対象にしています。ローンチの概要はGPT-6 Astra ガイドで、GPT-6 Astra API チュートリアルでは非同期ツールでリリースチェック用エージェントを構築します。
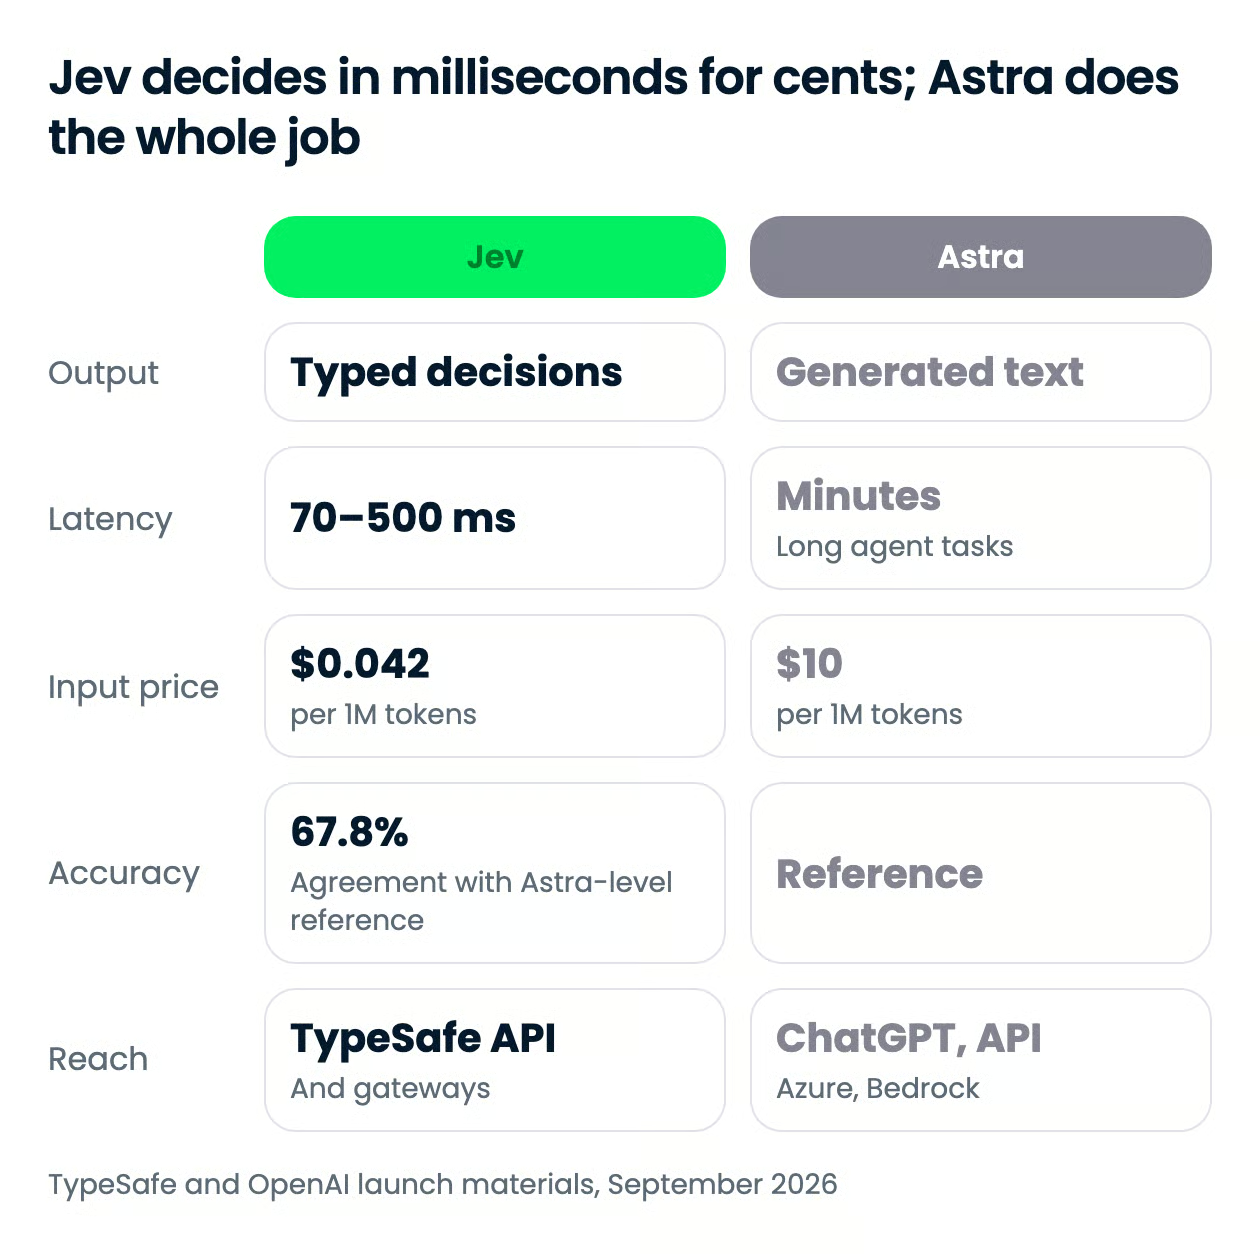
両モデルは同じトレードオフの両端に位置します。Jev はテキストを生成しないことで速度、価格、型安全性を獲得し、Astra はすべてを生成することで幅と深さを得ます。以下の多くはこの単一の設計選択から導かれます。
| 機能 | Jev | GPT-6 Astra |
|---|---|---|
| 出力 | 確率付きの型付き判断(Choice、Score、Noul);テキストなし | 生成テキスト;構造化出力と関数呼び出しに対応 |
| 型/スキーマエラー | 設計上 0% | 発生しうる;OpenAI 内部の幻覚ベンチで 4.2% |
| 入力 | テキスト、JSON オブジェクト、配列;画像なし | テキストと画像 |
| コンテキスト長 | TypeSafe のドキュメントでは未記載;OpenRouter と Vercel AI Gateway の掲載は 32,000 トークン | 1,050,000 トークン;出力最大 128,000 |
| エンドツーエンド遅延 | 1 コールあたり 70〜500 ms(ベンダー公称) | エージェントタスクで数分;OSWorld 2.0 のタスクあたり約 40 分 |
| 判断精度 | TypeSafe の 4 ワークフロー評価で Astra + Fable 5.1 の参照に 67.8% 一致 | 参照モデル;GPQA Diamond 96.0%、FrontierMath Tier 4 97.6% |
| エージェントとツール | なし;コード内の意思決定 | コンピュータ操作、ホストシェル、ウェブ検索、コードインタプリタ;OSWorld 2.0 で 72.6% |
| 信頼度 | すべての回答に較正済み確率と導出信頼スコア | フィールドとしては未公開 |
| 100 万トークンあたりの価格 | 入力 $0.042;出力無料 | 入力 $10;出力 $50 |
| 提供状況 | TypeSafe API、OpenRouter、Vercel AI Gateway による早期アクセス | ChatGPT 有料プラン、OpenAI API、Azure、AWS Bedrock、GitHub Copilot、OpenRouter |
Jev は不正な値を出せず、Astra は出しうる——この一点が、両者が同じスロットではなくシステムの異なる層を担う理由です。
Jev へのリクエストは、状態ブロックと型付きの質問マップです:
推論前に回答空間が固定されるためスキーマは必ず一致します。TypeSafe は構造化出力やツール呼び出しのエラー率を 0% とし、この数字は実験値ではないと述べています。
Astra は古典的な LLM としてテキストを返します。構造化出力や関数呼び出しには対応し、OpenAI 内部の幻覚ベンチで Sol のエラー率を約 3 分の 1 に減らしていますが、出力は依然としてパースと検証が必要です。TypeSafe の図ではフロンティア LLM の構造化出力エラーは 0.58%〜45.5% の範囲で示され、Astra 固有の数字は未公表のため、下限にあるとは仮定しないほうがよいでしょう。
Jev の保証の代償は、根拠がなく確率のみであることです。ルーティング層には十分ですが、コンプライアンス審査には不向きなので、低信頼度のケースは文章を書けるモデルにエスカレーションする計画を立ててください。
信頼性数値に関する留意点が 2 つあります:
一発でパース可能な出力が必要なら Jev の契約が有利です。人が読むものなら、答えられるのは Astra だけです。
Astra のほうが高精度です。TypeSafe の 4 つのプロダクションワークフロー(インシデント対応、エージェントトレース可観測性、請求書処理、カスタマーサービス)では、Jev は Astra と Claude Fable 5.1 の平均に 67.8% 一致しており、GPT-5.6 Terra と同程度、GPT-5.6 Sol と Claude Opus 5には 5〜6 ポイント劣ります。
ここで Astra は参照側なので、自身の一致スコアはありません。自社ベンチでは FrontierMath Tier 4、GPQA Diamond、ARC-AGI-3 を飽和しており、最後はステートフルなハーネスに依存します。Jev はターンをまたいだ推論や計画、説明は行わず、TypeSafe のように真値ではなく LLM との一致で採点すると、参照モデルのバイアスを受け継ぐリスクがあります。
少量でも最高精度が必要な判断なら、依然として LLM に軍配が上がります。
TypeSafe の測定では、Jev はエンドツーエンドで 70〜500 ミリ秒で回答します。同種のクエリでフロンティア LLM は 3〜329 秒です。トークンを 1 個ずつではなく全回答を並列サンプリングし、Choice の選択肢は最大 255 まで受け付けます。
Astra はモデル特性に対しては速く、OSWorld 2.0 の 1 タスクあたり時間は Sol 比で約 47% 短縮、Fast モードでは価格 2 倍で最大 2 倍速くなります。それでもタスクは数十分かかります。TypeSafe のエンジニアが作った Doom ボットは毎秒 10 クエリで時給約 $7 で動き、フロンティア LLM では到底届かない予算です。
100 ms のレイテンシ予算がある意思決定パスでは、候補は Jev のみです。
Astra は Jev がしないことをすべて行います:
Jev はテキスト、JSON、またはテキスト配列を受け付けますが、画像は不可、ツール呼び出しも行いません。ワークフロー内の曖昧さを含む if 文の役割で、分類、ルーティング、スコアリング、抽出、他モデル出力の検証(LLM プロンプトの脱獄検知も含む)に用います。
この次元は Jev が競っていないため、Astra の完勝です。
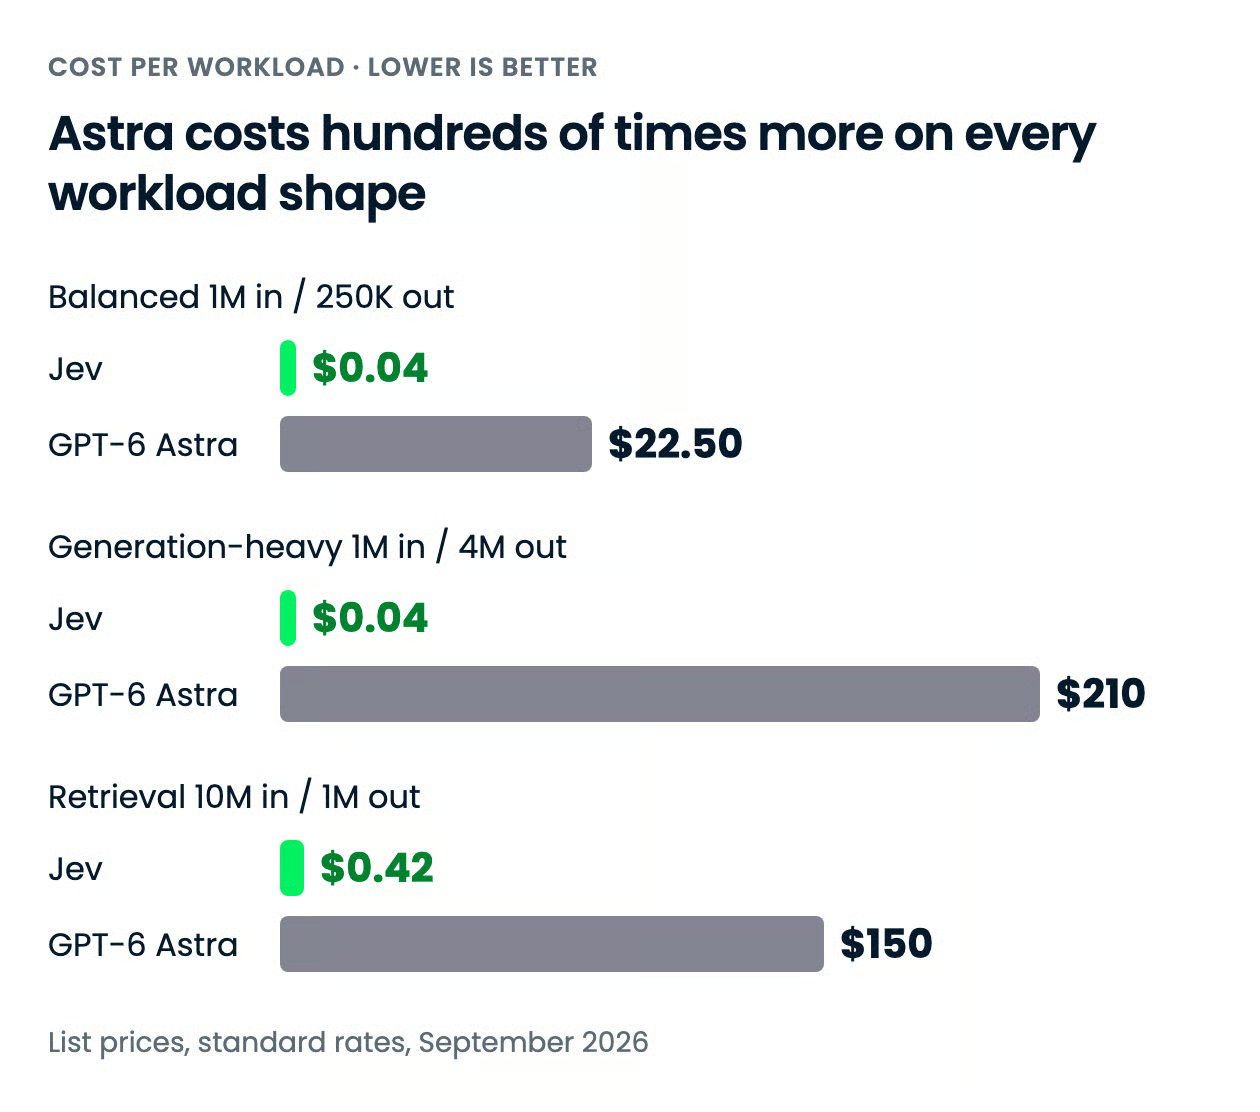
どのようなワークロード形状でも、Astra は Jev より数百倍高く、タスクが多くの出力を生むほど差は広がります。Jev は出力を課金しないためです。
| レート | Jev | GPT-6 Astra |
|---|---|---|
| 入力(100 万トークンあたり) | $0.042 | $10.00 |
| 出力(100 万トークンあたり) | 無料 | $50.00 |
| キャッシュ済み入力の読み出し(100 万トークンあたり) | 未公表 | $1.00 |
| キャッシュ書き込み(100 万トークンあたり) | 未公表 | $12.50 |
| バッチ割引 | 未公表 | 50%(Batch および Flex) |
| 長コンテキスト割増 | 未公表 | 入力とキャッシュ 2 倍、出力 1.5 倍(272K 入力トークン超) |
| Fast モード | 該当なし | 適用レートの 2 倍 |
| コンシューマ向け | 該当なし;API のみ | ChatGPT Plus、Pro、Business、Enterprise(Astra Pro は Pro 以上) |
差の大きさと同じくらい形も重要です。Astra の出力単価は入力の 5 倍で、推論トークンは出力として課金されます。そのため、思考が多い、もしくは冗長な作業ほど請求額が最も増えやすくなります。Jev は入力のみの課金で、典型的な回答は出力が数十トークンなので、コストは送る状態量だけで決まります。
TypeSafe は、この価格が補助金によらないとは証明できないと率直に述べており、値上げではなく値下げを見込んでいます。
| ワークロード | Jev | GPT-6 Astra | 差額 |
|---|---|---|---|
| バランス型:入力 100 万/出力 25 万 | $0.04 | $22.50 | $22.46(Jev が 99.8% 安い) |
| 生成多め:入力 100 万/出力 400 万 | $0.04 | $210 | $209.96(Jev が 99.98% 安い) |
| 検索(閾値未満):入力 1,000 万/出力 100 万 | $0.42 | $150 | $149.58(Jev が 99.7% 安い) |
計算式は、(ボリューム ÷ 100 万)× レートを入力と出力で合算、通常レート適用です。生成多めの行が外れ値なのは Jev の出力が無料だからで、もっとも Jev には非現実的でもあります。モデルが 400 万トークンの出力を出すことはないため、ここは出力プレミアムが Astra に与える影響と読み替えてください。検索の行は Jev の実運用に近く、状態を大量に送り、返りは少数の確率ですが、それでも 357 倍の差があります。
閾値超の検索行がないのは、TypeSafe のドキュメントに長コンテキストの割増がなく、ルーターが掲載する Jev のコンテキスト長は Astra の閾値を大きく下回るため、Astra の入力 2 倍/出力 1.5 倍の係数と比較できないからです。共有ワークロードでのトークン数はどちらも未公開で、Jev のトークナイザも非公開のため、これらの合計は請求ではなくレート比較として扱ってください。
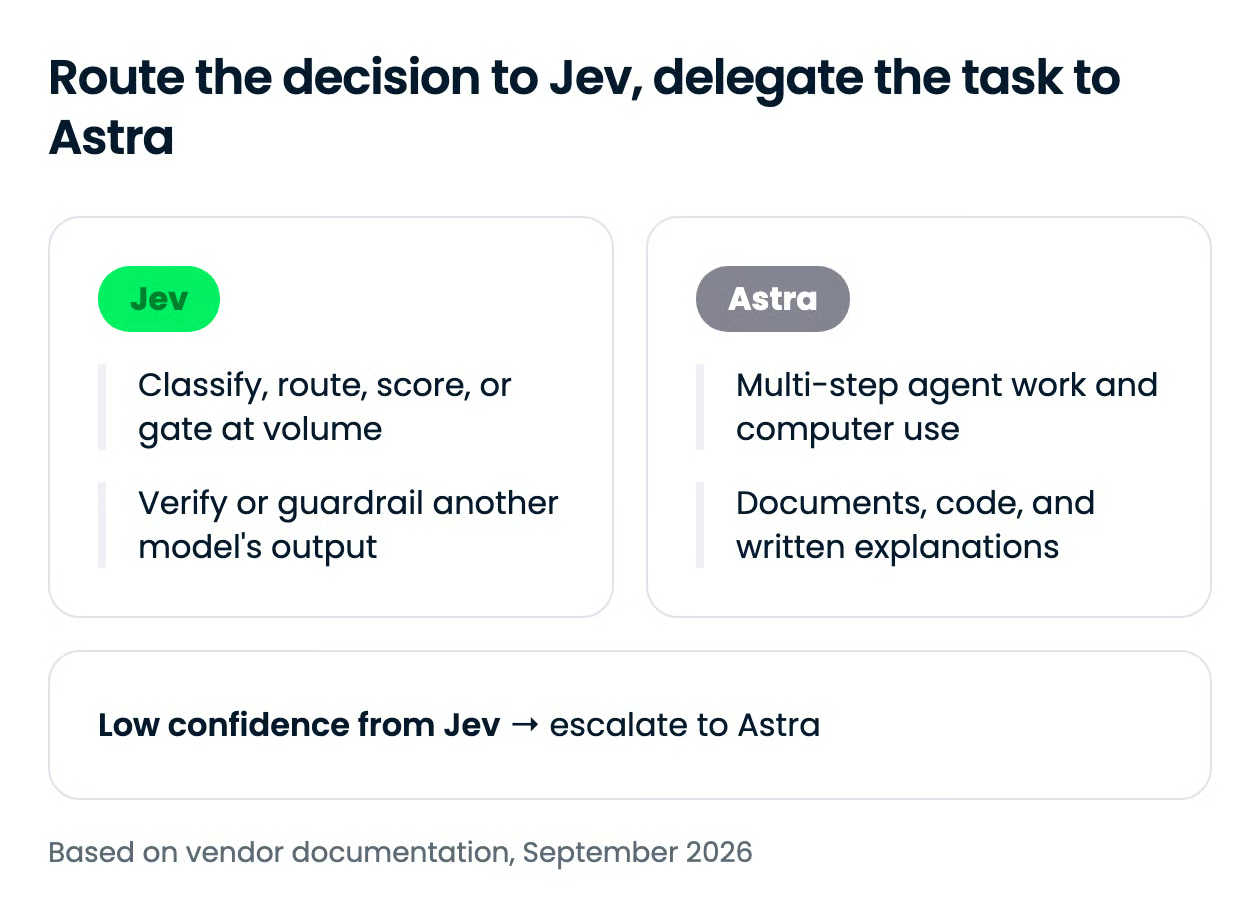
分かれ目は単独の精度や価格ではなく、そのステップが「判断」で終わるか「成果物」で終わるかです。判断は Jev、誰かが読む/実行する/開くものは Astra の領分です。
到達性は本記事で最も差が大きい軸です。Astra は通常の OpenAI モデルがある場所ならどこにでもあり、Jev はウェイトリストでゲートされた API で、招待なしの経路は OpenRouter と Vercel AI Gateway の掲載のみです。
| サーフェス | Jev | GPT-6 Astra |
|---|---|---|
| コンシューマアプリ | なし;開発者コンソールのみ | ChatGPT Plus、Pro、Business、Enterprise;ローンチ時点で Enterprise ワークスペースでは既定で無効 |
| ファーストパーティ API | TypeSafe API(ウェイトリスト経由の早期アクセスのみ);セルフサーブ登録なし | OpenAI API(Responses と Chat Completions)、ローンチ後数日にかけて段階的提供 |
| クラウドプラットフォーム | なし | Microsoft Azure AI Foundry、AWS Bedrock(us.openai.gpt-6-astra) |
| コーディングエージェント | 該当なし;テキストやツール呼び出しを生成しない | Codex、GitHub Copilot;2026 年 9 月 21 日時点で Cursor のドキュメントには未掲載 |
| サードパーティルーター | OpenRouter(typesafe/jev-1.13、専用の systemone エンドポイント経由)、Vercel AI Gateway(typesafe-ai/jev) |
OpenRouter(openai/gpt-6-astra) |
| API モデル ID | jev-latest(jev-1.13.0 のエイリアス) |
gpt-6-astra |
モデル ID は jev-latest(TypeSafe の SDK のデフォルトで、現在は jev-1.13.0 に解決)と gpt-6-astra です。信頼度の閾値を調整している場合は、エイリアスが新リリースで動くため、TypeSafe はバージョン付き ID へのピン留めを推奨します。Jev のレート制限は毎秒 250,000 トークン、毎分 1,200 リクエストで、スケールの間は予告なく変更される可能性があるとしています。
これは文字列ひとつの置換では済みません。Astra は Responses API でプロンプトを受けてテキストを返し、Jev は単一のエンドポイントで状態と型付き質問マップを受けて確率を返します。以下の 2 つのブロックは、同じ返品リクエストをそれぞれのモデルに投げ、形の違いを示しています。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidenceAstra のセットアップ全体(非同期ツールやターン途中の制御を含む)は、GPT-6 Astra API チュートリアルを参照してください。OpenAI モデルから構造化 JSON を得る方法は、構造化出力チュートリアルで解説しています。
コードが行動する「判断」で終わる工程には Jev、人が読む・実行するものに至る工程には GPT-6 Astra を使ってください。今回のローンチが示唆するアーキテクチャは両方併用です。前段に安価で較正済みのルーターとして Jev を置き、信頼度が下がったときに Astra へエスカレーションします。
特に示唆的なのは、TypeSafe が Jev を Astra の回答で採点している点です。OpenAI は最前線の方向性を自律実行だと示し、TypeSafe はソフトウェアがモデルに尋ねる多くが実は境界づけられた質問だと賭けています。Jev にとっての未解決の問いは、独立ベンチが同等性を裏づけるか、そして価格が補助抜きで持続するかです。
どちらのモデルが位置する意思決定レイヤーを構築するには、当社のDeveloping AI Systems with the OpenAI APIコースと、AI Agent Fundamentalsトラックをおすすめします。
DataCamp で AI エンジニアリングを学ぼう!
Courses
Tracks
Courses