
Cursus
AI-systemen ontwikkelen met de OpenAI API
3 Hr
22.8K
TypeSafe kwam op 15 september 2026 uit stealth met Jev, een model dat het een System One-model noemt: je stuurt programmastatus en getypeerde vragen, en het retourneert beslissingen met gekalibreerde waarschijnlijkheden in plaats van tekst. Twaalf dagen eerder bracht OpenAI GPT-6 Astra uit, dat het omschrijft als het meest intelligente en uitgelijnde model, gebouwd voor computergebruik, coderen en professioneel werk end-to-end.
In dit artikel vergelijk ik Jev en GPT-6 Astra op outputbetrouwbaarheid, beslisnauwkeurigheid, snelheid, agent-bereik en prijsstelling, en zeg ik vervolgens welke calls in een softwarepijplijn bij welk model horen.
Jev is een gehost beslismodel dat TypeSafe AI in september 2026 in early access uitbracht, het eerste van wat het System One-modellen noemt.
Het verkooppunt is dat het tekstgeneratie opgeeft: je definieert de antwoordruimte vooraf als Choice, Score of Noul (ja/nee) vragen, en het retourneert getypeerde waarden met gekalibreerde waarschijnlijkheden waarop software direct kan vertakken. Onze Jev-gids behandelt de lancering en de evaluatieclaims van TypeSafe.
GPT-6 Astra is OpenAI’s frontier-vlaggenschip, uitgebracht op 3 september 2026 als opvolger van GPT-5.6 Sol.
De positionering is autonome uitvoering: OpenAI noemt het ’s werelds beste model voor computergebruik en het meest uitgelijnde, getraind om formulieren in te vullen, een CRM bij te werken, een website te bouwen en te testen, en documenten te produceren die jouw templates volgen. Onze GPT-6 Astra-gids behandelt de lancering; onze GPT-6 Astra API-tutorial bouwt een release-check-agent met asynchrone tools.
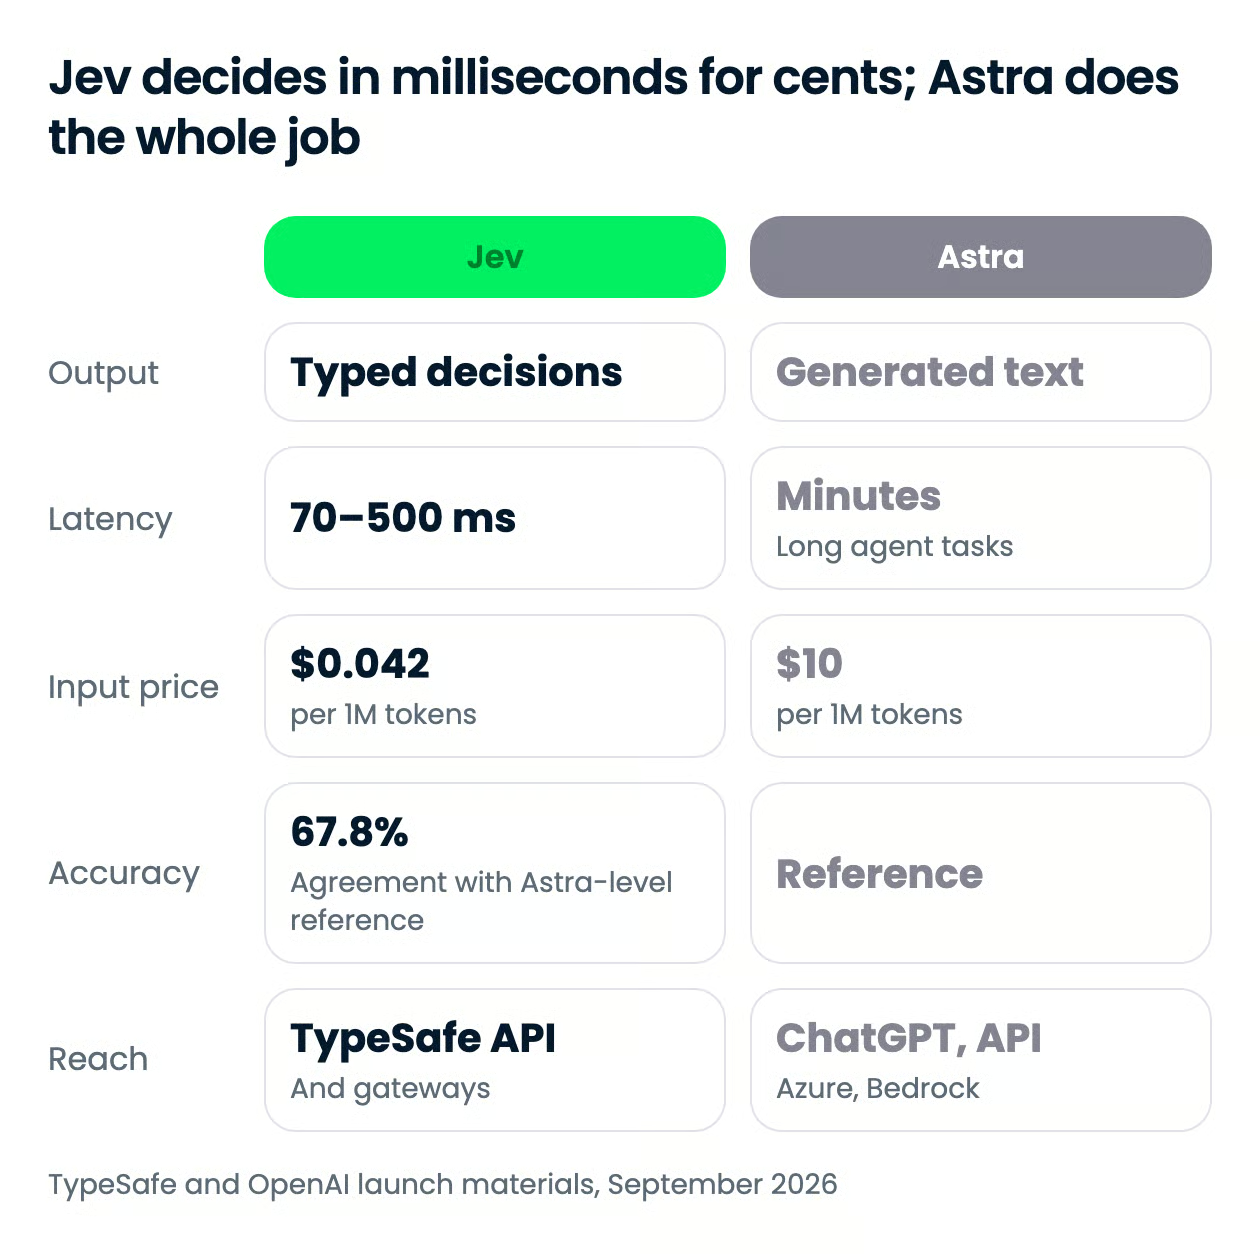
De twee modellen zitten aan tegenovergestelde kanten van één trade-off: Jev koopt snelheid, prijs en typeveiligheid door geen tekst te genereren, en Astra koopt breedte en diepte door alles te genereren. De meeste rijen hieronder volgen uit die ene ontwerpkeuze.
| Functie | Jev | GPT-6 Astra |
|---|---|---|
| Output | Getypeerde beslissingen (Choice, Score, Noul) met waarschijnlijkheden; geen tekst | Gegenereerde tekst; gestructureerde outputs en function calling ondersteund |
| Type- of schemafouten | 0% door constructie | Mogelijk; 4,2% op OpenAI’s interne hallucinatiebenchmark |
| Input | Tekst, JSON-objecten, arrays; geen afbeeldingen | Tekst en afbeeldingen |
| Contextvenster | Niet vermeld in TypeSafe’s docs; 32.000 tokens op de OpenRouter- en Vercel AI Gateway-lijsten | 1.050.000 tokens; 128.000 max output |
| End-to-end latentie | 70 tot 500 ms per call (door leverancier gerapporteerd) | Minuten bij agenttaken; ongeveer 40 minuten per OSWorld 2.0-taak |
| Beslisnauwkeurigheid | 67,8% overeenstemming met een Astra + Fable 5.1-referentie op TypeSafe’s 4-workflow-evaluatie | Is de referentie; 96,0% GPQA Diamond, 97,6% FrontierMath Tier 4 |
| Agents en tools | Geen; een beslissing binnen je code | Computergebruik, gehoste shell, webzoek, code-interpreter; 72,6% OSWorld 2.0 |
| Vertrouwen | Gekalibreerde waarschijnlijkheid bij elk antwoord, plus een afgeleide vertrouwensscore | Niet als veld blootgelegd |
| Prijs per 1M tokens | $0,042 input; output gratis | $10 input; $50 output |
| Beschikbaarheid | Early access via TypeSafe API, OpenRouter, Vercel AI Gateway | ChatGPT betaalde tiers, OpenAI API, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev kan geen ongeldig waarde produceren, en Astra kan dat wel. Dat ene feit is waarom de twee in verschillende lagen van een systeem terechtkomen in plaats van op dezelfde plek.
Een Jev-verzoek is een blok status plus een map met getypeerde vragen:
De antwoordruimte ligt voor inferentie vast, dus schema-afstemming is gegarandeerd; TypeSafe zet zijn foutpercentage voor gestructureerde output en tool-calls op 0% en noemt het cijfer niet-empirisch.
Astra vertegenwoordigt een klassieke LLM en retourneert tekst. Hoewel het gestructureerde outputs en function calling ondersteunt, en het het foutpercentage van Sol tot ongeveer een derde terugbrengt op OpenAI’s interne hallucinatiebenchmark, moet de output nog steeds geparsed en gevalideerd worden. TypeSafe’s grafiek zet de fout bij gestructureerde output van frontier-LLM’s tussen 0,58% en 45,5%; Astra’s eigen cijfer is niet gepubliceerd, dus ik zou niet aannemen dat het aan de onderkant zit.
De prijs van Jev’s garantie is dat je geen onderbouwing krijgt, alleen een waarschijnlijkheid: prima voor een routinglaag, niet voor een compliance reviewer, dus plan om low-confidence gevallen te escaleren naar een model dat kan schrijven.
Twee kanttekeningen bij de betrouwbaarheidsgetallen:
Voor output die de eerste keer moet parsen, wint Jev’s contract; voor alles wat een persoon leest, kan alleen Astra antwoorden.
Astra is nauwkeuriger. Op TypeSafe’s vier productie-workflows (incidentrespons, agent-trace-observability, factuurverwerking, klantenservice) stemt Jev 67,8% van de tijd overeen met het gemiddelde van Astra en Claude Fable 5.1, gelijk aan GPT-5.6 Terra en 5 tot 6 punten achter GPT-5.6 Sol en Claude Opus 5.
Astra is daar de referentie, dus het heeft geen eigen overeenstemmingsscore. Op zijn eigen benchmarks satureert het FrontierMath Tier 4, GPQA Diamond en ARC-AGI-3, al hangt de laatste af van een stateful harness. Jev redeneert niet over beurten heen, plant niet en legt niet uit, en het beoordelen op overeenstemming met LLM’s in plaats van met grondwaarheid, zoals TypeSafe doet, riskeert het overnemen van de biases van de referentiemodellen.
Als pieknauwkeurigheid bij een beslissing met laag volume is wat je nodig hebt, wint de LLM nog steeds.
Jev antwoordt in 70 tot 500 milliseconden end-to-end, volgens metingen van TypeSafe, vergeleken met 3 tot 329 seconden voor frontier-LLM’s bij hetzelfde soort query. Het sampelt alle antwoorden parallel in plaats van token voor token en accepteert tot 255 opties per Choice.
Astra is snel voor wat het is: ongeveer 47% minder tijd per OSWorld 2.0-taak dan Sol, en Fast-modus levert tot 2x de snelheid tegen 2x de prijs. Die taken kosten nog steeds tientallen minuten. De Doom-bot van een TypeSafe-engineer draait 10 queries per seconde voor ongeveer $7 per uur, een budget waar geen frontier-LLM aan kan tippen.
Voor een beslis-pad met een budget van 100 ms is Jev hier de enige kandidaat.
Astra doet alles wat Jev niet doet:
Jev neemt tekst, JSON of arrays van tekst, geen afbeeldingen, en roept geen tools aan. Het is de fuzzy if-statement binnen een workflow die je code bezit: classificeren, routeren, scoren, extraheren of de output van een ander model verifiëren, inclusief jailbreak-detectie op LLM-prompts.
Astra wint deze dimensie glansrijk omdat Jev hier niet aan meedoet.
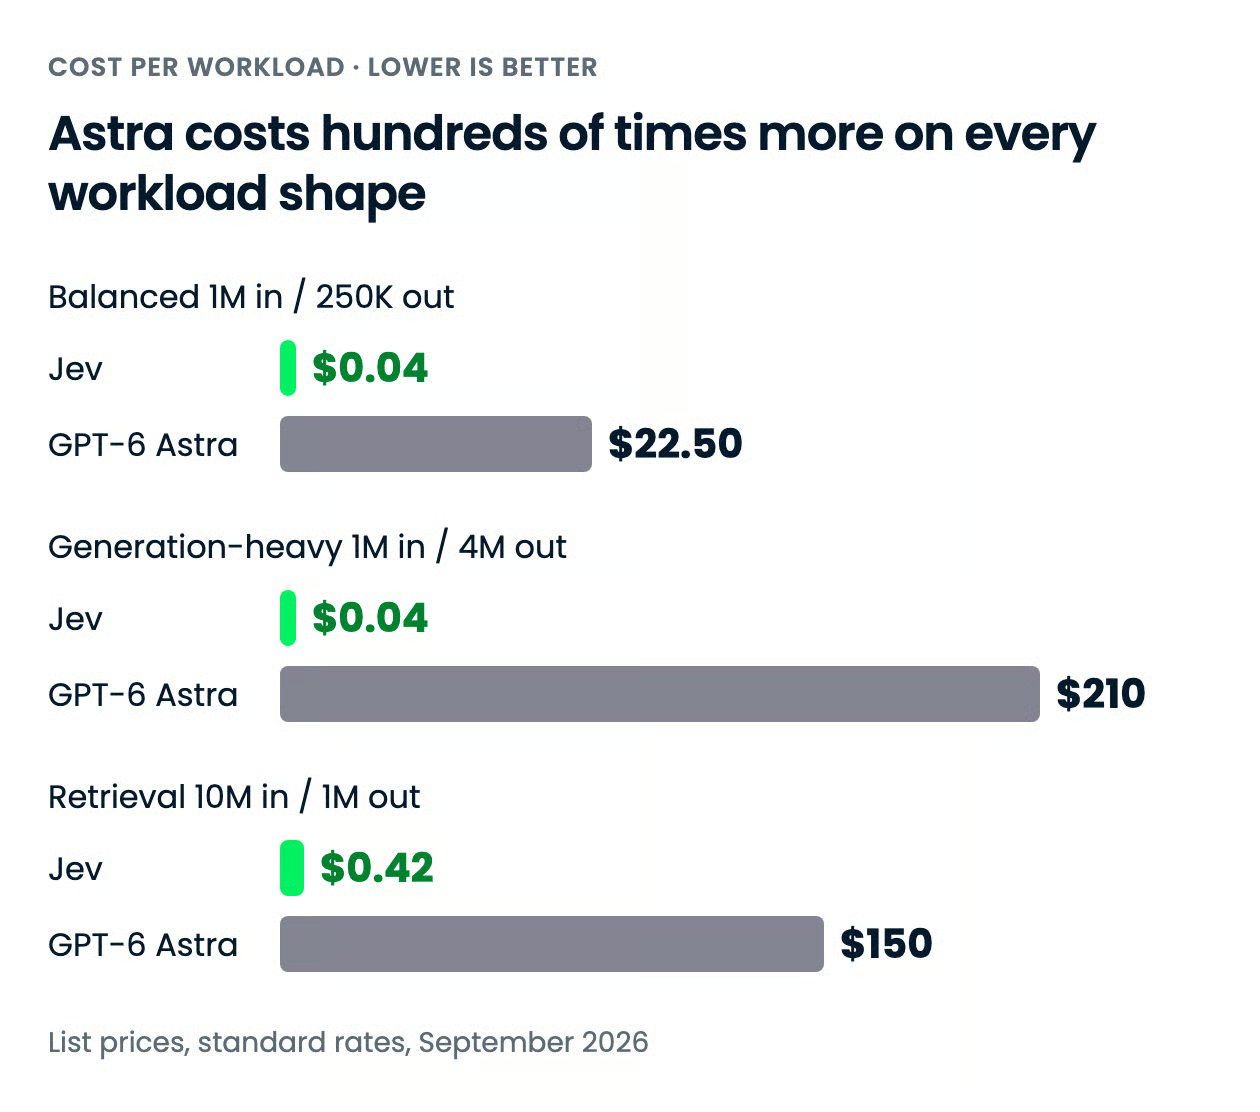
Astra kost vele honderden keren meer dan Jev bij elke workloadvorm, en het gat wordt groter naarmate de taak meer output produceert, omdat Jev output helemaal niet factureert.
| Tarief | Jev | GPT-6 Astra |
|---|---|---|
| Input, per 1M tokens | $0,042 | $10,00 |
| Output, per 1M tokens | Gratis | $50,00 |
| Gecachte input read, per 1M tokens | Niet gepubliceerd | $1,00 |
| Cache write, per 1M tokens | Niet gepubliceerd | $12,50 |
| Batchkorting | Niet gepubliceerd | 50% (Batch en Flex) |
| Toeslag lange context | Niet gepubliceerd | 2x input en cache, 1,5x output, boven 272K inputtokens |
| Fast-modus | Niet van toepassing | 2x de toepasselijke tarieven |
| Consumententier | Niet van toepassing; alleen API | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro op Pro en hoger) |
De vorm van het verschil is net zo belangrijk als de grootte. Astra’s outputtarief is 5x het inputtarief, en zijn redeneertokens worden als output gefactureerd, dus denkintensief of breedsprakig werk is waar de rekening het snelst groeit. Jev factureert alleen input, en een typisch antwoord is enkele tientallen outputtokens, dus de kosten zijn een functie van hoeveel status je verstuurt en niets anders.
TypeSafe is open dat het niet kan bewijzen dat de prijs niet gesubsidieerd is, en verwacht dat die eerder daalt dan stijgt.
| Workload | Jev | GPT-6 Astra | Verschil |
|---|---|---|---|
| Gebalanceerde assistent: 1M in / 250K uit | $0,04 | $22,50 | $22,46, Jev 99,8% goedkoper |
| Generatie-zwaar: 1M in / 4M uit | $0,04 | $210 | $209,96, Jev 99,98% goedkoper |
| Retrieval, onder drempel: 10M in / 1M uit | $0,42 | $150 | $149,58, Jev 99,7% goedkoper |
De formule is (volume ÷ 1M) × tarief, opgeteld over input en output, tegen standaardtarieven. De generatie-zware rij is de uitschieter omdat Jev’s output gratis is, al is het ook de minst realistische rij voor Jev: het model produceert nooit 4M outputtokens, dus lees dit als wat de outputpremie alleen al met Astra doet. De retrieval-rij is degene die past bij hoe Jev daadwerkelijk wordt gebruikt, veel status in en een handvol waarschijnlijkheden uit, en het is nog steeds 357x verschil.
Er is geen retrieval-rij boven de drempel omdat TypeSafe’s docs geen toeslag voor lange context vermelden, en het contextvenster dat de routers voor Jev noemen ver onder Astra’s drempel ligt, dus Astra’s 2x input- en 1,5x output-multipliers hebben hier geen vergelijkingspunt. Geen van beide leveranciers heeft tokenaantallen voor een gedeelde workload gepubliceerd, en Jev’s tokenizer is niet gedocumenteerd, dus behandel deze totalen als een tariefvergelijking in plaats van een rekening.
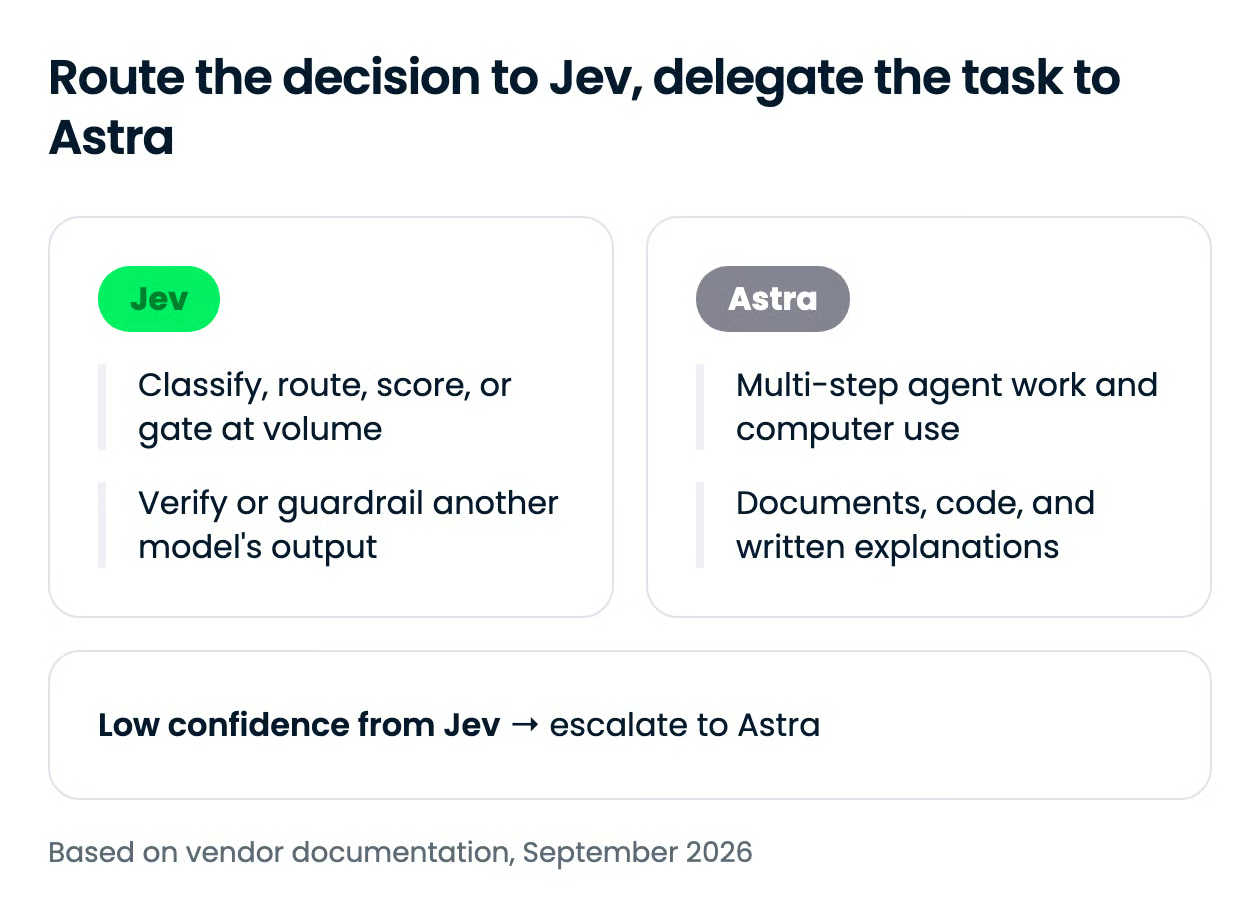
De splitsing draait niet om op zichzelf nauwkeurig of geprijsd, maar om of de stap eindigt in een beslissing of in een artefact. Een beslissing hoort bij Jev; alles wat iemand zal lezen, draaien of openen hoort bij Astra.
Bereik is de meest scheve dimensie in dit artikel: Astra is overal waar OpenAI-modellen normaal zijn, en Jev is een via wachtlijst afgeschermde API waarvan de enige routes zonder invite de OpenRouter- en Vercel AI Gateway-lijsten zijn.
| Surface | Jev | GPT-6 Astra |
|---|---|---|
| Consumentenapp | Geen; alleen developer console | ChatGPT Plus, Pro, Business en Enterprise; standaard uit voor Enterprise-werkruimtes bij lancering |
| First-party API | TypeSafe API, early access alleen via wachtlijst; geen self-serve signup | OpenAI API (Responses en Chat Completions), uitrol in de dagen na lancering |
| Cloudplatforms | Geen | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Codeeragents | Niet van toepassing; produceert geen tekst of tool-calls | Codex, GitHub Copilot; niet genoemd in de Cursor-docs per 21 september 2026 |
| Routers van derden | OpenRouter (typesafe/jev-1.13, via een dedicated systemone-endpoint), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| API-model-ID | jev-latest (alias voor jev-1.13.0) |
gpt-6-astra |
De model-ID’s zijn jev-latest, waar TypeSafe’s SDK’s standaard op staan en dat momenteel resolveert naar jev-1.13.0, en gpt-6-astra. TypeSafe raadt aan de versienummer-ID te pinnen als je vertrouwensdrempels hebt afgesteld, omdat de alias verschuift wanneer een nieuwe release uitkomt. Jev’s snelheidslimieten zijn 250.000 tokens per seconde en 1.200 requests per minuut, en TypeSafe zegt dat beide zonder waarschuwing kunnen veranderen tijdens het opschalen.
Dit is geen one-string swap. Astra neemt een prompt en retourneert tekst via de Responses API; Jev neemt status en een map met getypeerde vragen via één endpoint en retourneert waarschijnlijkheden. De twee blokken hieronder sturen hetzelfde retourverzoek naar elk model, zodat je het verschil in vorm ziet.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidenceVoor de volledige Astra-setup, inclusief async tools en mid-turn steering, volg onze GPT-6 Astra API-tutorial; voor gestructureerde JSON uit OpenAI-modellen, zie onze tutorial over gestructureerde outputs.
Als de stap eindigt in een beslissing waar je code op handelt, gebruik Jev; als het eindigt in iets dat een persoon leest of draait, gebruik GPT-6 Astra. De architectuur die deze lancering suggereert is beide tegelijk: Jev als de goedkope, gekalibreerde router vooraan, Astra als de specialist waarnaar het escaleert wanneer het vertrouwen daalt.
Wat ik het meest veelzeggend vind, is dat TypeSafe Jev beoordeelt aan de hand van Astra’s antwoorden. OpenAI doet de uitspraak dat de frontier autonome uitvoering is; TypeSafe wedt dat het meeste wat software aan een model vraagt, een begrensde vraag in vermomming is. De open vraag voor Jev is of een onafhankelijke benchmark de pariteit bevestigt en of de prijsstelling de subsidie overleeft.
Om de beslislaag te bouwen waar elk model in zit, raad ik onze cursus Developing AI Systems with the OpenAI API en onze AI Agent Fundamentals-track aan.
Leer AI Engineering met DataCamp!
Cursus
Leerpad
Cursus