
Cours
Concevoir des systèmes d’IA avec l’API OpenAI
3 h
22.8K
TypeSafe est sorti de l'ombre le 15 septembre 2026 avec Jev, un modèle qu'il qualifie de modèle System One : vous lui envoyez l'état du programme et des questions typées, et il renvoie des décisions avec des probabilités calibrées au lieu de texte. Douze jours plus tôt, OpenAI a lancé GPT-6 Astra, présenté comme son modèle le plus intelligent et le plus aligné, conçu pour l'usage du PC, le code et le travail professionnel de bout en bout.
Dans cet article, je compare Jev et GPT-6 Astra sur la fiabilité de sortie, la précision des décisions, la vitesse, le périmètre agentique et la tarification, puis j'indique à quels appels d'un pipeline logiciel affecter chaque modèle.
Jev est un modèle de décision hébergé que TypeSafe AI a publié en accès anticipé en septembre 2026, le premier de ce qu'il appelle les modèles System One.
Son argument clé est de renoncer à la génération de texte : vous définissez à l'avance l'espace de réponse en questions Choice, Score ou Noul (oui/non), et il renvoie des valeurs typées avec des probabilités calibrées sur lesquelles le logiciel peut bifurquer directement. Notre guide Jev couvre le lancement et les revendications d'évaluation de TypeSafe.
GPT-6 Astra est le vaisseau amiral de frontière d'OpenAI, lancé le 3 septembre 2026 en successeur de GPT-5.6 Sol.
Son positionnement est l'exécution autonome : OpenAI l'appelle le meilleur modèle d'usage du PC au monde et le plus aligné, entraîné pour remplir des formulaires, mettre à jour un CRM, créer et QA un site web, et produire des documents conformes à vos modèles. Notre guide GPT-6 Astra couvre le lancement ; notre tutoriel API GPT-6 Astra construit un agent de vérification de mise en production avec des outils asynchrones.
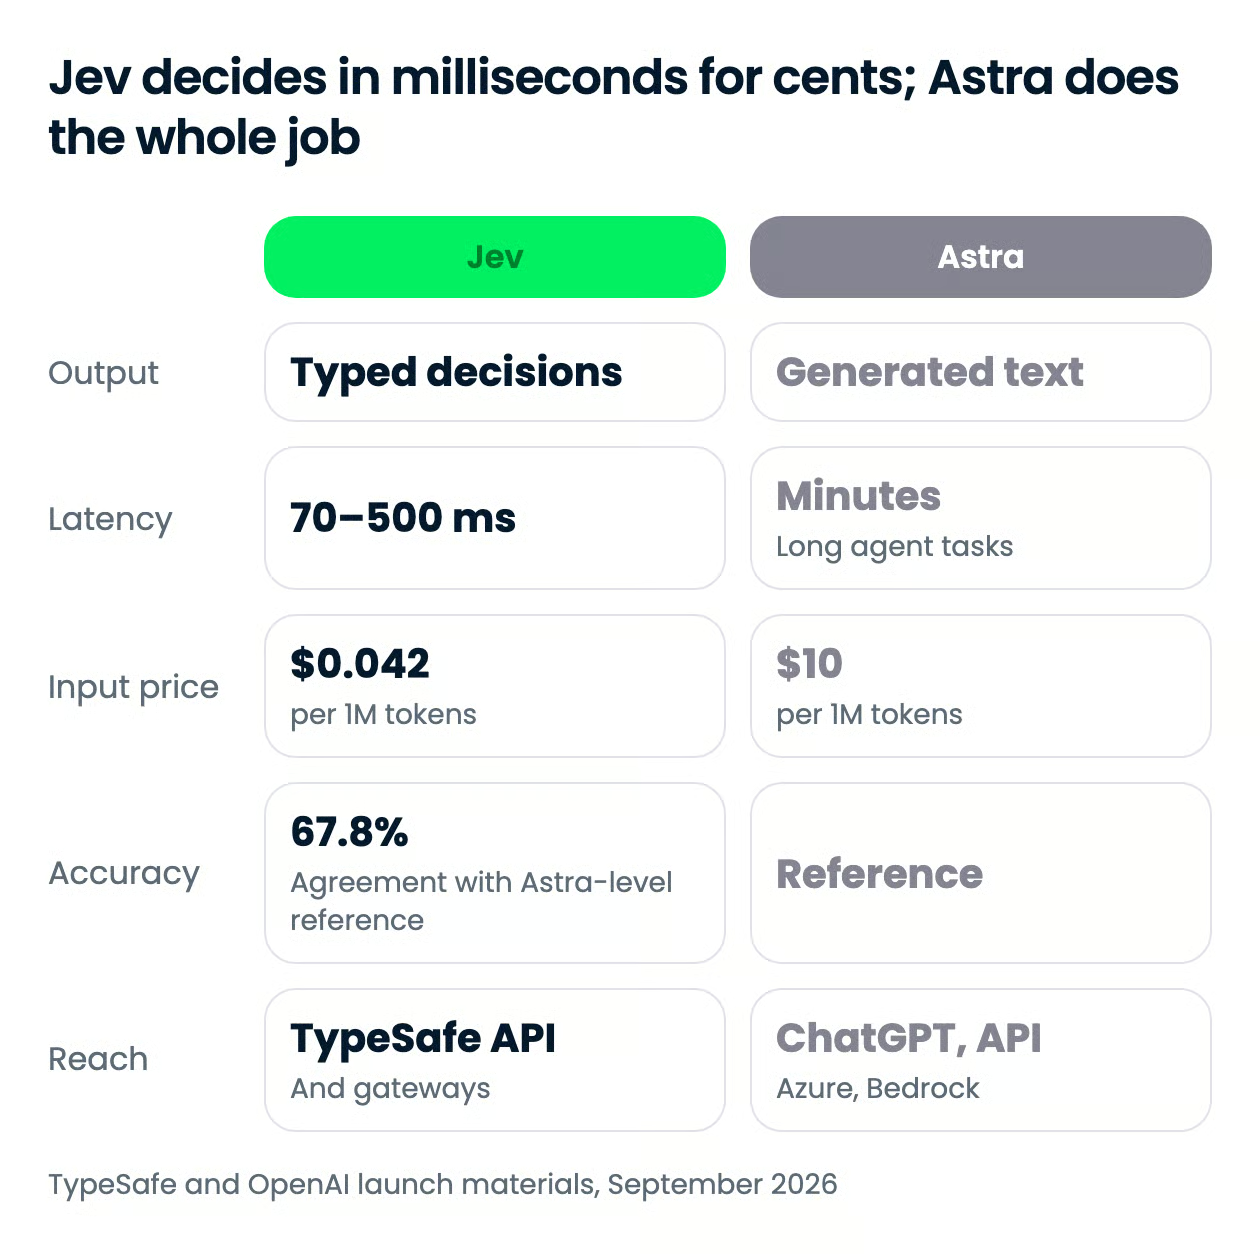
Les deux modèles se situent aux extrêmes d'un même arbitrage : Jev achète la vitesse, le prix et la sécurité de types en refusant de générer du texte, et Astra achète l'ampleur et la profondeur en générant tout. La plupart des lignes ci-dessous découlent de ce seul choix de conception.
| Caractéristique | Jev | GPT-6 Astra |
|---|---|---|
| Sortie | Décisions typées (Choice, Score, Noul) avec probabilités ; pas de texte | Texte généré ; sorties structurées et appels de fonctions pris en charge |
| Erreurs de type ou de schéma | 0 % par construction | Possibles ; 4,2 % sur le benchmark interne d'hallucination d'OpenAI |
| Entrée | Texte, objets JSON, tableaux ; pas d'images | Texte et images |
| Fenêtre de contexte | Non indiqué dans la doc TypeSafe ; 32 000 tokens sur les listings OpenRouter et Vercel AI Gateway | 1 050 000 tokens ; 128 000 max en sortie |
| Latence de bout en bout | 70 à 500 ms par appel (données éditeur) | Minutes sur des tâches d'agent ; environ 40 minutes par tâche OSWorld 2.0 |
| Précision des décisions | 67,8 % d'accord avec une référence Astra + Fable 5.1 sur l'éval 4 workflows de TypeSafe | Fait office de référence ; 96,0 % sur GPQA Diamond, 97,6 % sur FrontierMath Tier 4 |
| Agents et outils | Aucun ; une décision à l'intérieur de votre code | Usage du PC, shell hébergé, recherche web, interpréteur de code ; 72,6 % sur OSWorld 2.0 |
| Confiance | Probabilité calibrée sur chaque réponse, plus un score de confiance dérivé | Non exposé comme champ |
| Prix par 1 M de tokens | 0,042 $ en entrée ; sortie gratuite | 10 $ en entrée ; 50 $ en sortie |
| Disponibilité | Accès anticipé via l'API TypeSafe, OpenRouter, Vercel AI Gateway | Formules payantes ChatGPT, API OpenAI, Azure, AWS Bedrock, GitHub Copilot, OpenRouter |
Jev ne peut pas produire de valeur invalide, alors qu'Astra le peut. Ce seul fait explique pourquoi ils se retrouvent à des couches différentes d'un système plutôt qu'au même emplacement.
Une requête Jev est un bloc d'état plus une map de questions typées :
L'espace de réponse est figé avant l'inférence, donc la correspondance de schéma est garantie ; TypeSafe situe son taux d'erreur de sorties structurées et d'appels d'outils à 0 % et précise que ce chiffre n'est pas empirique.
Astra représente un LLM classique et renvoie du texte. Bien qu'il prenne en charge les sorties structurées et les appels de fonctions, et qu'il réduise d'environ deux tiers le taux d'erreurs de Sol sur le benchmark interne d'hallucination d'OpenAI, la sortie doit encore être parsée et validée. Le graphique de TypeSafe place l'erreur de sortie structurée des LLM de frontière entre 0,58 % et 45,5 % ; le chiffre propre à Astra n'est pas publié, je n'en déduirais donc pas qu'il se situe au bas de l'intervalle.
Le coût de la garantie de Jev est que vous n'obtenez pas de justification, seulement une probabilité : parfait pour une couche de routage, pas pour un contrôle de conformité ; prévoyez donc d'escalader les cas à faible confiance vers un modèle qui sait écrire.
Deux mises en garde sur les chiffres de fiabilité :
Pour une sortie qui doit être parsée du premier coup, le contrat de Jev l'emporte ; pour tout ce qu'une personne doit lire, seul Astra peut répondre.
Astra est plus précis. Sur les quatre workflows de production de TypeSafe (réponse à incident, observabilité des traces d'agent, traitement de factures, service client), Jev tombe d'accord avec la moyenne d'Astra et de Claude Fable 5.1 dans 67,8 % des cas, à égalité avec GPT-5.6 Terra et à 5 à 6 points derrière GPT-5.6 Sol et Claude Opus 5.
Astra est la référence ici, donc il n'a pas de score d'accord propre. Sur ses propres benchmarks, il sature FrontierMath Tier 4, GPQA Diamond et ARC-AGI-3, même si ce dernier dépend d'un harnais avec état. Jev ne raisonne pas sur plusieurs tours, ne planifie pas et n'explique pas, et l'évaluer sur l'accord avec des LLM plutôt que sur la vérité terrain, comme le fait TypeSafe, risque d'hériter des biais des modèles de référence.
Si vous avez besoin de la précision maximale sur une décision à faible volume, le LLM reste gagnant.
Jev répond en 70 à 500 millisecondes de bout en bout, selon les mesures de TypeSafe, contre 3 à 329 secondes pour des LLM de frontière sur le même type de requête. Il échantillonne toutes les réponses en parallèle plutôt qu'un token à la fois et accepte jusqu'à 255 options par Choice.
Astra est rapide pour ce qu'il est : environ 47 % de temps en moins par tâche OSWorld 2.0 que Sol, et le mode Fast double la vitesse pour un prix doublé. Ces tâches prennent toutefois des dizaines de minutes. Le bot Doom d'un ingénieur TypeSafe exécute 10 requêtes par seconde pour environ 7 $ de l'heure, un budget qu'aucun LLM de frontière ne peut tenir.
Pour un chemin de décision avec 100 ms de budget, Jev est le seul candidat ici.
Astra fait tout ce que Jev ne fait pas :
Jev accepte du texte, du JSON ou des tableaux de texte, pas d'images, et n'appelle aucun outil. C'est l'instruction conditionnelle floue au sein d'un workflow dont votre code est propriétaire : classer, router, scorer, extraire, ou vérifier la sortie d'un autre modèle, y compris la détection de jailbreak sur des prompts LLM.
Astra l'emporte largement sur cette dimension, car Jev n'y concourt pas.
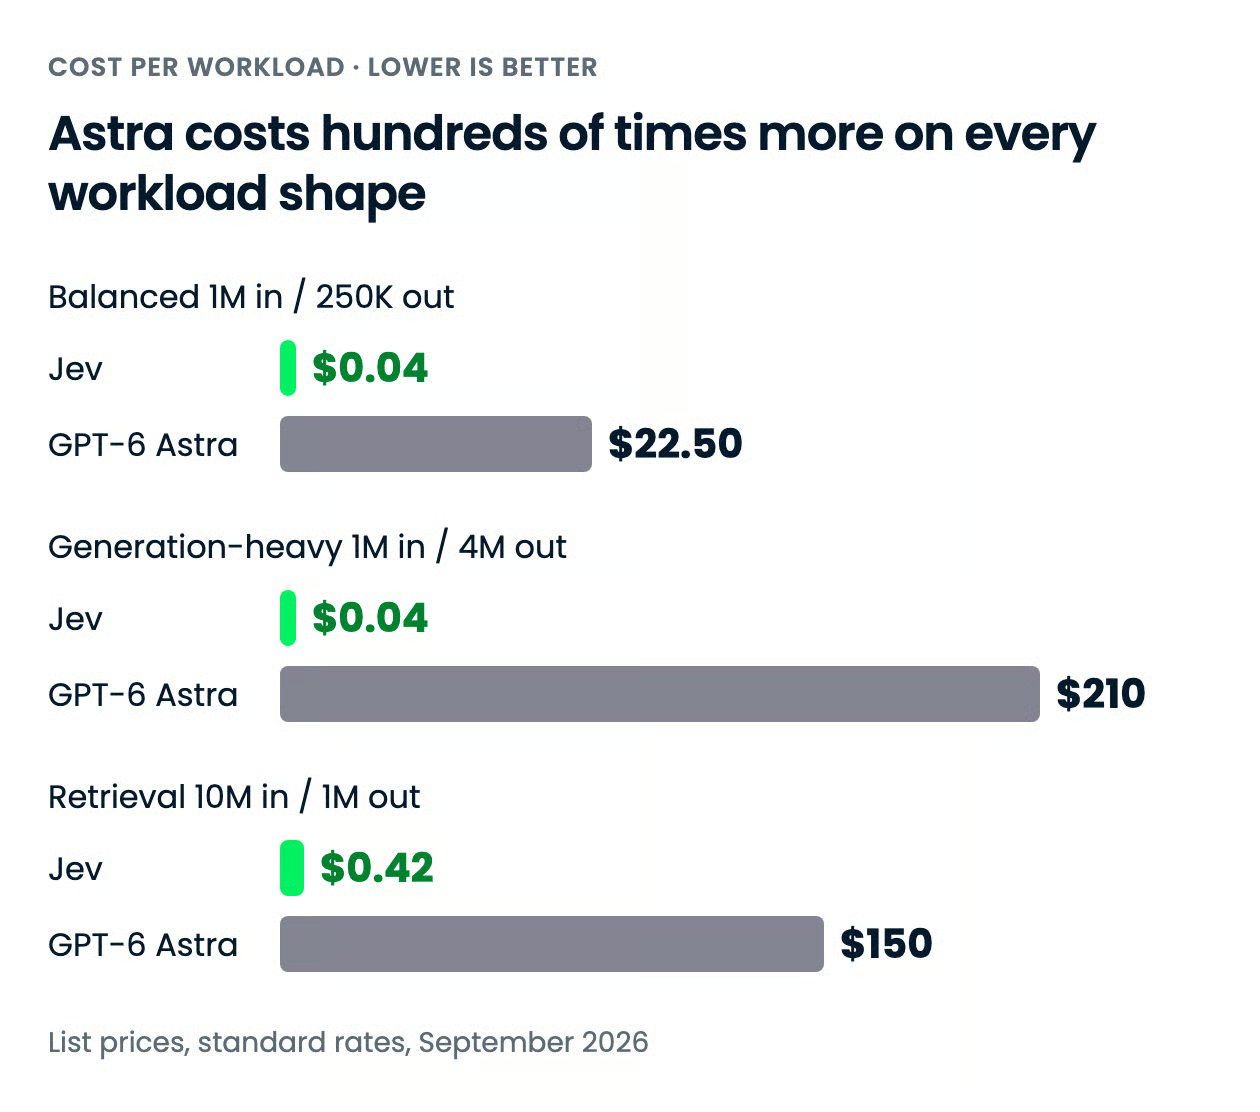
Astra coûte plusieurs centaines de fois plus que Jev sur n'importe quelle forme de charge, et l'écart se creuse à mesure que la tâche produit plus de sortie, puisque Jev ne facture pas la sortie.
| Tarif | Jev | GPT-6 Astra |
|---|---|---|
| Entrée, par 1 M de tokens | 0,042 $ | 10,00 $ |
| Sortie, par 1 M de tokens | Gratuit | 50,00 $ |
| Lecture de cache d'entrée, par 1 M de tokens | Non publié | 1,00 $ |
| Écriture de cache, par 1 M de tokens | Non publié | 12,50 $ |
| Remise batch | Non publié | 50 % (Batch et Flex) |
| Surcoût long contexte | Non publié | 2x en entrée et cache, 1,5x en sortie, au-delà de 272K tokens en entrée |
| Mode Fast | Sans objet | 2x les tarifs applicables |
| Offre grand public | Sans objet ; API uniquement | ChatGPT Plus, Pro, Business, Enterprise (Astra Pro sur Pro et au-dessus) |
La forme de la différence compte autant que sa taille. Le tarif de sortie d'Astra est 5x son tarif d'entrée, et ses tokens de raisonnement sont facturés en sortie, donc les travaux intensifs en réflexion ou verbeux sont ceux où la facture augmente le plus vite. Jev ne facture que l'entrée, et une réponse typique représente quelques dizaines de tokens en sortie, donc son coût dépend uniquement de la quantité d'état envoyée.
TypeSafe reconnaît ne pas pouvoir prouver que la tarification n'est pas subventionnée, et s'attend à ce qu'elle baisse plutôt qu'elle n'augmente.
| Charge | Jev | GPT-6 Astra | Écart |
|---|---|---|---|
| Assistant équilibré : 1 M entrée / 250 K sortie | 0,04 $ | 22,50 $ | 22,46 $, Jev 99,8 % moins cher |
| Génération lourde : 1 M entrée / 4 M sortie | 0,04 $ | 210 $ | 209,96 $, Jev 99,98 % moins cher |
| Recherche, sous seuil : 10 M entrée / 1 M sortie | 0,42 $ | 150 $ | 149,58 $, Jev 99,7 % moins cher |
La formule est (volume ÷ 1 M) × tarif, sommée entre entrée et sortie, aux tarifs standards. La ligne « génération lourde » est atypique parce que la sortie de Jev est gratuite, mais c'est aussi la ligne la moins réaliste pour Jev : le modèle n'émet jamais 4 M de tokens en sortie, lisez-la donc comme l'effet du seul premium de sortie sur Astra. La ligne « recherche » reflète l'usage réel de Jev : beaucoup d'état en entrée et une poignée de probabilités en sortie, et l'écart reste de 357x.
Il n'y a pas de ligne « au-dessus du seuil » pour la recherche car la doc de TypeSafe n'indique aucun surcoût long contexte, et la fenêtre de contexte listée par les routeurs pour Jev est bien en deçà du seuil d'Astra ; les multiplicateurs 2x en entrée et 1,5x en sortie d'Astra n'ont donc pas d'équivalent à comparer. Aucun des éditeurs n'a publié de comptage de tokens sur une charge partagée, et le tokenizer de Jev n'est pas documenté, considérez donc ces totaux comme une comparaison de tarifs plutôt qu'une facture.
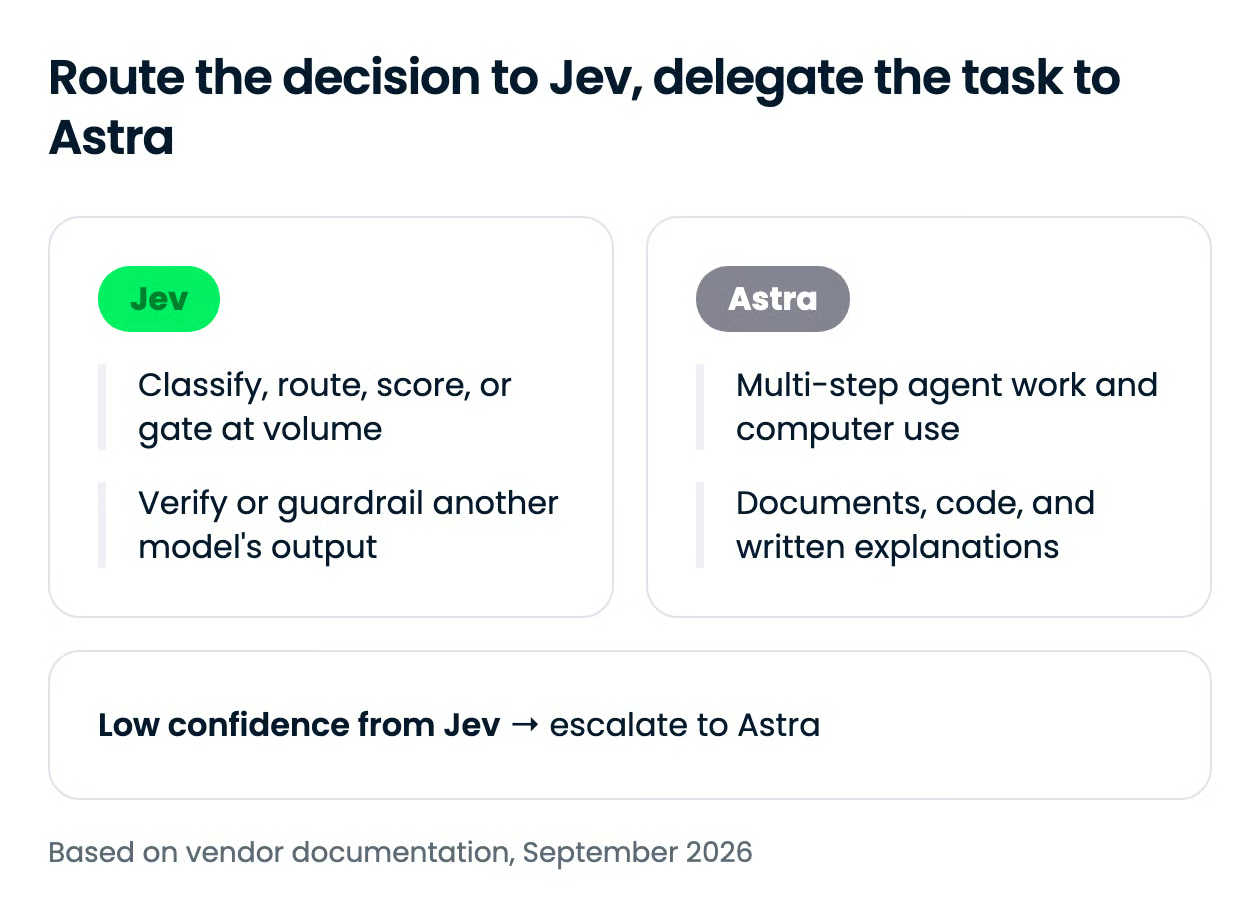
Le critère n'est ni la précision ni le prix isolément, mais la nature de l'aboutissement : une décision ou un artefact. Une décision revient à Jev ; tout ce qu'une personne lira, exécutera ou ouvrira revient à Astra.
La portée est la dimension la plus déséquilibrée de cet article : Astra est partout où les modèles OpenAI sont habituellement disponibles, et Jev est une API à liste d'attente dont les seuls points d'accès sans invitation sont les listings OpenRouter et Vercel AI Gateway.
| Surface | Jev | GPT-6 Astra |
|---|---|---|
| Application grand public | Aucune ; console développeur uniquement | ChatGPT Plus, Pro, Business et Enterprise ; désactivé par défaut pour les espaces Enterprise au lancement |
| API éditeur | API TypeSafe, accès anticipé via liste d'attente uniquement ; pas d'inscription en libre-service | API OpenAI (Responses et Chat Completions), déploiement progressif après le lancement |
| Plateformes cloud | Aucune | Microsoft Azure AI Foundry, AWS Bedrock (us.openai.gpt-6-astra) |
| Agents de code | Sans objet ; ne produit ni texte ni appels d'outils | Codex, GitHub Copilot ; non listé dans la doc Cursor au 21 septembre 2026 |
| Routeurs tiers | OpenRouter (typesafe/jev-1.13, via un endpoint systemone dédié), Vercel AI Gateway (typesafe-ai/jev) |
OpenRouter (openai/gpt-6-astra) |
| ID de modèle API | jev-latest (alias de jev-1.13.0) |
gpt-6-astra |
Les IDs de modèle sont jev-latest, valeur par défaut des SDK TypeSafe et qui résout actuellement vers jev-1.13.0, et gpt-6-astra. TypeSafe recommande d'épingler l'ID versionné si vous avez ajusté des seuils de confiance, car l'alias bouge à chaque nouvelle version. Les limites de débit de Jev sont de 250 000 tokens par seconde et 1 200 requêtes par minute, et TypeSafe indique qu'elles peuvent changer sans préavis pendant la montée en charge.
Ce ne sont pas des remplacements « une chaîne pour une chaîne ». Astra prend un prompt et renvoie du texte via l'API Responses ; Jev prend un état et une map de questions typées via un unique endpoint et renvoie des probabilités. Les deux blocs ci-dessous formulent la même demande de retour à chaque modèle, pour visualiser la différence de forme.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="A bike-shop customer writes: 'The frame arrived scratched, I want this "
          "sorted before my race on Sunday.' Resolve as refund, replacement, or repair.",
)
print(response.output_text)  # free text you still have to parse
import requests
response = requests.post(
"https://api.typesafe.ai/v1/systemone",
headers={"Authorization": "Bearer YOUR_TYPESAFE_KEY"},
json={
"model": "jev-latest",
"state": "The frame arrived scratched, I want this sorted before my race on Sunday.",
"questions": {
"resolution": {
"type": "choice",
"instructions": "How should the shop resolve this return?",
"criteria": {"refund": "Customer wants money back",
"replacement": "Same item, undamaged, shipped fast",
"repair": "Cosmetic fix is acceptable"},
}
},
},
)
answer = response.json()["answers"]["resolution"]
print(answer["choice"], answer["confidence"]) # typed option plus 0-1 confidencePour la configuration complète d'Astra, y compris les outils asynchrones et le pilotage en cours de tour, suivez notre tutoriel API GPT-6 Astra ; pour obtenir du JSON structuré depuis les modèles OpenAI, consultez notre tutoriel sur les sorties structurées.
Si l'étape aboutit à une décision sur laquelle votre code agit, utilisez Jev ; si elle aboutit à quelque chose qu'une personne lira ou exécutera, utilisez GPT-6 Astra. L'architecture que ce lancement suggère combine les deux : Jev comme routeur bon marché et calibré en frontal, Astra comme spécialiste vers lequel il escalade quand la confiance baisse.
Ce que je trouve le plus parlant, c'est que TypeSafe note Jev par rapport aux réponses d'Astra. OpenAI affirme que la frontière, c'est l'exécution autonome ; TypeSafe parie que la plupart des demandes logicielles à un modèle sont des questions bornées déguisées. La question ouverte pour Jev est de savoir si un benchmark indépendant confirmera la parité et si la tarification survivra à la subvention.
Pour construire la couche de décision où s'insère chaque modèle, je vous recommande notre cours Developing AI Systems with the OpenAI API et notre parcours AI Agent Fundamentals.
Formez-vous à l'ingénierie de l'IA avec DataCamp !
Cours
Cursus
Cours