Kursus
AI generatif AWS mewakili masa depan layanan cloud karena memungkinkan bisnis membuat konten otomatis dan pekerjaan berbasis pengetahuan melalui model fondasi yang menghasilkan teks, gambar, dan video secara real time.
Dalam artikel ini, saya menyajikan gambaran komprehensif tentang elemen penting metode penerapan dan kerangka tata kelola yang diperlukan untuk mengembangkan solusi AI generatif siap produksi.
AWS adalah penyedia cloud terdepan karena menawarkan Amazon Bedrock bersama infrastruktur komputasi khusus dan kemampuan integrasi luas yang melampaui platform cloud lainnya.
Jika Anda baru menggunakan AWS, kursus pengantar ini menyediakan landasan yang kuat sebelum mendalami spesifik AI generatif.
Memahami Komponen Inti
Di bagian ini, kita akan menelusuri blok bangunan yang menggerakkan AI generatif AWS.
Ekosistem model fondasi
Bedrock berfungsi sebagai control plane terkelola untuk seluruh AI generatif di AWS. Layanan ini mengekspos API yang konsisten untuk menerapkan, menskalakan, dan mengamankan model fondasi dari penyediaan endpoint hingga penagihan, sehingga Anda dapat fokus pada perancangan prompt dan integrasi AI alih-alih mengelola infrastruktur.
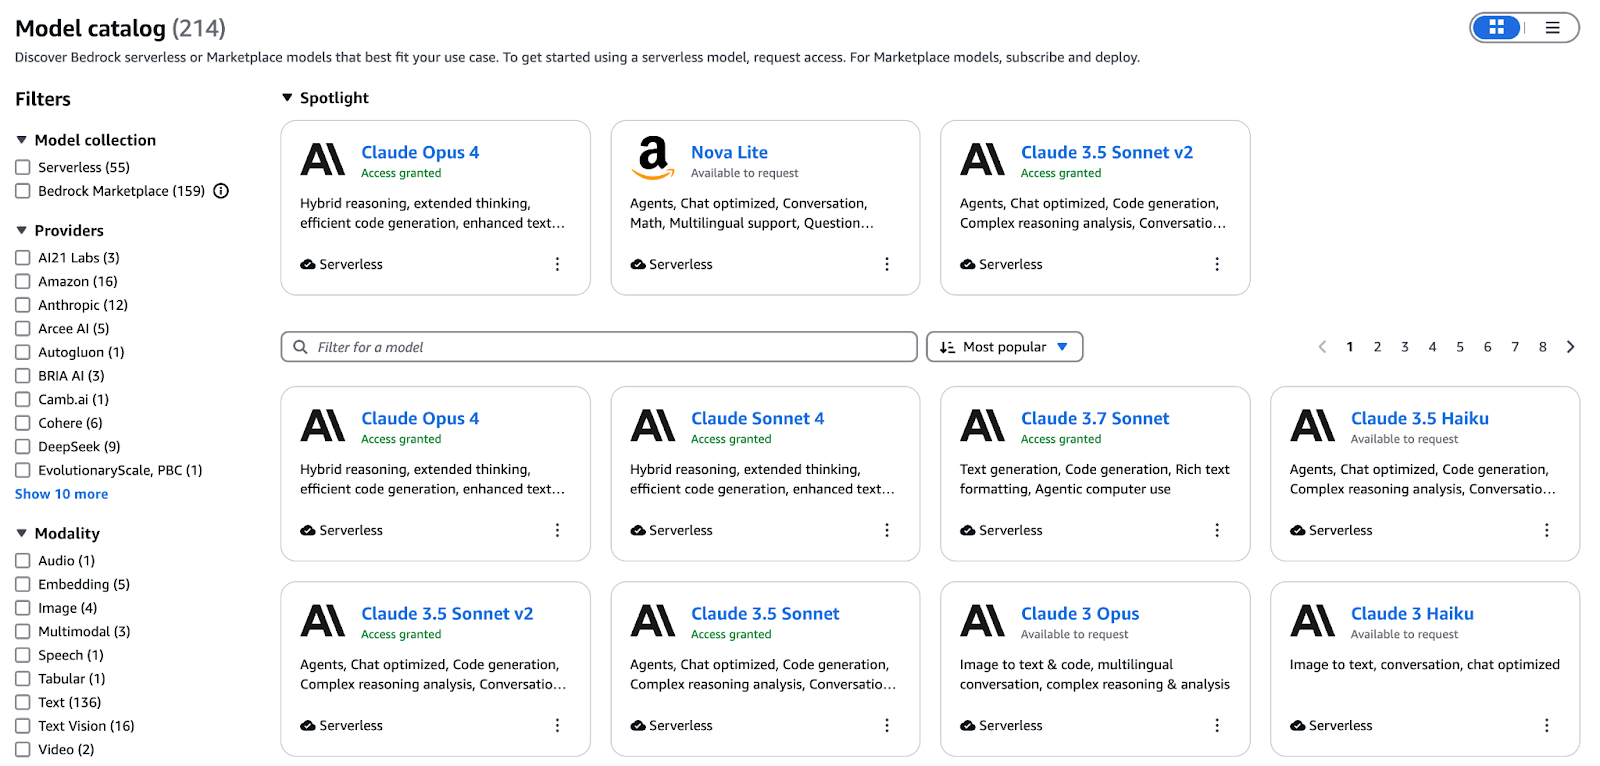
Diagram konseptual yang menggambarkan ekosistem model fondasi AWS
Katalog Bedrock menyatukan model untuk teks, gambar, video, dan embedding dalam satu antarmuka. Penawaran utama meliputi:
- Titan Text (Premier, Express, Lite): Jendela konteks hingga 32K token untuk dialog kompleks
- Nova Canvas: Pembuatan teks-ke-gambar berfidelitas tinggi dan inpainting untuk aset kreatif yang aman bagi merek
- Nova Reel: Klip video animasi pendek yang dihasilkan dari satu prompt
- Titan Multimodal Embeddings G1: Mengenkode teks dan gambar ke dalam ruang vektor bersama untuk pencarian kemiripan dan RAG
Fine-tune model pada data berlabel Anda atau lanjutkan pra-pelatihan pada korpus khusus domain melalui konsol atau SDK Bedrock. Setelah pelatihan selesai, suite evaluasi Bedrock menjalankan perbandingan berdampingan yang melaporkan akurasi, latensi, dan biaya per token sehingga Anda dapat secara objektif memilih varian optimal untuk SLA produksi.
Di luar keluarga Titan dan Nova milik AWS, Bedrock memberi Anda akses ke model mitra dari Anthropic, Cohere, Mistral, AI21 Labs, dan lainnya. Manfaatkan keluasan ini untuk:
- Membangun asisten pengetahuan bertenaga RAG yang menampilkan jawaban tepat dari wiki internal
- Menghasilkan salinan pemasaran dan gambar dalam skala besar dengan suara merek yang konsisten
- Menyematkan pelengkapan dan peninjauan kode berbasis AI ke dalam alur kerja pengembang
- Menambah dataset pelatihan dengan mensintesis teks, gambar, atau video yang disesuaikan dengan domain Anda
Untuk mendalami bagaimana Bedrock mengorkestrasi model fondasi ini di lingkungan produksi, silakan baca panduan lengkap Amazon Bedrock.
Infrastruktur komputasi yang dioptimalkan AI
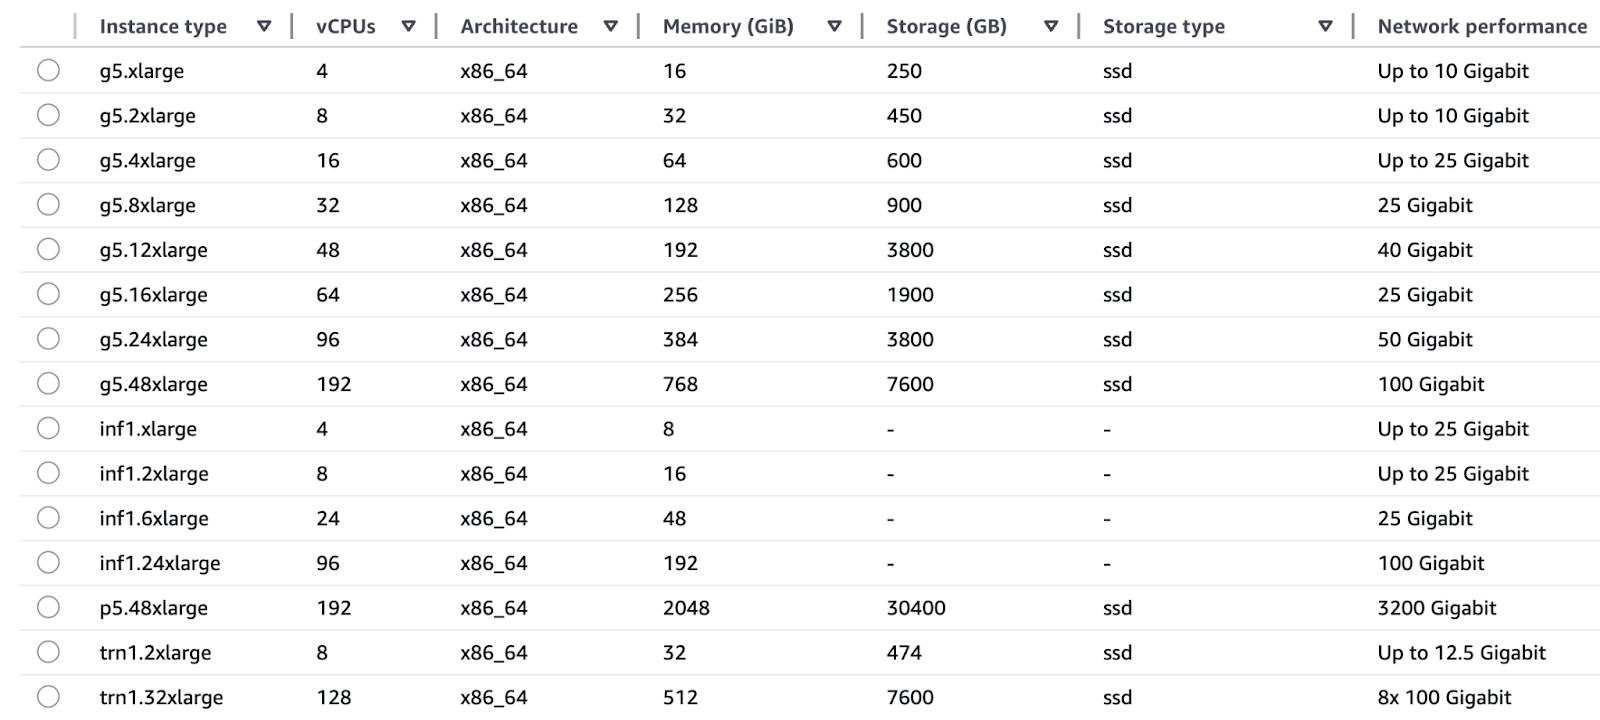
Keluarga instance EC2 yang disediakan AWS ada untuk memenuhi kebutuhan berbeda dari operasi pelatihan dan inferensi.
Pelatihan:
- Instance Trn1 (Trainium) beroperasi dengan chip AWS Trainium untuk menyediakan kemampuan pelatihan deep learning, termasuk LLM dan model difusi, dengan kecepatan 3 kali lebih tinggi dan biaya per jam lebih rendah dibandingkan instance berbasis GPU.
- P5 dan P4 (GPU NVIDIA H100 dan A100) menawarkan kemampuan pemrosesan paralel yang luas melalui dukungan presisi campuran, yang cocok untuk pengujian tingkat riset dan proses pelatihan ulang produksi berskala besar.
Inferensi:
- Chip AWS Inferential yang digunakan pada sistem Inf1 dan Inf2 memungkinkan inferensi real-time dengan latensi dalam hitungan milidetik tunggal sekaligus memberikan biaya per inferensi 2× lebih rendah daripada alternatif GPU.
- G5 dan G4dn (GPU NVIDIA A10G dan T4) memberikan keseimbangan kinerja yang hemat biaya dan cocok untuk akselerasi GPU real-time pada aplikasi chatbot dan mesin rekomendasi.

Diagram ilustratif tentang infrastruktur komputasi AWS yang dioptimalkan untuk AI.
AWS mencapai integrasi mulus antara perangkat keras dan komponen perangkat lunaknya yang dirancang khusus melalui Trainium untuk pelatihan dan Inferentia untuk chip inferensi, yang bekerja langsung dengan layanan AWS. Integrasi vertikal ini menghasilkan:
- Rasio harga-kinerja unggul di seluruh beban kerja TensorFlow dan PyTorch yang mengarah pada total biaya kepemilikan lebih rendah.
- Kombinasi efisiensi energi dan penyediaan yang disederhanakan membantu tim keluar dari penguncian vendor GPU.
- SageMaker dan Bedrock menerapkan fitur right-sizing otomatis yang memungkinkan pengguna memilih konfigurasi silikon optimal melalui beberapa klik tanpa perlu mengelola detail tingkat chip.
AWS Nitro System menggunakan kartu perangkat keras khusus untuk melakukan fungsi virtualisasi, sehingga menghadirkan kecepatan bare-metal yang cepat bersamaan dengan isolasi yang aman:
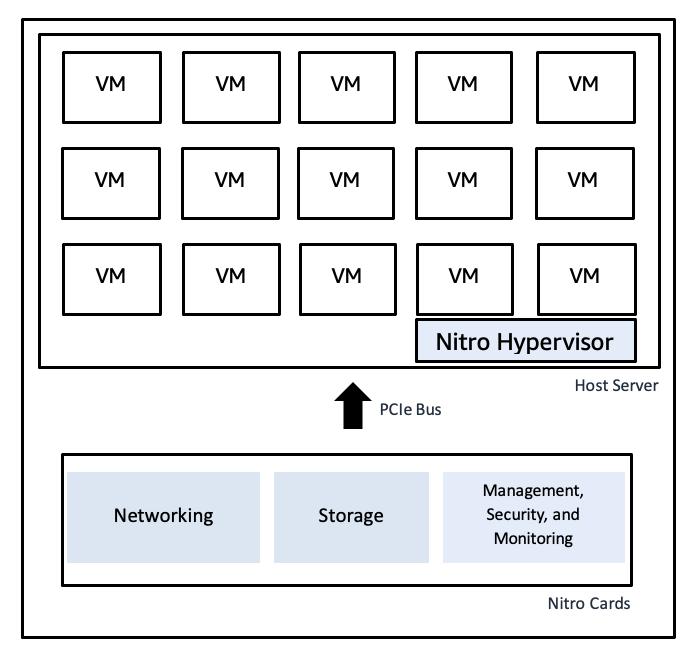
- Nitro Hypervisor mempertahankan basis kode minimal, yang mengurangi kerentanan sekaligus menjaga beban kerja tetap terpisah satu sama lain.
- Jalur jaringan dan penyimpanan yang dipercepat perangkat keras beroperasi pada throughput I/O tinggi dan tingkat jitter rendah, yang mencegah lonjakan latensi untuk menghadirkan kinerja beban puncak yang konsisten.
- Integrasi Nitro dengan CloudTrail, CloudWatch, dan AWS Config menyediakan pemantauan kepatuhan end-to-end tanpa penurunan kinerja.
Diagram ilustratif tentang Nitro Hypervisor AWS
Jelajahi ekosistem komputasi, penyimpanan, dan analitik yang lebih luas dalam kursus AWS Cloud Technology and Services.
Fondasi data untuk AI generatif yang tangguh
Pelatihan model berkecepatan tinggi dan pipeline RAG memerlukan akses ke data yang bersih dan tertata kelolanya dengan baik:
- Sistem penyimpanan data skala petabita Amazon S3 terintegrasi dengan Lake Formation untuk pengkatalogan dan fitur keamanan saat pemasukan dataset mentah dan terkurasi.
- Solusi gudang data Amazon Redshift beroperasi sebagai platform untuk tabel terstruktur yang menyediakan analitik dan pengambilan data cepat.
- Pipeline transformasi data yang dibangun dengan AWS Glue dan Athena memungkinkan persiapan fitur dan konteks untuk beban kerja generatif serta eksekusi kueri ad-hoc.
- Mekanisme tata kelola dan garis keturunan data memastikan pelatihan model menggunakan input tepercaya sementara pengetahuan perusahaan membumikan output melalui kontrol akses dan pelacakan asal.
Kerangka integrasi enterprise
Kemampuan AI generatif AWS terintegrasi langsung dengan ekosistem yang lebih luas untuk menghadirkan solusi kelas produksi end-to-end. Bagian ini menjelaskan proses menggabungkan Bedrock dengan layanan pendampingnya untuk mengembangkan aplikasi AI generatif nyata.
Siklus hidup ML terpadu dengan SageMaker JumpStart dan Bedrock
Pilih model fondasi dari hub model SageMaker JumpStart dan langsung terapkkan. Anda dapat menerapkan banyak model open-source dan proprietari melalui satu tombol sebelum mendaftarkannya langsung ke Amazon Bedrock. Model yang dimasukkan ke Bedrock mendapatkan akses ke:
- Moderasi konten dan penegakan kebijakan melalui fitur guardrail.
- Knowledge base menyediakan kemampuan Retrieval-Augmented Generation (RAG) untuk sumber data privat.
- Converse API menjaga konsistensi dengan menyediakan lapisan abstraksi yang menghilangkan variasi spesifik model.
Arsitektur terintegrasi memungkinkan pengembang membuat prototype di SageMaker Studio lalu meningkatkannya di Bedrock sebelum menerapkan melalui pipeline CI/CD tanpa modifikasi kode.
Tutorial SageMaker ini memandu proses fine-tuning dan penerapan model menggunakan platform ML andalan AWS.
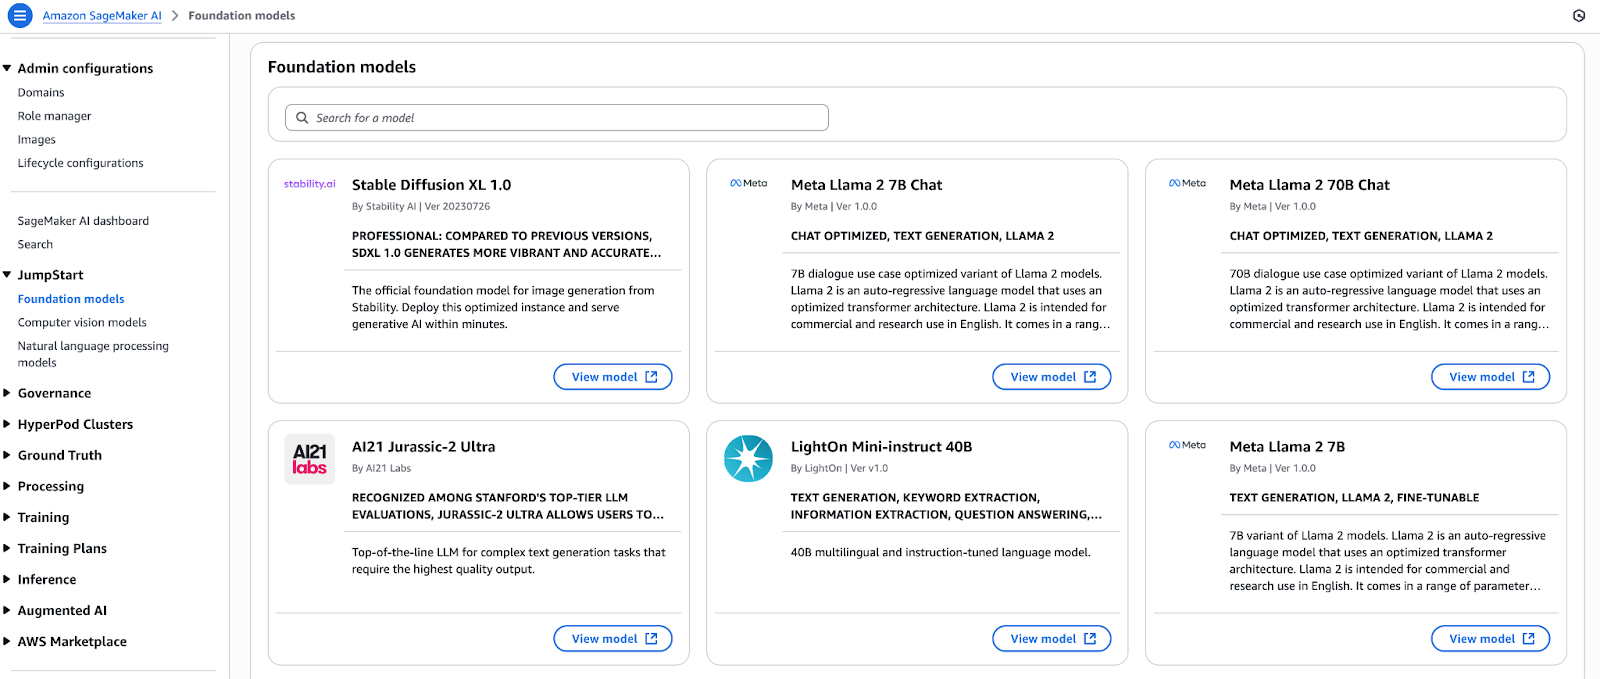
Diagram ilustratif yang menampilkan siklus hidup ML terpadu dengan SageMaker JumpStart dan Bedrock.
Mengorkestrasi alur kerja dengan Amazon Bedrock Agents
Melalui Bedrock Agents, Anda dapat mengintegrasikan AI generatif ke dalam aplikasi operasional dengan otomatis mengambil data dan mentransformasikannya sebelum mengeksekusi tindakan. Agent hanya memerlukan konfigurasi dasar untuk:
- Sistem membangun koneksi aman ke API RESTful serta database dan antrian pesan.
- Sistem menerima dokumen, metrik, dan data log sambil melakukan pra-pemrosesan sebelum membuat data tersedia bagi model.
- Sistem menjalankan beberapa operasi latar belakang, termasuk validasi pengayaan dan notifikasi melalui pemanggilan fungsi berurutan.
- Sistem menghasilkan output terstruktur atau percakapan untuk dikonsumsi sistem hilir.
Fungsi plumbing dari Agents memungkinkan pengembang berfokus pada logika bisnis alih-alih kode integrasi, sehingga mempercepat time-to-value.
Membangun asisten percakapan dengan Amazon Q
Amazon Q berfungsi sebagai layanan terkelola penuh untuk membangun asisten bisnis bertenaga RAG.
Layanan ini mengintegrasikan fungsi multi-model Bedrock dengan:
- Konektor gudang data (Redshift), mesin pencari (OpenSearch), dan alat BI yang telah dikonfigurasi sebelumnya.
- Sistem menyertakan fitur terintegrasi untuk mengelola dialog multi-giliran serta konteks sesi dan pembuatan respons bergaya sitasi.
- Platform menampilkan alat pengembangan antarmuka pengguna low-code untuk membuat prototipe dengan cepat.
Melalui Q, organisasi enterprise menciptakan chatbot untuk pelanggan serta dasbor eksekutif dan help desk khusus domain, yang dapat mereka terapkan dalam hitungan minggu alih-alih bulan.
Well-Architected Generative AI Lens menerapkan praktik terbaik di setiap langkah pengembangan beban kerja generatif.
Well-Architected Generative AI Lens
Generative AI Lens AWS memperluas lima pilar dari Well-Architected Framework ke beban kerja generatif. Kerangka ini mencakup sistem pemantauan model otomatis dan mekanisme deteksi drift bersamaan dengan pemicu pelatihan ulang dengan manajemen artefak versi dan pelacakan metrik inferensi.
Berikut pilarnya:
- Keamanan: Terapkan IAM dengan hak paling minimal, gunakan PrivateLink untuk endpoint Bedrock, enkripsi data saat transit dan saat disimpan, serta terapkan guardrail penyaringan konten.
- Keandalan: Solusi menggunakan penerapan endpoint berbasis AZ, penskalaan otomatis, circuit breaker, dan penerapan Canary untuk rilis tanpa risiko.
- Efisiensi kinerja: Pilih keluarga instance optimal, cache prompt yang sering dan batch permintaan, serta manfaatkan endpoint serverless untuk menskalakan hingga nol.
- Optimasi biaya: Pemilihan model harus mengikuti persyaratan latensi sembari menggunakan kapasitas spot atau reserved, rekayasa prompt harus meminimalkan penggunaan token, dan analisis biaya harus dilakukan di Cost Explorer.
- Keberlanjutan: Sesuaikan ukuran komputasi, gunakan chip hemat energi (Trainium, Inferentia), arsipkan data dingin di S3 Glacier, dan adopsi pipeline serverless untuk mengurangi sumber daya menganggur.
Bagi yang mengejar sertifikasi, AWS Cloud Practitioner track sejalan dengan pengetahuan dasar yang dibahas di sini.
Mempercepat adopsi dengan Mitra AWS
AWS Partner Network mendukung bisnis dengan mempercepat adopsi layanan AWS melalui akselerator solusi dan layanan mitra. Setiap organisasi enterprise berbeda satu sama lain sehingga AWS membentuk Partner Network dengan akselerator AI generatif spesifik untuk berbagai industri dan use case.
- AWS Partner Network mencakup Technology Partner yang menghadirkan aplikasi siap pakai bersama konektor dan model fondasi khusus domain, yang tersedia melalui AWS Marketplace.
- Program Generative AI Accelerator melayani startup dengan menawarkan kredit serta pendampingan dan blueprint praktik terbaik untuk mempercepat pengembangan proof-of-value.
- Penggunaan kerangka kerja mitra APN, bersama pola solusi tervalidasi AWS, memungkinkan tim mengurangi risiko selama proyek percontohan sambil menerapkan AI generatif di seluruh organisasi dengan keyakinan.
Gambaran Layanan AI AWS Pendukung
Kemampuan AI Generatif untuk menghasilkan konten baru tidak sepenuhnya selaras dengan kebutuhan aplikasi dunia nyata, yang perlu memproses dan memahami data melalui berbagai format penyajian.
AWS menyediakan kumpulan layanan pendukung yang terintegrasi dengan pipeline generatif Anda untuk mengonversi dokumen tidak terstruktur menjadi data terstruktur, mengekstrak wawasan gambar, dan memungkinkan percakapan alami serta penyampaian output dalam bahasa atau suara apa pun.
Berikut yang paling populer:
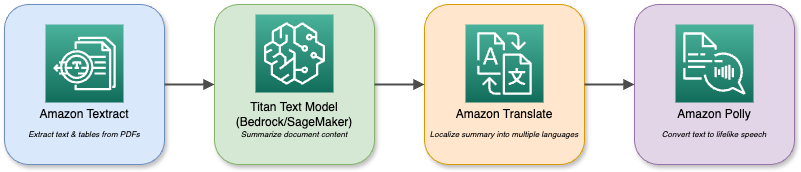
- Amazon Textract
- Sistem secara otomatis mendeteksi teks cetak, tabel, dan data formulir dalam dokumen hasil pemindaian dan file gambar.
- Sistem memanfaatkan pipeline RAG untuk memproses dokumen khusus domain, termasuk kontrak, laporan, dan faktur.
- Sistem menata konten tidak terorganisasi agar siap untuk templat prompt dan dataset fine-tuning.
- Amazon Rekognition
- Sistem memanfaatkan analisis gambar dan video untuk mengidentifikasi objek, adegan, teks, wajah, dan aktivitas.
- Sistem menghasilkan metadata kontekstual (label, skor kepercayaan) untuk generasi multimodal.
- Sistem memungkinkan pengguna menerapkan logika kondisional (misalnya, "hanya deskripsikan gambar yang berisi orang") dalam aplikasi pengguna akhir mereka.
- Amazon Polly
- Layanan mengubah teks tertulis menjadi audio ucapan yang mirip manusia dalam berbagai suara dan bahasa.
- Kemampuan output audio mengubah chatbot dan asisten generatif menjadi antarmuka interaktif.
- Sistem mendukung markup SSML untuk mengontrol output ucapan melalui pengucapan, penekanan, dan jeda yang presisi.
- Untuk mempelajari bagaimana Polly menghadirkan output suara mirip manusia dalam aplikasi nyata, silakan lihat tutorial praktis ini.
- Amazon Lex
- Sistem mengembangkan antarmuka percakapan melalui pengenalan ucapan otomatis (ASR) dan pemahaman bahasa alami (NLU).
- Sistem berfungsi sebagai antarmuka front-end untuk generator back-end, menangani manajemen sesi dan operasi pengisian slot.
- Sistem terhubung langsung ke AWS Lambda untuk mengeksekusi endpoint Bedrock atau SageMaker guna menghasilkan respons dinamis.
- Amazon Translate
- Layanan menawarkan terjemahan mesin neural instan untuk lebih dari 70 bahasa berbeda.
- Sistem menyesuaikan output generatif agar dapat diakses oleh audiens global.
- Sistem menstandarkan input multibahasa, memungkinkan satu model melayani pengguna dari berbagai wilayah.
Diagram ilustratif berbagai layanan AWS dan interaksinya
Model fondasi Anda di Bedrock atau SageMaker dapat dikombinasikan dengan layanan-layanan ini untuk membangun aplikasi multimodal yang kompleks.
Sebagai contoh, asisten analisis dokumen menggunakan Textract untuk memasukkan PDF lalu menggunakan Titan Text untuk meringkasnya sebelum menerjemahkan ringkasan ke berbagai bahasa dan memutarnya kembali melalui Polly. Ekosistem yang dapat disusun ini memungkinkan Anda menggabungkan berbagai kemampuan AI untuk memenuhi kebutuhan enterprise apa pun.
Pola Implementasi dan Use Case
AI generatif memberikan hasil terbaik saat Anda menggunakan pola yang terancang baik untuk menjawab masalah bisnis nyata.
Bagian ini menyajikan empat blueprint implementasi spesifik, termasuk retrieval-augmented generation dan asisten untuk pengembang serta enterprise, serta skenario bernilai tinggi lainnya yang dapat Anda terapkan hari ini.
Arsitektur retrieval-augmented generation (RAG)
Kombinasi kemampuan pencarian dengan model bahasa besar dalam retrieval-augmented generation menghasilkan respons akurat yang tetap membumi pada konteks. Pipeline empat tahap beroperasi sebagai berikut:
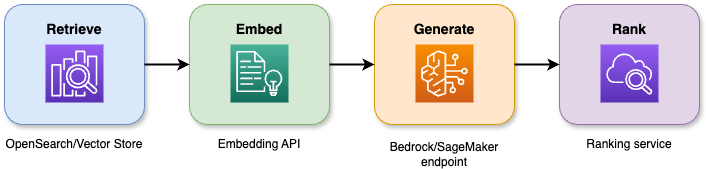
- Sistem mengambil N dokumen atau paragraf paling relevan dari penyimpanan vektor atau indeks pencarian melalui kueri.
- Sistem mentransformasikan dokumen dan kueri pengguna menjadi embedding semantik, yang memungkinkan penyelarasan konteks lebih baik.
- Sistem memasukkan kueri dan konteks yang diambil ke model fondasi untuk menghasilkan respons.
- Sistem menggunakan model sekunder atau heuristik untuk memberi skor dan menyusun ulang kandidat output, menyajikan jawaban paling sesuai.
Diagram ilustratif yang menampilkan arsitektur retrieval-augmented generation (RAG).
Manfaat dan peningkatan akurasi:
- Sistem menurunkan halusinasi sebesar 40 persen dibandingkan metode generasi dasar.
- Pilot basis pengetahuan enterprise menunjukkan relevansi jawaban meningkat 20–30 persen.
- Rata-rata waktu interaksi pengguna turun 25 persen saat menggunakan sistem dukungan virtual.
Aplikasi bisnis:
- Konten wiki internal menjadi fondasi chatbot dan asisten virtual untuk menyediakan ringkasan tiket dan petunjuk pemecahan masalah.
- Sistem RAG yang terintegrasi dengan antarmuka pengguna pencarian memungkinkan pengguna menjelajah koleksi dokumen luas melalui penelusuran bahasa alami.
- Sistem memungkinkan asisten kepatuhan, legal, dan regulasi memberikan sitasi paragraf sumber saat diminta pengguna.
Alur kerja pembuatan kode
AWS CodeWhisperer menghadirkan AI generatif langsung ke pengembang melalui IDE dan pipeline CI/CD mereka untuk melakukan otomatisasi boilerplate dan mempercepat proses pengodean:
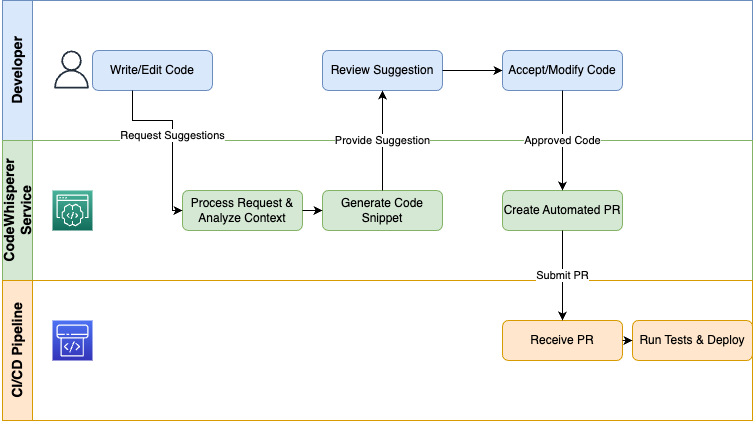
- Sistem menyediakan tiga fungsi utama, termasuk saran kode real-time, pelengkapan snippet, serta pembuatan tes yang beradaptasi dengan konteks pengodean Anda saat ini.
- Tim mencapai pengiriman fitur yang lebih cepat sebesar 30 persen, sementara kesalahan sintaks prototipe awal menurun 50 persen.
- Pipeline CodeCatalyst memungkinkan pengguna secara otomatis membuat snippet infrastruktur IaC, unit test, dan skrip penerapan melalui integrasi CodeWhisperer.
- Platform mendukung banyak bahasa pemrograman, termasuk Python, Java, JavaScript/TypeScript, C#, Go dan bahasa tambahan, yang memberi manfaat bagi seluruh tumpukan teknologi Anda.

Diagram ilustratif yang menampilkan alur kerja pembuatan kode.
Organisasi yang menggunakan CodeWhisperer sebagai asisten pengembang menghilangkan pekerjaan berulang, menegakkan standar pengodean, dan memungkinkan insinyur mendedikasikan waktu untuk aktivitas desain dan debugging bernilai tinggi.
Perlu diperhatikan bahwa CodeWhisperer akan menjadi bagian dari Amazon Q Developer.
Asisten enterprise
Amazon Q Business beroperasi sebagai solusi low-code bertenaga RAG, memungkinkan pengguna mengembangkan asisten percakapan yang mengambil data enterprise melalui pertanyaan.
Arsitektur:
- Sistem mengambil data dari Redshift, OpenSearch, SharePoint, dan S3 melalui konektor.
- Mesin RAG mengambil konteks yang sesuai sebelum mengaktifkan model fondasi.
- Pengelola dialog mengendalikan manajemen sesi multi-giliran, termasuk pengisian slot dan operasi status.
- Lapisan UI merespons widget chat, saluran suara, dan integrasi Slack.
Skenario penerapan:
- Transkripsi otomatis dan peringkasan butir tindakan melalui asisten rapat memungkinkan tim menghemat lebih dari dua jam kerja setiap minggu.
- Penerapan bot layanan mandiri mengalihkan pertanyaan rutin, menghasilkan pengurangan waktu penanganan sebesar 30 persen.
- Dasbor eksekutif menyediakan wawasan bahasa alami terkait penjualan, persediaan, dan KPI bagi pengguna yang tidak memerlukan pelatihan BI.
Para asisten membantu organisasi merampingkan pekerjaan berbasis pengetahuan, mengurangi biaya operasional, dan memungkinkan karyawan mencapai tingkat produktivitas yang lebih tinggi.
Use case bernilai tinggi tambahan
Nilai AI generatif melampaui RAG, pembuatan kode, dan asisten ke berbagai domain lainnya:
- Sistem ini dapat menghasilkan deskripsi produk yang dipersonalisasi, kampanye email, dan interaksi chat berdasarkan profil individu dan analisis perilaku.
- Kombinasi Textract dengan model parsing formulir dan generasi memungkinkan klasifikasi, markup, dan perutean otomatis untuk faktur, kontrak, dan klaim, serta tugas hilir (pembuatan tiket, perutean persetujuan, dan pembuatan laporan) melalui logika keputusan berbasis model.
- Analisis transkrip dukungan, feed media sosial, dan panggilan penjualan melalui analitik percakapan mengungkap tren sentimen, risiko kepatuhan, dan rekomendasi yang dapat ditindaklanjuti.
Mulailah dengan pola-pola ini untuk membangun proyek percontohan yang menunjukkan ROI jelas sebelum berlanjut ke optimasi dan penskalaan di seluruh organisasi Anda.
Model Keamanan dan Tata Kelola
Perusahaan perlu menerapkan kontrol keamanan dan praktik tata kelola di setiap tahap siklus hidup AI saat mengadopsi AI generatif.
AWS menyediakan kerangka keamanan dan kepatuhan komprehensif yang mencakup dari pusat data fisik hingga kebijakan tingkat aplikasi, memungkinkan inovasi dengan percaya diri.
Arsitektur perlindungan data
AWS melindungi beban kerja AI generatif melalui enam lapisan keamanan konsentris:
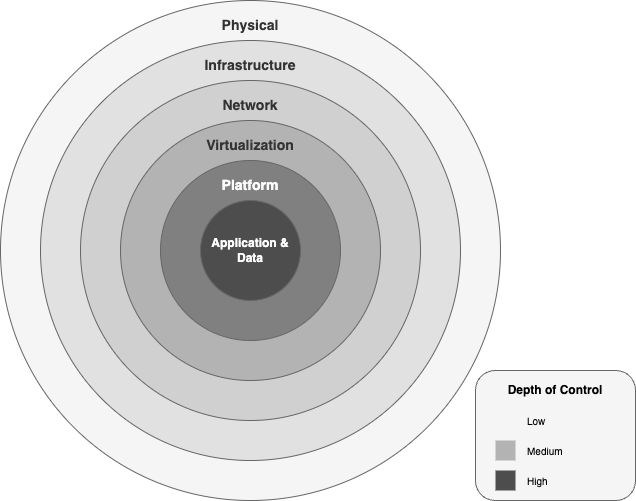
- Lapisan fisik pusat data memiliki kontrol akses multi-faktor, pemindaian biometrik, dan pemantauan 24/7, yang memastikan kontak perangkat keras tetap terbatas pada personel berwenang.
- Jaringan global AWS melindungi lalu lintas AI melalui koneksi serat pribadi dan mitigasi DDoS, serta AWS Shield Advanced, sambil mempertahankan throughput jaringan tinggi dengan mengisolasi lalu lintas dari internet publik.
- Endpoint model dan pipeline data tetap aman melalui kombinasi VPC dengan security group terperinci, ACL jaringan, dan endpoint PrivateLink, yang beroperasi dalam jaringan privat Anda.
- Nitro System memindahkan operasi virtualisasi ke komponen perangkat keras khusus, yang memberikan kecepatan bare-metal dan perlindungan berbasis perangkat keras terhadap berbagi data tidak sah antar mesin virtual.
- Lapisan platform endpoint Bedrock dan SageMaker terintegrasi dengan AWS KMS untuk kunci yang dikelola pelanggan, menggunakan enkripsi TLS 1.2+ untuk transmisi data, dan menegakkan izin IAM berdasarkan prinsip hak paling minimal.
- Lapisan aplikasi dan data menerapkan kebijakan sumber daya terperinci dengan enkripsi saat disimpan dan saat transit AES-256 dan mengintegrasikan pencatatan audit melalui CloudTrail dan CloudWatch untuk melindungi dan merekam setiap panggilan API.

Diagram ilustratif lapisan keamanan dalam kerangka AI generatif AWS.
Isolasi data dan kepatuhan:
- Setiap instance inferensi Bedrock beroperasi dalam VPC Anda sambil mengakses dan memodifikasi bucket S3 yang Anda kelola.
- Anda memilih CMK yang dikelola pelanggan melalui AWS KMS dan memiliki opsi menggunakan penyimpanan kunci eksternal (XKS/HYOK) untuk memenuhi persyaratan kepatuhan kedaulatan.
- AWS mempertahankan banyak sertifikasi, termasuk ISO 27001 dan SOC 1/2/3 Fed, RAMP High, HIPAA, PCI, DSS, dan GDPR, yang secara otomatis diperluas ke beban kerja AI generatif Anda tanpa memerlukan upaya duplikasi.
Kerangka AI yang bertanggung jawab
Pengembangan kepercayaan pada AI generatif memerlukan penerapan protokol etika dan keselamatan pada setiap tahap pemanggilan model. AWS menerapkan tata kelola AI yang bertanggung jawab melalui kerangka berikut:
- Prinsip etika AWS memprioritaskan keadilan, privasi, transparansi, dan akuntabilitas untuk mencegah bias diskriminatif pada model serta menjaga dokumentasi yang jelas tentang garis keturunan data dan logika keputusan.
- Sistem Bedrock Guardrails menyediakan filter berbasis kebijakan yang memeriksa data input dan hasil output terhadap kategori termasuk ujaran kebencian dan kekerasan, tindakan melukai diri sendiri, dan misinformasi. Invoke API dan ApplyGuardrail API memungkinkan pengguna menerapkan guardrail untuk pemeriksaan keselamatan secara mandiri atau melalui Invoke API.
- Sistem mencatat semua permintaan dan keputusan guardrail melalui CloudTrail, sementara kartu model dan laporan evaluasi menampilkan metrik kinerja, potensi bias, serta trade-off biaya/latensi.
- Sistem menyediakan pengawasan berkelanjutan melalui deteksi bias SageMaker Clarify dan alur kerja tinjauan human-in-the-loop untuk output berkeyakinan rendah, serta peringatan deteksi drift otomatis untuk pelatihan ulang atau pencabutan model.
Lapisan dan praktik ini membangun postur pertahanan berlapis untuk AI generatif enterprise, memungkinkan Anda meraih inovasi sambil menjaga standar tertinggi dalam keamanan, kepatuhan, dan tanggung jawab etis.
Strategi Optimasi Biaya
Pengendalian anggaran AI generatif menuntut pemahaman lengkap tentang mekanisme harga dan praktik manajemen biaya berkelanjutan. Bagian ini menjelaskan penetapan harga AWS untuk beban kerja AI sambil menyajikan contoh TCO penerapan menengah dan strategi untuk menekan pengeluaran.
Analisis model harga
Penetapan harga AI generatif AWS terbagi dalam empat dimensi utama:
- Biaya komputasi
- Jam endpoint: ditagihkan per jam instance, bervariasi menurut keluarga
- Inf1.xlarge sebesar $0,228/jam
- G5.xlarge sebesar $1,006/jam
- Pekerjaan pelatihan: ditagihkan per jam instance pada perangkat keras Trn1, P4, atau P5 (misalnya, Trn1.32xlarge sebesar $21,50/jam)
- Biaya token/permintaan
- Token prompt: $0,0008 per 1 K token
- Token completion: $0,0016 per 1 K token
- Penyimpanan & transfer data
- Artefak model: S3 Standard sebesar $0,023/GB-bulan
- Egress data: $0,09/GB di luar free tier
- Kustomisasi & evaluasi
- Fine-tuning: biaya pelatihan per jam instance tambahan plus biaya pemrosesan data minimal.
- Sesi evaluasi: biaya token untuk perbandingan baseline vs. kustom.
Strategi optimasi biaya
- Pilih silikon yang tepat: Gunakan Inferentia (Inf1/Inf2) untuk inferensi volume tinggi dan latensi rendah serta Trainium (Trn1) untuk pelatihan skala besar guna menurunkan $/TPU-jam.
- Batch dan cache prompt: Kelompokkan permintaan serupa dan cache jawaban populer untuk mengurangi pengeluaran token berulang.
- Endpoint multi-model: Host beberapa model lebih kecil di balik satu endpoint—menukar latensi puncak dengan penurunan signifikan pada biaya jam menganggur.
- Kapasitas Spot & reserved: Komit sebagian kapasitas baseline dengan Reserved Instances atau gunakan Spot untuk beban kerja batch non-kritis.
- Rekayasa prompt: Rampungkan instruksi untuk meminimalkan penggunaan token per permintaan tanpa mengorbankan kualitas.
Membandingkan arsitektur
|
Arsitektur |
Pendorong biaya komputasi |
Pendorong biaya token |
Kesesuaian terbaik |
|
Chatbot real-time |
Banyak endpoint kecil berjalan 24×7 |
Laju permintaan tinggi, token kecil |
Dukungan pelanggan, Help desk |
|
Generasi batch |
Instance besar berumur pendek |
Sedikit lonjakan token besar |
Pembuatan laporan, Augmentasi data |
|
Pipeline RAG |
Gabungan pencarian + inferensi |
Token retrieval + token generasi |
Asisten berbasis pengetahuan |
Model total biaya kepemilikan
Di bawah ini contoh TCO bulanan untuk proyek percontohan AI generatif berukuran menengah:
|
Item biaya |
Biaya unit |
Penggunaan |
Biaya bulanan |
|
Endpoint inferensi (Inf1.xl) |
$0,228 /jam |
3 endpoint × 24 jam × 30 hari |
$492,48 |
|
Penggunaan token (Titan Express) |
$0,0024 /1 K token |
3 M token/hari × 30 hari |
$216,00 |
|
Penyimpanan S3 (artefak model) |
$0,023 /GB-bulan |
10 000 GB |
$230 |
|
Egress data |
$0,09 /GB |
1 TB |
$90 |
|
Glue ETL (persiapan fitur) |
$0,44 /DPU-jam |
20 DPU-jam |
$8,80 |
|
Total |
$1.037,28 |
Tuas optimasi kunci:
- Auto-scale hingga nol: Matikan endpoint menganggur saat trafik turun.
- Endpoint multi-model: Konsolidasikan model untuk mengurangi biaya jam menganggur hingga 60%.
- Reserved & Spot: Kunci tarif diskon untuk kapasitas baseline dan jalankan Spot untuk pekerjaan yang tidak sensitif terhadap latensi.
- Kompresi prompt: Refactor prompt untuk memangkas token berlebih, mengurangi 10–15% pengeluaran token.
Manajemen biaya berkelanjutan:
- Gunakan AWS Pricing Calculator untuk memodelling skenario sebelum peluncuran.
- Pantau penggunaan nyata di AWS Cost Explorer, tetapkan anggaran dan peringatan untuk anomali.
- Tag semua sumber daya AI untuk pelaporan charge-back dan showback yang jelas.
Kombinasi arsitektur yang sadar harga dengan optimasi terarah dan pemantauan berkelanjutan memungkinkan Anda menskalakan AI generatif tanpa mengalami biaya berlebihan.
Peta Jalan Implementasi
Proses menskalakan AI generatif dari konsep ke produksi memerlukan metodologi bertahap yang sistematis. Peta jalan ini menyediakan pendekatan langkah demi langkah, mulai dari penilaian awal melalui proyek percontohan proof-of-concept hingga membangun platform kelas enterprise yang tangguh.
Fase penilaian dan percontohan
Langkah pertama melibatkan pemeriksaan kelayakan dan memperoleh kesepakatan pemangku kepentingan sebelum melanjutkan ke pengembangan arsitektur penuh.
- Analisis kesenjangan dan penetapan tujuan
- Lakukan wawancara dengan pemilik bisnis untuk memperoleh kebutuhan use case, kriteria keberhasilan, dan target ROI.
- Tinjau sumber data saat ini, kontrol kualitas keamanan, dan kemampuan ML.
- Identifikasi kesenjangan kepatuhan atau privasi (misalnya, penanganan PII) yang harus ditangani oleh proyek percontohan Anda.
- Pengembangan proof of concept (PoC)
- Pilih use case bernilai tinggi (misalnya, bot dukungan bertenaga RAG atau peringkas dokumen) untuk fase pertama.
- Siapkan infrastruktur minimal: satu endpoint Bedrock atau SageMaker yang terhubung ke dataset kecil melalui S3 atau OpenSearch.
- Tentukan metrik kunci (akurasi, latensi, biaya per permintaan) dan instrumentasikan dasbor CloudWatch.
- Prototyping cepat dengan panduan langkah demi langkah
- Gunakan proyek contoh AWS Solutions Library (misalnya, RAG Chatbot, demo CodeWhisperer) untuk membangun prototipe.
- Iterasikan dengan cepat pada prompt dan strategi retrieval, tangkap pembelajaran di wiki bersama.
- Validasi pemangku kepentingan
- Tunjukkan prototipe fungsional kepada pengguna akhir dan kumpulkan masukan tentang kualitas output dan UX.
- Rampingkan cakupan, tambah atau hapus sumber data, dan sesuaikan parameter model berdasarkan penggunaan nyata.
- Amankan sponsor eksekutif dan anggaran untuk fase berikutnya.
Fase fondasi dan skala
Proof of Concept menghasilkan pengembangan platform fundamental sebelum sistem dapat diadopsi secara luas.
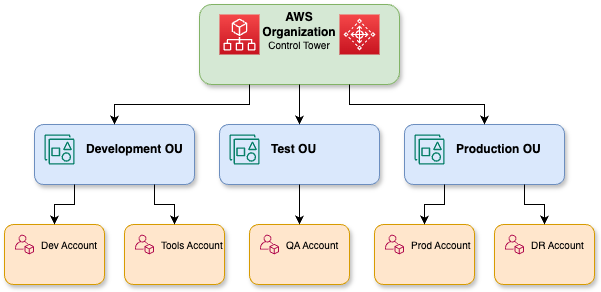
- Pengembangan fondasi platform
- Struktur multi-akun AWS Control Tower perlu ditetapkan untuk batas OU dev, test, dan prod di landing zone.
- Terapkan peran dan kebijakan IAM, AWS SSO, dan kontrol hak paling minimal untuk akses model dan pipeline data.
- VPC harus dikonfigurasi dengan endpoint PrivateLink. KMS CMK Bedrock/SageMaker harus diaktifkan, dan pemantauan GuardDuty harus diterapkan.
- Otomatiskan ETL dengan AWS Glue/Athena, katalogkan aset di Lake Formation, dan sinkronkan knowledge store untuk RAG.

Representasi terperinci tentang organisasi AWS.
- MLOps dan tata kelola model
- Proses pelatihan ulang, evaluasi, dan penerapan model harus diotomatiskan melalui pipeline CI/CD yang menggunakan CodeCatalyst atau CodePipeline.
- Registri model harus ditetapkan di SageMaker atau katalog berbasis Git untuk artefak berbasis versi dan fine-tuned.
- Sistem harus secara otomatis mendeteksi drift dan melakukan pelatihan ulang terjadwal untuk menjaga kinerja dan kepatuhan.
- Menskalakan ke produksi
- Pola trafik variatif harus dicocokkan melalui penggunaan endpoint Bedrock atau SageMaker yang otomatis menskalakan.
- Penggunaan endpoint multi-model memungkinkan hosting beberapa FM yang lebih kecil di balik satu API, menghasilkan pengurangan biaya menganggur hingga 60%.
- Penerapan harus dilakukan di beberapa Availability Zone, dan rollout canary harus diterapkan untuk memastikan pembaruan tanpa downtime.
- AWS Partner Network dan Innovation Center
- Libatkan Consulting Partner untuk akselerator spesifik domain di keuangan, kesehatan, dan ritel.
- Gunakan AWS Marketplace untuk memperoleh konektor siap pakai dan model domain terlatih dari Technology Partner.
- AWS Innovation Center dan Community Builders harus berkolaborasi untuk mengakses hackathon, tinjauan arsitektur, dan lokakarya praktis guna mempercepat adopsi praktik terbaik.
Pendekatan bertahap berupa validasi, diikuti pembangunan fondasi, lalu penskalaan dengan tata kelola dan dukungan mitra, akan membantu Anda mengubah proyek percontohan AI generatif menjadi kapabilitas yang tangguh di seluruh enterprise.
Fase optimasi dan tata kelola
Penyempurnaan berkelanjutan dan praktik tata kelola yang kuat, diterapkan setelah Anda menskalakan platform AI generatif, memastikan sistem berkinerja baik sambil mempertahankan keamanan dan kepatuhan regulasi.
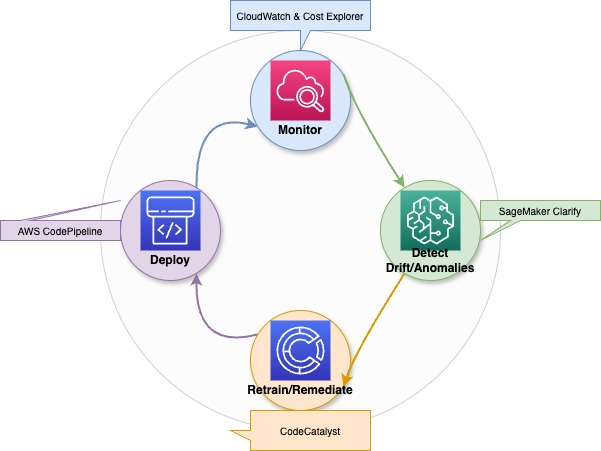
Optimasi berkelanjutan
- Pemantauan dan peringatan otomatis
- Endpoint Bedrock/SageMaker memerlukan metrik CloudWatch (termasuk latensi, tingkat kesalahan, dan throughput) serta dasbor Cost Explorer untuk instrumentasi.
- Siapkan alarm deteksi anomali misalnya lonjakan pengeluaran token mendadak atau regresi latensi inferensi dan picu alur kerja remediasi otomatis (scale-up/down, rollback model).

Diagram ilustratif yang menampilkan optimasi berkelanjutan, deteksi drift, dan proses pelatihan ulang untuk model AI generatif.
- Deteksi drift dan pelatihan ulang
- Gunakan detektor drift berbasis embedding atau SageMaker Clarify untuk menandai pergeseran distribusi data.
- Ambang drift memicu pipeline pelatihan ulang otomatis melalui CodePipeline/CodeCatalyst untuk menjaga akurasi model dan kinerja tanpa bias.
- Penyetelan biaya
- Secara berkala tinjau biaya jam menganggur dan konsolidasikan model ke endpoint multi-model jika memungkinkan.
- Fine-tune prompt untuk mengurangi penggunaan token yang tidak perlu dan batch permintaan berprioritas rendah.
Audit tata kelola dan kepatuhan
- Audit terjadwal
- Organisasi Anda harus melakukan asesmen triwulanan atas kebijakan IAM dan penggunaan kunci KMS, bersama konfigurasi endpoint VPC dan log CloudTrail, untuk memastikan kepatuhan pada akses hak paling minimal dan standar enkripsi.
- AWS Audit Manager dan aturan AWS Config memungkinkan pengumpulan bukti otomatis untuk mandat ISO, HIPAA, atau SOC.
- Penegakan kebijakan
- Organisasi Anda harus memperbarui Bedrock Guardrails dengan kebijakan konten dan melakukan asesmen filter kategori pada setiap periode rilis.
- Pipeline CI/CD Anda harus menerapkan gerbang persetujuan yang mencegah penerapan versi model ketika evaluasi keamanan atau keadilan gagal.
Pelatihan dan pengembangan keterampilan berkelanjutan
- AWS Skill Builder
- Jalur pembelajaran Generative AI harus mendaftarkan tim melalui AWS Skill Builder untuk mempelajari dasar-dasar Bedrock, pola RAG, dan praktik terbaik penerapan yang aman.
- Lab praktis mengajarkan cara menyiapkan instance Trn1/Inf1 sambil mengonfigurasi Guardrail dan melakukan deteksi bias dengan SageMaker Clarify.
- Sertifikasi dan komunitas
- Insinyur harus mengejar kredensial AWS Certified Machine Learning – Specialty dan AWS Certified Security – Specialty.
- AWS Community Builders dan lokakarya Innovation Center memungkinkan Anda terus mengikuti layanan baru, tinjauan arsitektur, dan program akselerator.
Dengan mengintegrasikan optimasi berkelanjutan dan audit ketat dengan praktik pembelajaran organisasi, Anda dapat mempertahankan kapabilitas AI generatif yang tangguh, tepercaya, dan hemat biaya.
Sumber Daya dan Memulai
Perjalanan AI generatif AWS dapat dipercepat melalui jalur pembelajaran, komunitas, dan proyek praktis yang membangun kepercayaan diri dan mendorong dampak bisnis nyata.
AWS Skill Builder dan sumber pelatihan
- Jalur pembelajaran Generative AI di AWS Skill Builder menawarkan pelatihan komprehensif tentang model fondasi, pipeline RAG, dan praktik terbaik penerapan yang aman.
- Platform interaktif PartyRock dan Bedrock Playground memungkinkan pengguna menguji rekayasa prompt, fine-tuning, dan inferensi tanpa perlu menyiapkan infrastruktur.
- Lab terpandu menunjukkan cara membuat instance Trn1 dan Inf1 serta menyiapkan endpoint terenkripsi KMS sebelum menerapkan alur kerja RAG end-to-end.
Komunitas pengembang dan ekosistem mitra
- AWS Generative AI Community dan Developer Center menyediakan akses ke contoh kode, forum, dan whitepaper terkurasi tentang Well-Architected Generative AI Lens.
- AWS Partner Network menyediakan akselerator siap pakai, model fondasi khusus domain, dan konektor turnkey, yang semuanya tersedia di AWS Marketplace.
- AWS Innovation Center dan Community Builders menawarkan lokakarya, hackathon, dan sesi tinjauan arsitektur yang membantu Anda mempercepat proses implementasi.
Panduan langkah demi langkah dan proyek contoh
- Platform DataCamp menyediakan tutorial langkah demi langkah dan templat solusi yang memungkinkan pengguna memperoleh kode untuk kustomisasi melalui fork.
- Repositori contoh end-to-end mendemonstrasikan cara memanfaatkan Textract untuk pemasukan data dan orkestrasi RAG SageMaker, serta Polly untuk output suara.
- Pengguna dapat menerapkan proyek yang sepenuhnya fungsional melalui platform, yang memungkinkan mereka mengubah prompt, model, dan pipeline untuk use case enterprise dan pengukuran kinerja.
Kesimpulan
AI generatif AWS menyediakan sistem end-to-end lengkap, termasuk model fondasi, komputasi yang dioptimalkan, tata kelola, integrasi, dan kontrol biaya, untuk membantu enterprise berinovasi lebih cepat dan mengurangi beban operasional sambil membangun aplikasi tepercaya, multimodal, dalam skala besar.
Melalui eksperimen, pembelajaran berkelanjutan, dan kolaborasi komunitas, Anda akan mencapai potensi penuh AI generatif AWS untuk mendorong dampak bisnis nyata.
Rahul Sharma adalah AWS Ambassador, Arsitek DevOps, dan blogger teknis yang mengkhususkan diri pada komputasi awan, praktik DevOps, serta teknologi open-source. Dengan keahlian di AWS, Kubernetes, dan Terraform, ia menyederhanakan konsep yang kompleks bagi pelajar dan profesional melalui artikel dan tutorial yang menarik. Rahul bersemangat memecahkan tantangan DevOps dan berbagi wawasan untuk memberdayakan komunitas teknologi.