Vai al contenuto principale

AI generativa su AWS: come distribuire, governare e scalare le soluzioni

Un’analisi approfondita di come l’AI generativa di AWS alimenta applicazioni AI scalabili, sicure e ottimizzate nei costi in vari settori. Ideale per team pronti a passare dal pilot alla produzione.
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

L’AI generativa di AWS rappresenta il futuro dei servizi cloud perché consente alle aziende di creare contenuti e attività di knowledge work automatizzati attraverso foundation model che generano testo, immagini e video in tempo reale. 

In questo articolo offro una panoramica completa degli elementi essenziali dei metodi di deployment e dei framework di governance necessari per sviluppare soluzioni di AI generativa pronte per la produzione. 

AWS è il principale provider cloud perché offre Amazon Bedrock insieme a un’infrastruttura di calcolo specializzata e a vaste capacità di integrazione che superano altre piattaforme cloud.

Se sei alle prime armi con AWS, ti consigliamo questo corso introduttivo che fornisce una solida base prima di entrare negli aspetti specifici dell’AI generativa.

Comprendere i componenti chiave

In questa sezione esploriamo i mattoni che alimentano l’AI generativa su AWS.

Ecosistema dei foundation model

Bedrock funge da control plane gestito per tutta l’AI generativa su AWS. Espone un’API coerente per distribuire, scalare e mettere in sicurezza i foundation model, dal provisioning degli endpoint alla fatturazione, così puoi concentrarti su prompt e integrazione dell’AI invece che sulla gestione dell’infrastruttura.
Questo diagramma rappresenta visivamente i componenti principali dell'AI generativa di AWS, mostrando l'interazione tra l'ecosistema dei foundation model, l'infrastruttura di calcolo ottimizzata per l'AI e basi dati solide, cruciali per sviluppare e distribuire soluzioni di AI generativa.

Un diagramma concettuale che illustra l’ecosistema dei foundation model di AWS

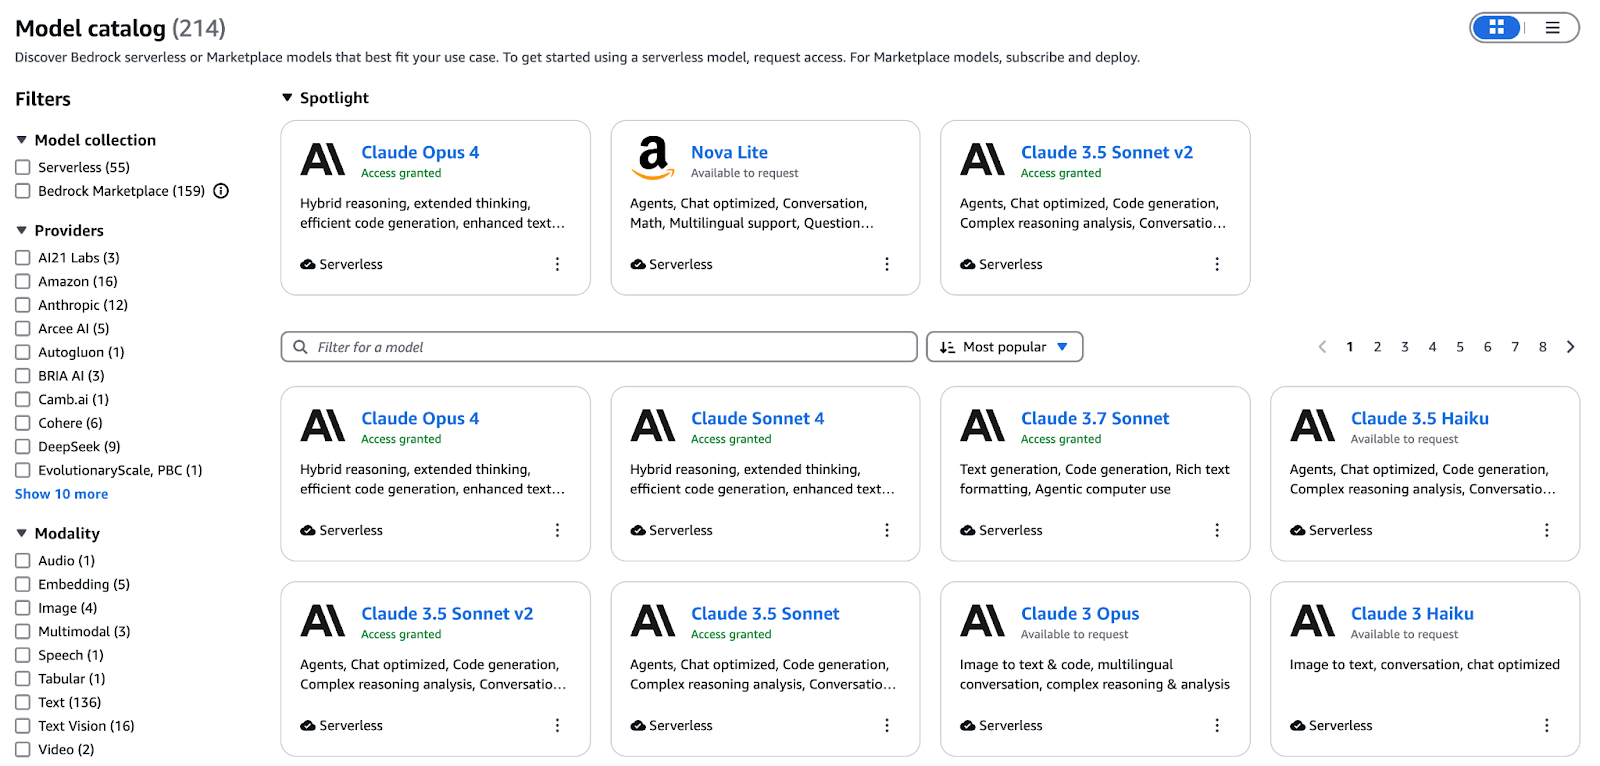
Il catalogo di Bedrock unifica modelli per testo, immagini, video ed embeddings sotto un’unica interfaccia. Le offerte principali includono:

  • Titan Text (Premier, Express, Lite): fino a 32K token di contesto per dialoghi complessi
  • Nova Canvas: generazione testo-immagine ad alta fedeltà e inpainting per asset creativi brand-safe
  • Nova Reel: clip video animati brevi generati da un singolo prompt
  • Titan Multimodal Embeddings G1: codifica testo e immagini in uno spazio vettoriale condiviso per similarity search e RAG

Esegui il fine-tuning dei modelli sui tuoi dati etichettati o continua il pre-training su corpora specifici di dominio tramite la console o l’SDK di Bedrock. Una volta completato l’addestramento, la suite di valutazione di Bedrock esegue confronti affiancati riportando accuratezza, latenza e costo per token, così puoi scegliere in modo oggettivo la variante ottimale per gli SLA di produzione.

Oltre alle famiglie Titan e Nova di AWS, Bedrock ti dà accesso a modelli partner di Anthropic, Cohere, Mistral, AI21 Labs e altri. Sfrutta questa ampiezza per:

  • Creare assistenti di knowledge basati su RAG che estraggono risposte precise da wiki interni
  • Generare testi e immagini di marketing su larga scala con una voce di brand coerente
  • Integrare completamento e revisione del codice guidati dall’AI nei flussi di lavoro degli sviluppatori
  • Arricchire i dataset di training sintetizzando testo, immagini o video mirati al tuo dominio

Per approfondire come Bedrock orchestra questi foundation model in ambienti di produzione, dai un’occhiata a questa guida completa ad Amazon Bedrock.

Infrastruttura di calcolo ottimizzata per l’AI

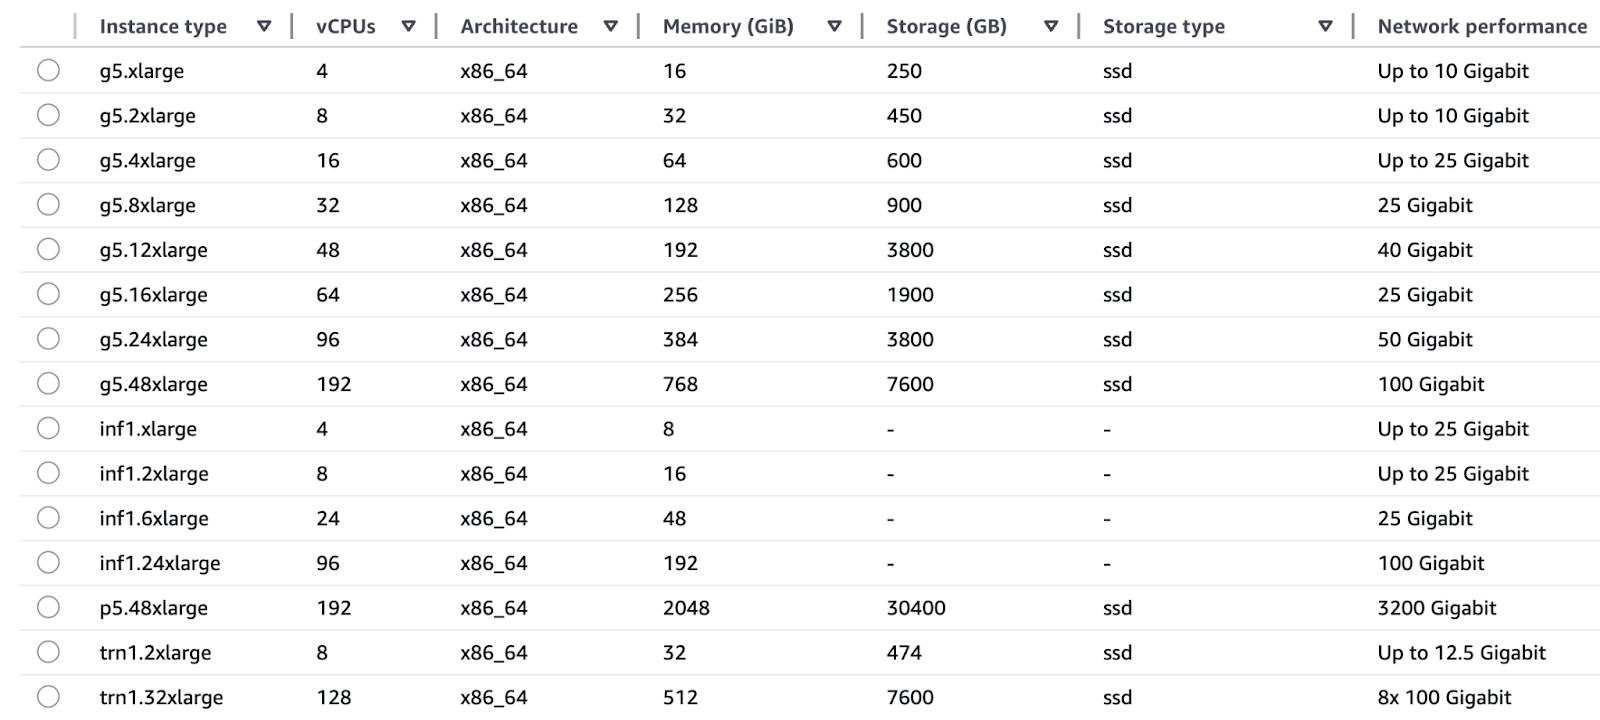
Le famiglie di istanze EC2 fornite da AWS rispondono alle esigenze specifiche delle operazioni di training e inference.

Training:

  • Le istanze Trn1 (Trainium) utilizzano chip AWS Trainium per offrire capacità di training deep learning, inclusi LLM e modelli di diffusione, con velocità fino a 3 volte superiori e costo orario ridotto rispetto alle istanze basate su GPU.
  • Le P5 e P4 (GPU NVIDIA H100 e A100) offrono ampie capacità di elaborazione parallela tramite supporto a precisione mista, adatte sia a test di ricerca sia a processi di ri-addestramento su larga scala in produzione.

Inference:

  • I chip AWS Inferentia usati nei sistemi Inf1 e Inf2 abilitano inferenze realtime con latenze di pochi millisecondi, offrendo un costo per inferenza 2× inferiore rispetto alle alternative su GPU.
  • G5 e G4dn (GPU NVIDIA A10G e T4) offrono un equilibrio costo/prestazioni adatto all’accelerazione GPU in tempo reale per chatbot e motori di raccomandazione.

Infrastruttura di calcolo ottimizzata per l'AI

Un diagramma illustrativo dell’infrastruttura di calcolo ottimizzata per l’AI di AWS.

AWS ottiene un’integrazione fluida tra componenti hardware e software progettati su misura grazie a Trainium per il training e Inferentia per l’inference, che lavorano direttamente con i servizi AWS. Questa integrazione verticale comporta:

  • Un rapporto prezzo/prestazioni superiore per i carichi TensorFlow e PyTorch, con riduzione del TCO.
  • La combinazione di efficienza energetica e procurement semplificato aiuta i team a evitare il lock-in con i vendor di GPU.
  • SageMaker e Bedrock implementano funzionalità di right-sizing automatico che permettono di scegliere configurazioni ottimali di silicio con semplici clic, senza dover gestire dettagli a livello di chip.

L’AWS Nitro System utilizza schede hardware dedicate per le funzioni di virtualizzazione, fornendo velocità bare metal insieme a isolamento sicuro:
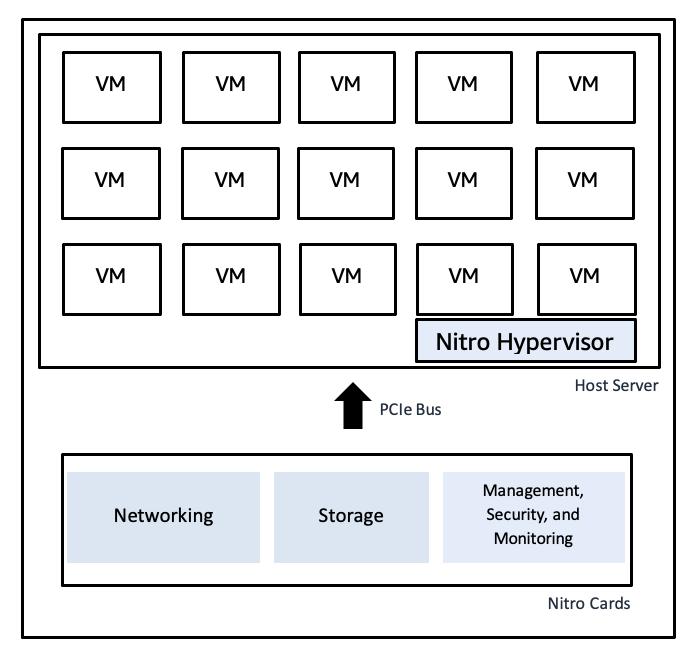
  • Il Nitro Hypervisor mantiene una codebase minimale, riducendo le vulnerabilità e mantenendo i carichi isolati tra loro.
  • I percorsi hardware-accelerati di rete e storage operano con elevata I/O e bassa variabilità, prevenendo picchi di latenza per prestazioni costanti anche ai carichi di punta.
  • L’integrazione di Nitro con CloudTrail, CloudWatch e AWS Config fornisce monitoraggio di conformità end-to-end senza degrado prestazionale.

Un diagramma illustrativo dell'Hypervisor Nitro di AWSUn diagramma illustrativo dell’Hypervisor Nitro di AWS

Esplora l’ecosistema più ampio di compute, storage e analytics in questo corso su AWS Cloud Technology and Services.

Fondamenti dati per un’AI generativa robusta

Il training ad alta velocità e le pipeline RAG richiedono accesso a dati puliti e correttamente governati:

  • L’archiviazione dati petabyte-scale di Amazon S3 si integra con Lake Formation per catalogazione degli ingest di dataset grezzi e curati e funzionalità di sicurezza.
  • Il data warehouse Amazon Redshift funge da piattaforma per tabelle strutturate che offrono analytics e recupero dati rapidi.
  • Le pipeline di trasformazione dati costruite con AWS Glue e Athena abilitano sia la preparazione di feature e contesto per carichi generativi sia l’esecuzione di query ad hoc.
  • Meccanismi di data governance e lineage garantiscono che il training utilizzi input affidabili mentre la conoscenza aziendale ancora gli output tramite controllo degli accessi e tracciamento della provenienza.

Framework di integrazione enterprise

Le funzionalità di AI generativa di AWS si integrano direttamente con il suo ecosistema più ampio per offrire soluzioni end-to-end di livello produttivo. Questa sezione descrive come combinare Bedrock con i servizi complementari per sviluppare applicazioni di AI generativa reali.

Ciclo di vita ML unificato con SageMaker JumpStart e Bedrock

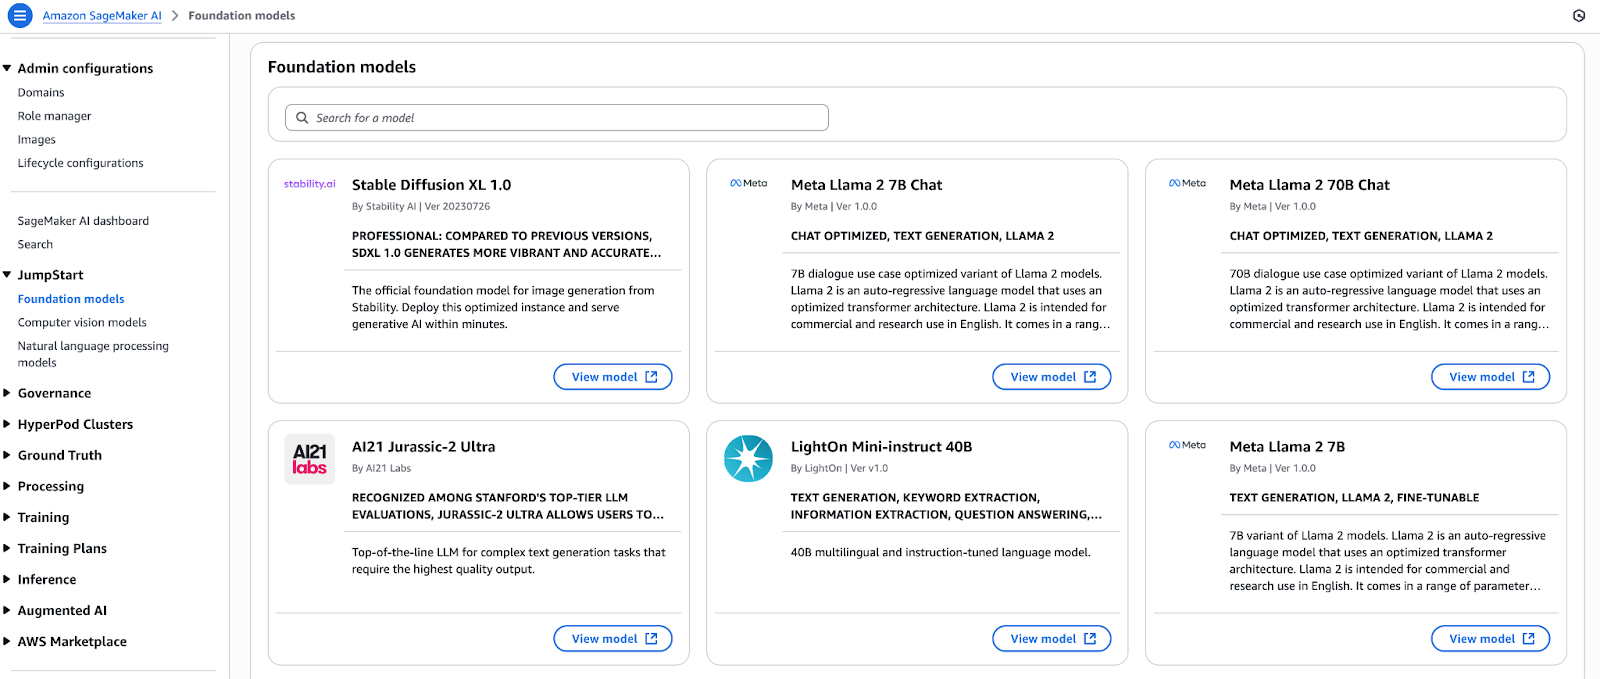
Seleziona foundation model dall’hub di SageMaker JumpStart e distribuiscili immediatamente. Puoi distribuire numerosi modelli open-source e proprietari con un solo pulsante, quindi registrarli direttamente in Amazon Bedrock. I modelli inseriti in Bedrock ottengono accesso a:

  • Moderazione dei contenuti ed enforcement delle policy tramite funzionalità di guardrail.
  • Le knowledge base forniscono capacità di Retrieval-Augmented Generation (RAG) per fonti dati private.
  • La Converse API mantiene la coerenza fornendo un layer di astrazione che elimina le variazioni specifiche del modello.

L’architettura integrata consente agli sviluppatori di creare prototipi in SageMaker Studio e poi perfezionarli in Bedrock prima di distribuirli tramite pipeline CI/CD senza modifiche al codice.

Questo tutorial su SageMaker illustra il processo di fine-tuning e deployment dei modelli utilizzando la piattaforma ML di punta di AWS.
Un diagramma illustrativo che mostra il ciclo di vita ML unificato con SageMaker JumpStart e Bedrock.Un diagramma illustrativo che mostra il ciclo di vita ML unificato con SageMaker JumpStart e Bedrock.

Orchestrare workflow con Amazon Bedrock Agents

Con Bedrock Agents puoi integrare l’AI generativa nelle applicazioni operative recuperando e trasformando automaticamente i dati prima di eseguire azioni. Un Agent richiede solo una configurazione di base per:

  • Stabilire connessioni sicure verso API RESTful, database e code di messaggi.
  • Acquisire documenti, metriche e log, eseguendo il preprocessing prima di rendere i dati disponibili ai modelli.
  • Eseguire diverse operazioni in background, tra cui arricchimento, validazione e notifica tramite chiamate di funzione sequenziali.
  • Generare output strutturati o conversazionali per l’utilizzo a valle da parte di altri sistemi.

Le funzioni di “plumbing” degli Agents permettono agli sviluppatori di concentrarsi sulla logica di business invece che sul codice di integrazione, accelerando il time-to-value.

Creare assistenti conversazionali con Amazon Q

Amazon Q è un servizio completamente gestito per sviluppare assistenti business basati su RAG.

Il servizio integra la funzionalità multi-modello di Bedrock con:

  • Connettori preconfigurati per data warehouse (Redshift), motore di ricerca (OpenSearch) e strumenti BI.
  • Funzionalità integrate per gestire dialoghi multi-turn, contesto di sessione e generazione di risposte con citazioni.
  • Uno strumento low-code per lo sviluppo dell’interfaccia utente che consente di creare rapidamente prototipi.

Con Q, le organizzazioni enterprise creano chatbot rivolti ai clienti insieme a dashboard esecutive e help desk specifici di dominio, distribuendoli in settimane anziché mesi.

La Well-Architected Generative AI Lens implementa le best practice in ogni fase dello sviluppo di workload generativi.

Well-Architected Generative AI Lens

La Generative AI Lens di AWS estende i cinque pilastri del Well-Architected Framework ai carichi di lavoro generativi. Il framework include sistemi automatizzati di monitoraggio dei modelli e meccanismi di rilevamento del drift, insieme a trigger di ri-addestramento con gestione delle versioni degli artifact e tracciamento delle metriche di inference.

Ecco i pilastri:

  • Sicurezza: applica IAM a privilegio minimo, usa PrivateLink per gli endpoint Bedrock, cifra i dati in transito e a riposo e implementa guardrail di content filtering.
  • Affidabilità: distribuzione degli endpoint su più AZ, auto scaling, circuit breaker e deployment Canary per rollout senza rischi.
  • Efficienza delle prestazioni: scegli famiglie di istanze ottimali, metti in cache prompt frequenti e batcha le richieste, sfrutta endpoint serverless per scalare a zero.
  • Ottimizzazione dei costi: seleziona i modelli in base ai requisiti di latenza usando capacità spot o riservata, progetta i prompt per ridurre l’uso di token ed esegui l’analisi dei costi in Cost Explorer.
  • Sostenibilità: dimensiona correttamente il compute, usa chip efficienti (Trainium, Inferentia), archivia i dati freddi in S3 Glacier e adotta pipeline serverless per ridurre le risorse inattive.

Per chi persegue la certificazione, il percorso AWS Cloud Practitioner si allinea bene con le conoscenze di base trattate qui.

Accelerare l’adozione con gli AWS Partner

L’AWS Partner Network supporta le aziende accelerando l’adozione dei servizi AWS tramite solution accelerator e servizi dei partner. Ogni organizzazione enterprise è diversa, perciò AWS ha creato il Partner Network con accelerator di AI generativa specifici per settori e casi d’uso.

  • L’AWS Partner Network include Technology Partner che forniscono applicazioni predefinite, connettori e foundation model specifici di dominio, disponibili tramite AWS Marketplace.
  • Il programma Generative AI Accelerator supporta le startup offrendo crediti, mentorship e blueprint di best practice per accelerare lo sviluppo della proof of value.
  • L’uso dei framework dei partner APN, insieme a pattern di soluzione validati da AWS, permette ai team di ridurre il rischio nei progetti pilota mentre distribuiscono l’AI generativa in tutta l’organizzazione con maggiore sicurezza.

Panoramica dei servizi AI di supporto AWS

La capacità dell’AI generativa di creare nuovi contenuti non coincide da sola con i requisiti delle applicazioni reali, che devono elaborare e comprendere dati in vari formati di presentazione. 

AWS fornisce una raccolta di servizi di supporto che si integrano con le tue pipeline generative per convertire documenti non strutturati in dati strutturati, estrarre insight dalle immagini e abilitare conversazioni naturali e consegna degli output in qualsiasi lingua o voce.

Ecco i più popolari:
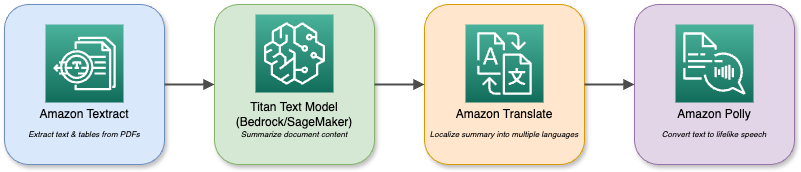
  • Amazon Textract
    • Rileva automaticamente testo stampato, tabelle e dati di moduli all’interno di documenti scansionati e file immagine.
    • Utilizza pipeline RAG per elaborare documenti specifici di dominio, inclusi contratti, report e fatture.
    • Organizza contenuti non strutturati per prepararli a template di prompt e dataset di fine-tuning.
  • Amazon Rekognition
    • Sfrutta l’analisi di immagini e video per identificare oggetti, scene, testo, volti e attività.
    • Genera metadati contestuali (etichette, confidence score) per generazione multimodale.
    • Consente di implementare logica condizionale (es. “descrivi solo immagini contenenti persone”) nelle applicazioni utente finali.
  • Amazon Polly
    • Trasforma testo scritto in audio parlato realistico in più voci e lingue.
    • La capacità di output audio trasforma chatbot e assistenti generativi in interfacce interattive.
    • Supporta il markup SSML per controllare l’output vocale con pronuncia, enfasi e pause precise.
    • Per scoprire come Polly abilita voci naturali nelle applicazioni reali, dai un’occhiata a questo tutorial pratico.
  • Amazon Lex
    • Sviluppa interfacce conversazionali tramite riconoscimento vocale automatico (ASR) e comprensione del linguaggio naturale (NLU).
    • Funziona come front-end per generatori back-end, gestendo sessioni e slot filling.
    • Si connette direttamente ad AWS Lambda per eseguire endpoint Bedrock o SageMaker e generare risposte dinamiche.
  • Amazon Translate
    • Offre servizi di traduzione automatica neurale immediata per oltre 70 lingue.
    • Adatta gli output generativi rendendoli accessibili a un pubblico globale.
    • Standardizza input multilingue, consentendo a un singolo modello di servire utenti di diverse regioni.

Un diagramma illustrativo dei vari servizi di AWS, come Amazon Textract, Bedrock e altri, e delle loro interazioni.  

Un diagramma illustrativo dei vari servizi di AWS e delle loro interazioni

I foundation model in Bedrock o SageMaker possono essere combinati con questi servizi per costruire applicazioni multimodali complesse. 

Un assistente per l’analisi documentale, ad esempio, usa Textract per acquisire PDF e poi Titan Text per riassumerli, prima di tradurre il sommario in più lingue e riprodurlo con Polly. L’ecosistema componibile consente di combinare varie capacità di AI per soddisfare qualsiasi esigenza enterprise.

Pattern di implementazione e casi d’uso

L’AI generativa dà il meglio quando utilizzi pattern ben architettati per risolvere problemi reali di business. 

Questa sezione presenta quattro blueprint di implementazione specifici, tra cui retrieval-augmented generation e assistenti per sviluppatori e aziende, oltre ad altri scenari ad alto valore che puoi implementare oggi.

Architetture di retrieval-augmented generation (RAG)

La combinazione di capacità di ricerca con large language model nella retrieval-augmented generation produce risposte accurate e ancorate al contesto. La pipeline in quattro fasi opera così:
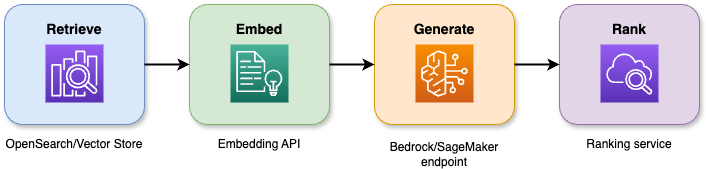
  • Recupero dei primi N documenti o passaggi rilevanti da un archivio vettoriale o indice di ricerca tramite query.
  • Trasformazione di documenti e query dell’utente in embeddings semantici, per un migliore allineamento del contesto.
  • Invio della query e del contesto recuperato a un foundation model per generare la risposta.
  • Uso di un modello secondario o di euristiche per valutare e riordinare gli output candidati, presentando la risposta più adatta.

Un diagramma illustrativo che mostra un'architettura di retrieval-augmented generation (RAG). 

Un diagramma illustrativo che mostra un’architettura di retrieval-augmented generation (RAG).

Benefici e guadagni di accuratezza:

  • Riduzione delle allucinazioni del 40% rispetto alla generazione “base”.
  • Nei pilot su knowledge base aziendali, la pertinenza delle risposte migliora del 20–30%.
  • Riduzione del tempo medio di interazione dell’utente del 25% nei sistemi di supporto virtuale.

Applicazioni di business:

  • Contenuti di wiki interni alimentano chatbot e assistenti virtuali per fornire riepiloghi di ticket e suggerimenti di troubleshooting.
  • Sistemi RAG integrati con interfacce di ricerca permettono di esplorare collezioni documentali estese con ricerche in linguaggio naturale.
  • Abilita assistenti per compliance, legale e normativo a fornire citazioni dei passaggi sorgente su richiesta.

Workflow di generazione del codice

AWS CodeWhisperer porta l’AI generativa direttamente agli sviluppatori nei loro IDE e nelle pipeline CI/CD per automatizzare il boilerplate e velocizzare la scrittura del codice:
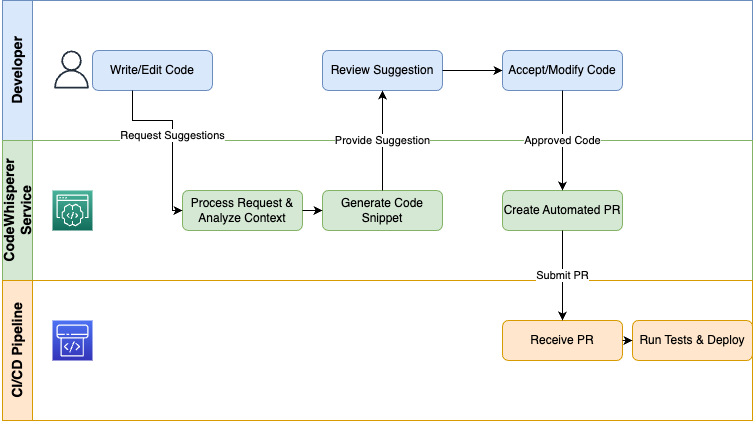
  • Offre tre funzioni principali: suggerimenti di codice in tempo reale, completamento di snippet e generazione di test adattati al contesto corrente di sviluppo.
  • I team consegnano funzionalità più velocemente del 30%, mentre gli errori di sintassi dei primi prototipi diminuiscono del 50%.
  • La pipeline CodeCatalyst consente di creare automaticamente snippet IaC di infrastruttura, unit test e script di deployment tramite integrazione con CodeWhisperer.
  • Supporta più linguaggi di programmazione, tra cui Python, Java, JavaScript/TypeScript, C#, Go e altri, con vantaggi per l’intero stack tecnologico.

Un diagramma illustrativo che mostra un workflow di generazione del codice.

Un diagramma illustrativo che mostra un workflow di generazione del codice.

Le organizzazioni che usano CodeWhisperer come assistente per sviluppatori eliminano lavori ripetitivi, impongono standard di coding e permettono agli ingegneri di dedicarsi ad attività a maggior valore come design e debugging.

Tieni presente che CodeWhisperer entrerà a far parte di Amazon Q Developer.

Assistenti enterprise

Amazon Q Business è una soluzione low-code basata su RAG che consente di sviluppare assistenti conversazionali che recuperano dati aziendali tramite domande.

Architettura:

  • Recupero dei dati da Redshift, OpenSearch, SharePoint e S3 tramite connettori.
  • Il motore RAG recupera il contesto appropriato prima di attivare i foundation model.
  • Il gestore del dialogo controlla sessioni multi-turn, inclusi slot filling e gestione dello stato.
  • Il layer UI risponde a widget di chat, canali vocali e integrazioni Slack.

Scenari di deployment:

  • Trascrizione automatica e sintesi degli action item tramite assistenti per riunioni, con un risparmio superiore a due ore a settimana per i team.
  • L’implementazione di bot self-service devia le richieste di routine, riducendo del 30% i tempi di gestione.
  • Dashboard esecutive offrono insight in linguaggio naturale su vendite, inventario e KPI per utenti senza formazione BI.

Gli assistenti aiutano le organizzazioni a snellire il knowledge work, ridurre i costi operativi e abilitare livelli superiori di produttività.

Ulteriori casi d’uso ad alto valore

Il valore dell’AI generativa va oltre RAG, generazione di codice e assistenti, estendendosi a vari altri domini:

  • I sistemi possono generare descrizioni prodotto personalizzate, campagne email e interazioni in chat basate su profili individuali e analisi comportamentale.
  • La combinazione di Textract con modelli per il parsing di moduli e generazione consente la classificazione, marcatura e instradamento automatici di fatture, contratti e sinistri, oltre a task a valle (creazione ticket, flussi di approvazione e generazione report) tramite logica decisionale guidata dal modello.
  • L’analisi di transcript di supporto, feed social e chiamate di vendita tramite analytics conversazionale rivela trend di sentiment, rischi di conformità e raccomandazioni azionabili.

Parti da questi pattern per avviare pilot con ROI chiaro, poi passa all’ottimizzazione e alla scalabilità nell’organizzazione.

Modello di sicurezza e governance

Quando adottano l’AI generativa, le imprese devono implementare controlli di sicurezza e pratiche di governance in ogni fase del ciclo di vita dell’AI. 

AWS fornisce un framework completo di sicurezza e conformità, dai data center fisici alle policy a livello applicativo, abilitando un’innovazione fiduciosa.

Architettura di protezione dei dati

AWS protegge i carichi di lavoro di AI generativa attraverso sei livelli concentrici di sicurezza:
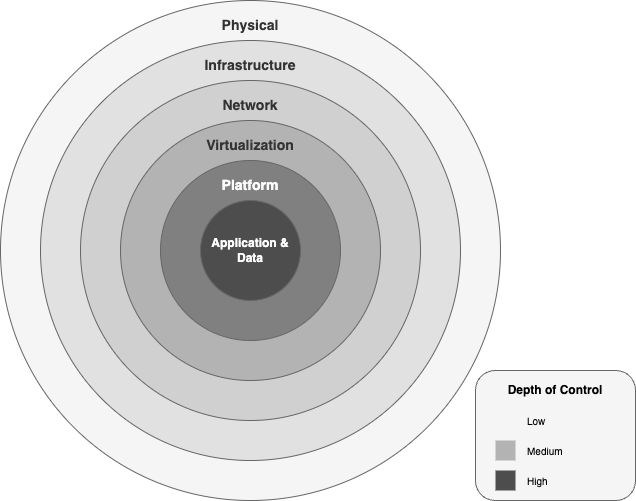
  • Il livello fisico dei data center prevede controlli di accesso multi-fattore, screening biometrici e monitoraggio 24/7, assicurando che l’accesso all’hardware resti limitato al personale autorizzato.
  • La rete globale AWS protegge il traffico AI con connessioni in fibra private e mitigazione DDoS, nonché AWS Shield Advanced, mantenendo un’elevata velocità di rete grazie all’isolamento del traffico da Internet pubblica.
  • Endpoint dei modelli e pipeline dati restano sicuri grazie a VPC con security group granulari, ACL di rete ed endpoint PrivateLink, operando all’interno delle tue reti private.
  • Il Nitro System sposta le operazioni di virtualizzazione su componenti hardware specializzati, offrendo velocità bare metal e protezione hardware-based contro condivisioni non autorizzate di dati tra macchine virtuali.
  • Il livello di piattaforma degli endpoint Bedrock e SageMaker si integra con AWS KMS per chiavi gestite dal cliente, utilizza cifratura TLS 1.2+ per la trasmissione dei dati e impone permessi IAM basati sul principio del privilegio minimo.
  • Il livello applicativo e dei dati implementa policy di risorsa granulari con cifratura AES-256 a riposo e in transito e integra audit logging tramite CloudTrail e CloudWatch per proteggere e registrare ogni chiamata API.

Un diagramma illustrativo dei livelli di sicurezza all'interno del framework di AI generativa di AWS.

Un diagramma illustrativo dei livelli di sicurezza all’interno del framework di AI generativa di AWS.

Isolamento dei dati e conformità:

  • Ogni istanza di inference Bedrock opera all’interno della tua VPC, accedendo e modificando bucket S3 che gestisci tu.
  • Selezioni CMK gestite dal cliente tramite AWS KMS e puoi usare external key store (XKS/HYOK) per soddisfare requisiti di sovranità.
  • AWS mantiene numerose certificazioni, tra cui ISO 27001 e SOC 1/2/3, FedRAMP High, HIPAA, PCI DSS e GDPR, che si estendono automaticamente ai carichi di AI generativa senza sforzi duplicati.

Framework di AI responsabile

Sviluppare fiducia nell’AI generativa richiede l’implementazione di protocolli etici e di sicurezza in ogni fase dell’invocazione del modello. AWS applica la governance dell’AI responsabile tramite il seguente framework:

  • I principi etici di AWS danno priorità a equità, privacy, trasparenza e responsabilità per prevenire bias discriminatori nei modelli e mantenere documentazione chiara su lineage dei dati e logica decisionale.
  • Il sistema Bedrock Guardrails fornisce filtri basati su policy che controllano input e output rispetto a categorie quali hate speech e violenza, autolesionismo e disinformazione. Le API Invoke e ApplyGuardrail permettono di implementare guardrail per i controlli di sicurezza in modo indipendente o tramite la Invoke API.
  • Tutte le richieste e le decisioni dei guardrail sono loggate tramite CloudTrail, mentre le model card e i report di valutazione mostrano metriche di performance, potenziali bias e trade-off costo/latenza.
  • La supervisione continua è fornita dai workflow di rilevamento bias di SageMaker Clarify e dalla revisione human-in-the-loop per output a bassa confidenza, oltre ad alert automatici di drift per ri-addestramento o revoca.

Questi livelli e pratiche stabiliscono una difesa in profondità per l’AI generativa enterprise, consentendoti di innovare mantenendo i più alti standard di sicurezza, conformità e responsabilità etica.

Strategie di ottimizzazione dei costi

Controllare i budget per l’AI generativa richiede sia piena conoscenza dei meccanismi di prezzo sia pratiche continue di gestione dei costi. Questa sezione spiega i prezzi AWS per i carichi AI, presentando un esempio di TCO per un deployment medio e strategie per ridurre le spese.

Analisi del modello di pricing

Il pricing dell’AI generativa su AWS si articola in quattro dimensioni principali:

  • Costi di compute
    • Ore endpoint: addebito per ora/istanza, variabile per famiglia
      • Inf1.xlarge a $0,228/ora
      • G5.xlarge a $1,006/ora
    • Job di training: fatturati per ora/istanza su hardware Trn1, P4 o P5 (es. Trn1.32xlarge a $21,50/ora)
  • Commissioni per token/richiesta
    • Token di prompt: $0,0008 per 1 K token
    • Token di completamento: $0,0016 per 1 K token
  • Storage e trasferimento dati
    • Artifact dei modelli: S3 Standard a $0,023/GB-mese
    • Uscita dati: $0,09/GB oltre il free tier
  • Personalizzazione e valutazione
    • Fine-tuning: ulteriori costi orari di training per istanza più costi minimi di processamento dati.
    • Esecuzioni di valutazione: commissioni per token per confronti tra baseline e modelli personalizzati.

Strategie di ottimizzazione dei costi

  • Scegli il silicio giusto: usa Inferentia (Inf1/Inf2) per inference ad alto volume e bassa latenza e Trainium (Trn1) per training su larga scala per ridurre $/TPU-ora.
  • Batch e cache dei prompt: raggruppa richieste simili e metti in cache le risposte popolari per ridurre spese ripetitive di token.
  • Endpoint multi-modello: ospita più modelli piccoli dietro un unico endpoint—scambiando latenza di picco per una significativa riduzione dei costi orari inattivi.
  • Capacità Spot e riservata: impegna una frazione della capacità di base con Reserved Instances o usa Spot per workload batch non critici.
  • Prompt engineering: snellisci le istruzioni per minimizzare i token per richiesta senza sacrificare la qualità.

Confronto tra architetture

Architettura

Driver di costo compute

Driver di costo token

Miglior utilizzo

Chatbot in tempo reale

Molti endpoint piccoli attivi 24×7

Alto tasso di richieste, pochi token

Supporto clienti, Help desk

Generazione batch

Istanze grandi di breve durata

Pochi burst con molti token

Generazione report, Data augmentation

Pipeline RAG

Ricerca + inference combinate

Token di retrieval + token di generazione

Assistenti ancorati alla conoscenza

Modello di costo totale di proprietà

Di seguito un TCO mensile di esempio per un pilota di AI generativa di medie dimensioni:

Voce di costo

Costo unitario

Utilizzo

Costo mensile

Endpoint di inference (Inf1.xl)

$0,228 /ora

3 endpoint × 24 ore × 30 giorni

$492,48

Uso token (Titan Express)

$0,0024 /1 K token

3 M token/giorno × 30 giorni

$216,00

Storage S3 (artifact modello)

$0,023 /GB-mese

10.000 GB

$230

Uscita dati

$0,09 /GB

1 TB

$90

Glue ETL (prep feature)

$0,44 /DPU-ora

20 DPU-ore

$8,80

Totale


$1.037,28

Leve di ottimizzazione chiave:

  • Auto-scale a zero: smantella gli endpoint inattivi quando il traffico cala.
  • Endpoint multi-modello: consolida i modelli per ridurre fino al 60% i costi orari inattivi.
  • Reserved e Spot: blocca tariffe scontate per la capacità di base e usa Spot per job non sensibili alla latenza.
  • Compressione dei prompt: rifattorizza i prompt per eliminare token superflui, riducendo del 10–15% la spesa in token.

Gestione continua dei costi:

  • Usa l’AWS Pricing Calculator per modellare scenari prima del lancio.
  • Monitora l’uso reale in AWS Cost Explorer, impostando budget e avvisi per anomalie.
  • Tagga tutte le risorse AI per report di charge-back e showback chiari.

La combinazione di un’architettura consapevole dei prezzi con ottimizzazioni mirate e monitoraggio continuo ti consente di scalare l’AI generativa senza incorrere in costi eccessivi.

Roadmap di implementazione

Scalare l’AI generativa dal concept alla produzione richiede una metodologia sistematica e per fasi. La roadmap offre un approccio step-by-step, dalle valutazioni iniziali ai pilot di proof of concept fino alla creazione di una piattaforma enterprise resiliente.

Fasi di assessment e pilot

Il primo passo consiste nel verificare la fattibilità e ottenere l’allineamento degli stakeholder prima di procedere allo sviluppo completo dell’architettura.

  • Gap analysis e definizione degli obiettivi
    • Conduci interviste con i responsabili di business per raccogliere requisiti dei casi d’uso, criteri di successo e target di ROI.
    • Rivedi le attuali fonti dati, i controlli di qualità e sicurezza e le capacità ML.
    • Identifica gap di conformità o privacy (es. gestione PII) che il pilot deve affrontare.
  • Sviluppo della Proof of Concept (PoC)
    • Seleziona un caso d’uso ad alto valore (es. bot di supporto basato su RAG o riassuntore di documenti) per la prima fase.
    • Prepara l’infrastruttura minima: un endpoint Bedrock o SageMaker collegato a un piccolo dataset via S3 o OpenSearch.
    • Definisci metriche chiave (accuratezza, latenza, costo per richiesta) e strumenta dashboard CloudWatch.
  • Prototipazione rapida con guide passo-passo
    • Usa progetti di esempio dalla AWS Solutions Library (es. RAG Chatbot, demo CodeWhisperer) per costruire il prototipo.
    • Itera rapidamente su prompt e strategie di retrieval, documentando le lezioni apprese in una wiki condivisa.
  • Validazione degli stakeholder
    • Mostra il prototipo funzionale agli utenti finali e raccogli feedback su qualità dell’output e UX.
    • Raffina lo scope, aggiungi o rimuovi fonti dati e regola i parametri del modello in base all’uso reale.
    • Ottieni sponsorship esecutiva e budget per la fase successiva.

Fasi di foundation e scale

La PoC porta alla costruzione della piattaforma fondamentale prima dell’adozione su larga scala.
  • Costruzione della foundation della piattaforma
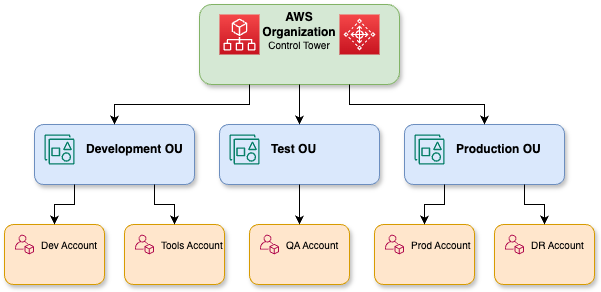
    • Definire la struttura multi-account di AWS Control Tower per i confini di dev, test e prod nell’area di landing.
    • Implementare ruoli e policy IAM, AWS SSO e controlli a privilegio minimo per accesso ai modelli e pipeline dati.
    • Configurare le VPC con endpoint PrivateLink. Abilitare CMK KMS per Bedrock/SageMaker e distribuire il monitoraggio GuardDuty.
    • Automatizzare ETL con AWS Glue/Athena, catalogare gli asset in Lake Formation e sincronizzare gli archivi di conoscenza per RAG.

Una rappresentazione dettagliata di AWS Organizations che mostra varie strutture di account.

Una rappresentazione dettagliata delle organizzazioni AWS.

  • MLOps e governance dei modelli
    • Automatizzare ri-addestramento, valutazione e deployment tramite pipeline CI/CD con CodeCatalyst o CodePipeline.
    • Stabilire un model registry in SageMaker o un catalogo basato su Git per versionare artifact di base e di fine-tuning.
    • Rilevare automaticamente il drift ed eseguire ri-addestramenti pianificati per garantire prestazioni e conformità.
  • Scalare in produzione
    • Allineare i pattern di traffico variabili tramite endpoint Bedrock o SageMaker con auto scaling.
    • Usare endpoint multi-modello per ospitare più FM piccoli dietro un’unica API, riducendo fino al 60% i costi inattivi.
    • Distribuire su più Availability Zone e implementare rollout canary per aggiornamenti senza downtime.
  • AWS Partner Network e Innovation Center
    • Coinvolgi Consulting Partner per accelerator specifici di dominio in finanza, sanità e retail.
    • Utilizza AWS Marketplace per ottenere connettori chiavi in mano e modelli pre-addestrati di dominio dai Technology Partner.
    • Collabora con AWS Innovation Center e Community Builders per accedere a hackathon, review architetturali e workshop pratici per accelerare l’adozione delle best practice.

L’approccio per fasi—validazione, costruzione della foundation e poi scalabilità con governance e supporto dei partner—ti aiuterà a trasformare il pilot di AI generativa in una capacità robusta a livello enterprise.

Fasi di ottimizzazione e governance

Il perfezionamento continuo e pratiche di governance solide, implementati dopo la scalabilità della piattaforma di AI generativa, garantiscono prestazioni elevate mantenendo sicurezza e conformità normativa.
Ottimizzazione continua

  • Monitoraggio e alerting automatizzati
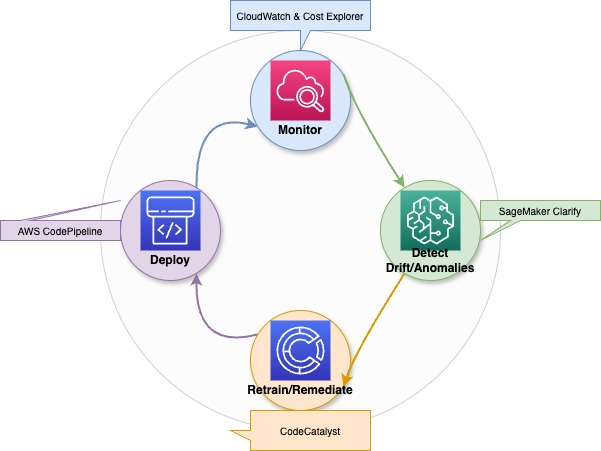
    • Gli endpoint Bedrock/SageMaker richiedono metriche CloudWatch (latenza, tassi di errore, throughput) e dashboard di Cost Explorer per l’osservabilità.
    • Configura allarmi di rilevamento anomalie, ad es. improvvisi picchi di spesa in token o regressioni della latenza di inference, e attiva workflow di auto-rimediation (scale up/down, rollback del modello).

Un diagramma illustrativo che mostra ottimizzazione continua, rilevamento del drift e processi di ri-addestramento per modelli di AI generativa.

Un diagramma illustrativo che mostra ottimizzazione continua, rilevamento del drift e ri-addestramento per modelli di AI generativa.

  • Rilevamento del drift e ri-addestramento
    • Usa rilevatori di drift basati su embedding o SageMaker Clarify per segnalare spostamenti nella distribuzione dei dati.
    • Le soglie di drift attivano pipeline di ri-addestramento automatiche tramite CodePipeline/CodeCatalyst per mantenere accuratezza e imparzialità del modello.
  • Ottimizzazione dei costi
    • Rivedi regolarmente i costi di ore inattive e consolida i modelli in endpoint multi-modello quando possibile.
    • Affina i prompt per ridurre l’uso di token non necessari e batcha le richieste a bassa priorità.

Governance e audit di conformità

  • Audit pianificati
    • La tua organizzazione dovrebbe condurre verifiche trimestrali di policy IAM, uso delle chiavi KMS, configurazioni degli endpoint VPC e log CloudTrail per confermare l’aderenza a accesso a privilegio minimo e standard di cifratura.
    • AWS Audit Manager e le regole AWS Config abilitano la raccolta automatizzata di evidenze per mandati ISO, HIPAA o SOC.
  • Enforcement delle policy
    • La tua organizzazione deve aggiornare Bedrock Guardrails con policy sui contenuti e condurre verifiche dei filtri per categoria a ogni release.
    • La pipeline CI/CD dovrebbe implementare una approval gate che impedisca il deployment della versione del modello in caso di fallimento delle valutazioni di sicurezza o imparzialità.

Formazione continua e sviluppo delle competenze

  • AWS Skill Builder
    • Il learning path su Generative AI in AWS Skill Builder dovrebbe coinvolgere i team per apprendere le basi di Bedrock, i pattern RAG e le best practice di deployment sicuro.
    • I laboratori pratici insegnano a configurare istanze Trn1/Inf1, impostare Guardrails ed eseguire il rilevamento bias con SageMaker Clarify.
  • Certificazioni e community
    • Gli ingegneri dovrebbero perseguire le certificazioni AWS Certified Machine Learning – Specialty e AWS Certified Security – Specialty.
    • Gli AWS Community Builders e gli Innovation Center offrono workshop, hackathon e sessioni di review architetturale per restare aggiornati su nuovi servizi, review e programmi accelerator.

Integrando ottimizzazione continua e audit rigorosi con pratiche di apprendimento organizzativo, puoi sostenere una capacità di AI generativa resiliente, affidabile e conveniente.

Risorse e primi passi

Il percorso nell’AI generativa su AWS può essere accelerato tramite learning path, community e progetti hands-on che costruiscono fiducia e generano impatto reale sul business.

AWS Skill Builder e risorse di training

  • Il learning path su Generative AI in AWS Skill Builder offre una formazione completa su foundation model, pipeline RAG e best practice di deployment sicuro.
  • Le piattaforme interattive PartyRock e Bedrock Playground permettono di testare prompt engineering, fine-tuning e inference senza configurare infrastruttura.
  • I lab guidati mostrano come creare istanze Trn1 e Inf1 e impostare endpoint cifrati con KMS prima di distribuire workflow RAG end-to-end.

Community degli sviluppatori ed ecosistema dei partner

  • L’AWS Generative AI Community e il Developer Center offrono accesso a esempi di codice, forum e whitepaper curati sulla Well-Architected Generative AI Lens.
  • L’AWS Partner Network fornisce accelerator predefiniti, foundation model di dominio e connettori chiavi in mano, tutti disponibili nell’AWS Marketplace.
  • Gli AWS Innovation Center e i Community Builders offrono workshop, hackathon e sessioni di review architetturale che aiutano ad accelerare l’implementazione.

Guide passo-passo e progetti di esempio

  • La piattaforma DataCamp offere tutorial passo-passo e template di soluzione che consentono di ottenere codice da personalizzare tramite fork.
  • I repository end-to-end dimostrano come utilizzare Textract per l’ingest dei dati, l’orchestrazione RAG con SageMaker e Polly per l’output vocale.
  • È possibile distribuire progetti pienamente funzionali tramite la piattaforma, modificando prompt, modelli e pipeline per casi d’uso enterprise e misurazione delle prestazioni.

Conclusione

L’AI generativa di AWS offre un sistema end-to-end completo—foundation model, compute ottimizzato, governance, integrazione e controllo dei costi—per aiutare le imprese a innovare più velocemente e ridurre l’overhead operativo, costruendo applicazioni multimodali affidabili su larga scala.

Attraverso sperimentazione, apprendimento continuo e collaborazione con la community, potrai sfruttare appieno il potenziale dell’AI generativa su AWS per generare reale impatto di business.


Rahul Sharma's photo
Author
Rahul Sharma
LinkedIn
Twitter

Rahul Sharma è un AWS Ambassador, DevOps Architect e blogger tecnico specializzato in cloud computing, pratiche DevOps e tecnologie open source. Con esperienza in AWS, Kubernetes e Terraform, semplifica concetti complessi per chi studia e per i professionisti attraverso articoli e tutorial coinvolgenti. Rahul è appassionato di risolvere le sfide DevOps e di condividere idee per dare forza alla community tech.

Argomenti
AWS
Intelligenza artificiale

Approfondisci AWS con questi corsi!

Corso

Concetti di tecnologie e servizi cloud AWS

3 ore
22.3K
Impara alla grande la tecnologia cloud AWS con lezioni pratiche e applicazioni reali nell'ecosistema AWS.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

Mostra AltroMostra Altro