L'IA générative AWS représente l'avenir des services cloud, car elle permet aux entreprises de créer du contenu automatisé et des tâches cognitives grâce à des modèles de base qui produisent du texte, des images et des vidéos en temps réel.
Dans cet article, je présente un aperçu complet des éléments essentiels des méthodes de déploiement et des cadres de gouvernance nécessaires pour développer des solutions d'IA générative prêtes à être mises en production.
AWS est le premier fournisseur de services cloud, car il propose Amazon Bedrock ainsi qu'une infrastructure informatique spécialisée et de vastes capacités d'intégration qui surpassent les autres plateformes cloud.
Si vous découvrez AWS, ce cours d'introductionvous permettra d'acquérir des bases solides avant de vous plonger dans les spécificités de l'IA générative.
Compréhension des composants principaux
Dans cette section, nous examinerons les éléments constitutifs qui alimentent l'IA générative d'AWS.
Écosystème du modèle de base
Bedrock sert de plan de contrôle géré pour toute l'IA générative sur AWS. Il fournit une API cohérente pour le déploiement, la mise à l'échelle et la sécurisation des modèles de base, depuis la mise à disposition des terminaux jusqu'à la facturation. Vous pouvez ainsi vous concentrer sur la création d'invites et l'intégration de l'IA plutôt que sur la gestion de l'infrastructure.
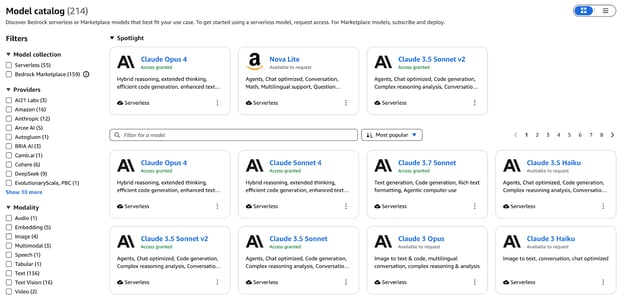
Un diagramme conceptuel illustrant l'écosystème du modèle de base AWS.
Lecatalogue Bedrockunifie les modèles pour le texte, l'image, la vidéo et les intégrations sous une seule interface. Nos principales offres comprennent :
- Titan Text (Premier, Express, Lite) : Fenêtres contextuelles pouvant contenir jusqu'à 32 000 tokens pour les dialogues complexes
- Nova Canvas : Génération et restauration haute fidélité de texte en image pour des ressources créatives respectueuses de l'image de marque
- Nova Reel : Courts clips vidéo animés générés à partir d'une seule invite
- Embeddings multimodaux Titan G1 : Encode le texte et les images dans un espace vectoriel partagé pour la recherche de similitudes et le RAG.
Affinez vos modèles à partir de vos données étiquetées ou poursuivez le pré-entraînement sur des corpus spécifiques à votre domaine via la console Bedrock ou le SDK. Une fois la formation terminée, la suite d'évaluation de Bedrock effectue des comparaisons parallèles et génère des rapports sur la précision, la latence et le coût par jeton, ce qui vous permet de choisir objectivement la variante optimale pour les accords de niveau de service (SLA) de production.
Au-delà des familles Titan et Nova d'AWS, Bedrock vous donne accès à des modèles partenaires d'Anthropic, Cohere, Mistral, AI21 Labs et bien d'autres encore. Tirez parti de cette diversité pour :
- Développez des assistants de connaissances alimentés par RAG qui fournissent des réponses précises à partir de wikis internes.
- Créez du contenu marketing et des images à grande échelle tout en conservant une voix de marque cohérente.
- Intégrez la complétion et la révision de code basées sur l'IA dans les workflows des développeurs.
- Enrichissez vos ensembles de données d'entraînement en synthétisant du texte, des images ou des vidéos adaptés à votre domaine.
Pour en savoir plus sur la manière dont Bedrock orchestre ces modèles de base dans les environnements de production, veuillez consulter ce guide complet sur Amazon Bedrock.
Les familles d'instances EC2 fournies par AWS ont été conçues pour répondre aux besoins spécifiques des opérations de formation et d'inférence.
Formation :
- Les instances Trn1 (Trainium) fonctionnent avec des puces AWS Trainium afin de fournir des capacités de formation en apprentissage profond, notamment des modèles LLM et de diffusion, à une vitesse trois fois supérieure et à un coût horaire réduit par rapport aux instances basées sur GPU.
- Les P5 et P4 (GPU NVIDIA H100 et A100) offrent des capacités de traitement parallèle étendues grâce à la prise en charge de la précision mixte, qui convient aussi bien aux tests de recherche qu'aux processus de réentraînement à grande échelle.
Conclusion :
- Les puces AWS Inferential utilisées dans les systèmes Inf1 et Inf2 permettent des inférences en temps réel avec des latences de l'ordre de quelques millisecondes, tout en offrant un coût par inférence deux fois moins élevé que les alternatives GPU.
- Les processeurs G5 et G4dn (GPU NVIDIA A10G et T4) offrent un rapport performances/prix équilibré, idéal pour l'accélération GPU en temps réel dans les applications de chatbot et de moteur de recommandation.
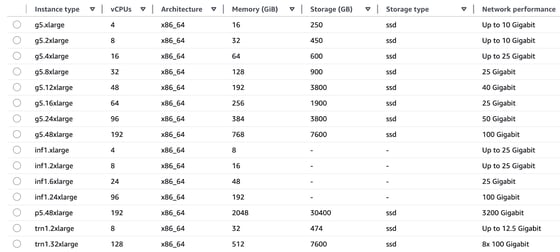
Un schéma illustratif de l'infrastructure informatique optimisée par l'IA d'AWS.
AWS assure une intégration transparente entre ses composants matériels et logiciels conçus sur mesure grâce à Trainium pour la formation et Inferentia pour les puces d'inférence, qui fonctionnent directement avec les services AWS. Cette intégration verticale permet d'obtenir :
- Le rapport qualité-prix supérieur de TensorFlow et PyTorch pour les charges de travail permet de réduire le coût total de possession.
- La combinaison de l'efficacité énergétique et de la simplification des achats permet aux équipes d'éviter la dépendance vis-à-vis d'un fournisseur de GPU.
- SageMaker et Bedrock intègrent des fonctionnalités de dimensionnement automatique qui permettent aux utilisateurs de sélectionner les configurations de silicium optimales en quelques clics, sans avoir à gérer les détails au niveau des puces.
Le système AWS Nitro utilise des cartes matérielles dédiées pour exécuter les fonctions de virtualisation, offrant ainsi des vitesses bare metal rapides et une isolation sécurisée :
- Le Nitro Hypervisor dispose d'un code source minimal, ce qui réduit les vulnérabilités tout en séparant les charges de travail les unes des autres.
- Les chemins réseau et de stockage accélérés par le matériel fonctionnent à un débit d'E/S élevé et avec de faibles niveaux de gigue, ce qui évite les pics de latence et garantit des performances constantes en cas de charge maximale.
- L'intégration de Nitro avec CloudTrail, CloudWatch et AWS Config assure une surveillance de la conformité de bout en bout sans aucune dégradation des performances.
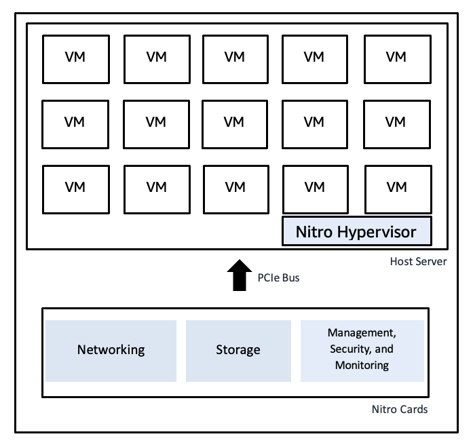 Schéma illustratif du hyperviseur Nitro d'AWS
Découvrez l'écosystème plus vaste du calcul, du stockage et de l'analyse dans ce courssur la technologie et les services cloud AWS.
Fondements des données pour une IA générative robuste
La formation de modèles à grande vitesse et les pipelines RAG nécessitent l'accès à des données propres et correctement gérées :
- Le système de stockage de données à l'échelle du pétaoctet d'Amazon S3 s'intègre à Lake Formation pour offrir des fonctionnalités de catalogage et de sécurité pour l'ingestion de jeux de données bruts et organisés.
- La solution d'entreposage de données Amazon Redshift fonctionne comme une plateforme pour des tableaux structurés qui fournissent des analyses et une récupération rapide des données.
- Les pipelines de transformation des données créés avec AWS Glue et Athena permettent de préparer les fonctionnalités et le contexte pour les charges de travail génératives et l'exécution de requêtes ad hoc.
- La gouvernance des données et les mécanismes de traçabilité garantissent que la formation des modèles utilise des données fiables, tandis que les connaissances de l'entreprise étayent les résultats grâce au contrôle d'accès et au suivi de la provenance.
Cadre d'intégration d'entreprise
Les capacités d'IA générative d'AWS s'intègrent directement à son écosystème plus large afin de fournir des solutions de bout en bout adaptées à la production. Cette section décrit le processus de combinaison de Bedrock avec ses services associés afin de développer des applications d'IA générative concrètes.
Cycle de vie ML unifié avec SageMaker JumpStart et Bedrock
Sélectionnez des modèles de base dans le hub de modèles SageMaker JumpStart et déployez-les immédiatement. Vous pouvez déployer de nombreux modèles open source et propriétaires à l'aide d'un seul bouton avant de les enregistrer directement dans Amazon Bedrock. Les modèles enregistrés dans Bedrock bénéficient des avantages suivants :
- Modération du contenu et application des politiques grâce à des fonctionnalités de protection.
- Les bases de connaissances offrent des fonctionnalités de génération augmentée par la recherche (RAG) pour les sources de données privées.
- L'API Converse assure la cohérence en fournissant une couche d'abstraction qui élimine les variations spécifiques aux modèles.
L'architecture intégrée permet aux développeurs de créer des prototypesdans SageMaker Studio, puis de les améliorer dans Bedrock avant de les déployer via des pipelines CI/CD sans modification du code.
Ce tutoriel SageMaker vous guide à travers le processus de réglage fin et de déploiement de modèles à l'aide de la plateforme ML phare d'AWS.
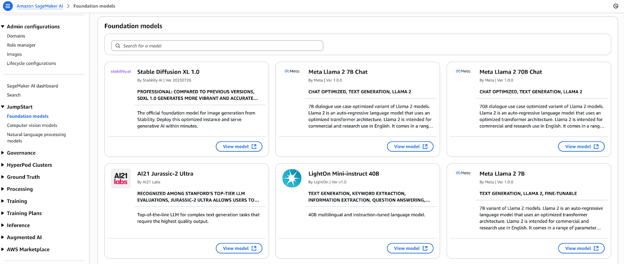 Un diagramme illustratif présentant le cycle de vie unifié du ML avec SageMaker JumpStart et Bedrock.
Orchestration des flux de travail avec Amazon Bedrock Agents
Grâce à Bedrock Agents, vous pouvez intégrer l'IA générative à vos applications opérationnelles en récupérant automatiquement les données et en les transformant avant d'exécuter des actions. Un agent ne nécessite qu'une configuration de base pour :
- Le système établit des connexions sécurisées aux API RESTful ainsi qu'aux bases de données et aux files d'attente de messages.
- Le système collecte les documents, les métriques et les données de journalisation tout en effectuant des tâches de prétraitement avant de mettre les données à la disposition des modèles.
- Le système effectue plusieurs opérations en arrière-plan, notamment la validation de l'enrichissement et la notification par le biais d'appels de fonctions séquentiels.
- Le système génère des résultats structurés ou conversationnels destinés à être utilisés par les systèmes en aval.
Les fonctionnalités de base des agents permettent aux développeurs de se concentrer sur la logique métier plutôt que sur le code d'intégration, accélérant ainsi la rentabilisation.
Création d'assistants conversationnels avec Amazon Q
Amazon Q est un service entièrement géré permettant de développer des assistants professionnels basés sur la technologie RAG.
Le service intègre la fonctionnalité multimodèle Bedrock avec :
- L'entrepôt de données (Redshift), le moteur de recherche (OpenSearch) et les connecteurs d'outils BI sont préconfigurés.
- Le système comprend des fonctionnalités intégrées pour la gestion des dialogues à plusieurs tours de parole, ainsi que le contexte de la session et la génération de réponses de type citation.
- La plateforme comprend un outil de développement d'interface utilisateur à faible code permettant de créer rapidement des prototypes.
Grâce à Q, les entreprises créent des chatbots destinés à leurs clients, ainsi que des tableaux de bord pour les cadres et des services d'assistance spécifiques à leur domaine, qu'elles déploient en quelques semaines au lieu de plusieurs mois.
La lentille IA générative bien conçue met en œuvre les meilleures pratiques à chaque étape du développement des charges de travail génératives.
Lentille IA générative bien conçue
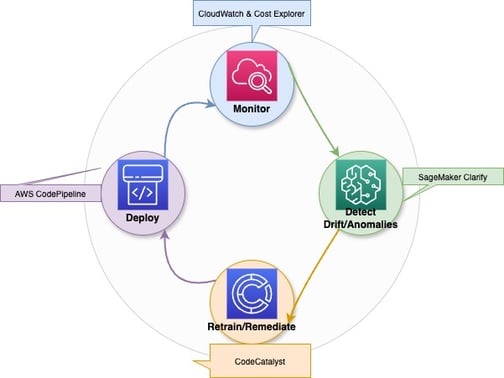
La lentille IA générative d'AWS étend les cinq piliers du cadre Well-Architected aux charges de travail génératives. Le cadre comprend des systèmes automatisés de surveillance des modèles et des mécanismes de détection des dérives, ainsi que des déclencheurs de recyclage avec gestion des artefacts de version et suivi des métriques d'inférence.
Voici les piliers :
- Sécurité : Appliquez une gestion des accès basée sur le principe du moindre privilège, utilisez PrivateLink pour les points de terminaison Bedrock, cryptez les données en transit et au repos, et appliquez des mesures de protection par filtrage de contenu.
- Fiabilité : La solution utilise le déploiement de terminaux basé sur AZ, l'auto-scaling, des disjoncteurs et le déploiement Canary pour des déploiements sans risque.
- Efficacité des performances : Sélectionnez les familles d'instances optimales, mettez en cache les invites fréquentes et les requêtes par lots, et tirez parti des points de terminaison sans serveur pour évoluer vers zéro.
- Optimisation des coûts : La sélection des modèles doit respecter les exigences en matière de latence lors de l'utilisation de la capacité ponctuelle ou réservée, l'ingénierie rapide doit minimiser l'utilisation des jetons et l'analyse des coûts doit être effectuée dans Cost Explorer.
- Durabilité : Dimensionnez correctement vos ressources informatiques, utilisez des puces à faible consommation d'énergie (Trainium, Inferentia), archivez les données inactives dans S3 Glacier et adoptez des pipelines sans serveur afin de réduire les ressources inutilisées.
Pour ceux qui souhaitent obtenir une certification, le cursus AWS Cloud Practitionercorrespond parfaitement aux connaissances fondamentales abordées ici.
Accélérer l'adoption avec les partenaires AWS
Le réseau de partenaires AWS offre un soutien aux entreprises en accélérant leur adoption des services AWS grâce à des accélérateurs de solutions et des services partenaires. Chaque entreprise est unique, c'est pourquoi AWS a mis en place le réseau de partenaires avec des accélérateurs d'IA générative spécifiques pour différents secteurs et cas d'utilisation.
- Le réseau de partenaires AWS comprend des partenaires technologiques qui fournissent des applications préconfigurées ainsi que des connecteurs et des modèles de base spécifiques à un domaine, disponibles via AWS Marketplace.
- Le programme Generative AI Accelerator soutient les start-ups en leur offrant des crédits, un mentorat et des modèles de bonnes pratiques afin d'accélérer le développement de la preuve de valeur.
- L'utilisation des cadres des partenaires APN, associée aux modèles de solutions validés par AWS, permet aux équipes de réduire les risques lors des projets pilotes tout en déployant l'IA générative dans l'ensemble de leur organisation en toute confiance.
Présentation des services d'intelligence artificielle AWS pris en charge
La capacité de l'IA générative à générer de nouveaux contenus ne correspond pas aux exigences des applications du monde réel, qui doivent traiter et comprendre les données sous divers formats de présentation.
AWS fournit un ensemble de services complémentaires qui s'intègrent à vos pipelines génératifs afin de convertir des documents non structurés en données structurées, d'extraire des informations à partir d'images et de permettre des conversations naturelles et la diffusion de résultats dans n'importe quelle langue ou voix.
Voici les plus populaires :
- Amazon Textract
- Le système détecte automatiquement le texte imprimé, les tableaux et les données de formulaire dans les documents numérisés et les fichiers image.
- Le système utilise des pipelines RAG pour traiter des documents spécifiques à un domaine, notamment des contrats, des rapports et des factures.
- Le système organise le contenu non structuré afin de le préparer pour les modèles de réponse rapide et l'ajustement des ensembles de données.
- Amazon Rekognition
- Le système utilise l'analyse d'images et de vidéos pour identifier des objets, des scènes, du texte, des visages et des activités.
- Le système génère des métadonnées contextuelles (étiquettes, scores de confiance) pour la génération multimodale.
- Le système permet aux utilisateurs de mettre en œuvre une logique conditionnelle (par exemple, « décrire uniquement les images contenant des personnes ») dans leurs applications destinées aux utilisateurs finaux.
- Amazon Polly
- Ce service transforme du texte écrit en audio parlé de manière naturelle, dans plusieurs langues et avec différentes voix.
- La fonctionnalité de sortie audio transforme les chatbots et assistants génératifs en interfaces interactives.
- Le système prend en charge le balisage SSML pour contrôler la sortie vocale grâce à une prononciation précise, des accents toniques et une gestion des pauses.
- Pour découvrir comment Polly permet de générer des voix humaines dans des applications réelles, veuillez consulterce tutoriel pratique.
- Amazon Lex
- Le système développe des interfaces conversationnelles grâce à la reconnaissance vocale automatique (ASR) et à la compréhension du langage naturel (NLU).
- Le système sert d'interface frontale pour les générateurs back-end, gérant la gestion des sessions et les opérations de remplissage des emplacements.
- Le système se connecte directement à AWS Lambda afin d'exécuter les points de terminaison Bedrock ou SageMaker pour générer des réponses dynamiques.
- Amazon Traduction
- Le service propose des services de traduction automatique neuronale immédiate pour plus de 70 langues différentes.
- Le système adapte les résultats génératifs afin de les rendre accessibles à un public international.
- Le système normalise les entrées multilingues, ce qui permet à un seul modèle de servir des utilisateurs de différentes régions.
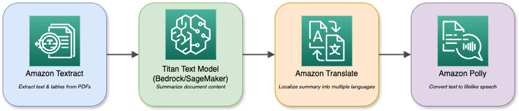
Un diagramme illustratif des différents services AWS et de leurs interactions.
Vos modèles de base dans Bedrock ou SageMaker peuvent être associés à ces services pour créer des applications multimodales complexes.
Un assistant d'analyse de documents, par exemple, utilise Textract pour ingérer des fichiers PDF, puis Titan Text pour les résumer avant de traduire le résumé en plusieurs langues et de le restituer via Polly. L'écosystème modulable vous permet de combiner diverses capacités d'IA afin de répondre à toutes les exigences de votre entreprise.
Modèles de mise en œuvre et cas d'utilisation
L'IA générative offre les meilleurs résultats lorsque vous utilisez des modèles bien conçus pour répondre à des problèmes commerciaux concrets.
Cette section présente quatre plans de mise en œuvre spécifiques, notamment la génération augmentée par la récupération et les assistants pour développeurs et entreprises, ainsi que d'autres scénarios à forte valeur ajoutée que vous pouvez mettre en œuvre dès aujourd'hui.
Architectures de génération augmentée par la récupération (RAG)
La combinaison des capacités de recherche et des modèles linguistiques volumineux dans la génération augmentée par la récupération produit des réponses précises qui restent ancrées dans le contexte. Le pipeline en quatre étapes fonctionne comme suit :
- Le système récupère les N documents ou passages les plus pertinents à partir d'un magasin vectoriel ou d'un index de recherche à l'aide d'une requête.
- Le système transforme les documents et les requêtes des utilisateurs en intégrations sémantiques, ce qui permet un meilleur alignement contextuel.
- Le système transmet la requête et le contexte récupéré à un modèle de base afin de générer une réponse.
- Le système utilise un modèle secondaire ou heuristique pour noter et reclasser les résultats candidats, afin de présenter la réponse la plus appropriée.
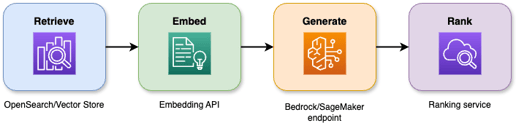
Un diagramme illustratif présentant une architecture de génération augmentée par la récupération (RAG).
Avantages et gains en termes de précision :
- Le système réduit les hallucinations de 40 % par rapport aux méthodes de génération de base.
- Les projets pilotes de base de connaissances d'entreprise démontrent que la pertinence des réponses s'améliore de 20 à 30 %.
- Le temps moyen d'interaction des utilisateurs diminue de 25 % lors de l'utilisation de systèmes d'assistance virtuelle.
Applications commerciales :
- Le contenu du wiki interne sert de base aux chatbots et aux assistants virtuels pour fournir des résumés de tickets et des conseils de dépannage.
- Les systèmes RAG intégrés à des interfaces utilisateur de recherche permettent aux utilisateurs d'explorer de vastes collections de documents à l'aide de recherches en langage naturel.
- Le système permet aux assistants chargés de la conformité, des questions juridiques et réglementaires de fournir des citations de sources lorsque les utilisateurs en font la demande.
Workflows de génération de code
AWS CodeWhisperer fournit une IA générative directement aux développeurs via leurs IDE et leurs pipelines CI/CD afin d'automatiser les tâches répétitives et d'accélérer les processus de codage.
- Le système offre trois fonctions principales, notamment des suggestions de code en temps réel, la complétion de fragments de code et la génération de tests qui s'adaptent à votre contexte de codage actuel.
- Les équipes accélèrent la livraison des fonctionnalités de 30 % et réduisent de 50 % les erreurs de syntaxe dans les premiers prototypes.
- Le pipeline CodeCatalyst permet aux utilisateurs de créer automatiquement des extraits IaC d'infrastructure, des tests unitaires et des scripts de déploiement grâce à l'intégration de CodeWhisperer.
- La plateforme prend en charge plusieurs langages de programmation, notamment Python, Java, JavaScript/TypeScript, C#, Go et d'autres langages, qui offrent des avantages à l'ensemble de votre pile technologique.
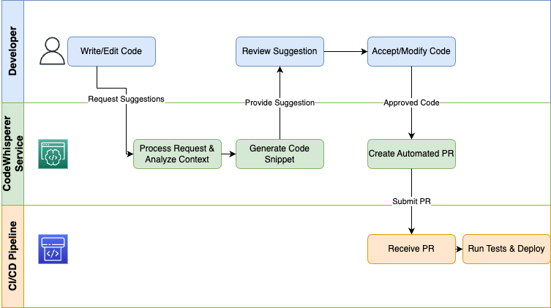
Un diagramme illustratif présentant un processus de génération de code.
Les organisations qui utilisent CodeWhisperer comme assistant de développement éliminent les tâches répétitives, appliquent les normes de codage et permettent aux ingénieurs de consacrer leur temps à des activités de conception et de débogage à forte valeur ajoutée.
Veuillez noterque CodeWhisperer fera désormais partie d'Amazon Q Developer.
Assistants d'entreprise
Amazon Q Business est une solution low-code basée sur la technologie RAG qui permet aux utilisateurs de développer des assistants conversationnels capables de récupérer des données d'entreprise à partir de questions.
Architecture :
- Le système récupère les données de Redshift, OpenSearch, SharePoint et S3 via des connecteurs.
- Le moteur RAG récupère le contexte approprié avant d'activer les modèles de base.
- Le gestionnaire de dialogue contrôle la gestion des sessions multi-tours, y compris le remplissage des emplacements et les opérations d'état.
- La couche UI est compatible avec les widgets de chat, les canaux vocaux et les intégrations Slack.
Scénarios de déploiement :
- La transcription et le résumé automatiques des actions à entreprendre grâce aux assistants de réunion permettent aux équipes de gagner plus de deux heures de travail par semaine.
- La mise en place de robots en libre-service permet de détourner les demandes courantes, ce qui se traduit par une réduction de 30 % du temps de traitement.
- Les tableaux de bord exécutifs fournissent des informations en langage naturel sur les ventes, les stocks et les indicateurs clés de performance aux utilisateurs qui n'ont pas besoin de formation en BI.
Les assistants aident les organisations à rationaliser le travail intellectuel, à réduire les coûts opérationnels et à permettre aux employés d'atteindre des niveaux de productivité plus élevés.
Autres cas d'utilisation à forte valeur ajoutée
La valeur de l'IA générative s'étend au-delà du RAG, de la génération de code et des assistants à divers autres domaines :
- Ces systèmes peuvent générer des descriptions de produits personnalisées, des campagnes par e-mail et des interactions par chat en fonction des profils individuels et de l'analyse comportementale.
- La combinaison de Textract avec des modèles d'analyse syntaxique et de génération permet la classification, le balisage et le routage automatiques des factures, contrats et réclamations, ainsi que les tâches en aval (création de tickets, routage des approbations et génération de rapports) grâce à une logique décisionnelle basée sur des modèles.
- L'analyse des transcriptions d'assistance, des flux de réseaux sociaux et des appels commerciaux à l'aide de l'analyse conversationnelle révèle les tendances en matière de sentiments, les risques de non-conformité et les recommandations exploitables.
Commencez par ces modèles pour mettre en place des projets pilotes démontrant un retour sur investissement clair avant de passer à l'optimisation et à la mise à l'échelle dans l'ensemble de votre organisation.
Modèle de sécurité et de gouvernance
Les entreprises doivent mettre en œuvre des contrôles de sécurité et des pratiques de gouvernance à chaque étape du cycle de vie de l'IA lorsqu'elles adoptent l'IA générative.
AWS fournit un cadre complet de sécurité et de conformité qui s'étend des centres de données physiques aux politiques au niveau des applications, permettant ainsi d'innover en toute confiance.
Architecture de protection des données
AWS protège les charges de travail d'IA générative grâce à six couches de sécurité concentriques :
- La couche physique des centres de données comprend des contrôles d'accès multifacteurs, un filtrage biométrique et une surveillance 24 heures sur 24, 7 jours sur 7, qui garantissent que l'accès au matériel est réservé au personnel autorisé.
- Le réseau mondial AWS protège le trafic IA grâce à des connexions fibre optique privées et à l'atténuation des attaques DDoS, ainsi qu'à AWS Shield Advanced, tout en maintenant un débit réseau élevé en isolant le trafic isolant le trafic du réseau Internet public.
- Les points de terminaison et les pipelines de données des modèles restent sécurisés grâce à la combinaison de VPC avec des groupes de sécurité granulaires, des listes de contrôle d'accès réseau et des points de terminaison PrivateLink, qui fonctionnent au sein de vos réseaux privés.
- Le système Nitro transfère les opérations de virtualisation vers des composants matériels spécialisés, qui offrent une vitesse et une protection matérielle de niveau bare-metal. une protection matérielle contre le partage non autorisé de données entre les machines virtuelles.
- La couche plateforme des points de terminaison Bedrock et SageMaker s'intègre à AWS KMS pour les clés gérées par le client, utilise le chiffrement TLS 1.2+ pour la transmission des données et applique les autorisations IAM sur la base du principe du moindre privilège.
- La couche application et la couche données mettent en œuvre des politiques de ressources très précises avec un chiffrement AES-256 au repos et en transit et intègrent la la journalisation des audits via CloudTrail et CloudWatch afin de protéger et d'enregistrer chaque appel API.
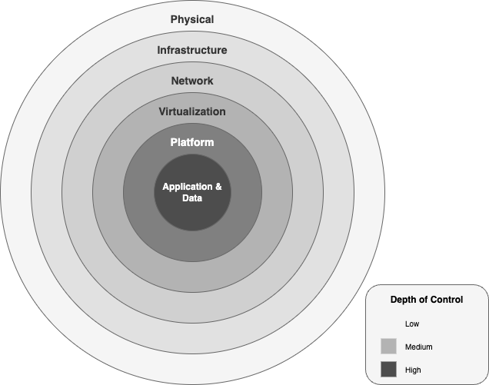
Un diagramme illustratif des couches de sécurité au sein du cadre d'IA générative AWS.
Isolation des données et conformité :
- Chaque instance d'inférence Bedrock fonctionne au sein de votre VPC tout en accédant aux compartiments S3 que vous gérez et en les modifiant.
- Vous sélectionnez les CMK gérées par le client via AWS KMS et avez la possibilité d'utiliser des magasins de clés externes (XKS/HYOK) pour répondre aux exigences de conformité souveraines.
- AWS dispose de plusieurs certifications, notamment ISO 27001 et SOC 1/2/3 Fed, RAMP High, HIPAA, PCI, DSS et GDPR, qui s'étendent automatiquement à vos charges de travail d'IA générative sans nécessiter d'efforts supplémentaires.
Cadre pour une IA responsable
Le développement de la confiance dans l'IA générative nécessite la mise en œuvre de protocoles éthiques et de sécurité à chaque étape de l'invocation du modèle. AWS met en œuvre une gouvernance responsable de l'IA à travers le cadre suivant :
- Les principes éthiques d'AWS privilégient l'équité, la confidentialité, la transparence et la responsabilité afin d'éviter tout biais discriminatoire dans les modèles et de conserver une documentation claire sur la provenance des données et la logique décisionnelle.
- Le système Bedrock Guardrails fournit des filtres basés sur des politiques qui vérifient à la fois les données entrantes et les résultats sortants par rapport à des catégories comprenant les discours haineux et la violence, l'automutilation et la désinformation. Les API Invoke et ApplyGuardrail permettent aux utilisateurs de mettre en œuvre des garde-fous pour les contrôles de sécurité, soit de manière indépendante, soit via l'API Invoke.
- Le système enregistre toutes les demandes et les décisions prises par le système de contrôle via CloudTrail, tandis que les fiches de modèle et les rapports d'évaluation affichent les indicateurs de performance, les biais potentiels et les compromis entre coût et latence.
- Le système assure une surveillance continue grâce aux workflows de détection des biais et de révision humaine de SageMaker Clarify pour les résultats peu fiables, ainsi qu'à des alertes automatiques de détection des dérives pour le réentraînement ou la révocation des modèles.
Ces couches et pratiques établissent une posture de défense en profondeur pour l'IA générative d'entreprise, vous permettant d'innover tout en respectant les normes les plus strictes en matière de sécurité, de conformité et de responsabilité éthique.
Stratégies d'optimisation des coûts
Le processus de contrôle des budgets consacrés à l'IA générative exige à la fois une connaissance approfondie des mécanismes de tarification et des pratiques de gestion continue des coûts. Cette section explique la tarification AWS pour les charges de travail IA, tout en présentant un exemple de coût total de possession pour un déploiement de taille moyenne et des stratégies pour réduire les dépenses.
Analyse du modèle de tarification
La tarification de l'IA générative AWS s'articule autour de quatre dimensions principales :
- Calculer les coûts
- Heures de point de terminaison : facturées par heure d'instance, en fonction de la famille
- Inf1.xlarge à 0,228 $/heure
- G5.xlarge à 1,006 $/heure
- Tâches de formation : facturées à l'heure d'instance sur du matériel Trn1, P4 ou P5 (par exemple, Trn1.32xlarge à 21,50 $/heure).
- Frais de jeton/demande
- Jetons instantanés : 0,0008 $ par 1 000 jetons
- Jetons d'achèvement : 0,0016 $ par 1 000 jetons
- Stockage et transfert de données
- Modèles d'artefacts : S3 Standard à 0,023 $/Go-mois
- Sortie de données : 0,09 $/Go au-delà du quota gratuit
- Personnalisation et évaluation
- Réglage fin : frais de formation supplémentaires par heure et par instance, plus frais minimes de traitement des données.
- Évaluations : frais de jetons pour les comparaisons de référence et personnalisées.
Stratégies d'optimisation des coûts
- Choisissez le bon silicone: Utilisez Inferentia (Inf1/Inf2) pour les inférences à haut volume et à faible latence, et Trainium (Trn1) pour les formations à grande échelle afin de réduire le coût par heure de TPU.
- r les invites de traitement par lots et de mise en cache: Regroupez les demandes similaires et mettez en cache les réponses courantes afin de réduire les dépenses répétitives en jetons.
- multimodèle des critères d'évaluation: Hébergez plusieurs modèles plus petits derrière un seul terminal, en sacrifiant la latence maximale pour réduire considérablement les coûts liés aux heures d'inactivité.
- s sur les places disponibles et réservées: Engagez-vous sur une fraction de la capacité de base avec les instances réservées ou utilisez Spot pour les charges de travail par lots non critiques.
- s techniques rapides: Simplifiez les instructions afin de réduire l'utilisation de jetons par requête sans compromettre la qualité.
Comparaison des architectures
|
Architecture
|
Calculer le facteur de coût
|
Facteur de coût des jetons
|
Meilleure correspondance
|
|
Chatbots en temps réel
|
De nombreux petits terminaux fonctionnant 24 heures sur 24, 7 jours sur 7
|
Taux de requêtes élevé, jetons de petite taille
|
Assistance clientèle, services d'assistance
|
|
Génération par lots
|
Instances de grande taille à courte durée de vie
|
Peu de pics importants de jetons
|
Génération de rapports, augmentation des données
|
|
Pipelines RAG
|
Recherche combinée + inférence
|
Jeton de récupération + jeton de génération
|
Assistants basés sur les connaissances
|
Modèle de coût total de possession
Vous trouverez ci-dessous un exemple de coût total de possession mensuel pour un projetpilote d'IA générative de taille moyenne:
|
Élément de coût
|
Coût unitaire
|
Utilisation
|
Coût mensuel
|
|
Critères d'évaluation de l'inférence (Inf1.xl)
|
0,228 $ / heure
|
3 critères d'évaluation × 24 heures × 30 jours
|
492,48 $
|
|
Utilisation des jetons (Titan Express)
|
0,0024 $ / 1 000 jetons
|
3 jetons M par jour × 30 jours
|
216,00 $
|
|
Stockage S3 (artefacts de modèle)
|
0,023 $ / Go par mois
|
10 000 GO
|
$230
|
|
Sortie des données
|
0,09 $ / GO
|
1 TO
|
$90
|
|
Coller ETL (préparation des fonctionnalités)
|
0,44 $ /DPU-heure
|
20 heures de travail par jour
|
8,80 $
|
|
Total
| | |
1 037,28 $
|
Principauxleviers d'optimisation:
- Auto-échelle à zéro: Supprimez les points de terminaison inactifs lorsque le trafic diminue.
- multimodèle des critères d'évaluation: Consolidez vos modèles afin de réduire les frais liés aux heures d'inactivité jusqu'à 60 %.
- s sur les réservations et les places disponibles: Bénéficiez de tarifs réduits pour la capacité de base et activez Spot pour les tâches non sensibles à la latence.
- s de compression rapide: Refactorisez les invites afin de supprimer les jetons superflus, ce qui permettra de réduire de 10 à 15 % la consommation de jetons.
Gestion continue des coûts :
- Veuillez utiliser le calculateur de prix AWS pourmodéliser différents scénarios avant le lancement.
- Surveillez l'utilisation réelle dans AWS Cost Explorer, définissez des budgets et des alertes en cas d'anomalies.
- Marquez toutes les ressources IA pour obtenir des rapports clairs sur la refacturation et la réimputation.
La combinaison d'une architecture sensible aux prix, d'optimisations ciblées et d'une surveillance continue vous permet de faire évoluer l'IA générative sans coûts excessifs.








L'IA générative AWS représente l'avenir des services cloud, car elle permet aux entreprises de créer du contenu automatisé et des tâches cognitives grâce à des modèles de base qui produisent du texte, des images et des vidéos en temps réel.
Dans cet article, je présente un aperçu complet des éléments essentiels des méthodes de déploiement et des cadres de gouvernance nécessaires pour développer des solutions d'IA générative prêtes à être mises en production.
AWS est le premier fournisseur de services cloud, car il propose Amazon Bedrock ainsi qu'une infrastructure informatique spécialisée et de vastes capacités d'intégration qui surpassent les autres plateformes cloud.
Si vous découvrez AWS, ce cours d'introductionvous permettra d'acquérir des bases solides avant de vous plonger dans les spécificités de l'IA générative.
Compréhension des composants principaux
Dans cette section, nous examinerons les éléments constitutifs qui alimentent l'IA générative d'AWS.
Écosystème du modèle de base
Bedrock sert de plan de contrôle géré pour toute l'IA générative sur AWS. Il fournit une API cohérente pour le déploiement, la mise à l'échelle et la sécurisation des modèles de base, depuis la mise à disposition des terminaux jusqu'à la facturation. Vous pouvez ainsi vous concentrer sur la création d'invites et l'intégration de l'IA plutôt que sur la gestion de l'infrastructure.
Un diagramme conceptuel illustrant l'écosystème du modèle de base AWS.
Lecatalogue Bedrockunifie les modèles pour le texte, l'image, la vidéo et les intégrations sous une seule interface. Nos principales offres comprennent :
Affinez vos modèles à partir de vos données étiquetées ou poursuivez le pré-entraînement sur des corpus spécifiques à votre domaine via la console Bedrock ou le SDK. Une fois la formation terminée, la suite d'évaluation de Bedrock effectue des comparaisons parallèles et génère des rapports sur la précision, la latence et le coût par jeton, ce qui vous permet de choisir objectivement la variante optimale pour les accords de niveau de service (SLA) de production.
Au-delà des familles Titan et Nova d'AWS, Bedrock vous donne accès à des modèles partenaires d'Anthropic, Cohere, Mistral, AI21 Labs et bien d'autres encore. Tirez parti de cette diversité pour :
Pour en savoir plus sur la manière dont Bedrock orchestre ces modèles de base dans les environnements de production, veuillez consulter ce guide complet sur Amazon Bedrock.
Infrastructure informatique optimisée par l'IA
Les familles d'instances EC2 fournies par AWS ont été conçues pour répondre aux besoins spécifiques des opérations de formation et d'inférence.
Formation :
Conclusion :
Un schéma illustratif de l'infrastructure informatique optimisée par l'IA d'AWS.
AWS assure une intégration transparente entre ses composants matériels et logiciels conçus sur mesure grâce à Trainium pour la formation et Inferentia pour les puces d'inférence, qui fonctionnent directement avec les services AWS. Cette intégration verticale permet d'obtenir :
Le système AWS Nitro utilise des cartes matérielles dédiées pour exécuter les fonctions de virtualisation, offrant ainsi des vitesses bare metal rapides et une isolation sécurisée :
Découvrez l'écosystème plus vaste du calcul, du stockage et de l'analyse dans ce courssur la technologie et les services cloud AWS.
Fondements des données pour une IA générative robuste
La formation de modèles à grande vitesse et les pipelines RAG nécessitent l'accès à des données propres et correctement gérées :
Cadre d'intégration d'entreprise
Les capacités d'IA générative d'AWS s'intègrent directement à son écosystème plus large afin de fournir des solutions de bout en bout adaptées à la production. Cette section décrit le processus de combinaison de Bedrock avec ses services associés afin de développer des applications d'IA générative concrètes.
Cycle de vie ML unifié avec SageMaker JumpStart et Bedrock
Sélectionnez des modèles de base dans le hub de modèles SageMaker JumpStart et déployez-les immédiatement. Vous pouvez déployer de nombreux modèles open source et propriétaires à l'aide d'un seul bouton avant de les enregistrer directement dans Amazon Bedrock. Les modèles enregistrés dans Bedrock bénéficient des avantages suivants :
L'architecture intégrée permet aux développeurs de créer des prototypesdans SageMaker Studio, puis de les améliorer dans Bedrock avant de les déployer via des pipelines CI/CD sans modification du code.
Ce tutoriel SageMaker vous guide à travers le processus de réglage fin et de déploiement de modèles à l'aide de la plateforme ML phare d'AWS.
Orchestration des flux de travail avec Amazon Bedrock Agents
Grâce à Bedrock Agents, vous pouvez intégrer l'IA générative à vos applications opérationnelles en récupérant automatiquement les données et en les transformant avant d'exécuter des actions. Un agent ne nécessite qu'une configuration de base pour :
Les fonctionnalités de base des agents permettent aux développeurs de se concentrer sur la logique métier plutôt que sur le code d'intégration, accélérant ainsi la rentabilisation.
Création d'assistants conversationnels avec Amazon Q
Amazon Q est un service entièrement géré permettant de développer des assistants professionnels basés sur la technologie RAG.
Le service intègre la fonctionnalité multimodèle Bedrock avec :
Grâce à Q, les entreprises créent des chatbots destinés à leurs clients, ainsi que des tableaux de bord pour les cadres et des services d'assistance spécifiques à leur domaine, qu'elles déploient en quelques semaines au lieu de plusieurs mois.
La lentille IA générative bien conçue met en œuvre les meilleures pratiques à chaque étape du développement des charges de travail génératives.
Lentille IA générative bien conçue
La lentille IA générative d'AWS étend les cinq piliers du cadre Well-Architected aux charges de travail génératives. Le cadre comprend des systèmes automatisés de surveillance des modèles et des mécanismes de détection des dérives, ainsi que des déclencheurs de recyclage avec gestion des artefacts de version et suivi des métriques d'inférence.
Voici les piliers :
Pour ceux qui souhaitent obtenir une certification, le cursus AWS Cloud Practitionercorrespond parfaitement aux connaissances fondamentales abordées ici.
Accélérer l'adoption avec les partenaires AWS
Le réseau de partenaires AWS offre un soutien aux entreprises en accélérant leur adoption des services AWS grâce à des accélérateurs de solutions et des services partenaires. Chaque entreprise est unique, c'est pourquoi AWS a mis en place le réseau de partenaires avec des accélérateurs d'IA générative spécifiques pour différents secteurs et cas d'utilisation.
Présentation des services d'intelligence artificielle AWS pris en charge
La capacité de l'IA générative à générer de nouveaux contenus ne correspond pas aux exigences des applications du monde réel, qui doivent traiter et comprendre les données sous divers formats de présentation.
AWS fournit un ensemble de services complémentaires qui s'intègrent à vos pipelines génératifs afin de convertir des documents non structurés en données structurées, d'extraire des informations à partir d'images et de permettre des conversations naturelles et la diffusion de résultats dans n'importe quelle langue ou voix.
Voici les plus populaires :
Un diagramme illustratif des différents services AWS et de leurs interactions.
Vos modèles de base dans Bedrock ou SageMaker peuvent être associés à ces services pour créer des applications multimodales complexes.
Un assistant d'analyse de documents, par exemple, utilise Textract pour ingérer des fichiers PDF, puis Titan Text pour les résumer avant de traduire le résumé en plusieurs langues et de le restituer via Polly. L'écosystème modulable vous permet de combiner diverses capacités d'IA afin de répondre à toutes les exigences de votre entreprise.
Modèles de mise en œuvre et cas d'utilisation
L'IA générative offre les meilleurs résultats lorsque vous utilisez des modèles bien conçus pour répondre à des problèmes commerciaux concrets.
Cette section présente quatre plans de mise en œuvre spécifiques, notamment la génération augmentée par la récupération et les assistants pour développeurs et entreprises, ainsi que d'autres scénarios à forte valeur ajoutée que vous pouvez mettre en œuvre dès aujourd'hui.
Architectures de génération augmentée par la récupération (RAG)
La combinaison des capacités de recherche et des modèles linguistiques volumineux dans la génération augmentée par la récupération produit des réponses précises qui restent ancrées dans le contexte. Le pipeline en quatre étapes fonctionne comme suit :
Un diagramme illustratif présentant une architecture de génération augmentée par la récupération (RAG).
Avantages et gains en termes de précision :
Applications commerciales :
Workflows de génération de code
AWS CodeWhisperer fournit une IA générative directement aux développeurs via leurs IDE et leurs pipelines CI/CD afin d'automatiser les tâches répétitives et d'accélérer les processus de codage.
Un diagramme illustratif présentant un processus de génération de code.
Les organisations qui utilisent CodeWhisperer comme assistant de développement éliminent les tâches répétitives, appliquent les normes de codage et permettent aux ingénieurs de consacrer leur temps à des activités de conception et de débogage à forte valeur ajoutée.
Veuillez noterque CodeWhisperer fera désormais partie d'Amazon Q Developer.
Assistants d'entreprise
Amazon Q Business est une solution low-code basée sur la technologie RAG qui permet aux utilisateurs de développer des assistants conversationnels capables de récupérer des données d'entreprise à partir de questions.
Architecture :
Scénarios de déploiement :
Les assistants aident les organisations à rationaliser le travail intellectuel, à réduire les coûts opérationnels et à permettre aux employés d'atteindre des niveaux de productivité plus élevés.
Autres cas d'utilisation à forte valeur ajoutée
La valeur de l'IA générative s'étend au-delà du RAG, de la génération de code et des assistants à divers autres domaines :
Commencez par ces modèles pour mettre en place des projets pilotes démontrant un retour sur investissement clair avant de passer à l'optimisation et à la mise à l'échelle dans l'ensemble de votre organisation.
Modèle de sécurité et de gouvernance
Les entreprises doivent mettre en œuvre des contrôles de sécurité et des pratiques de gouvernance à chaque étape du cycle de vie de l'IA lorsqu'elles adoptent l'IA générative.
AWS fournit un cadre complet de sécurité et de conformité qui s'étend des centres de données physiques aux politiques au niveau des applications, permettant ainsi d'innover en toute confiance.
Architecture de protection des données
AWS protège les charges de travail d'IA générative grâce à six couches de sécurité concentriques :
Un diagramme illustratif des couches de sécurité au sein du cadre d'IA générative AWS.
Isolation des données et conformité :
Cadre pour une IA responsable
Le développement de la confiance dans l'IA générative nécessite la mise en œuvre de protocoles éthiques et de sécurité à chaque étape de l'invocation du modèle. AWS met en œuvre une gouvernance responsable de l'IA à travers le cadre suivant :
Ces couches et pratiques établissent une posture de défense en profondeur pour l'IA générative d'entreprise, vous permettant d'innover tout en respectant les normes les plus strictes en matière de sécurité, de conformité et de responsabilité éthique.
Stratégies d'optimisation des coûts
Le processus de contrôle des budgets consacrés à l'IA générative exige à la fois une connaissance approfondie des mécanismes de tarification et des pratiques de gestion continue des coûts. Cette section explique la tarification AWS pour les charges de travail IA, tout en présentant un exemple de coût total de possession pour un déploiement de taille moyenne et des stratégies pour réduire les dépenses.
Analyse du modèle de tarification
La tarification de l'IA générative AWS s'articule autour de quatre dimensions principales :
Stratégies d'optimisation des coûts
Comparaison des architectures
Architecture
Calculer le facteur de coût
Facteur de coût des jetons
Meilleure correspondance
Chatbots en temps réel
De nombreux petits terminaux fonctionnant 24 heures sur 24, 7 jours sur 7
Taux de requêtes élevé, jetons de petite taille
Assistance clientèle, services d'assistance
Génération par lots
Instances de grande taille à courte durée de vie
Peu de pics importants de jetons
Génération de rapports, augmentation des données
Pipelines RAG
Recherche combinée + inférence
Jeton de récupération + jeton de génération
Assistants basés sur les connaissances
Modèle de coût total de possession
Vous trouverez ci-dessous un exemple de coût total de possession mensuel pour un projetpilote d'IA générative de taille moyenne:
Élément de coût
Coût unitaire
Utilisation
Coût mensuel
Critères d'évaluation de l'inférence (Inf1.xl)
0,228 $ / heure
3 critères d'évaluation × 24 heures × 30 jours
492,48 $
Utilisation des jetons (Titan Express)
0,0024 $ / 1 000 jetons
3 jetons M par jour × 30 jours
216,00 $
Stockage S3 (artefacts de modèle)
0,023 $ / Go par mois
10 000 GO
$230
Sortie des données
0,09 $ / GO
1 TO
$90
Coller ETL (préparation des fonctionnalités)
0,44 $ /DPU-heure
20 heures de travail par jour
8,80 $
Total
1 037,28 $
Principauxleviers d'optimisation:
Gestion continue des coûts :
La combinaison d'une architecture sensible aux prix, d'optimisations ciblées et d'une surveillance continue vous permet de faire évoluer l'IA générative sans coûts excessifs.