Cursus
AWS generatieve AI vertegenwoordigt de toekomst van clouddiensten, omdat het bedrijven in staat stelt geautomatiseerde content en kenniswerk te creëren met foundation-modellen die realtime tekst, afbeeldingen en video produceren.
In dit artikel geef ik een uitgebreid overzicht van de essentiële elementen van implementatiemethoden en governancekaders die nodig zijn om productieklare generatieve AI-oplossingen te ontwikkelen.
AWS is de toonaangevende cloudprovider omdat het Amazon Bedrock biedt naast gespecialiseerde compute-infrastructuur en brede integratiemogelijkheden die verder gaan dan andere cloudplatforms.
Als je nieuw bent met AWS, biedt deze introductiecursus een solide basis voordat je in de details van generatieve AI duikt.
De kerncomponenten begrijpen
In deze sectie verkennen we de bouwstenen die AWS generatieve AI aandrijven.
Ecosysteem van foundation-modellen
Bedrock fungeert als het beheerde control plane voor alle generatieve AI op AWS. Het biedt een consistente API voor het implementeren, opschalen en beveiligen van foundation-modellen, van endpointvoorziening tot facturatie, zodat jij je kunt richten op het maken van prompts en het integreren van AI in plaats van het beheren van infrastructuur.
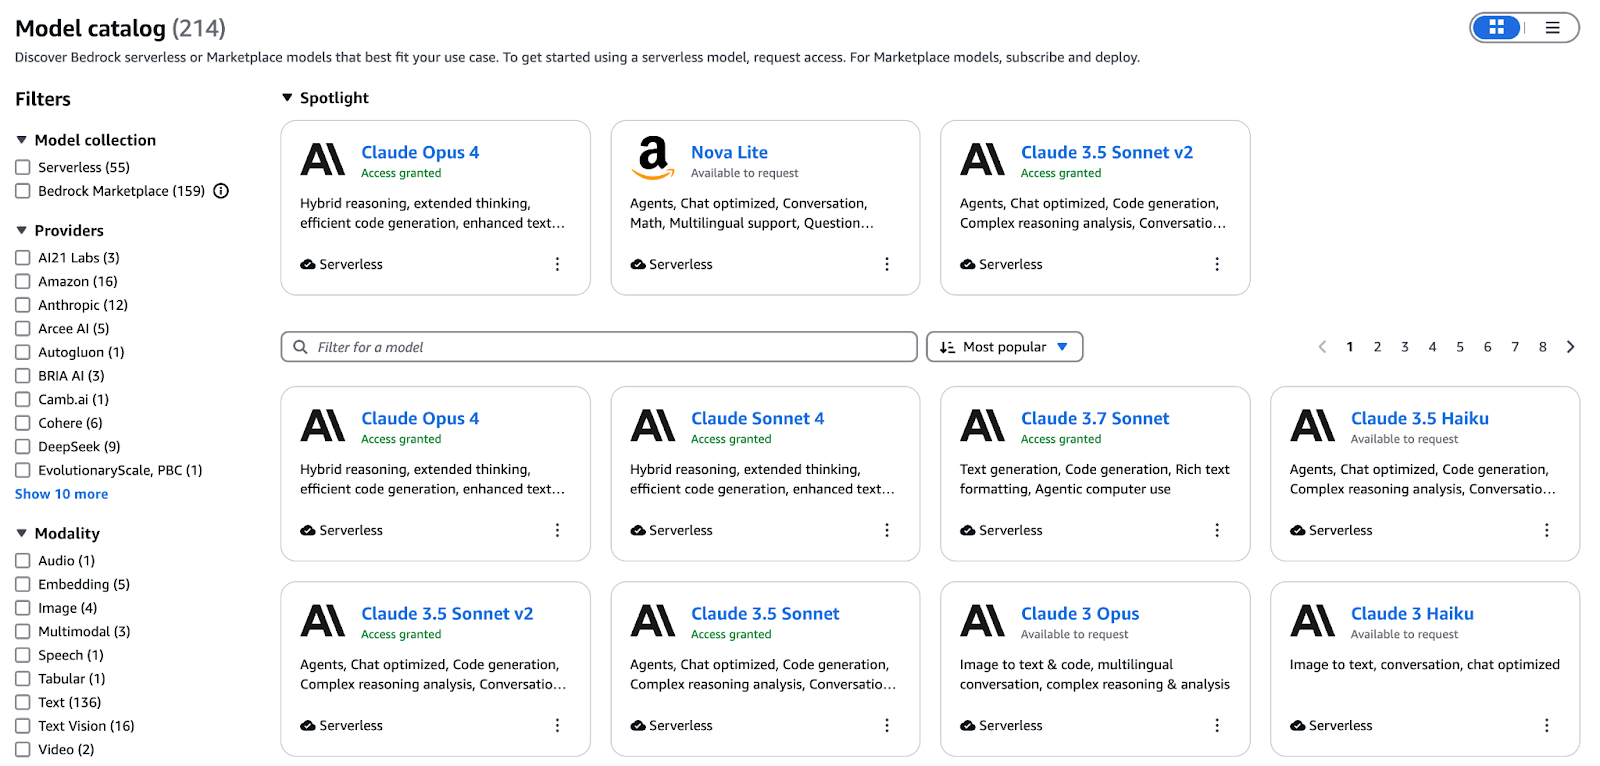
Een conceptueel diagram dat het AWS-ecosysteem van foundation-modellen illustreert
De Bedrock-catalogus verenigt modellen voor tekst, beeld, video en embeddings onder één interface. Belangrijke opties zijn onder andere:
- Titan Text (Premier, Express, Lite): Contextvensters tot 32K tokens voor complexe dialogen
- Nova Canvas: Hoogwaardige text-naar-beeldgeneratie en inpainting voor merkvriendelijke creatieve assets
- Nova Reel: Korte geanimeerde videoclips gegenereerd vanuit één enkele prompt
- Titan Multimodal Embeddings G1: Encodeert tekst en afbeeldingen in een gedeelde vectorruimte voor similariteitszoektocht en RAG
Fine-tune modellen op je gelabelde data of zet het voortrainen voort op domeinspecifieke corpora via de Bedrock-console of SDK. Zodra de training is voltooid, voert de evaluatiesuite van Bedrock vergelijkingen naast elkaar uit met rapportage over nauwkeurigheid, latency en kosten per token, zodat je objectief de optimale variant voor productie-SLA’s kunt kiezen.
Naast de Titan- en Nova-families van AWS krijg je via Bedrock toegang tot partnermodellen van Anthropic, Cohere, Mistral, AI21 Labs en meer. Benut deze breedte om:
- Kennisassistenten met RAG te bouwen die precieze antwoorden uit interne wiki’s naar boven halen
- Marketingcopy en beeldmateriaal op schaal te genereren met een consistente merkstem
- AI-gestuurde codeaanvulling en -review in ontwikkelworkflows te embedden
- Trainingsdatasets uit te breiden door tekst, afbeeldingen of video te synthetiseren die op jouw domein zijn afgestemd
Wil je dieper ingaan op hoe Bedrock deze foundation-modellen orkestreert in productieomgevingen? Bekijk dan deze complete gids voor Amazon Bedrock.
Voor AI geoptimaliseerde compute-infrastructuur
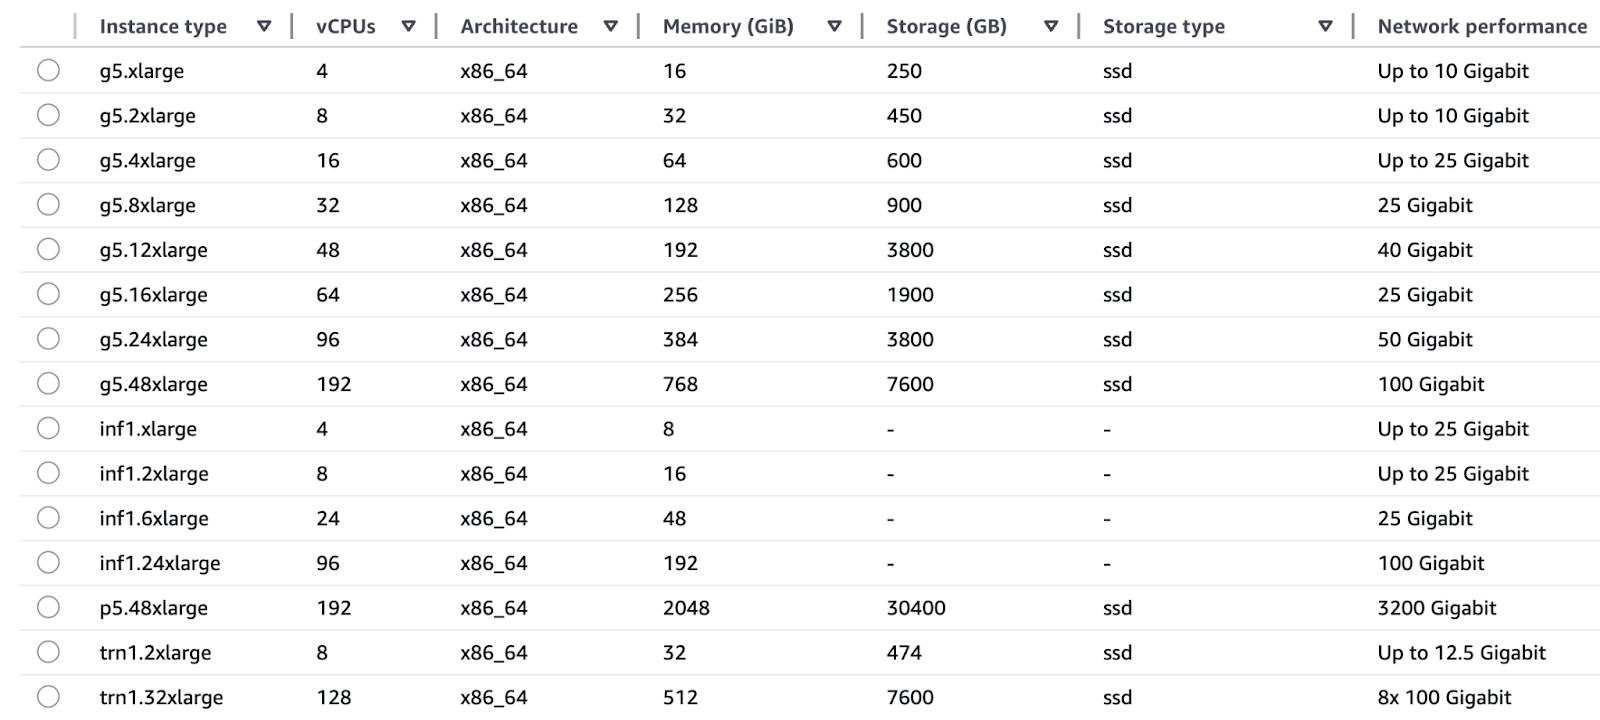
De EC2-instancefamilies van AWS zijn er om te voldoen aan de verschillende behoeften van trainings- en inferentie-activiteiten.
Training:
- Trn1 (Trainium)-instances werken met AWS Trainium-chips om deep learning-training te leveren, waaronder LLM’s en diffusiemodellen, met 3 keer hogere snelheden en lagere kosten per uur vergeleken met GPU-gebaseerde instances.
- P5 en P4 (NVIDIA H100- en A100-GPU’s) bieden uitgebreide parallelle verwerkingsmogelijkheden via mixed precision-ondersteuning, geschikt voor zowel onderzoeksmatige tests als grootschalige productiehertraining.
Inferentie:
- AWS Inferentia-chips in Inf1- en Inf2-systemen maken realtime-inferenties mogelijk met enkelcijferige milliseconde-latenties, terwijl de kosten per inferentie 2× lager liggen dan GPU-alternatieven.
- G5 en G4dn (NVIDIA A10G en T4 GPU’s) bieden een kosteneffectieve balans in prestaties, geschikt voor realtime GPU-versnelling in chatbots en aanbevelingsmachines.

Een illustratief diagram van de AI-geoptimaliseerde compute-infrastructuur van AWS.
AWS realiseert naadloze integratie tussen zijn custom ontworpen hardware- en softwarecomponenten via Trainium voor training en Inferentia voor inferentiechips, die rechtstreeks met AWS-services samenwerken. Deze verticale integratie levert op:
- Een superieure prijs-prestatieverhouding voor TensorFlow- en PyTorch-workloads, wat leidt tot een lagere total cost of ownership.
- De combinatie van energie-efficiëntie en vereenvoudigde inkoop helpt teams om vendor lock-in bij GPU’s te vermijden.
- SageMaker en Bedrock implementeren automatische right-sizing-functies waarmee gebruikers optimale siliconconfiguraties kunnen selecteren met simpele klikken, zonder chipdetails te hoeven beheren.
Het AWS Nitro System gebruikt speciale hardwarekaarten om virtualisatiefuncties uit te voeren, en levert zo bare-metal-snelheden met veilige isolatie:
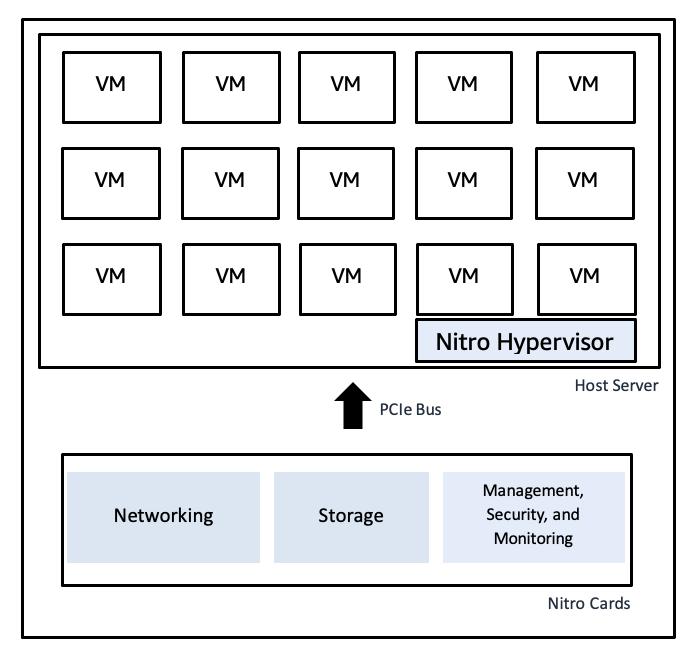
- De Nitro Hypervisor heeft een minimale codebase, wat kwetsbaarheden vermindert en workloads gescheiden houdt.
- Hardwareversnelde netwerk- en opslagpaden werken met hoge I/O-throughput en lage jitter, wat latency-pieken voorkomt en consistente topprestaties levert.
- De integratie van Nitro met CloudTrail, CloudWatch en AWS Config biedt end-to-end compliancemonitoring zonder prestatieverlies.
Een illustratief diagram van de Nitro Hypervisor van AWS
Verken het bredere ecosysteem van compute, opslag en analytics in deze cursus over AWS Cloud Technology and Services.
Datafundamenten voor robuuste generatieve AI
Modeltraining met hoge snelheid en RAG-pijplijnen hebben toegang nodig tot data die schoon en goed beheerd is:
- Het datastoragesysteem op petabyteschaal van Amazon S3 integreert met Lake Formation voor catalogisering en beveiliging van rauwe en gecureerde gegevensinname.
- De datawarehousingoplossing Amazon Redshift fungeert als platform voor gestructureerde tabellen die snelle analytics en dataterugwinning bieden.
- Datatransformatiepijplijnen gebouwd met AWS Glue en Athena maken zowel feature- als contextvoorbereiding mogelijk voor generatieve workloads en ad-hocquery’s.
- Datagovernance en herkomstmechanismen zorgen ervoor dat modeltraining betrouwbare input gebruikt, terwijl enterprise-kennis de output fundeert via toegangsbeheer en herkomsttracking.
Enterprise-integratieraamwerk
De generatieve AI-mogelijkheden van AWS integreren direct met het bredere ecosysteem om end-to-end oplossingen op productieniveau te leveren. Deze sectie beschrijft hoe je Bedrock combineert met aanverwante services om daadwerkelijke generatieve AI-toepassingen te ontwikkelen.
Uniforme ML-levenscyclus met SageMaker JumpStart en Bedrock
Selecteer foundation-modellen uit de modelhub van SageMaker JumpStart en implementeer ze direct. Je kunt talloze open-source en proprietaire modellen via één knop uitrollen en ze vervolgens rechtstreeks registreren in Amazon Bedrock. De modellen die in Bedrock staan, krijgen toegang tot:
- Contentmoderatie en beleidsafdwinging via guardrail-functies.
- Knowledge bases die Retrieval-Augmented Generation (RAG) bieden voor private databronnen.
- De Converse API die consistentie bewaakt door een abstractielaag te bieden die modelspecifieke variaties elimineert.
De geïntegreerde architectuur stelt ontwikkelaars in staat prototypes te maken in SageMaker Studio en ze daarna te verfijnen in Bedrock, om ze vervolgens via CI/CD-pijplijnen te implementeren zonder codewijzigingen.
Deze SageMaker-tutorial doorloopt het proces van fine-tuning en implementatie met het toonaangevende ML-platform van AWS.
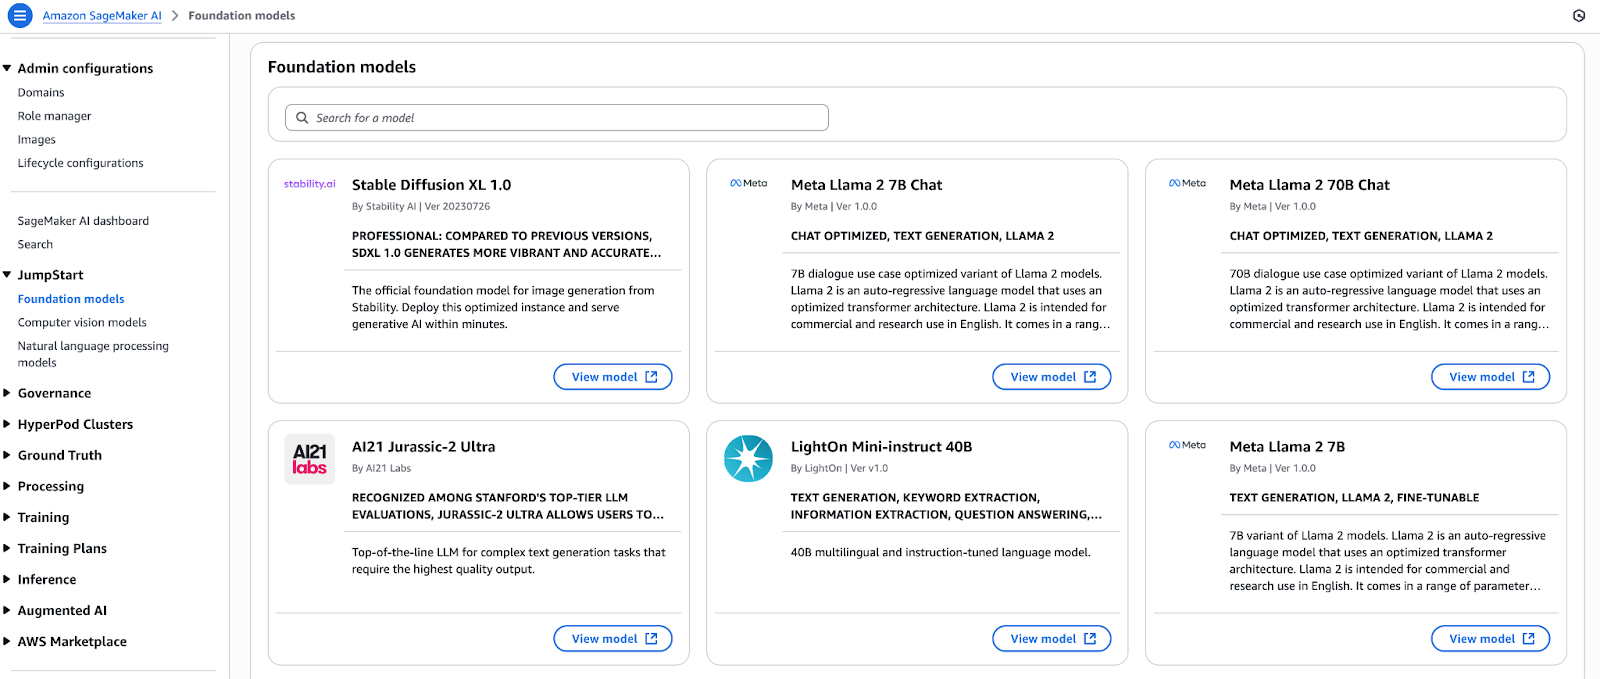
Een illustratief diagram van de uniforme ML-levenscyclus met SageMaker JumpStart en Bedrock.
Workflows orkestreren met Amazon Bedrock Agents
Met Bedrock Agents kun je generatieve AI integreren in operationele applicaties door automatisch data op te halen en te transformeren voordat acties worden uitgevoerd. Een Agent vereist slechts basisconfiguratie om:
- Beveiligde verbindingen op te zetten met RESTful API’s, databases en message queues.
- Documenten, metrics en logdata in te nemen en voorbewerking uit te voeren voordat de data beschikbaar wordt gesteld aan modellen.
- Verschillende achtergrondbewerkingen uit te voeren, waaronder verrijking, validatie en notificatie via sequentiële functieaanroepen.
- Gestructureerde of conversatiële outputs te genereren voor downstreamsystemen.
De ‘plumbing’-functies van Agents stellen ontwikkelaars in staat zich te concentreren op businesslogica in plaats van integratiecode, wat de time-to-value versnelt.
Conversatie-assistenten bouwen met Amazon Q
Amazon Q is een volledig beheerde service om RAG-gestuurde businessassistenten te ontwikkelen.
De service integreert de multimodelfunctionaliteit van Bedrock met:
- Voorgeconfigureerde connectors voor datawarehouse (Redshift), zoekmachine (OpenSearch) en BI-tools.
- Geïntegreerde functies voor het beheren van meerstapsdialogen, sessiecontext en ‘citation-style’ antwoordgeneratie.
- Een low-code tool voor UI-ontwikkeling om snel prototypes te maken.
Met Q bouwen organisaties klantgerichte chatbots, executive dashboards en domeinspecifieke helpdesks die ze binnen weken in plaats van maanden uitrollen.
De Well-Architected Generative AI Lens implementeert best practices in elke stap van de ontwikkeling van generatieve workloads.
Well-Architected Generative AI Lens
De Generative AI Lens van AWS breidt de vijf pijlers van het Well-Architected Framework uit naar generatieve workloads. Het framework omvat geautomatiseerde modelmonitoringsystemen en driftdetectiemechanismen, naast triggers voor hertraining met versie-artifactbeheer en tracking van inferentiemetingen.
Dit zijn de pijlers:
- Beveiliging: Handhaaf least-privilege IAM, gebruik PrivateLink voor Bedrock-endpoints, versleutel data in transit en at rest, en pas contentfiltering-guardrails toe.
- Betrouwbaarheid: De oplossing gebruikt AZ-gebaseerde endpointimplementatie, autoscaling, circuit breakers en Canary deployments voor risicoloze uitrol.
- Performance-efficiëntie: Kies optimale instancefamilies, cache frequente prompts en batch verzoeken, en benut serverloze endpoints om naar nul te schalen.
- Kostenoptimalisatie: Modelkeuze moet aansluiten op latentie-eisen; gebruik spot- of gereserveerde capaciteit; beperk tokengebruik met prompt engineering; voer kostenanalyse uit in Cost Explorer.
- Duurzaamheid: Kies de juiste compute-omvang, gebruik energiezuinige chips (Trainium, Inferentia), archiveer koude data in S3 Glacier en adopteer serverloze pijplijnen om idle resources te verminderen.
Voor wie certificering nastreeft: de AWS Cloud Practitioner-track sluit goed aan bij de basiskennis die hier wordt behandeld.
Adoptie versnellen met AWS Partners
Het AWS Partner Network ondersteunt bedrijven door hun adoptie van AWS-diensten te versnellen met solution accelerators en partnerservices. Elke enterprise is anders, daarom heeft AWS het Partner Network opgezet met specifieke generatieve AI-accelerators voor verschillende sectoren en use-cases.
- Het AWS Partner Network omvat Technology Partners die kant-en-klare applicaties, connectors en domeinspecifieke foundation-modellen leveren, beschikbaar via AWS Marketplace.
- Het Generative AI Accelerator-programma ondersteunt startups met credits, mentorship en blauwdrukken voor best practices om proof-of-value te versnellen.
- Door frameworks van APN-partners te gebruiken, samen met door AWS gevalideerde oplossingspatronen, kunnen teams het risico tijdens pilots verlagen en generatieve AI met vertrouwen organisatiebreed uitrollen.
Overzicht van ondersteunende AWS AI-services
Het vermogen van generatieve AI om nieuwe content te genereren sluit niet altijd aan op de eisen van realistische toepassingen, die data in verschillende presentatieformaten moeten verwerken en begrijpen.
AWS biedt een verzameling ondersteunende services die integreren met je generatieve pijplijnen om ongestructureerde documenten om te zetten in gestructureerde data, beeldinzichten te extraheren en natuurlijke conversaties en output in elke taal of stem mogelijk te maken.
Dit zijn de populairste:
- Amazon Textract
- Detecteert automatisch gedrukte tekst, tabellen en formuliergegevens in gescande documenten en afbeeldingsbestanden.
- Benut RAG-pijplijnen om domeinspecifieke documenten te verwerken, waaronder contracten, rapporten en facturen.
- Structureert ongestructureerde content om voor te bereiden op prompttemplates en fine-tuningdatasets.
- Amazon Rekognition
- Gebruikt beeld- en videoanalyse om objecten, scènes, tekst, gezichten en activiteiten te identificeren.
- Genereert contextuele metadata (labels, betrouwbaarheidscores) voor multimodale generatie.
- Stelt gebruikers in staat conditionele logica te implementeren (bijv. “beschrijf alleen afbeeldingen met mensen”) in hun eindgebruikersapplicaties.
- Amazon Polly
- Zet geschreven tekst om in menselijk klinkende spraak in meerdere stemmen en talen.
- De audio-outputfunctie verandert generatieve chatbots en assistenten in interactieve interfaces.
- Ondersteunt SSML-markup om spraakuitvoer nauwkeurig te sturen met uitspraak, nadruk en pauzes.
- Wil je leren hoe Polly mensachtige stemuitvoer mogelijk maakt in echte applicaties? Bekijk dan deze praktische tutorial.
- Amazon Lex
- Ontwikkelt conversatie-interfaces via automatische spraakherkenning (ASR) en natural language understanding (NLU).
- Fungeert als front-endinterface voor back-endgeneratoren en beheert sessies en slot-filling.
- Verbindt rechtstreeks met AWS Lambda om Bedrock- of SageMaker-endpoints aan te roepen voor dynamische antwoorden.
- Amazon Translate
- Biedt directe neurale machinevertaling voor meer dan 70 talen.
- Past generatieve outputs aan om ze toegankelijk te maken voor wereldwijde doelgroepen.
- Standaardiseert meertalige input, zodat één model gebruikers uit verschillende regio’s kan bedienen.
Een illustratief diagram van de verschillende AWS-services en hun interacties
Je foundation-modellen in Bedrock of SageMaker kun je combineren met deze services om complexe multimodale applicaties te bouwen.
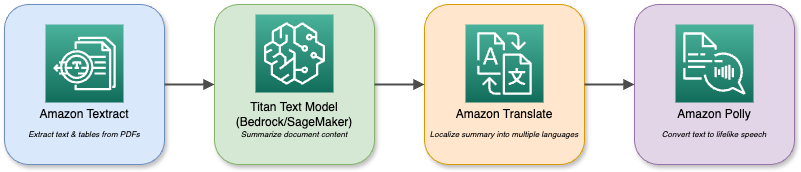
Een documentanalyse-assistent gebruikt bijvoorbeeld Textract om PDF’s in te lezen, daarna Titan Text om ze samen te vatten, om vervolgens de samenvatting in meerdere talen te vertalen en via Polly voor te lezen. Het samenstelbare ecosysteem stelt je in staat verschillende AI-mogelijkheden te combineren om aan elke enterprisebehoefte te voldoen.
Implementatiepatronen en use-cases
Generatieve AI levert de beste resultaten wanneer je goed ontworpen patronen gebruikt om echte bedrijfsproblemen aan te pakken.
Deze sectie presenteert vier specifieke implementatieblauwdrukken, waaronder retrieval-augmented generation en ontwikkelaars- en enterprise-assistenten, plus aanvullende waardevolle scenario’s die je vandaag kunt implementeren.
RAG-architecturen (retrieval-augmented generation)
De combinatie van zoekmogelijkheden met large language models in retrieval-augmented generation levert accurate antwoorden die stevig in context verankerd blijven. De pijplijn met vier fasen werkt als volgt:
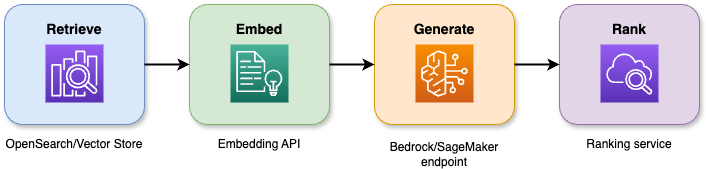
- De top N relevante documenten of passages worden opgehaald uit een vectorstore of zoekindex via querying.
- Zowel documenten als gebruikersvragen worden omgezet in semantische embeddings, wat betere contextafstemming mogelijk maakt.
- De vraag en de opgehaalde context worden aan een foundation-model gevoerd om een antwoord te genereren.
- Een tweede model of heuristiek scoort en her-rankt kandidaatoutputs en presenteert het meest geschikte antwoord.
Een illustratief diagram van een retrieval-augmented generation (RAG)-architectuur.
Voordelen en nauwkeurigheidswinsten:
- Vermindert hallucinaties met 40 procent vergeleken met basale generatie.
- Pilots met enterprise-kennisbanken tonen een verbetering van 20–30 procent in antwoordrelevantie.
- De gemiddelde gebruikersinteractietijd daalt met 25 procent bij virtuele supportsystemen.
Zakelijke toepassingen:
- Interne wiki-inhoud vormt de basis voor chatbots en virtuele assistenten om tickets samen te vatten en tips voor troubleshooting te geven.
- RAG-systemen geïntegreerd met zoekinterfaces laten gebruikers grote documentcollecties verkennen via natuurlijke taal.
- Maakt het mogelijk dat compliance-, juridische en regulatoire assistenten broncitaten geven wanneer gebruikers daarom vragen.
Workflows voor codegeneratie
AWS CodeWhisperer levert generatieve AI rechtstreeks aan ontwikkelaars in hun IDE’s en CI/CD-pijplijnen om boilerplate te automatiseren en het coderen te versnellen:
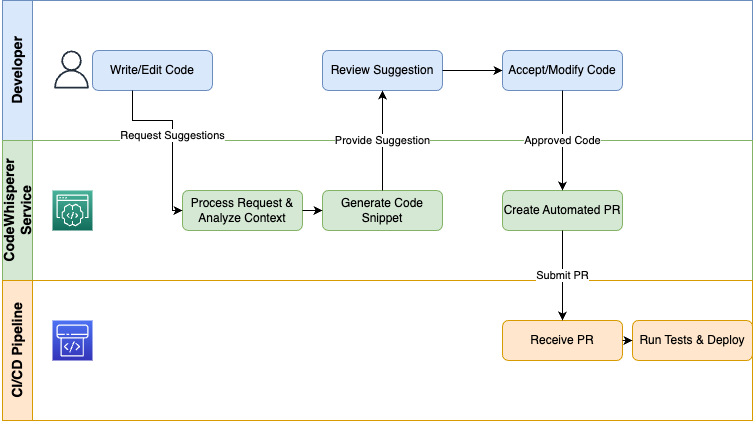
- Biedt drie hoofdfuncties: realtime codevoorstellen, snippet-completions en testgeneratie die zich aanpast aan je huidige context.
- Teams leveren 30 procent sneller features op, terwijl syntaxfouten in vroege prototypes met 50 procent afnemen.
- De CodeCatalyst-pijplijn kan automatisch IaC-snippets voor infrastructuur, unittests en deployscripts genereren via integratie met CodeWhisperer.
- Ondersteunt meerdere programmeertalen, waaronder Python, Java, JavaScript/TypeScript, C#, Go en meer, wat voordeel oplevert voor je volledige technologiestack.

Een illustratief diagram van een workflow voor codegeneratie.
Organisaties die CodeWhisperer als ontwikkelaarsassistent gebruiken, elimineren repetitief werk, handhaven codestandaarden en geven engineers de ruimte om zich te richten op waardevol ontwerp en debuggen.
Hou er rekening mee dat CodeWhisperer onderdeel wordt van Amazon Q Developer.
Enterprise-assistenten
Amazon Q Business fungeert als een RAG-gestuurde low-codeoplossing, waarmee je conversatie-assistenten bouwt die enterprise-data ophalen via vragen.
Architectuur:
- Haalt data op uit Redshift, OpenSearch, SharePoint en S3 via connectors.
- De RAG-engine haalt de juiste context op voordat foundation-modellen worden aangeroepen.
- De dialoogmanager beheert meerstapsessies, inclusief slot filling en statusbewaking.
- De UI-laag bedient chatwidgets, voicekanalen en Slack-integraties.
Implementscenario’s:
- Automatische transcriptie en samenvatting van actiepunten via vergaderassistenten besparen teams meer dan twee uur werk per week.
- Zelfservicebots vangen routinematige vragen af, wat leidt tot 30 procent kortere afhandeltijd.
- Executive dashboards bieden inzichten in natuurlijke taal over sales, voorraad en KPI’s voor gebruikers zonder BI-training.
De assistenten helpen organisaties kenniswerk te stroomlijnen, operationele kosten te verlagen en medewerkers productiever te maken.
Aanvullende waardevolle use-cases
De waarde van generatieve AI reikt verder dan RAG, codegeneratie en assistenten naar andere domeinen:
- Deze systemen kunnen gepersonaliseerde productbeschrijvingen, e-mailcampagnes en chatinteracties genereren op basis van profielen en gedragsanalyse.
- De combinatie van Textract met formulierparsing-modellen en generatie maakt automatische classificatie, markup en routering van facturen, contracten en claims mogelijk, plus downstreamtaken (ticketcreatie, goedkeuringsroutering en rapportage) via modelgestuurde beslislogica.
- Analyse van supporttranscripten, socialemediameldingen en salescalls via conversatie-analytics onthult sentimenttrends, compliancerisico’s en uitvoerbare aanbevelingen.
Begin met deze patronen om pilots op te zetten die duidelijke ROI aantonen, en ga daarna over op optimalisatie en opschaling binnen je organisatie.
Beveiligings- en governancemodel
Bedrijven moeten beveiligingscontroles en governancepraktijken in elke fase van de AI-levenscyclus implementeren wanneer ze generatieve AI adopteren.
AWS biedt een uitgebreid beveiligings- en compliancekader dat zich uitstrekt van fysieke datacenters tot beleidsregels op applicatieniveau, zodat je met vertrouwen kunt innoveren.
Architectuur voor databescherming
AWS beschermt generatieve AI-workloads met zes concentrische beveiligingslagen:
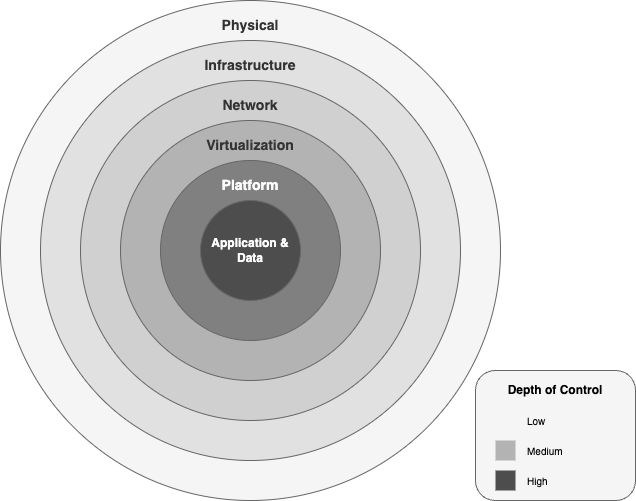
- De fysieke laag van datacenters heeft multi-factor-toegangscontrole, biometrische screening en 24/7 monitoring, zodat hardwaretoegang beperkt blijft tot geautoriseerd personeel.
- Het wereldwijde AWS-netwerk beschermt AI-verkeer via private glasvezelverbindingen en DDoS-mitigatie, plus AWS Shield Advanced, en waarborgt hoge netwerkdoorvoer door verkeer te isoleren van het publieke internet.
- Modelendpoints en datapijplijnen blijven veilig via de combinatie van VPC’s met fijnmazige security groups, netwerk-ACL’s en PrivateLink-endpoints, die binnen je private netwerken opereren.
- Het Nitro System verplaatst virtualisatie-operaties naar gespecialiseerde hardwarecomponenten, die bare-metal-snelheid en hardwarematige bescherming bieden tegen ongeautoriseerde gegevensdeling tussen virtuele machines.
- De platformlaag van Bedrock- en SageMaker-endpoints integreert met AWS KMS voor klantbeheerde sleutels, gebruikt TLS 1.2+ encryptie voor datatransport en handhaaft IAM-rechten volgens het least-privilegeprincipe.
- De applicatie- en datalaag implementeren fijnmazige resource policies met AES-256-encryptie in rust en tijdens transport en integreren auditlogging via CloudTrail en CloudWatch om elke API-call te beschermen en te registreren.

Een illustratief diagram van de beveiligingslagen binnen het AWS generatieve AI-kader.
Data-isolatie en compliance:
- Elke Bedrock-inferentieinstance draait binnen je VPC en heeft toegang tot S3-buckets die jij beheert.
- Je kiest klantbeheerde CMK’s via AWS KMS en kunt externe keystores (XKS/HYOK) gebruiken om aan soevereiniteitsvereisten te voldoen.
- AWS bezit meerdere certificeringen, waaronder ISO 27001 en SOC 1/2/3, FedRAMP High, HIPAA, PCI DSS en GDPR, die automatisch gelden voor jouw generatieve AI-workloads zonder dubbel werk.
Kader voor verantwoorde AI
Vertrouwen in generatieve AI vergt ethische en veiligheidsprotocollen bij elke stap van modelaanroepen. AWS implementeert governance voor verantwoorde AI via het volgende kader:
- De ethische principes van AWS prioriteren eerlijkheid, privacy, transparantie en verantwoording om discriminerende bias in modellen te voorkomen en duidelijke documentatie te waarborgen van datalijn en beslislogica.
- Het Bedrock Guardrails-systeem biedt beleidsgestuurde filters die input en output toetsen aan categorieën zoals haatdragende taal en geweld, zelfbeschadiging en desinformatie. De Invoke API en ApplyGuardrail API stellen je in staat guardrails in te zetten voor veiligheidscontroles, zelfstandig of via de Invoke API.
- Alle verzoeken en guardrail-beslissingen worden gelogd via CloudTrail, terwijl modelkaarten en evaluatierapporten prestatiestatistieken, potentiële biases en afwegingen tussen kosten/latentie tonen.
- Continue controle via SageMaker Clarify’s biasdetectie en human-in-the-loop reviews voor outputs met lage zekerheid, plus automatische driftalerts voor hertraining of intrekking.
Deze lagen en praktijken creëren een gelaagde verdedigingshouding voor enterprise generatieve AI, waarmee je kunt innoveren volgens de hoogste normen voor security, compliance en ethische verantwoordelijkheid.
Strategieën voor kostenoptimalisatie
Het beheersen van budgetten voor generatieve AI vereist zowel volledig begrip van prijsmechanismen als continue kostenbeheersing. Deze sectie legt AWS-prijzen voor AI-workloads uit, presenteert een TCO-voorbeeld voor een middelgrote implementatie en strategieën om uitgaven te verlagen.
Analyse van het prijsmodel
De prijsstelling van AWS generatieve AI valt uiteen in vier hoofddimensies:
- Compute-kosten
- Endpointuren: gefactureerd per instance-uur, wisselend per familie
- Inf1.xlarge à $0,228/uur
- G5.xlarge à $1,006/uur
- Trainingstaken: per instance-uur op Trn1-, P4- of P5-hardware (bijv. Trn1.32xlarge à $21,50/uur)
- Token-/verzoekkosten
- Prompttokens: $0,0008 per 1K tokens
- Completiontokens: $0,0016 per 1K tokens
- Opslag & datatransfer
- Modelartefacten: S3 Standard à $0,023/GB-maand
- Data-egress: $0,09/GB buiten de free tier
- Aanpassing & evaluatie
- Fine-tuning: extra training per instance-uur plus minimale verwerkingskosten voor data.
- Evaluatieruns: toekenkosten voor vergelijkingen tussen baseline en maatwerk.
Kostenoptimalisatiestrategieën
- Kies de juiste silicon: Gebruik Inferentia (Inf1/Inf2) voor hoogvolume, lage-latentie-inferentie en Trainium (Trn1) voor grootschalige training om $/TPU-uur te verlagen.
- Batchen en cachen van prompts: Groepeer vergelijkbare verzoeken en cache populaire antwoorden om repetitieve tokenkosten te verminderen.
- Multi-model endpoints: Host meerdere kleinere modellen achter één endpoint—ruil pieklatentie in voor aanzienlijk lagere idle-urenkosten.
- Spot & gereserveerde capaciteit: Committeer een fractie van de basiscapaciteit met Reserved Instances of gebruik Spot voor niet-kritische batchworkloads.
- Prompt engineering: Stroomlijn instructies om het aantal tokens per verzoek te minimaliseren zonder kwaliteitsverlies.
Architecturen vergelijken
|
Architectuur |
Compute-kostendrijver |
Tokendrijver voor kosten |
Beste toepassing |
|
Realtime chatbots |
Veel kleine endpoints die 24×7 draaien |
Hoge verzoekfrequentie, weinig tokens |
Klantondersteuning, helpdesks |
|
Batchgeneratie |
Kortdurende grote instances |
Weinige grote tokenpieken |
Rapportgeneratie, data-augmentatie |
|
RAG-pijplijnen |
Gecombineerde zoek- + inferentiekosten |
Retrievaltokens + generatietokens |
Kennis-gefundeerde assistenten |
Model voor totale eigendomskosten
Hieronder staat een voorbeeld van maandelijkse TCO voor een middelgrote generatieve AI-pilot:
|
Kostenelement |
Eenheidsprijs |
Gebruik |
Maandkosten |
|
Inferentie-endpoints (Inf1.xl) |
$0,228 /uur |
3 endpoints × 24 uur × 30 dagen |
$492,48 |
|
Tokengebruik (Titan Express) |
$0,0024 /1K tokens |
3M tokens/dag × 30 dagen |
$216,00 |
|
S3-opslag (modelartefacten) |
$0,023 /GB-maand |
10.000 GB |
$230 |
|
Data-egress |
$0,09 /GB |
1 TB |
$90 |
|
Glue ETL (featurevoorb.) |
$0,44 /DPU-uur |
20 DPU-uren |
$8,80 |
|
Totaal |
$1.037,28 |
Belangrijke optimalisatiehefbomen:
- Auto-scale naar nul: Schakel idle endpoints uit wanneer het verkeer inzakt.
- Multi-model endpoints: Consolideer modellen om idle-uurkosten tot 60% te verlagen.
- Reserved & Spot: Leg kortingstarieven vast voor basiscapaciteit en gebruik Spot voor jobs die niet gevoelig zijn voor latentie.
- Promptcompressie: Herstructureer prompts om overbodige tokens te schrappen en 10–15% op tokenspende te besparen.
Doorlopend kostenbeheer:
- Gebruik de AWS Pricing Calculator om scenario’s te modelleren vóór lancering.
- Monitor werkelijk gebruik in AWS Cost Explorer en stel budgetten en afwijkingsalerts in.
- Tag alle AI-resources voor duidelijke chargeback- en showbackrapportage.
De combinatie van prijsbewuste architectuur met gerichte optimalisaties en continue monitoring stelt je in staat generatieve AI op te schalen zonder buitensporige kosten.
Implementatieroadmap
Het opschalen van generatieve AI van concept naar productie vereist een systematische, gefaseerde aanpak. De roadmap biedt een stapsgewijze aanpak, van initiële beoordelingen via proof-of-concept-pilots tot het bouwen van een veerkrachtig platform op enterprise-niveau.
Beoordelings- en pilotfasen
De eerste stap is het toetsen van haalbaarheid en het verkrijgen van instemming van stakeholders, voordat je de volledige architectuur uitwerkt.
- Gapanalyse en doelstelling
- Voer interviews met business owners om use-caserequirements, succescriteria en ROI-doelen op te halen.
- Beoordeel huidige databronnen, securitykwaliteitscontroles en ML-capaciteiten.
- Identificeer compliance- of privacygaps (bijv. PII-verwerking) die je pilot moet adresseren.
- Proof of Concept (PoC)-ontwikkeling
- Kies een waardevolle use-case (bijv. RAG-gestuurde supportbot of documentsamenvatter) voor fase één.
- Richt minimale infrastructuur in: één Bedrock- of SageMaker-endpoint gekoppeld aan een kleine dataset via S3 of OpenSearch.
- Definieer kernmetrics (nauwkeurigheid, latentie, kosten per verzoek) en instrumenteer CloudWatch-dashboards.
- Snel prototypen met stapsgewijze gidsen
- Gebruik voorbeeldprojecten uit de AWS Solutions Library (bijv. RAG Chatbot, CodeWhisperer-demo) om het prototype te bouwen.
- Itereer snel op prompts en retrievalstrategieën en leg bevindingen vast in een gedeelde wiki.
- Validatie door stakeholders
- Laat het functionele prototype zien aan eindgebruikers en verzamel feedback over outputkwaliteit en UX.
- Verfijn de scope, voeg databronnen toe of verwijder ze en pas modelparameters aan op basis van werkelijk gebruik.
- Verzeker executive sponsorship en budget voor de volgende fase.
Fundament- en opschalingsfasen
De Proof of Concept leidt tot de ontwikkeling van het fundamentele platform, voordat brede adoptie plaatsvindt.
- Platformfundament opbouwen
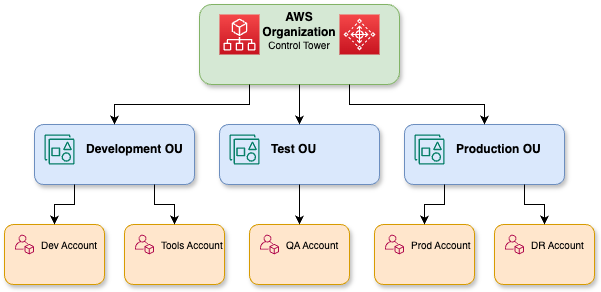
- Richt de multi-accountstructuur van AWS Control Tower in voor dev-, test- en prod-OU-grenzen in de landing zone.
- Implementeer IAM-rollen en -policies, AWS SSO en least-privilege-controles voor modeltoegang en datapijplijnen.
- Configureer VPC’s met PrivateLink-endpoints. Schakel KMS CMK’s in voor Bedrock/SageMaker en zet GuardDuty-monitoring aan.
- Automatiseer ETL met AWS Glue/Athena, catalogiseer assets in Lake Formation en synchroniseer kennismodellen voor RAG.

Een gedetailleerde weergave van de AWS-organisaties.
- MLOps en modelgovernance
- Automatiseer hertraining, evaluatie en implementatie van modellen via CI/CD-pijplijnen met CodeCatalyst of CodePipeline.
- Richt een model registry in binnen SageMaker of een Git-ondersteunde catalogus om versies en fijn-afgestelde artefacten te beheren.
- Detecteer automatisch drift en voer geplande hertraining uit om performance en compliance te borgen.
- Opschalen naar productie
- Stem af op variabel verkeer met autoscaling Bedrock- of SageMaker-endpoints.
- Gebruik multi-model endpoints om meerdere kleinere FM’s achter één API te hosten en idle-kosten tot 60% te verlagen.
- Implementeer over meerdere Availability Zones en voer canary rollouts uit voor updates zonder downtime.
- AWS Partner Network en Innovation Centers
- Schakel Consulting Partners in voor domeinspecifieke accelerators in finance, healthcare en retail.
- Gebruik de AWS Marketplace voor kant-en-klare connectors en voorgetrainde domeinmodellen van Technology Partners.
- Werk samen met AWS Innovation Centers en Community Builders voor toegang tot hackathons, architectuurreviews en hands-on workshops om adoptie van best practices te versnellen.
De gefaseerde aanpak—validatie, gevolgd door fundamentopbouw en daarna opschalen met governance en partnerondersteuning—helpt je om je generatieve AI-pilot te transformeren tot een robuuste, organisatiebrede capability.
Optimaliseren en besturen
Doorlopende verfijning en sterke governancepraktijken, toegepast nadat je generatieve AI-platform is opgeschaald, zorgen voor goede prestaties en behouden security en naleving.
Continue optimalisatie
- Geautomatiseerde monitoring en alerting
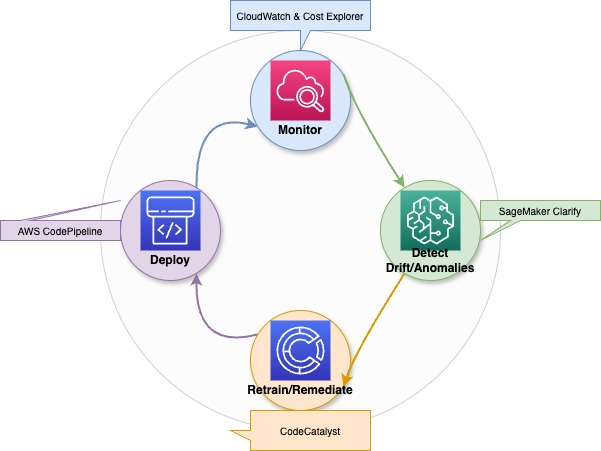
- Instrumenteer Bedrock/SageMaker-endpoints met CloudWatch-metrics (waaronder latentie, foutpercentages en throughput) en dashboards in Cost Explorer.
- Stel anomaliedetectiealarmen in, zoals plotselinge pieken in tokenspende of regressie in inferentielatentie, en trigger autoremediatie (opschalen/afschalen, modelrollback).

Een illustratief diagram van continue optimalisatie, driftdetectie en hertraining voor generatieve AI-modellen.
- Driftdetectie en hertraining
- Gebruik embedding-gebaseerde driftdetectoren of SageMaker Clarify om verschuivingen in datadistributie te signaleren.
- Driftdrempels starten geautomatiseerde hertrainingspijplijnen via CodePipeline/CodeCatalyst om zowel nauwkeurigheid als onbevooroordeelde prestaties te behouden.
- Kostenafstemming
- Evalueer regelmatig idle-uurkosten en consolideer modellen naar multi-model endpoints waar mogelijk.
- Fine-tune prompts om onnodig tokengebruik te verminderen en batch laagprioritaire verzoeken.
Governance- en compliance-audits
- Geplande audits
- Voer elk kwartaal beoordelingen uit van IAM-policies, KMS-sleutelgebruik, VPC-endpointconfiguraties en CloudTrail-logs om te bevestigen dat least-privilege en encryptiestandaarden worden nageleefd.
- AWS Audit Manager en AWS Config-regels maken geautomatiseerde bewijsverzameling mogelijk voor ISO-, HIPAA- of SOC-vereisten.
- Beleidsafdwinging
- Werk Bedrock Guardrails bij met contentbeleid en voer categoriefilterbeoordelingen uit bij elke release.
- Neem in je CI/CD-pijplijn een goedkeuringsstap op die de implementatie van modelversies blokkeert wanneer security- of fairnessevaluatie faalt.
Doorlopende training en vaardigheidsontwikkeling
- AWS Skill Builder
- Schrijf teams in voor het Generative AI-leerpad in AWS Skill Builder om Bedrock-basics, RAG-patronen en best practices voor veilige implementatie te leren.
- Hands-on labs leren hoe je Trn1/Inf1-instances opzet, Guardrails configureert en biasdetectie uitvoert met SageMaker Clarify.
- Certificering en community
- Engineers kunnen streven naar AWS Certified Machine Learning – Specialty en AWS Certified Security – Specialty.
- AWS Community Builders en Innovation Center-workshops helpen je up-to-date te blijven over nieuwe services, architectuurreviews en acceleratorprogramma’s.
Door voortdurende optimalisatie en strikte audits te combineren met organisatiebreed leren, kun je een veerkrachtige, betrouwbare en kostenefficiënte generatieve AI-capability in stand houden.
Resources en aan de slag
De reis met AWS generatieve AI kan worden versneld via leerroutes, communities en hands-on projecten die vertrouwen opbouwen en echte zakelijke impact opleveren.
AWS Skill Builder en trainingsresources
- Het Generative AI-leerpad op AWS Skill Builder biedt uitgebreide training over foundation-modellen, RAG-pijplijnen en best practices voor veilige implementatie.
- De interactieve platforms PartyRock en Bedrock Playground laten je prompt engineering, fine-tuning en inferentie testen zonder infrastructuur op te zetten.
- De begeleide labs tonen hoe je Trn1- en Inf1-instances maakt, KMS-versleutelde endpoints inricht en end-to-end RAG-workflows uitrolt.
Developercommunity en partner-ecosysteem
- De AWS Generative AI Community en Developer Center bieden toegang tot codevoorbeelden, forums en geselecteerde whitepapers over de Well-Architected Generative AI Lens.
- Het AWS Partner Network biedt kant-en-klare accelerators, domeinspecifieke foundation-modellen en turnkey connectors, allemaal beschikbaar in de AWS Marketplace.
- AWS Innovation Centers en Community Builders organiseren workshops, hackathons en architectuursessies die je helpen je implementatie te versnellen.
Stapsgewijze gidsen en voorbeeldprojecten
- Het DataCamp-platform biedt stap-voor-stap-tutorials en oplossingssjablonen waarmee je code kunt forken en aanpassen.
- End-to-end voorbeeldrepositories tonen hoe je Textract gebruikt voor data-inname, SageMaker voor RAG-orkestratie en Polly voor stemuitvoer.
- Je kunt volledig functionele projecten uitrollen via het platform en prompts, modellen en pijplijnen aanpassen voor enterprise-use-cases en prestatiemeting.
Conclusie
AWS generatieve AI biedt een compleet end-to-end systeem—met foundation-modellen, geoptimaliseerde compute, governance, integratie en kostenbeheersing—om enterprises te helpen sneller te innoveren en operationele overhead te verminderen, terwijl ze betrouwbare, multimodale applicaties op schaal bouwen.
Door te experimenteren, continu te leren en met de community samen te werken, benut je het volledige potentieel van AWS generatieve AI voor echte zakelijke impact.
Rahul Sharma is een AWS Ambassador, DevOps-architect en technisch blogger, gespecialiseerd in cloudcomputing, DevOps-praktijken en open-sourcetechnologieën. Met expertise in AWS, Kubernetes en Terraform maakt hij complexe concepten eenvoudiger voor zowel studenten als professionals via boeiende artikelen en tutorials. Rahul is gepassioneerd over het oplossen van DevOps-uitdagingen en het delen van inzichten om de techcommunity te versterken.