Die generative KI von AWS ist die Zukunft der Cloud-Services, weil sie Unternehmen ermöglicht, automatisierte Inhalte und Wissensarbeit über Basismodelle zu erstellen, die Texte, Bilder und Videos in Echtzeit produzieren.
In diesem Artikel gebe ich einen umfassenden Überblick über die wichtigsten Elemente von Bereitstellungsmethoden und Governance-Frameworks, die für die Entwicklung produktionsreifer generativer KI-Lösungen erforderlich sind.
AWS ist der führende Cloud-Anbieter, weil es Amazon Bedrock zusammen mit einer speziellen Recheninfrastruktur und umfassenden Integrationsmöglichkeiten anbietet, die andere Cloud-Plattformen übertreffen.
Wenn du noch nicht mit AWS vertraut bist,bekommst du indiesem Einführungskurseine solide Grundlage, bevor du dich mit den Besonderheiten der generativen KI beschäftigst.
Die wichtigsten Teile verstehen
In diesem Abschnitt schauen wir uns die Bausteine an, die die generative KI von AWS zum Laufen bringen.
Ökosystem des Basismodells
Bedrock ist die verwaltete Steuerungsebene für alle generativen KI-Lösungen auf AWS. Es bietet eine einheitliche API für die Bereitstellung, Skalierung und Sicherung von Basismodellen, von der Endpunktbereitstellung bis zur Abrechnung. So kannst du dich ganz auf die Erstellung von Eingabeaufforderungen und die Integration von KI konzentrieren, anstatt dich um die Verwaltung der Infrastruktur zu kümmern.
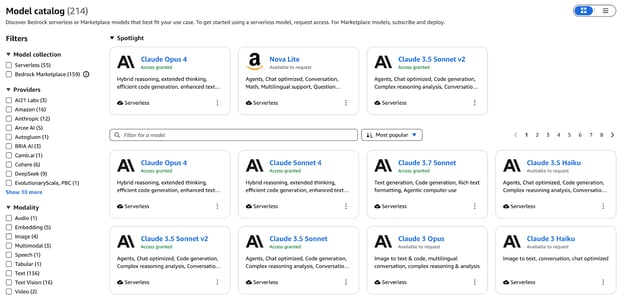
Ein Konzeptdiagramm, das das AWS-Foundation-Modell-Ökosystem zeigt
Der Bedrock -Katalog „“ bringt Modelle für Text, Bilder, Videos und Einbettungen unter einer einzigen Oberfläche zusammen. Zu den wichtigsten Angeboten gehören:
- Titan Text (Premier, Express, Lite): Bis zu 32K-Token-Kontextfenster für komplexe Dialoge
- Nova Canvas: Hochpräzise Text-zu-Bild-Generierung und Inpainting für markensichere kreative Assets
- Nova-Rolle: Kurze animierte Videoclips, die aus einer einzigen Eingabe erstellt werden
- Titan Multimodal Embeddings G1: Kodiert Text und Bilder in einen gemeinsamen Vektorraum für die Ähnlichkeitssuche und RAG.
Optimiere Modelle anhand deiner beschrifteten Daten oder mach weiter mit dem Vortraining auf domänenspezifischen Korpora über die Bedrock-Konsole oder das SDK. Nach dem Training macht die Bewertungssuite von Bedrock Vergleiche und zeigt dir die Genauigkeit, Latenz und Kosten pro Token, damit du die beste Variante für deine Produktions-SLAs objektiv auswählen kannst.
Neben den Titan- und Nova-Familien von AWS kannst du mit Bedrock auch Modelle von Partnern wie Anthropic, Cohere, Mistral, AI21 Labs und anderen nutzen. Nutzen Sie diese Bandbreite, um:
- Entwickle RAG-basierte Wissensassistenten, die präzise Antworten aus internen Wikis finden.
- Erstell Marketingtexte und Bilder in großem Stil mit einer einheitlichen Markenstimme.
- Integriere KI-gesteuerte Code-Vervollständigung und -Überprüfung in die Arbeitsabläufe der Entwickler.
- Erweitere Trainingsdatensätze, indem du Texte, Bilder oder Videos zusammenstellst, die genau zu deinem Fachgebiet passen.
Wenn du genauer wissen willst, wie Bedrock diese Basismodelle in Produktionsumgebungen zusammenbringt, schau dir diese komplette Anleitung zu Amazon Bedrockan .
KI-optimierte Recheninfrastruktur
Die EC2-Instanzfamilien von AWS sind genau auf die besonderen Anforderungen von Trainings- und Inferenzvorgängen zugeschnitten.
Schulung:
- Die Trn1 (Trainium)-Instanzen laufen mit AWS Trainium-Chips und bieten Deep-Learning-Trainingsfunktionen, einschließlich LLMs und Diffusionsmodellen, mit dreimal höherer Geschwindigkeit und geringeren Kosten pro Stunde im Vergleich zu GPU-basierten Instanzen.
- Die P5 und P4 (NVIDIA H100 und A100 GPUs) bieten echt coole parallele Verarbeitungsmöglichkeiten durch Unterstützung für gemischte Genauigkeit, was sowohl für Tests auf Forschungsniveau als auch für große Produktions-Retraining-Prozesse super ist.
Schlussfolgerung:
- Die AWS Inferential-Chips in den Inf1- und Inf2-Systemen machen Echtzeit-Inferenzen mit Latenzen im einstelligen Millisekundenbereich möglich und kosten dabei nur halb so viel pro Inferenz wie GPUs.
- G5 und G4dn (NVIDIA A10G und T4 GPUs) bieten ein gutes Preis-Leistungs-Verhältnis, das sich super für Echtzeit-GPU-Beschleunigung in Chatbot- und Empfehlungsmaschinen-Apps eignet.
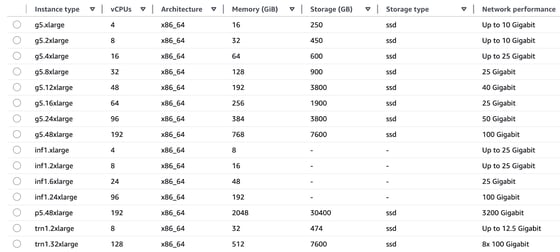
Ein Diagramm, das die KI-optimierte Recheninfrastruktur von AWS zeigt.
AWS schafft eine nahtlose Integration zwischen seiner maßgeschneiderten Hardware und Softwarekomponenten durch Trainium für Schulungen und Inferentia für Inferenzchips, die direkt mit AWS-Diensten zusammenarbeiten. Diese vertikale Integration bringt folgende Vorteile:
- Das super Preis-Leistungs-Verhältnis bei TensorFlow- und PyTorch-Workloads sorgt für niedrigere Gesamtkosten.
- Durch die Kombination aus Energieeffizienz und einfacher Beschaffung können Teams sich von der Bindung an einen bestimmten GPU-Anbieter lösen.
- SageMaker und Bedrock haben automatische Funktionen zur richtigen Dimensionierung, mit denen man mit ein paar Klicks die beste Siliziumkonfiguration auswählen kann, ohne sich um die Details auf Chip-Ebene kümmern zu müssen.
Das AWS Nitro System nutzt spezielle Hardwarekarten für die Virtualisierungsfunktionen und bietet so schnelle Bare-Metal-Geschwindigkeiten zusammen mit sicherer Isolierung:
- Der Nitro Hypervisor hat einen minimalen Code, was Schwachstellen reduziert und gleichzeitig die Arbeitslasten voneinander trennt.
- Die hardwarebeschleunigten Netzwerk- und Speicherpfade laufen mit hohem I/O-Durchsatz und wenig Jitter, was Latenzspitzen verhindert und so eine gleichbleibende Leistung bei Spitzenlasten sicherstellt.
- Die Integration von Nitro mit CloudTrail, CloudWatch und AWS Config sorgt für eine durchgängige Compliance-Überwachung, ohne dass die Leistung darunter leidet.
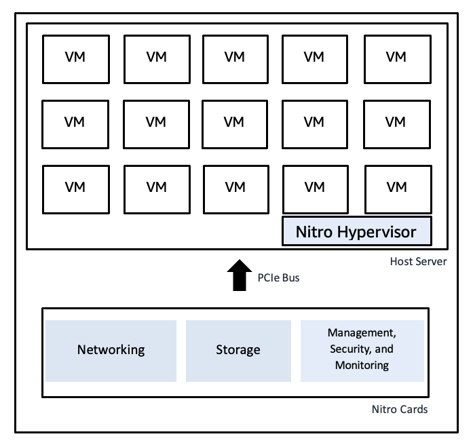 Ein Diagramm, das AWS' Nitro Hypervisor zeigt Nitro Hypervisor
Entdecke in diesem Kursüber AWS Cloud-Technologie und -Servicesdas umfassende Ökosystem aus Rechenleistung, Speicher und Analysen.
Datenfundamente für robuste generative KI
Modelltraining mit hoher Geschwindigkeit und RAG-Pipelines brauchen Daten, die sauber und gut verwaltet sind:
- Das Datenspeichersystem von Amazon S3, das Petabytes verwalten kann, ist mit Lake Formation verbunden, um rohe und kuratierte Datensätze zu erfassen, zu katalogisieren und zu sichern.
- Die Data-Warehousing-Lösung Amazon Redshift ist eine Plattform für strukturierte Tabellen, die schnelle Analysen und Datenabfragen ermöglicht.
- Die mit AWS Glue und Athena erstellten Datenumwandlungspipelines ermöglichen sowohl die Vorbereitung von Funktionen als auch von Kontexten für generative Workloads und die Ausführung von Ad-hoc-Abfragen.
- Daten-Governance und Herkunftsnachverfolgung sorgen dafür, dass beim Modelltraining vertrauenswürdige Daten verwendet werden, während Unternehmenswissen durch Zugriffskontrolle und Lernpfad-Nachverfolgung die Ergebnisse absichert.
Rahmenwerk für die Unternehmensintegration
Die generativen KI-Funktionen von AWS lassen sich direkt in das umfassende AWS-Ökosystem integrieren und bieten so durchgängige Lösungen für die Produktion. In diesem Abschnitt wird erklärt, wie man Bedrock mit den dazugehörigen Diensten kombiniert, um echte generative KI-Anwendungen zu entwickeln.
Einheitlicher ML-Lebenszyklus mit SageMaker JumpStart und Bedrock
Such dir einfach ein paar Basismodelle aus dem Modell-Hub von SageMaker JumpStart aus und leg los. Du kannst ganz einfach mehrere Open-Source- und proprietäre Modelle über einen einzigen Knopf bereitstellen, bevor du sie direkt in Amazon Bedrock registrierst. Die in Bedrock eingegebenen Modelle haben Zugriff auf:
- Inhaltsmoderation und Durchsetzung von Richtlinien über Schutzfunktionen.
- Die Wissensdatenbanken bieten Funktionen zur Retrieval-Augmented Generation (RAG) für private Datenquellen.
- Die Converse API sorgt für Konsistenz, indem sie eine Abstraktionsschicht bereitstellt, die modellspezifische Abweichungen beseitigt.
Dank der integrierten Architektur können Entwickler Prototypenin SageMaker Studio erstellen, sie dann in Bedrock verbessern und schließlich über CI/CD-Pipelines ohne Codeänderungen bereitstellen.
Dieses SageMaker-Tutorial zeigt dir Schritt für Schritt, wie du Modelle mit der ML-Plattform von AWS optimierst und bereitstellst.
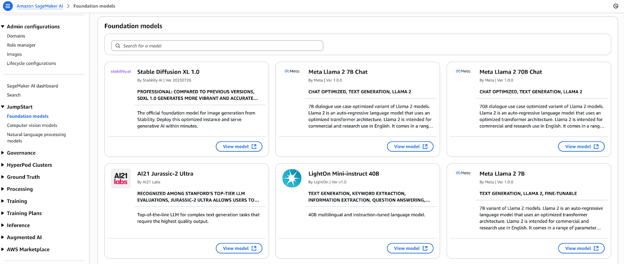 Ein Diagramm, das den einheitlichen ML-Lebenszyklus mit SageMaker JumpStart und Bedrock zeigt.
Workflows mit Amazon Bedrock Agents organisieren
Mit Bedrock Agents kannst du generative KI in deine operativen Anwendungen einbauen, indem du Daten automatisch abrufst und umwandelst, bevor du Aktionen ausführst. Ein Agent braucht nur ein paar einfache Einstellungen, um:
- Das System baut sichere Verbindungen zu RESTful-APIs sowie zu Datenbanken und Nachrichtenwarteschlangen auf.
- Das System nimmt Dokumente, Metriken und Protokolldaten auf, führt Vorverarbeitungsaufgaben durch und stellt die Daten dann den Modellen zur Verfügung.
- Das System macht im Hintergrund ein paar Sachen, wie zum Beispiel die Überprüfung der Anreicherung und Benachrichtigungen durch aufeinanderfolgende Funktionsaufrufe.
- Das System macht strukturierte oder dialogorientierte Ergebnisse für die Verwendung in anderen Systemen.
Dank der pipelinegestützten Funktionen der Agenten können sich Entwickler voll auf die Geschäftslogik konzentrieren, anstatt sich mit dem Integrationscode rumzuschlagen, was die Zeit bis zur Wertschöpfung verkürzt.
Entwickle mit Amazon Q Gesprächsassistenten
Amazon Q ist ein komplett verwalteter Service zum Entwickeln von RAG-basierten Business-Assistenten.
Der Service verbindet die Multimodalfunktionen von Bedrock mit:
- Datenlager (Redshift), Suchmaschine (OpenSearch) und BI-Tool-Konnektoren sind schon fertig eingerichtet.
- Das System hat integrierte Funktionen für die Verwaltung von Dialogen mit mehreren Runden, den Sitzungskontext und die Erstellung von Antworten im Zitierstil.
- Die Plattform hat ein Low-Code-Tool für die Entwicklung von Benutzeroberflächen, mit dem man schnell Prototypen erstellen kann.
Mit Q können Unternehmen Chatbots für den Kundenkontakt zusammen mit Dashboards für Führungskräfte und Helpdesks für bestimmte Bereiche erstellen und diese innerhalb von Wochen statt Monaten bereitstellen.
Die Well-Architected Generative AI Lens setzt in jedem Schritt der Entwicklung generativer Workloads bewährte Verfahren ein.
Gut konzipierte generative KI-Linse
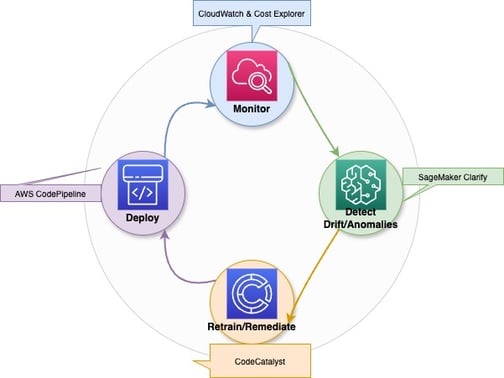
Die Generative AI Lens von AWS erweitert die fünf Säulen des Well-Architected Frameworks auf generative Workloads. Das Framework umfasst automatisierte Modellüberwachungssysteme und Drift-Erkennungsmechanismen sowie Auslöser für Nachschulungen mit Versionsartefaktmanagement und Lernpfad-Tracking.
Hier sind die Säulen:
- Sicherheit: Sorg dafür, dass IAM mit geringsten Rechten durchgesetzt wird, nutze PrivateLink für Bedrock-Endpunkte, verschlüssele Daten während der Übertragung und im Ruhezustand und setz Schutzmaßnahmen für die Inhaltsfilterung ein.
- Zuverlässigkeit: Die Lösung nutzt AZ-basierte Endpunktbereitstellung, automatische Skalierung, Circuit Breaker und Canary-Bereitstellung für risikofreie Rollouts.
- Leistungseffizienz: Such dir die besten Instanzfamilien aus, speicher häufig angezeigte Eingabeaufforderungen und Batch-Anfragen im Cache und nutze serverlose Endpunkte, um auf null zu skalieren.
- Kostenoptimierung: Die Auswahl des Modells sollte den Latenzanforderungen bei der Nutzung von Spot- oder reservierter Kapazität entsprechen, das Prompt Engineering sollte den Token-Verbrauch minimieren und die Kostenanalyse sollte im Cost Explorer durchgeführt werden.
- Nachhaltigkeit: Recheneinheiten richtig dimensionieren, energieeffiziente Chips (Trainium, Inferentia) nutzen, kalte Daten in S3 Glacier archivieren und serverlose Pipelines einsetzen, um ungenutzte Ressourcen zu reduzieren.
Für alle, die eine Zertifizierung anstreben, passtder AWS Cloud Practitioner Lernpfadsuper zu den Grundlagen, die hier behandelt werden.
Schnellere Einführung mit AWS-Partnern
Das AWS Partner Network hilft Unternehmen dabei, AWS-Services schneller einzusetzen, indem es ihnen Solution Accelerators und Partner-Services zur Verfügung stellt. Jedes Unternehmen ist anders, deshalb hat AWS das Partner Network mit speziellen generativen KI-Beschleunigern für verschiedene Branchen und Anwendungsfälle aufgebaut.
- Das AWS Partner Network hat Technologiepartner, die fertige Anwendungen mit Konnektoren und domänenspezifischen Basismodellen anbieten, die über den AWS Marketplace verfügbar sind.
- Das Generative AI Accelerator-Programm hilft Start-ups mit Credits, Mentoring und Best-Practice-Vorlagen, um die Entwicklung von Proof-of-Value zu beschleunigen.
- Durch die Nutzung der Frameworks von APN-Partnern zusammen mit AWS-geprüften Lösungsmustern können Teams Risiken bei Pilotprojekten reduzieren und gleichzeitig generative KI sicher im ganzen Unternehmen einsetzen.
Übersicht über unterstützte AWS-KI-Services
Die Fähigkeit der generativen KI, neue Inhalte zu erstellen, passt nicht zu dem, was man in der Praxis braucht, wo Daten in verschiedenen Formaten verarbeitet und verstanden werden müssen.
AWS hat eine Reihe von Services, die sich in deine generativen Pipelines einbinden lassen, um unstrukturierte Dokumente in strukturierte Daten umzuwandeln, Bildinformationen zu extrahieren und natürliche Gespräche sowie die Ausgabe in jeder Sprache oder Stimme zu ermöglichen.
Hier sind die beliebtesten:
- Amazon Textract
- Das System erkennt automatisch gedruckten Text, Tabellen und Formulardaten in gescannten Dokumenten und Bilddateien.
- Das System nutzt RAG-Pipelines, um fachspezifische Dokumente wie Verträge, Berichte und Rechnungen zu verarbeiten.
- Das System sortiert alles, was noch nicht sortiert ist, damit es für Vorlagen und die Feinabstimmung von Datensätzen bereit ist.
- Amazon Rekognition
- Das System nutzt Bild- und Videoanalyse, um Objekte, Szenen, Texte, Gesichter und Aktivitäten zu erkennen.
- Das System macht kontextbezogene Metadaten (Bezeichnungen, Konfidenzwerte) für die multimodale Generierung.
- Mit dem System können Leute bedingte Logik (z. B. „nur Bilder mit Personen beschreiben“) in ihren Endnutzer-Apps einbauen.
- Amazon Polly
- Der Service verwandelt geschriebenen Text in menschlich klingende Sprache in verschiedenen Stimmen und Sprachen.
- Die Audioausgabe macht generative Chatbots und Assistenten zu interaktiven Schnittstellen.
- Das System unterstützt SSML-Markup, um die Sprachausgabe durch genaue Aussprache, Betonung und Pausenmanagement zu steuern.
- Wenn du wissen willst, wie Polly in echten Anwendungen menschenähnliche Sprachausgaben macht, schau dirdieses praktische Tutorialan.
- Amazon Lex
- Das System macht gesprochene Sprache zu Text und entwickelt so eine Art Unterhaltung.
- Das System ist die Schnittstelle für die Backend-Generatoren und kümmert sich um die Verwaltung der Sitzungen und das Füllen der Slots.
- Das System verbindet sich direkt mit AWS Lambda, um Bedrock- oder SageMaker-Endpunkte für die Generierung dynamischer Antworten auszuführen.
- Amazon Translate
- Der Service bietet sofortige neuronale maschinelle Übersetzungen für über 70 verschiedene Sprachen.
- Das System passt generative Ergebnisse so an, dass sie für ein weltweites Publikum zugänglich sind.
- Das System macht mehrsprachige Eingaben einheitlich, sodass ein einziges Modell für Leute aus verschiedenen Regionen funktioniert.
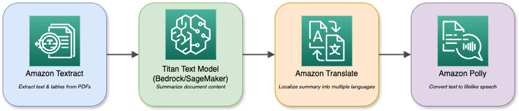
Ein Diagramm, das die verschiedenen Dienste und Interaktionen von AWS zeigt.
Deine Basismodelle in Bedrock oder SageMaker kannst du mit diesen Diensten kombinieren, um komplexe multimodale Anwendungen zu erstellen.
Ein Assistent für die Dokumentenanalyse nutzt zum Beispiel Textract, um PDFs zu lesen, und Titan Text, um sie zusammenzufassen. Dann werden die Zusammenfassungen in verschiedene Sprachen übersetzt und über Polly abgespielt. Mit dem modularen Ökosystem kannst du verschiedene KI-Funktionen kombinieren, um alle Anforderungen deines Unternehmens zu erfüllen.
Implementierungsmuster und Anwendungsfälle
Generative KI liefert die besten Ergebnisse, wenn du gut durchdachte Muster nutzt, um echte Geschäftsprobleme anzugehen.
In diesem Abschnitt werden vier konkrete Implementierungspläne vorgestellt, darunter die suchgestützte Generierung sowie Entwickler- und Unternehmensassistenten, und es werden weitere nützliche Szenarien vorgestellt, die du schon heute umsetzen kannst.
Generierung mit Suchunterstützung (RAG)
Die Kombination von Suchfunktionen mit großen Sprachmodellen in der suchgestützten Generierung liefert genaue Antworten, die immer im Kontext bleiben. Die vierstufige Pipeline läuft so ab:
- Das System holt die relevantesten N Dokumente oder Passagen aus einem Vektorspeicher oder einem Suchindex, indem es eine Abfrage macht.
- Das System verwandelt sowohl Dokumente als auch Nutzeranfragen in semantische Einbettungen, was eine bessere Kontextanpassung ermöglicht.
- Das System schickt sowohl die Anfrage als auch den gefundenen Kontext an ein Basismodell, um eine Antwort zu erstellen.
- Das System nutzt ein zweites Modell oder eine Heuristik, um die möglichen Ergebnisse zu bewerten und neu zu ordnen, und zeigt dann die beste Antwort an.
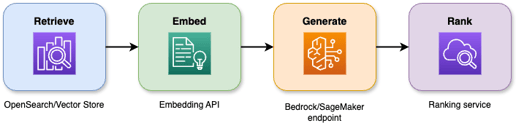
Ein Diagramm, das zeigt, wie die RAG-Architektur funktioniert.
Vorteile und Genauigkeitsgewinne:
- Das System reduziert Halluzinationen um 40 Prozent im Vergleich zu einfachen Generierungsmethoden.
- Die ersten Versuche mit der Wissensdatenbank im Unternehmen zeigen, dass die Relevanz der Antworten um 20 bis 30 Prozent besser geworden ist.
- Die durchschnittliche Zeit, die jemand mit dem Support verbringt, wird um 25 Prozent kürzer, wenn man virtuelle Supportsysteme nutzt.
Geschäftliche Anwendungen:
- Interne Wiki-Inhalte sind die Basis für Chatbots und virtuelle Assistenten, um Ticket-Zusammenfassungen und Tipps zur Fehlerbehebung zu geben.
- RAG-Systeme, die in Suchbenutzeroberflächen eingebaut sind, lassen Nutzer umfangreiche Dokumentensammlungen mit natürlicher Sprache durchsuchen.
- Das System hilft Compliance-, Rechts- und Regulierungsassistenten dabei, Quellenangaben zu liefern, wenn Nutzer danach fragen.
Code-Generierungs-Workflows
AWS CodeWhisperer bringt generative KI direkt über die IDEs und CI/CD-Pipelines zu den Entwicklern, um Routineaufgaben zu automatisieren und das Codieren schneller zu machen:
- Das System bietet drei Hauptfunktionen: Code-Vorschläge in Echtzeit, Vervollständigung von Codeausschnitten und die Generierung von Tests, die sich an deinen aktuellen Programmierkontext anpassen.
- Teams können Features um 30 Prozent schneller bereitstellen, während die Syntaxfehler in frühen Prototypen um 50 Prozent weniger werden.
- Mit der CodeCatalyst-Pipeline können Leute automatisch Infrastructure IaC-Snippets, Unit-Tests und Deployment-Skripte über die CodeWhisperer-Integration erstellen.
- Die Plattform unterstützt mehrere Programmiersprachen, darunter Python, Java, JavaScript/TypeScript, C#, Go und andere, was für deine gesamte Technologieplattform von Vorteil ist.
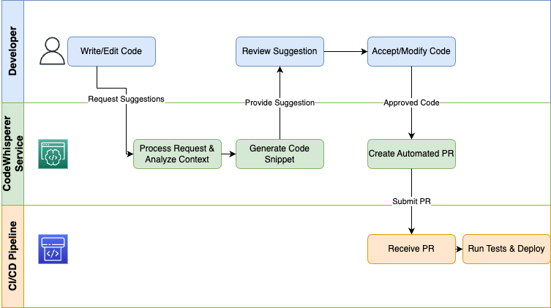
Ein Diagramm, das zeigt, wie Codes erstellt werden.
Firmen, die CodeWhisperer als Entwicklerassistent nutzen, sparen sich langweilige Routineaufgaben, halten sich an Coding-Standards und können sich so voll auf das Design und die Fehlerbehebung konzentrieren.
Denk dran, dass CodeWhisperer Teil von Amazon Q Developer wird.
Unternehmensassistenten
Amazon Q Business ist eine RAG-basierte Low-Code-Lösung, mit der Leute Chatbots entwickeln können, die Unternehmensdaten über Fragen abrufen.
Architektur:
- Das System holt Daten über Konnektoren aus Redshift, OpenSearch, SharePoint und S3.
- Der RAG-Motor holt den passenden Kontext, bevor er die Basismodelle aktiviert.
- Der Dialogmanager kümmert sich um die Verwaltung von Mehrfach-Turn-Sitzungen, einschließlich Slot-Füllung und Statusoperationen.
- Die Benutzeroberfläche reagiert auf Chat-Widgets, Sprachkanäle und Slack-Integrationen.
Einsatzmöglichkeiten:
- Durch die automatische Transkription und Zusammenfassung von Aktionspunkten mithilfe von Meeting-Assistenten sparen Teams jede Woche mehr als zwei Stunden Arbeit.
- Durch die Einführung von Self-Service-Bots werden Routineanfragen abgefangen, was die Bearbeitungszeit um 30 Prozent verkürzt.
- Mit Executive Dashboards kriegst du auf einfache Weise Infos zu Verkäufen, Lagerbeständen und KPIs, auch wenn du keine BI-Kenntnisse hast.
Die Assistenten helfen Unternehmen dabei, die Arbeit mit Wissen zu optimieren, Betriebskosten zu senken und die Produktivität der Mitarbeiter zu steigern.
Weitere hochwertige Anwendungsfälle
Der Wert generativer KI geht über RAG, Codegenerierung und Assistenten hinaus und erstreckt sich auf viele andere Bereiche:
- Diese Systeme können auf Basis von individuellen Profilen und Verhaltensanalysen maßgeschneiderte Produktbeschreibungen, E-Mail-Kampagnen und Chat-Interaktionen erstellen.
- Die Kombination von Textract mit Formular-Parsing-Modellen und Generierung macht die automatische Klassifizierung, Markierung und Weiterleitung von Rechnungen, Verträgen und Ansprüchen sowie nachgelagerte Aufgaben (Ticket-Erstellung, Genehmigungsweiterleitung und Berichterstellung) durch modellgesteuerte Entscheidungslogik möglich.
- Die Analyse von Support-Protokollen, Social-Media-Beiträgen und Verkaufsgesprächen mithilfe von Konversationsanalysen zeigt Stimmungstrends, Compliance-Risiken und umsetzbare Empfehlungen auf.
Probier erst mal diese Vorlagen aus, um Pilotprojekte zu starten, die einen klaren ROI zeigen, bevor du mit der Optimierung und Skalierung in deinem Unternehmen weitermachst.
Sicherheits- und Governance-Modell
Unternehmen müssen bei der Einführung generativer KI in jeder Phase des KI-Lebenszyklus Sicherheitskontrollen und Governance-Praktiken einführen.
AWS hat ein umfassendes Sicherheits- und Compliance-Framework, das von physischen Rechenzentren bis hin zu Richtlinien auf Anwendungsebene reicht und so Innovationen ohne Bedenken ermöglicht.
Datenschutz-Struktur
AWS schützt generative KI-Workloads mit sechs konzentrischen Sicherheitsebenen:
- Die physische Ebene von Rechenzentren umfasst mehrstufige Zugangskontrollen, biometrische Überprüfungen und eine Überwachung rund um die Uhr, wodurch sichergestellt wird, dass nur autorisiertes Personal Zugang zur Hardware hat.
- Das globale Netzwerk von AWS schützt den KI-Datenverkehr durch private Glasfaserverbindungen und DDoS-Abwehr sowie AWS Shield Advanced und sorgt gleichzeitig für einen hohen Netzwerkdurchsatz, indem es den Datenverkehr vom öffentlichen Internet isoliert.
- Modellendpunkte und Datenpipelines bleiben sicher, weil VPCs mit detaillierten Sicherheitsgruppen, Netzwerk-ACLs und PrivateLink-Endpunkten kombiniert werden, die in deinen privaten Netzwerken laufen. privaten Netzwerken.
- Das Nitro-System verschiebt Virtualisierungsvorgänge auf spezielle Hardwarekomponenten, die Bare-Metal-Geschwindigkeit und Hardware-basierten Schutz vor unbefugter Datenweitergabe zwischen virtuellen Maschinen.
- Die Plattformschicht von Bedrock und SageMaker-Endpunkten lässt sich mit AWS KMS integrieren. AWS KMS für vom Kunden verwaltete Schlüssel, nutzt TLS 1.2+ Verschlüsselung für die Datenübertragung und setzt IAM-Berechtigungen basierend auf dem Prinzip der geringsten Berechtigungen.
- Die Anwendungs- und Datenebene setzen detaillierte Ressourcenrichtlinien mit AES-256-Verschlüsselung Verschlüsselung bei der Speicherung und Übertragung und integrieren Audit-Protokollierung über CloudTrail und CloudWatch, um jeden API-Aufruf zu schützen und aufzuzeichnen.
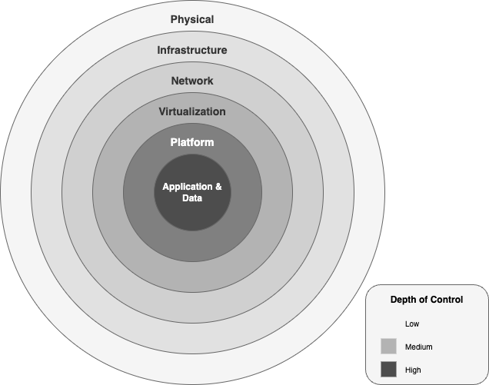
Ein Diagramm, das die Sicherheitsstufen im generativen KI-Framework von AWS zeigt.
Datenisolierung und Compliance:
- Jede Bedrock-Inferenzinstanz läuft in deiner VPC und greift auf die von dir verwalteten S3-Buckets zu und ändert sie.
- Du wählst über AWS KMS vom Kunden verwaltete CMKs aus und kannst externe Schlüsselspeicher (XKS/HYOK) nutzen, um die Anforderungen an die Einhaltung nationaler Datenschutzbestimmungen zu erfüllen.
- AWS hat mehrere Zertifizierungen, darunter ISO 27001 und SOC 1/2/3 Fed, RAMP High, HIPAA, PCI, DSS und GDPR, die automatisch für deine generativen KI-Workloads gelten, ohne dass du was extra machen musst.
Rahmenwerk für verantwortungsbewusste KI
Um Vertrauen in generative KI aufzubauen, muss man in jeder Phase der Modellanwendung ethische und Sicherheitsprotokolle einhalten. AWS sorgt für eine verantwortungsvolle KI-Governance mit diesem Rahmenwerk:
- Die ethischen Grundsätze von AWS legen Wert auf Fairness, Datenschutz, Transparenz und Verantwortlichkeit, um diskriminierende Vorurteile in Modellen zu vermeiden und eine klare Dokumentation der Datenherkunft und Entscheidungslogik zu gewährleisten.
- Das Bedrock Guardrails-System hat Filter, die nach Regeln arbeiten und sowohl eingehende Daten als auch Ergebnisse auf Sachen wie Hassreden, Gewalt, Selbstverletzung und Falschinfos checken. Mit der Invoke-API und der ApplyGuardrail-API können Leute Schutzmaßnahmen für Sicherheitsprüfungen entweder selbst oder über die Invoke-API einrichten.
- Das System speichert alle Anfragen und Schutzmaßnahmen über CloudTrail, während Modellkarten und Auswertungsberichte Leistungsmetriken, mögliche Verzerrungen und Kompromisse zwischen Kosten und Latenz anzeigen.
- Das System sorgt für ständige Kontrolle durch die Bias-Erkennung von SageMaker Clarify und Workflows mit menschlicher Überprüfung bei Ergebnissen mit geringer Zuverlässigkeit sowie automatische Warnungen bei Abweichungen, damit Modelle neu trainiert oder gesperrt werden können.
Diese Schichten und Vorgehensweisen sorgen für eine umfassende Verteidigung für generative KI in Unternehmen, sodass du Innovationen vorantreiben und gleichzeitig die höchsten Standards in Sachen Sicherheit, Compliance und ethischer Verantwortung einhalten kannst.
Strategien zur Kostenoptimierung
Um die Budgets für generative KI im Griff zu haben, muss man die Preismechanismen genau kennen und die Kosten ständig im Auge behalten. Hier geht's um die AWS-Preise für KI-Workloads, mit einem Beispiel für die Gesamtbetriebskosten einer mittelgroßen Bereitstellung und Tipps, wie du die Kosten runterhalten kannst.
Analyse des Preismodells
Die Preise für generative KI von AWS sind in vier Hauptkategorien unterteilt:
- Kosten berechnen
- Endpunkt-Stunden: pro Instanzstunde berechnet, je nach Familie unterschiedlich
- Inf1.xlarge für 0,228 $/Stunde
- G5.xlarge für 1,006 $/Stunde
- Schulungsaufträge: werden pro Instanzstunde auf Trn1-, P4- oder P5-Hardware abgerechnet (z. B. Trn1.32xlarge zu 21,50 $/Stunde)
- Token-/Anfragegebühren
- Sofort-Token: 0,0008 $ pro 1 K Token
- Abschluss-Token: 0,0016 $ pro 1.000 Token
- Speicherung und Datenübertragung
- Modellartefakte: S3 Standard für 0,023 $/GB pro Monat
- Datenausgang: 0,09 $/GB über die kostenlose Nutzung hinaus
- Anpassung & Bewertung
- Feinabstimmung: zusätzliche Schulungsgebühren pro Stunde und Instanz plus minimale Datenverarbeitungsgebühren.
- Evaluierungsläufe: Token-Gebühren für Basis- vs. benutzerdefinierte Vergleiche.
Strategien zur Kostenoptimierung
- Wähl das richtige Silikon: Verwende Inferentia (Inf1/Inf2) für Inferenz mit hohem Volumen und geringer Latenz und Trainium (Trn1) für groß angelegtes Training, um die Kosten pro TPU-Stunde zu senken.
- Eingabeaufforderungen stapeln und zwischenspeichern: Gruppiere ähnliche Anfragen und speichere beliebte Antworten, um wiederholte Token-Ausgaben zu vermeiden.
- Multimodale Endpunkte: Stell mehrere kleinere Modelle hinter einem Endpunkt auf – so sparst du Spitzenlatenzzeiten und hast deutlich niedrigere Kosten in den Leerlaufzeiten.
- Spot- und reservierte Kapazitäts: Entscheide dich für einen Bruchteil der Basiskapazität mit Reserved Instances oder nutze Spot für nicht so wichtige Batch-Workloads.
- Prompt-Engineering-: Mach die Anweisungen einfacher, um die Anzahl der Tokens pro Anfrage zu reduzieren, ohne dass die Qualität leidet.
Vergleich von Architekturen
|
Architektur
|
Kostentreiber berechnen
|
Token-Kostenfaktor
|
Am besten geeignet
|
|
Chatbots in Echtzeit
|
Viele kleine Endpunkte, die rund um die Uhr laufen
|
Hohe Anfrage-Rate, kleine Tokens
|
Kundensupport, Helpdesks
|
|
Batch-Erstellung
|
Kurzlebige große Instanzen
|
Nur wenige große Token-Bursts
|
Erstellung von Berichten, Datenanreicherung
|
|
RAG-Pipelines
|
Kombinierte Suche + Schlussfolgerung
|
Abruftoken + Generierungstoken
|
Wissensbasierte Assistenten
|
Gesamtbetriebskostenmodell
Hier ist ein Beispiel für die monatlichen Gesamtbetriebskosten für ein mittelgroßesgeneratives KI-Pilotprojekt:
|
Kostenpunkt
|
Stückkosten
|
Verwendung
|
Monatliche Kosten
|
|
Inferenz-Endpunkte (Inf1.xl)
|
0,228 $/Stunde
|
3 Endpunkte × 24 Stunden × 30 Tage
|
$492.48
|
|
Token-Nutzung (Titan Express)
|
0,0024 $ / 1 K-Token
|
3 M-Token pro Tag × 30 Tage
|
$216.00
|
|
S3-Speicher (Modellartefakte)
|
0,023 $/GB-Monat
|
10.000 GB
|
$230
|
|
Datenausgang
|
0,09 $/GB
|
1 TB
|
$90
|
|
Glue ETL (Feature-Vorbereitung)
|
0,44 $/DPU-Stunde
|
20 DPU-Stunden
|
$8.80
|
|
Insgesamt
| | |
$1,037.28
|
WichtigeHebel für die Optimierung:
- Automatische Skalierung auf Null: Leere Endpunkte löschen, wenn der Datenverkehr nachlässt.
- Multimodale Endpunkte: Modelle zusammenlegen, um die Leerlaufkosten um bis zu 60 % zu senken.
- Reservierung und Spot-: Sichere dir günstige Preise für die Basiskapazität und nutze Spot für Jobs, bei denen es nicht so sehr auf die Latenz ankommt.
- Schnelle Komprimierungs: Refactor-Eingabeaufforderungen zum Entfernen überflüssiger Tokens, wodurch 10–15 % der Token-Ausgaben eingespart werden.
Laufendes Kostenmanagement:
- Mit dem AWS-Preisrechner kannst duvor dem Start verschiedene Szenarien durchspielen.
- Überwache die tatsächliche Nutzung im AWS Cost Explorer und leg Budgets und Warnmeldungen für Anomalien fest.
- Kennzeichne alle KI-Ressourcen für eine klare Abrechnung und Berichterstattung.
Durch die Kombination aus einer preisbewussten Architektur mit gezielten Optimierungen und ständiger Überwachung kannst du generative KI skalieren, ohne dass es zu hohen Kosten kommt.


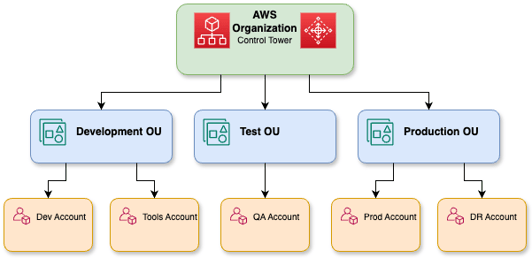




Die generative KI von AWS ist die Zukunft der Cloud-Services, weil sie Unternehmen ermöglicht, automatisierte Inhalte und Wissensarbeit über Basismodelle zu erstellen, die Texte, Bilder und Videos in Echtzeit produzieren.
In diesem Artikel gebe ich einen umfassenden Überblick über die wichtigsten Elemente von Bereitstellungsmethoden und Governance-Frameworks, die für die Entwicklung produktionsreifer generativer KI-Lösungen erforderlich sind.
AWS ist der führende Cloud-Anbieter, weil es Amazon Bedrock zusammen mit einer speziellen Recheninfrastruktur und umfassenden Integrationsmöglichkeiten anbietet, die andere Cloud-Plattformen übertreffen.
Wenn du noch nicht mit AWS vertraut bist,bekommst du indiesem Einführungskurseine solide Grundlage, bevor du dich mit den Besonderheiten der generativen KI beschäftigst.
Die wichtigsten Teile verstehen
In diesem Abschnitt schauen wir uns die Bausteine an, die die generative KI von AWS zum Laufen bringen.
Ökosystem des Basismodells
Bedrock ist die verwaltete Steuerungsebene für alle generativen KI-Lösungen auf AWS. Es bietet eine einheitliche API für die Bereitstellung, Skalierung und Sicherung von Basismodellen, von der Endpunktbereitstellung bis zur Abrechnung. So kannst du dich ganz auf die Erstellung von Eingabeaufforderungen und die Integration von KI konzentrieren, anstatt dich um die Verwaltung der Infrastruktur zu kümmern.
Ein Konzeptdiagramm, das das AWS-Foundation-Modell-Ökosystem zeigt
Der Bedrock -Katalog „“ bringt Modelle für Text, Bilder, Videos und Einbettungen unter einer einzigen Oberfläche zusammen. Zu den wichtigsten Angeboten gehören:
Optimiere Modelle anhand deiner beschrifteten Daten oder mach weiter mit dem Vortraining auf domänenspezifischen Korpora über die Bedrock-Konsole oder das SDK. Nach dem Training macht die Bewertungssuite von Bedrock Vergleiche und zeigt dir die Genauigkeit, Latenz und Kosten pro Token, damit du die beste Variante für deine Produktions-SLAs objektiv auswählen kannst.
Neben den Titan- und Nova-Familien von AWS kannst du mit Bedrock auch Modelle von Partnern wie Anthropic, Cohere, Mistral, AI21 Labs und anderen nutzen. Nutzen Sie diese Bandbreite, um:
Wenn du genauer wissen willst, wie Bedrock diese Basismodelle in Produktionsumgebungen zusammenbringt, schau dir diese komplette Anleitung zu Amazon Bedrockan .
KI-optimierte Recheninfrastruktur
Die EC2-Instanzfamilien von AWS sind genau auf die besonderen Anforderungen von Trainings- und Inferenzvorgängen zugeschnitten.
Schulung:
Schlussfolgerung:
Ein Diagramm, das die KI-optimierte Recheninfrastruktur von AWS zeigt.
AWS schafft eine nahtlose Integration zwischen seiner maßgeschneiderten Hardware und Softwarekomponenten durch Trainium für Schulungen und Inferentia für Inferenzchips, die direkt mit AWS-Diensten zusammenarbeiten. Diese vertikale Integration bringt folgende Vorteile:
Das AWS Nitro System nutzt spezielle Hardwarekarten für die Virtualisierungsfunktionen und bietet so schnelle Bare-Metal-Geschwindigkeiten zusammen mit sicherer Isolierung:
Entdecke in diesem Kursüber AWS Cloud-Technologie und -Servicesdas umfassende Ökosystem aus Rechenleistung, Speicher und Analysen.
Datenfundamente für robuste generative KI
Modelltraining mit hoher Geschwindigkeit und RAG-Pipelines brauchen Daten, die sauber und gut verwaltet sind:
Rahmenwerk für die Unternehmensintegration
Die generativen KI-Funktionen von AWS lassen sich direkt in das umfassende AWS-Ökosystem integrieren und bieten so durchgängige Lösungen für die Produktion. In diesem Abschnitt wird erklärt, wie man Bedrock mit den dazugehörigen Diensten kombiniert, um echte generative KI-Anwendungen zu entwickeln.
Einheitlicher ML-Lebenszyklus mit SageMaker JumpStart und Bedrock
Such dir einfach ein paar Basismodelle aus dem Modell-Hub von SageMaker JumpStart aus und leg los. Du kannst ganz einfach mehrere Open-Source- und proprietäre Modelle über einen einzigen Knopf bereitstellen, bevor du sie direkt in Amazon Bedrock registrierst. Die in Bedrock eingegebenen Modelle haben Zugriff auf:
Dank der integrierten Architektur können Entwickler Prototypenin SageMaker Studio erstellen, sie dann in Bedrock verbessern und schließlich über CI/CD-Pipelines ohne Codeänderungen bereitstellen.
Dieses SageMaker-Tutorial zeigt dir Schritt für Schritt, wie du Modelle mit der ML-Plattform von AWS optimierst und bereitstellst.
Workflows mit Amazon Bedrock Agents organisieren
Mit Bedrock Agents kannst du generative KI in deine operativen Anwendungen einbauen, indem du Daten automatisch abrufst und umwandelst, bevor du Aktionen ausführst. Ein Agent braucht nur ein paar einfache Einstellungen, um:
Dank der pipelinegestützten Funktionen der Agenten können sich Entwickler voll auf die Geschäftslogik konzentrieren, anstatt sich mit dem Integrationscode rumzuschlagen, was die Zeit bis zur Wertschöpfung verkürzt.
Entwickle mit Amazon Q Gesprächsassistenten
Amazon Q ist ein komplett verwalteter Service zum Entwickeln von RAG-basierten Business-Assistenten.
Der Service verbindet die Multimodalfunktionen von Bedrock mit:
Mit Q können Unternehmen Chatbots für den Kundenkontakt zusammen mit Dashboards für Führungskräfte und Helpdesks für bestimmte Bereiche erstellen und diese innerhalb von Wochen statt Monaten bereitstellen.
Die Well-Architected Generative AI Lens setzt in jedem Schritt der Entwicklung generativer Workloads bewährte Verfahren ein.
Gut konzipierte generative KI-Linse
Die Generative AI Lens von AWS erweitert die fünf Säulen des Well-Architected Frameworks auf generative Workloads. Das Framework umfasst automatisierte Modellüberwachungssysteme und Drift-Erkennungsmechanismen sowie Auslöser für Nachschulungen mit Versionsartefaktmanagement und Lernpfad-Tracking.
Hier sind die Säulen:
Für alle, die eine Zertifizierung anstreben, passtder AWS Cloud Practitioner Lernpfadsuper zu den Grundlagen, die hier behandelt werden.
Schnellere Einführung mit AWS-Partnern
Das AWS Partner Network hilft Unternehmen dabei, AWS-Services schneller einzusetzen, indem es ihnen Solution Accelerators und Partner-Services zur Verfügung stellt. Jedes Unternehmen ist anders, deshalb hat AWS das Partner Network mit speziellen generativen KI-Beschleunigern für verschiedene Branchen und Anwendungsfälle aufgebaut.
Übersicht über unterstützte AWS-KI-Services
Die Fähigkeit der generativen KI, neue Inhalte zu erstellen, passt nicht zu dem, was man in der Praxis braucht, wo Daten in verschiedenen Formaten verarbeitet und verstanden werden müssen.
AWS hat eine Reihe von Services, die sich in deine generativen Pipelines einbinden lassen, um unstrukturierte Dokumente in strukturierte Daten umzuwandeln, Bildinformationen zu extrahieren und natürliche Gespräche sowie die Ausgabe in jeder Sprache oder Stimme zu ermöglichen.
Hier sind die beliebtesten:
Ein Diagramm, das die verschiedenen Dienste und Interaktionen von AWS zeigt.
Deine Basismodelle in Bedrock oder SageMaker kannst du mit diesen Diensten kombinieren, um komplexe multimodale Anwendungen zu erstellen.
Ein Assistent für die Dokumentenanalyse nutzt zum Beispiel Textract, um PDFs zu lesen, und Titan Text, um sie zusammenzufassen. Dann werden die Zusammenfassungen in verschiedene Sprachen übersetzt und über Polly abgespielt. Mit dem modularen Ökosystem kannst du verschiedene KI-Funktionen kombinieren, um alle Anforderungen deines Unternehmens zu erfüllen.
Implementierungsmuster und Anwendungsfälle
Generative KI liefert die besten Ergebnisse, wenn du gut durchdachte Muster nutzt, um echte Geschäftsprobleme anzugehen.
In diesem Abschnitt werden vier konkrete Implementierungspläne vorgestellt, darunter die suchgestützte Generierung sowie Entwickler- und Unternehmensassistenten, und es werden weitere nützliche Szenarien vorgestellt, die du schon heute umsetzen kannst.
Generierung mit Suchunterstützung (RAG)
Die Kombination von Suchfunktionen mit großen Sprachmodellen in der suchgestützten Generierung liefert genaue Antworten, die immer im Kontext bleiben. Die vierstufige Pipeline läuft so ab:
Ein Diagramm, das zeigt, wie die RAG-Architektur funktioniert.
Vorteile und Genauigkeitsgewinne:
Geschäftliche Anwendungen:
Code-Generierungs-Workflows
AWS CodeWhisperer bringt generative KI direkt über die IDEs und CI/CD-Pipelines zu den Entwicklern, um Routineaufgaben zu automatisieren und das Codieren schneller zu machen:
Ein Diagramm, das zeigt, wie Codes erstellt werden.
Firmen, die CodeWhisperer als Entwicklerassistent nutzen, sparen sich langweilige Routineaufgaben, halten sich an Coding-Standards und können sich so voll auf das Design und die Fehlerbehebung konzentrieren.
Denk dran, dass CodeWhisperer Teil von Amazon Q Developer wird.
Unternehmensassistenten
Amazon Q Business ist eine RAG-basierte Low-Code-Lösung, mit der Leute Chatbots entwickeln können, die Unternehmensdaten über Fragen abrufen.
Architektur:
Einsatzmöglichkeiten:
Die Assistenten helfen Unternehmen dabei, die Arbeit mit Wissen zu optimieren, Betriebskosten zu senken und die Produktivität der Mitarbeiter zu steigern.
Weitere hochwertige Anwendungsfälle
Der Wert generativer KI geht über RAG, Codegenerierung und Assistenten hinaus und erstreckt sich auf viele andere Bereiche:
Probier erst mal diese Vorlagen aus, um Pilotprojekte zu starten, die einen klaren ROI zeigen, bevor du mit der Optimierung und Skalierung in deinem Unternehmen weitermachst.
Sicherheits- und Governance-Modell
Unternehmen müssen bei der Einführung generativer KI in jeder Phase des KI-Lebenszyklus Sicherheitskontrollen und Governance-Praktiken einführen.
AWS hat ein umfassendes Sicherheits- und Compliance-Framework, das von physischen Rechenzentren bis hin zu Richtlinien auf Anwendungsebene reicht und so Innovationen ohne Bedenken ermöglicht.
Datenschutz-Struktur
AWS schützt generative KI-Workloads mit sechs konzentrischen Sicherheitsebenen:
Ein Diagramm, das die Sicherheitsstufen im generativen KI-Framework von AWS zeigt.
Datenisolierung und Compliance:
Rahmenwerk für verantwortungsbewusste KI
Um Vertrauen in generative KI aufzubauen, muss man in jeder Phase der Modellanwendung ethische und Sicherheitsprotokolle einhalten. AWS sorgt für eine verantwortungsvolle KI-Governance mit diesem Rahmenwerk:
Diese Schichten und Vorgehensweisen sorgen für eine umfassende Verteidigung für generative KI in Unternehmen, sodass du Innovationen vorantreiben und gleichzeitig die höchsten Standards in Sachen Sicherheit, Compliance und ethischer Verantwortung einhalten kannst.
Strategien zur Kostenoptimierung
Um die Budgets für generative KI im Griff zu haben, muss man die Preismechanismen genau kennen und die Kosten ständig im Auge behalten. Hier geht's um die AWS-Preise für KI-Workloads, mit einem Beispiel für die Gesamtbetriebskosten einer mittelgroßen Bereitstellung und Tipps, wie du die Kosten runterhalten kannst.
Analyse des Preismodells
Die Preise für generative KI von AWS sind in vier Hauptkategorien unterteilt:
Strategien zur Kostenoptimierung
Vergleich von Architekturen
Architektur
Kostentreiber berechnen
Token-Kostenfaktor
Am besten geeignet
Chatbots in Echtzeit
Viele kleine Endpunkte, die rund um die Uhr laufen
Hohe Anfrage-Rate, kleine Tokens
Kundensupport, Helpdesks
Batch-Erstellung
Kurzlebige große Instanzen
Nur wenige große Token-Bursts
Erstellung von Berichten, Datenanreicherung
RAG-Pipelines
Kombinierte Suche + Schlussfolgerung
Abruftoken + Generierungstoken
Wissensbasierte Assistenten
Gesamtbetriebskostenmodell
Hier ist ein Beispiel für die monatlichen Gesamtbetriebskosten für ein mittelgroßesgeneratives KI-Pilotprojekt:
Kostenpunkt
Stückkosten
Verwendung
Monatliche Kosten
Inferenz-Endpunkte (Inf1.xl)
0,228 $/Stunde
3 Endpunkte × 24 Stunden × 30 Tage
$492.48
Token-Nutzung (Titan Express)
0,0024 $ / 1 K-Token
3 M-Token pro Tag × 30 Tage
$216.00
S3-Speicher (Modellartefakte)
0,023 $/GB-Monat
10.000 GB
$230
Datenausgang
0,09 $/GB
1 TB
$90
Glue ETL (Feature-Vorbereitung)
0,44 $/DPU-Stunde
20 DPU-Stunden
$8.80
Insgesamt
$1,037.28
WichtigeHebel für die Optimierung:
Laufendes Kostenmanagement:
Durch die Kombination aus einer preisbewussten Architektur mit gezielten Optimierungen und ständiger Überwachung kannst du generative KI skalieren, ohne dass es zu hohen Kosten kommt.