
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
51.9K
Large Language Models (LLM) menghasilkan teks menggunakan teknik yang disebut autoregresi, yakni memprediksi kata paling mungkin berikutnya dalam sebuah urutan berdasarkan kata-kata sebelumnya. Agen berbasis LLM seperti ChatGPT juga disetel ulang (fine-tuned) untuk mengikuti maksud pengguna. Karena itu, mereka tidak hanya melengkapi urutan input, tetapi juga menangkap maksud pengguna pada input tersebut dan menghasilkan respons yang sesuai.
Jika Anda sudah mencoba ChatGPT untuk beberapa waktu, saya yakin Anda menyadari bahwa kualitas dari sebuah jawaban juga bergantung pada kualitas input pengguna; misalnya, agen memberikan respons yang “lebih baik” untuk pertanyaan tertentu dibanding yang lain.
Rahasia untuk mendapatkan jawaban terbaik adalah memahami bagaimana LLM menghasilkan output dan merumuskan prompt input sesuai dengan itu. Kumpulan teknik yang diterapkan pada input pengguna untuk memaksimalkan potensi model dikenal sebagai Prompt Engineering.
Dalam artikel ini, kita akan mengeksplorasi salah satu teknik Prompt Engineering yang paling kuat: Chain-of-Thought (CoT) prompting. Teknik ini melibatkan penyusunan prompt dengan cara yang memudahkan model menyelesaikan tugas kompleks yang membutuhkan penalaran atau pemecahan masalah. Telah ditunjukkan bahwa tanpa CoT, model yang sama gagal memberikan jawaban yang benar.
Meskipun LLM dikenal dengan kemampuannya untuk menggeneralisasi, kemampuan model bergantung pada tugasnya. Saat menggunakan LLM, penting untuk mempertimbangkan bahwa setiap model telah dilatih pada basis data yang sangat besar namun terbatas, dan dioptimalkan untuk tugas tertentu. Oleh karena itu, sementara model dapat sangat andal di domain tertentu, model bisa gagal di domain lainnya.
Kemampuan model juga bergantung pada waktu. Seperti halnya manusia, jika Anda memberi saya penjumlahan 5 digit, saya butuh waktu untuk berpikir dan kembali menjawab dengan benar. Jika dilakukan tergesa-gesa, Anda bisa saja salah hitung dan gagal memberikan respons yang benar.
Demikian pula, jika kita memberikan model bahasa sebuah tugas yang terlalu kompleks untuk diselesaikan dalam waktu yang dibutuhkan untuk menghitung token berikutnya, ia mungkin gagal memberikan jawaban yang benar.
Namun, seperti manusia, itu tidak serta-merta berarti model tidak mampu mengerjakan tugas tersebut. Dengan sedikit waktu atau panduan untuk menalar langkah demi langkah, model mungkin tetap mampu menjawab secara andal.
Respons model dan waktu yang dibutuhkan untuk menghasilkannya juga dapat dipengaruhi oleh berbagai faktor, seperti perumusan pertanyaan secara spesifik:
Chain-of-Thought prompting membimbing LLM untuk berhasil menyelesaikan tugas kompleks, baik dengan memilih cara merumuskan prompt maupun memberi model waktu atau langkah yang diperlukan untuk menghasilkan jawaban yang benar.
Chain-of-Thought prompting adalah teknik yang meningkatkan performa model bahasa dengan secara eksplisit meminta model menghasilkan penjelasan atau proses penalaran langkah demi langkah sebelum sampai pada jawaban akhir. Metode ini membantu model memecah masalah dan tidak melewatkan tugas-tugas antara agar terhindar dari kegagalan penalaran.
CoT efektif karena membantu memfokuskan mekanisme atensi LLM. Dekomposisi proses penalaran membuat model memusatkan perhatian pada satu bagian masalah dalam satu waktu, meminimalkan risiko kesalahan yang mungkin muncul akibat menangani terlalu banyak informasi secara bersamaan.
Para peneliti di Google memperkenalkan Chain-of-Thought prompting dalam makalah berjudul “Chain of Thought Prompting Elicits Reasoning in Large Language Models” pada 2022. Riset ini menyoroti bagaimana membimbing model melalui serangkaian langkah penalaran antara secara signifikan meningkatkan performanya pada tugas-tugas seperti pemecahan masalah matematika, penalaran logis, dan tanya jawab multi-hop.
Mari kita lihat salah satu contoh yang diusulkan:
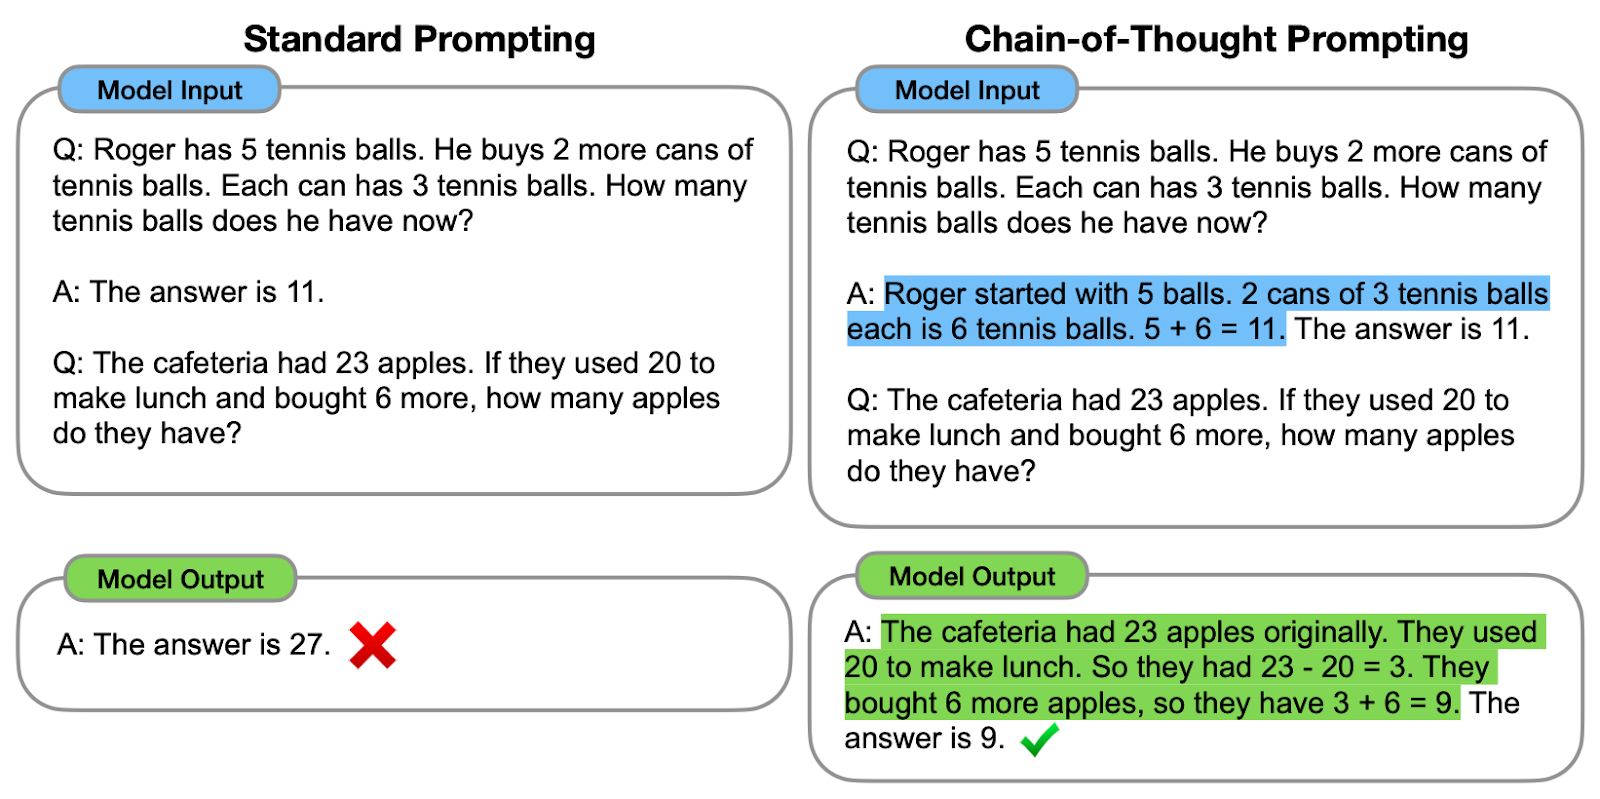
Perbandingan antara standard prompting dan CoT prompting. Di kiri, model diminta langsung memberikan jawaban akhir (standard prompting). Di kanan, model diminta menampilkan proses penalaran untuk sampai pada jawaban akhir (CoT prompting).
Seperti yang kita amati, menghasilkan rantai pemikiran — serangkaian langkah penalaran antara — membantu model memberikan jawaban yang benar.
Para penulis asli merujuk chain of thought sebagai serangkaian langkah penalaran bahasa alami antara yang mengarah pada output akhir, dan menyebut pendekatan ini sebagai Chain-of-Thought prompting.
Prosesnya dimulai dengan merancang prompt yang mendorong model untuk memikirkan masalah secara bertahap, sehingga menghasilkan langkah-langkah antara tanpa langsung melompat ke jawaban akhir. Ini dapat dilakukan menggunakan berbagai strategi:
Memberi instruksi eksplisit berarti memecah masalah di dalam prompt pengguna itu sendiri. Misalnya, menggunakan kalimat seperti “Pertama, kita perlu mempertimbangkan…” untuk meminta model merinci alur pikirannya.
Mari kita lihat penerapannya!
Bayangkan ibu saya yang orang Spanyol mengirimkan resep keluarga untuk menyiapkan Cold Brew:
input_text = """
¡Preparar café Cold Brew es un proceso sencillo y refrescante!
Todo lo que necesitas son granos de café molido grueso y agua fría.
Comienza añadiendo el café molido a un recipiente o jarra grande.
Luego, vierte agua fría, asegurándote de que todos los granos de café
estén completamente sumergidos.
Remueve la mezcla suavemente para garantizar una saturación uniforme.
Cubre el recipiente y déjalo en remojo en el refrigerador durante al
menos 12 a 24 horas, dependiendo de la fuerza deseada.
"""
Misalkan kita ingin menerjemahkan semua kata terkait kopi ke bahasa Inggris, dan kita ingin menggunakan ChatGPT untuk tugas ini:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Berikut respons untuk prompt ini:
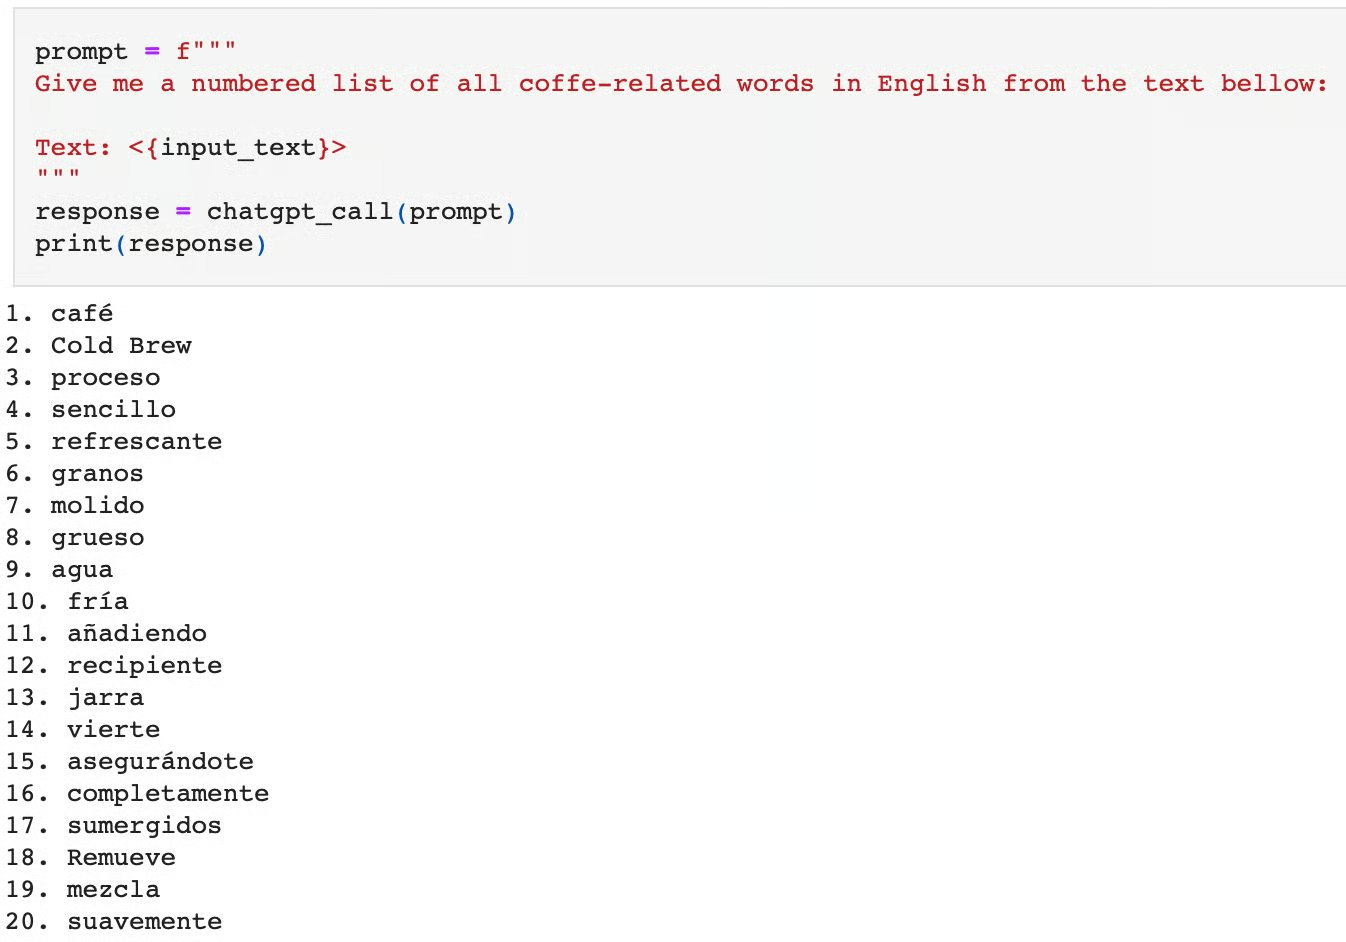
Jika kita meminta model melakukan tugas ini secara langsung, kita dapat melihat bahwa ia melaksanakan tugas tersebut dengan keliru. Bukan hanya mengeluarkan kata-kata yang tidak terkait kopi, tetapi juga menuliskannya dalam bahasa Spanyol, bukan bahasa Inggris.
Kita dapat menganggap bahwa tugas ini kompleks karena memerlukan dua langkah:
Sebaliknya, model langsung melompat ke tugas akhir mengidentifikasi kata-kata terkait kopi, sehingga melewatkan langkah penerjemahan. Dengan menentukan penerjemahan sebagai tugas antara atau memecah tugas menjadi dua langkah utama, kita dapat membimbing model menuju output yang benar:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
The task requires the following actions:
1 - Translate the given text into English.
2 - List each coffee-related word from the English text.
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Menyertakan Chain-of-Thought di atas menghasilkan jawaban yang benar:
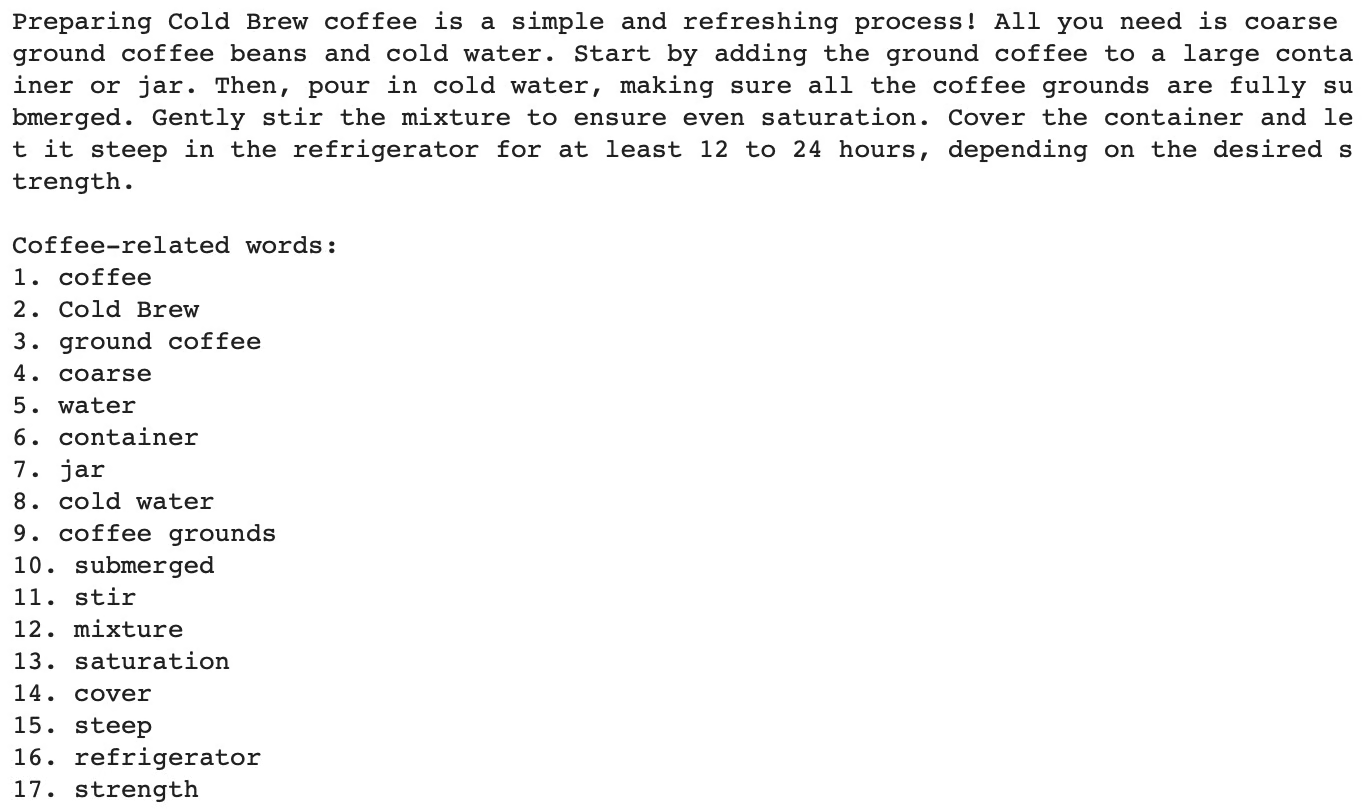
Jika Anda tertarik mencoba teknik ini dengan LLM lain selain ChatGPT atau OpenAI API seperti dalam artikel ini, kursus “Developing Large Language Models” cocok untuk Anda!
Terkadang, kita tidak perlu memecah masalah sendiri di prompt. University of Tokyo bersama Google Research mengusulkan metode sederhana untuk meningkatkan respons LLM yang cukup dengan menambahkan “Let’s think step by step" di akhir prompt asli.
Kalimat sederhana ini meminta model untuk menalar secara terbuka dan melalui semua langkah yang diperlukan untuk menyelesaikan tugas.
Mari kita analisis salah satu contoh yang diajukan penulis dalam makalah asli “Large Language Models are Zero-Shot Reasoners”:
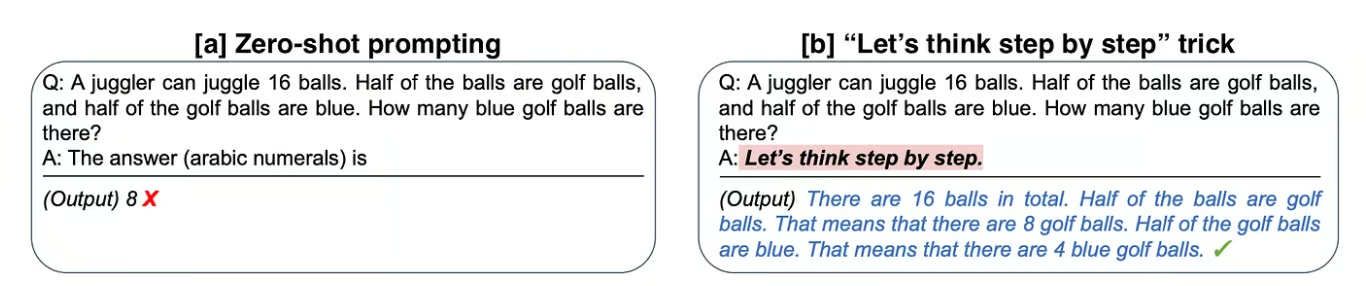
Perbandingan antara standard prompting dan penggunaan instruksi CoT implisit. Di kiri, model langsung memberikan jawaban akhir atas masalah (zero-shot prompting) dan gagal. Di kanan, model diberi instruksi CoT implisit (CoT prompting) sehingga memperoleh jawaban yang benar.
[a] Pada contoh pertama, penulis meminta model menyelesaikan soal aritmetika, namun model gagal.
[b] Lalu, dengan menambahkan “Let’s think step by step” pada pertanyaan asli, model menalar jawaban secara terbuka dan berhasil.
Dengan menerapkan trik sederhana ini pada dataset matematika MultiArith, penulis menemukan bahwa instruksi implisit ini meningkatkan akurasi empat kali lipat dari 18% menjadi 79%!
Jika Anda tertarik, Anda dapat membaca lebih lanjut tentang teknik ini di “Use This Short Prompt to Boost ChatGPT’s Outcome.”
Kita telah beberapa kali menggunakan istilah “zero-shot” pada bagian di atas. Zero-shot merujuk pada kemampuan model untuk melakukan suatu tugas tanpa dilatih secara eksplisit dengan contoh tugas spesifik tersebut.
Ini bergantung pada kemampuan model untuk menggeneralisasi dan menghasilkan respons yang sesuai untuk tugas baru yang sebelumnya belum pernah dilihat. Artinya, ketika kita membuka antarmuka pengguna ChatGPT dan langsung mengajukan pertanyaan, kita sedang melakukan zero-shot prompting.
Meski begitu, ada cara untuk menunjukkan kepada model beberapa contoh tugas serupa yang ingin kita selesaikan. Menyediakan serangkaian contoh demonstratif dikenal sebagai one-shot dan few-shot prompting, bergantung pada jumlah contoh yang diberikan.
One-shot prompting melibatkan menunjukkan satu contoh kepada model yang mirip dengan tugas target sebagai panduan.
Sebagai contoh, jika kita merujuk kembali pada Gambar pertama dalam artikel, kita dapat mengamati bahwa model menghasilkan Chain-of-Thought berkat contoh demonstratif yang disediakan dalam prompt.
Few-shot bekerja sama seperti one-shot, tetapi jumlah contoh yang diberikan lebih banyak, biasanya sekitar seratus. Performa model meningkat secara linear dengan jumlah contoh.
Few-shot prompting dipelajari oleh Jason Wei dan Denny Zhou dkk. dari Google. Pendekatan ini sangat berguna untuk tugas yang membutuhkan pengetahuan yang lebih khusus atau spesifik domain, di mana model mungkin tidak memiliki pengetahuan latar yang cukup untuk melakukan tugas tersebut menggunakan zero-shot atau one-shot prompting. Few-shot prompting terkadang dipandang sebagai penyetelan kecil (fine-tuning ringan) pada model dengan sekumpulan data baru atau khusus.
Lihat lebih banyak contoh one-shot dan few-shot prompting di “Improve ChatGPT Performance with Prompt Engineering.”
One-shot dan few-shot prompting bukanlah CoT. Namun, para peneliti telah mengeksplorasi bagaimana pembelajaran few-shot dapat dikombinasikan dengan CoT prompting, yang dikenal sebagai “Few-shot CoT prompting.” Pada few-shot CoT, model diberikan beberapa contoh masalah beserta solusi langkah demi langkahnya untuk membimbing proses penalarannya.
Mengombinasikan few-shot CoT prompting dengan teknik lain, seperti retrieval-augmented generation atau interaktif querying, dapat semakin meningkatkan performa dan keandalan model. Mengintegrasikan basis pengetahuan eksternal, basis data, atau sistem temu kembali informasi memungkinkan model memperkaya penalarannya dengan informasi faktual dan terkini.
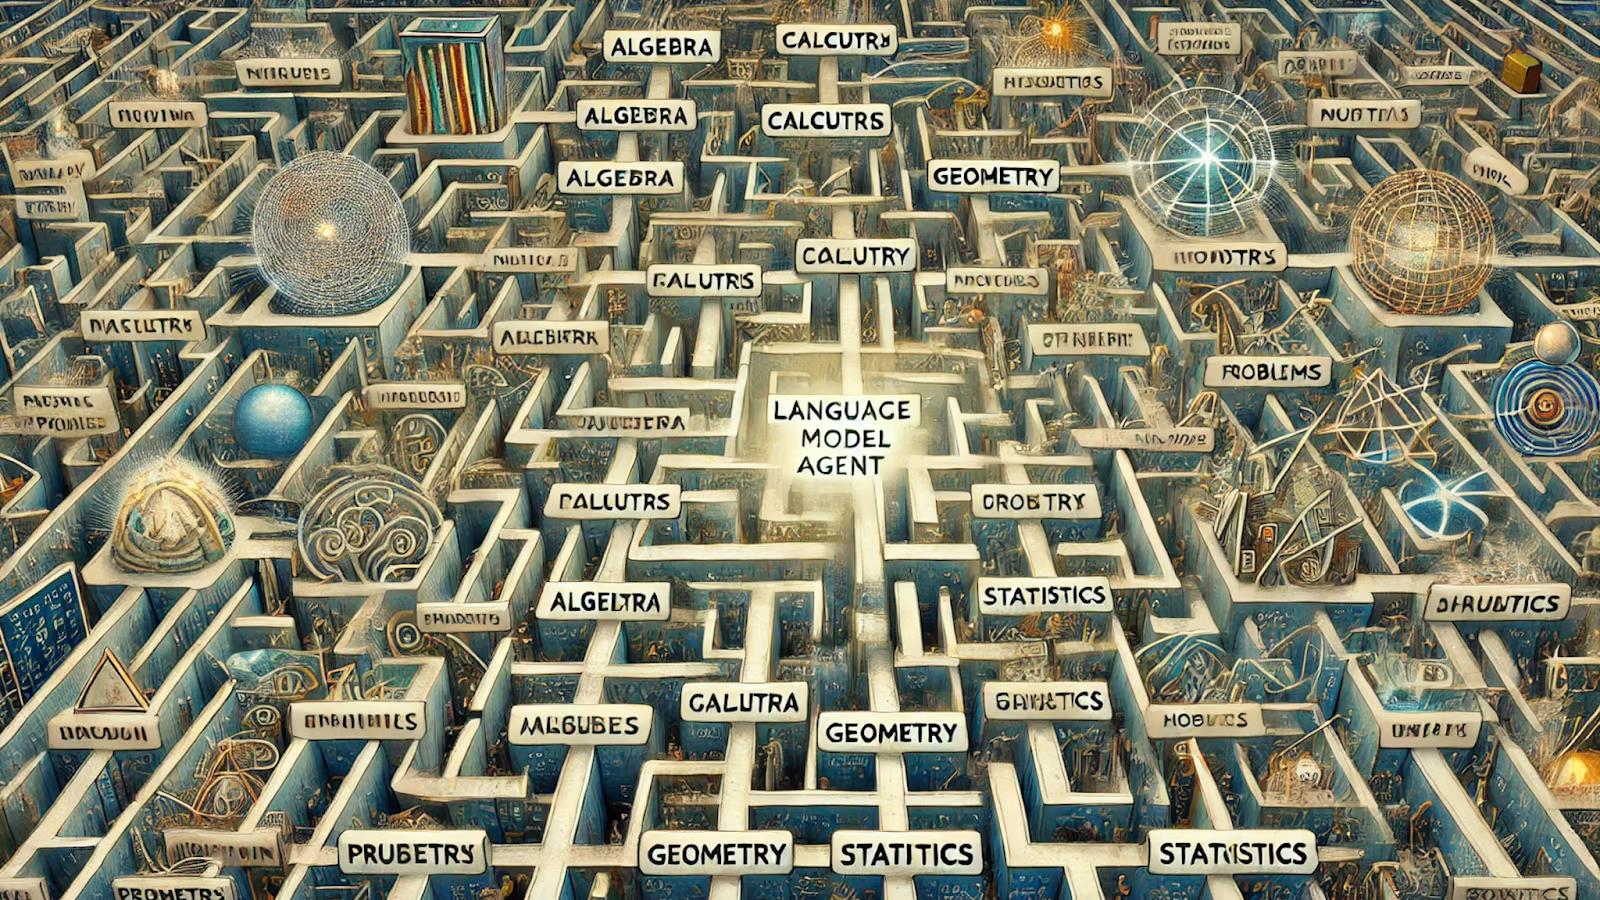
Labu-labu soal matematika untuk menggambarkan bagaimana CoT dapat membantu model menavigasi ruang pengetahuan dan menyelesaikan tugas kompleks. Gambar dibuat sendiri menggunakan ChatGPT 4o image generation dengan prompt berikut: “Imagine a Language Model agent through a maze of mathematical problems”.
Ada berbagai cara untuk memasukkan CoT ke dalam prompt kita:
Ada banyak kerangka kerja yang dapat membantu Anda menerapkan CoT dan teknik Prompt Engineering lainnya, tetapi LangChain adalah favorit saya. Jika Anda tertarik menggunakan LangChain sebagai bagian dari proyek berbasis LLM, kursus “Developing LLM Applications with LangChain” adalah titik awal yang ideal.
Chain-of-Thought prompting menawarkan sejumlah manfaat, khususnya dalam meningkatkan performa dan keandalan model bahasa pada tugas-tugas kompleks.
Dengan memecah masalah menjadi langkah-langkah kecil yang mudah dikelola, model dapat menangani tugas kompleks dengan lebih akurat. Langkah-langkah antara menyediakan titik pemeriksaan tempat potensi kesalahan dapat dideteksi dan dikoreksi, sehingga menghasilkan jawaban akhir yang lebih akurat.
Alasan mengapa tugas seperti soal matematika, teka-teki logika, atau tanya jawab multi-hop diuntungkan dari pendekatan ini adalah karena tugas-tugas tersebut secara alami memang memerlukan beberapa langkah penalaran.
Proses penalaran langkah demi langkah bersifat transparan, memungkinkan pengguna memahami bagaimana model sampai pada kesimpulannya. Transparansi ini membangun kepercayaan pada output model.
Ini juga dapat membantu dalam debugging karena pengguna lebih mudah menemukan di mana model mungkin keliru dalam menalar.
Tentu saja, seperti teknik apa pun, selalu ada beberapa kekurangan yang perlu dipertimbangkan:
Penting untuk dipertimbangkan bahwa CoT adalah teknik yang bergantung pada model. Oleh karena itu, efektivitas CoT prompting sangat bergantung pada kemampuan model bahasa yang mendasarinya.
Menyusun prompt CoT yang efektif juga bisa menantang. Diperlukan perancangan yang cermat untuk memastikan prompt membimbing model dengan benar melalui proses penalaran. Memperbarui dan memelihara prompt untuk berbagai jenis tugas dan domain bisa memakan waktu dan mungkin memerlukan penyempurnaan terus-menerus.
CoT prompting mungkin tidak seefektif untuk tugas yang tidak memiliki proses penalaran berurutan yang jelas. Selain itu, ia mungkin tidak menggeneralisasi dengan baik pada jenis masalah yang benar-benar baru atau tak terduga tanpa pelatihan atau adaptasi tambahan, sehingga mempertahankan basis pengetahuan yang mutakhir dan prompt yang sesuai menjadi krusial.
Walaupun CoT prompting meningkatkan interpretabilitas dengan menyediakan penjelasan langkah demi langkah, ia juga dapat menghasilkan output yang lebih panjang dan bertele-tele, yang mungkin tidak selalu diinginkan untuk semua aplikasi.
Dalam artikel ini, kita telah melihat bagaimana Chain-of-Thought prompting merepresentasikan kemajuan signifikan dalam meningkatkan kemampuan penalaran Large Language Models, beserta beberapa contoh praktis implementasinya.
Baik menggunakan templat prompt, prompting interaktif, maupun feedback loop, gagasan di balik pendekatan ini adalah membimbing model melalui proses penalaran dan memanfaatkan kemampuannya.
Selain itu, kita telah mengeksplorasi teknik-teknik kuat seperti one-shot dan few-shot prompting yang semakin meningkatkan performa model dan dapat dikombinasikan dengan CoT, beserta manfaat dan beberapa keterbatasan yang tidak boleh diabaikan.
Pertimbangkan untuk mencoba teknik-teknik yang dibahas dalam artikel ini untuk membangun prompt yang lebih andal dan berkinerja tinggi, dan ingat: Prompt Engineering dapat berdampak besar pada output Anda!
Anda dapat mempelajari lebih lanjut tentang prompt engineering melalui kursus DataCamp, Understanding Prompt Engineering dan ChatGPT Prompt Engineering for Developers. Anda juga dapat melihat panduan terpisah untuk sertifikasi prompt engineering dan mengetahui jalur belajar terbaik bagi Anda.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



