
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
52K
Large Language Models (LLM’s) genereren tekst met een techniek genaamd autoregressie, waarbij het meest waarschijnlijke volgende woord in een reeks wordt voorspeld op basis van de voorgaande woorden. Door LLM aangestuurde agents zoals ChatGPT zijn ook fijn-afgesteld om de gebruikersintentie te volgen. Ze vullen daarom niet alleen de invoerreeks aan, maar vangen ook de bedoeling van de gebruiker en genereren daarop een passend antwoord.
Als je al even met ChatGPT hebt gewerkt, heb je vast gemerkt dat de kwaliteit van een antwoord ook afhangt van de kwaliteit van de gebruikersinvoer; de agent geeft bijvoorbeeld “betere” reacties op bepaalde vragen dan op andere.
Het geheim om het best mogelijke antwoord te krijgen, is begrijpen hoe LLM’s de output genereren en je prompt daar vervolgens op afstemmen. De set aan technieken die je op de gebruikersinvoer toepast om het volledige potentieel van het model te benutten, staat bekend als Prompt Engineering.
In dit artikel bekijken we een van de krachtigste Prompt Engineering-technieken: Chain-of-Thought (CoT) prompting. Deze techniek houdt in dat je de prompt zó structureert dat het voor het model makkelijker wordt om complexe taken uit te voeren die redeneren of probleemoplossing vereisen. Er is aangetoond dat hetzelfde model zonder CoT niet tot het juiste antwoord komt.
Hoewel LLM’s bekendstaan om hun vermogen te generaliseren, hangen de mogelijkheden van een model af van de taak. Houd er bij het gebruik van LLM’s rekening mee dat elk model is getraind op een enorme maar toch beperkte dataset en geoptimaliseerd is voor bepaalde taken. Een model kan dus zeer goed presteren in sommige domeinen, maar tekortschieten in andere.
De capaciteiten van een model hangen ook samen met timing. Net als bij mensen: geef je me een som met 5 cijfers, dan heb ik even tijd nodig om na te denken en met het juiste antwoord te komen. Als je het gehaast doet, reken je al snel verkeerd en faal je in je antwoord.
Op dezelfde manier kan een taalmodel falen als je het een taak geeft die te complex is om op te lossen in de tijd die het heeft om zijn volgende token te berekenen.
Maar net als bij mensen betekent dat niet per se dat het model de taak niet aankan. Met wat tijd of begeleiding om te redeneren, kan het model alsnog betrouwbaar antwoorden.
De respons van het model en de benodigde tijd om die te genereren, kunnen ook worden beïnvloed door verschillende factoren, zoals de specifieke formulering van de vraag:
Chain-of-Thought prompting helpt LLM’s om complexe taken tot een goed einde te brengen, zowel door de formulering van de prompt als door het model de benodigde tijd of stappen te geven om tot het juiste antwoord te komen.
Chain-of-Thought prompting is een techniek die de prestaties van taalmodellen verbetert door het model expliciet te vragen eerst een stapsgewijze uitleg of redeneerlijn te genereren voordat het een eindantwoord geeft. Deze methode helpt het model om het probleem op te delen en geen tussenstappen over te slaan, zodat redeneringsfouten worden voorkomen.
CoT werkt goed omdat het helpt de aandacht van het LLM te richten. Door de redeneerstappen op te delen, kan het model zich steeds op één deel van het probleem concentreren, waardoor de kans op fouten door te veel informatie tegelijk kleiner wordt.
Onderzoekers bij Google introduceerden Chain-of-Thought prompting in 2022 in het paper “Chain of Thought Prompting Elicits Reasoning in Large Language Models”. Dit onderzoek liet zien dat het begeleiden van een model via een reeks tussenliggende redeneerstappen de prestaties aanzienlijk verbeterde bij taken zoals wiskundige probleemoplossing, logisch redeneren en multi-hop vraagbeantwoording.
Laten we een van de voorgestelde voorbeelden bekijken:
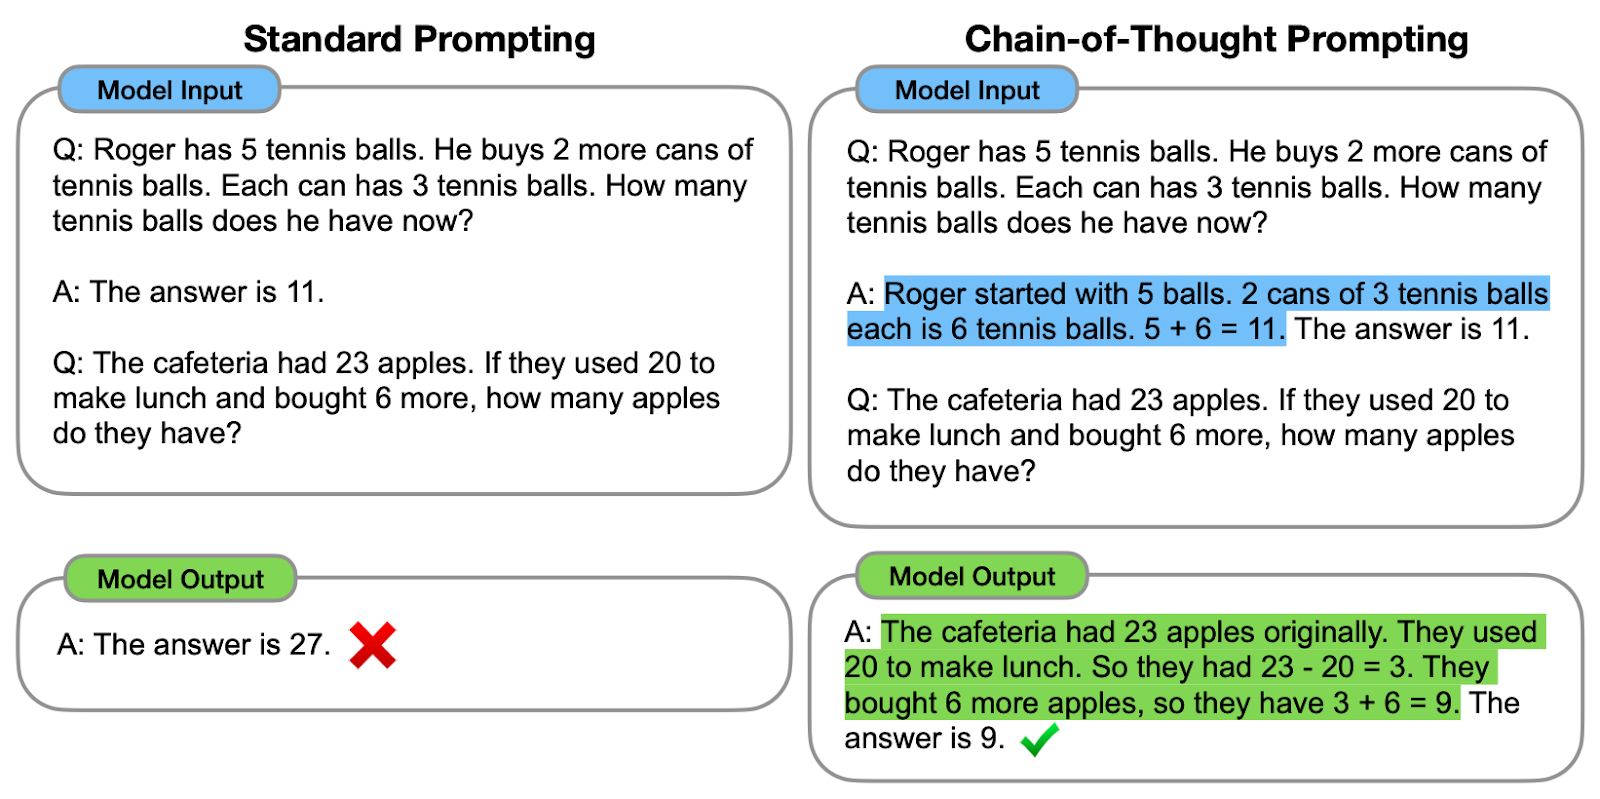
Vergelijking tussen standaard prompting en CoT prompting. Links wordt het model opgedragen om direct het eindantwoord te geven (standaard prompting). Rechts wordt het model gevraagd om het redeneerproces te tonen om tot het eindantwoord te komen (CoT prompting).
Zoals we zien, helpt het genereren van een chain of thought — een reeks tussenliggende redeneerstappen — het model om het juiste antwoord te geven.
De oorspronkelijke auteurs beschrijven de chain of thought als de reeks tussenliggende redeneerstappen in natuurlijke taal die tot de uiteindelijke output leidt, en noemen deze aanpak Chain-of-Thought prompting.
Het proces begint met het opstellen van prompts die het model aanmoedigen om stap voor stap over het probleem na te denken, zodat de tussenstappen worden gegenereerd in plaats van meteen naar het eindantwoord te springen. Dat kan op verschillende manieren:
Expliciete instructies geven betekent dat je het probleem in de prompt zelf opdeelt. Bijvoorbeeld door zinnen te gebruiken als “Eerst moeten we overwegen…” om het model aan te zetten zijn denkstappen te beschrijven.
Laten we het in actie zien!
Stel, mijn Spaanse moeder heeft me het familierecept gestuurd voor Cold Brew:
input_text = """
¡Preparar café Cold Brew es un proceso sencillo y refrescante!
Todo lo que necesitas son granos de café molido grueso y agua fría.
Comienza añadiendo el café molido a un recipiente o jarra grande.
Luego, vierte agua fría, asegurándote de que todos los granos de café
estén completamente sumergidos.
Remueve la mezcla suavemente para garantizar una saturación uniforme.
Cubre el recipiente y déjalo en remojo en el refrigerador durante al
menos 12 a 24 horas, dependiendo de la fuerza deseada.
"""
Stel dat we alle koffiegerelateerde woorden naar het Engels willen vertalen en ChatGPT voor deze taak willen gebruiken:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Dit is de reactie op deze prompt:
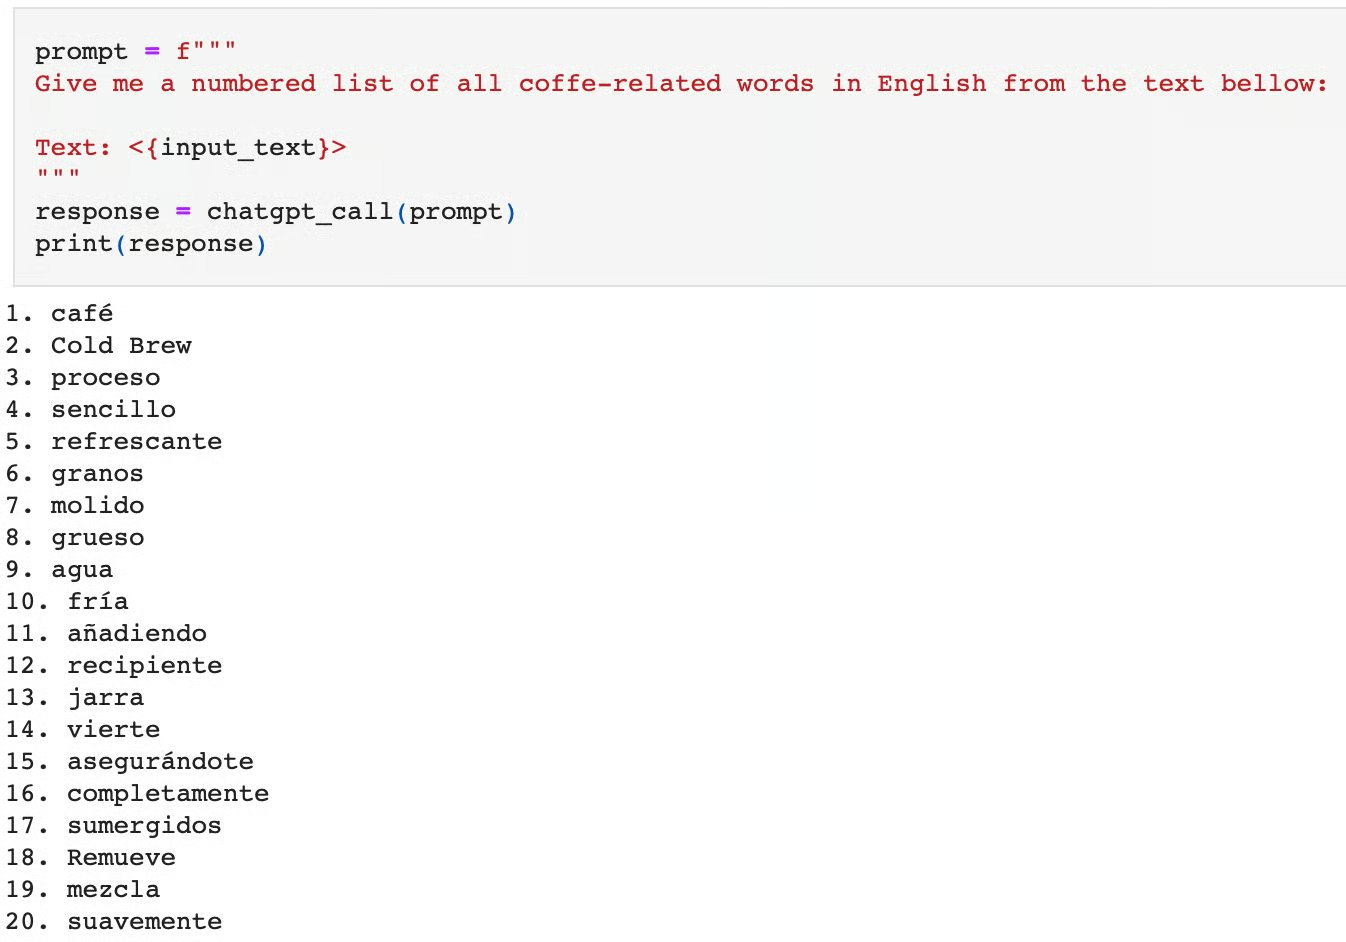
Als we het model vragen deze taak direct uit te voeren, zien we dat het de taak verkeerd uitvoert. Het geeft niet alleen woorden die niets met koffie te maken hebben, maar doet dat ook nog eens in het Spaans in plaats van in het Engels.
We kunnen dit beschouwen als een complexe taak, omdat er twee stappen nodig zijn:
In plaats daarvan springt het model direct naar de eindtaak van het identificeren van koffiegerelateerde woorden, en slaat het de vertaling over. Door de vertaling als tussenstap te specificeren of de taak in de twee hoofdtaken op te delen, kunnen we het model naar de juiste output sturen:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
The task requires the following actions:
1 - Translate the given text into English.
2 - List each coffee-related word from the English text.
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Door de Chain-of-Thought hierboven op te nemen, komen we tot het juiste antwoord:
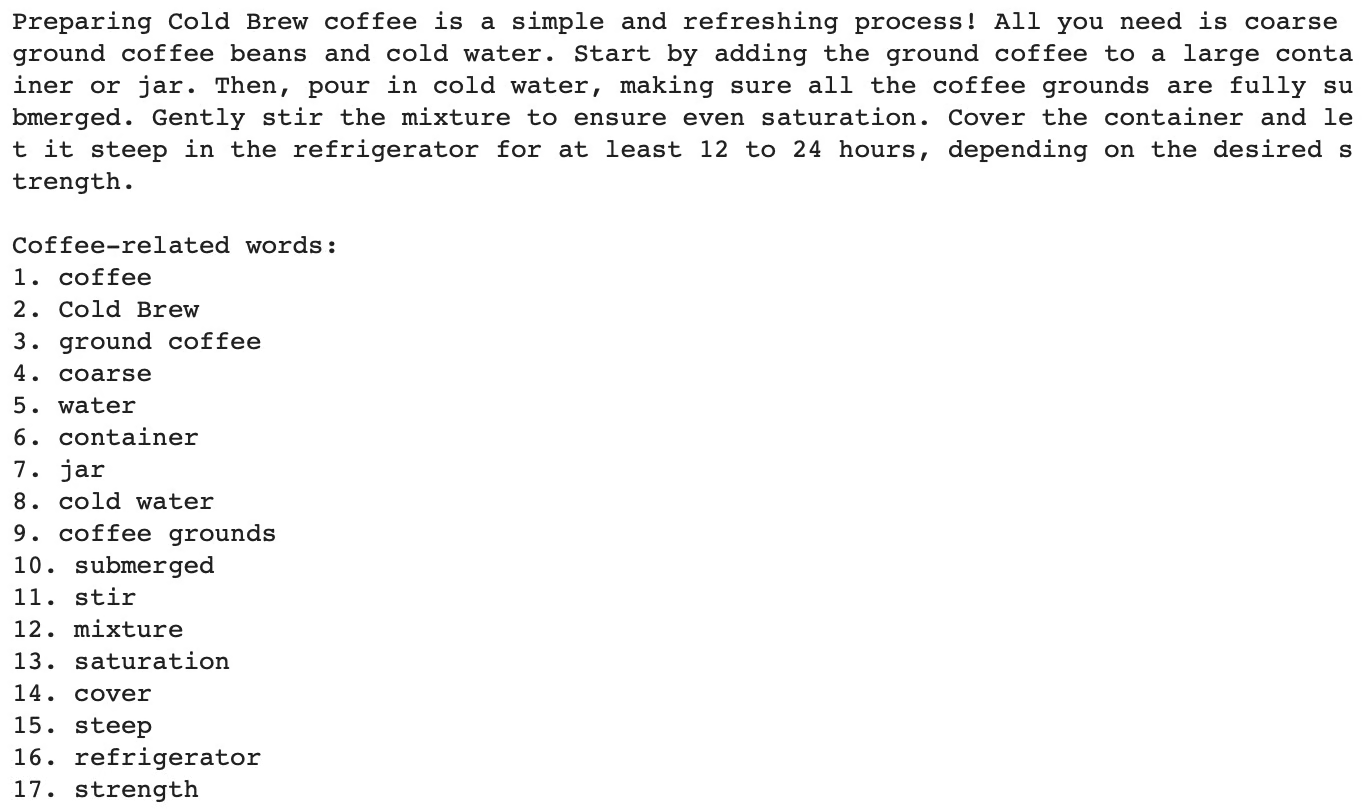
Wil je deze techniek uitproberen met andere LLM’s dan ChatGPT of de OpenAI API, zoals in dit artikel? Dan is de cursus “Developing Large Language Models” iets voor jou!
Soms is het niet nodig om het probleem in de prompt zelf op te delen. De Universiteit van Tokio, samen met Google Research, stelde een eenvoudige methode voor om LLM-antwoorden te verbeteren: voeg simpelweg “Let’s think step by step" toe aan het einde van de oorspronkelijke prompt.
Deze eenvoudige zin zet het model ertoe aan hardop te redeneren en alle noodzakelijke stappen te doorlopen om de taak uit te voeren.
Laten we een van de voorbeelden analyseren die de auteurs voorstelden in het oorspronkelijke paper “Large Language Models are Zero-Shot Reasoners”:
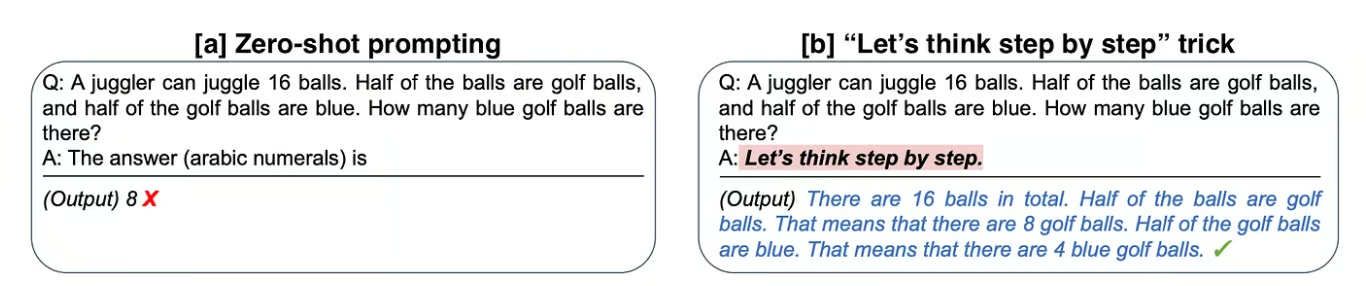
Vergelijking tussen standaard prompting en het gebruik van impliciete CoT-instructies. Links geeft het model meteen het eindantwoord (zero-shot prompting) en faalt. Rechts wordt het model aangestuurd met een impliciete CoT-instructie (CoT prompting) en komt het tot het juiste antwoord.
[a] In het eerste voorbeeld vragen de auteurs het model een rekenopgave op te lossen, maar dat mislukt.
[b] Door vervolgens “Let’s think step by step” aan de oorspronkelijke vraag toe te voegen, redeneert het model zijn antwoord hardop en slaagt het.
Door deze eenvoudige truc toe te passen op de MultiArith-wiskundeset, ontdekten de auteurs dat deze impliciete instructie de nauwkeurigheid verviervoudigde van 18% naar 79%!
Als je geïnteresseerd bent, lees dan meer over deze techniek in “Use This Short Prompt to Boost ChatGPT’s Outcome.”
We hebben hierboven meerdere keren de term “zero-shot” gebruikt. Zero-shot verwijst naar het vermogen van een model om een taak uit te voeren zonder expliciet te zijn getraind op voorbeelden van die specifieke taak.
Het leunt op het vermogen van het model om te generaliseren en passende reacties te genereren op nieuwe en niet eerder geziene taken. Dat betekent dat wanneer we de gebruikersinterface van ChatGPT openen en direct een vraag stellen, we zero-shot prompting doen.
Toch zijn er manieren om het model meerdere voorbeelden te tonen van soortgelijke taken die we willen oplossen. Het aanbieden van een reeks demonstratieve voorbeelden heet one-shot en few-shot prompting, afhankelijk van het aantal gegeven voorbeelden.
One-shot prompting houdt in dat je het model één voorbeeld laat zien dat lijkt op de doeltaak, als leidraad.
Als we terugkijken naar de eerste figuur in het artikel, zien we dat het model de Chain-of-Thought genereert dankzij het demonstratieve voorbeeld in de prompt.
Few-shot werkt hetzelfde als one-shot, maar het aantal gegeven voorbeelden is groter, meestal rond de honderd. De prestaties van het model nemen lineair toe met het aantal voorbeelden.
Few-shot prompting werd bestudeerd door Jason Wei en Denny Zhou et al. van Google. Deze aanpak is vooral nuttig voor taken die meer gespecialiseerde of domeinspecifieke kennis vereisen, waarbij het model mogelijk niet genoeg achtergrondkennis heeft om de taak met zero-shot of one-shot prompting uit te voeren. Few-shot prompting wordt soms gezien als een kleine fine-tuning van het model op een verzameling nieuwe of speciale data.
Bekijk meer voorbeelden van one-shot en few-shot prompting in “Improve ChatGPT Performance with Prompt Engineering.”
One-shot en few-shot prompting zijn op zichzelf geen CoT. Onderzoekers hebben echter onderzocht hoe few-shot learning kan worden gecombineerd met CoT prompting, bekend als “Few-shot CoT prompting.” In een few-shot CoT krijgt het model enkele voorbeeldproblemen met hun stap-voor-stapoplossingen om het redeneerproces te sturen.
Het combineren van few-shot CoT prompting met andere technieken, zoals retrieval-augmented generation of interactieve bevraging, kan de prestaties en betrouwbaarheid van het model verder verbeteren. Het integreren van externe kennisbanken, databases of informatiesystemen stelt het model in staat zijn redenering te verrijken met feitelijke en actuele informatie.
Doolhof van wiskundige problemen om te illustreren hoe CoT modellen kan helpen door de kennisspace te navigeren en complexe taken op te lossen. Zelfgegenereerde afbeelding met ChatGPT 4o-beeldgeneratie met de prompt “Imagine a Language Model agent through a maze of mathematical problems”.
Er zijn meerdere manieren om CoT in je prompts op te nemen:
Er zijn meerdere frameworks die je helpen CoT en andere Prompt Engineering-technieken te implementeren, maar LangChain is mijn favoriet. Ben je van plan LangChain te gebruiken in je LLM-projecten, dan is de cursus “Developing LLM Applications with LangChain” een ideaal startpunt.
Chain-of-Thought prompting biedt verschillende voordelen, vooral bij het verbeteren van de prestaties en betrouwbaarheid van taalmodellen bij complexe taken.
Door een probleem op te delen in kleinere, behapbare stappen kan het model complexe taken nauwkeuriger afhandelen. Tussenstappen bieden controlepunten waar potentiële fouten kunnen worden opgemerkt en gecorrigeerd, wat leidt tot nauwkeurigere eindantwoorden.
Taken zoals wiskundige problemen, logische puzzels of multi-hop vraagbeantwoording profiteren van deze aanpak omdat ze van nature meerdere redeneerstappen vereisen.
Het stapsgewijze redeneerproces is transparant, waardoor gebruikers begrijpen hoe het model tot zijn conclusie is gekomen. Deze transparantie vergroot het vertrouwen in de output van het model.
Het kan ook helpen bij debuggen, omdat gebruikers makkelijker kunnen zien waar het model in zijn redenering is misgegaan.
Zoals bij elke techniek zijn er ook nadelen om rekening mee te houden:
Het is belangrijk te beseffen dat CoT een modelafhankelijke techniek is. De effectiviteit van CoT prompting hangt dus sterk af van de capaciteiten van het onderliggende taalmodel.
Effectieve CoT-prompts opstellen kan ook uitdagend zijn. Het vereist zorgvuldige vormgeving om ervoor te zorgen dat de prompts het model op de juiste manier door het redeneerproces leiden. Prompts up-to-date houden en onderhouden voor verschillende soorten taken en domeinen kan tijdrovend zijn en voortdurend fijnslijpen vereisen.
CoT prompting is mogelijk minder effectief voor taken die geen duidelijk sequentieel redeneerproces hebben. Bovendien generaliseert het mogelijk niet goed naar volledig nieuwe of onverwachte probleemtypes zonder extra training of aanpassing, dus het onderhouden van een actuele kennisbasis en geschikte prompts is cruciaal.
Hoewel CoT prompting de uitlegbaarheid vergroot door stapsgewijze verklaringen te geven, kan het ook leiden tot langere en breedsprakigere outputs, wat niet altijd wenselijk is voor elke toepassing.
In dit artikel hebben we gezien hoe Chain-of-Thought prompting een aanzienlijke stap voorwaarts is in het versterken van de redeneercapaciteiten van Large Language Models, met enkele praktische voorbeelden van de implementatie.
Of je nu prompttemplates, interactieve prompting of feedbackloops gebruikt, het idee achter deze benaderingen is om het model door het redeneerproces te leiden en zijn capaciteiten te benutten.
Daarnaast hebben we krachtige technieken verkend zoals one-shot en few-shot prompting, die de prestaties van het model verder verbeteren en gecombineerd kunnen worden met CoT, evenals de voordelen en enkele beperkingen die we niet mogen negeren.
Probeer de technieken uit dit artikel om betrouwbaardere, beter presterende prompts te bouwen en onthoud: Prompt Engineering kan een grote impact hebben op je outputs!
Je kunt meer leren over prompt engineering via DataCamp-cursussen, Understanding Prompt Engineering en ChatGPT Prompt Engineering for Developers. Je kunt ook een aparte gids bekijken over certificering in prompt engineering en ontdekken welke leerpaden het beste bij je passen.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

