
Corso
Sviluppare applicazioni LLM con LangChain
3 ore
52K
I Large Language Model (LLM) generano testo usando una tecnica chiamata autoregressione, che consiste nel prevedere la parola successiva più probabile in una sequenza in base alle parole precedenti. Agenti alimentati da LLM come ChatGPT sono anche perfezionati per seguire l’intento dell’utente. Perciò non solo completano la sequenza di input, ma colgono anche l’intenzione dell’utente e generano una risposta di conseguenza.
Se hai provato ChatGPT per un po’, avrai sicuramente notato che la qualità di una risposta dipende anche dalla qualità dell’input dell’utente, ad esempio l’agente fornisce risposte “migliori” ad alcune richieste rispetto ad altre.
Il segreto per ottenere la migliore risposta possibile è capire come gli LLM generano l’output e formulare l’input di conseguenza. L’insieme delle tecniche applicate all’input dell’utente per sfruttare al massimo il potenziale del modello è noto come Prompt Engineering.
In questo articolo, esploreremo una delle tecniche di Prompt Engineering più potenti: il prompting Chain-of-Thought (CoT). Questa tecnica prevede di strutturare il prompt in modo da rendere più semplice per il modello completare compiti complessi che richiedono ragionamento o problem solving. È stato dimostrato che, senza CoT, lo stesso modello non riesce a fornire la risposta corretta.
Sebbene gli LLM siano noti per la loro capacità di generalizzare, le capacità del modello dipendono dal compito. Quando si usano gli LLM, è importante considerare che ogni modello è stato addestrato su un database enorme ma limitato, ed è stato ottimizzato per determinati compiti. Quindi, mentre il modello può essere altamente performante in alcuni ambiti, può fallire in altri.
Le capacità del modello dipendono anche dal fattore tempo. Come per gli esseri umani: se mi dai una somma a 5 cifre, avrò bisogno di un po’ di tempo per pensarci e rispondere con il risultato corretto. Se lo faccio di fretta, potrei sbagliare facilmente e fallire nella risposta.
Allo stesso modo, se affidiamo a un modello linguistico un compito troppo complesso per il tempo necessario a calcolare il suo prossimo token, potrebbe non fornire la risposta corretta.
Eppure, proprio come gli umani, ciò non significa necessariamente che il modello sia incapace del compito. Con un po’ di tempo o con una guida per ragionare, il modello potrebbe comunque riuscire a rispondere in modo affidabile.
La risposta del modello e il tempo necessario per generarla possono essere influenzati anche da vari fattori, come la formulazione specifica della domanda:
Il prompting Chain-of-Thought guida gli LLM a risolvere con successo compiti complessi sia scegliendo come formulare il prompt, sia fornendo al modello il tempo o i passaggi necessari per generare la risposta corretta.
Il prompting Chain-of-Thought è una tecnica che migliora le prestazioni dei modelli linguistici sollecitando esplicitamente il modello a generare una spiegazione passo dopo passo o un processo di ragionamento prima di arrivare alla risposta finale. Questo metodo aiuta il modello a scomporre il problema e a non saltare compiti intermedi, evitando errori di ragionamento.
Il CoT è efficace perché aiuta a focalizzare il meccanismo di attenzione dell’LLM. La scomposizione del processo di ragionamento fa sì che il modello concentri l’attenzione su una parte del problema alla volta, riducendo al minimo il rischio di errori che potrebbero derivare dalla gestione simultanea di troppe informazioni.
I ricercatori di Google hanno introdotto il prompting Chain-of-Thought in un articolo del 2022 intitolato “Chain of Thought Prompting Elicits Reasoning in Large Language Models”. Questa ricerca ha evidenziato come guidare un modello attraverso una serie di passaggi intermedi di ragionamento migliori significativamente le sue prestazioni in compiti come la risoluzione di problemi matematici, il ragionamento logico e le domande multi-hop.
Vediamo uno degli esempi proposti:
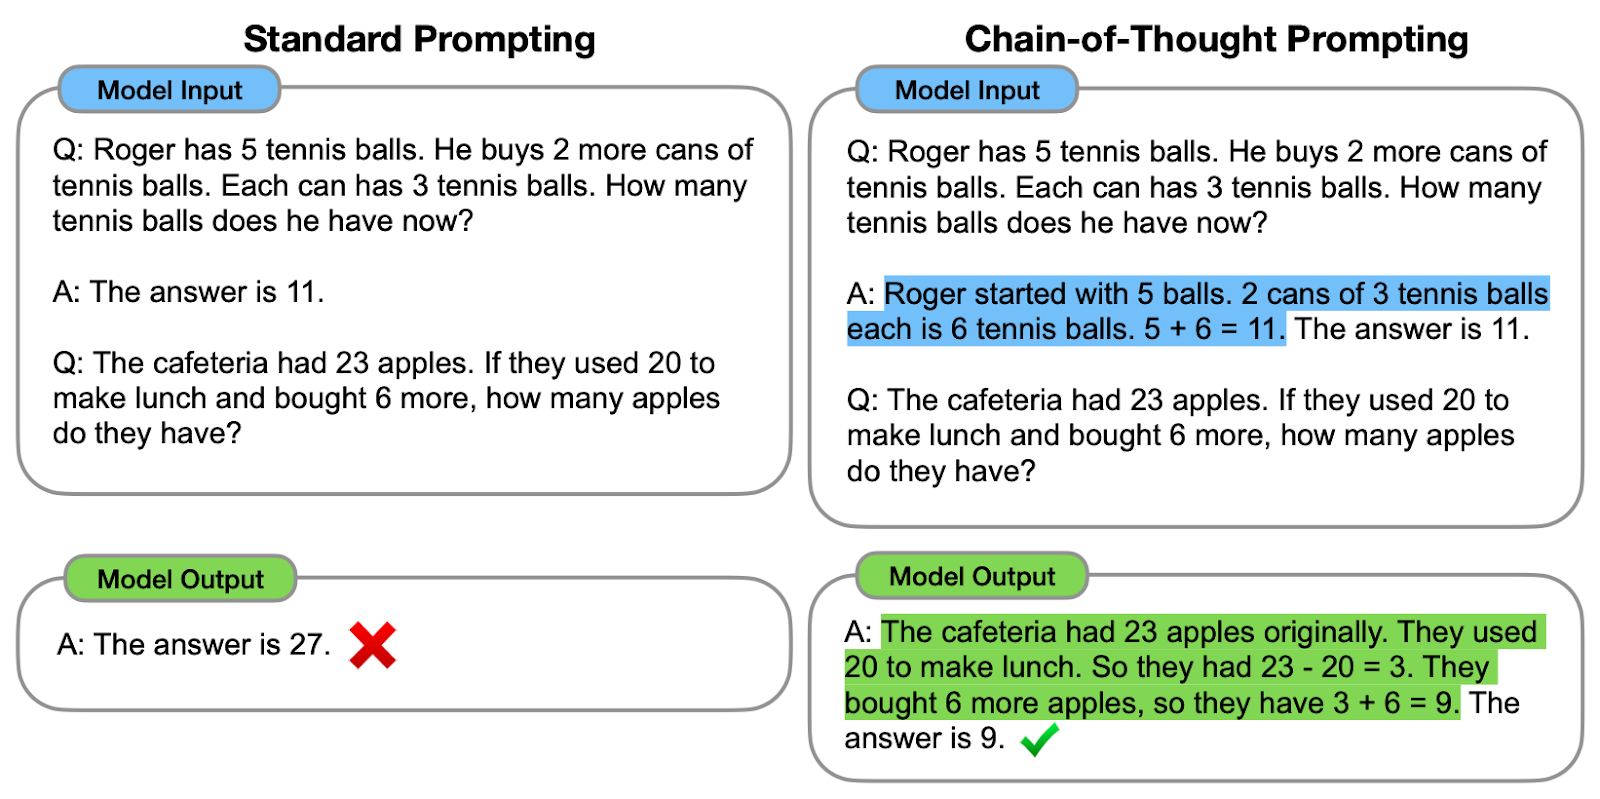
Confronto tra prompting standard e prompting CoT. A sinistra, al modello viene chiesto di fornire direttamente la risposta finale (prompting standard). A destra, al modello viene chiesto di mostrare il processo di ragionamento per arrivare alla risposta finale (prompting CoT).
Come possiamo osservare, generare una catena di pensiero — una serie di passaggi intermedi di ragionamento — aiuta il modello a fornire la risposta corretta.
Gli autori originali si riferiscono alla chain of thought come alla serie di passaggi di ragionamento in linguaggio naturale che portano all’output finale, chiamando questo approccio prompting Chain-of-Thought.
Il processo inizia creando prompt che incoraggino il modello a riflettere sul problema in modo graduale, generando quindi i passaggi intermedi senza saltare direttamente alla risposta finale. Questo può essere fatto con diverse strategie:
Dare istruzioni esplicite significa scomporre il problema direttamente nel prompt dell’utente. Per esempio, usando frasi come “Per prima cosa dobbiamo considerare…” per spingere il modello a dettagliare il proprio processo di pensiero.
Vediamolo in azione!
Immagina che mia madre spagnola mi abbia inviato la ricetta di famiglia per preparare il Cold Brew:
input_text = """
¡Preparar café Cold Brew es un proceso sencillo y refrescante!
Todo lo que necesitas son granos de café molido grueso y agua fría.
Comienza añadiendo el café molido a un recipiente o jarra grande.
Luego, vierte agua fría, asegurándote de que todos los granos de café
estén completamente sumergidos.
Remueve la mezcla suavemente para garantizar una saturación uniforme.
Cubre el recipiente y déjalo en remojo en el refrigerador durante al
menos 12 a 24 horas, dependiendo de la fuerza deseada.
"""
Diciamo che ci interessa tradurre tutte le parole legate al caffè in inglese e vogliamo usare ChatGPT per il compito:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Ecco la risposta a questo prompt:
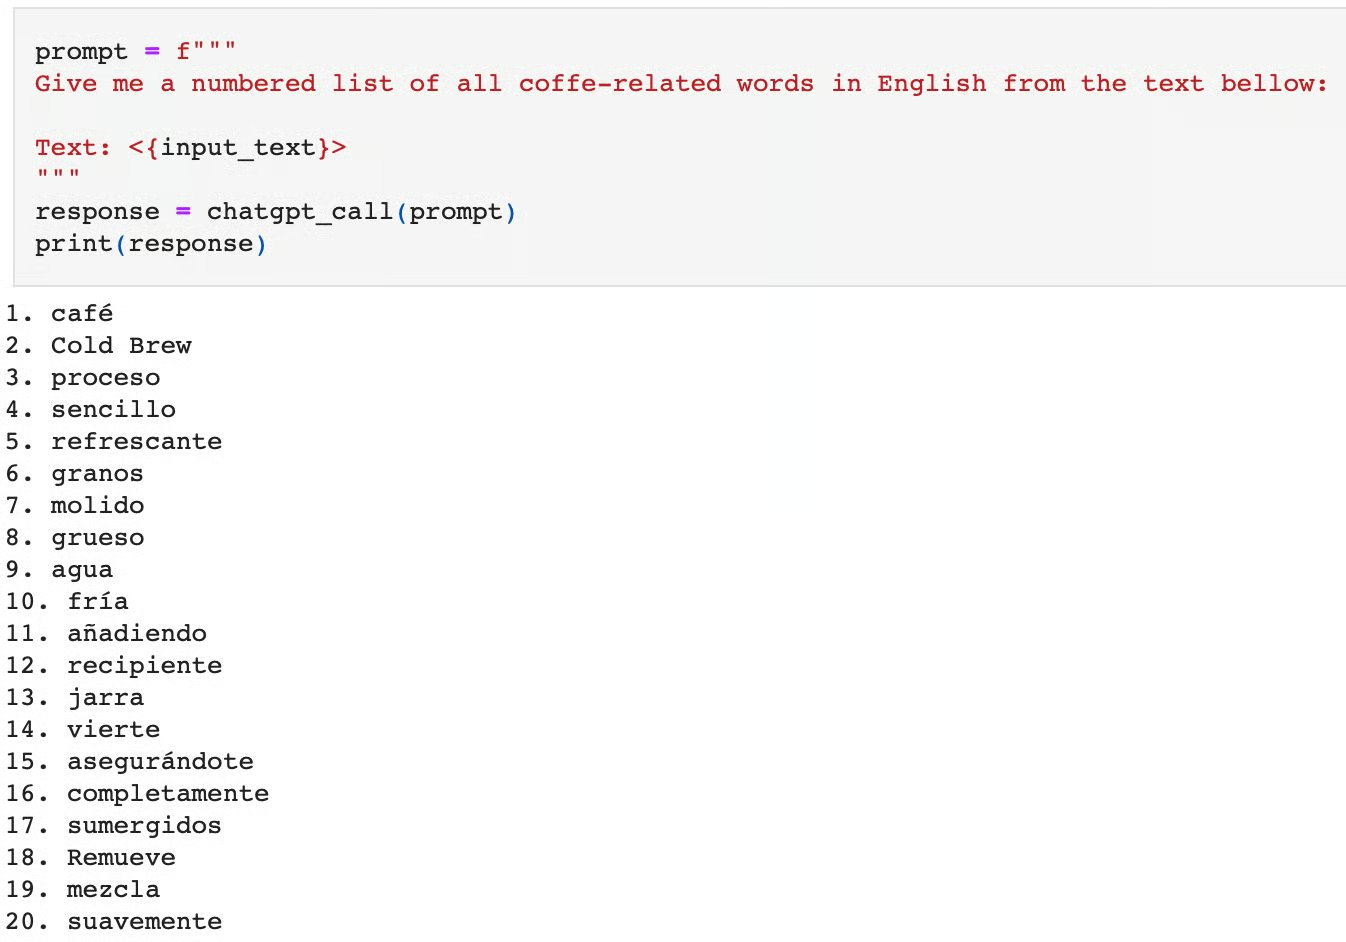
Se chiediamo al modello di svolgere subito questo compito, vediamo che lo esegue in modo errato. Non solo restituisce parole non legate al caffè, ma le produce anche in spagnolo, non in inglese.
Potremmo considerare questo compito complesso perché richiede due passaggi:
Invece, il modello salta direttamente al compito finale di identificare le parole legate al caffè, tralasciando la traduzione. Specificando la traduzione come passaggio intermedio o scomponendo il compito nei due passaggi principali, possiamo guidare il modello verso l’output corretto:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
The task requires the following actions:
1 - Translate the given text into English.
2 - List each coffee-related word from the English text.
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Includere la Chain-of-Thought sopra porta alla risposta corretta:
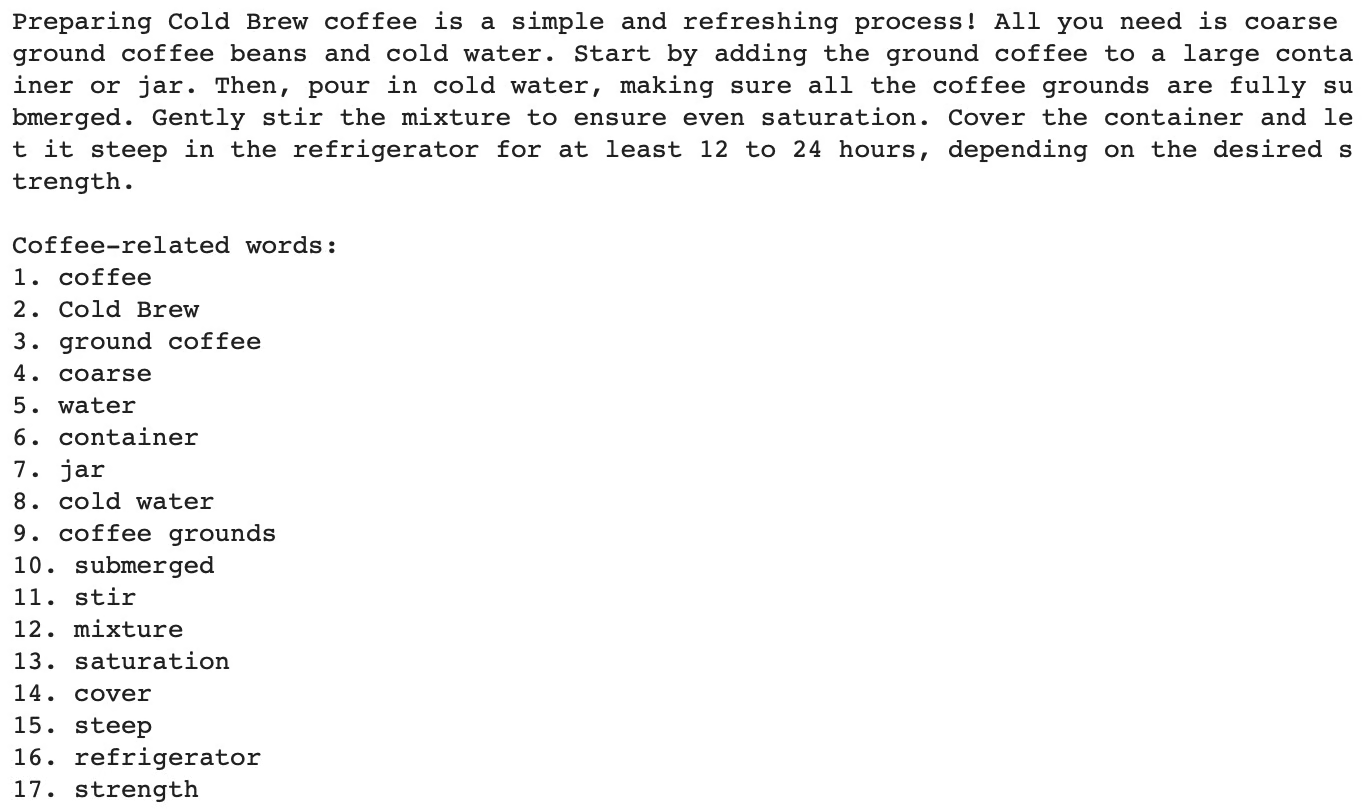
Se ti interessa provare questa tecnica con altri LLM invece di ChatGPT o dell’API di OpenAI, come in questo articolo, il corso “Developing Large Language Models” fa per te!
A volte non è necessario scomporre noi stessi il problema nel prompt. L’Università di Tokyo, insieme a Google Research, ha proposto un metodo semplice per migliorare le risposte degli LLM che consisteva semplicemente nell’aggiungere “Let’s think step by step" alla fine del prompt originale.
Questa semplice frase spinge il modello a ragionare ad alta voce e a percorrere tutti i passaggi necessari per svolgere il compito.
Analizziamo uno degli esempi proposti dagli autori nell’articolo originale “Large Language Models are Zero-Shot Reasoners”:
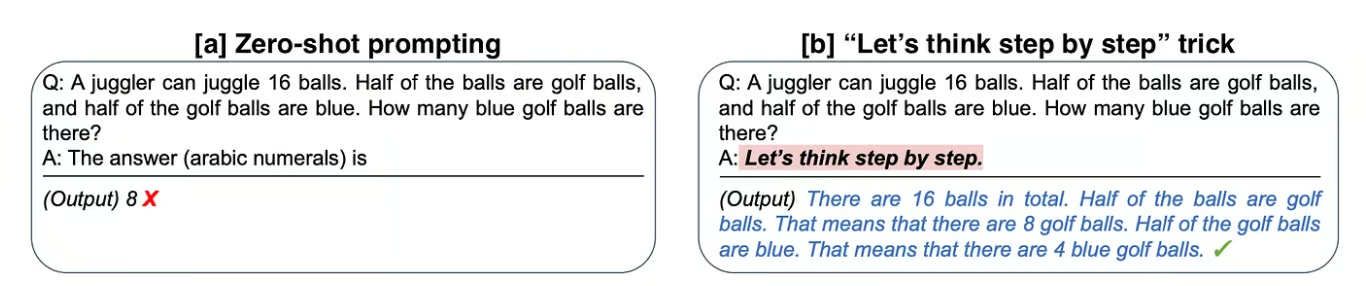
Confronto tra prompting standard e uso di istruzioni CoT implicite. A sinistra, il modello fornisce subito la risposta finale al problema (zero-shot prompting) e fallisce. A destra, il modello è istruito con una indicazione CoT implicita (prompting CoT) e arriva alla risposta corretta.
[a] Nel primo esempio, gli autori chiedono al modello di risolvere un problema aritmetico, ma fallisce in questo compito.
[b] Poi, aggiungendo “Let’s think step by step” alla domanda originale, il modello ragiona ad alta voce sulla risposta e ha successo.
Applicando questo semplice trucco al dataset matematico MultiArith, gli autori hanno scoperto che questa istruzione implicita quadruplicava l’accuratezza dal 18% al 79%!
Se ti interessa, puoi leggere di più su questa tecnica in “Use This Short Prompt to Boost ChatGPT’s Outcome”.
Abbiamo usato più volte il termine “zero-shot” nella sezione sopra. Zero-shot si riferisce alla capacità di un modello di eseguire un compito senza essere stato esplicitamente addestrato su esempi di quel compito specifico.
Si basa sulla capacità del modello di generalizzare e generare risposte appropriate a compiti nuovi e mai visti. Ciò significa che quando apriamo l’interfaccia di ChatGPT e poniamo subito una domanda, stiamo facendo zero-shot prompting.
Tuttavia, esistono modi per mostrare al modello diversi esempi di compiti simili a quello che vogliamo risolvere. Fornire una serie di esempi dimostrativi è noto come one-shot e few-shot prompting, a seconda del numero di esempi forniti.
Il one-shot prompting prevede di mostrare al modello un solo esempio simile al compito target come guida.
Per esempio, tornando alla prima figura dell’articolo, possiamo osservare che il modello genera la Chain-of-Thought grazie all’esempio dimostrativo fornito nel prompt.
Il few-shot learning funziona come il one-shot, ma il numero di esempi forniti è maggiore, tipicamente intorno a un centinaio. Le prestazioni del modello aumentano linearmente con il numero di esempi.
Il few-shot prompting è stato studiato da Jason Wei e Denny Zhou et al. di Google. Questo approccio è particolarmente utile per compiti che richiedono conoscenze più specialistiche o specifiche di dominio, dove il modello potrebbe non avere conoscenze di base sufficienti per eseguire il compito con zero-shot o one-shot prompting. Il few-shot prompting è talvolta visto come un piccolo fine-tuning del modello su una collezione di dati nuovi o speciali.
Vedi altri esempi di one-shot e few-shot prompting in “Improve ChatGPT Performance with Prompt Engineering”.
One-shot e few-shot prompting non sono CoT. Tuttavia, i ricercatori hanno esplorato come il few-shot learning possa essere combinato con il prompting CoT, noto come “Few-shot CoT prompting”. In un few-shot CoT, al modello vengono forniti alcuni esempi di problemi insieme alle loro soluzioni passo passo per guidarne il processo di ragionamento.
Combinare il few-shot CoT prompting con altre tecniche, come la retrieval-augmented generation o le interrogazioni interattive, può migliorare ulteriormente le prestazioni e l’affidabilità del modello. L’integrazione di knowledge base esterne, database o sistemi di information retrieval consente al modello di arricchire il ragionamento con informazioni fattuali e aggiornate.
Labirinto di problemi matematici per illustrare come il CoT possa aiutare i modelli a orientarsi nello spazio della conoscenza e risolvere compiti complessi. Immagine autogenerata con la generazione di immagini di ChatGPT 4o con il seguente prompt “Imagine a Language Model agent through a maze of mathematical problems”.
Ci sono diversi modi per includere il CoT nei nostri prompt:
Esistono vari framework che possono aiutarti a implementare CoT e altre tecniche di Prompt Engineering, ma LangChain è il mio preferito. Se ti interessa usare LangChain nei tuoi progetti basati su LLM, il corso “Developing LLM Applications with LangChain” è un ottimo punto di partenza.
Il prompting Chain-of-Thought offre diversi vantaggi, in particolare nel migliorare le prestazioni e l’affidabilità dei modelli linguistici in compiti complessi.
Scomponendo un problema in passaggi più piccoli e gestibili, il modello può affrontare compiti complessi con maggiore accuratezza. I passaggi intermedi forniscono checkpoint in cui è possibile individuare e correggere potenziali errori, portando a risposte finali più corrette.
Il motivo per cui compiti come problemi matematici, rompicapi logici o domande multi-hop traggono beneficio da questo approccio è che richiedono già naturalmente più passaggi di ragionamento.
Il processo di ragionamento passo dopo passo è trasparente, consentendo agli utenti di capire come il modello è arrivato alla sua conclusione. Questa trasparenza aumenta la fiducia negli output del modello.
Può anche aiutare nel debugging poiché gli utenti possono individuare più facilmente dove il modello potrebbe aver sbagliato nel suo ragionamento.
Ovviamente, come per qualsiasi tecnica, ci sono alcuni aspetti negativi da considerare:
È importante considerare che il CoT è una tecnica dipendente dal modello. Pertanto, l’efficacia del prompting CoT dipende in gran parte dalle capacità del modello linguistico sottostante.
Progettare prompt CoT efficaci può essere impegnativo. Richiede una progettazione attenta per garantire che i prompt guidino correttamente il modello attraverso il processo di ragionamento. Aggiornare e mantenere i prompt per diversi tipi di compiti e domini può richiedere tempo e potrebbe richiedere un perfezionamento costante.
Il prompting CoT potrebbe non essere altrettanto efficace per compiti che non hanno un chiaro processo di ragionamento sequenziale. Inoltre, potrebbe non generalizzare bene a tipi di problemi completamente nuovi o inaspettati senza ulteriore addestramento o adattamento, quindi mantenere una knowledge base aggiornata e prompt adeguati è cruciale.
Sebbene il prompting CoT aumenti l’interpretabilità fornendo spiegazioni passo dopo passo, può anche portare a output più lunghi e prolissi, il che potrebbe non essere sempre desiderabile per tutte le applicazioni.
In questo articolo abbiamo visto come il prompting Chain-of-Thought rappresenti un progresso significativo nel migliorare le capacità di ragionamento dei Large Language Model, insieme ad alcuni esempi pratici della sua implementazione.
Che si usino template di prompt, prompting interattivo o feedback loop, l’idea alla base di questi approcci è guidare il modello attraverso il processo di ragionamento e sfruttarne le capacità.
Inoltre, abbiamo esplorato tecniche potenti come il one-shot e il few-shot prompting che migliorano ulteriormente le prestazioni del modello e possono essere combinati con il CoT, insieme ai benefici e ad alcuni limiti da non trascurare.
Prova le tecniche discusse in questo articolo per costruire prompt più affidabili e performanti e ricorda: il Prompt Engineering può avere un grande impatto sui tuoi output!
Puoi approfondire il prompt engineering con i corsi di DataCamp, Understanding Prompt Engineering e ChatGPT Prompt Engineering for Developers. Puoi anche consultare una guida separata alla certificazione in prompt engineering e scoprire quali sono i percorsi di apprendimento migliori per te.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



